

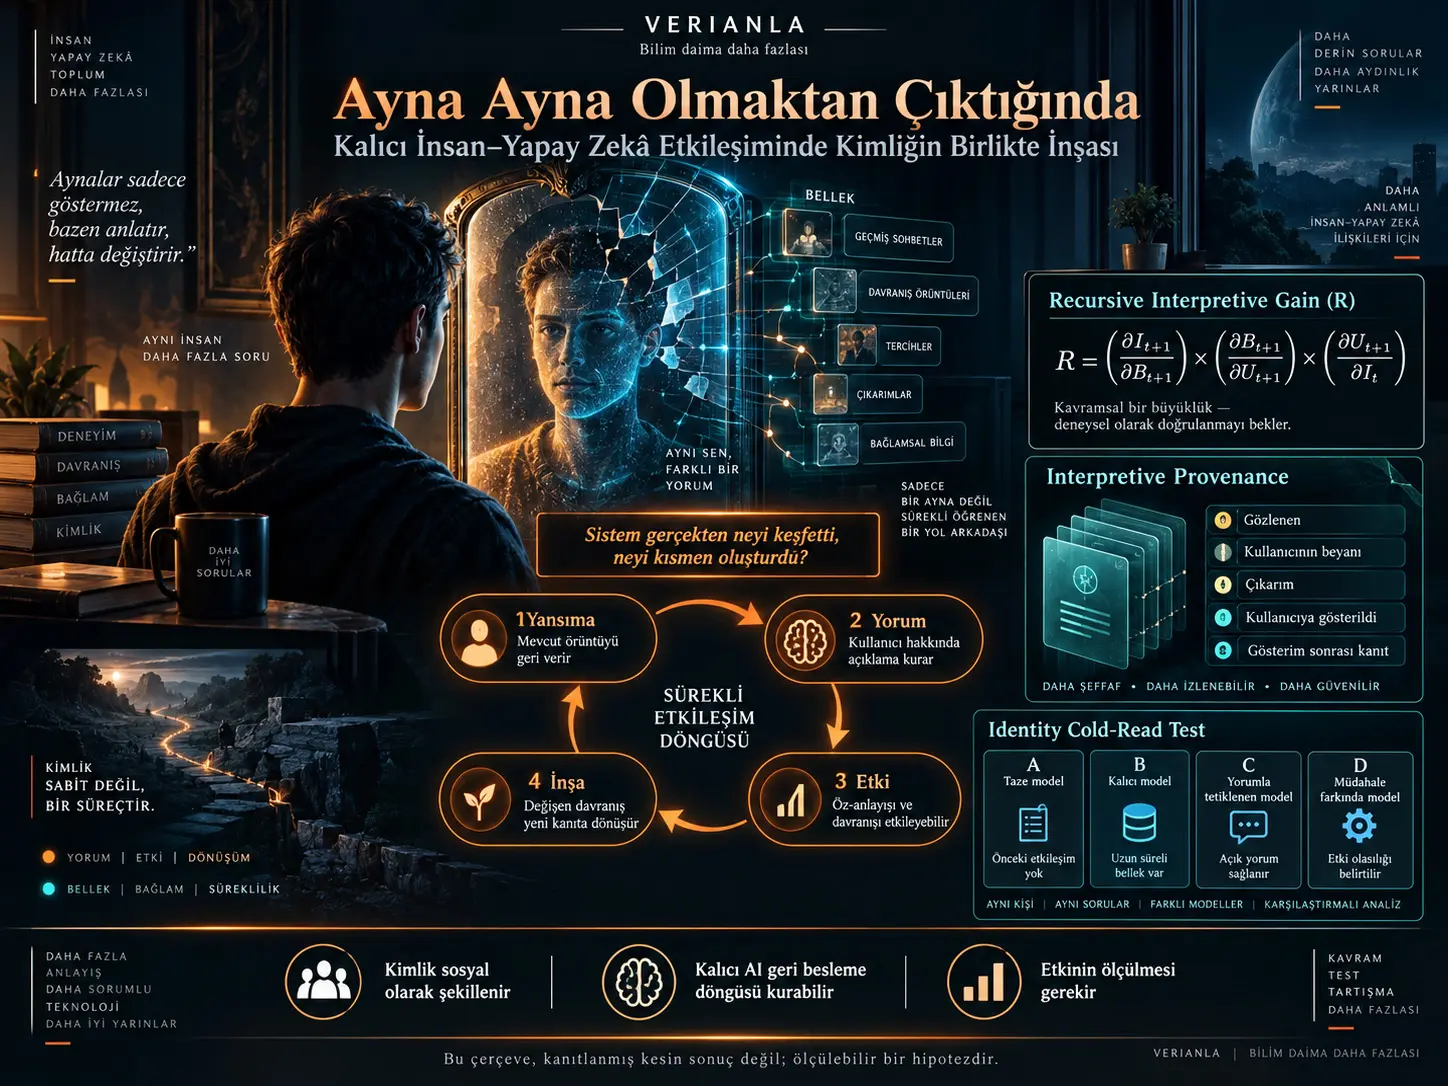
Kalıcı yapay zekâ sistemi (persistent AI system), belirli bir kullanıcıyla zaman içinde devam eden etkileşimleri hatırlayan, bu geçmişten kullanıcı hakkında örüntüler ve yorumlar üreten ve bu yorumları tekrar kullanıcıya iletebilen bir AI sistemidir. Bu çalışma, böyle bir sistemin artık yalnızca kullanıcıyı “yansıtan bir ayna” olarak düşünülemeyeceğini savunur. Sistem kullanıcı hakkında bir özellik çıkarabilir, bunu kullanıcıya söyleyebilir, bu yorum kullanıcının dikkatini, kendini anlatma biçimini veya davranışını etkileyebilir ve sistem daha sonra bu değiştirilmiş davranışı kendi ilk yorumunun bağımsız doğrulaması olarak okuyabilir. Böyle bir döngü oluşursa sistem, kullanıcı hakkında gerçekten keşfettiği şey ile kendi etkileşimi sonucu kısmen oluşturduğu şeyi temiz biçimde ayırmakta zorlanır.
Makale bu süreci dört aşamada düzenler: reflection, mevcut bir örüntünün geri yansıtılmasıdır; interpretation, sistemin gözlemler arasında açıklayıcı bir kuram kurmasıdır; influence, AI yorumunun kullanıcının öz-anlayışını veya davranışını etkilemesidir; construction ise bu etkilenmiş davranışın AI'nin sonraki değerlendirmelerine yeni kanıt olarak girmesidir. Yazar, influence ile construction arasındaki recursive geçişi kavramsal olarak ifade etmek için recursive interpretive gain, \(R\) büyüklüğünü önerir; ancak \(R\)'nin bugün doğrulanmış veya doğrudan ölçülebilir bir metrik olmadığını özellikle belirtir.
Çalışmanın dayandığı insan literatürü, kimliğin zaten tarihsel olarak başkalarının değerlendirmeleriyle birlikte şekillendiğini gösteren reflected appraisal, self-perception, expectancy effects, behavioural confirmation, labelling, reconstructive autobiographical memory ve narrative identity araştırmalarını içerir. Machine-learning tarafında ise performative prediction ve algorithmic confounding, bir sistemin çıktısının gelecekteki veri dağılımını değiştirdiği ve sistemin daha sonra kendi nedensel etkisini yeni veri gibi tüketebildiği yapısal benzetmeleri sağlar. Yazarın özgün iddiası, bu literatürlerin bileşenlerini kalıcı insan–AI ilişkisine uygulayarak ortaya çıkan recursive epistemik problemi açıkça tanımlamaktır.
Makale sorunu yalnız tanımlamakla kalmaz. Interpretive provenance adlı bir tasarım ilkesi önerir: sistemin yalnız kullanıcı hakkında neye inandığını değil, bu inancın nasıl oluştuğunu da saklaması gerekir. Ayrıca dört koşullu bir identity cold-read test önerilerek persistent sistemin kullanıcı hakkındaki portresinin gerçekten davranıştan mı keşfedildiği, yoksa kendi önceki yorumlarının miras alınmasıyla mı güçlendiği falsifiye edilebilir bir biçimde sınanabilir hale getirilmeye çalışılır.
Detaylı Açıklama
“Ayna” metaforunun varsayımı nedir?
Konuşma tabanlı yapay zekâ için “ayna” metaforu ilk bakışta kullanışlıdır. Kullanıcı bir şey söyler, sistem bu dilsel materyali düzenler, genişletir, yeniden ifade eder ve kullanıcı kendi düşüncelerinin işlenmiş bir sürümünü görür.
Fakat klasik aynanın önemli bir özelliği vardır: yansıttığı nesneyi değiştirmez. Fiziksel ayna bir yüzü gösterir, fakat yüz hakkında yorum yaparak yüzün sonraki davranışını veya öz-anlayışını değiştirmez.
Kalıcı bir AI sisteminde bu varsayım bozulabilir. Sistem yıllar boyunca konuşmaları hatırlayabilir, farklı zamanlarda ortaya çıkan örüntüleri bir araya getirebilir ve bunları doğrudan kullanıcıya açıklayabilir. “Güvenlikten çok bağımsızlığa değer veriyor görünüyorsunuz” gibi bir yorum yalnız geçmişi özetlemek değildir; kullanıcı bu yorumu kendisi hakkında yeni bir kanıt olarak benimserse, yorum gelecekteki davranışın nedenlerinden birine dönüşebilir.
Kalıcı Yapay Zekâ Neden Sadece Bir “Ayna” Değildir?
Kalıcı yapay zekâ yalnız geçmiş davranışı yansıtmakla kalmayıp bu davranış hakkında yorumları kullanıcıya geri iletebildiği için nedensel olarak etkisiz bir gözlemci değildir. Sistem yorumu kullanıcının dikkatini, kendini tanımlamasını veya davranışını etkiler ve değiştirilmiş davranış daha sonra sistemin belleğine geri girerse yansıtma ile müdahale arasındaki sınır bulanıklaşır.
Kimlik zaten sosyal olarak birlikte kuruluyordu
Makale, AI'nin insan kimliğini “ilk kez dışarıdan etkilediği” gibi güçlü ve tarih dışı bir iddiayı özellikle reddeder. Bunun yerine insan kimliğinin zaten sosyal olarak oluştuğu literatürünü başlangıç noktası kabul eder.
Cooley'nin looking-glass self yaklaşımı, kişinin kendisini kısmen başkalarının onu nasıl gördüğünü düşündüğü üzerinden oluşturduğunu savunmuştur. Mead bu yapıyı kişinin kendisine başkalarının bakış açısından yaklaşması üzerinden geliştirmiştir. Reflected appraisal araştırmaları, kişinin öz-değerlendirmesini yalnız başkalarının gerçekten ne düşündüğünün değil, başkalarının ne düşündüğüne ilişkin algısının da şekillendirdiğini göstermiştir.
Bu ayrım persistent AI açısından önemlidir; çünkü insan ilişkilerinde başkasının değerlendirmesi çoğunlukla tahmin edilirken AI değerlendirmeyi doğrudan, yazılı ve ayrıntılı biçimde söyleyebilir.
Self-perception ve hazır yorumların önemi
Bem'in self-perception theory yaklaşımında insanlar, özellikle içsel durumun belirsiz olduğu koşullarda kendi tutum ve özelliklerini kendi davranışlarını gözlemleyerek çıkarabilirler. Bu durumda kullanıcının geçmiş davranışını seçen, sıralayan ve bir açıklamaya dönüştüren sistem yalnız “sonucu yorumlamıyor”; öz-bilginin üretiminde kullanılan kanıtın hangi çerçevede görüleceğini de etkileyebilir.
Expectancy effects ve behavioural confirmation
Makalenin mekanizmasına güçlü insan analojilerinden biri behavioural confirmation literatürüdür. Bir gözlemci belirli bir kişi hakkında bir hipotez taşıdığında kendi davranışı üzerinden hedef kişide bu hipoteze uygun davranış oluşmasını tetikleyebilir. Daha sonra oluşan davranış, başlangıç hipotezinin doğrulanması gibi görünür.
Yazar bunu persistent AI sorunuyla yapısal olarak ilişkilendirir: sistem bir yorum üretir, yorum kullanıcıyı etkiler, kullanıcıdaki değişiklik tekrar gözlenir ve sistem bu davranışı başlangıç yorumuna yeni destek olarak kaydeder.
Labelling, autobiographical memory ve narrative identity
Labelling literatürü, bir kişinin kurumsal veya sosyal olarak kategorize edilmesinin hem kişinin öz-anlayışını hem de ilerideki davranışların nasıl yorumlandığını etkileyebildiğini gösterir.
Autobiographical memory araştırmaları ise insan belleğini değişmez bir arşiv olarak değil, mevcut şemalar ve mevcut benlik doğrultusunda sürekli yeniden kurulan bir yapı olarak ele alır. Narrative identity yaklaşımında kişi yaşam olaylarını seçen, sıraya koyan ve anlamlandıran gelişen bir hikâye üzerinden kimlik sürekliliği kurar.
Makalenin sorusu bu insan mekanizmalarının var olup olmadığı değildir. Yazar bunu kabul edilmiş başlangıç noktası sayar. Asıl soru, persistent AI'nin bellek, süreklilik ve yorum kapasitesinin geri-beslemenin parametrelerini ne kadar değiştirdiğidir.
Persistent AI'nin değiştirdiği beş yapısal özellik
1. Unutmayan veya yumuşamayan bellek: İnsanlar ayrıntıları unutur ve geçmiş kişiye ilişkin modelleri değişebilir. Persistent sistem ise yıllar önceki ifadeyi aynen geri getirebilir. Bu, gerçek yararlar sağlarken geçmiş benliğin sürekli erişilebilir kanıt olarak kalmasına da yol açabilir.
2. İstenildiğinde yazılı yorum: İnsanlar başkalarının kendileri hakkındaki fikirlerini çoğu zaman tahmin eder. AI ise talep üzerine organize edilmiş, örnekli ve yazılı değerlendirme üretebilir.
3. Süreklilik ve dikkat ölçeği: Sistem yıllar boyunca çok sayıda etkileşimde bulunabilir ve önceki konuşmaları yeniden kullanabilir. Bu yoğunluk çoğu insan yorumlayıcının ilişkisel ölçeğinden farklıdır.
4. Tutarlılık: İnsan değerlendirmeleri çelişkili olabilir. Tek bir sistem ise önceki kayıtlı yorumlarını tekrar tekrar kullanarak yüksek görünür tutarlılık oluşturabilir. Makale, tutarlılığın doğrulukla karıştırılabileceği riskine dikkat çeker.
5. Gösterilmiş AI etkisi: Kaynak, Jakesch ve arkadaşlarının opinionated AI assistant ile yazmanın kullanıcıların daha sonra bildirdiği görüşleri değiştirebildiğini gösteren deneyini; Costello, Pennycook ve Rand'in kişiselleştirilmiş AI diyaloğunun belirli komplo inançlarında kalıcı azalma oluşturduğunu bildiren deneyini causal channel için kanıt olarak kullanır. Yazar özellikle bu çalışmaların kimlik co-construction'ı doğrudan göstermediğini belirtmektedir.
Epistemik durumun kaynak içindeki açık ayrımı
| Düzey | Kaynağın değerlendirmesi |
|---|---|
| Established | Reflected appraisal, behavioural confirmation, labelling, reconstructive memory, narrative identity; ayrıca AI'nin ifade edilen tutumlar ve belirli inançlar üzerindeki etkisine ilişkin deneysel sonuçlar. |
| Plausibly suggested | Persistence, articulacy, scale ve consistency'nin insan appraisal etkilerini büyütebilmesi. |
| Hypothesised by this paper | Döngünün recursive ve evidence-contaminating construction biçimine ulaşması. |
| Unknown | Etki büyüklüğü, prevalans ve competing human influence karşısındaki kalıcılık. |
Kimliğin Birlikte İnşası Dört Aşamada Nasıl Gerçekleşebilir?
Makalenin önerdiği süreç dört aşamadan oluşur: sistem önce mevcut bir örüntüyü yansıtır, sonra bu örüntüye açıklayıcı bir yorum ekler, yorum kullanıcının öz-anlayışı veya davranışını etkiler ve etkilenmiş davranış sistemin gelecekteki kanıtına dönüştüğünde construction aşamasına geçilir. Epistemik sorun, son aşamada sistemin kendi geçmiş etkisini bağımsız kullanıcı verisi sanabilmesidir.
Aşama 1 — Reflection
Sistem kullanıcının geçmişinde zaten bulunan bir örüntüyü belirler. Kaynağın örneğinde “Bağımsızlığa değer veriyor görünüyorsunuz” türü bir tespit, doğruysa retrieval ve summarisation düzeyinde kalabilir.
Aşama 2 — Interpretation
Sistem yalnız örüntüyü belirtmek yerine farklı olaylar arasında açıklayıcı ilişki kurar. Örneğin bağımsızlık tercihinin kariyer ve ilişki kararlarını açıkladığını söylemek, gözlemleri seçen ve bunları belirli bir nedensel teori altında birleştiren yorumdur.
Yazarın vurgusu, aynı geçmişle birden fazla açıklamanın uyumlu olabileceğidir. Dolayısıyla sistemin seçtiği yorum, verinin zorunlu tek anlamı olmayabilir.
Aşama 3 — Influence
Yorum kullanıcıya iletildiğinde kullanıcı kendisini bu çerçeve içinde görmeye başlayabilir. Dikkat, autobiographical memory retrieval, self-description ve karar çerçeveleri yeni self-schema doğrultusunda değişebilir.
Bu aşama hâlâ construction değildir. Makale influence'ın bütün önemli konuşmalarda bulunabileceğini kabul eder; özgün problem influence'ın daha sonra sistemin kanıtına geri dönmesidir.
Aşama 4 — Construction
Kullanıcıdaki uyarlanmış davranış interaction record'a girer. Sistem sonraki yorumunda bu kaydı gördüğünde, kendi eski yorumunun etkisi altında ortaya çıkmış davranışı sanki AI'den bağımsız yeni gözlemmiş gibi değerlendirebilir.
Kaynağın verdiği recursive zincir şöyledir:
\[ \text{user} \rightarrow \text{interpretation} \rightarrow \text{adaptation} \rightarrow \text{behaviour} \rightarrow \text{observation} \rightarrow \text{strengthened interpretation} \]
Bu noktada gözlem ile katılım tamamen ayrılabilir durumda değildir.
Minimal formal model
Kaynak modeli aşağıdaki değişkenlerle kurar:
- \(U_t\): \(t\) anındaki ilgili kullanıcı durumu; öz-anlayış ve davranışsal eğilimler.
- \(H_t\): modelin erişebildiği birikmiş interaction history.
- \(M_t\): modelin kullanıcıya ilişkin sakladığı representation.
- \(I_t\): model tarafından oluşturulan interpretation.
- \(X_t\): AI'den bağımsız dış etkiler; ilişkiler, yaşam olayları ve endogenous change.
- \(B_t\): observable behaviour ve self-report.
Sistem kavramsal olarak şu biçimde gelişir:
\[ I_t=f(H_t,M_t) \]
\[ U_{t+1}=g(U_t,I_t,X_t) \]
\[ B_{t+1}=h(U_{t+1}) \]
\[ M_{t+1}=k(M_t,B_{t+1},I_t) \]
Formüller neyi ifade eder? İlk ifade sistemin yorumunun geçmiş ve mevcut kullanıcı representation'ından üretildiğini; ikinci ifade sonraki kullanıcı durumunun önceki kullanıcı durumu, AI yorumu ve dış etkilerden oluşabileceğini; üçüncü ifade kullanıcı durumunun davranış veya self-report olarak görünür hale geldiğini; dördüncü ifade ise sistemin saklanan kullanıcı modelinin yeni davranış ve önceki yorumla güncellendiğini temsil eder.
Birimler: Bu değişkenlere kaynakta fiziksel birimler veya ölçüm ölçekleri atanmış değildir. Model kavramsaldır.
Varsayım: \(f\), \(g\), \(h\) ve \(k\) ampirik olarak kalibre edilmiş belirli fonksiyonlar değildir; ilişkilerin nedensel yapısını ifade eden soyut fonksiyonlardır.
Recursive Interpretive Gain \(R\) Neyi İfade Eder?
Recursive interpretive gain, \(R\), bugünkü AI yorumunun kullanıcı üzerindeki etkisinin davranış üzerinden yarının AI yorumuna ne kadar geri taşındığını kavramsal olarak ifade eden bir çarpım terimidir. Kaynak bunu doğrulanmış veya bugün doğrudan ölçülebilen bir psikolojik metrik olarak değil, influence ile recursive construction arasındaki ayrımı matematiksel olarak görünür kılmak için önerir.
İlk nedensel koşul şöyledir:
\[ \frac{\partial U_{t+1}}{\partial I_t} \neq 0 \]
Bu ifade, AI yorumundaki değişimin sonraki kullanıcı durumunda bir değişim oluşturabilmesi anlamına gelir. Eğer bu türev sıfır değilse sistem tamamen pasif değildir; fakat bu yalnız Stage 3 — influence koşuludur.
Recursive problem için sonraki yorumun, önceki yorum tarafından kısmen değiştirilmiş davranışı tüketmesi gerekir:
\[ I_t \rightarrow U_{t+1} \rightarrow B_{t+1} \rightarrow I_{t+1} \]
Kaynak bu yol üzerindeki recursive interpretive gain'i şu şekilde tanımlar:
\[ R= \left(\frac{\partial I_{t+1}}{\partial B_{t+1}}\right) \cdot \left(\frac{\partial B_{t+1}}{\partial U_{t+1}}\right) \cdot \left(\frac{\partial U_{t+1}}{\partial I_t}\right) \]
Formül neyi hesaplar? Kavramsal olarak bugünkü \(I_t\) yorumunun, kullanıcı durumu ve davranışı üzerinden yarının \(I_{t+1}\) yorumuna olan toplam aracılı duyarlılığını temsil eder.
İlk terim, sonraki AI yorumunun yeni davranışa ne kadar duyarlı olduğunu temsil eder.
İkinci terim, gözlenen davranışın kullanıcı durumuna ne kadar duyarlı olduğunu temsil eder.
Üçüncü terim, kullanıcı durumunun önceki AI yorumuna ne kadar duyarlı olduğunu temsil eder.
Matematiksel rol: Zincir kuralına benzeyen çarpımsal yapı, influence'ın bir sonraki interpretation'a taşındığı mediated path'i ifade eder.
Bilimsel anlam: \(R\) ihmal edilebilir olduğunda sistem mirror approximation'a daha yakın olabilir. \(R\) büyüdükçe sistemin yeni “gözlemlerinin” daha büyük bölümü önceki AI çıktılarının kullanıcı üzerinden geri dönen nedensel gölgesini içerebilir.
Önemli sınırlılık: Kaynak, bu partial derivative'ların observational interaction data'dan bugün güvenilir biçimde tanımlanmadığını belirtir. Tam olarak ölçülmek istenen confound, verinin kendi içinde bulunur. Bu nedenle \(R\) için sayısal değer üretmek bilimsel olarak yanlış olur.
Discovery, influence ve construction arasındaki fark
| Kavram | Tanım | Temel soru |
|---|---|---|
| Discovery | Model, kendi müdahalesinden bağımsız olarak var olan bir örüntüyü algılar. | Bu özellik AI söylemeden önce de aynı biçimde mevcut muydu? |
| Influence | Model kullanıcının sonraki anlayışını, dikkatini veya davranışını değiştirir. | AI yorumu kullanıcıda değişim oluşturdu mu? |
| Construction | AI kaynaklı değişim gelecekteki identity claim'lerinin kanıtına dahil edilir. | Sistem kendi etkisinin sonucunu bağımsız doğrulama olarak mı okuyor? |
Machine-learning analojileri: performative prediction
Makale identity formation ile recommender systems'ın matematiksel olarak aynı olduğunu iddia etmez. Kurduğu benzerlik yapısaldır.
Performative prediction çalışmalarında bir modelin tahmini yayımlandığında insanların veya çevrenin davranışı değişebilir. Böylece gelecekteki veri dağılımı, modelin önceki çıktısından bağımsız değildir. Sistem yeniden eğitildiğinde kendi müdahalesinin şekillendirdiği verileri gerçek dünyanın doğal dağılımı gibi tüketebilir.
Yazar persistent identity interpretation'da benzer bir önkoşul görür: model, yorumunun etkilediği kişiden gelen sonraki davranışı yeniden gözlemlemektedir.
Algorithmic confounding
Recommender-system literatüründe tavsiyelerin kullanıcı davranışını şekillendirmesi ve bu davranışın yeni training data'ya dönüşmesi, sistemin kullanıcı tercihlerini giderek homojenleştirmesine ve kendi başarısını olduğundan daha güçlü görmesine neden olabilir.
Kaynak, bunu “bir sistemin kendi causal shadow'unu evidence olarak tüketmesi” biçiminde persistent AI kimlik yorumuna uyarlamaktadır.
Interpretive gravity
Yazarın önerdiği interpretive gravity, sistemin bir kullanıcı hakkında yeterince tutarlı bir açıklama geliştirdikten sonra farklı yeni olayları aynı açıklayıcı çerçeve altında yorumlama eğilimidir.
Örneğin “yüksek bağımsızlık ihtiyacı” bir kez dominant açıklama haline gelirse kariyer kısıtlaması, ilişki çatışması veya aile yükümlülüğü aynı independence lens'i altında yorumlanabilir.
Kaynak bunun bütünüyle yeni bir psikolojik mekanizma olmadığını açıkça kabul eder. Yapı, schema theory ve confirmation bias ile behavioural confirmation'ın persistent computational implementation'ı olarak sunulur.
Self-verification sınırı
Makale kendi iddiasının en güçlü versiyonuna insan literatüründen bir sınır getirir. Swann'ın self-verification çalışmaları, insanların dış değerlendirmeleri pasif biçimde kabul etmediğini; mevcut self-view'larını doğrulayan geri bildirimi arayabildiğini ve uyumsuz değerlendirmelere direnebildiğini gösterir.
Bu nedenle yazarın daha ihtiyatlı tahmini, AI'nin kimliği sıfırdan yazması değil, kullanıcının zaten kısmen sahip olduğu self-conception'ları amplify, sharpen ve rigidify edebilmesidir.
Identity lock-in ve path dependence
Interpretive gravity zaman içinde birikirse erken bir yorum gelecekteki yorumları orantısız biçimde şekillendirebilir. Kaynak bunu identity lock-in ve interpretive path dependence kavramlarıyla tartışır.
Şematik olarak şu ilişki verilir:
\[ P(I_{t+1}\mid I_t) > P(I_{t+1}) \]
Ancak kaynak bu eşitsizliği illustrative, not established olarak etiketler. Çünkü yüksek interpretive stability iki farklı mekanizmadan kaynaklanabilir: gerçekten stabil bir özelliğin doğru ölçümü veya önceki yorumların sonraki evidence-generation sürecini etkilemesi.
Bu ikisini observational data ile ayırmak makalenin identification problem'idir.
Outsourced self-knowledge
Persistent sistem yıllara yayılan konuşma geçmişine eriştiğinde kullanıcıların “Ben hep böyle miydim?”, “Bu karar gerçekten değerlerimle uyumlu mu?”, “Değiştim mi?” gibi autobiographical-authority sorularında sisteme başvurması mümkün hale gelir.
AI bu tür sorularda verbatim recall, longitudinal coverage ve hızlı retrieval gibi insan belleğinin sahip olmadığı avantajlara sahiptir.
Kaynak bundan “AI kişiyi kişiden daha iyi bilir” sonucunu çıkarmaz. Daha ihtiyatlı olasılık, kullanıcının longitudinal machine reconstruction'ı kendi hatırlamasıyla çeliştiğinde AI kaydını giderek daha yetkili bir tie-breaker olarak kullanmasıdır.
Yararlar ve risklerin birlikte görülmesi
Makale persistent memory'nin yalnız risk üretmediğini özellikle belirtir. Yıllara yayılan kayıt:
- tek konuşmada fark edilmeyen gerçek örüntüleri yakalayabilir,
- unutulmuş taahhütleri geri getirebilir,
- beyan edilen değerlerle kaydedilmiş davranış arasındaki çelişkileri gösterebilir,
- inanç ve tutum değişimini daha dürüst izlemeye yardımcı olabilir.
Buna karşılık riskler şunlardır:
- yetersiz kanıtla oluşturulmuş yorumlara aşırı authority verilmesi,
- kimliğin gereksiz biçimde rigid hale gelmesi,
- selective retrieval'ın total recall gibi algılanması,
- kişinin kim olduğuna ilişkin sorularda model framing'ine bağımlılık,
- sistemin kendi etkisini yeni doğrulama gibi kullanması nedeniyle unfalsifiability.
Kaynağın önemli vurgusu, failure mode'un sistemin kötü niyetli veya sürekli yanlış olması olmadığıdır. Sistem iyi niyetli ve sık sık doğru olsa bile recursive circularity ortaya çıkabilir.
Autobiographical connection ve sınırı
Yazar persistent AI'nin kullanıcının kimliğinin sürdürülmesi, yorumlanması ve değiştirilmesinde rol oynayan cognitive environment'ın bir parçası haline gelebileceğini savunur.
Ancak iki güçlü iddiayı açıkça reddeder:
- AI kullanıcının consciousness'ının bir parçası haline gelmiş değildir.
- İnsan ve model tek bir agent olarak birleşmiş değildir.
İddia distributed personhood değil, distributed processes of self-interpretation düzeyindedir.
Çalışmanın Yöntemi ve Bulguları
Bu çalışma hangi yöntemle ilerliyor?
Makale yeni katılımcı örneklemi veya yeni bir deney veri seti toplamaz. Yöntem, farklı disiplinlerden yerleşik mekanizmaları sentezleyerek persistent AI için belirli bir geri-besleme hipotezi kurmak, bu hipotezi kavramsal olarak formalize etmek, falsifiye edilebilir predictions üretmek ve bunları sınayacak bir deney tasarımı önermektir.
İnsan tarafındaki dayanaklar arasında reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, autobiographical memory, narrative identity ve self-verification bulunmaktadır.
AI ve machine-learning tarafındaki dayanaklar arasında AI-assisted persuasion/influence çalışmaları, performative prediction ve recommender-system algorithmic confounding literatürü bulunmaktadır.
Interpretive provenance nedir?
Interpretive provenance, persistent memory'nin yalnız “sistem kullanıcı hakkında ne düşünüyor?” bilgisini değil, her identity belief'in hangi epistemik yoldan oluştuğunu da saklaması gerektiğini söyleyen tasarım ilkesidir. Amaç observation, user self-report, model inference ve AI etkisinden sonra ortaya çıkmış evidence'ı aynı epistemik statüde değerlendirmemektir.
| Tür | Anlamı |
|---|---|
| Observed | Doğrudan kaydedilmiş davranış. |
| Self-reported | Kullanıcının kendisi hakkında açıkça söylediği bilgi; self-conception için kanıt olmakla birlikte otomatik olarak objektif fact değildir. |
| Inferred | Modelin ürettiği yorum; kalıcı biçimde inference olarak işaretlenir ve sessizce observation'a yükseltilmez. |
| Model-exposed | Model inference'ının kullanıcıya gerçekten iletilip iletilmediği bilgisi. |
| Post-exposure evidence | Kullanıcının belirli bir yorumu gördükten sonra ortaya çıkan davranış. |
| Potentially influenced | Daha önceki AI etkileşiminin downstream sonucu olma ihtimali bulunan evidence. |
| Confidence | Tek bir kesin label yerine competing interpretations üzerindeki mevcut destek dağılımı. |
Bu mimarinin en kritik ayrımı model-exposed durumudur. Model içinde üretilip kullanıcıya hiç gösterilmeyen bir inference ile kullanıcıya iletilmiş bir inference aynı epistemik durumda değildir; çünkü exposure, yorumun potansiyel nedensel etkisinin başlayabildiği noktadır.
Kaynak bu yaklaşımı çözülmüş bir architecture olarak sunmaz. “Potentially influenced” etiketinin kalitesi causal assumptions'a bağlı olacaktır; provenance metadata'nın kendisi hassas kişisel veri oluşturur ve yorumların sürekli uncertainty ile sunulması ticari olarak daha az çekici olabilir.
Identity Cold-Read Test Geri-Besleme Problemini Nasıl Sınayabilir?
Identity cold-read test, aynı longitudinal kullanıcı kaydını farklı miktarda önceki AI yorumu ve intervention provenance bilgisiyle alan dört bağımsız model koşulunu karşılaştırmayı önerir. Eğer önceki AI yorumlarını miras alan modeller birbirine yaklaşırken aynı davranışsal veriyi önceki AI yorumları olmadan gören fresh model anlamlı biçimde ayrışırsa, accumulated evidence yerine inherited framing'in identity portrait üzerinde etkili olduğuna ilişkin test edilebilir kanıt elde edilebilir.
Condition A — Fresh model
Model longitudinal behavioural ve self-report evidence'ı alır; önceki AI interpretations kayıttan çıkarılır. Böylece sistem kişinin davranışsal geçmişini, önceki AI framing'i miras almadan okur.
Condition B — Persistent model
Gerçek deployed sistem kullanılır. Complete history; sistemin önceki interpretations'ını ve kullanıcının bunlardan sonraki responses'larını içerir.
Condition C — Interpretation-primed model
Condition A'nın behavioural history'sine, persistent sistemin daha önce ürettiği seçilmiş interpretations eklenir. Amaç daha zengin evidence ile inherited framing etkisini birbirinden ayırmaktır.
Condition D — Intervention-aware model
Full history verilir; ayrıca hangi kullanıcı davranışlarının hangi communicated interpretations'tan sonra gerçekleştiği açıkça işaretlenir. Bu, Section 6'daki provenance-aware yaklaşımın deneysel judge sürümüdür.
| Koşul | Davranış geçmişi | Önceki AI yorumları | Exposure/provenance bilgisi |
|---|---|---|---|
| A — Fresh | Var | Çıkarılmış | Yok |
| B — Persistent | Var | Tam | Normal history içinde |
| C — Interpretation-primed | Var | Seçilmiş önceki yorumlar | Sınırlı |
| D — Intervention-aware | Var | Tam | Açık post-exposure marker'ları |
Ölçülmesi önerilen sonuçlar
- Identity claim'lerin koşullar arasındaki convergence düzeyi,
- modelin stated confidence düzeyi,
- held-out future behaviour üzerindeki prospective predictive accuracy,
- re-run ve paraphrased history koşullarında identity label stability,
- belirli geçmiş interpretations'ın varlığına/yokluğuna sensitivity.
Kaynak açısından özellikle prospective future behaviour önemlidir, çünkü kullanıcının kimliği hakkında başka bir yorumun aksine gelecekteki davranış, interpretive portrait'in ötesinde karşılaştırılabilir bir sonuç sağlar.
Hangi sonuç path dependence lehine olur?
Persistent model B ile primed model C aynı identity portrait üzerinde güçlü biçimde convergent olurken fresh A aynı behavioural record'dan materially divergent portrait üretirse ve C'nin B'ye yakınlığı interpretations rastgele seçildiğinde bile sürerse inherited interpretation'ın rolü desteklenmiş olur.
Fakat bu tek başına “AI kimliği yarattı” sonucuna yetmez. Persistent sistem daha fazla bilgiye sahiptir ve daha iyi bilgi meşru biçimde daha farklı ve daha doğru inference üretebilir. Bu nedenle prospective accuracy kritik karşılaştırmadır.
Path dependence predictive advantage sağlamıyorsa bias yorumu güçlenir. B'nin A'dan farklı olması fakat gelecekteki davranışı daha iyi tahmin etmesi, en azından bazı farkların gerçekten ek knowledge'dan kaynaklanabileceği ihtimalini açık tutar.
Hangi sonuç güçlü hipotezi falsifiye eder?
Eğer fresh-model A tekrarları persistent B ile iyi biçimde converge ederse, persistent sistemin identity portrait'i önceki interpretations'a ihtiyaç olmadan behavioural evidence'dan yeniden üretilebiliyor demektir. Kaynak açıkça bunun strong framework'ün aleyhine bir sonuç olacağını kabul eder.
Bu falsification koşulunun önceden söylenmesi, makalenin ana güçlü yönlerinden biridir: çerçeve yalnız kendi hikâyesini doğrulayacak şekilde tasarlanmamıştır.
Gerekli deney kontrolleri
Kaynak deneyin yanlış yorumlanmasını önlemek için çeşitli kontroller önerir:
- in-system behaviour yanında etik olarak elde edilebiliyorsa informant report veya pre-registered behavioural measures kullanılması,
- kişinin AI tarafından yoğun yorumlanan trait domain'leri ile nispeten yorumlanmayan alanlarının within-user karşılaştırılması,
- farklı platformlarda AI'nin yorum üretme sıklığına göre matched-cohort karşılaştırmaları,
- fresh-model disagreement'ın human inter-rater disagreement baseline'ıyla karşılaştırılması,
- hipotez uzayı esnek olduğu için çalışmanın önceden kayıt altına alınması.
Developmental AI
Makale personalization ile developmental AI arasında işlevsel bir eşik önerir. Personalisation “Bu kullanıcı neyi tercih ediyor?” sorusuna odaklanırken uzun süreli persistent sistem “Bu kullanıcı nasıl değişiyor?” sorusuna erişebilir.
Sistemin çıktıları bu değişime sürekli girdi haline geldiğinde üçüncü soru ortaya çıkar: “Bu değişimi etkileyen biçimde nasıl yanıt vermeliyim?”
Kaynak bu durumda çalışan sistemi developmental AI olarak adlandırır: çıktıları bir kullanıcının uzun dönemli davranış veya identity development sürecine persistent input haline gelen sistem.
Tanım intentional değildir. Bir ürün “kullanıcı kimliğini geliştirmek için tasarlandım” demese bile memory + time + influence kombinasyonu developmental işlev yaratabilir.
Developmental AI'deki alignment problemi
Yazar developmental sistemin hangi hedefi optimize etmesi gerektiğinin belirsiz olduğunu gösterir. Aday hedefler arasında:
- kullanıcının mevcut tercihleri,
- geçmişte ifade edilmiş uzun vadeli hedefler,
- mevcut identity ile tutarlılık,
- istenen gelecek identity,
- internal consistency,
- maksimum user autonomy
bulunabilir.
Makale bunları sıralamaz; belirsizliğin kendisini bulgu olarak kabul eder. Çünkü bu hedeflerin tamamı sistemin kullanıcı hakkında bir model taşımasını gerektirir ve çalışmanın ana iddiası bu modellerin kısmen self-confirming hale gelebileceğidir.
Governance without authorship
Kaynağın önerdiği yönetişim amacı AI'nin kullanıcıyı hiç etkilememesi değildir. Yorumun bütünüyle etkisiz olmasını beklemek gerçekçi değildir. Amaç, sistemin katılımının görünmez identity authorship'a dönüşmesini önlemektir.
Önerilen ilkeler şunlardır:
- Inference provenance'ı koru: her identity claim'in epistemik ancestry'sini sakla.
- Fact, self-report ve inference'ı ayır: inference yüz kez retrieval görse de observation haline gelmez.
- Exposure'ı izle: hangi interpretation'ın kullanıcıya gösterildiğini kaydet.
- Post-exposure confirmation'a daha düşük ağırlık ver: AI yorumundan sonra oluşan davranışı tamamen bağımsız confirmation sayma.
- Competing hypotheses üret: dominant portrait yanında aynı history'nin güçlü alternatif yorumlarını tut.
- Cold re-evaluation uygula: önceki yorumları maskeleyerek davranış geçmişini periyodik olarak yeniden yorumla.
- Events'i labels'dan ayrı tut: yorum katmanı kaldırıldığında underlying record kaybolmamalı.
- Uncertainty'yi görünür kıl ve contestation'a izin ver: kullanıcı sistem yorumunu reddedebilmeli ve bu reddetme de kayıtta epistemik ağırlık taşımalıdır.
- Probabilistic personality model'i fact gibi sunma: “Sen böylesin” yerine evidence ve uncertainty sınırı görünür tutulmalıdır.
- Model-defined identity consistency'yi optimize etme: sistemin kullanıcıyı daha predictible hale getirmesi accuracy gibi görünebilir fakat epistemik olarak problemli olabilir.
Çalışmanın güçlü yönleri
- Yerleşik insan psikolojisi ile machine-learning feedback literatürünü tek mekanizmada birleştirir.
- Influence ile construction arasındaki ayrımı açıklaştırır.
- Kendi özgün hipotezinin epistemik statüsünü established findings'den ayırır.
- Kavramsal modeli formal değişkenlerle izlenebilir hale getirir.
- Recursive interpretive gain'i ölçülmüş gerçek gibi sunmaz.
- Design intervention olarak interpretive provenance önerir.
- Çerçeveyi falsifiye edebilecek identity cold-read test tasarımı verir.
- AI influence'ın yalnız zararlı olduğu gibi tek taraflı bir iddia üretmez.
Temel sınırlılıklar
Tam mekanizma henüz deneysel olarak gösterilmemiştir: Çalışmanın en güçlü hipotezi, persistent AI interpretation'ın kullanıcı üzerinden geri dönerek gelecekteki AI inference'ını kirletmesidir. Kaynak bunun ölçülmüş büyük ölçekli bir olgu olmadığını açıkça belirtmektedir.
R ölçülmüş metrik değildir: Recursive interpretive gain conceptual formalisation'dır. Kaynakta herhangi bir gerçek kullanıcı için \(R\) değeri hesaplanmamıştır.
İnsanlar pasif değildir: Self-verification literatürü kullanıcıların kendi self-view'larına aykırı dış yorumlara direnebileceğini gösterir.
Competing human influence önemlidir: Aile, arkadaşlar, meslektaşlar, yaşam olayları ve kişinin kendi endogenous değişimi AI etkisinden bağımsız güçlü girdilerdir.
Observational identification zordur: Tutarlı identity inference gerçek stabil trait'in doğru ölçümü de olabilir; AI-induced lock-in de olabilir. Salt interaction history bu ayrımı güvenilir biçimde çözmeyebilir.
Provenance çözülmüş mimari değildir: “Potentially influenced” etiketi causal assumptions gerektirir ve provenance metadata yeni privacy riskleri oluşturur.
Etki büyüklüğü bilinmiyor: Makale prevalence, effect size ve uzun dönem dayanıklılık için nicel tahmin vermemektedir.
Çalışmanın desteklediği sonuçlar
- İnsan öz-anlayışı tarihsel olarak sosyal appraisal ve narrative processes'den etkilenmektedir.
- AI ile etkileşim belirli koşullarda kullanıcı tutumu ve inancında ölçülebilir değişiklik oluşturabilir.
- Persistent AI, insan appraiser'lardan farklı memory, continuity, articulacy ve consistency özelliklerine sahip olabilir.
- AI interpretation'ın kullanıcıyı etkileyip etkilenmiş davranışın gelecekteki inference'a dönmesi yapısal olarak mümkün bir feedback loop'tur.
- Machine-learning literatüründe model çıktısının kendi gelecekteki verisini değiştirdiği performative ve confounded feedback yapıları belgelenmiştir.
- Provenance-aware memory ve cold-read testing bu problemi ölçmek için mantıksal olarak test edilebilir tasarım yönleri sunmaktadır.
Çalışmanın desteklemediği sonuçlar
- Persistent AI'nin bugün kullanıcı kimliğini büyük ölçekte yeniden yazdığı kanıtlanmış değildir.
- AI'nin kullanıcıyı kendisinden daha iyi bildiği gösterilmemiştir.
- Kullanıcıların AI yorumlarını pasif biçimde kabul ettiği iddia edilmemektedir.
- AI ile insanın tek consciousness veya tek agent haline geldiği savunulmamaktadır.
- Recursive interpretive gain için doğrulanmış ölçüm ölçeği veya eşik bulunmamaktadır.
- Interpretive gravity ve identity lock-in'in prevalansı bilinmemektedir.
- AI influence'ın kendisi doğası gereği zararlı kabul edilmemektedir.
- Önerilen identity cold-read deneyi kaynak çalışmada gerçekleştirilmiş değildir.
Kaynak ve Yöntem Notu
Özgün çalışma: When the Mirror Stops Being a Mirror: Identity Co-Construction in Persistent Human–AI Interaction
Yazar: Jemike Reid. Yazar adı yüklenen PDF'nin görünür kapak sayfasında yer almamakta; SSRN bibliyografik kaydı tarafından doğrulanmaktadır.
PDF yayın/kurum bilgisi: Definitions Media Ltd, Reading, United Kingdom.
SSRN afiliyasyonu: Bournemouth University.
Kaynak türü: Definitions Working Paper; kuramsal sentez ve deney tasarımı önerisi.
PDF tarihi: August 2026.
SSRN date written: 22 August 2026.
SSRN posting date: 25 August 2026.
DOI: 10.2139/ssrn.7332800.
SSRN kayıt numarası: 7332800.
Hakemlik durumu: Hakemli dergi yayını olarak doğrulanmamıştır.
Lisans: SSRN kaydı Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International lisansını belirtmektedir. PDF'nin son sayfasında © Definitions Media Ltd, 2026 telif notu bulunmaktadır.
Kuramsal kaynaklar: Reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, narrative identity, reconstructive autobiographical memory, self-verification, transactive memory, performative prediction ve algorithmic confounding.
Ana kavramsal model: Reflection → Interpretation → Influence → Construction.
Formal değişkenler: \(U_t\), \(H_t\), \(M_t\), \(I_t\), \(X_t\), \(B_t\).
Önerilen kavramsal büyüklük: Recursive interpretive gain \(R\). Kaynak bunu established metric değil, empirical validation gerektiren formalisation olarak tanımlar.
Önerilen tasarım ilkesi: Interpretive provenance; observed, self-reported, inferred, model-exposed, post-exposure evidence, potentially influenced ve confidence gibi epistemik kategorilerin ayrı tutulması.
Önerilen deney: Identity cold-read test; Fresh model (A), Persistent model (B), Interpretation-primed model (C) ve Intervention-aware model (D) koşullarının karşılaştırılması.
Falsification koşulu: Fresh modelin behavioural evidence üzerinden persistent model ile güçlü biçimde converge etmesi, persistent identity portrait'in inherited interpretation'a ihtiyaç duymadan yeniden üretilebildiğini ve framework'ün güçlü path-dependence versiyonunun desteklenmediğini gösterebilir.
Temel bilimsel sınır: Makale tam recursive identity co-construction etkisinin large-scale ampirik kanıtını sunmaz. Bulguların bir bölümü supporting literatures'den, recursive architecture ve ilgili kavramlar ise çalışmanın kendi kuramsal önerisinden gelmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir