

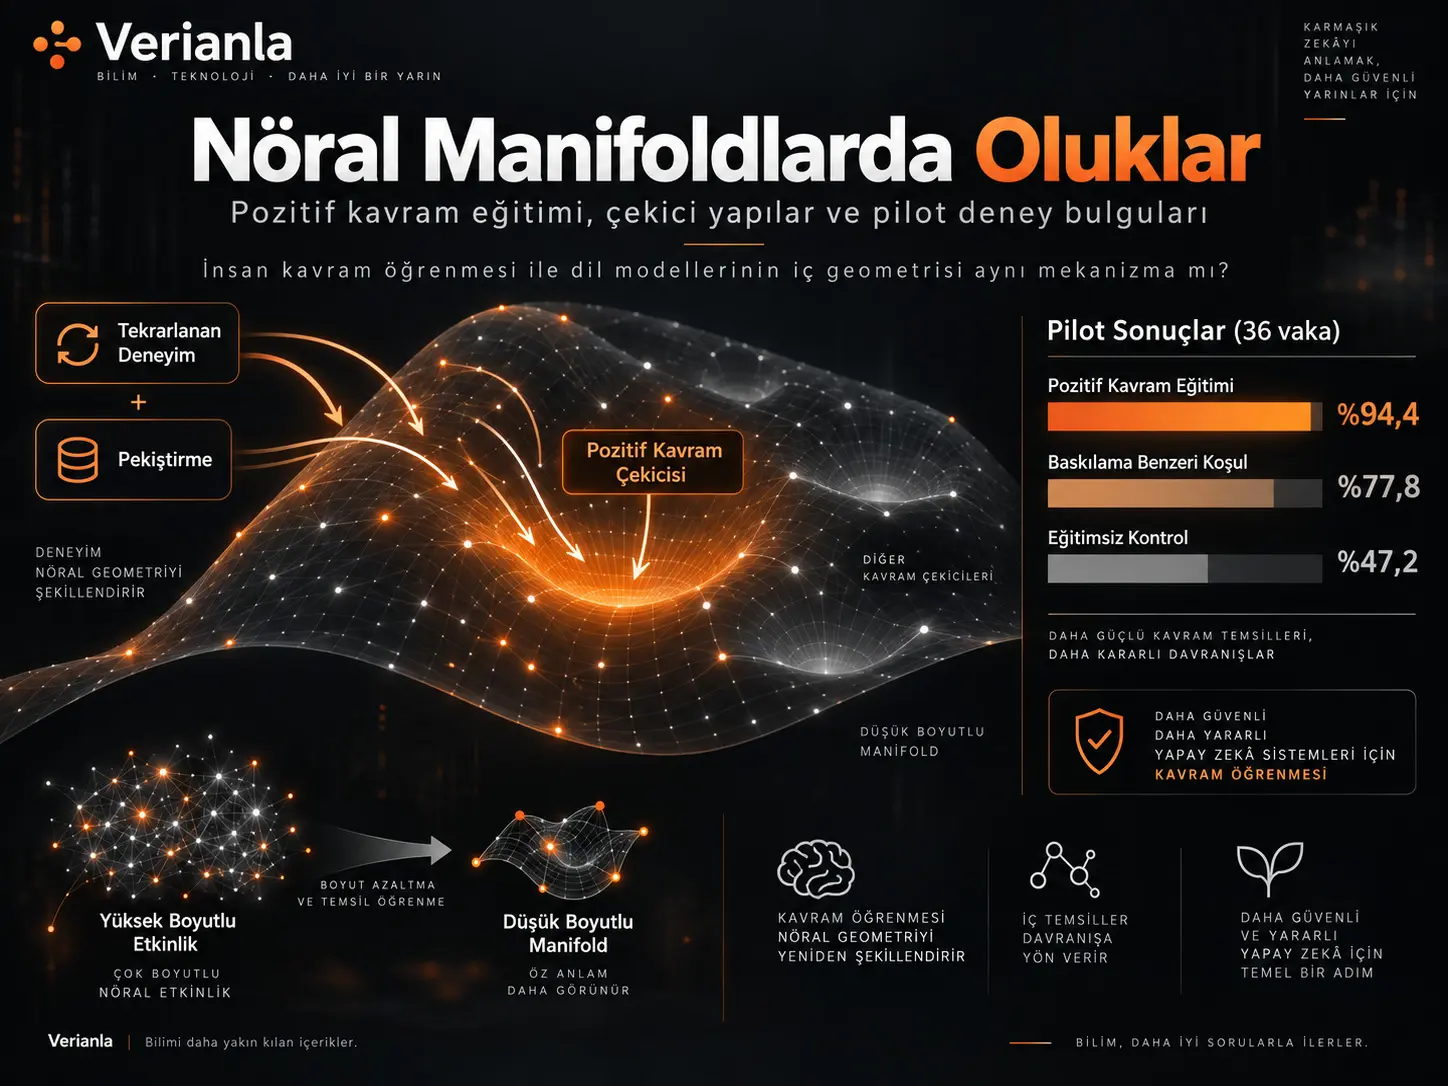
Nöral manifold, çok sayıdaki nöronun veya yapay ağ biriminin yüksek boyutlu etkinlik uzayında oluşturduğu davranışın, daha düşük boyutlu geometrik bir yüzey üzerinde düzenlendiğini ifade eden temsil yaklaşımıdır. Frederick Roth'un çalışması, insanlarda kavram öğrenimi ile eğitilmiş dil modellerindeki kavramsal temsillerin iki farklı mekanizma değil, pekiştirmeyle biçimlenen düşük boyutlu çekici yapının iki ölçekteki görünümü olduğu hipotezini savunmaktadır. Bu çerçevede kavramlar tek tek sembolik tanımlar halinde depolanmak yerine, benzer deneyimlerin tekrar tekrar etkinleştirdiği ve sistem durumunun geri dönme eğilimi gösterdiği yoğun geometrik bölgeler olarak ele alınmaktadır. Makale bu yaklaşımın yapay zekâ güvenliği için doğrudan bir sonucu olduğunu ileri sürer: istenmeyen davranışları yalnız bastırmak yerine istenen davranışın kendisini pozitif, adlandırılmış bir kavramsal çekici olarak eğitmek. Yazar bu yöntemi Concept Programming (CP) olarak adlandırmaktadır. 3 milyar parametreli Llama 3.2 üzerinde raporlanan pilotta CP, 36 governance-safety vakasında %94,4 doğruluk elde ederken negatif çerçeveli punishment-analog koşulu %77,8, eğitimsiz kontrol %47,2 doğruluk göstermiştir. Bununla birlikte punishment-analog koşulu gerçek üretim ölçekli RLHF değildir; çalışma CP'nin RLHF'yi doğrudan deneysel olarak geçtiğini göstermemektedir. Ayrıca raporlanan davranışsal sonuçlar manifold geometrisinin doğrudan ölçümü değildir. Çalışmanın temel insan–AI mekanizma özdeşliği hipotezi bu nedenle ilgi çekici ve yanlışlanabilir, ancak henüz yerleşik bir bilimsel sonuç değildir.
Makale, kendi kapsamını özellikle sınırlı tanımlamaktadır. Yazar bu metnin kitabın ve iki teknik companion çalışmanın kısa özeti olduğunu ve burada aktarılan iddiaların birincil kaynağının bu 7 sayfalık makale olmadığını açıkça belirtmektedir. Tam deney protokolleri, ek sonuçlar ve kod başka çalışmalara bırakılmıştır.
Bu ayrım önemlidir; çünkü çalışma bir tarafta bilişsel bilim, Hebb tipi hücre toplulukları, kategori öğrenimi ve attractor ağlarını tek bir geometrik anlatı altında birleştirirken diğer tarafta küçük ölçekli pilot deneylerden yapay zekâ hizalama mimarisi için daha geniş teorik sonuçlar çıkarmaktadır. Verianla açısından doğru yaklaşım, bu sonuçları “kanıtlanmış genel yapay zekâ güvenliği yasası” olarak değil, açık deneysel sınırları bulunan bir araştırma programının başlangıç kanıtları olarak sunmaktır.
Nöral Manifold Nedir?
Nöral manifold, çok yüksek boyutlu bir nöral etkinlik uzayındaki sistem durumlarının gerçekte çok daha düşük boyutlu düzenli bir yüzey üzerinde yoğunlaşması fikridir; bu yaklaşımda temsil edilen bilgi tek tek nöronların sabit anlamlarında değil, sistem etkinliğinin bu geometrik yüzey üzerindeki konumu ve hareketinde kodlanır.
Bir sinir ağı milyonlarca veya milyarlarca ayrı parametreye sahip olabilir. Buna rağmen belirli bir görev sırasında oluşan etkinlik örüntülerinin bütün olası yüksek boyutlu durum uzayını kullanması gerekmez. Aktivasyonların belirli yönlerde yoğunlaşması halinde sistem davranışı düşük boyutlu bir geometrik yapı üzerinde açıklanabilir.
Kaynağın kavramsal yaklaşımında kategori üyeliği de bu geometrik yapı üzerinden anlaşılır. Bir örnek belirli bir kategorinin “içinde” veya “dışında” olmak zorunda değildir; manifold üzerindeki konumu kategori bölgesine farklı derecelerde yakın olabilir. Böylece tipik ve atipik kategori üyelerinin farklı hız veya güvenle tanınması gibi dereceli davranışların açıklanabileceği savunulmaktadır.
Kategori üyeliği neden derecelidir?
Kaynak Eleanor Rosch'un kategori araştırmalarına dayanarak günlük kavramların çoğunda üyeliğin tamamen ikili olmadığını vurgulamaktadır. Bazı örnekler kategoriye daha tipik görünürken bazıları sınırda kalabilir. Manifold yaklaşımında bunun nedeni kavramın katı bir sembolik koşullar listesi değil, geometrik bir bölge olarak ele alınmasıdır.
Wittgenstein'ın “aile benzerliği” yaklaşımı da bu bağlama yerleştirilmektedir. Bir kategorideki bütün örneklerin paylaşmak zorunda olduğu tek bir ortak özellik bulunmayabilir; kategori birliğini sağlayan şey, örneklerin özelliklerinin örtüşerek oluşturduğu bölgesel yapı olabilir.
Çekici Yapı Nedir ve Kavram Öğrenmeyle Nasıl İlişkilendiriliyor?
Çekici yapı (attractor), sistem etkinliğinin belirli bir bölgeye doğru yönelme ve küçük sapmalardan sonra yeniden aynı bölgeye dönme eğilimini ifade eder. Kaynak, öğrenilmiş kavramların tek bir sabit nöral devreden çok, sınırları dereceli olan kararlı ve yoğun manifold bölgeleri şeklinde düşünülebileceğini savunmaktadır.
Donald Hebb'in hücre topluluğu kavramı bu anlatıya tarihsel temel olarak dahil edilmektedir. Hebb, birlikte tekrar tekrar etkinleşen hücre gruplarının zamanla birlikte çalışabilen bir işlevsel birim oluşturabileceğini öne sürmüştür.
Roth bu fikri geometrik bir dille yeniden yorumlar: hücre topluluğu belirli üyelerden oluşan değişmez bir liste olmak yerine, etkinliğin tekrar tekrar yoğunlaştığı bir manifold bölgesi gibi düşünülebilir.
Bu modelde pekiştirme yalnız belirli bir çıktıyı ödüllendiren olay değildir. Tekrarlanan etkinliğin sistemin durum uzayında belirli yolları ve bölgeleri daha kolay erişilebilir hale getirdiği bir geometrik biçimlenme mekanizması olarak yorumlanmaktadır.
“Groove” yani oluk benzetmesi ne anlama geliyor?
Çalışmanın ve kitabın başlığındaki “groove” sözcüğü bu tekrarlı kullanım fikrini ifade eder. Bir davranış veya kavramsal örüntü tekrar tekrar etkinleştikçe sistemin aynı etkinlik bölgesine yeniden ulaşması daha kolay hale gelir.
Bu bir fiziksel oluk bulunduğu anlamına gelmez. Kaynağın kullandığı geometrik metafor, öğrenilmiş davranışların yüksek boyutlu etkinlik uzayındaki tercihli yollar veya kararlı bölgeler şeklinde temsil edilebileceği varsayımını anlatmaktadır.
Bir kavram neden tek bir manifoldla sınırlı görülmüyor?
Kaynak, algısal veya motor bir becerinin tek bir temsil alanında ele alınabileceğini; daha geniş kavramların ise farklı modaliteleri birleştirmesi gerektiğini savunur. Örneğin “köpek” kavramı görsel biçim, ses, hareket ve başka deneyim türlerini aynı kavramsal yapı içinde ilişkilendirir.
Bu durumda ayrı deneyim alanlarının ortak yapısının nasıl birleştirildiği sorusu ortaya çıkar. Roth burada Hayes-Roth ve McDermott'un 1978 tarihli interference matching yaklaşımını kullanmaktadır.
Interference Matching Nedir?
Interference matching, bir kavrama ait birden fazla örneğin etkinleştirdiği özellik yapılarını üst üste getirerek bu örnekler arasında tekrar eden ortak yapının ayrıştırılması yaklaşımıdır; kaynak bunu farklı deneyimlerden daha genel bir kavramsal soyutlama oluşturmanın mekanizması olarak ele almaktadır.
Kaynağın ifadesiyle işlem, her örneğin etkinleştirdiği öğeler kümelerinin kesişimini hesaplamaya biçimsel olarak benzetilebilir. Tek bir örnekte tesadüfi veya bağlama özgü olan özellikler tekrarlar arasında kaybolurken, ortak özellik kombinasyonları güçlenir.
Roth bu yaklaşımı sembolik bir şema veya tek prototip depolamak yerine, birlikte ortaya çıkan özellik kombinasyonlarına ilişkin dereceli belleğin oluşması şeklinde yorumlamaktadır.
Yeni bilgi yapısı kullanım sırasında nasıl değişiyor?
Kaynak Barbara Hayes-Roth'un 1977 çalışmasında bildirilen üç aşamalı transfer eğrisini ayrı biçimde belirtmektedir:
- Başlangıç kolaylaştırması: yeni oluşan bilgi yapısı belirli görevlerde başlangıç avantajı sağlar.
- Recovery aşaması: ortak alt bileşenlerin konsolidasyon sırasında birbirleriyle rekabet ettiği dönem ortaya çıkar.
- Asimptotik aşama: bilgi yapısı daha kararlı hale gelir.
Yazar, bu üç-aşamalı bulgunun Barbara Hayes-Roth'a ait olduğunu özellikle ayırmakta; property-set modelinin ise Frederick Hayes-Roth'un 1974 çalışmasından başlayıp daha sonra birlikte geliştirilmiş farklı bir tarihçeye sahip olduğunu belirtmektedir.
Sembolik Bağlama Problemi Nedir?
Sembolik bağlama problemi, bir sembolik sistemin soyut değişkenlerdeki rollerin sahnedeki gerçek nesnelere nasıl atanacağını belirlemesi gerektiğinde ortaya çıkan kombinatoryal eşleştirme problemidir. Kaynak, manifold temsillerinin bu problemi daha hızlı “çözdüğünü” değil, değişken–değer bağlama gerektiren temsil biçimini baştan kullanmayarak problemin kendisini ortadan kaldırdığını savunmaktadır.
Sembolik bir sistem bir ilişkiyi örneğin şöyle temsil edebilir:
above(block-A, block-B)
Genel bir kural farklı nesnelere uygulanacaksa sistem hangi nesnenin hangi değişken rolünü doldurduğunu belirlemelidir. Nesne ve ilişki sayısı arttıkça olası eşleştirmelerin sayısı büyüyebilir.
Kaynak bu problemi Hayes-Roth ve McDermott'un 1978'de yapısal örüntü öğrenme açısından belirlediği temel pratik engellerden biri olarak sunmaktadır.
Manifold Yaklaşımı Bağlama Problemini Nasıl “Ortadan Kaldırıyor”?
Roth'un önerisinde ilişkiler adlandırılmış değişkenlere nesne atayarak değil, manifoldlar arasındaki göreli konum, mesafe veya ortak etkinlik örüntüsüyle temsil edilebilir; böylece değişken–değer bağlama aramasına ihtiyaç kalmaz ve tanıma işlemi öğrenilmiş çekici yapıya karşı örüntü tamamlama problemi olarak yeniden tanımlanır.
Bu önemli bir teorik ayrımdır. Makale “NP-zor bir bağlama problemini daha hızlı çözen yeni algoritma” önermemektedir. Bunun yerine o problem sınıfını üreten sembolik temsil varsayımının gereksiz olabileceğini ileri sürmektedir.
Ancak bu sonuç çalışmada büyük dil modellerinin iç aktivasyonlarından türetilen kapsamlı bir bağlama deneyiyle gösterilmemektedir. Kaynak burada teorik bir temsil argümanı kurmaktadır.
İnsan Kavram Öğrenmesi ile Dil Modellerinin İç Geometrisi Aynı Mekanizma mı?
Bu makalenin temel tezi “evet” yönündedir, ancak kaynak bunu yerleşik bir bilimsel gerçek olarak değil yanlışlanabilir bir birleştirme iddiası olarak geliştirmektedir. İnsan kavram öğrenmesinin davranışsal literatürü ile yapay sinir ağlarındaki düşük boyutlu temsil geometrisinin aynı temel çekici mekanizmayı yansıttığı savunulur; bu mekanizmaların biyolojik ve yapay sistemlerde gerçekten özdeş olduğunu doğrudan gösteren ortak deney ise bu makalede bulunmamaktadır.
Bu nedenle iki farklı kanıt düzeyi birbirinden ayrılmalıdır.
| İddia | Bu makaledeki statüsü |
|---|---|
| Kavram üyeliği dereceli olabilir. | Önceki bilişsel bilim literatürüne dayanan arka plan. |
| Sinir ağlarında düşük boyutlu temsil yapıları oluşabilir. | Makalenin referans verdiği çağdaş interpretability literatüründen hareket edilen arka plan. |
| İnsan kavram öğrenimi ve dil modeli kavram geometrisi aynı mekanizmadır. | Yazarın birleştirici teorik hipotezi. |
| Bu mekanizma attractor-based Concept Programming'i mümkün kılar. | Teoriden türetilen uygulanabilir araştırma hipotezi. |
| Pilot CP eğitimi belirli safety testlerinde daha yüksek doğruluk verdi. | Kaynakta raporlanan davranışsal deney sonucu. |
Concept Programming Nedir?
Concept Programming (CP), bir yapay zekâ sisteminde istenmeyen çıktıyı yalnız cezalandırmak veya filtrelemek yerine, istenen davranışsal kavramı adlandırılmış pozitif bir çekici olarak eğitip gerektiğinde istenmeyen alternatifin ortaya çıkmasını engelleyecek bir cevap örüntüsüyle eşleştirmeyi amaçlayan davranış eğitimi yaklaşımıdır.
Kaynak CP'yi operant conditioning'deki “punishment” ile “inhibitory learning” ayrımına benzetmektedir.
Yazarın modelinde suppression yaklaşımı, istenmeyen davranışı gerçekleştikten veya ortaya çıkmaya başladıktan sonra cezalandırır. Pozitif kavram eğitimi ise istenen alternatif davranışın kendisini daha erişilebilir bir temsil haline getirmeyi amaçlar.
CP'de bir yasak kavramı yalnız “bunu yapma” biçiminde tanımlanmaz. Kavramın neyi temsil ettiği ve hangi karşı davranışın etkinleşmesi gerektiği pozitif biçimde eğitilir.
Çalışma Concept Programming'in RLHF'den Daha İyi Olduğunu Kanıtlıyor mu?
Hayır. Kaynağın deneyinde Concept Programming, üretim ölçeğinde gerçek RLHF fine-tuning ile karşılaştırılmamıştır. Karşılaştırılan ikinci koşul, negatif çerçeveli prompting kullanılarak oluşturulan ve yazarın “punishment-analog” olarak tanımladığı küçük ölçekli suppression analoğudur; dolayısıyla sonuç “CP bu punishment-analog pilot koşulundan daha başarılıydı” şeklinde okunmalıdır.
Bu sınır kaynakta açık biçimde kabul edilmektedir. Yazar full RLHF karşılaştırmasını ve adversarial jailbreak testlerini gelecekte yapılması gereken deneyler arasında saymaktadır.
Bu nedenle aşağıdaki iki cümle eşdeğer değildir:
Kaynağın desteklediği: “Pozitif kavram eğitimi bu pilotta punishment-analog koşulundan daha yüksek doğruluk verdi.”
Kaynağın desteklemediği: “Concept Programming, RLHF'den genel olarak daha güvenlidir ve bunu deneysel olarak kanıtlamıştır.”
Çalışmanın Yöntemi ve Bulguları
Araştırma yapısı
Bu 7 sayfalık çalışma deneylerin tam teknik raporu değildir. Kaynak üç deney grubunun sonuçlarını özetlemekte ve ayrıntılı protokol, kod ve ek sonuçlar için iki companion makaleye yönlendirmektedir.
Ana safety pilotu:
- 3 milyar parametreli açık ağırlıklı Llama 3.2 modeli,
- Ollama üzerinden yerel çalıştırma,
- pozitif concept training,
- punishment-analog prompting,
- eğitimsiz kontrol
olmak üzere üç koşul içermektedir.
Governance-safety pilot sonucu
| Koşul | 36 governance-safety vakasında doğruluk |
|---|---|
| Pozitif Concept Programming | %94,4 |
| Punishment-analog | %77,8 |
| Eğitimsiz kontrol | %47,2 |
Kaynak Fisher's exact test için p<0,0001 bildirmektedir.
Bu sonuç pilotun en doğrudan davranışsal kanıtıdır. Test setinin bütün örnekleri ve prosedürün tam ayrıntısı ise bu özet makalede bulunmamaktadır.
Yeni alanlara transfer
Pozitif kavram modeli üç yeni operasyon alanında değerlendirilmiştir.
| Yeni alan | Kaynakta raporlanan sonuç |
|---|---|
| Hastane operasyonları | Alan-özel eğitim almadan doğruluk kaybı bildirilmemiştir. |
| Depo operasyonları | Alan-özel eğitim almadan doğruluk kaybı bildirilmemiştir. |
| İnşaat sahası güvenliği | Doğruluk %66,7'ye düşmüştür. |
Yazar inşaat güvenliğindeki düşüşü daha uzmanlaşmış ve değişken terminolojiyle tutarlı bir sonuç olarak yorumlamaktadır.
Ancak üç alanın yalnız bu pilot kapsamındaki sonuçları bulunduğu için CP'nin bütün yeni alanlara kayıpsız transfer yaptığı sonucuna ulaşılamaz.
Sosyal baskı altında kısıt koruma
Kaynak, prompt'un modele açık veya örtük sosyal baskı uyguladığı test vakalarını özellikle önemli görmektedir.
| Koşul | Kısıtı koruma |
|---|---|
| Pozitif concept model | %92,6 |
| Eğitimsiz kontrol | %44,4 |
Yazar bu farkı pozitif kavram modelinde baskıya direnebilen iç temsil oluştuğuna dair destek olarak yorumlamaktadır.
Bununla birlikte bu deneyde “iç temsil” doğrudan manifold geometrisi ölçümüyle gösterilmemiştir. Ölçülen sonuç davranışsal kısıt uyumudur; iç temsil açıklaması teorik yorum katmanıdır.
Pozitif Kavram Eğitimi Yeni Durumlara Neden Aktarılabilir?
Kaynağın teorisine göre pozitif kavram eğitimi tek tek yasak cümleleri ezberletmek yerine kavramın daha geniş ifade alanını kapsayan bir çekici havza oluşturmayı hedeflediği için, aynı kavram farklı kelimeler veya farklı operasyon bağlamlarıyla ortaya çıktığında sistemin tekrar aynı davranış bölgesine yönelmesi beklenir. Bu aktarım mekanizması teorik açıklamadır; pilotta iki yeni alanda güçlü aktarım gözlenmiş, üçüncü alanda ise belirgin performans kaybı oluşmuştur.
İkinci deney: değer kavramının eğitimi
İkinci deney safety constraint yerine kültürel değer kavramını değerlendirmektedir.
Tek bir Budist etik çerçevesine karşılık gelen adlandırılmış değer kavramı, senaryo-özel örnekler kullanılmadan eğitilmiştir.
Model daha sonra beş standart moral-psychology vakasında değerlendirilmiştir:
- trolley senaryosu,
- footbridge varyantı,
- Heinz-tipi ikilem,
- ağlayan bebek senaryosu,
- whistleblower vakası.
Kaynak, eğitilen modelin beş vakanın tamamını geçtiğini ve aynı pilotta test edilen diğer geleneklerden hiçbirinin senaryo-özel eğitim olmadan aynı sonucu yakalamadığını bildirmektedir.
Diğer geleneklerin ayrıntılı skorları ve tam eğitim protokolü bu özet çalışmada verilmemektedir.
Üçüncü deney: eğitim maliyeti
Üçüncü deney, Concept Programming'in kaç eğitim örneğinde güvenlik hatalarını azaltmaya başladığını governance-adapted signal detection çerçevesiyle değerlendirmektedir.
İki eğitim yaklaşımı karşılaştırılmıştır:
| Eğitim yaklaşımı | Kaynakta tanımlanan özellik |
|---|---|
| Geniş örnekleme | Kavramın doğal ifade aralığının daha geniş bölümünden örnekler kullanır. |
| Dar örnekleme | Kavramın en sık kullanılan ifadelerine yoğunlaşır. |
Her iki yöntem de eğitimsiz kontroldeki %100 miss rate'i 200 eğitim vakası içinde %25'in altına indirmiştir.
Bununla birlikte kaynakta önceden belirlenen %95 stopping criterion'a 200 vaka bütçesi içinde ulaşılamadığı açıkça belirtilmektedir.
Geniş örnekleme yaklaşımı daha yüksek correct-rejection rate verirken, dar örnekleme daha yüksek hit rate üretmiştir.
Yazar bu karşıtlığı farklı eğitim örneklemelerinin farklı attractor geometrileri oluşturacağı beklentisiyle uyumlu görmektedir. Bu geometrik açıklama doğrudan manifold ölçümü değil, sonuçların teori çerçevesindeki yorumudur.
Kitabın Güven Etiketleri Neden Önemli?
Kaynakta özetlenen kitap, yerleşik ampirik sonuç, kısmi destek, pilot deney sonucu ve yazar beklentisi gibi farklı epistemik seviyeleri aynı kesinlikte yazmamak amacıyla altı güven etiketi kullanan bir raporlama sistemi benimsemektedir. Bu yaklaşım özellikle geniş teorik sentez ile küçük ölçekli pilot sonuçların birbirine karıştırılmasını önlemeyi amaçlar.
Kaynak örnek olarak şu kategorileri açıklar:
| Etiket | Anlamı |
|---|---|
| Established | Yerleşik ampirik literatür tarafından desteklenen sonuç. |
| Well supported | Gerçek fakat henüz tam olmayan destek. |
| Our experiments show | Yazarın kendi deneyinden gelen ve örneklem büyüklüğüyle birlikte verilmesi gereken sonuç. |
| I expect | Bilgiye dayalı fakat deneysel olarak yerleşmemiş beklenti. |
| I suspect | Daha düşük güven düzeyindeki teorik yargı. |
| What would change my mind | İddianın yanlışlanmasına yol açacak kanıtın açık biçimde belirtilmesi. |
Bu 7 sayfalık makale aynı etiket sistemini biçimsel olarak her cümlede kullanmasa da yazar, pilot sonuç ile daha geniş teori arasındaki farkı metin boyunca özellikle belirtmeye çalışmaktadır.
Bu Teoriyi Hangi Bulgular Yanlışlayabilir?
Kaynak, teorinin temel iddialarını yanlışlanabilir olarak sunmaktadır. Özellikle gelecek interpretability araştırmaları dil modellerindeki kavramların düşük boyutlu attractor manifoldları yerine gerçekten ayrık, sembol-benzeri yapılar ve kombinatoryal variable binding üzerinden işlendiğini gösterirse insan kavram öğrenimi ile dil modeli geometrisinin aynı mekanizma olduğu merkezi iddia doğrudan yanlışlanmış olacaktır.
Kaynakta belirtilen başlıca sınama noktaları
Birinci sınır, çalışmanın en geniş unification claim'idir. Dil modellerinin kavram öğrenimi gelecekte tamamen farklı bir mekanizmayla açıklanırsa teori yalnız eksik değil, temel düzeyde yanlış olacaktır.
İkinci sınır, framework içindeki daha zayıf destekli bir iddiadır: belirli bilişsel düzeylerin kendi işlem birimi başına yaklaşık sabit hızla çalıştığı varsayımı. Kaynak bazı sinir yollarında bunun ölçüldüğünü ancak diğerlerinde varsayıldığını kabul eder.
Aynı bilişsel düzey içinde işlem hızının sistematik biçimde değiştiği gösterilirse bu iddia doğrudan zarar görecektir.
Üçüncü pratik sınama, Concept Programming'in gerçek RLHF ve production-scale suppression yöntemleriyle doğrudan karşılaştırılmasıdır.
Dördüncü sınama ise adversarial jailbreak yeniden ifade etmeleridir. Kaynak CP'nin bu saldırılara suppression yöntemlerinden daha dirençli olması gerektiğini öngörmektedir, ancak ilgili test henüz yapılmamıştır.
Çalışmanın desteklediği sonuçlar
- 3B Llama 3.2 modelindeki pilotta pozitif concept training, punishment-analog ve eğitimsiz kontrol koşullarından daha yüksek governance-safety doğruluğu vermiştir.
- Kaynakta 36 vakalık karşılaştırma için %94,4, %77,8 ve %47,2 doğruluk oranları bildirilmiştir.
- Pozitif concept model iki yeni operasyon alanına doğruluk kaybı olmadan aktarılmış, üçüncü alanda %66,7'ye düşmüştür.
- Sosyal baskı içeren vakalarda pozitif kavram koşulu eğitimsiz kontrolden daha yüksek kısıt uyumu göstermiştir.
- Bir Budist etik değer kavramı pilotta beş moral-psychology vakanın tamamını geçmiştir.
- İki CP eğitim stratejisi 200 eğitim vakası içinde miss rate'i %100'den %25'in altına indirmiştir.
- Kaynak manifold ve attractor geometrisini Concept Programming'in teorik açıklama çerçevesi olarak kullanmaktadır.
Çalışmanın desteklemediği sonuçlar
- Concept Programming'in üretim ölçekli RLHF'den üstün olduğu doğrudan gösterilmemiştir.
- Punishment-analog prompting ile gerçek RLHF aynı deneysel koşul değildir.
- Frontier ölçekli modellerde aynı sonucun ortaya çıkacağı gösterilmemiştir.
- Adversarial jailbreak saldırılarına karşı üstün dayanıklılık henüz test edilmemiştir.
- Davranışsal doğruluk artışı tek başına model içinde ölçülmüş bir attractor manifoldunun varlığını kanıtlamaz.
- İnsan kavram öğrenimi ile dil modeli temsillerinin biyolojik ve hesaplamalı olarak özdeş olduğu bu makalede doğrudan gösterilmemiştir.
- İnşaat alanındaki %66,7 sonuç tüm yeni alanlara kusursuz transfer olmadığını göstermektedir.
- Beş moral senaryodaki başarı geniş kültürel değer uyumunun evrensel doğrulaması değildir.
Temel yöntemsel sınırlılıklar
Bütün uygulamalı sonuçlar tek bir 3 milyar parametreli modelden gelmektedir.
Kaynak herhangi bir deployed frontier modelde deney raporlamamaktadır.
Punishment-analog koşulu gerçek RLHF fine-tuning değildir.
Jailbreak tipi adversarial testler yapılmamıştır.
Bu özet çalışma deneylerin tam protokolünü içermez; ayrıntılar companion makalelere bırakılmıştır.
Attractor geometrisi deneylerin davranışsal çıktısından çıkarılan teorik mekanizma olarak yorumlanmakta, burada doğrudan aktivasyon uzayı analiziyle doğrulanmamaktadır.
Çıkar çatışmasının yorumlanması
Yazar, Concept Programming'de kullanılan concept-instillation mimarisiyle ilgili patent başvuruları bulunduğunu beyan etmektedir.
Bu durum sonuçların otomatik olarak geçersiz olduğu anlamına gelmez; ancak yöntemin değerlendirilmesinde bağımsız replikasyonun özellikle önemli olduğunu gösteren ilgili bir çıkar bağlamıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Grooves in Neural Manifolds: A Summary of the Argument and the Experimental Evidence
Yazar: Frederick Roth
Kaynakta belirtilen görev: Professor, Information Sciences, Naval Postgraduate School (Retired)
Kaynakta belirtilen üyelik: Fellow, Association for the Advancement of Artificial Intelligence
Kaynak türü: Teorik/kavramsal sentez ve companion deney sonuçlarının özet makalesi.
Birincil kaynak statüsü: Yazar, bu makalenin kendi iddialarının birincil kaynağı olmadığını açıkça belirtmektedir.
Dergi / cilt / sayı: Yüklenen PDF'de belirtilmemiştir.
Makalenin DOI'si: Yüklenen PDF'de belirtilmemiştir.
Hakemlik durumu: Yüklenen PDF içinde hakemli yayın olduğunu doğrulayan bilgi yoktur; hakemli nihai makale olarak sunulmamalıdır.
Merkezi teorik iddia: İnsan kavram öğreniminin ve eğitilmiş dil modellerindeki kavramsal geometrinin, pekiştirmeyle biçimlenen düşük boyutlu attractor yapının iki farklı ölçekteki görünümü olduğu hipotezi.
Merkezi uygulamalı yöntem: Concept Programming (CP).
Pilot model: Llama 3.2, 3 milyar parametre, yerel Ollama çalıştırması.
Governance-safety testi: 36 vaka.
Ana pilot sonuç: Pozitif concept training %94,4; punishment-analog %77,8; eğitimsiz kontrol %47,2; Fisher's exact test p<0,0001.
Transfer: Hastane ve depo operasyonlarında kaynak doğruluk kaybı bildirmemektedir; inşaat sahası güvenliğinde %66,7.
Sosyal baskı testi: Pozitif concept model %92,6; eğitimsiz kontrol %44,4 kısıt koruma.
Değer kavramı deneyi: Tek Budist etik değer kavramıyla beş moral-psychology senaryosunun beşi de geçilmiştir.
Eğitim maliyeti deneyi: İki eğitim yöntemi de 200 vaka içinde miss rate'i %100'den %25'in altına indirmiş, ancak önceden belirlenen %95 stopping criterion'a ulaşmamıştır.
Kitap: Grooves in Neural Manifolds: AI Reveals Why You Think What You Think, and How to Reshape It.
Kitap DOI'si: 10.5281/zenodo.21966428.
Teknik companion çalışma 1: Concept Programming for Dependable AI.
Teknik companion çalışma 2: Neural manifolds, assemblies, and cross-domain interference.
Kod: Kaynak, companion deneylerin kodunun github.com/ricodoco/safety-concept-experiment adresinde kamuya açık olduğunu belirtmektedir.
Çıkar çatışması: Yazar concept-instillation mimarisine ilişkin patent başvuruları bulunduğunu bildirmektedir.
Finansman: Bu özet PDF'de ayrı finansman beyanı bulunmamaktadır.
Veri erişilebilirliği: Bu özet PDF'de ayrı bir veri erişilebilirliği bölümü bulunmamaktadır; deney protokolleri ve kod için companion çalışmalara yönlendirme yapılmaktadır.
Temel bilimsel yorum sınırı: Pilotun davranışsal performans sonuçları doğrudan raporlanmıştır; insan bilişi ile dil modeli geometrisinin aynı mekanizma olduğu iddiası ve performansın attractor geometrisinden kaynaklandığı açıklaması teorik framework'ün parçasıdır. Ayrıca punishment-analog koşulu gerçek RLHF olmadığından pilot sonucu RLHF'ye doğrudan üstünlük olarak sunulmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir