

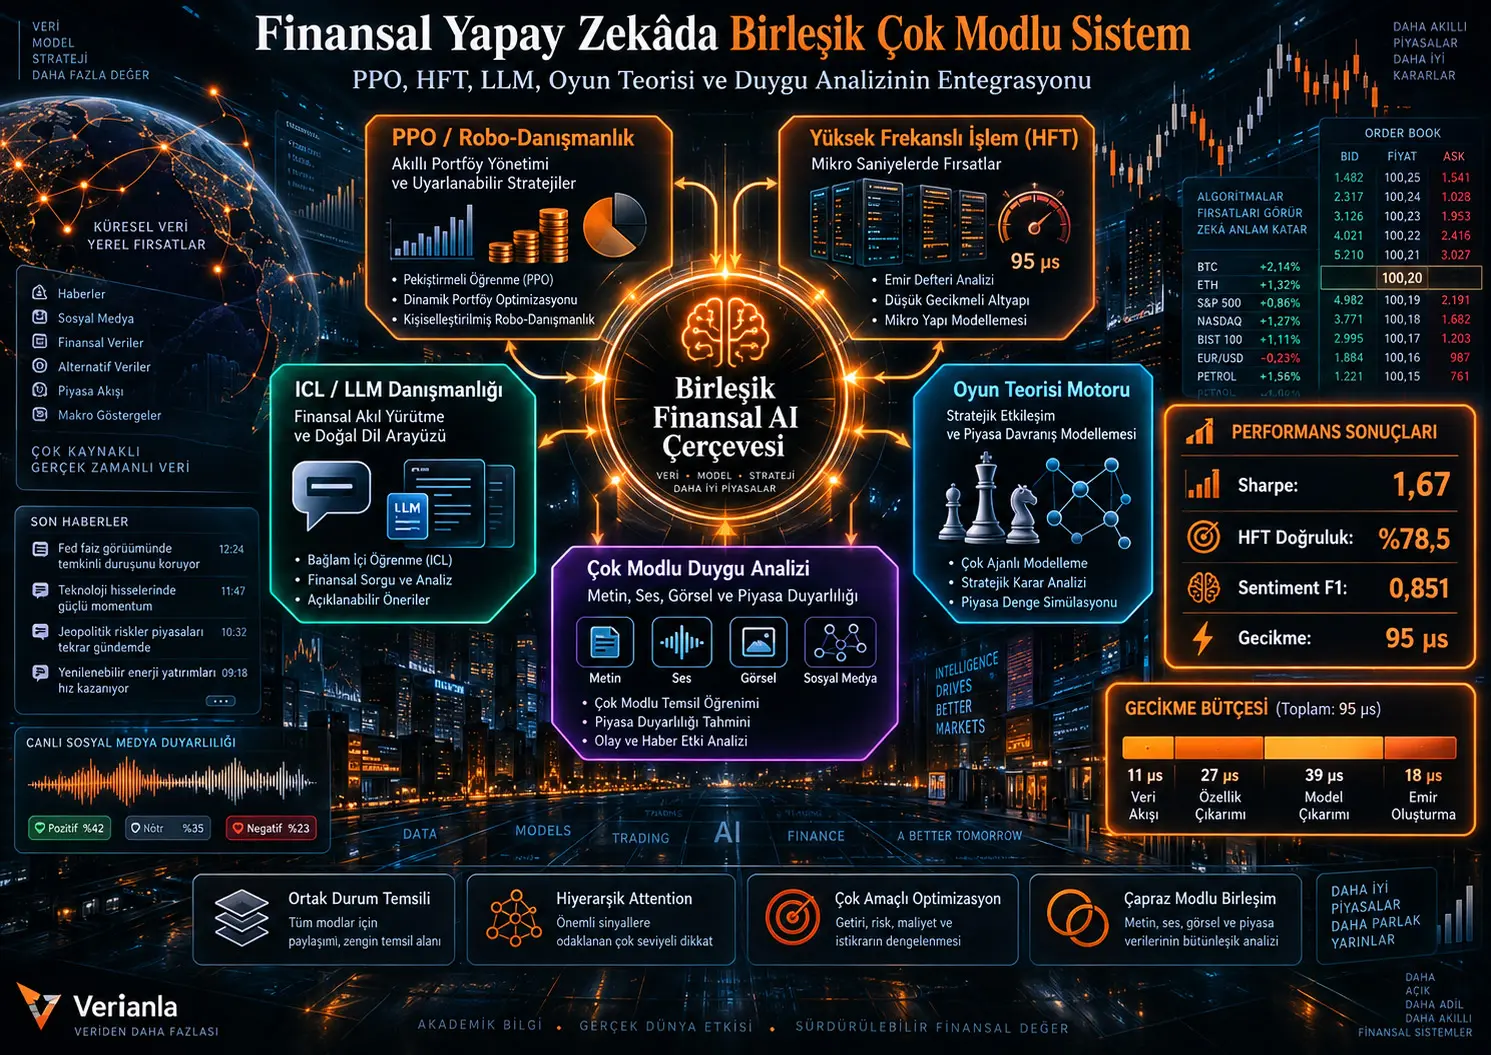
Finansal yapay zekâ sistemleri çoğunlukla birbirinden ayrı problemler için geliştirilir: bir model portföy dağılımını optimize eder, başka bir model yüksek frekanslı fiyat hareketlerini tahmin eder, dil modeli yatırım sorularını yanıtlar, oyun teorisi rakip kurumların davranışlarını inceler ve ayrı bir sentiment modeli haber veya şirket açıklamalarını analiz eder. Bu çalışma, söz konusu parçalı yapının yerine beş farklı finansal yapay zekâ bileşenini ortak durum temsili ve çok amaçlı optimizasyon altında birleştiren bütünleşik bir mimari önermektedir.
Sistemin beş temel bileşeni Proximal Policy Optimization (PPO) tabanlı robo-danışmanlık, multi-scale Temporal Convolutional Network ile yüksek frekanslı işlem tahmini, retrieval-augmented in-context learning tabanlı yatırım danışmanlığı, rekabetçi finansal davranışları modelleyen oyun teorisi motoru ve metin, ses ile finansal grafiklerden bilgi çıkaran çok modlu sentiment analizidir. Bileşenler bağımsız çıktılar üretmek yerine ortak bir state representation üzerinden bilgi paylaşır. Hierarchical attention mekanizması piyasa koşullarına göre hangi bileşenin daha fazla ağırlık alacağını belirler; öğrenilebilir görev ağırlıkları ve gradient-conflict yönetimi ise ortak eğitimi düzenler.
Kaynak deneylerinde birleşik sistem için 1,67 Sharpe oranı, −%8,9 maksimum drawdown, %78,5 yüksek frekanslı yön tahmin doğruluğu ve 0,851 sentiment F1 değeri raporlanmaktadır. HFT yolunun toplam wire-to-order gecikmesi 95 µs olarak ölçülmüş; bunun 11 µs'si veri akışının ayrıştırılmasına, 27 µs'si özellik çıkarımına, 39 µs'si model inference'a ve 18 µs'si emir oluşturma ile FIX 4.4 serileştirmesine ayrılmıştır.
Bununla birlikte sonuçların yorumunda bazı sınırlamalar bulunmaktadır. Makaledeki bazı üst düzey yüzde iyileşmelerin hangi baseline üzerinden hesaplandığı tablolar kullanılarak tam olarak yeniden üretilememektedir. FI-2010 benchmark karşılaştırması prediction horizon ve deney kurulumu bakımından daha ayrıntılı eşleştirme gerektirir. Ayrıca gerçek finans kuruluşlarında yapıldığı belirtilen üç uygulama anonim kurumlara dayandığından bağımsız doğrulamaya açık değildir.
| Bileşen | Teknik yaklaşım | Temel görev |
|---|---|---|
| Robo-danışmanlık | PPO | Portföy dağılımı ve uzun dönem risk/getiri optimizasyonu |
| Yüksek frekanslı işlem | Multi-Scale TCN + cross-scale attention | Kısa vadeli fiyat ve yön tahmini |
| Yatırım danışmanlığı | ICL + RAG + LLM | Yeni müşteri ve piyasa bağlamlarına hızlı uyum |
| Stratejik rekabet | Diferansiyellenebilir oyun teorisi | Rakip davranışı ve Nash dengesi analizi |
| Duygu analizi | Text + Audio + Visual fusion | Finansal sentiment ve risk sinyali üretimi |
Neden tek bir finansal AI modeli yeterli görülmüyor?
Bir finansal karar yalnız fiyat geçmişine bağlı değildir. Portföy yöneticisi aynı anda piyasa hareketini, risk sınırlarını, haber akışını, rakip kurumların davranışını ve yatırımcının kendi hedeflerini değerlendirmek zorunda olabilir.
Geleneksel yapıda bu problemler ayrı sistemlere bölünür:
- portföy modeli varlık ağırlıklarını belirler,
- HFT modeli mikro-yapıyı izler,
- sentiment modeli haberleri analiz eder,
- LLM yatırımcıyla iletişim kurar,
- stratejik model rakip davranışını inceler.
Çalışmanın temel hipotezi, bu sistemlerin birbirinden tamamen bağımsız çalışmasının değerli bilgiyi kaybettirebileceğidir.
Örneğin sentiment modelinin algıladığı ani negatif haber yalnız uzun vadeli portföy sistemine değil, kısa vadeli HFT modeline de bilgi sağlayabilir. Rakip piyasa yapıcıların davranışını tahmin eden oyun teorisi motoru da kısa vadeli execution kararlarının riskini değiştirebilir.
Birleşik Finansal Yapay Zekâ Sistemi Nasıl Çalışıyor?
Çerçevenin merkezinde tüm alt sistemlerin kullanabildiği ortak bir durum uzayı bulunmaktadır:
\[ S= S_{market} \times S_{portfolio} \times S_{sentiment} \times S_{strategic} \times S_{context} \]
Bu yapı beş farklı bilgi sınıfını tek karar alanında birleştirir.
Piyasa durumu
Piyasa durumu:
\[ s_{market}^{t} = [p_t,v_t,b_t,a_t,\nabla p_t,\sigma_t^2,\rho_t] \]
şeklinde tanımlanmaktadır.
Burada:
- \(p_t\): varlık fiyatları,
- \(v_t\): işlem hacimleri,
- \(b_t,a_t\): çok seviyeli bid ve ask yapısı,
- \(\nabla p_t\): fiyat değişimleri,
- \(\sigma_t^2\): volatilite,
- \(\rho_t\): korelasyon yapısıdır.
Portföy durumu
Portföy alt uzayı mevcut ağırlıklar, getiri, Value-at-Risk, Conditional VaR, alpha, beta ve Sharpe oranı gibi risk ve performans bilgilerini taşır.
Sentiment durumu
Duygu bileşeni üç farklı veri tipini ortak embedding içinde birleştirir:
\[ s_{sentiment}^{t} = f_{fusion} (e_{text}^{t},e_{audio}^{t},e_{visual}^{t}) \]
Metin finansal haber veya raporlardan, ses özellikle şirket earnings call kayıtlarından, görsel bileşen ise finansal grafiklerden gelebilir.
Stratejik durum
Game-theory state rakiplerin gözlenen eylemlerini, tahmini Nash stratejilerini ve piyasa yapıcı/likidite sağlayıcı davranışlarını içerir.
Context durumu
LLM ve in-context learning için prompt temsilleri, örnek belleği ve adaptasyon parametreleri ayrı context state içinde saklanır.
Hiyerarşik Attention Neden Kullanılıyor?
Beş modülün her piyasa koşulunda eşit öneme sahip olması beklenmez. Çok yüksek volatilitede HFT ve sentiment bileşenleri daha kritik olabilirken uzun vadeli portföy yeniden dengelemesinde PPO modülü daha fazla ağırlık alabilir.
Çalışma bu önceliği:
\[ \alpha_i^t= \frac{ \exp(f_{priority}(s_i^t,M_t)) }{ \sum_{j=1}^{5} \exp(f_{priority}(s_j^t,M_t)) } \]
ile hesaplanan attention ağırlıklarıyla ifade etmektedir.
Böylece her modül için:
\[ 0<\alpha_i^t<1 \]
ve bütün ağırlıkların toplamı:
\[ \sum_{i=1}^{5}\alpha_i^t=1 \]
olur.
Bilgi aktarımı yalnız attention ağırlıklarıyla yapılmaz. GRU tabanlı gating mekanizması bir modülün diğer modüllerden hangi bilgileri kabul edeceğini de öğrenir.
Beş Farklı Amaç Aynı Anda Nasıl Optimize Ediliyor?
Ortak hedef:
\[ J(\pi) = \sum_{i=1}^{5} \lambda_iJ_i(\pi) + \gamma R_{synergy}(\pi) \]
şeklinde tanımlanır.
\(J_i\) her bileşenin kendi hedefini, \(\lambda_i\) öğrenilebilir görev ağırlığını, \(R_{synergy}\) ise alt modellerin birbirini engellemesini azaltmayı amaçlayan ortaklık terimini temsil eder.
Kaynak görev ağırlıklarını belirsizliğe dayalı olarak:
\[ \lambda_i= \frac{1}{2\sigma_i^2} \]
biçiminde öğrenir. Gürültüsü daha yüksek olan bileşenin ortak gradient üzerindeki etkisi böylece otomatik olarak azaltılabilir.
Gradient conflict nasıl ele alınıyor?
Farklı görevlerin gradient yönleri birbirine zıt olabilir. Örneğin bir parametre değişimi HFT tahminini geliştirirken sentiment modelini kötüleştirebilir.
Kaynak, gradient çiftlerinin cosine similarity değerini izler. Negatif conflict ortaya çıktığında PCGrad yaklaşımıyla çelişen gradient bileşeni projekte edilerek kaldırılabilir.
Bu mekanizmanın amacı çok görevli öğrenmede bir alt sistemin diğer alt sistemin eğitimini bozmasını azaltmaktır.
Yüksek Frekanslı İşlem Modülü Nasıl Çalışıyor?
HFT bileşeni Multi-Scale Temporal Convolutional Network kullanmaktadır.
Kaynak Appendix B'de beş zaman ölçeği tanımlar:
- 1 ms,
- 10 ms,
- 100 ms,
- 1 s,
- 10 s.
Her ölçek ayrı temporal convolution branch tarafından işlenir. Daha sonra cross-scale attention farklı zaman çözünürlükleri arasında bilgi paylaşımı sağlar.
Bu tasarımın amacı hem çok kısa süreli order-flow değişimlerini hem de birkaç saniyeye yayılan daha yavaş piyasa örüntülerini aynı tahmin içinde değerlendirmektir.
HFT objective
Yüksek frekanslı bileşenin amacı yalnız tahmin hatasını azaltmak değildir:
\[ J_{HFT} = - E_t \left[ \|p_{t+\delta}-\hat{p}_{t+\delta}\|^2 + \alpha TC(a_t) \right] \]
İkinci terim transaction cost'u temsil eder. Böylece fiyat tahmininin teorik doğruluğu ile işlemin ekonomik maliyeti aynı objective içinde değerlendirilebilir.
95 Mikrosaniyelik Karar Gecikmesi Neyi Kapsıyor?
Kaynakta raporlanan 95 µs yalnız sinir ağının tahmin süresi değildir. Wire-to-order toplam latency aşağıdaki dört parçadan oluşmaktadır:
| Aşama | Gecikme |
|---|---|
| Feed parsing | 11 µs |
| Feature extraction | 27 µs |
| Model inference | 39 µs |
| Order construction + FIX 4.4 | 18 µs |
| Toplam | 95 µs |
Test platformunda Intel Xeon Gold 6338, NVIDIA A100 40 GB, DPDK kernel-bypass networking ve ONNX Runtime + TensorRT kullanılmaktadır.
Bu ölçüm exchange tarafından emrin kabul edilmesi veya fill edilmesini kapsayan round-trip latency değildir; sistemin kendi girişinden emir çıktısına kadar olan yerel işlem yoludur.
LLM HFT yolunu neden yavaşlatmıyor?
ICL/LLM bileşeninin tek inference süresi yaklaşık 2,4 ms'dir ve 95 µs HFT bütçesinden çok daha uzundur.
Bu nedenle LLM synchronous şekilde HFT kararını bekletmez. En son advisory embedding lock-free ring buffer içinde tutulur ve HFT modeli mevcut en güncel embedding'i kullanır.
Böylece:
yavaş semantik analiz → asenkron güncelleme → hızlı HFT yolu
mimarisi oluşturulmuştur.
Çalışmanın Yöntemi ve Bulguları
Veri evreni
| Modül | Veri | Dönem / Frekans | Bölme |
|---|---|---|---|
| PPO | S&P 500, FTSE 100, Nikkei 225 | 2010–2024 / günlük | 60/20/20 |
| HFT | BTC/USDT, ETH/USDT, NASDAQ top-100 | 2022–2024 / tick | 70/15/15 |
| Sentiment | Earnings calls, FNSPID, X/Twitter | 2015–2024 / event | 70/15/15 |
| ICL | Anonim yatırım danışmanlığı logları | 2019–2024 / session | Leave-one-quarter-out |
| Game theory | FDIC call reports | 2014–2024 / quarterly | Cross-validation |
HFT bölmelerinde train ve test dönemleri arasında 24 saat embargo, portföy ve sentiment görevlerinde ise beş trading-day embargo uygulanmıştır.
Kaynak ayrıca sonuçların beş bağımsız random seed üzerinden ortalama olarak raporlandığını, 10.000 bootstrap tekrarından %95 confidence interval hesaplandığını ve en güçlü single-component baseline'a karşı paired t-test uygulandığını belirtmektedir.
Genel performans
| Metrik | Kaynak sonucu |
|---|---|
| Sharpe Ratio | 1,67 |
| Maximum Drawdown | −%8,9 |
| HFT Directional Accuracy | %78,5 |
| Sentiment F1 | 0,851 |
| Nash yakınsaması | 53 iterasyon |
| ICL Adaptation Score | 0,74 |
Birleşik sistem için %95 bootstrap güven aralıkları Sharpe'da 1,61–1,73, maximum drawdown'da yaklaşık −%9,6 ile −%8,1, HFT accuracy'de %77,4–%79,6 ve sentiment F1'de 0,842–0,860 olarak verilmiştir.
HFT karşılaştırması
| Model | RMSE | MAE | Yön Doğruluğu | Latency | Profit Factor |
|---|---|---|---|---|---|
| ARIMA | 0,0834 | 0,0621 | %52,3 | 12 µs | 1,08 |
| LSTM | 0,0612 | 0,0453 | %58,7 | 47 µs | 1,21 |
| Transformer | 0,0543 | 0,0398 | %63,2 | 83 µs | 1,34 |
| DeepLOB | 0,0487 | 0,0352 | %66,8 | 91 µs | 1,42 |
| HFT Module | 0,0421 | 0,0304 | %71,4 | 78 µs | 1,53 |
| Birleşik Framework | 0,0289 | 0,0214 | %78,5 | 95 µs | 1,87 |
HFT Module'dan birleşik sisteme RMSE:
\[ 0.0421\rightarrow0.0289 \]
seviyesine düşmektedir. Bu yaklaşık %31,35'lik azalmadır ve abstract'ta bildirilen yaklaşık %31,2 HFT prediction-error improvement ile uyumludur.
İşlem maliyetleri
Backtest üç maliyet bileşeni kullanmaktadır:
- hisselerde 10 bps sabit venue fee,
- kriptoda 4 bps sabit venue fee,
- market order için bid-ask half-spread,
- bunlara ek olarak square-root price-impact modeli.
Price-impact katsayısı iki katına çıkarıldığında genel Sharpe'ın 1,67'den 1,51'e, HFT profit factor'ın ise 1,87'den 1,62'ye gerilediği raporlanmaktadır.
Çok modlu sentiment sonuçları
| Yöntem | Accuracy | F1 | AUC |
|---|---|---|---|
| Text Only | %71,3 | 0,698 | 0,782 |
| Text + Audio | %76,8 | 0,753 | 0,831 |
| All — Concatenation | %79,4 | 0,778 | 0,856 |
| All — Attention | %82,7 | 0,812 | 0,883 |
| Önerilen Fusion | %86,9 | 0,851 | 0,912 |
Sonuçlar metin, ses ve görsel bilginin birlikte kullanılmasının kaynak deneyinde tek modality modellerinden daha yüksek performans verdiğini göstermektedir.
Ablation sonuçları
Bileşenler çıkarıldığında performansın çoğu boyutta gerilediği raporlanmaktadır.
| Yapı | Sharpe | HFT Accuracy | Sentiment F1 | Latency |
|---|---|---|---|---|
| Tam Framework | 1,67 | %78,5 | 0,851 | 95 µs |
| Sentiment olmadan | 1,53 | %71,9 | — | 71 µs |
| Game Theory olmadan | 1,58 | %75,3 | 0,834 | 78 µs |
| Attention olmadan | 1,42 | %72,4 | 0,812 | 103 µs |
| Synergy term olmadan | 1,51 | %74,6 | 0,827 | 91 µs |
Özellikle attention katmanının kaldırılması yalnız doğruluğu değil latency'yi de kötüleştirmektedir. Bu sonuç kaynağın attention mekanizmasını yalnız tahmin kalitesi değil hesaplama kaynaklarının yönlendirilmesi için de kullandığı iddiasıyla uyumludur.
FI-2010 benchmark sonucu nasıl yorumlanmalı?
Kaynak FI-2010 benchmark'ta kendi HFT modülü için %80,7 directional accuracy raporlamakta ve bunu DeepLOB'un yayımlanmış %78,0 değeriyle karşılaştırmaktadır.
Ancak FI-2010 sonuçları prediction horizon ve kullanılan evaluation setup'a güçlü biçimde bağlıdır. DeepLOB literatüründe farklı setup'larda yaklaşık %79'dan %84'ün üzerine çıkan accuracy sonuçları bulunmaktadır. Bu nedenle iki modelin aynı horizon ve preprocessing koşulları kullanılmadan tek bir yüzdelik değer üzerinden üstünlük karşılaştırması yapılması yeterli değildir.
Gerçek dünyadaki üç vaka
Kaynak:
- orta ölçekli bir hedge fund'da altı aylık kullanım sonucu risk-ayarlı performansta %27 iyileşme,
- bir retail brokerage'da müşteri memnuniyetinde %34 ve assets under management'da %22 artış,
- bir yatırım bankasında adverse-selection cost'ta %19 azalma
bildirmektedir.
Ancak kurum isimleri ve ayrıntılı vaka verileri verilmediğinden bu sonuçlar dışarıdan doğrulanabilir klinik veya kontrollü deney türü kanıtlar değildir. Kaynağın raporladığı saha sonuçları olarak değerlendirilmelidir.
Teorik yakınsama sonucu ne kadar güçlü?
Makale birleşik optimizasyon için \(O(1/\sqrt{T})\) yakınsama oranı sunmaktadır. Bununla birlikte descent lemma'da kullanılan ikinci dereceden üst sınır için yalnız fonksiyonun Lipschitz sürekli olması yerine genellikle gradient smoothness varsayımı gerekir.
Ayrıca ana Algorithm 1 ile Appendix A'da learning-rate yazımı tam olarak aynı değildir.
Bu nedenle yakınsama sonucu çalışmanın teorik çerçevesinin önemli bir parçasıdır ancak kanıtın varsayımlarının ve notasyonunun daha kesin biçimde formüle edilmesi yararlı olacaktır.
Çalışmanın güçlü yönleri
- Beş farklı finansal AI disiplinini ortak mimaride birleştirmesi.
- Tick-level HFT, uzun vadeli portföy, LLM ve multimodal sentiment'i aynı state space içinde modellemesi.
- Kronolojik veri bölme ve embargo kullanması.
- Beş random seed, bootstrap confidence interval ve paired significance test raporlaması.
- Transaction cost ve market impact'i backtest'e dahil etmesi.
- 95 µs gecikmeyi alt bileşenlere ayırarak raporlaması.
- Ablation, sensitivity ve cross-market transfer deneyleri sunması.
- LLM yolunu HFT yolundan asenkron biçimde ayırması.
Başlıca sınırlılıklar
- Bazı abstract iyileşme yüzdeleri ana tablolardan doğrudan yeniden üretilemiyor.
- Table 3'teki HFT Only %64,8 ile Table 5'teki HFT Module %71,4 farkı yeterince açıklanmıyor.
- FI-2010 / DeepLOB benchmark karşılaştırması prediction-horizon eşleştirmesini açık göstermiyor.
- Yakınsama ispatındaki smoothness varsayımları daha kesin ifade edilmeli.
- Learning-rate notasyonu ana algoritma ve appendix arasında tam tutarlı değil.
- Open-source implementation iddiasına rağmen kaynakta doğrudan kod deposu URL'si verilmemiş.
- Proprietary ICL veri seti bağımsız yeniden üretimi sınırlandırıyor.
- Real-world case-study kurumları anonim tutuluyor.
- 95 µs sonucu belirli kurumsal sınıf donanım ve yazılım optimizasyonuna bağlıdır.
- Finansal kârlılık ve prediction başarısı farklı piyasalarda aynı düzeyde devam etmek zorunda değildir.
Kaynak ve Yöntem Notu
Özgün başlık: A Unified Multi-Modal Framework for Intelligent Financial Systems: Integrating Reinforcement Learning, High-Frequency Trading, and Game-Theoretic Approaches with Cross-Modal Sentiment Analysis
Yazarlar: Yuwei Zhang; Fanrong Liu; Chang-An Xu; Mingni Luo.
Dergi: Mathematics.
Cilt / sayı: 14 / 13.
Makale numarası: 2437.
Yayın tarihi: 7 Temmuz 2026.
Received: 26 Mayıs 2026.
Revised: 25 Haziran 2026.
Accepted: 30 Haziran 2026.
DOI: 10.3390/math14132437.
Lisans: Creative Commons Attribution 4.0 International — CC BY 4.0.
Kurumlar: City University of Hong Kong; Henan University; South China Agricultural University; Northeastern University.
Temel mimari: PPO robo-advisory + multi-scale HFT TCN + ICL/RAG/LLM + differentiable game-theory engine + text/audio/visual sentiment fusion.
HFT mimarisi: 1 ms, 10 ms, 100 ms, 1 s ve 10 s ölçeklerinde Multi-Scale Temporal Convolutional Network; cross-scale attention; 1000 tick sequence.
HFT veri evreni: BTC/USDT, ETH/USDT ve NASDAQ top-100; tick-level veri; 2022–2024; kronolojik %70/%15/%15 split.
HFT leakage control: Train/test fold'ları arasında 24 saat embargo.
İşlem maliyet modeli: Equities için 10 bps, crypto için 4 bps venue fee; market order half-spread ve square-root market-impact terimi.
Birleşik HFT sonucu: RMSE 0,0289; MAE 0,0214; directional accuracy %78,5; profit factor 1,87; wire-to-order latency 95 µs.
Latency platformu: Intel Xeon Gold 6338 + NVIDIA A100 40 GB; DPDK; ONNX Runtime; TensorRT.
Sentiment encoder'ları: BERT-base, wav2vec2-base ve ViT-B/16.
Finansman: Kaynak harici finansman alınmadığını belirtmektedir.
Veri erişimi: Ham verilerin yazarlar tarafından talep üzerine sağlanacağı belirtilmektedir; ICL/advisory veri setinin bir bölümü proprietary'dir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmektedir.
Kaynak-içi performans uyarısı: Abstract'taki %31,2 HFT prediction-error reduction Table 5 ile yaklaşık olarak doğrulanabilirken diğer bazı toplu iyileşme yüzdelerinin karşılaştırma tabanı ana tablolardan aynı açıklıkta yeniden hesaplanamamaktadır.
Benchmark uyarısı: FI-2010 sonucu prediction horizon ve preprocessing setup belirtilmeden DeepLOB ile tek değer üzerinden karşılaştırılmamalıdır.
Teorik uyarı: \(O(1/\sqrt{T})\) yakınsama ispatında kullanılan descent adımı için belirtilenden daha güçlü smoothness varsayımına ihtiyaç bulunabilir; learning-rate notasyonu da bölümler arasında tam tutarlı değildir.
Kod erişimi uyarısı: Makale open-source implementation yayımlandığını belirtmektedir; ancak kaynak PDF'de doğrudan repository bağlantısı verilmemektedir.
Genellenebilirlik: Sonuçlar belirli veri setleri, işlem maliyeti modeli ve yüksek performanslı donanım altında elde edilmiştir. Başka piyasa, venue veya gecikme ortamlarında aynı performansın oluşacağı garanti edilmemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir