

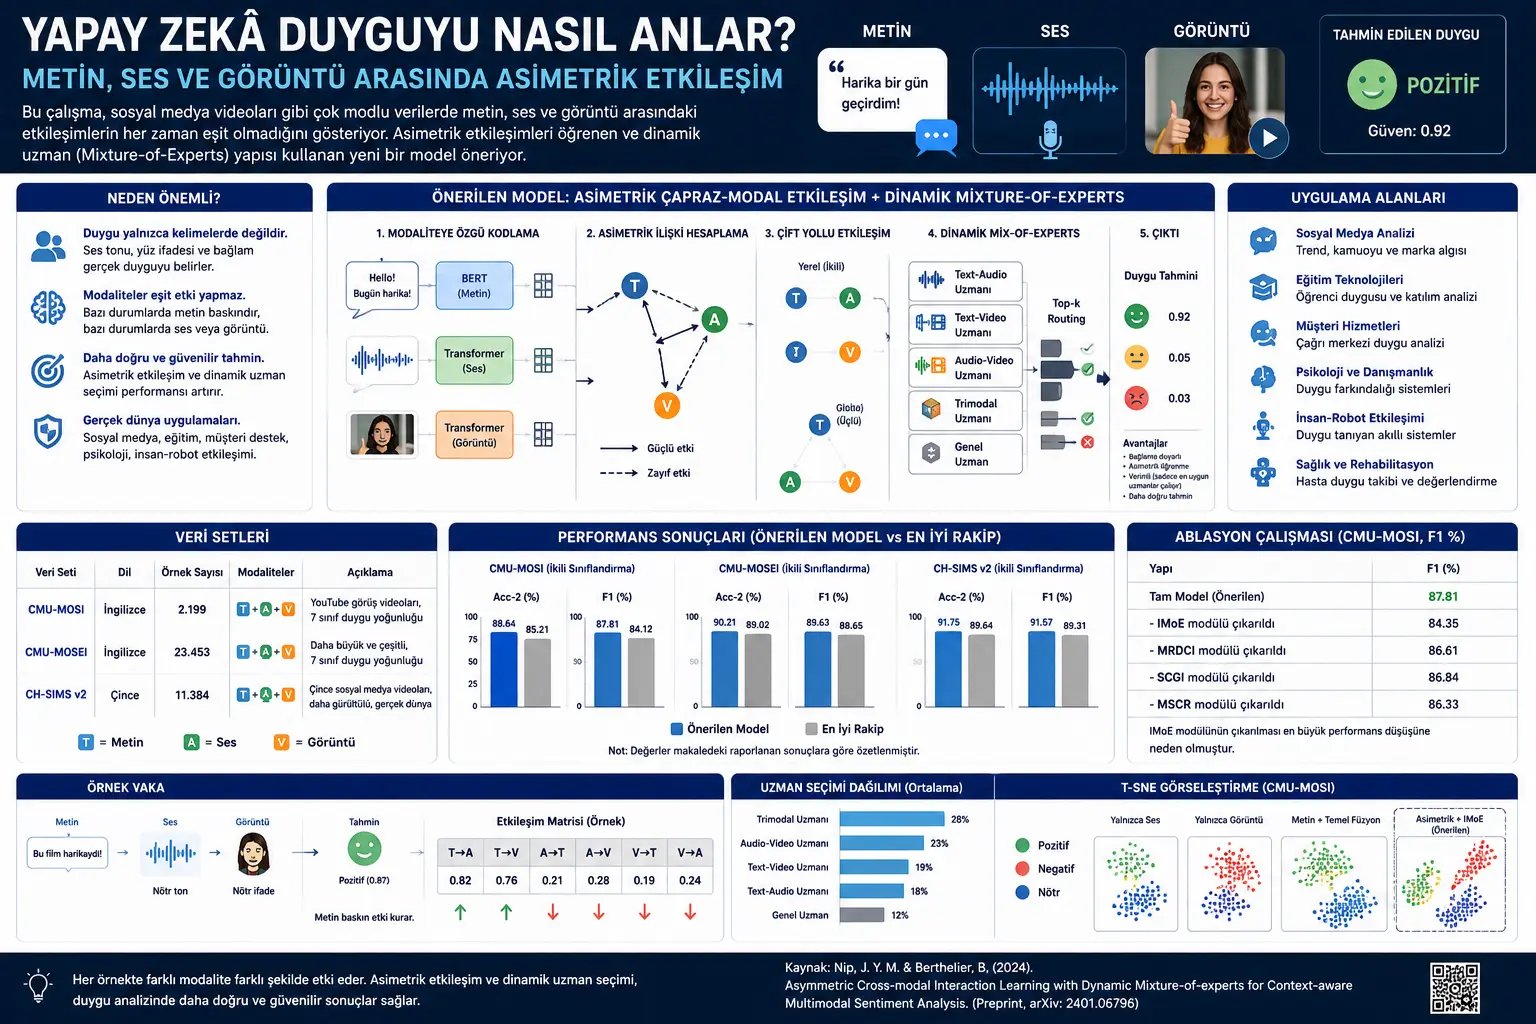
Адамдын эмоциясы көп учурда сөздөрдөн гана көрүнбөйт. Адам айткан сүйлөм үнүнүн тону жана жүзүнүн мимикасы менен бирге мааниге ээ болот. Бир эле сүйлөм түз үн менен айтылса нейтралдуу; шылдыңдаган үн менен айтылса терс; кубанган жүз мимикасы менен айтылса оң мааниде кабылданышы мүмкүн. Ошондуктан жасалма интеллект системалары эмоцияны талдоодо текстти гана эмес, үн жана сүрөт белгилерин да эске алышы керек.
Бул изилдөө көп модалдуу эмоция анализиндеги маанилүү бир божомолду суроого алат: текст, үн жана сүрөттүн өз ара таасири чындап эле симметриялуубу? Башкача айтканда, текст үндү канчалык деңгээлде таасирлентсе, үн да текстке ошол эле өлчөмдө таасир этеби? Изилдөөнүн жообу — жок. Модалдуулуктар ортосунда багытталган жана тең эмес таасирлер болушу мүмкүн. Айрым үлгүлөрдө текст негизги маани булагы болсо, кээ бир учурларда үн же сүрөт тексттеги бүдөмүктү оңдоп, күчөтүп же тескери багытка бура алат.
Ошондуктан макала асимметриялык кайчылаш-модалдык өз ара аракеттенүүнү үйрөнүү моделин сунуштайт. Модель кайсы модалдуулук экинчисине канчалык таасир этерин өз-өзүнчө эсептейт; андан соң ар түрдүү өз ара аракеттенүү түрлөрүн иштетүү үчүн динамикалык Mixture-of-Experts түзүмүн колдонот. Mixture-of-Experts кыргызча «эксперттер аралашмасы» деп которулушу мүмкүн: модель ар бир үлгүдө бардык эксперттерди иштетпестен, ошол үлгүгө эң ылайыктуу болгон бир нече эксперттик ички тармакты тандап, ийкемдүү жана натыйжалуу өкүлчүлүк түзөт.
Көйгөй Эмне?
Көп модалдуу эмоция анализи текст, үн жана сүрөт сыяктуу ар башка маалымат түрлөрүн бириктирип, эмоциялык абалды божомолдоого аракет кылат. Бул тармак социалдык медиа, онлайн видеолорду чечмелөө, билим берүү технологиялары, адам-компьютер өз ара аракеттенүүсү жана эмоцияны эске алган жасалма интеллект системалары үчүн маанилүү. Бирок ар башка модалдуулуктарды бириктирүү техникалык жактан кыйын.
Биринчи кыйынчылык — модалдуулуктар бирдей түрдөгү маалыматты алып жүрбөйт. Текст адатта мааниге бай булак болуп, адам эмне айтканын түздөн-түз камтыйт. Үн басым, ылдамдык, үн бийиктиги жана эмоциялык тон сыяктуу белгилерди берет. Сүрөт болсо жүз мимикасы, жаңсоо, кыймыл жана дене туруму аркылуу кошумча сигналдарды берет. Бул үч канал бири-бирин толукташы мүмкүн; бирок ар бир үлгүдө бирдей күч менен иштебейт.
Экинчи кыйынчылык — мурдагы көптөгөн ыкмалар модалдуулуктар ортосундагы өз ара аракеттенүүнү симметриялуу же тең деп кабыл алган. Чыныгы сүйлөшүүдө болсо бул ар дайым туура эмес. Текст үндүн кандай чечмеленишин күчтүү аныкташы мүмкүн; бирок үндүн текстке болгон таасири ошол эле деңгээлде болбошу мүмкүн. Ошол сыяктуу, сүрөт айрым үлгүлөрдө абдан маанилүү болсо, башка үлгүлөрдө дээрлик эч кандай эмоция сигналын бербеши мүмкүн.
Үчүнчү кыйынчылык — контекстке жараша өзгөргөн өз ара аракеттенүү. Юмор, ирония, шылдың, бүдөмүк текст, алсыз эмоциялык көрүнүш же ызы-чуулуу видео сыяктуу учурларда модель кайсы модалдуулукка көбүрөөк ишенерин динамикалык түрдө жөндөшү керек. Туруктуу салмактар же жөнөкөй бириктирүү ыкмалары бул ийкемдүүлүктү дайыма бере албайт.
Изилдөөнүн негизги суроосу ушул жерде чыгат: жасалма интеллект текст, үн жана сүрөт ортосундагы багытталган жана үлгүгө жараша өзгөргөн өз ара аракеттенүүлөрдү кантип жакшыраак үйрөнө алат?
Ыкма Эмнени Сунуштайт?
Изилдөө контекстти эске алган көп модалдуу эмоция анализи үчүн асимметриялык кайчылаш-модалдык өз ара аракеттенүүнү үйрөнүү моделин сунуштайт. Моделдин негизги идеясы — ар бир модалдуулуктун башка модалдуулуктарга тийгизген таасирин өзүнчө багыттар боюнча эсептөө жана бул өз ара аракеттенүүлөрдү динамикалык эксперттик тармактар менен иштетүү.
Биринчи компонент — модалдуулукка мүнөздүү коддоо модулу. Текст үчүн BERT колдонулат. BERT сүйлөм ичиндеги сөздөрдү контекстте чагылдырган күчтүү тил модели. Үн жана сүрөт үчүн болсо позициялык маалымат кошулган Transformer encoder түзүмдөрү колдонулат. Ошентип ар бир модалдуулук адегенде өз ичинде маңыздуу өкүлчүлүккө айландырылат.
Экинчи компонент — Modality Relation-aware Dual-path Cross-modal Interaction, башкача айтканда модалдуулуктар ортосундагы мамилени эске алган кош жолдуу кайчылаш-модалдык өз ара аракеттенүү модулу. Бул модуль текст, үн жана сүрөт ортосундагы багытталган таасир салмактарын эсептейт. Мисалы, тексттен үнгө болгон таасир менен үндөн текстке болгон таасир бирдей деп кабыл алынбайт; ар бир багыт өзүнчө ишеним салмагы менен моделденет.
Үчүнчү компонент — кош жолдуу өз ара аракеттенүү түзүмү. Модель жергиликтүү жуптук өз ара аракеттенүүлөрдү да, глобалдуу үч модалдуу өз ара аракеттенүүнү да кармоого аракет кылат. Жергиликтүү жол текст-үн, текст-сүрөт жана үн-сүрөт сыяктуу жуптук байланыштарды талдайт. Глобалдуу жол болсо үч модалдуулуктун чогуу түзгөн кеңири өз ара аракеттенүү үлгүсүн кармайт.
Төртүнчү компонент — Interaction-aware Mixture-of-Experts модулу. Бул түзүм ар түрдүү кайчылаш-модалдык өз ара аракеттенүү түрлөрү үчүн ар башка эксперттик тармактарды түзөт. Text-Audio Expert, Text-Video Expert, Audio-Video Expert, Trimodal Expert жана General Expert сыяктуу эксперттер бар. Модель ар бир үлгүдө бардык эксперттерди бирдей колдонбойт; top-k routing стратегиясы менен эң ылайыктуу бир нече экспертти тандайт.
Бешинчи компонент — Semantically Complementary Global Interaction модулу. Бул түзүм асимметриялык өз ара аракеттенүүлөрдө жоголуп кетиши мүмкүн болгон толуктоочу эмоция белгилерин кайра кармоого аракет кылат. Алтынчы компонент болсо Modality-Specific Channel Refinement модулу. Бул модуль ар бир модалдуулуктун өз ичинде алып жүргөн маанилүү эмоция сигналдарын сактап, бириккен өкүлчүлүктүн алсырашын алдын алууга аракет кылат.
Формулалар Эмнени Түшүндүрөт?
Изилдөөдө көп сандагы математикалык туюнтмалар бар. Төмөнкү формулалар макаладагы символ түзүмүнө мүмкүн болушунча берилген бойдон сакталып, Verianla окурманы үчүн жөнөкөй түшүндүрмөлөр менен берилет.
Текст модалдуулугу BERT менен коддолот. Бул жерде \(X_t\) текст киргизүүсүн; \(H_t\) тексттен чыгарылган контексттик өкүлчүлүктөрдүн тизмегин билдирет.
Үн жана сүрөт модалдуулуктарына позициялык маалымат кошулат жана Transformer encoder аркылуу өкүлчүлүк алынат. Бул жерде \(m \in \{a,v\}\) үн же сүрөт модалдуулугун билдирет.
Андан соң модель модалдуулуктарды жалпы өлчөмгө проекциялайт. Текст үчүн [CLS] өкүлчүлүгү, үн жана сүрөт үчүн орточо pooling колдонулат.
Асимметриялык байланыштарды аныктоо механизми бир модалдуулуктун башка модалдуулукка багытталган таасирин эсептейт. Бул жерде \(w_{j \rightarrow i}\) булак модалдуулук \(j\)'ден максат модалдуулук \(i\)'ге болгон таасир ишеним салмагын билдирет.
Бул салмактар колдонулуп, ар бир модалдуулук башка модалдуулуктардан келген багытталган таасирге жараша кайра масштабдалат. Бул жерде \(\odot\) элемент боюнча көбөйтүүнү билдирет.
Жергиликтүү жуптук өз ара аракеттенүүдө эки модалдуулуктун күчөтүлгөн өкүлчүлүктөрү бириктирилип, сызыктуу эмес өзгөртүүдөн өткөрүлөт.
Үч жуптук өз ара аракеттенүү вектору кабатталып, кеңири байланыш түзүмү пайда болот.
Mixture-of-Experts түзүмүндө ар башка эксперттер ар башка өз ара аракеттенүү түрлөрүн иштетет. Мисалы, текст-үн, текст-сүрөт, үн-сүрөт, үч модалдуу жана жалпы эксперттер өзүнчө өз ара аракеттенүү үлгүлөрүнө басым жасайт.
Routing, башкача айтканда багыттоо тармагы ар бир үлгү үчүн кайсы эксперттер тандаларын аныктайт. Модель бардык эксперттерди иштетпестен эң ылайыктуу \(k\) экспертти тандайт.
Тандалган эксперттердин чыгыштары салмактуу түрдө бириктирилет.
Эксперттердин кыйрашын алдын алуу үчүн жүктү тең салмактоо жоготуусу колдонулат. Эксперттердин кыйрашы — модель дайыма эле ошол бир нече экспертке багытталып, башка эксперттердин үйрөнө албай калышы.
Регрессия бөлүгүндө эмоция баллын божомолдоо үчүн L1 жоготуусу колдонулат. Бул жоготуу божомолдонгон эмоция мааниси менен чыныгы эмоция маанисинин абсолюттук айырмасын өлчөйт.
Жалпы окутуу максаты регрессия жоготуусун, эмоцияны эске алган контрастивдик жоготууну жана жүктү тең салмактоо жоготуусун бириктирет.
График, Таблица жана Схеманын Негизги Мааниси
Модель архитектурасынын схемасы система текст, үн жана сүрөт киргизүүлөрүн адегенде өз-өзүнчө коддоп, андан кийин бул модалдуулуктар ортосундагы багытталган таасирлерди эсептээрин көрсөтөт. Схеманын негизги кабары мындай: модель «текст + үн + сүрөт» биригүүсүн жөнөкөй кошуу катары карабайт; кайсы канал кайсы каналга канчалык таасир этерин өзүнчө үйрөнөт.
Асимметриялык байланыш схемасы модалдуулуктар ортосундагы өз ара аракеттенүүлөр бир багыттуу жана тең эмес болушу мүмкүн экенин түшүндүрөт. Мисалы, бир үлгүдө текст үн жана сүрөткө күчтүү таасир бере алат; бирок үн же сүрөт текстти ошол эле деңгээлде өзгөртпөшү мүмкүн. Бул ыкма өзгөчө ирония, бүдөмүк текст жана алсыз эмоция сигналы бар учурларда маанилүү.
Semantically Complementary Global Interaction схемасы модель асимметриялык өз ара аракеттенүү менен гана чектелбей турганын көрсөтөт. Айрым эмоция белгилери багытталган өз ара аракеттенүү учурунда алсырап же жоголуп кетиши мүмкүн. Ошондуктан модель үч модалдуулуктун жалпы өкүлчүлүгүнөн жергиликтүү да, глобалдуу да толуктоочу эмоция маалыматын чыгарууга аракет кылат.
Маалымат топтому таблицасынын негизги кабары — модель англисче да, кытайча да көп модалдуу эмоция анализинин маалыматтарында сыналган. CMU-MOSI кичирээк жана классикалык benchmark. CMU-MOSEI чоңураак жана эмоция мисалдары кыйла ар түрдүү. CH-SIMS v2 болсо кытайча маалымат топтому катары реалдуу дүйнөдөгү көбүрөөк ызы-чууну жана алсыз эмоция билдирүүлөрүн камтып, моделди башка контекстте сынайт.
Өндүрүмдүүлүк таблицалары сунушталган модель өзгөчө экилик эмоция классификациясында күчтүү натыйжа бергенин көрсөтөт. CMU-MOSIде Acc-2 жана F1 көрсөткүчтөрүндө олуттуу өсүү билдирилет. CMU-MOSEIде кичирээк, бирок туруктуу жакшыртуулар байкалат. CH-SIMS v2де болсо ызы-чуулуу жана алсыз эмоция сигналы бар үлгүлөрдө оң натыйжалар алдыга чыгат.
Абляция таблицасы моделдин кайсы бөлүктөрү чындап салым кошорун көрсөтөт. IMoE модулу алынып салынганда F1 көрсөткүчүндө эң чоң төмөндөөлөрдүн бири болот. Бул динамикалык эксперт тандоосу татаал контексттерде майда эмоция сигналдарын кармоодо маанилүү экенин көрсөтөт. MRDCI жана SCGI модулдары алынып салынганда да натыйжа төмөндөйт; бул асимметриялык өз ара аракеттенүү жана толуктоочу глобалдуу өкүлчүлүк модель үчүн негизги экенин көрсөтөт.
Үлгү окуянын талдоосу текст ачык терс эмоция алып жүргөн, ал эми үн менен сүрөттө белгилүү эмоция сигналы жок кырдаалды көрсөтөт. Өз ара аракеттенүү матрицасы текст башка модалдуулуктарга күчтүү таасир берип, үн менен сүрөттүн текстке болгон тескери таасири төмөн экенин көрсөтөт. Бул мисал «ар бир модалдуулук бирдей салмакта эмес» деген идеяны конкреттештирет.
Эксперт тандоо бөлүштүрүлүшү модель бир эле экспертке көз каранды болуп калбаганын көрсөтөт. Trimodal Expert жана Audio-Video Expert көбүрөөк тандалганы менен башка эксперттер да маанилүү деңгээлде колдонулат. Бул top-k routing механизми ар башка үлгүлөрдө ар башка өз ара аракеттенүү эксперттерин ишке киргизе аларын көрсөтөт.
T-SNE визуалдаштыруу моделдин өкүлчүлүк сапатын көрнөк-жарнак түрүндө түшүндүрөт. Үн же сүрөт өзүнчө колдонулганда эмоция топтору бири-бирине катуу аралашып кетет. Текст жакшыраак бөлүнүүнү берсе да нейтралдуу эмоция дагы эле чачыранды. Кайчылаш-модалдык өз ара аракеттенүү жана IMoE кошулганда оң, терс жана нейтралдуу үлгүлөр жакшыраак ажырай баштайт. Бул моделдин өзгөчө нейтралдуу эмоция менен полярдуу оң/терс эмоциялар ортосундагы чек араны жакшыраак сыза аларын көрсөтөт.
Эксперименттер Кантип Жүргүзүлгөн?
Изилдөөдө көп колдонулган үч көп модалдуу эмоция анализи маалымат топтому колдонулган: CMU-MOSI, CMU-MOSEI жана CH-SIMS v2. CMU-MOSI YouTube пикир видеолорунан турган классикалык benchmark. CMU-MOSEI көлөмү чоңураак жана темалары ар түрдүү кеңейтилген маалымат топтому. CH-SIMS v2 болсо кытайча көп модалдуу эмоция анализи үчүн колдонулган, реалдуу дүйнөдөгү көбүрөөк ызы-чууну жана алсыз эмоция билдирүүлөрүн камтыган маалымат топтому.
Модель текст, үн жана сүрөт белгилерин өз-өзүнчө иштетет. Текст жагында BERT-base же кытайча маалымат топтому үчүн BERT-base-cn колдонулат. Үн жана сүрөт жагында маалымат топтомуна жараша ар башка белги өлчөмдөрү колдонулат. Эксперименттер PyTorch менен ишке ашырылып, бир NVIDIA RTX 3090 GPUда жүргүзүлөт.
Баалоо регрессия жана классификация көрсөткүчтөрү менен жүргүзүлөт. Регрессия жагында MAE жана Pearson корреляциясы колдонулат. MAE божомолдонгон эмоция баллы менен чыныгы эмоция баллынын орточо абсолюттук катасын өлчөйт. Pearson корреляциясы божомол менен чыныгы энбелги ортосундагы сызыктуу байланышты көрсөтөт.
Классификация жагында Acc-7, Acc-5, Acc-2 жана F1 көрсөткүчтөрү берилет. Acc-7 жана Acc-5 кыйла майда эмоция класстарын бөлүүнү өлчөйт. Acc-2 жана F1 болсо оң/терс бөлүү сыяктуу ири, бирок практикада маанилүү эмоция классификациясын баалайт.
Модель классикалык fusion ыкмалары, Transformer негизиндеги ыкмалар, контрастивдик үйрөнүү ыкмалары, өкүлчүлүктү ажыратуу методдору, адаптивдүү эксперт механизмдери жана мультимодалдык чоң тил моделдерине негизделген ыкмалар менен салыштырылат. Мунун аркасында сунушталган моделдин эски ыкмаларга гана эмес, жаңы күчтүү ыкмаларга салыштырмалуу орду да көрүнөт.
Мындан тышкары ablation изилдөөлөрү жүргүзүлөт. Ablation — моделден компоненттерди бирден алып чыгып, ар бир бөлүктүн өндүрүмдүүлүккө канчалык салым кошконун өлчөө ыкмасы. MRDCI, APMR, GPTA, LBI, IMoE, SCGI жана MSCR сыяктуу компоненттер алынганда натыйжанын өзгөрүшү талданат.
Жыйынтыктар Эмнени Көрсөтөт?
Биринчи жыйынтык — көп модалдуу эмоция анализинде модалдуулуктар ортосундагы өз ара аракеттенүүнү симметриялуу деп кабыл алуу чектелүү. Текст, үн жана сүрөт ар бир үлгүдө бирдей салмакта иштебейт. Айрым учурларда текст негизги аныктоочу; башка учурларда үн же сүрөт текстти толуктап, оңдоп же алсыз эмоцияны көрүнүктүү кыла алат.
Экинчи жыйынтык — асимметриялык өз ара аракеттенүүнү моделдөө өндүрүмдүүлүккө маанилүү салым берет. MRDCI модулу алынып салынганда F1 көрсөткүчүнүн олуттуу төмөндөшү багытталган модалдуулук мамилелерин үйрөнүү эмоцияны божомолдоодо маанилүү экенин көрсөтөт.
Үчүнчү жыйынтык — динамикалык эксперт тандоосу критикалык мааниге ээ. IMoE модулу алынып салынганда өндүрүмдүүлүк олуттуу төмөндөйт. Бул ар бир үлгү үчүн бир эле fusion стратегиясы жетишсиз экенин; моделдин контекстке жараша ар башка эксперттерди тандашы жакшы натыйжа бере аларын көрсөтөт.
Төртүнчү жыйынтык — толуктоочу глобалдуу өз ара аракеттенүү жана модалдуулукка мүнөздүү каналдарды жакшыртуу эмоция сигналдарынын жоголушун азайта алат. SCGI үч модалдуулук ортосундагы жалпы жана жергиликтүү-глобалдуу эмоция белгилерин күчөтөт. MSCR болсо ар бир модалдуулуктун өзүндө алып жүргөн маанилүү сигналдарды сактайт.
Бешинчи жыйынтык — модель өзгөчө алсыз эмоция сигналдары жана ызы-чуулуу үлгүлөрдө артыкчылык берет. CH-SIMS v2 натыйжалары нейтралдуу эмоцияны оң же терс класстардан ажыратуу кыйын болгон учурларда модель күчтүүрөөк бөлүү жасай аларын көрсөтөт.
Алтынчы жыйынтык — көбүрөөк экспертти иштетүү ар дайым жакшы эмес. Top-k sparse routing ыкмасы эң ылайыктуу эксперттерди гана тандап, эсептөө жүгүн азайтат жана үлгүгө ылайыктуу өкүлчүлүк түзөт. Изилдөөдө 5 эксперт жана top-2 activation стратегиясы ири эмоция классификациясы менен корреляция көрсөткүчтөрүндө жакшы тең салмак берет.
Бул Эмне Үчүн Маанилүү?
Бул изилдөө эмоция анализинде «көбүрөөк маалымат каналын бириктирели» деген ой өзү жетишсиз экенин көрсөтөт. Негизги маселе — бул каналдар бири-бирине кандай таасир этерин жана кайсы контекстте кайсы канал ишенимдүү экенин түшүнө билүү.
Социалдык медиа видеолору, онлайн билим берүү жазуулары, кардарларды колдоо сүйлөшүүлөрү, адам-робот өз ара аракеттенүүсү жана эмоцияны эске алган колдонмолордо текст, үн жана сүрөт көп учурда бирге болот. Бирок бул маалыматтар дайыма шайкеш эмес. Адам оң сөздөрдү колдонуп жатканда жүзү терс болушу мүмкүн; үн тону тексттеги маанини тескери бурушу мүмкүн; сүрөт сапаты начар болушу мүмкүн; сүйлөшүү бүдөмүк же ирониялуу болушу мүмкүн.
Ошондуктан контекстти эске алып, асимметриялык өз ара аракеттенүүнү үйрөнгөн моделдер классикалык «үч каналды бириктир да божомол жаса» ыкмасынан алдыга жылган кадам болуп саналат. Модель модалдуулуктарды жөн гана кошпойт; алардын ортосундагы күч тең салмагын үйрөнүүгө аракет кылат.
Изилдөө Mixture-of-Experts архитектурасы көп модалдуу эмоция анализинде эмне үчүн маанилүү болушу мүмкүн экенин да көрсөтөт. Ар бир үлгү ар башка эмоциялык өз ара аракеттенүү үлгүсүн алып жүрсө, бир эле жалпы моделдин ордуна ар башка эксперттерди контекстке жараша тандоо ийкемдүү жана натыйжалуу болушу мүмкүн.
Бирок мындай системаларды реалдуу дүйнөдө колдонуу этияттыкты талап кылат. Эмоция таануу адамдын ички дүйнөсүн так окуй турган курал эмес. Модель маалыматтагы текст, үн жана сүрөт сигналдарынан божомол чыгарат; бул божомолдор контекстке, маданиятка, маалымат сапатына, колдонуучунун жүрүм-турумуна жана этикалык чектөөлөргө көз каранды.
Көңүл Буруучу Жагдайлар
Биринчи көңүл буруучу жагдай — изилдөөнүн preprint болушу. Рецензиядан өтпөгөндүктөн ыкма, жыйынтыктар жана дооматтар кийин өзгөрүшү мүмкүн. Ошондуктан табылгаларды келечектүү изилдөө натыйжасы катары окуп, бекемделген стандарт катары кароо туура эмес.
Экинчи көңүл буруучу жагдай — эмоция таануунун этикалык чектери. Адамдын эмоциясын текст, үн жана сүрөттөн автоматтык божомолдоо сезимтал процесс. Билим берүү, жумушка алуу, саламаттык сактоо, коопсуздук, көзөмөл же кардарларды баалоо сыяктуу тармактарда мындай системалар адамдарды автоматтык энбелгилөө үчүн жалгыз өзүнчө колдонулбашы керек.
Үчүнчү көңүл буруучу жагдай — маалымат топтомуна көз карандылык. CMU-MOSI, CMU-MOSEI жана CH-SIMS v2 күчтүү benchmark болгону менен реалдуу дүйнөдөгү маалымат кыйла татаал болушу мүмкүн. Ар башка тилдер, маданияттар, акценттер, камера сапаты, социалдык контексттер жана жүз мимикасынын нормалары моделдин өндүрүмдүүлүгүн өзгөртө алат.
Төртүнчү көңүл буруучу жагдай — майда эмоция класстарын бөлүү. Изилдөө айрым модулдар экилик классификацияны күчөткөнү менен Acc-5 жана Acc-7 сыяктуу майда эмоция көрсөткүчтөрүндө дайыма эле ошол эле пайда бербегенин белгилейт. Бул оң/терс бөлүү жеңилирээк; ал эми эмоциянын интенсивдүүлүгү жана нейтралдуу чек аралар кыйыныраак экенин көрсөтөт.
Бешинчи көңүл буруучу жагдай — моделдин татаалдыгы. Динамикалык эксперттер, top-k routing, асимметриялык өз ара аракеттенүү жана көптөгөн жоготуу функциялары күчтүү архитектура сунуштаганы менен системаны татаалдаштырат. Реалдуу өндүрүш чөйрөсүндө түшүндүрмөлүүлүк, эсептөө чыгымы, кечигүү, маалымат купуялыгы жана тейлөө талаптары өзүнчө бааланышы керек.
Жыйынтык
Бул изилдөө көп модалдуу эмоция анализиндеги маанилүү идеяны борборго коёт: текст, үн жана сүрөт ортосундагы мамиле ар дайым тең жана симметриялуу эмес. Айрым үлгүлөрдө текст башка модалдуулуктарды багыттайт; кээ биринде үн жана сүрөт тексттин маанисин толуктайт; айрым учурларда үч модалдуулукту чогуу иштетүү керек.
Сунушталган модель бул татаалдыкты асимметриялык кайчылаш-модалдык өз ара аракеттенүү жана динамикалык Mixture-of-Experts түзүмү аркылуу чечет. MRDCI модалдуулуктар ортосундагы багытталган таасирлерди кармайт. IMoE контекстке жараша ылайыктуу эксперттерди тандап, майда эмоция сигналдарын иштетет. SCGI жоголуп кетиши мүмкүн болгон толуктоочу глобалдуу белгилерди күчөтөт. MSCR болсо модалдуулукка мүнөздүү маанилүү сигналдарды сактайт.
Эксперименталдык жыйынтыктар модель үч benchmark маалымат топтомунда күчтүү өндүрүмдүүлүк көрсөткөнүн жана өзгөчө экилик эмоция классификациясы, ызы-чуулуу үлгүлөр жана алсыз эмоция сигналдарында артыкчылык бере аларын көрсөтөт.
Verianla үчүн изилдөөнүн негизги кабары мындай: жасалма интеллект адамдын эмоциясын жакшыраак түшүнүшү үчүн текст, үн жана сүрөттү бирге колдонушу гана жетишсиз. Бул каналдардын ортосундагы багытталган күч мамилесин, контекстти жана үлгүгө мүнөздүү өз ара аракеттенүүлөрдү да үйрөнүшү керек.
Булак жана Ыкма Жөнүндө Эскертүү
Бул мазмун “Asymmetric Cross-modal Interaction Learning with Dynamic Mixture-of-experts for Context-aware Multimodal Sentiment Analysis” аттуу preprint изилдөөгө таянып даярдалган. Изилдөө көп модалдуу эмоция анализи, асимметриялык кайчылаш-модалдык өз ара аракеттенүү, динамикалык Mixture-of-Experts, top-k routing, семантикалык толуктоочу глобалдуу өз ара аракеттенүү жана модалдуулукка мүнөздүү каналдарды жакшыртуу ыкмаларын CMU-MOSI, CMU-MOSEI жана CH-SIMS v2 маалымат топтомдорунда талдайт.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianlaнын жарыялоо багытына ылайык жөнөкөйлөштүрүлүп, оригиналдуу түркчө редакциялык макалага айландырылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген