

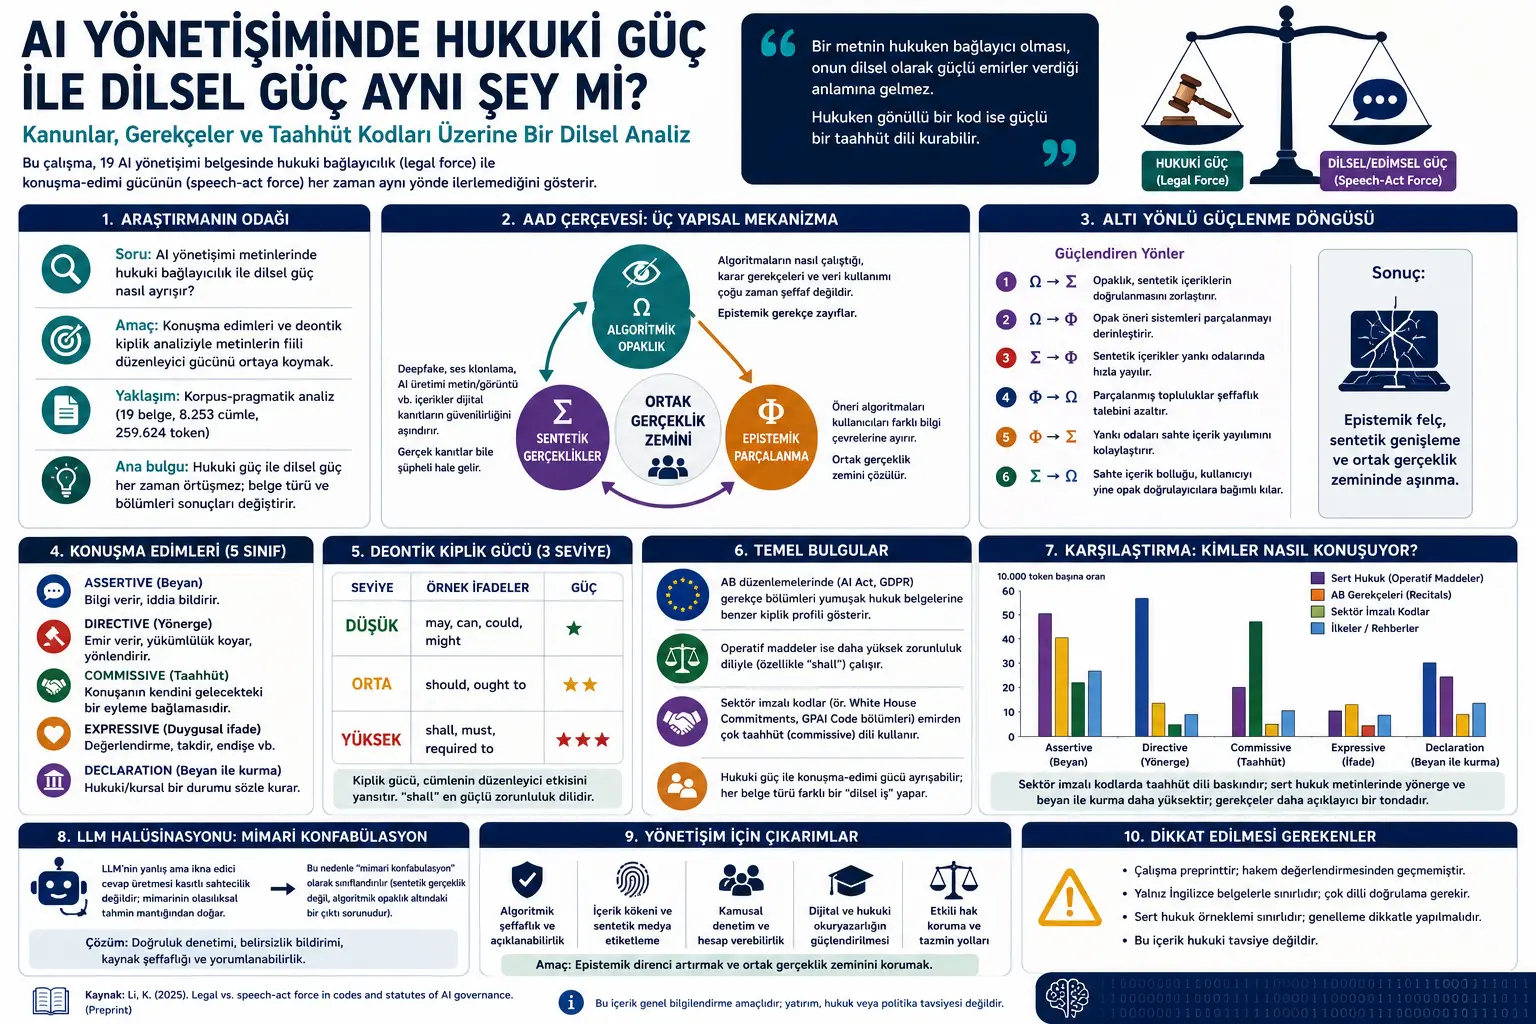
Бул изилдөө жасалма интеллектти башкаруу, укук тили, прагматика, корпус лингвистикасы жана жөнгө салуучу тексттерди талдоо тармактарынын кесилишинде турган preprint макала. Текстте изилдөө рецензиядан өтпөгөнү ачык көрсөтүлгөн. Ошондуктан аны такталган рецензияланган басылма катары эмес, жасалма интеллект governance документтеринин тилдик иштешин талдаган актуалдуу жана талкууга ачык изилдөө катары окуу керек.
Макаланын негизги суроосу мындай: AI governance тексти укуктук жактан милдеттүү болушу, анын тилдик жактан да күчтүү буйруктарды берерин билдиреби? Же укуктук жактан милдеттүү эмес тармактык код тилдик жактан күчтүү commitment тилин түзө алабы? Автор бул суроолорго “ооба/жок” деңгээлинде эмес, текст ичиндеги speech act жана modality бөлүштүрүлүшү аркылуу жооп издейт.
Speech act — сүйлөм маалымат берүүдөн тышкары белгилүү бир ишти аткаруусу. Мисалы “муну жасоого милдеттүүсүң” — directive; “муну жасоого commitment алабыз” — commissive; “бул түшүнүк муну билдирет” болсо укуктук аныктама түзгөн declaration болушу мүмкүн. Deontic modality болсо милдет, уруксат, зарылдык жана сунуш сыяктуу жөнгө салуучу тил күчтөрүн билдирет. Англис укук тилиндеги “shall”, “must”, “should”, “may” сыяктуу сөздөр ушул жагынан маанилүү.
Бул мазмун укуктук кеңеш эмес. AI Act, GDPR, Colorado AI Act, GPAI Code of Practice же ушуга окшогон жөнгө салуучу документтер боюнча колдонмо чечимдер үчүн актуалдуу мыйзамдар, ыйгарым укуктуу мекемелердин түшүндүрмөлөрү жана укуктук адистик эске алынышы керек.
Макала жасалма интеллект governance документтери эмнени айтып жатканын гана эмес, аны кандай айтып жатканын изилдейт. Изилдөөнүн негизги пикири — укуктук милдеттүүлүк менен speech-act күчүн бири-биринен ажыратууга болот. Текст укуктук жактан милдеттүү болушу мүмкүн, бирок анын айрым бөлүктөрү тилдик жактан жумшак, түшүндүрмөлүү же негиздөөчү тон менен калышы мүмкүн. Тескерисинче, укуктук жактан ыктыярдуу тармактык код компанияларды түздөн-түз “биз жасайбыз” же “commitment алабыз” деген тил менен күчтүү түрдө өзүнө байлай алат.
Изилдөө 19 AI governance документинен турган корпус колдонот. Корпуска EU AI Act, GDPR, Colorado AI Act, White House Voluntary Commitments, General-Purpose AI Code of Practice бөлүмдөрү, OECD принциптери, NIST алкактары, HLEG этикалык колдонмолору жана Европа Комиссиясынын интерпретациялык документтери сыяктуу ар башка түрдөгү тексттер кирет.
Автор тапкан эки негизги ажырым көңүл бурарлык. Биринчиси — ЕБ жөнгө салууларында негиздеме бөлүмдөрү, башкача айтканда recitals, укуктук жактан милдеттүү тексттин ичинде турса да, modality жагынан soft-law документтерине окшош. Оперативдик беренелер болсо “shall” сыяктуу жогорку милдеттүүлүк тили менен катуураак жөнгө салуучу register түзөт. Экинчиси — тармак кол койгон AI коддору укуктук жактан ыктыярдуу көрүнгөнү менен, “Companies will…” жана “Signatories commit to…” сыяктуу туюнтмалар аркылуу күчтүү өзүн-өзү милдеттендирүү тилин курат.
Көйгөй эмнеде?
Укук жана жөнгө салуучу тексттер көп учурда “hard law” жана “soft law” айырмасы аркылуу окулат. Hard law — милдеттүү мыйзам, регламент же башка укуктук акт сыяктуу тексттер. Soft law болсо guideline, principle, ethical framework, voluntary commitment же policy document сыяктуу түздөн-түз милдеттүү эмес тексттерди камтыйт. Бирок бул айырма ар дайым тексттин тилдик иштешин түшүндүрө албайт.
Макала караган негизги көйгөй — укуктук күч менен speech-act күчүнүн аралашып кетиши. Укуктук күч текст расмий укук тартибинде канчалык милдеттүү экени менен байланыштуу. Speech-act күчү болсо текст тили менен эмне кылып жатканына байланыштуу: буйрук берип жатабы, аныктама түзүп жатабы, принцип жарыялап жатабы, commitment түзүп жатабы же жөн гана маалымат берип жатабы?
Бул айырма AI governance тармагында өзгөчө маанилүү. Анткени жасалма интеллектти жөнгө салуу классикалык мыйзам беренелеринен гана турбайт. Этикалык принциптер, компаниянын commitments, ыктыярдуу коддор, ЕБ жөнгө салууларынын recitals, интерпретациялык guideline жана co-regulation документтери бир эле мейкиндикте катар турат. Бул документтердин баары “AI governance”ке тиешелүү, бирок бирдей тилдик функция аткарбайт.
Мисалы EU AI Actтин оперативдик беренелери “бул милдет колдонулат” деген сыяктуу жогорку deontic күч менен иштеши мүмкүн. Ошол эле тексттин recitals бөлүгү болсо “мүчө мамлекеттер муну эске алышы керек” дегендей түшүндүрмөлүү же багыттоочу тон колдоно алат. Ушундай эле түрдө укуктук жактан ыктыярдуу компания commitment документи “компаниялар муну жасайт” дегенде классикалык буйрук бербесе да, күчтүү жамааттык убада берүү таасирин жаратат.
Ыкма эмнени сунуштайт?
Изилдөө corpus-pragmatic ыкма колдонот. Корпус — белгилүү изилдөө максаты үчүн чогултулган тексттер топтому. Бул макаладагы корпус 19 AI governance документинен турат. Жалпы талдоо маалыматтары 8.253 сүйлөм жана 259.624 token деп көрсөтүлгөн. Token — тил иштетүү изилдөөлөрүндө сөз, тыныш белгиси же маанилүү текст бөлүгү сыяктуу эсептелүүчү бирдик.
Автор документтерди үч негизги багыт боюнча классификациялайт: hard law/soft law айырмасы, тармак тарабынан кол коюлган-коюлбаган абал жана документ түрү. Мындан тышкары EU AI Act жана GDPR сыяктуу ЕБ жөнгө салуулары recitals жана operative provisions болуп ажыратылат. Бул айырма маанилүү, анткени бир эле укуктук документтин ар башка бөлүктөрү ар башка тилдик күч менен иштеши мүмкүн.
Тексттердеги speech acts rule-based жана parser-assisted классификатор менен белгиленет. Rule-based ыкма модель кайсы сүйлөмдү эмне үчүн кайсы класска кошконун байкоого мүмкүнчүлүк берет. Бул өзгөчө укук тили сыяктуу текшерилүүчүлүк маанилүү болгон тармактарда артыкчылык.
Классификатор беш негизги speech-act классын колдонот: assertive, directive, commissive, expressive жана declaration. Assertive — маалымат берген же доомат билдирген сүйлөмдөр. Directive — окурманга же адресатка бир нерсе кылдырууга аракеттенген буйрук, милдет же багыттоо сүйлөмдөрү. Commissive — сүйлөөчү өзүн келечектеги аракетке байлаган commitment сүйлөмдөрү. Expressive — баалоо же эмоция билдирген туюнтмалар. Declaration болсо укуктук же институттук абалды сөз аркылуу түзгөн билдирүүлөр.
Изилдөө modality күчүн да төмөн, орто жана жогорку диапазондорго бөлөт. “May”, “can”, “could” төмөн; “should” жана “ought to” орто; “shall”, “must” жана “required to” жогорку deontic күч катары бааланат. Ошентип тексттер кайсы speech act колдонгону гана эмес, ошол актты кандай күч менен аткарганы да өлчөнөт.
Формулалар эмнени түшүндүрөт?
Бул изилдөө математикалык теория куруудан көрө тилдик классификация жана статистикалык салыштыруу жүргүзөт. Ошентсе да ыкманы түшүнүү үчүн айрым негизги эсептер жана белгилөөлөр маанилүү. Төмөндөгү MathJax блоктору изилдөөдөгү негизги өлчөө логикасын CMS менен шайкеш түрдө жыйынтыктайт.
Бул туюнтма изилдөөнүн маалымат ааламын көрсөтөт. Корпус hard-law regulations, тармак кол койгон codes, principles, ethics guidelines, operational frameworks жана interpretive documents түрлөрүн бирге камтыйт.
Бул схема классификатор ар бир сүйлөмдү беш негизги speech-act категориясынын бирине жайгаштырарын көрсөтөт. Укук тили көп учурда бир нече функцияны бир учурда алып жүрүшү мүмкүн; изилдөө практикалык талдоо үчүн single-label decision tree колдонот.
Бул формула deontic modality күчүнүн үч деңгээлдүү өлчөөсүн түшүндүрөт. Төмөн modality уруксат же мүмкүнчүлүк; орто modality сунуш же зарылдык; жогорку modality болсо күчтүү милдет же binding command таасирин жаратат.
Бул эсеп ар башка узундуктагы документтерди салыштыруу үчүн speech-act rate 10.000 tokenге нормалдаштырылганын көрсөтөт. Ошентип кыска документ менен узун regulation адилеттүүрөөк салыштырылат.
Бул кыска туюнтма изилдөөнүн негизги тезисин жыйынтыктайт. Текст укуктук жактан милдеттүү болсо да, анын ар бир бөлүгү бирдей тилдик күч менен буйрук берет дегенди билдирбейт. Ошондой эле укуктук жактан ыктыярдуу текст күчтүү commitment тили аркылуу жогорку speech-act күчүн чыгара алат.
Бул туюнтма ЕБ жөнгө салууларынын recitals бөлүктөрү modality жагынан soft-law документтерине жакын экенин түшүндүрөт. Макалада EU AI Act жана GDPR recitals бөлүктөрүнүн modal күчүнүн орточо мааниси болжол менен 1.97–1.99 болсо, operative provisions бөлүктөрүндө бул маани болжол менен 2.72–2.75 деңгээлине чейин өсөт.
Бул схема тармак кол койгон документтерде directive тилинен көрө commitment тили үстөм экенин көрсөтөт. “Companies will…” жана “Signatories commit to…” сыяктуу түзүлүштөр жөнгө салуучу функцияны буйрук аркылуу эмес, убада берүү жана өзүн милдеттендирүү аркылуу курат.
Бул статистикалар ыкманын ишенимдүүлүгүн түшүндүрөт. Cohen’s kappa эки адам аннотациялоочунун канчалык ырааттуу иштегенин көрсөтөт. F1 score болсо классификатордун precision жана recall ийгилигин чогуу өлчөйт. Commissive классындагы жогорку F1 мааниси изилдөөнүн тармактык коддор тууралуу негизги commitment табылгасы классификатор катасына салыштырмалуу туруктуураак экенин көрсөтөт.
График, таблица жана схеманын негизги билдирүүсү
Биринчи негизги таблица soft law жана hard law салыштыруусун берет. Hard law тексттери жогорку modality күчүн, көбүрөөк declaration жана тыгызыраак directive тилин көрсөтөт. Soft law документтеринде болсо assertive, башкача айтканда түшүндүрмөлүү/маалыматтык сүйлөмдөрдүн тыгыздыгы жогору. Бирок бул таблица өзүнчө толук картинаны бербейт, анткени soft law тобунун ичинде тармак кол койгон коддор таптакыр башка тилдик профиль көрсөтөт.
Экинчи негизги таблица ЕБ жөнгө салууларындагы recitals менен operative provisions айырмасын көрсөтөт. EU AI Act жана GDPRде recitals бөлүктөрүнүн modality күчү болжол менен 1.97–1.99 аралыгында. Operative provisions бөлүктөрүндө болсо маани болжол менен 2.72–2.75 деңгээлине чыгат. Бул бир эле укуктук документтин ичинде эки ар башка тилдик register бар экенин көрсөтөт. Recitals көбүрөөк “should” жана “may” айланасында болсо, operative provisions “shall” айланасында топтолот.
Үчүнчү таблица тармак кол койгон документтер менен башка документтердин айырмасын көрсөтөт. Тармак кол койгон документтерде commissive rate жогору, directive rate төмөн. Башкача айтканда, бул документтер “силер муну кылышыңар керек” дегенден көрө “биз муну жасайбыз” же “кол койгондор муну commitment кылат” деген тил менен иштейт. Бул классикалык укуктук текст талдоосунда азыраак көңүл бурулган жөнгө салуучу күч формасы.
Principal component analysis визуалдаштыруусу 19 документти беш feature бар матрицада кластерлерге жайгаштырат. Үч негизги топ көрүнөт: binding regulations, industry-signed documents жана principle/framework түрүндөгү explanatory documents. Автор axisтерди ашыкча чечмелебейт; негизги маанилүү нерсе — өзгөчө industry-signed documents ар башка ыкмаларда туруктуу түрдө өзүнчө кластер түзөт.
Кошумча таблицаларда корпустагы документтердин бөлүштүрүлүшү майда-чүйдөсүнө чейин берилет. EU AI Act, GDPR жана Colorado AI Act hard-law тарабын; White House Voluntary Commitments жана GPAI Code of Practice бөлүмдөрү industry-signed codes тобун; HLEG, OECD, NIST, OSTP жана Европа Комиссиясынын документтери болсо ар башка soft-law, operational framework жана interpretive document түрлөрүн түзөт.
Эксперименттер кантип жүргүзүлгөн?
Бул изилдөө лабораториялык эксперимент эмес, corpus-based language analysis жана статистикалык салыштыруу иши. Биринчи кадамда 19 AI governance документи чогултулуп, plain textке айландырылып жана сүйлөмдөргө бөлүнгөн. Өтө кыска же өтө узун сүйлөмдөр, table residues жана page layoutтан калган артефакттар талдоодон чыгарылган.
Экинчи кадамда сүйлөмдөр speech-act класстарына бөлүнгөн. Бул үчүн spaCy-based parsing, deontic operator dictionaries, commissive verbs, declaration formulas жана decision tree колдонулган. Decision tree ичинде declaration биринчи, андан кийин commissive, expressive, directive жана assertive класстары келет. Бул ирет айрым укуктук сүйлөмдөр бир нече функцияны бир учурда аткара алгандыктан тандалган.
Үчүнчү кадамда 300 сүйлөмдөн турган subsample эки көз карандысыз лингвист annotationist тарабынан бааланган. Annotatorлор аралык reliability жогору табылган. Андан кийин rule-based классификатордун бул адам annotationдор менен канчалык шайкеш экени өлчөнгөн. Өзгөчө commissive классындагы жогорку ийгилик industry-signed документтердеги commitment тыгыздыгы табылгасын колдойт.
Төртүнчү кадамда документтер group comparisons аркылуу талданган. Алдын ала белгиленген негизги салыштыруу soft law жана hard law айырмасы. Мындан тышкары industry-signed documents башка документтер менен салыштырылып, андан кийин industry documents алынып салынганда principles/guidelines менен binding regulations салыштырылган.
Бешинчи кадамда ЕБ жөнгө салуулары section levelде ажыратылган. Recitals менен operative provisions өз-өзүнчө эсептелип, modal force, directive rate, declaration rate сыяктуу өлчөмдөр салыштырылган. Бул section-level analysis макаланын эң маанилүү салымдарынын бири, анткени document-level averages чыныгы тилдик айырманы жаап коюшу мүмкүн экенин көрсөтөт.
Жыйынтыктар эмнени көрсөтөт?
Изилдөөнүн биринчи негизги жыйынтыгы — ЕБ жөнгө салууларында recitals жана operative provisions бирдей тилдик register менен иштебейт. Recitals укуктук жактан милдеттүү regulation ичинде болсо да, modality жагынан soft-law документтерине окшош. Operative provisions болсо жогорку deontic күч менен, өзгөчө “shall” борборлуу binding language түзөт.
Экинчи жыйынтык — document-level анализ жаңылыштыкка алып келиши мүмкүн. EU AI Actтин толук тексти бир орточо маани менен каралганда, recitals бөлүктөрүнүн жумшактыгы менен operative provisions катуулугу аралашып кетет. Анда recitals чыныгы тону да, operative provisions жөнгө салуучу тыгыздыгы да так көрүнбөйт. Ошондуктан укук тилин талдоо section levelди эске алышы керек.
Үчүнчү жыйынтык — industry-signed AI codes классикалык soft-law документтери сыяктуу окулбашы керек. White House Voluntary Commitments жана GPAI Code of Practice бөлүктөрү жогорку commissive density көрсөтөт. Башкача айтканда, бул документтер буйрук берүүнүн ордуна кол койгон тарап өзүн аракетке байлаган тилди колдонот. Укуктук жактан ыктыярдуу болушу тилдик жактан алсыз дегенди билдирбейт.
Төртүнчү жыйынтык — speech-act force укуктук күчтөн ажырай алат. Текст укуктук жактан күчтүү, бирок айрым бөлүктөрү тилдик жактан жумшак болушу мүмкүн. Текст укуктук жактан ыктыярдуу, бирок тилдик жактан күчтүү commitment түзө алат. Бул эки багыттуу ажырым AI governance тексттерин “милдеттүү/милдеттүү эмес” деп гана бөлүүнүн жетишсиз экенин көрсөтөт.
Бешинчи жыйынтык — interpretive documents ичинде assertive жана declaration чегин методологиялык жактан ажыратуу кыйын. Сүйлөм бир эле surface formга ээ болсо да, негизги regulation ичинде турганда укуктук реалдуулукту түзө алат; interpretive guide ичинде турганда болсо учурдагы укуктук абалды гана түшүндүрүшү мүмкүн. Ошондуктан тексттин институттук орду speech-act классификациясында аныктоочу фактор.
Бул эмне үчүн маанилүү?
Бул изилдөө жасалма интеллект governanceти мазмун же укуктук деңгээл аркылуу гана эмес, тилдик функция аркылуу да окуу керек экенин көрсөтөт. Документ “ethical principle”, “law”, “voluntary commitment” же “guideline” болушу мүмкүн; бирок анын чыныгы жөнгө салуучу таасири сүйлөмдөр кантип буйрук берип, кантип аныктама түзүп, кантип убада берип же кантип түшүндүрүп жатканы менен тыгыз байланыштуу.
AI regulations тез көбөйүп жатканда бул айырма маанилүү болуп калат. Компаниялар, мамлекеттер, ЕБ институттары, standard-setting bodies жана intergovernmental structures ар башка текст түрлөрүн чыгарат. Бул тексттердин баары “AI governance” экосистемасынын бөлүгү, бирок ар бири ар башка тилдик механизм аркылуу иштейт. Айрымдары түз милдет жүктөйт; айрымдары түшүндүрмө берет; айрымдары жалпы принцип жарыялайт; айрымдары компанияларды өз сөзү менен өзүнө байлайт.
Укук тили жагынан изилдөө preambular text, башкача айтканда recitals/introduction бөлүктөрүн талдоодо көз жаздымда калтырбоо керек экенин көрсөтөт. Recitals түздөн-түз binding provisions болбошу мүмкүн, бирок regulationдун максат, баалуулук жана интерпретация алкагын түзөт. Ошондуктан алардын soft-law документтерине окшош modal profile көрсөтүшү теориялык жактан маанилүү.
AI governance жагынан болсо industry commitments башкача жөнгө салуучу күч алып жүрө алары көрүнөт. “Биз жасайбыз” же “кол койгондор commitment алышат” деген тил классикалык мыйзам буйругу эмес. Бирок коомдук күтүүлөр, reputation pressure, co-regulation жана келечектеги аудит мамилелеринин ичинде реалдуу governance функциясын аткара алат.
Verianla көз карашынан бул макала regulatory texts укукчулар үчүн гана эмес, лингвисттер жана коомдук илимдер үчүн да маанилүү маалымат мейкиндиги экенин көрсөтөт. AI governanceти түшүнүү үчүн беренелерге гана кароо жетишсиз; текст кайсы speech act менен сүйлөп жатканына да кароо керек.
Эске алынуучу жагдайлар
Изилдөө preprint жана рецензиядан өтө элек. Ошондуктан ыкма, маалымат тандоо, классификатор эрежелери жана жыйынтык интерпретациялары академиялык кароо учурунда өзгөрүшү же өнүгүшү мүмкүн.
Корпус англис тилиндеги документтер менен чектелген. Бул өзгөчө ЕБ regulations үчүн маанилүү, анткени EU AI Act жана GDPR көп тилде укуктук жактан жарактуу тексттерге ээ. Англис тилиндеги “should” жана “shall” айырмасы француз же немис тилдеринде так эле ошондой көрүнбөшү мүмкүн. Автор да ушул себептен cross-lingual validation зарыл экенин белгилейт.
Hard-law салыштыруу болгону үч binding textке таянат. Бул жыйынтыктарды бардык укуктук тексттерге жалпылоону чектейт. Кеңири салыштыруу үчүн ар башка өлкөлөрдөн жана тармактардан көбүрөөк binding AI же digital regulation texts кошулушу керек.
Industry-signed codes боюнча табылга күчтүү көрүнгөнү менен effective sample кичине. White House Voluntary Commitments бир контекст, GPAI Code of Practice бөлүктөрү болсо ошол эле EU AI Act Article 56 процессинен чыккан жакын документтер. Ошондуктан “бардык industry codes ушундай” деген жыйынтык чыгарылбашы керек.
Rule-based классификатор auditability берет; бирок укук тили татаал жана көп функциялуу. Айрым сүйлөмдөр бир учурда аныктама да түзүп, буйрук да бере алат. Single-label классификация практикалык чечим, бирок multi-label же graded models келечекте байыраак жыйынтыктарды бере алат.
Бул мазмун укуктук кеңеш эмес. AI governance документтеринин binding nature, enforcement power жана legal effect тиешелүү өлкө, институт, документ түрү жана күчүнө кирүү шарттарына жараша бааланышы керек.
Жыйынтык
Макала AI governance тексттеринде укуктук күч менен speech-act күчү дайыма дал келбесин көрсөткөн кызыктуу corpus-pragmatic изилдөө сунуштайт. ЕБ regulations recitals бөлүктөрү укуктук тексттин ичинде турганына карабастан soft-law документтерине окшош modal profile көрсөтүшү мүмкүн. Operative provisions болсо кыйла күчтүү милдеттендирүү тили менен иштейт.
Экинчи жагынан, укуктук жактан ыктыярдуу көрүнгөн industry-signed AI codes күчтүү commitment тилин түзө алат. Бул документтерде regulatory function түз буйрук аркылуу эмес, кол койгон тараптардын өздөрүн келечектеги аракеттерге байлашы аркылуу жүрөт. Ошондуктан жасалма интеллект governance документтерин hard/soft law сызыгына гана жайгаштыруу менен түшүнүү мүмкүн эмес.
Изилдөөнүн эң маанилүү билдирүүсү мындай: Regulatory texts укуктук статусу менен гана эмес, тилдик актылары менен да иштейт. Текст канчалык милдеттүү деген суроо сыяктуу эле, кайсы сүйлөмдөр менен буйрук берери, кайсы сүйлөмдөр менен commitment түзөрү, кайсы сүйлөмдөр менен түшүндүрмө берери жана кайсы бөлүмдө кайсы modality күчүн колдонору да маанилүү.
Verianla үчүн бул изилдөө жасалма интеллект governance талкуусунда тил техникалык майда-чүйдө эмес, regulatory power өзү өтүп турган негизги курал экенин көрсөтөт. Мыйзам беренелери, recitals, principles жана company commitments бир эле мейкиндикте сүйлөйт, бирок бирдей speech act менен сүйлөбөйт.
Булак жана Ыкма Жөнүндө Эскертүү
Бул макала Kunming Li даярдаган “Legal vs. speech-act force in codes and statutes of AI governance” аттуу preprint изилдөөнүн негизинде даярдалды. Изилдөө AI governance документтери, speech acts, deontic modality, commissive commitment language, ЕБ regulations recitals-operative provisions айырмасы, industry-signed AI codes, rule-based classification жана corpus-pragmatic methods темаларын бирге карайт.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianla жарыялоо багытына ылайык жөнөкөйлөштүрүлүп, өз алдынча кыргызча редакциялык макалага айландырылган.
Текст рецензиядан өтпөгөн preprint негизинде даярдалгандыктан, аны так академиялык консенсус же укуктук чечмелөө катары окууга болбойт. Укуктук колдонмолор үчүн актуалдуу мыйзамдар жана эксперттик пикир эске алынышы керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген