

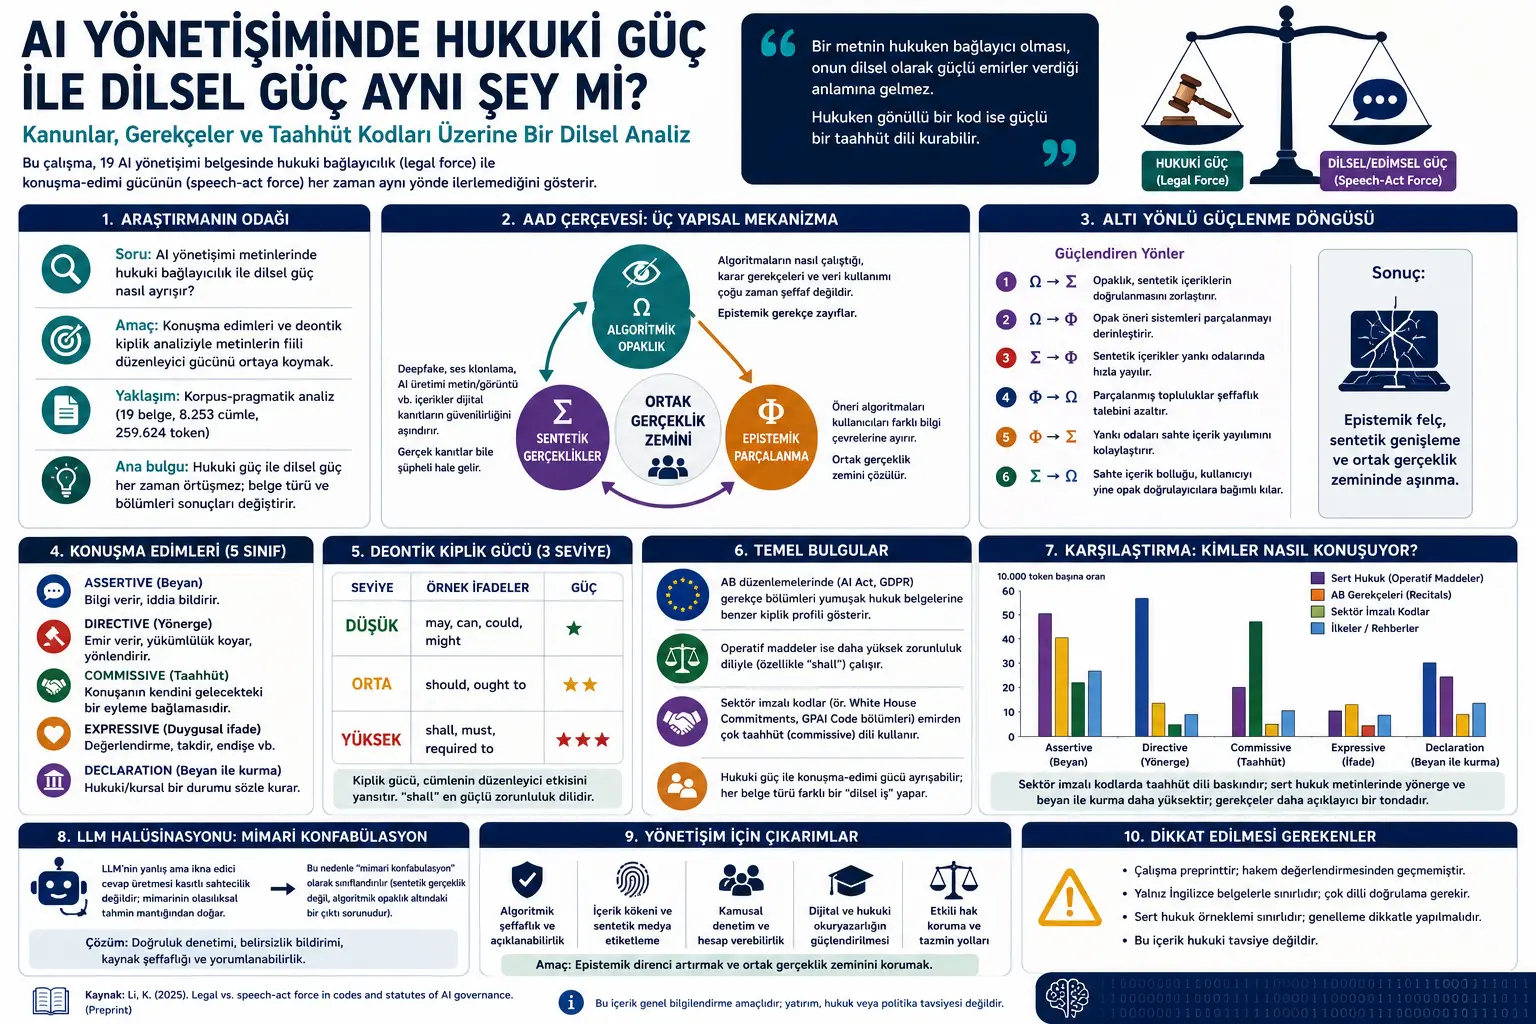
Bu tədqiqat süni intellekt idarəetməsi, hüquq dili, praqmatika, korpus dilçiliyi və tənzimləyici mətn təhlili sahələrinin kəsişməsində yerləşən preprint məqalədir. Mətndə tədqiqatın resenziyadan keçmədiyi açıq şəkildə bildirilir. Buna görə iş yekunlaşmış resenziyalı nəşr kimi deyil, süni intellekt idarəetmə sənədlərinin dil baxımından necə işlədiyini araşdıran aktual və müzakirəyə açıq tədqiqat kimi oxunmalıdır.
Məqalənin əsas sualı budur: AI idarəetmə mətninin hüquqi baxımdan məcburi olması onun dil baxımından da güclü əmrlər verdiyi mənasına gəlirmi? Yaxud hüquqi baxımdan məcburi olmayan sektor kodeksi dil baxımından güclü öhdəlik dili qura bilərmi? Müəllif bu suallara sadəcə “bəli/xeyr” səviyyəsində deyil, mətn daxilindəki nitq aktları və modallıq paylanmaları üzərindən cavab axtarır.
Nitq aktı cümlənin yalnız məlumat ötürməklə kifayətlənməyib eyni zamanda bir əməl yerinə yetirməsidir. Məsələn, “bunu etmək məcburiyyətindəsən” yönləndirmə; “bunu etməyi öhdəmizə götürürük” öhdəlik; “bu anlayış bu məna daşıyır” isə hüquqi tərif yaradan bəyan ola bilər. Deontik modallıq məcburiyyət, icazə, zərurət və tövsiyə kimi tənzimləyici dil güclərini ifadə edir. İngilis hüquq dilində “shall”, “must”, “should”, “may” kimi ifadələr bu baxımdan vacibdir.
Bu məzmun hüquqi məsləhət deyil. AI Act, GDPR, Colorado AI Act, GPAI Code of Practice və ya oxşar tənzimləyici sənədlərlə bağlı tətbiq qərarları üçün aktual qanunvericilik, səlahiyyətli qurumların açıqlamaları və hüquq ekspertizası nəzərə alınmalıdır.
Məqalə süni intellekt idarəetmə sənədlərinin yalnız nə dediyini deyil, necə dediyini araşdırır. Tədqiqatın əsas iddiası hüquqi məcburilik ilə nitq-aktı gücünün bir-birindən ayrıla bilməsidir. Mətn hüquqi baxımdan məcburi ola bilər, lakin bəzi bölmələri dil baxımından yumşaq, izahlı və ya əsaslandırıcı tonda qala bilər. Əksinə, hüquqi baxımdan könüllü olan sektor kodeksi şirkətləri birbaşa “biz edəcəyik” və ya “öhdəlik götürürük” dili ilə güclü şəkildə özünü bağlama vəziyyətinə gətirə bilər.
Tədqiqat 19 AI idarəetmə sənədindən ibarət korpusdan istifadə edir. Korpusa AB Süni İntellekt Aktı, GDPR, Colorado AI Act, White House Voluntary Commitments, General-Purpose AI Code of Practice bölmələri, OECD prinsipləri, NIST çərçivələri, HLEG etik təlimatları və Avropa Komissiyasının şərhedici sənədləri kimi müxtəlif mətn növləri daxildir.
Müəllifin müəyyən etdiyi iki əsas ayrışma diqqət çəkir. Birincisi, AB tənzimləmələrində əsaslandırma bölmələri, yəni recitals, hüquqi baxımdan məcburi mətnin daxilində olsa da modallıq baxımından yumşaq hüquq sənədlərinə bənzəyir. Operativ maddələr isə “shall” kimi yüksək məcburiyyət dili ilə daha sərt tənzimləyici registr yaradır. İkincisi, sektor tərəfindən imzalanmış AI kodeksləri hüquqi baxımdan könüllü görünsə də, “Companies will…” və “Signatories commit to…” kimi ifadələrlə güclü özünü bağlama dili qurur.
Problem Nədir?
Hüquq və tənzimləmə mətnləri çox vaxt “sərt hüquq” və “yumşaq hüquq” fərqi ilə oxunur. Sərt hüquq məcburi qanun, akt və ya qaydalar kimi mətnləri ifadə edir. Yumşaq hüquq isə təlimat, prinsip, etik çərçivə, könüllü öhdəlik və ya siyasət sənədi kimi birbaşa məcburi olmayan mətnləri əhatə edir. Lakin bu fərq həmişə mətnin dil baxımından necə işlədiyini izah etmir.
Məqalənin ələ aldığı əsas problem hüquqi güc ilə nitq-aktı gücünün qarışdırılmasıdır. Hüquqi güc mətnin rəsmi hüquq sistemi daxilində nə dərəcədə məcburi olması ilə bağlıdır. Nitq-aktı gücü isə mətnin dili ilə nə etdiyini göstərir: əmr verir, tərif yaradır, prinsip açıqlayır, öhdəlik yaradır, yoxsa yalnız məlumat ötürür?
Bu fərq AI idarəetməsi sahəsində xüsusilə vacibdir. Çünki süni intellekt tənzimlənməsi yalnız klassik qanun maddələrindən ibarət deyil. Etik prinsiplər, şirkət öhdəlikləri, könüllü kodekslər, AB tənzimləmələrinin recitalları, şərhedici təlimatlar və birgə tənzimləmə sənədləri eyni sahədə yanaşı mövcuddur. Bu sənədlərin hamısı “AI idarəetməsi”nə aiddir, lakin eyni dil funksiyasını yerinə yetirmir.
Məsələn, AB AI Act-in operativ maddələri “bu öhdəlik tətbiq olunur” kimi yüksək məcburiyyət dili ilə işləyə bilər. Eyni mətnin recitalları isə “üzv dövlətlər bunu nəzərə almalıdır” kimi daha izahlı və ya istiqamətləndirici ton işlədə bilər. Oxşar şəkildə, hüquqi baxımdan könüllü şirkət öhdəliyi “şirkətlər bunu edəcək” dedikdə klassik əmr verməsə də, güclü kollektiv sözvermə təsiri yarada bilər.
Metod Nə Təklif Edir?
Tədqiqat korpus-praqmatik metoddan istifadə edir. Korpus müəyyən tədqiqat məqsədi ilə toplanmış mətn toplusudur. Bu məqalədə korpus 19 AI idarəetmə sənədindən ibarətdir. Ümumi analiz məlumatı 8.253 cümlə və 259.624 token kimi göstərilir. Token dil emalı tədqiqatlarında söz, durğu işarəsi və ya mənalı mətn parçası kimi sayıla bilən vahidə verilən addır.
Müəllif sənədləri üç əsas ox üzrə təsnif edir: sərt hüquq/yumşaq hüquq fərqi, sektor tərəfindən imzalanıb-imzalanmaması və sənəd növü. Bundan əlavə, AB AI Act və GDPR kimi AB tənzimləmələri recitallar və operativ maddələr kimi ayrılır. Bu fərq vacibdir, çünki eyni hüquqi sənədin müxtəlif bölmələri fərqli dil gücü ilə işləyə bilər.
Mətnlərdəki nitq aktları qayda əsaslı və parser dəstəkli təsnifatçı ilə etiketlənir. Qayda əsaslı yanaşma modelin hansı cümləni niyə hansı sinfə yerləşdirdiyinin izlənməsinə imkan verir. Bu, xüsusilə hüquq dili kimi audit edilə bilmənin vacib olduğu sahələrdə üstünlükdür.
Təsnifatçı beş əsas nitq aktı sinfindən istifadə edir: assertive, directive, commissive, expressive və declaration. Assertive məlumat verən və ya iddia bildirən cümlələrdir. Directive oxucuya və ya ünvana nəsə etdirməyə çalışan əmr, məcburiyyət və ya istiqamətləndirmə cümlələridir. Commissive danışanın özünü gələcək hərəkətə bağladığı öhdəlik cümlələridir. Expressive qiymətləndirmə və ya hiss bildirən ifadələrdir. Declaration isə hüquqi və ya institusional vəziyyəti söz vasitəsilə yaradan bəyanlardır.
Tədqiqat həmçinin modallıq gücünü aşağı, orta və yüksək diapazonlara ayırır. “May”, “can”, “could” aşağı; “should” və “ought to” orta; “shall”, “must” və “required to” yüksək deontik güc kimi qiymətləndirilir. Bununla mətnlərin yalnız hansı nitq aktından istifadə etdiyi deyil, həmin aktı hansı güclə icra etdiyi də ölçülür.
Formullar Nəyi İzah Edir?
Bu tədqiqat riyazi nəzəriyyə qurmaqdan daha çox dil təsnifatı və statistik müqayisə aparır. Bununla belə, metodu anlamaq üçün bəzi əsas hesablamalar və işarələmələr vacibdir. Aşağıdakı MathJax blokları tədqiqatdakı əsas ölçmə məntiqini CMS-uyğun şəkildə ümumiləşdirir.
Bu ifadə tədqiqatın məlumat kainatını göstərir. Korpusa sərt hüquq tənzimləmələri, sektor tərəfindən imzalanmış kodekslər, prinsiplər, etik təlimatlar, əməliyyat çərçivələri və şərhedici sənədlər birlikdə daxildir.
Bu sxem təsnifatçının hər cümləni beş əsas nitq aktı kateqoriyasından birinə yerləşdirdiyini göstərir. Hüquq dili çox vaxt eyni anda birdən çox funksiya daşıya bilər; tədqiqat praktik analiz üçün tək etiketli qərar ağacından istifadə edir.
Bu formul deontik modallıq gücünün üçsəviyyəli ölçülməsini izah edir. Aşağı modallıq icazə və ya ehtimal; orta modallıq tövsiyə və ya zərurət; yüksək modallıq isə güclü məcburiyyət və ya bağlayıcı əmr təsiri yaradır.
Bu hesablama müxtəlif uzunluqdakı sənədlərin müqayisəsi üçün nitq aktı nisbətlərinin 10.000 tokenə görə normallaşdırıldığını göstərir. Beləliklə, qısa sənədlə uzun akt daha ədalətli müqayisə edilə bilir.
Bu qısa ifadə tədqiqatın əsas tezisini ümumiləşdirir. Mətnin hüquqi baxımdan məcburi olması hər bölməsinin eyni dil gücü ilə əmr verdiyi mənasına gəlmir. Eyni şəkildə, hüquqi baxımdan könüllü mətn də güclü öhdəlik dili ilə yüksək nitq-aktı gücü yarada bilər.
Bu ifadə AB tənzimləmələrinin recitallarının modallıq baxımından yumşaq hüquq sənədlərinə yaxın olduğunu göstərir. Məqalədə EU AI Act və GDPR recitallarının modal güc ortalaması təxminən 1.97–1.99 olduğu halda, operativ maddələrdə bu dəyər təxminən 2.72–2.75 səviyyəsinə yüksəlir.
Bu sxem sektor tərəfindən imzalanmış sənədlərdə əmr dilindən daha çox öhdəlik dilinin üstün olduğunu göstərir. “Companies will…” və “Signatories commit to…” kimi quruluşlar tənzimləyici funksiyanı əmr vasitəsilə deyil, sözvermə və özünü bağlama yolu ilə yaradır.
Bu statistikalar metodun etibarlılığını izah edir. Cohen’s kappa iki insan annotatorun nə dərəcədə tutarlı işlədiyini göstərir. F1 göstəricisi isə təsnifatçının dəqiqliyini və aşkarlama uğurunu birlikdə ölçür. Commissive sinfindəki yüksək F1 dəyəri tədqiqatın sektor kodeksləri ilə bağlı əsas öhdəlik nəticəsinin təsnifatçı xətasına qarşı daha davamlı olduğunu göstərir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
İlk əsas cədvəl yumşaq hüquq və sərt hüquq müqayisəsini verir. Sərt hüquq mətnləri daha yüksək modallıq gücü, daha çox declaration və daha sıx directive dili göstərir. Bunun əksinə, yumşaq hüquq sənədlərində assertive, yəni izahlı/məlumatverici cümlələrin sıxlığı daha yüksəkdir. Lakin bu cədvəl təkbaşına bütün mənzərəni göstərmir, çünki yumşaq hüquq qrupu daxilində sektor tərəfindən imzalanmış kodekslər çox fərqli dil profili nümayiş etdirir.
İkinci əsas cədvəl AB tənzimləmələrində recitallar və operativ maddələr arasındakı fərqi göstərir. EU AI Act və GDPR-də recitalların modallıq gücü təxminən 1.97–1.99 intervalındadır. Operativ maddələrdə isə dəyər təxminən 2.72–2.75-ə yüksəlir. Bu, eyni hüquqi sənəd daxilində iki ayrı dil registrinin olduğunu göstərir. Recitallar daha çox “should” və “may” ətrafında dövr etdiyi halda, operativ maddələr “shall” ətrafında cəmlənir.
Üçüncü cədvəl sektor tərəfindən imzalanmış sənədlərlə digər sənədlər arasındakı fərqi göstərir. Sektor imzalı sənədlərdə commissive nisbəti yüksək, directive nisbəti aşağıdır. Başqa sözlə, bu sənədlər “siz bunu etməlisiniz” deməkdən daha çox “biz bunu edəcəyik” və ya “imzaçılar bunu öhdələrinə götürür” dili ilə işləyir. Bu, klassik hüquqi mətn təhlilində daha az diqqət görən tənzimləyici güc formasıdır.
Principal component analysis vizuallaşdırması 19 sənədi beş xüsusiyyətli matris üzərində klasterlər şəklində yerləşdirir. Üç əsas qrup görünür: məcburi tənzimləmələr, sektor tərəfindən imzalanmış sənədlər və prinsip/çərçivə tipli izahlı sənədlər. Müəllif oxları həddindən artıq şərh etmir; vacib məqamın xüsusilə sektor imzalı sənədlərin metodlar arasında ardıcıl şəkildə ayrıca klaster yaratması olduğunu bildirir.
Əlavə cədvəllərdə korpusun sənəd bölgüsü ətraflı göstərilir. EU AI Act, GDPR və Colorado AI Act sərt hüquq tərəfini; White House Voluntary Commitments və GPAI Code of Practice bölmələri sektor imzalı kodeksləri; HLEG, OECD, NIST, OSTP və Avropa Komissiyasının sənədləri isə müxtəlif yumşaq hüquq, əməliyyat çərçivəsi və şərhedici sənəd növlərini təşkil edir.
Təcrübələr Necə Aparılıb?
Bu tədqiqat laboratoriya təcrübəsi deyil, korpus əsaslı dil təhlili və statistik müqayisə işidir. İlk mərhələdə 19 AI idarəetmə sənədi toplanıb, sadə mətnə çevrilib və cümlələrə ayrılıb. Çox qısa və ya çox uzun cümlələr, cədvəl qalıqları və səhifə düzənindən yaranan qalıq parçalar təhlildən çıxarılıb.
İkinci mərhələdə cümlələr nitq aktı siniflərinə ayrılıb. Bunun üçün spaCy əsaslı parsing, deontik operator lüğətləri, commissive feilləri, declaration formulları və qərar ağacından istifadə olunub. Qərar ağacında əvvəl declaration, sonra commissive, expressive, directive və assertive sinifləri gəlir. Bu sıralama bəzi hüquq cümlələrinin eyni anda birdən çox funksiya daşıya bilməsi səbəbindən seçilib.
Üçüncü mərhələdə 300 cümləlik alt nümunə iki müstəqil dilçi annotator tərəfindən qiymətləndirilib. Annotatorlararası etibarlılıq yüksək olub. Daha sonra qayda əsaslı təsnifatçının bu insan etiketləri ilə nə dərəcədə uyğunluğu ölçülüb. Xüsusilə commissive sinfindəki yüksək uğur sektor imzalı sənədlərdəki öhdəlik sıxlığı nəticəsini dəstəkləyir.
Dördüncü mərhələdə sənədlər qrup müqayisələrinə daxil edilib. Əvvəlcədən müəyyənləşdirilmiş əsas müqayisə yumşaq hüquq və sərt hüquq fərqidir. Bundan əlavə, sektor imzalı sənədlərlə digər sənədlər müqayisə edilib, sonra sektor sənədləri çıxarılaraq prinsiplər/təlimatlar ilə məcburi tənzimləmələr müqayisə olunub.
Beşinci mərhələdə AB tənzimləmələri bölmə səviyyəsində ayrılıb. Recitallar ilə operativ maddələr ayrıca hesablanıb və modal güc, directive nisbəti, declaration nisbəti kimi ölçülər müqayisə edilib. Bu bölmə səviyyəli təhlil məqalənin ən mühüm töhfələrindən biridir, çünki sənəd səviyyəli ortalamaların real dil fərqini gizlədə biləcəyini göstərir.
Nəticələr Nə Göstərir?
Tədqiqatın ilk əsas nəticəsi AB tənzimləmələrində recitalların və operativ maddələrin eyni dil registri ilə işləməməsidir. Recitallar hüquqi baxımdan məcburi tənzimləmənin daxilində yerləşsə də modallıq baxımından yumşaq hüquq sənədlərinə bənzəyir. Operativ maddələr isə yüksək deontik güclə, xüsusilə “shall” mərkəzli məcburi dil qurur.
İkinci nəticə sənəd səviyyəsində aparılan təhlillərin yanıltıcı ola bilməsidir. EU AI Act-in bütün mətni tək orta dəyərlə araşdırıldıqda recitalların yumşaqlığı ilə operativ maddələrin sərtliyi bir-birinə qarışır. Bu halda nə recitalların real tonu, nə də operativ maddələrin tənzimləyici sıxlığı aydın görünür. Buna görə hüquq dili təhlili bölmə səviyyəsini nəzərə almalıdır.
Üçüncü nəticə sektor tərəfindən imzalanmış AI kodekslərinin klassik yumşaq hüquq sənədləri kimi oxuna bilməməsidir. White House Voluntary Commitments və GPAI Code of Practice bölmələri yüksək commissive sıxlığı göstərir. Yəni bu sənədlər əmr vermək əvəzinə imzaçının özünü gələcək hərəkətə bağladığı dil işlədir. Hüquqi baxımdan könüllü olmaları dil baxımından zəif olduqları demək deyil.
Dördüncü nəticə nitq-aktı gücünün hüquqi gücdən ayrıla bilməsidir. Mətn hüquqi baxımdan güclü ola bilər, lakin bəzi bölmələri dil baxımından daha yumşaq qala bilər. Mətn hüquqi baxımdan könüllü ola bilər, lakin dil baxımından güclü öhdəliklər yarada bilər. Bu ikitərəfli ayrışma AI idarəetmə mətnlərini yalnız “məcburi/məcburi deyil” kimi ayırmağın yetərsiz olduğunu göstərir.
Beşinci nəticə şərhedici sənədlərdə assertive və declaration sərhədinin metodoloji baxımdan çətin olmasıdır. Cümlə eyni səthi formaya malik olsa belə, əsas tənzimləmədə yer aldıqda hüquqi reallıq yarada bilər; şərhedici təlimatda yer aldıqda isə yalnız mövcud hüquqi vəziyyəti izah edə bilər. Buna görə mətnin institusional mövqeyi nitq aktı təsnifatında həlledicidir.
Bu Niyə Vacibdir?
Bu tədqiqat süni intellekt idarəetməsini yalnız məzmun və ya hüquqi səviyyə üzərindən deyil, dil funksiyası üzərindən də oxumalı olduğumuzu göstərir. Sənəd “etik prinsip”, “qanun”, “könüllü öhdəlik” və ya “təlimat” ola bilər, lakin onun real tənzimləyici təsiri cümlələrin necə əmr verdiyi, necə tərif qurduğu, necə söz verdiyi və ya necə izah etdiyi ilə sıx əlaqəlidir.
AI tənzimləmələri sürətlə artdıqca bu fərq daha da vacib olur. Şirkətlər, dövlətlər, AB institutları, standart qurumları və hökumətlərarası strukturlar fərqli mətn növləri yaradır. Bu mətnlərin hamısı “AI idarəetməsi” ekosisteminin hissəsidir, lakin hər biri fərqli dil mexanizmi ilə işləyir. Bəzisi birbaşa öhdəlik qoyur, bəzisi şərh verir, bəzisi ortaq prinsip bəyan edir, bəzisi isə şirkətləri öz sözləri ilə bağlayır.
Hüquq dili baxımından tədqiqat preambular text, yəni recitallar/giriş bölmələrinin təhlildə nəzərdən qaçırılmamalı olduğunu göstərir. Recitallar birbaşa məcburi müddəalar olmaya bilər, lakin tənzimləmənin məqsədini, dəyərlərini və şərh çərçivəsini qurur. Buna görə onların yumşaq hüquq sənədlərinə bənzər modal profil göstərməsi nəzəri baxımdan vacibdir.
AI idarəetməsi baxımından isə sektor öhdəliklərinin fərqli tənzimləyici güc daşıya bildiyi görünür. “Biz edəcəyik” və ya “imzaçılar öhdəlik götürür” dili klassik qanun əmri deyil. Lakin ictimai gözlənti, reputasiya təzyiqi, birgə tənzimləmə və gələcək nəzarət münasibətləri daxilində real idarəetmə funksiyası yerinə yetirə bilər.
Verianla baxımından bu məqalə tənzimləyici mətnlərin yalnız hüquqşünaslar üçün deyil, dilçilər və sosial elm mütəxəssisləri üçün də mühüm məlumat sahəsi olduğunu göstərir. AI idarəetməsini anlamaq üçün yalnız maddələrə baxmaq kifayət deyil; mətnin hansı aktla danışdığına da baxmaq lazımdır.
Diqqət Nöqtələri
Tədqiqat preprintdir və resenziyadan keçməyib. Buna görə metod, məlumat seçimi, təsnifatçı qaydaları və nəticə şərhləri akademik qiymətləndirmə prosesində dəyişə və ya təkmilləşdirilə bilər.
Korpus ingilisdilli sənədlərlə məhdudlaşır. Bu, xüsusilə AB tənzimləmələri baxımından vacibdir, çünki EU AI Act və GDPR bir çox dildə hüquqi qüvvəyə malik mətnlərə sahibdir. İngilis dilindəki “should” və “shall” fərqi fransızca və ya almanca kimi dillərdə tam eyni şəkildə görünməyə bilər. Müəllif də buna görə dillərarası doğrulamanın lazım olduğunu bildirir.
Sərt hüquq müqayisəsi yalnız üç məcburi mətnə əsaslanır. Bu, nəticələrin bütün hüquq mətnlərinə ümumiləşdirilməsini məhdudlaşdırır. Daha geniş müqayisə üçün fərqli ölkələrdən və sektorlardan daha çox məcburi AI və ya rəqəmsal tənzimləmə mətni əlavə edilməlidir.
Sektor imzalı kodekslər üçün nəticə güclü görünsə də effektiv nümunə kiçikdir. White House Voluntary Commitments tək kontekstdir; GPAI Code of Practice bölmələri isə eyni AB AI Act Article 56 prosesindən yaranan yaxın sənədlərdir. Buna görə “bütün sektor kodeksləri belədir” nəticəsi çıxarılmamalıdır.
Qayda əsaslı təsnifatçı audit edilə bilmə təmin edir, lakin hüquq dili mürəkkəb və çoxfunksiyalıdır. Bəzi cümlələr eyni anda həm tərif yarada, həm də əmr verə bilər. Tək etiketli təsnifat praktik həll təqdim edir, lakin çoxetiketli və ya dərəcəli modellər gələcəkdə daha zəngin nəticələr verə bilər.
Bu məzmun hüquqi məsləhət deyil. AI idarəetmə sənədlərinin məcburi xarakteri, tətbiq gücü və hüquqi təsiri müvafiq ölkə, qurum, sənəd növü və qüvvədə olma şərtlərinə görə qiymətləndirilməlidir.
Nəticə
Məqalə AI idarəetmə mətnlərində hüquqi güc ilə nitq-aktı gücünün həmişə üst-üstə düşmədiyini göstərən diqqətəlayiq korpus-praqmatik tədqiqat təqdim edir. AB tənzimləmələrinin recitalları hüquqi mətnin daxilində olsa da dil baxımından daha yumşaq registr yarada bilər; operativ maddələr isə daha yüksək məcburiyyət gücü ilə işləyir.
Digər tərəfdən, hüquqi baxımdan könüllü görünən sektor imzalı AI kodeksləri güclü öhdəlik dili qura bilər. Bu sənədlərdə tənzimləyici iş birbaşa əmrlə deyil, imzaçıların özlərini gələcək hərəkətlərə bağlaması ilə həyata keçirilir. Buna görə “yumşaq hüquq” dil baxımından həmişə yumşaq deyil.
Tədqiqatın ən vacib mesajı budur: Tənzimləyici mətnlər yalnız hüquqi statusları ilə deyil, dil aktları ilə də işləyir. Mətnin nə qədər məcburi olması sualı qədər, hansı cümlələrlə əmr verdiyi, hansı cümlələrlə öhdəlik yaratdığı, hansı cümlələrlə tərif və izah qurduğu da vacibdir.
Verianla üçün bu tədqiqat süni intellekt idarəetməsi müzakirələrində dilin texniki detal deyil, tənzimləyici gücü daşıyan əsas vasitə olduğunu göstərir. Qanun maddələri, recitallar, prinsiplər və şirkət öhdəlikləri eyni idarəetmə sahəsində fərqli dil alətləri ilə işləyir.
Mənbə və Metod Qeydi
Bu yazı Kunming Li tərəfindən hazırlanmış “Legal vs. speech-act force in codes and statutes of AI governance” başlıqlı preprint tədqiqat əsasında hazırlanıb. Tədqiqat AI idarəetmə sənədləri, nitq aktları, deontik modallıq, sərt hüquq/yumşaq hüquq fərqi, AB tənzimləmələrinin recitalları, operativ maddələr, sektor imzalı kodekslər və korpus-praqmatik metodları birlikdə nəzərdən keçirir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal Azərbaycan dilli redaksiya məqaləsinə çevrilib.
Mətn resenziyadan keçməmiş preprint əsasında hazırlandığı üçün yekun akademik konsensus və ya hüquqi şərh kimi oxunmamalıdır. Hüquqi tətbiqlər üçün aktual qanunvericilik və mütəxəssis rəyi nəzərə alınmalıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib