

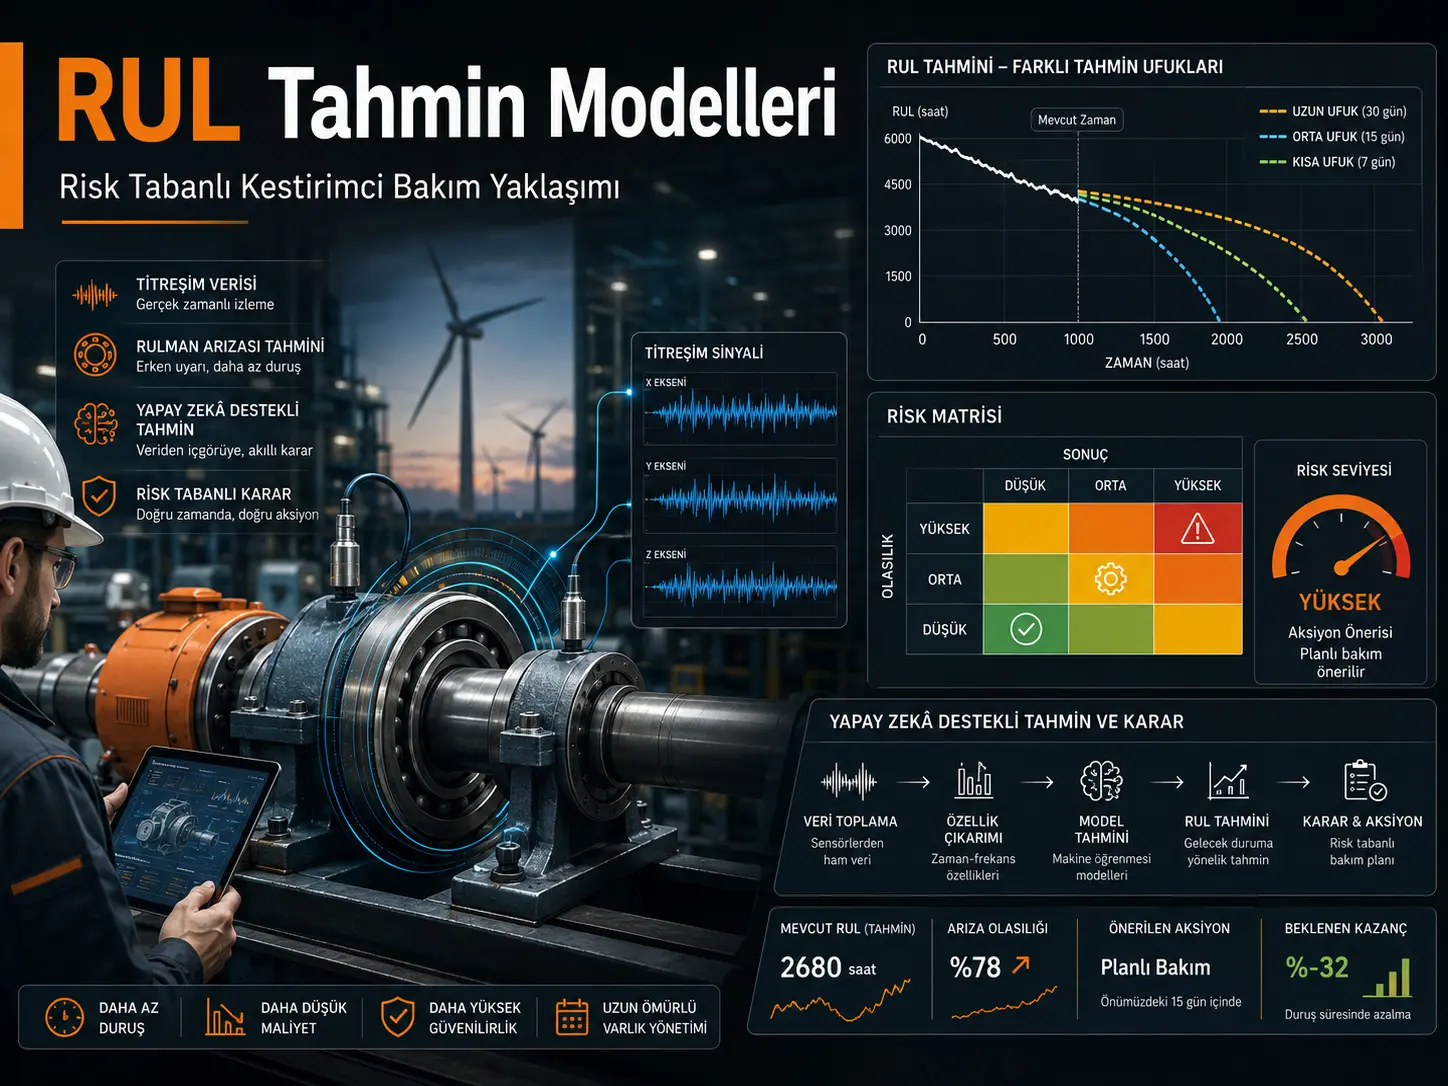
Машинанын качан бузуларын туура болжолдоо болжолдуу тейлөө үчүн өзүнчө жетишсиз болушу мүмкүн. Тейлөө тобу запастык бөлүктөрдү камсыз кылуу, персоналды пландоо, өндүрүштү токтотуу же кийлигишүүгө даярдык көрүшү үчүн болжол жетиштүү эрте келиши да керек. Бул изилдөө Remaining Useful Life (RUL; калган пайдалуу өмүр) моделдерин жалпы ката же тактык маанилери менен гана эмес, бузулууга калган убакыт, башкача айтканда болжолдоо горизонту жана туура эмес болжолдун операциялык натыйжасы менен бирге эске алып баалоону сунуштайт.
Изилдөөдө эки ачык вибрациялык маалымат топтомунда ARIMA, Facebook Prophet, LSTM, GRU жана PatchTST деп жыйынтыкталган беш болжолдоо ыкмасы салыштырылган. Чийки вибрация маалыматтарын кысуу жана белгилерди чыгаруу үчүн бардык моделдерден мурда autoencoder колдонулгандыгы айтылат. Болжолдоо иштеши узак, орто жана кыска болуп үч горизонтто бааланган. Биринчи маалымат топтомунда бул 20 күн окутуу + 30 күн болжол, 40 + 10 жана 47 + 3 күндүк бөлүштүрүүлөр менен аткарылган.
Жыйынтыктар кайсы модель “эң жакшы” экени болжолдоо горизонтуна жараша өзгөрөрүн көрсөтөт. Dataset 1де узак горизонтто Prophet %72,67 менен эң жогорку чыгарылган тактыкты берген, ал эми кыска горизонтто ARIMA %90,63кө жеткен. Dataset 2де узак горизонтто Prophet %86,62, орто горизонтто Таблица 8ге ылайык ARIMA %82,04 жана кыска горизонтто кайрадан ARIMA %98,25 менен эң жогорку маанини берген. Ал эми PatchTST айрыкча Dataset 1дин орто горизонтунда %18,13 жана Dataset 2нин кыска горизонтунда %30,29 менен начар жыйынтыктарды көрсөткөн.
Бул сандардагы “accuracy” классикалык классификация тактыгы эмес. Изилдөөдө \(Accuracy = 100 - MAPE\) түрүндө аныкталган. Бул айырма маанилүү; анткени Dataset 1дин кыска горизонтунда ARIMAнын чыгарылган тактыгы %90,63 болгону менен R² мааниси −0,5988. Башкача айтканда, болжолдордун орточо өлчөм катасы салыштырмалуу төмөн көрүнсө да, модель реалдуу деградация ийри сызыгындагы өзгөрүүнү жетиштүү түшүндүрө албайт.
Изилдөөнүн эң маанилүү методологиялык чектөөсү — болжолдоо горизонту кыскарганда окутуу маалыматтарынын көлөмү да ошол эле учурда көбөйөт. Узун горизонт тажрыйбасында 20 күндүк, кыска горизонт тажрыйбасында 47 күндүк окутуу маалыматы колдонулат. Ошондуктан горизонттор арасындагы иштөө өзгөрүүсүнүн канчасы кыскараак болжолдоо мөөнөтүнөн, канчасы көбүрөөк окутуу маалыматынан келип чыкканын тажрыйба дизайны аркылуу өзүнчө ажыратууга болбойт. Табылгалар “кыска болжолдор бардык шартта такыраак” деген универсалдуу модель мыйзамы катары чечмеленбеши керек.
| Негизги табылга | Булак жыйынтыгы | Илимий чечмелөө |
|---|---|---|
| Узун горизонт тактык аралыгы | %11,64–86,62 | Эрте болжол көбүрөөк пландоо убактысын берет, бирок жыйынтыктар модель жана маалымат топтомуна катуу көз каранды. |
| Орто горизонт тактык аралыгы | %18,13–82,04 | Иштөө кыйла өзгөрмөлүү. |
| Кыска горизонт тактык аралыгы | %30,29–98,25 | Жалпысынан жогору, бирок кийлигишүүгө калган убакыт азыраак. |
| Dataset 1 узун горизонт лидери | Prophet: %72,67 | Эрте пландоо жагынан булак тарабынан өзгөчө белгиленген. |
| Dataset 1 кыска горизонт лидери | ARIMA: %90,63 | Жогорку чыгарылган тактыкка карабастан R² терс. |
| Dataset 2 кыска горизонт лидери | ARIMA: %98,25 | Бул маалымат топтомундагы үч күндүк горизонт жыйынтыгы. |
RUL эмне үчүн тейлөө чечимдеринде маанилүү?
Remaining Useful Life жабдуунун учурдагы абалынан функционалдык бузулуу чекитине чейин калган колдонууга жарактуу убакытты болжолдоого аракет кылат. Максат бузулуу жакындап калганын гана аныктоо эмес, кийлигишүүгө колдонула турган убакыт терезесин баалоо.
Изилдөөнүн негизги жүйөсү ушул себептен абдан практикалык: бузулууга үч күн калганда туура болжол сандык жактан ийгиликтүү көрүнсө да, айрым тейлөө иштерине кеч болуп калышы мүмкүн. Отуз күн мурда бир аз каталуураак, бирок колдонууга боло турган болжол болсо запастык бөлүк, команда, өндүрүш планы жана тейлөө убактысы жагынан баалуураак болушу мүмкүн.
Тобокелдикке негизделген тейлөө менен тобокелдик маалыматына негизделген тейлөөнүн айырмасы эмнеде?
Макаладагы 2-сүрөт эки түшүнүктү ар башка жашоо цикли этаптарына жайгаштырат. Тобокелдикке негизделген болжолдуу тейлөө долбоор этабында кайсы болжолдоо техникасын тандоо керек деген суроого багытталат. Тобокелдик маалыматына негизделген болжолдуу тейлөө болсо система иштеп жатканда, болжол келгенден кийин тейлөөнү качан жүргүзүү керектиги менен байланышат.
Бул изилдөөнүн негизги басымы биринчи көйгөйгө, башкача айтканда болжол моделин системага киргизүүдөн мурда кантип баалоо керектигине багытталган. Модель тандоосу орточо ката маанисине гана эмес, ар башка болжол горизонтторундагы иштөөсүнө жана туура эмес чечимдин натыйжасына таянышы сунушталат.
Эмне үчүн болжолдоо горизонту өзүнчө иштөө өлчөмү?
Макаладагы 3-сүрөт жогорку кыска мөөнөттүү тактык автоматтык түрдө эң пайдалуу моделди бербестигин концептуалдык көрсөтөт. Тактык бир огунда, убакыт/натыйжа деңгээли башка огунда каралат. Ошентип төмөн тактык–жогорку натыйжа оордугу айкалышы эң тобокелдүү аймак катары чечмеленет.
Изилдөө 30 күн калганда пайда болгон болжол катасын төмөн натыйжа деңгээли, 10 күн калганда орто жана 3 күн калганда жогорку натыйжа деңгээли менен байланыштырат. Бул деңгээлдер универсалдуу стандарт эмес; авторлор аларды шамал фермасы активдерин башкарууга байланышкан практикалык божомолдор катары колдонушат.
Кайсы RUL модель үй-бүлөлөрү талкууланат?
Макаланын 1-сүрөтүндөгү дарак RUL болжол моделдерин статистикалык/ишенимдүүлүккө негизделген, машиналык үйрөнүү, терең үйрөнүү жана физикага негизделген ыкмалар болуп кеңири топторго бөлөт. Мындан тышкары бул топтордун компоненттерин бириктирген гибрид моделдер өзүнчө катмар катары көрсөтүлөт.
Эксперименттик салыштырууда беш ыкма колдонулган: ARIMA, Facebook Prophet, LSTM, GRU жана булактагы гиперпараметр таблицасында “PatchTST-inspired” деп аталган Transformer-негизиндеги ыкма. Натыйжа бөлүмдөрүндө акыркы модель кыскача PatchTST деп аталат; ошондуктан изилдөө стандарттуу PatchTST ишке ашыруусунун бардык деталдары толугу менен колдонулганын ырастабайт.
Эки маалымат топтому эмнени билдирет?
Dataset 1 реалдуу иш шартындагы 2 MW шамал турбинасынын жогорку ылдамдыктагы вал подшипнигине байланышкан вибрация маалыматтары. Макала подшипниктин 50 күндүк прогрессивдүү деградациясын көзөмөлдөгөн MEMS-негизиндеги радиалдык акселерометр маалыматтарын колдонот. Номиналдык айлануу ылдамдыгы 1800 rpm, жогорку үлгү алуу жыштыгы 97.656 Hz жана жаздыруу мөөнөтү 6 секунд деп берилет.
Dataset 2 University of Cincinnati Intelligent Maintenance Systems Centre тарабынан иштелип чыккан run-to-failure подшипник тажрыйбаларына негизделген. Макаладагы 5-сүрөт колдонуу өмүрүнүн аягына жакындаган сайын вибрация амплитудасы ачык өсүп турган айкын деградация түзүлүшүн көрсөтөт. Авторлор Dataset 2 Dataset 1ге караганда үйрөнүүгө оңойураак деградация белгисин камтышы мүмкүн деп сунушташат.
Маалымат булактарын көрсөтүүдө булак ичинде библиографиялык белгисиздик бар. Dataset 1 метод текстинде GitHub аркылуу жеткиликтүү деп сүрөттөлгөнү менен тиешелүү шилтеме MathWorksка багыттайт. Dataset 2 үчүн метод жана маалымат жеткиликтүүлүк бөлүмдөрү NASA Prognostics Data Repositoryни көрсөтөт, ал эми [47] номердүү шилтеме Kaggle дареги. Бул жагдай жыйынтыктарды өзүнөн-өзү жараксыз кылбайт; бирок көз карандысыз кайра өндүрүү үчүн кайсы оригинал repository жана маалымат версиясы колдонулганын так документтөө керек.
Болжолдоо горизонттору кантип түзүлдү?
| Горизонт | Окутуу бөлүгү | Тест / болжол бөлүгү | Булактын натыйжа божомолу |
|---|---|---|---|
| Узун | 20 күн | 30 күн | Эрте этап; тейлөөнү пландоого көбүрөөк убакыт |
| Орто | 40 күн | 10 күн | Бузулуу өнүккөн, кийлигишүү убактысы тарылган этап |
| Кыска | 47 күн | 3 күн | Критикалык бузулууга жакын, натыйжа оордугу жогорку деп кабыл алынган этап |
Бул дизайндын маанилүү натыйжасы — эки эксперименттик өзгөрмө бирге жылат. Болжолдоо горизонту 30 күндөн 3 күнгө кыскарганда окутуу маалыматы 20 күндөн 47 күнгө көбөйөт. Ошондуктан кыска горизонттогу иштөө өсүшү гана жакын келечекти болжолдоо жеңилдегенинен келип чыгат деп айтууга болбойт; модель көбүрөөк деградация тарыхын көрүшү да жыйынтыктарга таасир берет.
Dataset 1де модель рейтинги кантип өзгөрдү?
Verianla Live: Dataset 1де модель тактыгынын болжолдоо горизонтуна жараша өзгөрүшү
Маанилер булак Таблица 2ден алынган. “Тактык” изилдөөдө 100 − MAPE катары эсептелет; классикалык классификация тактыгы эмес. Горизонт өзгөргөн сайын окутуу маалыматтарынын көлөмү да өзгөрөт.
| Модель | Узун горизонт (%) | Орто горизонт (%) | Кыска горизонт (%) | Булак |
|---|---|---|---|---|
| ARIMA | 11,64 | 56,56 | 90,63 | Таблица 2 |
| Prophet | 72,67 | 66,12 | 89,81 | Таблица 2 |
| LSTM | 34,46 | 59,04 | 79,72 | Таблица 2 |
| GRU | 33,77 | 54,77 | 90,39 | Таблица 2 |
| PatchTST | 33,99 | 18,13 | 67,64 | Таблица 2 |
Dataset 1де Prophet узун жана орто горизонтто эң жогорку маанини берет, ал эми ARIMA кыска горизонтто алдыга чыгат. ARIMAнын %11,64төн %90,63кө өсүшү модель рейтинги баалоо терезесине канчалык көз каранды болушу мүмкүн экенин ачык көрсөтөт.
Dataset 2 да ошол эле рейтингди бердиби?
Жок. Экинчи маалымат топтомунда көпчүлүк моделдердин жалпы иштөөсү жогорулап, айрым рейтингдер өзгөргөн. Бул изилдөөнүн “моделдин тобокелдик профили алгоритмдин гана касиети эмес; маалымат топтомунун деградация түзүлүшүнө да көз каранды” деген тезисин колдогон негизги табылгалардын бири.
Verianla Live: Dataset 2де модель тактыгынын болжолдоо горизонтуна жараша өзгөрүшү
Маанилер булак Таблица 8ден алынган. Таблица орто горизонтто ARIMA үчүн %82,04 жана Prophet үчүн %81,03 берет. Булак баяндамасында Prophet Dataset 2нин орто горизонтунда да эң жакшы деп жазылган, бул таблицага туура келбейт.
| Модель | Узун горизонт (%) | Орто горизонт (%) | Кыска горизонт (%) | Булак |
|---|---|---|---|---|
| ARIMA | 77,35 | 82,04 | 98,25 | Таблица 8 |
| GRU | 76,56 | 73,21 | 95,18 | Таблица 8 |
| LSTM | 84,86 | 70,72 | 95,14 | Таблица 8 |
| PatchTST | 46,12 | 33,79 | 30,29 | Таблица 8 |
| Prophet | 86,62 | 81,03 | 96,76 | Таблица 8 |
Dataset 2 узун горизонтто Prophet %86,62 менен эң жогорку жыйынтыкты берет. Орто горизонтто булак Таблица 8деги эң жогорку маани ARIMAнын %82,04ү; Prophet %81,03. Кыска горизонтто ARIMA %98,25ке жетет. PatchTST болсо башка моделдерден айырмаланып кыска горизонтто жакшырбай, %30,29га түшкөн.
Түркия жагынан кантип чечмелениши мүмкүн?
Изилдөө Түркияда талаалык валидация жүргүзгөн эмес. Ошентсе да шамал турбиналары, өндүрүш линиялары, айлануучу машиналар, подшипниктер жана ушул сыяктуу критикалык жабдууларда болжолдуу тейлөө колдонгон ишканалар үчүн көтөрүлгөн чечим көйгөйү Түркия үчүн да инженердик жактан маанилүү: жөн гана “эң аз ката берген моделди” тандоонун ордуна ишкананын реалдуу запастык бөлүк жеткирүү убактысы, тейлөө командасын мобилизациялоо, пландалган токтотуу талабы жана бузулуунун коопсуздук/өндүрүш натыйжасы менен шайкеш болжолдоо горизонту аныкталышы керек.
Бирок изилдөөдөгү 30, 10 жана 3 күндүк чектер Түркиядагы бардык өнөр жай активдерине колдонулуучу стандарттуу маанилер эмес. Булактын өзү да бул мөөнөттөр жабдууга, деградация механизмине жана операциялык чөйрөгө жараша ылайыкташтырылышы керек экенин белгилейт.
Изилдөө эмнени колдойт, эмнени далилдебейт?
| Изилдөө колдогон жыйынтык | Изилдөө далилдебеген / текшербеген жыйынтык |
|---|---|
| Модель иштөөсү болжолдоо горизонтуна жана маалымат топтомуна жараша олуттуу өзгөрүшү мүмкүн. | Бир алгоритм бардык өнөр жай активдери үчүн жалпы эң жакшы RUL модели экени далилденген эмес. |
| Жогорку кыска-горизонт сандык тактыгы тейлөөнү пландоо үчүн жетиштүү эрте эскертүү бербеши мүмкүн. | Кыска горизонттогу иштөө өсүшү горизонт узундугунан гана келип чыкканы көрсөтүлгөн эмес; окутуу маалыматтарынын көлөмү да өзгөрөт. |
| Бир ката метрикасы реалдуу деградация ийри сызыгын жетиштүү чагылдырбашы мүмкүн. | Сунушталган Shape-RMSE же PHEP бардык RUL колдонмолорунда текшерилген универсалдуу стандарттар экени көрсөтүлгөн эмес. |
| Prophet эки маалымат топтомунда узун горизонтто салыштырмалуу туруктуу иштөө көрсөткөн. | Prophet бардык маалымат топтомдорунда же актив түрлөрүндө эң аз тобокелдүү ыкма болору көрсөтүлгөн эмес. |
| ARIMA эки маалымат топтомунда кыска горизонтто эң жогорку чыгарылган тактыкты берген. | Бул жыйынтык ARIMA реалдуу деградация формасын эң жакшы үйрөнгөнүн көрсөтпөйт; Dataset 1де кыска-горизонт R² терс. |
| Эки маалымат топтомун колдонуу бир маалымат топтомун баалоого караганда көбүрөөк жалпылоо маалыматын берген. | Жыйынтыктар башка подшипниктерге, редукторлорго, насосторго, моторлорго же ар башка иш шарттарына автоматтык жалпыланбайт. |
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Моделдерден мурда маалымат кантип иштетилди?
Булак жогорку өлчөмдүү жана ызы-чуулуу вибрация сигналдарын түздөн-түз болжол моделдерине берүүнүн ордуна autoencoder колдонулганын билдирет. Autoencoder маалыматты кысуу жана белгилерди чыгаруу үчүн колдонулуп, алынган өкүлчүлүк андан кийин беш болжолдоо ыкмасына өткөрүлгөн.
Ошентсе да autoencoderдын катмар архитектурасы, latent өлчөмү жана окутуунун бардык деталдары негизги гиперпараметр таблицасында берилбейт. Бул өзгөчө изилдөөнүн жыйынтыктарын так кайра өндүрүүнү каалаган изилдөөчүлөр үчүн методологиялык кемчилик.
Негизги модель жөндөөлөрү
| Модель | Булакта берилген тандалган жөндөөлөр | Көңүл буруучу жагы |
|---|---|---|
| LSTM | Ирет узундугу 2; 16 LSTM бирдиги; dropout 0,1; dense 16; 300 epoch; batch 4 же 2 | “4 же 2” batch мааниси кайсы шартта колдонулганы таблицада ажыратылбайт. |
| GRU | Ирет узундугу 2; 16 GRU бирдиги; dropout 0,1; dense 16; 300 epoch; batch 4 же 2 | Терең модель үчүн маалымат абдан чектелүү. |
| ARIMA | p: 0–3; d: 0–2; q: 0–3; эң жакшы AIC-негизиндеги тартип | Статистикалык ыкма |
| Prophet | Күндүк/жылдык сезондуулук өчүк; жумалык күйүк; changepoint prior 0,05; seasonality prior 10; Fourier order 3 | Булак “Facebook Prophet” терминологиясын колдонот. |
| PatchTST-inspired | Ирет узундугу 2; attention head 2; key dimension 4; feed-forward 16; dense 16; 300 epoch | Гиперпараметр таблицасындагы ат “PatchTST-inspired”, жыйынтык таблицаларында “PatchTST”. |
“Accuracy” кантип эсептелди?
Изилдөөнүн негизги ката өлчөмдөрүнүн бири Mean Absolute Error (MAE):
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i| \]
Root Mean Square Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2} \]
жана Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100}{n}\sum_{i=1}^{n}\left|\frac{\hat{y}_i-y_i}{y_i}\right| \]
түрүндө берилет. Изилдөөнүн “accuracy” мааниси болсо түздөн-түз:
\[ Accuracy=100\%-MAPE(\%) \]
деп аныкталган. Ошондуктан %90 тактык деген сөз классификацияда колдонулган “туура болжолдордун пайызы” дегенди билдирбейт. Булактын өзү да өзгөчө MAPE жогору болгон учурларда жана тармактык толеранттуулуктар маанилүү болгондо бул аныктаманы этият колдонуу керектигин белгилейт.
R² эмне үчүн башкача окуяны айтып берет?
Coefficient of determination:
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} {\sum_{i=1}^{n}(y_i-\bar{y})^2} \]
менен эсептелет. R² терс болушу модель реалдуу катардагы вариацияны түшүндүрүүдө жөн гана орточо RUL маанисин болжолдоодон да начар болушу мүмкүн экенин көрсөтөт.
| Модель | MAE | RMSE | R² | MAPE (%) | Чыгарылган тактык (%) |
|---|---|---|---|---|---|
| ARIMA | 0,0252 | 0,0313 | −0,5988 | 9,3651 | 90,63 |
| Prophet | 0,0292 | 0,0294 | −0,4160 | 10,1910 | 89,81 |
| LSTM | 0,0558 | 0,0612 | −5,1204 | 20,2753 | 79,72 |
| GRU | 0,0275 | 0,0279 | −0,2698 | 9,6050 | 90,39 |
| PatchTST | 0,0905 | 0,0935 | −13,2818 | 32,3619 | 67,64 |
Таблица 3түн эң көңүл бурарлык өзгөчөлүгү кыска горизонтто беш моделдин тең R² мааниси терс болушу. Демек жогорку MAPE-негизиндеги тактык менен реалдуу деградация ийри сызыгынын динамикасын түшүндүрүү жөндөмү бир эле нерсе эмес. Макаланын 8-сүрөтүндөгү ARIMA ийри сызыгы да бул көйгөйдү визуалдык көрсөтөт.
Shape-RMSE эмнени өлчөөгө аракет кылат?
Изилдөө абсолюттук өлчөмдүн ордуна болжол ийри сызыгынын формасы реалдуу деградация ийри сызыгына канчалык окшош экенин өлчөө үчүн нормалдаштырылган Shape-RMSE сунуштайт:
\[ Shape\text{-}RMSE= \sqrt{\frac{1}{N} \sum_{t=1}^{N} (\hat{y}^{norm}_t-y^{norm}_t)^2} \]
Катарлар өзүнүн минимум жана максимумдары боюнча нормалдаштырылат:
\[ y^{norm}_t= \frac{y_t-\min(y)} {\max(y)-\min(y)} \]
Төмөн Shape-RMSE жакшы деп эсептелет.
| Модель | Узун горизонт | Орто горизонт | Кыска горизонт |
|---|---|---|---|
| ARIMA | 0,3846 | 0,7464 | 0,5636 |
| GRU | 0,5307 | 0,5147 | 0,1024 |
| LSTM | 0,5323 | 0,4746 | 0,5999 |
| PatchTST | 0,5959 | 0,3228 | 0,0540 |
| Prophet | 0,1015 | 0,1734 | 0,0681 |
Prophet узун жана орто горизонтто эң төмөн Shape-RMSE берет. Кыска горизонтто сандык жактан PatchTST 0,0540 менен эң төмөн мааниге ээ. Ошого карабастан булак авторлору визуалдык карап чыгууда Prophet реалдуу деградация жолун жакшыраак ээрчирин белгилешет. Макаланын өзү ошондуктан өтө кыска терезелерде Shape-RMSE жалгыз формага берилгендикти толук чагылдырбай калышы мүмкүн экенин кабыл алат. Бул жаңы сунушталган өлчөм азырынча өз алдынча чечим критерийи эмес экенин көрсөткөн маанилүү ички текшерүү.
Окутуу терезеси өзгөргөндө моделдер канчалык туруктуу?
Изилдөө тандалган окутуу узундуктарынын айланасында ±3 күн өзгөртүү жасап MAPE аралыктарын салыштырган. Айрыкча кыска горизонт айланасындагы 42–48 күндүк окутуу терезесинде Prophetтын MAPE аралыгы %7,75–14,46 менен эң тар жана эң төмөн аралыктардын бири. ARIMA ошол эле аймакта %8,35–45,12 арасында кыйла көп өзгөрөт.
| Модель | Узун горизонт айланасында MAPE (%) | Орто горизонт айланасында MAPE (%) | Кыска горизонт айланасында MAPE (%) |
|---|---|---|---|
| ARIMA | 95,15–110,82 | 15,21–93,18 | 8,35–45,12 |
| Prophet | 43,83–76,72 | 10,08–38,57 | 7,75–14,46 |
| LSTM | 91,98–101,41 | 36,60–90,98 | 20,99–48,31 |
| GRU | 93,16–100,39 | 42,70–91,17 | 25,80–55,45 |
| PatchTST | 79,90–104,66 | 55,76–117,48 | 32,36–65,27 |
10-сүрөттөгү boxplot Prophetты майда окутуу-терезе өзгөрүүлөрүнө эң туруктуу, ARIMAны болсо эң сезимтал модель катары көрсөтөт. Бул жыйынтык ARIMAнын белгилүү бир кыска горизонт кесиминде эң жогорку тактыкка жетиши моделдин бардык жакын окутуу терезелеринде да ошондой туруктуу экенин билдирбейт.
PHEP эмне үчүн сунушталды?
Prediction Horizon Error Profile (PHEP) бир орточо ката берүүнүн ордуна ката чоңдугу бузулууга калган убакытка жараша кантип өзгөрөрүн көрсөтүүнү максат кылат:
\[ PHEP(h)= \frac{1}{N_h} \sum_{i=1}^{N_h} \left| \frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}} \right| \times100 \]
11-сүрөттө көп моделдер бузулууга жакындаганда эки өзүнчө ката көтөрүлүшүн көрсөтүп, Prophet болсо түзүрөөк ката профилин көрсөткөнү айтылат. Булак бул эки чокуну адегенде деградация режими өзгөрө баштаган өтүү этабы, андан кийин бузулууга өтө жакын көбүрөөк сызыктуу эмес жана тартипсиз критикалык этап катары чечмелейт.
PHEP графигинин чекит маанилери негизги текстте таблица түрүндө берилбегендиктен Verianla Live ичинде графиктен болжолдуу сандар чыгарылган эмес.
Тобокелдик матрицасы кантип курулат?
Изилдөөдө болжол тактыгы үч практикалык класска бөлүнгөн: %95тен жогору — жогорку, %80–95 — орто жана %80ден төмөн — төмөн. Авторлор бул чектер актив менеджеринин тажрыйбасына негизделген салыштырмалуу классификация экенин жана бардык RUL колдонмолору үчүн универсалдуу стандарт эмес экенин ачык белгилешет.
Натыйжа оордугу 30 күн калганда төмөн, 10 күн калганда орто жана 3 күн калганда жогорку деп кабыл алынат. Dataset 1де эч бир модель 30 күн калганда жогорку же орто тактык классына жеткен эмес. Кыска горизонтто ARIMA, GRU жана Prophet орто тактык аймагына кирсе, LSTM жана PatchTST төмөн тактык аймагында калган.
Dataset 2де кыска горизонтто ARIMA %98,25, GRU %95,18, LSTM %95,14 жана Prophet %96,76 менен жогорку тактык классына кирсе, PatchTST %30,29 менен төмөн класста калган.
“Туура эмес болжол ыктымалдыгы” чынында ыктымалдыкпы?
Булак тобокелдик ыкмасын андан ары өнүктүрүү үчүн туура эмес болжол ыктымалдыгын accuracy, R², Shape-RMSE жана PHEP компоненттеринин функциясы катары концептуалдаштырат:
\[ P_{wrong}=f(E_{acc},E_{R^2},E_{ShapeRMSE},E_{PHEP}) \]
Андан кийин болжолдуу курама ишенимсиздик индекси сунушталат:
\[ P_{wrong}\approx w_1E_{acc}+w_2E_{R^2}+w_3E_{SSS}+w_4E_{PHEP} \]
\[ \sum_{i=1}^{4}w_i=1 \]
Бул формула калибрленген статистикалык бузулуу ыктымалдыгы эмес. Булак да чыныгы туура эмес болжол ыктымалдыгын түз эсептөө кыйын экенин жана бул жерде курама predictive unreliability index менен жакындатылганын айтат. Мындан тышкары, биринчи теңдемеде `EShapeRMSE` деп берилген үчүнчү компонент кийинки теңдемеде түшүндүрүүсүз `ESSS` болуп өзгөрөт; бул булак ичиндеги notation дал келбестиги. Салмактар үчүн да бул изилдөөдө универсалдуу же эксперименттик түрдө текшерилген сандар берилген эмес.
Модель баалоо үчүн сунушталган акыркы процесс
Verianla Live: RUL болжол моделин ишке киргизүүдөн мурда сунушталган баалоо агымы
Агым булак 13-сүрөттүн негизги баалоо логикасын кыскача берет. Бул талаа стандарты катары текшерилген милдеттүү процедура эмес, изилдөөчүлөр сунуштаган баалоо алкагы.
| Этап | Түшүндүрмө | Булак |
|---|---|---|
| 1. Туруктуу seed, бир горизонт | Модель окутулат; ката, R², ийри/форма окшоштугу жана негизги иштөө бааланат. | 13-сүрөт — Stage 1 FSSH |
| 2. Туш келди seed, бир горизонт | Модель бир нече жолу иштетилип бир горизонттогу иштөө статистикасы жана ишенимдүүлүк текшерилет. | 13-сүрөт — Stage 2 RSSH |
| 3. Туш келди seed, көп горизонт | Модель бир нече болжол горизонтунда кайталанып бааланат. | 13-сүрөт — Stage 3 RSMH |
| 4. Жалпы модель иштөөсү | Көп өлчөм жана көп горизонт жыйынтыктары башка моделдер менен салыштырылат. | 13-сүрөт |
| 5. Көп маалымат топтому тести | Керек болсо жаңы маалымат топтомдорунда, бир нече иштетүү жана горизонтто иштөө текшерилет. | 13-сүрөт — Stage 4 |
| 6. Бекитүү | Модель белгиленген иштөө жана ишенимдүүлүк талаптарына жооп берсе колдонууга ылайыктуу деп кабыл алынат. | 13-сүрөт |
Изилдөөнүн эң маанилүү методологиялык чектөөлөрү
Болжолдоо горизонту менен окутуу маалыматынын көлөмү тажрыйба дизайнында бирге өзгөргөндүктөн горизонттун көз карандысыз таасири бөлүнбөйт. Биринчи маалымат топтому болгону 50 күндүк чектелген тарыхты берет жана булак авторлору LSTM, GRU жана Transformer-сыяктуу моделдерде көрүнгөн дээрлик түз болжолдор жетишсиз маалымат жана оптимизациядан келип чыгышы мүмкүн экенин өзгөчө белгилешет. Ошондуктан тажрыйба “статистикалык моделдер жалпы терең үйрөнүүдөн жакшыраак” деген жыйынтыкты колдобойт.
Негизги модель таблицаларында ишеним интервалдары же модель рейтингдеринин статистикалык маанилүүлүгүн көрсөткөн тесттер берилбейт. Изилдөө окутуу терезесинин сезимталдыгын караганы менен сунушталган 13-сүрөт агымындагы туш келди-seed ишенимдүүлүк тесттеринин баары негизги салыштырууларда ошол эле деңгээлде колдонулганын көрсөтпөйт.
Тобокелдик матрицасы натыйжа оордугун түздөн-түз 30, 10 жана 3 күндүк терезелерге байланыштырат; бул классификация талаа боюнча универсалдуу эмес. Ошондой эле %95 жана %80 тактык чектери практикалык эксперттик пикирге негизделет. Жабдуунун реалдуу тобокелдиги коопсуздук натыйжасы, өндүрүш жоготуусу, тейлөө чыгымы, экологиялык таасир, запастык бөлүк убактысы жана туура эмес эрте тейлөө чыгымы сыяктуу активге мүнөздүү өзгөрмөлөр менен кайра калибрлениши керек.
Сунушталган туура эмес болжол ыктымалдыгы азырынча калибрленген ыктымалдык модели эмес жана анын салмактары изилдөө тарабынан сандык текшерилген эмес. Изилдөөнүн жыйынтык бөлүмүндө да белгисиздикти сандык аныктоо азыркы ишке толук интеграцияланбаганы жана келечектеги иш катары пландалганы ачык айтылат.
Болгону эки маалымат топтому колдонулган жана экөө тең подшипник вибрация маалыматына негизделген. Dataset 1 реалдуу шамал турбина шарттарын, Dataset 2 көзөмөлдөнгөн run-to-failure тажрыйбасын билдиргени менен, жыйынтыктар башка жабдуу класстарында түз текшерилген эмес.
Булакта ошондой эле Dataset 2 орто горизонт лидери текст менен Таблица 8де ар башка берилгени, маалымат repository шилтемелериндеги дал келбестик, `EShapeRMSE`/`ESSS` символ алмашуусу, PatchTST/PatchTST-inspired терминологиясы жана кыска горизонт Shape-RMSE жыйынтыгы авторлордун визуалдык баалоосу менен толук дал келбегени бар. Бул жагдайлар макаланын негизги билдирүүсүн жокко чыгарбайт, бирок кайра өндүрүлүүчүлүк жана өлчөмдөрдүн жетилгендиги жагынан эске алынышы керек.
Булак жана Ыкма Жөнүндө Эскертүү
| Толук оригинал изилдөө аталышы | Evaluating RUL Predictive Models: A Risk-Based Predictive Maintenance Approach |
|---|---|
| Авторлор | Idriss El-Thalji; Ali Usman; Waqar Ali |
| Авторлордун ирети | 1. Idriss El-Thalji; 2. Ali Usman; 3. Waqar Ali |
| Тең салым / тең биринчи автор | Булак изилдөөдө тең биринчи же тең салым билдирүүсү көрсөтүлгөн эмес. |
| Жооптуу автор | Idriss El-Thalji |
| Мекемелер | Department of Engineering Management, Prince Sultan University, Riyadh, Сауд Арабиясы; Department of Mechanical and Structural Engineering and Materials Science, University of Stavanger, Stavanger, Норвегия. |
| Булак түрү | RUL болжол моделдери эки ачык вибрация маалымат топтомунда салыштырылып, тобокелдикке негизделген модель баалоо алкагы сунушталган изилдөө макаласы. |
| Рецензия статусу | Рецензияланган журналда жарыяланган изилдөө макаласы; preprint эмес. |
| Журнал | AI |
| Басмакана | MDPI |
| Том / сан / макала | 2026, 7(5), 169 |
| DOI | 10.3390/ai7050169 |
| Кабыл алынган күнү | 2 март 2026 |
| Ревизия күнү | 10 май 2026 |
| Кабыл алуу күнү | 12 май 2026 |
| Жарыя күнү | 14 май 2026 |
| Расмий шилтеме | https://doi.org/10.3390/ai7050169 |
| Лицензия | Creative Commons Attribution (CC BY). |
Каржылоо, этика жана кызыкчылыктардын кагылышы
Авторлор изилдөө тышкы каржылоо албаганын билдиришкен. Institutional Review Board жана маалымдалган макулдук талаалары “колдонулбайт” деп көрсөтүлгөн. Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Маалымат жеткиликтүүлүгү
Булак изилдөө эки негизги маалымат топтому ачык repositoryлерден алынганын билдирет. Биринчи маалымат топтому шамал турбинасынын жогорку ылдамдыктагы подшипник prognosis маалыматы, экинчиси IMS bearing run-to-failure маалымат топтому. Бирок негизги тексттеги repository түшүндүрмөлөрү менен [46] жана [47] номердүү шилтемелердин багыттары толук дал келбегендиктен көз карандысыз кайра өндүрүүдө оригинал маалымат repositoryси жана версиясы өзүнчө текшерилиши керек.
Автордук салымдар
Idriss El-Thalji, Ali Usman жана Waqar Ali концептуалдаштыруу, программалык камсыздоо, валидация, формалдык талдоо, изилдөө, маалымат курaциясы, алгачкы долбоор, карап чыгуу жана визуалдаштырууга салым кошушкан. Методология Idriss El-Thalji жана Ali Usman тарабынан жүргүзүлгөн. Ресурстар, көзөмөл, долбоорду башкаруу жана каржылоо алуу Idriss El-Thalji тарабынан аткарылган.
Булакка берилгендик жагынан критикалык жазуу
Булак текстте Dataset 2нин орто болжол горизонтунда Prophet эң жакшы модель деп айтылат; бирок Таблица 8 ARIMA үчүн %82,04, Prophet үчүн %81,03 көрсөтөт. Verianla текстинде таблица маанилери өзгөртүлбөй сакталган жана текст–таблица дал келбестиги ачык белгиленген.
Булак Таблица 1 моделди “PatchTST-inspired” деп аныктайт, ал эми жыйынтык бөлүмдөрү “PatchTST” атын колдонот. Ошондуктан жыйынтыктар канондук PatchTST архитектурасынын көз карандысыз жана толук benchmarkы катары берилген эмес.
Shape-RMSE кыска горизонтто PatchTST үчүн 0,0540 жана Prophet үчүн 0,0681 берет. Математикалык өлчөм боюнча PatchTST жакшыраак көрүнгөнү менен булак авторлорунун визуалдык текшерүүсү Prophet реалдуу деградация ийри сызыгын жакшыраак ээрчирин айтат. Булактын өзү бул өтө кыска терезелерде Shape-RMSE жалгыз жетишсиз болушу мүмкүн экенин көрсөтөрүн белгилейт.
Туура эмес болжол тобокелдигинин курама формуласында биринчи көрсөтүүдө `EShapeRMSE`, кийинки теңдемеде болсо аныктамасыз `ESSS` колдонулат. Мындан тышкары, бул курама индекс үчүн салмактардын эксперименттик калибрациясы жана реалдуу туура эмес болжол ыктымалдыгына каршы валидациясы азыркы изилдөөдө жасалган эмес.
Жыйынтыктардын эң коопсуз чечмелөөсү — RUL моделинин тейлөөгө ылайыктуулугу бир гана ката метрикасы же бир гана убакыт горизонту менен бааланбашы керек. Изилдөө бул ыкманы эки подшипник маалымат топтомунда көрсөтөт, бирок сунушталган тобокелдикке негизделген алкак ар башка актив класстары, көз карандысыз маалымат топтомдору жана белгисиздикти сандык аныктоо менен кеңири текшерилиши керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген