

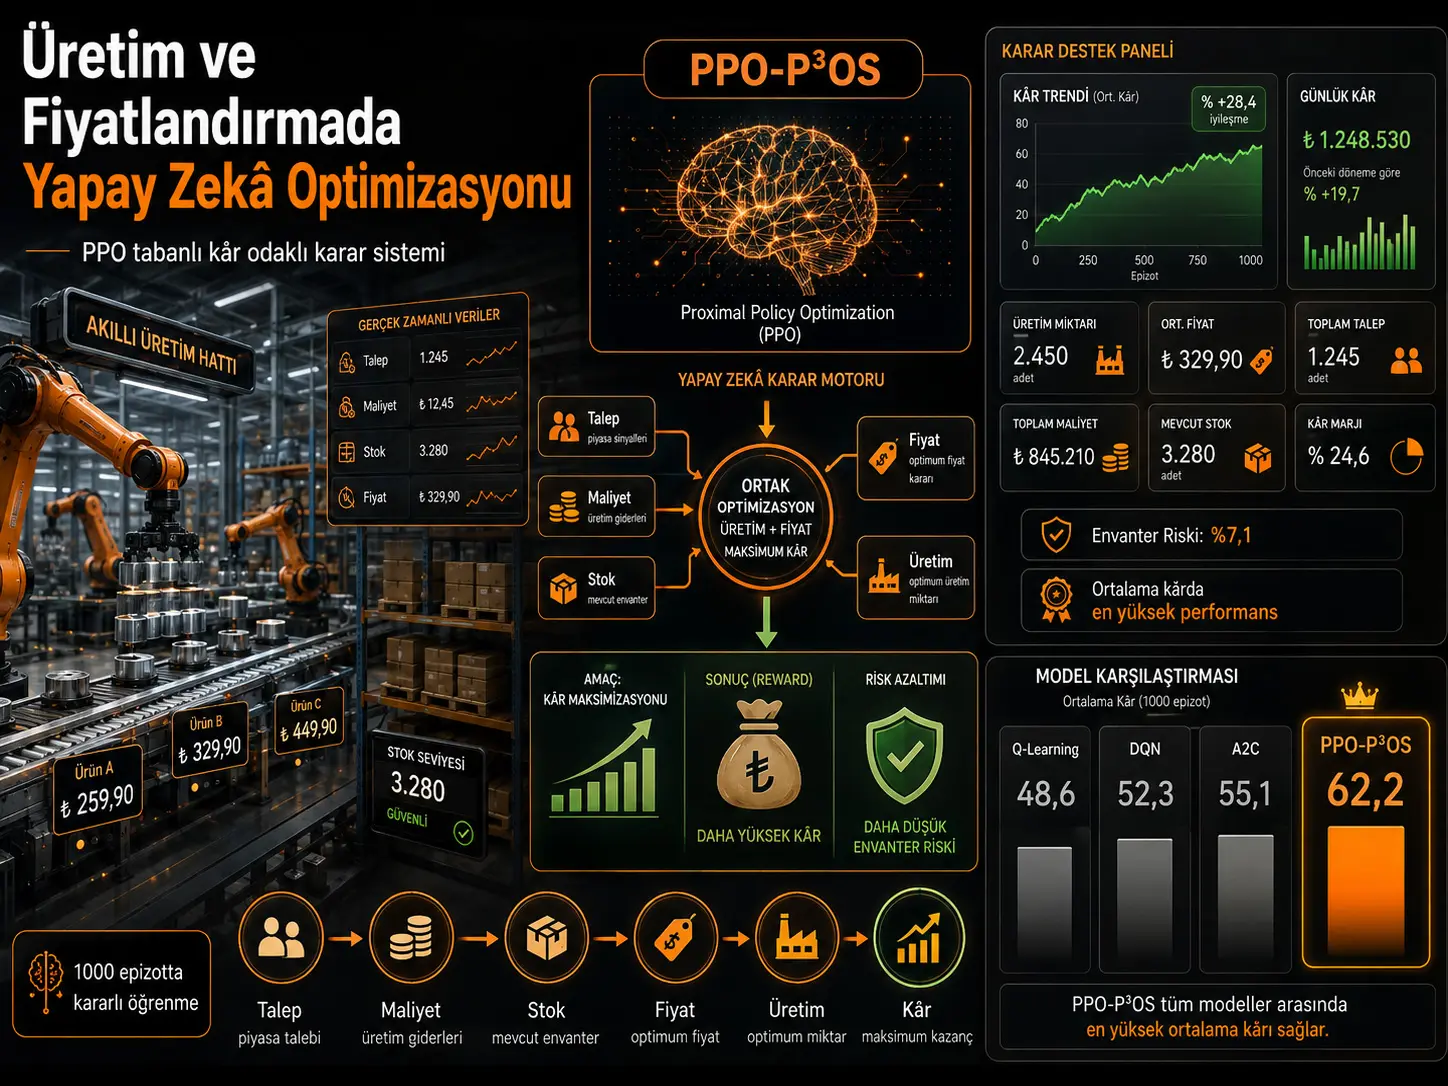
Өндүрүүчү бүгүн канча даана продукция өндүрүшү керек жана аны кандай баада сатышы керек? Эгер суроо-талап, чийки заттын чыгымдары жана кампадагы запас көлөмү тынымсыз өзгөрүп турса, бул эки чечимди бири-биринен көз карандысыз кабыл алууга болбойт. Бул изилдөө өндүрүш көлөмү менен сатуу баасын бир эле учурда жөнгө сала алган жана узак мөөнөттүү пайданы көбөйтүү менен катар запас тобокелдигин чектөөнү максат кылган бекемдөөчү үйрөнүү системасын сунуштайт. Изилдөөчүлөр PPO-P³OS деп атаган система Proximal Policy Optimization (PPO) алгоритмин колдонот. Жасалма интеллект агенти ар бир чечим кадамында өндүрүш чыгымын, рыноктук суроо-талапты, учурдагы запас деңгээлин жана продукт баасын байкап, андан соң жаңы баа менен өндүрүш көлөмүнө байланыштуу үзгүлтүксүз маанилүү чечимдерди чыгарат.
Модель өндүрүш жана баа коюу көйгөйүн Марков чечим кабыл алуу процесси (MDP) катары аныктайт. Сыйлык функциясы сатылган продукциядан алынган маржаны көбөйтүүгө аракет кылып, суроо-талап менен өндүрүш/запас ортосундагы тең салмаксыздыкты квадраттык жаза аркылуу азайтат. Болжол менен 36.000 үлгүдөн турары билдирилген реалдуу жана синтетикалык маалыматтардын айкалышында жүргүзүлгөн симуляцияларда PPO-P³OS Q-Learning, Deep Q-Network (DQN) жана Advantage Actor-Critic (A2C) менен салыштырылат. 1-таблицага ылайык, орточо пайда PPO-P³OS үчүн 62,2×10³ USD, A2C үчүн 55,1×10³ USD, DQN үчүн 52,3×10³ USD жана Q-Learning үчүн 48,6×10³ USD деп билдирилет.
Ошол эле учурда, изилдөө реалдуу өндүрүш ишканасында жандуу чечим кабыл алуу системасы катары текшерилген эмес. Маалымат топтомунун реалдуу бөлүгү 2021–2023 мезгилиндеги орточо көлөмдөгү керектөө товарларын өндүрүүчүнүн ERP жана MES жазууларына негизделет, ал эми жалпы маалымат топтому синтетикалык симуляция маалыматтары менен кеңейтилген. Реалдуу жана синтетикалык маалыматтардын катышы, ошондой эле синтетикалык маалыматты түзүү ыкмасы жетиштүү деңгээлде кеңири түшүндүрүлбөгөндүктөн, натыйжалар симуляция/benchmark ийгилиги катары бааланышы керек; реалдуу заводдордо дал ушундай пайда өсүшү камсыз болот деген түз жыйынтык чыгарууга болбойт.
Эмне үчүн өндүрүш көлөмү менен баа чогуу каралышы керек?
Өндүрүш ишканасында баа маркетинг бөлүмү гана, өндүрүш көлөмү болсо завод гана өз алдынча кабыл ала турган чечим эмес. Баа суроо-талапка таасир этет; суроо-талап өндүрүш муктаждыгын өзгөртөт; өндүрүш көлөмү запаска жана чыгымдарга таасир берет; чыгым өзгөргөн сайын кабыл алынуучу баа деңгээли да кайра өзгөрөт.
Мисалы, суроо-талап күтүлгөндөн төмөн болуп турганда өндүрүштү жогорку деңгээлде кармоо запас топтолушуна алып келиши мүмкүн. Өндүрүш чыгымы өсүп, сатуу баасы өзгөрбөсө, бирдиктик пайда маржасы кыскарышы мүмкүн. Баа өтө жогору көтөрүлсө, суроо-талап түшүшү мүмкүн. Баа өтө төмөн кармалса, сатуу көлөмү көбөйсө да кирешелүүлүк жабыркашы мүмкүн.
Изилдөөнүн баштапкы жери — бул өзгөрмөлөрдүн ортосундагы байланыш сызыктуу жана туруктуу эмес экендиги. Ошондуктан изилдөөчүлөр белгилүү бир учурда математикалык оптимумду гана издеген статикалык ыкманын ордуна, чөйрөдөн кайтарым байланыш алып, убакыттын өтүшү менен саясатты үйрөнгөн бекемдөөчү үйрөнүү агентин колдонушат.
PPO-P³OS деген эмне?
PPO-P³OS — изилдөөдө колдонулган Profit-Oriented Production and Pricing Optimization System сөз айкашынын кыскартмасы. Система Proximal Policy Optimization алгоритмин өндүрүш экономикасынын көйгөйүнө ылайыкташтырат.
1-сүрөттө модель төрт негизги блок менен көрсөтүлгөн:
- Абалы (State): өндүрүш чыгымы, запас деңгээли, рыноктук суроо-талап жана учурдагы баа,
- PPO саясаты: учурдагы абалды баалап, чечим чыгарган үйрөнүлгөн саясат,
- Аракет (Action): жөнгө салынган баа жана өндүрүш көлөмү,
- Сыйлык (Reward): пайда менен запас тобокелдигин чогуу баалаган кайтарым байланыш.
Агент алган сыйлыктарынан үйрөнүп, узак мөөнөттө жогору жалпы сыйлык бере турган баа–өндүрүш айкалыштарына багытталат.
Абал мейкиндигинде кандай маалыматтар бар?
Убакыттын t кадамындагы абал вектору изилдөөдө төмөнкүдөй аныкталат:
\[ s_t=[C_t,D_t,I_t,P_t] \]
Бул жерде:
- Ct: бирдиктик өндүрүш чыгымы,
- Dt: рыноктук суроо-талап,
- It: учурдагы запас деңгээли,
- Pt: учурдагы продукт баасы.
Бул төрт өзгөрмө агент үчүн ошол учурдагы экономикалык чөйрөнүн кыскача мүнөздөмөсүн түзөт.
Жасалма интеллект кандай чечимдерди кабыл алат?
Аракет вектору:
\[ a_t=[p_t,q_t] \]
түрүндө. Булакта pt бааны жөнгө салууну, qt болсо өндүрүштү жөнгө салууну билдирет.
Бул жердеги маанилүү техникалык айырма — чечимдер DQN сыяктуу алдын ала белгиленген бир нече варианттын бирин гана тандоого мажбур эмес. PPO үзгүлтүксүз аракет мейкиндиктеринде иштей алгандыктан баа менен өндүрүш көлөмүн үзгүлтүксүз өзгөрмө катары моделдей алат.
Моделдин сыйлык функциясы эмнени оптималдаштырат?
Изилдөөдө сыйлык төмөнкүдөй аныкталат:
\[ r_t=(p_t-C_t)\cdot \min(q_t,D_t)-\lambda(I_t+q_t-D_t)^2 \]
Биринчи мүчө сатуудан алынган экономикалык кирешени билдирет. min(qt,Dt) туюнтмасы сатууга мүмкүн болгон көлөм өндүрүш менен суроо-талаптын кичүүсү менен чектелген жөнөкөйлөштүрүлгөн түзүлүш экенин билдирет.
Экинчи мүчө:
\[ \lambda(I_t+q_t-D_t)^2 \]
запастагы тең салмаксыздыкты жазалайт. λ чоңойгон сайын агент запас тең салмаксыздыгына сезгич болуп калат.
Квадраттык жазага байланыштуу суроо-талап менен учурдагы запас плюс өндүрүштүн ортосундагы айырма чоңойгон сайын жаза тез өсөт. Ошентип, система кыска мөөнөттүү сатуу маржасын гана көбөйтпөстөн, запас башкаруусун да сыйлык функциясына киргизет.
Узак мөөнөттүү максат эмне?
PPO агентинин максаты дисконттолгон жалпы сыйлыкты максималдаштыруу:
\[ J(\theta)=E_t\left[\sum_{t=0}^{T}\gamma^t r_t\right] \]
Бул жерде γ дисконт коэффициенти. Эксперименттерде γ = 0,99 колдонулган. Бул жогорку маани модель кийинки чечимди гана эмес, андан кийинки экономикалык натыйжаларды да маанилүү деп эсептей тургандай жөндөлгөнүн көрсөтөт.
Эмне үчүн PPO тандалды?
PPO — саясат градиенти алгоритми. Негизги максат — саясат ар бир окутуу кадамында өтө чоң өзгөрүүлөрдү жасабашын камсыз кылып, үйрөнүүнү туруктуураак кылуу.
Изилдөөдө колдонулган кесилген PPO максат функциясы:
\[ L^{CLIP}(\theta) = E_t \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)\hat{A}_t \right) \right] \]
түрүндө берилет.
Бул жердеги ыктымалдык катышы:
\[ r_t(\theta)= \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{old}}(a_t|s_t)} \]
жаңы саясат менен эски саясаттын бир эле аракетке берген ыктымалдык тыгыздыктарын салыштырат. ε = 0,2 кесүү параметри жаңыртуунун өтө чоң болуп кетишине жол бербөөгө жардам берет.
Generalized Advantage Estimation эмне кылат?
Модель артыкчылык маанисин баалоодо Generalized Advantage Estimation (GAE) колдонот. Булакта:
\[ \hat A_t= \delta_t+ (\gamma\lambda)\delta_{t+1} +\ldots+ (\gamma\lambda)^{T-t+1}\delta_{T-1} \]
жана:
\[ \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) \]
туюнтмалары берилет.
Эксперименттерде GAE үчүн λ = 0,95 тандалган. Максат — артыкчылыкты баалоодо ыктуулук менен вариациянын ортосунда ылайыктуу тең салмак түзүү.
Actor жана Critic эмне кылат?
PPO-P³OS эки нейрондук тармак компонентинен турат.
Actor, учурдагы абалдан баа жана өндүрүш чечимдерин чыгарган саясатты билдирет. Үзгүлтүксүз аракеттер Гаусс бөлүштүрүүсү аркылуу моделделет.
Critic болсо белгилүү бир абалдан баштап келечекте күтүлүүчү сыйлыкты баалаган мааниси функциясын үйрөнөт.
Эксперименттик түзүлүштө эки жашыруун катмар 256 жана 128 нейрондон турары жана ReLU активдештирүүлөрү колдонулары көрсөтүлгөн. Ыкма бөлүмүндө тармактар дагы “үч толук байланышкан катмар” деп сүрөттөлөт; булак чыгаруу катмарын эсепке алабы же жокпу так көрсөтпөйт.
Модель кантип окутулган?
| Параметр | Булакта берилген маани |
|---|---|
| Программалык камсыздоо | PyTorch 2.2 |
| Окутуу эпизоду | 1000 |
| Эпизоддогу убакыт кадамы | 200 |
| Жашыруун катмарлар | 256 жана 128 нейрон |
| Активдештирүү | ReLU |
| Үйрөнүү ылдамдыгы | 3 × 10⁻⁴ |
| Дисконт коэффициенти γ | 0,99 |
| PPO clip катышы ε | 0,2 |
| Batch өлчөмү | 128 |
| GAE λ | 0,95 |
| Экспериментти кайталоо саны | 5 |
Аппараттык камсыздоо катары Intel Core i9-13900K процессору, 64 GB RAM жана NVIDIA RTX 4090 GPU колдонулган.
Маалымат топтому чындап эле завод маалыматыбы?
Жарым-жартылай. Изилдөө маалымат топтомун реалдуу ишкана маалыматтары менен синтетикалык симуляция маалыматтарынын айкалышы катары аныктайт.
Реалдуу маалымат компоненти керектөө товарлары секторунда иштеген орточо көлөмдөгү өндүрүш ишканасынын 2021–2023 мезгилиндеги ERP жана Manufacturing Execution System (MES) жазууларынан алынганы айтылат.
Бирок компаниянын аты, жайгашкан өлкөсү, продукттардын деталдары жана реалдуу жазуулардын жалпы 36.000 үлгүнүн ичиндеги үлүшү берилген эмес. Болжол менен үч жылдык реалдуу маалымат мезгилине карабастан, жалпы маалымат топтому болжол менен 36.000 үлгүдөн турары жана ар бир үлгү “бир күндүк операциялык абалды” билдирери жазылган. Ошондуктан маалымат топтомундагы синтетикалык кеңейтүүнүн масштабы жана ыкмасы натыйжаларды кайра өндүрүү жагынан маанилүү, бирок жетиштүү түшүндүрүлбөгөн маселе.
Маалыматта кандай өзгөрмөлөр бар?
Изилдөөчүлөр 12 сандык жана эки категориялык өзгөчөлүктү билдиришет.
Өндүрүш өзгөрмөлөрү:
- күнүмдүк өндүрүш көлөмү,
- машинаны пайдалануу коэффициенти,
- чийки заттын жеткиликтүүлүгү.
Рынок өзгөрмөлөрү:
- рыноктук суроо-талап,
- атаандаштардын орточо баасы,
- мезгилдүүлүк индекси.
Чыгым өзгөрмөлөрү:
- бирдиктик өндүрүш чыгымы,
- энергия чыгымы,
- логистика чыгымы.
Кирешелүүлүк өзгөрмөлөрү:
- чыныгы сатуу баасы,
- күнүмдүк пайда,
- запас деңгээли.
Категориялык өзгөрмөлөр — продукт түрү жана рынок аймагы. Өзгөчөлүктөр min–max масштабдоо ыкмасы менен нормалдаштырылганы айтылат.
Бизнес аналитика катмары эмнени кошот?
Изилдөө PPO саясаты аракет чыгарууну гана эмес, үйрөнүлгөн чечимдерди суроо-талап ийкемдүүлүгү жана маржиналдык чыгым сыяктуу экономикалык түшүнүктөр менен чечмелөөнү да максат кылат.
Бирок булакта бул “business analytics” катмарына тиешелүү өзүнчө текшерүү таблицасы, түшүндүрүлмөлүүлүк метрикасы же менеджерлер менен жүргүзүлгөн колдонуучу изилдөөсү берилген эмес. Демек, түшүндүрүлүүчү чечим колдоо бөлүгү моделдин дизайн максаттарынын бири; ал эксперименталдык жактан өзүнчө жана кеңири бааланган модуль эмес.
Макаланын эң маанилүү сандык натыйжасы кайсы?
1-таблица төрт ыкманы салыштырат:
| Модель | Орточо пайда (×10³ USD) | Пайда вариациясы (%) | Запас тобокелдиги (%) | Акыркы жоготуу | Жакындашууну баалоо |
|---|---|---|---|---|---|
| Q-Learning | 48,6 | 12,5 | 10,7 | 0,61 | Орточо |
| DQN | 52,3 | 9,8 | 9,3 | 0,47 | Орточо |
| A2C | 55,1 | 7,0 | 8,5 | 0,36 | Туруктуу |
| PPO-P³OS | 62,2 | 6,0 | 7,1 | 0,23 | Өтө туруктуу |
%12,8 пайда өсүшү так эмнеге салыштырмалуу?
Макаланын өз текстинде бул жерде дал келбестик бар.
1-таблица колдонулганда PPO-P³OS менен эң күчтүү атаандаш A2C ортосундагы пайда айырмасы:
\[ \frac{62.2-55.1}{55.1}\times100 \approx 12.9\% \]
болот. Бул жыйынтык бөлүмүндөгү “эң жакшы baseline A2Cге салыштырмалуу болжол менен %12,8” деген билдирүүгө туура келет.
Бирок DQN базалык катары алынса:
\[ \frac{62.2-52.3}{52.3}\times100 \approx 18.9\% \]
алынат.
Ошондуктан кыскача баяндама жана жыйынтык бөлүмдөрүндө %12,8 маанисинин DQNга каршы берилүүсү 1-таблицага туура келбейт.
Запас тобокелдигинде да ушундай көйгөй барбы?
Ооба. A2Cнин запас тобокелдиги %8,5, PPO-P³OSтуку %7,1:
\[ \frac{8.5-7.1}{8.5}\times100 \approx 16.5\% \]
Бул маани макаладагы %16,4 деген билдирүүгө туура келет жана базалык сызык A2C экенин көрсөтөт.
DQNдун %9,3 мааниси колдонулса, PPO-P³OSтун азайышы болжол менен %23,7 болот. Демек %16,4 DQN салыштыруусу эмес.
Акыркы жоготуу боюнча абал кандай?
DQNдагы акыркы жоготуу 0,47, PPO-P³OSта 0,23. Чийки таблица маанилеринен:
\[ \frac{0.47-0.23}{0.47}\times100 \approx 51.1\% \]
азайуу эсептелет. Бул маани макаладагы болжол менен %50,9 акыркы жоготуу азайышына жакын жана бул жолу салыштыруу чындап DQNга карата жасалганы көрүнөт.
Демек, булак бир эле кыскача сүйлөмдө ар башка көрсөткүчтөр үчүн ар башка базалык сызыктарды аралаштыргандай көрүнөт.
2-сүрөт эмнени көрсөтөт?
2-сүрөттө эки окутуу ийри сызыгы бар. Биринчи графикте орточо пайда болжол менен 50×10³ USD деңгээлинен башталат, алгачкы бир нече жүз эпизоддо тез өсүп, 1000-эпизодго жакындаганда болжол менен 62×10³ USD аймагында платого чыгат.
Экинчи графикте окутуу жоготуусу болжол менен 1,05 деңгээлинен тынымсыз төмөндөп, 1000-эпизоддо болжол менен 0,22–0,23 деңгээлине жетет.
Бул эки ийри сызык моделдин берилген окутуу чөйрөсүндө үйрөнүү процесси туруктуу абалга келгенин колдойт. Бирок окутуу жоготуусунун азайышы жана симуляция пайдасынын өсүшү модель реалдуу өндүрүш ишканаларында да ушундай экономикалык көрсөткүч берет дегенди өз алдынча далилдебейт.
PPO-P³OS чындап эле “оптималдуу” саясатты таптыбы?
Изилдөө модель “optimal” же “near-optimal” саясатты үйрөнгөнүн билдирет. Бирок эксперименттерде чыныгы математикалык глобалдык оптимум белгилүү болуп, PPO натыйжасы ошол оптимум менен салыштырылган optimality-gap талдоосу берилген эмес.
Ошондуктан натыйжаларды этияттап, изилденген симуляция чөйрөсүндө сыналган baseline ыкмалардан жогорураак билдирилген көрсөткүчтү камсыз кылган үйрөнүлгөн саясат деп мүнөздөө коопсузураак.
Изилдөө эмнени колдойт?
- Баа менен өндүрүш көлөмүн бир үзгүлтүксүз башкаруу көйгөйүнүн ичинде чогуу моделдөөгө болот.
- PPO бул изилдөөнүн симуляция чөйрөсүндө Q-Learning, DQN жана A2Cге караганда жогорураак билдирилген орточо пайда чыгарган.
- PPO-P³OS 1-таблицада салыштырылган моделдердин арасында эң төмөн пайда вариациясына жана запас тобокелдигине ээ.
- 1000 эпизоддук окутуу учурунда пайда ийри сызыгы өскөн, жоготуу ийри сызыгы азайган.
- Запас тең салмаксыздыгын сыйлык функциясына жаза катары кошуу кыска мөөнөттүү маржаны гана эмес, операциялык тең салмакты да бутага алууга мүмкүндүк берет.
- Үзгүлтүксүз аракет мейкиндиктеринде баа менен өндүрүш көлөмүн чогуу жөнгө салуу PPO үчүн табигый колдонуу чөйрөсүн түзүшү мүмкүн.
Изилдөө эмнени далилдебейт?
- PPO-P³OS реалдуу өндүрүш ишканасында %12,8 көбүрөөк пайда берет деп далилдебейт.
- Модель реалдуу убакыттагы завод операциясында жандуу түрдө ишке киргизилген эмес.
- 36.000 үлгүнүн баары реалдуу завод байкоосу эмес.
- Синтетикалык маалымат реалдуу рыноктун термелүүлөрүн толук чагылдырары көрсөтүлгөн эмес.
- Моделдердин экономикалык айырмалары үчүн ишеним аралыгы же статистикалык маанилүүлүк тести берилген эмес.
- PPO саясаты глобалдык математикалык оптимумга жеткени көрсөтүлгөн эмес.
- Бир ишканадан алынган реалдуу маалымат компонентин бардык өндүрүш секторлоруна жалпылоого болору далилденген эмес.
- Бизнес аналитика катмары менеджерлердин реалдуу чечим сапатын жогорулатарын колдонуучу же талаа изилдөөсү менен текшерилген эмес.
Изилдөөнүн Ыкмасы жана Натыйжалары
Эксперименттик маалымат түзүлүшү
Изилдөөнүн реалдуу маалымат компоненти керектөө товарлары секторундагы орточо көлөмдөгү өндүрүш ишканасынын 2021–2023 мезгилиндеги ERP жана MES жазууларынан алынган. Аларга синтетикалык симуляция маалыматтары кошулуп, болжол менен 36.000 үлгүлүү маалымат топтому түзүлгөнү айтылат.
Авторлор ар бир үлгүнү бир күндүк операциялык абал катары аныкташат. Бирок реалдуу/синтетикалык үлгүлөрдүн саны өзүнчө берилбегени жана синтетикалык маалымат түзүү процесси кеңири сүрөттөлбөгөнү изилдөөнүн эң маанилүү кайра өндүрүү чектөөлөрүнүн бири.
Салыштырылган алгоритмдер
PPO-P³OS үч baseline менен салыштырылган:
- Q-Learning,
- Deep Q-Network (DQN),
- Advantage Actor-Critic (A2C).
Баалоо көрсөткүчтөрү — орточо пайда, пайда вариациясы, запас тобокелдиги, акыркы жоготуу жана жакындашуу туруктуулугу.
Чийки эксперименттик натыйжалар
| Көрсөткүч | Q-Learning | DQN | A2C | PPO-P³OS |
|---|---|---|---|---|
| Орточо пайда (×10³ USD) | 48,6 | 52,3 | 55,1 | 62,2 |
| Пайда вариациясы (%) | 12,5 | 9,8 | 7,0 | 6,0 |
| Запас тобокелдиги (%) | 10,7 | 9,3 | 8,5 | 7,1 |
| Акыркы жоготуу | 0,61 | 0,47 | 0,36 | 0,23 |
Чийки таблица PPO-P³OS төрт көрсөткүчтүн баарында салыштырылган baseline моделдерге караганда жакшыраак сандык маанилер бергенин көрсөтөт.
Кайра өндүрүмдүүлүк үчүн жетишпеген маалыматтар
Изилдөө окутуу гиперпараметрлерин салыштырмалуу кеңири бергени менен, экспериментти толук кайра жүргүзүү үчүн бир катар маанилүү маалыматтар жетишпейт:
- реалдуу маалымат топтомунун так көлөмү,
- синтетикалык үлгүлөрдүн саны,
- синтетикалык маалымат түзүү теңдемелери же бөлүштүрүүлөрү,
- ишкана менен рыноктун толук контексти,
- train/validation/test бөлүү ыкмасы,
- кокустук уруктар,
- baseline алгоритмдеринин кеңири гиперпараметрлери,
- беш кайталоо үчүн стандарттык четтөө же ишеним аралыктары,
- баштапкы код же ачык эксперименттик маалымат топтому.
Ошондуктан натыйжаларды көз карандысыз команда тарабынан ошол эле шарттарда кайра өндүрүү булакта берилген маалыматтар менен чектелет.
Шилтемелердин бүтүндүгүндөгү көйгөйлөр
Макаланын адабият бөлүмүндө айрым текст–булак дал келүүлөрү көйгөйлүү көрүнөт. Киришүүдө машина үйрөнүүсүнө негизделген себептик тыянак чыгаруу колдонмосун колдоо үчүн [1] колдонулган; бирок адабият тизмесиндеги [1] сызыктуу программалоо менен продукт аралашмасынын пайдасын максималдаштырууга арналган 2012-жылкы изилдөө.
2.1-бөлүмдө “Aktepe et al.” тарабынан жасалганы айтылган регрессия, ANN жана SVR негизиндеги запастык бөлүктөргө суроо-талапты божомолдоо изилдөөсүнө [5] шилтемеси берилген. Адабият тизмесиндеги [5] болсо Zhuang жана кесиптештеринин “Behavior Proximal Policy Optimization” аттуу arXiv иши.
Бул жагдай негизги PPO эксперименттик натыйжаларын автоматтык түрдө жараксыз кылбайт; бирок адабият серептөөсүндөгү айрым колдоочу билдирүүлөр булак текшерүүсүз кайталанбашы керек экенин көрсөтөт.
Өнөр жай колдонмосуна өтүү үчүн эмне керек?
Бул ыкманы реалдуу өндүрүш ишканасына өткөрүү үчүн симуляциядагы ийгиликтен тышкары кошумча текшерүү керек. Эң аз дегенде реалдуу өндүрүш кубаттуулугу, машиналардын бузулуусу, жеткирүү мөөнөттөрү, продукт сактоо мөөнөтү, минималдуу заказ көлөмү, смена чектөөлөрү, камсыздоо мөөнөттөрү, баа ийкемдүүлүгү, атаандаштык баа реакциялары жана жоголгон сатуулар сыяктуу процесстер моделге киргизилиши мүмкүн.
Мындан тышкары, жасалма интеллект бааны түздөн-түз белгилеген системада башкаруучулук чектөөлөр, минималдуу–максималдуу баа эрежелери, адамдын бекитүүсү, коопсуздук катмарлары жана күтүлбөгөн рынок шарттарында артка кайтуу саясаттары болушу керек. Булар булак изилдөөдө эксперименталдык түрдө текшерилген эмес.
Түркия жагынан кандай бааланууга тийиш?
Булакта Түркиядан завод же рынок маалыматтары жок. Ошондуктан изилдөөдөгү пайда жана запас көрсөткүчтөрүн Түркиядагы өндүрүш ишканаларына түздөн-түз көчүрүүгө болбойт.
Ошол эле учурда, бул ыкма ERP, MES, өндүрүш чыгымдары, запас, суроо-талап жана баа тарыхын чогуу сактаган Түркиядагы өндүрүш ишканаларында өзүнчө пилоттук изилдөө үчүн алкак бере алат. Жергиликтүү колдонууда модель фирманын өз кубаттуулугу, чыгымы, заказы, валюта курсу, энергиясы жана камсыздоо чынжыры динамикалары менен кайра окутулуп, реалдуу операцияга чейин көлөкө режиминде текшерилиши керек.
Булак жана Ыкма Эскертүүсү
Оригиналдуу изилдөөнүн толук аталышы: Profit-Oriented Production and Pricing Optimization for Manufacturing Enterprises Using Proximal Policy Optimization
Авторлор: Pingmei Fan, Hanwu Li, Mengdie Hu.
Авторлордун ирети: Булактагы изилдөөнүн ирети өзгөртүүсүз сакталган.
Жооптуу автор: Pingmei Fan.
Биргелешкен биринчи/тең салым: Булакта биргелешкен биринчи авторлук же тең салым жөнүндө билдирүү жок.
Мекеме 1: Guangxi Vocational Normal University, Nanning, Guangxi, China.
Мекеме 2: Amazon.com Services LLC, Bellevue, Washington, USA.
Мекеме 3: Systems Engineering, University of Pennsylvania, Philadelphia, Pennsylvania, USA.
Булак түрү: Бекемдөөчү үйрөнүүгө негизделген эсептөө/моделдөө жана симуляция изилдөөсү.
Журнал: Economics and Management Innovation.
Том / сан: Vol. 3, No. 2 (2026).
Беттер: 8–17.
DOI: 10.71222/zsm3tb33
Жөнөтүлгөн дата: 1 январь 2026.
Кайра каралган дата: 25 февраль 2026.
Кабыл алынган дата: 12 март 2026.
Жарыяланган дата: 18 март 2026.
Расмий макала шилтемеси: https://doi.org/10.71222/zsm3tb33
Рецензиялоо/жарыялоо абалы: Economics and Management Innovation журналынын басмачы барагы журналды рецензияланган жана кош сокур рецензия процессин колдонгон деп сүрөттөйт; GBP автордук саясаты жарыяланган иштер үчүн кеминде эки көз карандысыз рецензенттин отчетун талап кыларын билдирет. Макала деңгээлиндеги рецензент отчеттору бул кароодо ачык булактан ырасталган эмес.
Лицензия: Булак PDFде иш Creative Commons Attribution лицензиясынын алдында мүмкүн болгон ачык жеткиликтүү жарыялоого берилгени айтылат. GBPнин учурдагы жалпы жарыялоо саясаты жарыяланган макалалар CC BY 4.0 астында экенин билдирет.
Каржылоо: Каралган макала текстинде изилдөөгө тиешелүү өзүнчө каржылоо билдирүүсү жок.
Маалыматтардын жеткиликтүүлүгү: Каралган макалада өзүнчө Data Availability Statement жок. Реалдуу ишкана маалыматтарынын кимдиги ачык айтылбайт жана маалымат топтому үчүн ачык репозиторий шилтемеси берилген эмес.
Кызыкчылыктар кагылышы: Каралган макалада авторлордун изилдөөгө тиешелүү өзүнчө кызыкчылыктар кагылышы билдирүүсү жок.
Этика комитети: Каралган текстте изилдөөгө тиешелүү этика комитетинин билдирүүсү жок.
CRediT/автордук салымдар: Булакта өзүнчө CRediT же автордук салымдар бөлүмү жок.
Маалымат камтуусу: Макала реалдуу ишкана маалыматтары менен синтетикалык симуляция маалыматтары бириктирилген, болжол менен 36.000 үлгүдөн турган маалымат топтомун билдирет. Реалдуу компонент 2021–2023 мезгилиндеги орточо көлөмдөгү керектөө товарларын өндүрүүчүнүн ERP жана MES жазууларынан алынган. Реалдуу жана синтетикалык үлгүлөрдүн өзүнчө көлөмү көрсөтүлгөн эмес.
Негизги методологиялык чек: Изилдөө реалдуу убакыттагы заводго жайгаштыруу эмес. Натыйжалар түзүлгөн эксперименттик чөйрөдө алынган benchmark көрсөткүчтөрү. Синтетикалык маалымат түзүү, маалымат бөлүү ыкмасы, baseline гиперпараметрлери жана кайталоолор арасындагы белгисиздик өлчөмдөрү жетиштүү кеңири берилбегендиктен, көз карандысыз кайра өндүрүмдүүлүк чектелүү.
Булак ичиндеги көрсөткүч дал келбестиги: 1-таблицага ылайык PPO-P³OSтун 62,2×10³ USD орточо пайдасы A2Cнин 55,1×10³ USD маанисинен болжол менен %12,9 жогору жана запас тобокелдиги A2Cнин %8,5 маанисинен PPO-P³OSто %7,1-ге төмөндөп, болжол менен %16,5 азаят. DQN базалык катары алынганда ошол эле айырмалар тиешелүүлүгүнө жараша болжол менен %18,9 жана %23,7. Ошого карабастан, кыскача жана жыйынтык бөлүмдөрүндө %12,8 пайда өсүшү жана %16,4 запас азайышы DQN менен бирге айтылат. Болжол менен %50,9 акыркы жоготуу азайышы болсо DQN салыштыруусуна туура келет. Бул Verianla мазмунунда чийки таблица маанилери негиз катары алынган.
Терминология эскертүүсү: Булактын кыскача жана жыйынтык бөлүмдөрүндө көрсөткүч өсүшү “cumulative profit” деп аталат, ал эми 1-таблица жана 2-сүрөттө колдонулган өлчөм “Average Profit”. Бул эки түшүнүк тең деп кабыл алынган эмес.
Адабият тизмесинин бүтүндүгү боюнча эскертүү: Макаланын айрым текст ичиндеги шилтемелери адабият тизмеси менен дал келбейт. Айрыкча [1] жана [5] номерлүү булактардын текстте байланыштырылган изилдөөлөрү менен адабият тизмесинде көрсөтүлгөн иштердин ортосунда ачык тема/автор дал келбестиги бар.
Илимий мазмун чеги: Бул Verianla макаласындагы модель түзүлүшү, теңдемелер, маалымат өзгөчөлүктөрү, гиперпараметрлер, окутуу ийри сызыктары жана көрсөткүч натыйжалары оригиналдуу изилдөөгө негизделген. Тышкы булактар библиографиялык идентификацияны, DOIни, журналды жана басмачынын рецензия/лицензия саясаттарын текшерүү үчүн гана колдонулган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген