

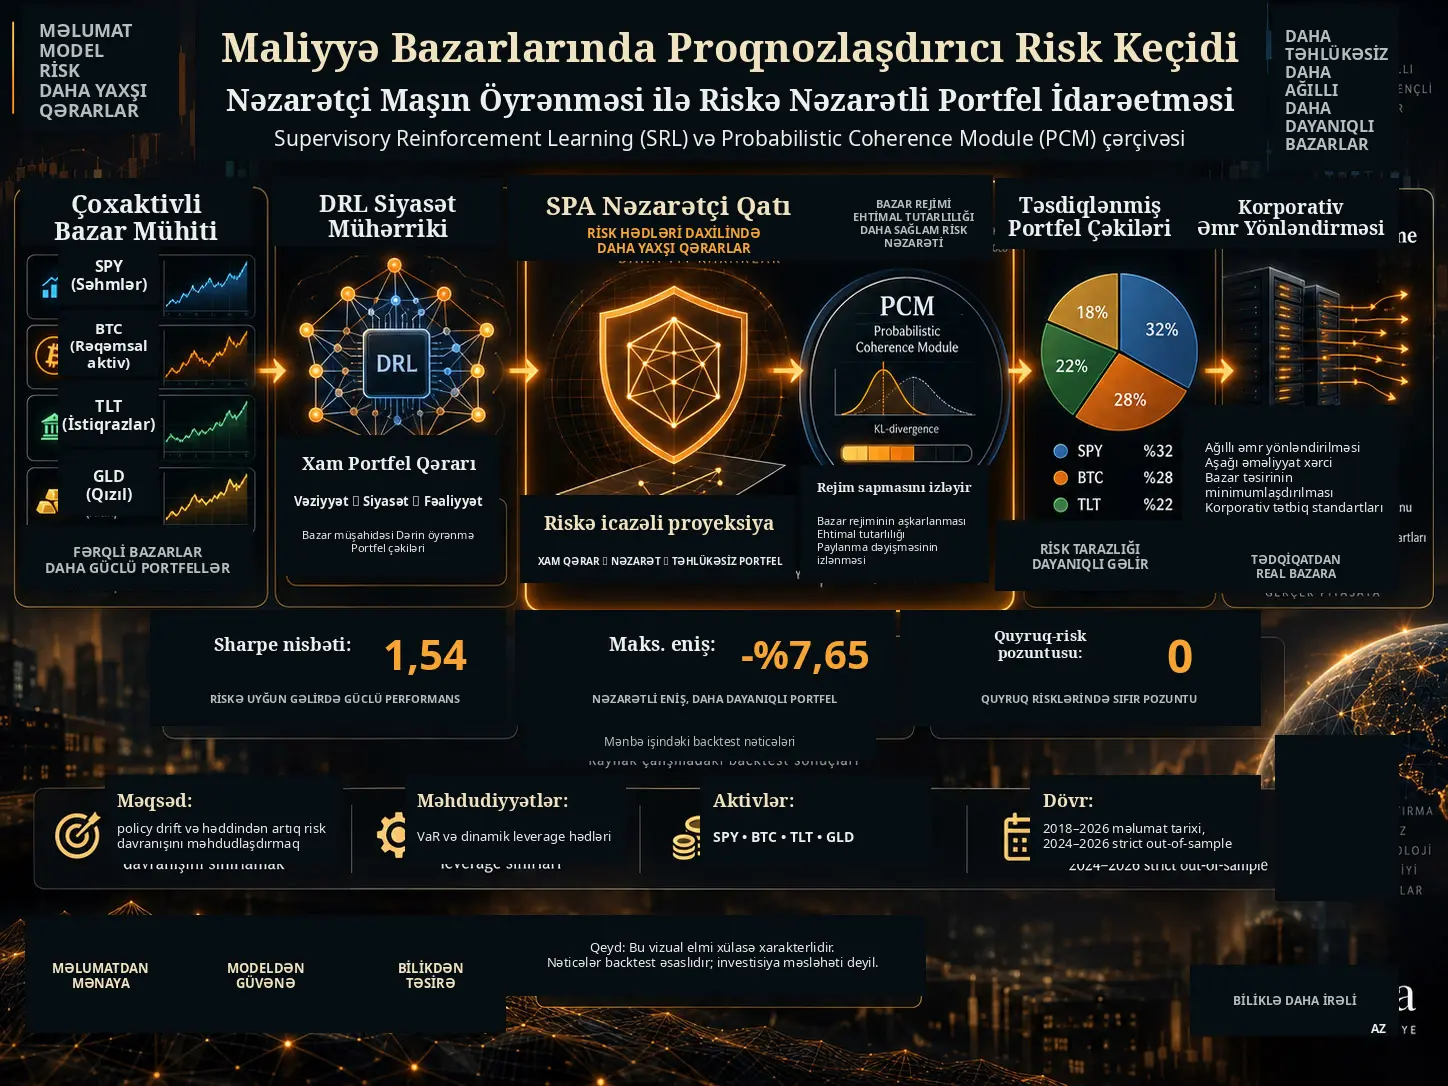
Maliyyə bazarlarında Deep Reinforcement Learning (DRL), keçmiş məlumatlardan sabit portfel qaydası öyrənmək əvəzinə dəyişən bazar vəziyyətlərinə uyğun olaraq davamlı şəkildə çəkilər yarada bilən modellərin qurulmasına imkan verir. Lakin bu çeviklik eyni zamanda risk yaradır: model təlim dövründə kifayət qədər qarşılaşmadığı bazar rejimi ilə üzləşdikdə həddindən artıq cəmlənmiş və ya risk hədlərindən kənara çıxan portfellər yarada bilər. Stephen Muli Kithimba-nın işi bu problemi DRL modelinin qərarvermə qabiliyyətini aradan qaldırmadan onun qarşısına ayrıca riyazi risk nəzarətçisi yerləşdirməklə həll etməyi hədəfləyən Supervisory Reinforcement Learning (SRL) çərçivəsini müəyyənləşdirir.
SRL-nin mərkəzində duran Supervisory Projection Architecture (SPA), DRL modelinin yaratdığı xam portfel çəkisini birbaşa bazara göndərmək əvəzinə onu icazə verilən risk sahəsindəki ən yaxın portfelə proyeksiya edir. Bu sahə leverage və Value-at-Risk (VaR) kimi məhdudiyyətlərlə müəyyənləşdirilir. Buna əlavə edilən Probabilistic Coherence Module (PCM) isə cari bazar paylanmasının istinad rejimindən nə qədər uzaqlaşdığını Kullback–Leibler divergence vasitəsilə izləyir; bazar strukturundakı sapma müəyyən edilmiş həddi keçdikdə risk limitlərini daraldaraq portfeli daha müdafiəkar hala gətirməyi hədəfləyir.
Mənbədə SPY, BTC, TLT və GLD istifadə edilərək aparılan tarixi və sintetik testlərdə tam SRL+PCM arxitekturası üçün Sharpe əmsalı 1,54, illik volatillik %11,14 və maksimum drawdown -%7,65 olaraq bildirilmişdir. SAC müqayisəsində Sharpe 0,75 və maksimum drawdown -%39,54-dür. Lakin bu rəqəmlər tarixi backtest və simulyasiya nəticələridir; canlı ticarət performansı və ya gələcəkdə əldə ediləcək gəlirin zəmanəti deyil.
DRL Portfellərində “Policy Drift” Nədir?
Tədqiqatda policy drift, DRL modelinin təlim zamanı öyrəndiyi vəziyyət–hərəkət münasibətlərinin bazar paylanması dəyişdikdə etibarlılığını itirməsi və normal şəraitdə verməyəcəyi qədər aqressiv portfel qərarları yaratması kimi nəzərdən keçirilir.
Maliyyə bazarları stasionar sistemlər deyil. Volatillik, likvidlik, korrelyasiya, faiz mühiti və bazar mikrostrukturu zamanla dəyişə bilər. Buna görə keçmiş məlumatlarda yaxşı işləyən siyasət fərqli rejimdə out-of-distribution vəziyyətlərlə qarşılaşa bilər.
DRL baxımından əsas problem modelin bu yeni vəziyyətlərdə yenə də hərəkət yaratmalı olmasıdır. Neural network vəziyyət məkanının təlim zamanı kifayət qədər təmsil olunmamış hissəsində də riyazi olaraq portfel çəkisi hesablaya bilər; lakin hesablanan hərəkətin iqtisadi və ya risk baxımından etibarlı olduğuna zəmanət verilmir.
Mənbə xüsusilə üç təhlükəyə diqqət çəkir:
- həddindən artıq aktiv cəmlənməsi,
- gross leverage artımı,
- tail-risk hədlərinin gec aşkarlanması.
Buna görə tədqiqat “modelin risk hədlərini təlim zamanı öyrənməsini gözləmək” ilə “model nə yaradırsa-yaratsın, əmrdən əvvəl onu riyazi risk filtrindən keçirmək” arasında fərq qoyur.
Soft risk cəzası ilə hard risk məhdudiyyəti arasındakı fərq
Ənənəvi riskə həssas reinforcement learning sistemlərində VaR, drawdown və ya leverage kimi risk ölçüləri reward function daxilinə cəza termini kimi əlavə edilə bilər. Bu yanaşmada model risk həddini pozduqda daha aşağı reward alaraq zamanla bunu etməməyi öyrənməyə çalışır.
Kithimba-nın təklif etdiyi arxitekturada isə risk həddi yalnız reward daxilində təmsil olunmur. Modelin yaratdığı portfel hərəkəti əməliyyatdan əvvəl riyazi olaraq icazə verilən çoxluğa daşınır.
Beləliklə iki ayrı funksiya yaranır:
| Qat | Əsas vəzifə |
|---|---|
| DRL Policy Engine | Gəlir/alpha imkanlarını araşdıraraq hədəf portfel çəkilərini yaratmaq |
| Supervisory Layer | Yaradılan çəkinin institusional risk hədlərini aşmasının qarşısını almaq |
Nəzarət Qatı Xam Portfel Qərarını Necə Dəyişdirir?
Modelin əsas əməliyyatı convex projection problemidir. DRL şəbəkəsi əvvəlcə xam hədəf bölgüsünü yaradır:
\[ a_t=\pi_\theta(s_t) \]
Burada \(s_t\) bazarın müşahidə olunan vəziyyətini, \(\pi_\theta\) DRL siyasətini, \(a_t\) isə modelin istədiyi xam portfel çəkilərini təmsil edir.
Nəzarət qatı daha sonra bu vektoru icazə verilən risk çoxluğuna proyeksiya edir:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Buradakı \(\Omega_t\), \(t\) zamanında qəbul edilə bilən portfellərin yaratdığı risk sahəsidir.
Proyeksiya problemi mənbənin əsas məntiqinə görə:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
şəklindədir.
Başqa sözlə, sistem DRL modelinin fikrini tamamilə silmək əvəzinə, risk qaydalarına cavab verən portfellər arasında xam qərara Evklid məsafəsinə görə ən yaxın bölgünü axtarır.
Risk sahəsi sabit deyil
Tədqiqatda icazə verilən çoxluq:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
kimi müəyyənləşdirilir.
Burada:
- \(C_t\): bazarın istinad paylanmasından uzaqlığını ölçən coherence göstəricisi,
- \(\Sigma_t\): cari covariance/regime matrisi,
- \(L_t\): dinamik leverage həddidir.
Beləliklə risk nəzarətçisi yalnız “portfeldə BTC ən çox bu qədər olsun” kimi sabit qayda deyil. Bazar rejimi dəyişdikcə icazə verilən portfel həndəsəsinin də dəyişməsi nəzərdə tutulur.
Leverage həddi
Mənbədə istifadə olunan əsas məhdudiyyətlərdən biri:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
şəklindədir. Bu ifadə portfelin ümumi gross exposure səviyyəsini məhdudlaşdırır.
Value-at-Risk həddi
İkinci mərkəzi məhdudiyyət:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
şəklindədir.
Mənbənin alqoritm nümunəsində %95 səviyyəsinə uyğun olan \(z=1.645\) dəyəri istifadə edilir.
Bu quruluş modelin gözlənilən gəlir baxımından cəlbedici hesab etdiyi portfeli, covariance matrisinin göstərdiyi risk müəyyən edilmiş VaR həddini aşırsa, kiçiltməyə imkan verir.
Probabilistic Coherence Module Bazar Rejiminin Dəyişdiyini Necə Anlayır?
PCM, cari bazar xüsusiyyətlərinin istinad kimi qəbul edilən paylanmadan nə qədər uzaqlaşdığını Kullback–Leibler divergence ilə ölçməyi hədəfləyir.
Mənbədə cari bazar:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
və istinad rejimi:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
kimi modelləşdirilmişdir.
Coherence metrikası:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
üzərindən qurulur.
İki çoxdəyişənli Gaussian paylanması üçün mənbə determinant, trace və orta fərqlərini ehtiva edən qapalı formalı KL ifadəsindən istifadə edir.
Hədd aşılarsa nə baş verir?
Mənbənin 9-cu səhifəsindəki Şəkil 2-də \(C_t\) zaman üzrə izlənir və \(\tau_c\) adlı breach threshold ilə müqayisə edilir. \(C_t\) həddin üzərinə çıxdıqda supervisor daha aşağı risk tolerantlığına keçir. :contentReference[oaicite:12]{index=12}
Bu mexanizm tədqiqatda dynamic leverage braking adlandırılır. Məqsəd bazar paylanmasındakı dəyişiklik DRL modelinin yenidən öyrənməsini gözləmədən mövqe hədlərini daraltmaqdır.
Covariance yenilənməsi
Tədqiqatda covariance quruluşu order-book imbalance xüsusiyyətlərindən istifadə etməklə exponential smoothing vasitəsilə yenilənir:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
və nümunə tətbiqində:
\[ \lambda=0.05 \]
istifadə edilir.
\(\Phi_t\), ani limit-order-book imbalance vektorunu təmsil edir.
Konveks Proyeksiyanın Riyazi Təminatı Nədir?
Mənbənin əsas nəzəri nəticəsi odur ki, risk çoxluğu \(\Omega_t\) boş olmayan, qapalı və konveks qaldığı müddətdə orthogonal projection operatoru non-expansive olur.
İki xam hərəkət \(a\) və \(b\) üçün:
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
alınır.
Bunun mənası supervisor-un iki DRL qərarı arasındakı məsafəni böyütməməsidir. Proyeksiya xam siyasət dəyişikliyini daha böyük portfel dəyişikliyinə çevirə bilməz.
Tədqiqat bunu ardıcıl network update-ləri üçün də genişləndirərək projected operational update-in conditional variance-nın underlying network parameter step ilə məhdudlandığını göstərir.
Bu nəticə vacib olsa da düzgün şərh edilməlidir: riyazi zəmanət portfelin zərər etməyəcəyinə zəmanət vermir. Zəmanət proyeksiya operatorunun göstərilən konveks çoxluq və riyazi fərziyyələr altındakı həndəsi davranışı ilə bağlıdır.
Tədqiqatın Metodu və Nəticələri
Aktiv kainatı
| Ticker | Təmsil etdiyi aktiv sinfi |
|---|---|
| SPY | ABŞ səhmləri |
| BTC | Rəqəmsal aktiv |
| TLT | Uzunmüddətli ABŞ Xəzinə istiqrazları / sabit gəlir |
| GLD | Qızıl / sərt əmtəə |
Zaman bölgüsü
Mənbənin eksperiment protokolu üç bloka bölünmüşdür:
| Dövr | Funksiya |
|---|---|
| Yanvar 2018 – Dekabr 2022 | In-sample training |
| Yanvar 2023 – Dekabr 2023 | Hyperparameter validation |
| Yanvar 2024 – Mart 2026 | Strict out-of-sample walk-forward test |
Buna görə tədqiqatın məlumat tarixçəsi 2018-ci ilə qədər uzansa da, müəyyən edilmiş strict out-of-sample test dövrü 2024–Mart 2026-dır.
Əməliyyat xərci
Backtest-lərdə round-turn başına 5 bazis bəndi əməliyyat xərci tətbiq edilmişdir. Mənbə həmçinin sabit seed=42 istifadə etdiyini bildirir.
Müqayisə olunan modellər
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- Təklif olunan SRL + PCM
Gəlir sırasının ekonometrik yoxlamaları
Mənbə backtest-dən əvvəl müxtəlif statistik testlər bildirir.
ADF: Bütün test ticker-larında unit-root null hipotezinin %1 səviyyəsində rədd edildiyi bildirilir.
Ljung–Box: Mənbə \(Q=48.2,\ p<0.01\) bildirir və return sıralarında qalıq avtokorrelyasiyanın olduğunu qeyd edir.
ARCH-LM: \(p<0.01\) nəticəsi volatillik klasterləşməsinə dəlil kimi şərh edilir.
Jarque–Bera: Normal paylanma rədd edilir. Mənbə SPY üçün kurtosis 5,82, BTC üçün 14,21 bildirir.
Mənbədə bildirilən performans
| Model | İllik gəlir | İllik volatillik | Sharpe | Sortino | Maks. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Cədvəl mühüm fərqi göstərir: təklif olunan model mənbədə ən yüksək nominal illik gəliri yaratmır. SAC üçün %19,82, SRL+PCM üçün %17,21 bildirilmişdir. Təklif olunan arxitekturanın iddia edilən üstünlüyü daha aşağı volatillik və drawdown sayəsində daha yüksək riskə uyğunlaşdırılmış performansdır.
Sharpe etibar intervalları
Mənbədə SRL+PCM üçün Sharpe:
1,54 [1,41–1,67]
olaraq verilir. Digər modellər üçün:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Mənbə bu qiymətləndirməni 5.000 block-bootstrap iterasiyası ilə əlaqələndirir.
Ablation analizi nə göstərir?
Mənbənin ablation cədvəlində risk qatları mərhələli şəkildə əlavə edilir:
| Konfiqurasiya | Sharpe | Artım | Mənbədə bildirilən drawdown azalması | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | İstinad | 0,00 |
| Yalnız SPA | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Bu nəticələr tədqiqatın backtest dizaynında risk nəzarətinin performans fərqindəki rolunu ayırmağa çalışır. Lakin ablation nəticələri yenə eyni tədqiqat mühitinə aiddir və fərqli bazar, xərc və ya hyperparameter quruluşlarında eyni böyüklükdə təsirə zəmanət vermir.
Q3 2022 müdaxilə nümunələri
Mənbənin Cədvəl III-ü supervisor-un xam portfel bölgülərini necə dəyişdirdiyinə dair üç nümunə verir.
- 15 İyul 2022, SPY: təklif olunan +0,65 çəki qəbul edilə bilən sahədə qaldığı üçün +0,65 olaraq keçirilib.
- 19 Avqust 2022, BTC: +0,85 xam çəki risk həddində kəsilərək +0,52-yə endirilib.
- 13 Sentyabr 2022, SPY: +0,95 xam çəki coherence breach-dən sonra +0,15-ə endirilib.
Mənbə son hadisə üçün %4,3-lük lokal bazar enişindən qaçıldığını bildirir. Bu, tədqiqatın simulyasiya edilmiş/backtest müdaxilə nümunəsidir; canlı investisiya hesabında təsdiqlənmiş əməliyyat deyil.
Sistemin Ən Mühüm Məhdudiyyətləri Nələrdir?
1. Optimallaşdırma gecikməsi
DRL modelinin forward pass-i sürətli ola bilər; lakin ardınca işləyən iterative convex optimizer əlavə gecikmə yaradır. Mənbə aşağıölçülü \(N=4\) sistemdə 1,2–4,5 ms, \(N=100\) səviyyəsində isə 15–40 ms intervalında solver latency bildirir.
Müəllif buna görə mövcud arxitekturanın sub-second high-frequency execution əvəzinə çoxsaatlıq və ya gündəlik yenidən balanslaşdırma üçün daha uyğun olduğunu qeyd edir.
2. Konveks olmayan qaydalar
Riyazi zəmanət risk sahəsinin qapalı və konveks olmasından asılıdır. Lakin real portfellərdə:
- minimum lot ölçüsü,
- binary concentration qaydaları,
- step-function transaction costs
kimi diskret şərtlər ola bilər.
Bunlar feasible set-i non-convex etdikdə sadə quadratic projection artıq eyni riyazi təminatı vermir. Mənbə belə hallarda Mixed-Integer Non-Linear Programming kimi daha mürəkkəb üsullara ehtiyac yarana biləcəyini bildirir.
3. Çox sürətli rejim qırılmalarında ölçmə gecikməsi
PCM bazar dəyişməsini dərhal “bilən” sistem deyil. Yeni order-book müşahidələri toplandıqca divergence ölçür. Mənbə flash crash kimi hadisələrdə təxminən 2–5 saniyəlik inference lag yarana biləcəyini və bu müddətdə baseline risk parametrlərinin qüvvədə qalacağını bildirir.
4. Pseudo-code ilə çap edilmiş Python kodu arasındakı fərq
Tədqiqatın Algorithm 1 bölməsində:
\[ \sum_i w_i=1 \]
şəklində fully-invested şərti açıq şəkildə mövcuddur.
Buna qarşılıq 18–19-cu səhifələrdə verilən SupervisoryProjectionArchitecture sinfinin project_action() funksiyası bu equality constraint-i optimizer-ə əlavə etmir. Kod yalnız:
- gross leverage həddi,
- VaR həddi,
- \(0\leq w_i\leq1\) bounds
tətbiq edir.
Beləliklə məqalədəki alqoritmik təsvir ilə çap edilmiş executable blueprint tam olaraq eyni feasible portfolio set-i müəyyənləşdirmir. Təkrar istehsal tədqiqatında bu fərqin aradan qaldırılması lazımdır.
5. Backtest ilə real bazar tətbiqi eyni şey deyil
Mənbənin performans nəticələri tarixi məlumatlar, müəyyən edilmiş transaction cost modeli və sintetik perturbation ssenariləri üzərində hesablanmışdır. Slippage, bazar təsiri, məlumat gecikməsi, tutum limiti, broker davranışı və model yenilənməsi xətaları canlı mühitdə fərqli ola bilər.
Gələcək tədqiqat istiqamətləri
Müəllif üç əsas inkişaf sahəsi müəyyənləşdirir:
Differentiable optimization: convex solver-in Cvxpylayers və ya OptNet tipli strukturlarla birbaşa neural network computation graph daxilinə alınması.
Meta-supervisor: non-convex və diskret risk qaydaları üçün ikinci DRL agentinin yuxarı səviyyəli nəzarətçi kimi istifadə edilməsi.
Multi-Agent Reinforcement Learning: səhmlər, fixed-income, digital asset və müxtəlif regional portfel agentlərinin mərkəzləşdirilmiş supervisor altında birləşdirilməsi.
Tədqiqatın dəstəklədiyi nəticələr
- Qapalı və konveks risk çoxluğuna orthogonal projection non-expansive operator kimi müəyyən edilə bilər.
- DRL hərəkəti ilə risk tətbiqi riyazi olaraq ayrı qatlara bölünə bilər.
- Mənbənin test mühitində SRL+PCM müqayisə olunan modellərdən daha yüksək Sharpe və daha aşağı maksimum drawdown yaratmışdır.
- PCM-nin əlavə edilməsi mənbədə SPA-only strukturu ilə müqayisədə əlavə riskə uyğunlaşdırılmış performans artımı ilə əlaqələndirilmişdir.
- Dinamik bazar sapmasını KL divergence əsaslı trigger ilə risk hədlərinə bağlamaq hesablanabilən supervisory mexanizm təqdim edir.
Tədqiqatın dəstəkləmədiyi nəticələr
- SRL+PCM-nin bütün bazar dövrlərində və ya bütün portfellərdə üstün olduğunu sübut etmir.
- Sharpe 1,54 dəyərinin gələcəkdə qorunacağını göstərmir.
- “0 breach” nəticəsi real bazarlarda heç bir risk həddinin aşılmayacağına zəmanət vermir.
- Konveks proyeksiya kapital itkisini riyazi olaraq aradan qaldırmır.
- Backtest nəticələri canlı investisiya performansı ilə eyni deyil.
- Tədqiqat SPY, BTC, TLT və ya GLD üçün investisiya məsləhəti yaratmır.
Mənbə və Metod Qeydi
Tam orijinal başlıq:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Müəllif: Stephen Muli Kithimba.
İnstitusional təsvir: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Yazılma tarixi: 15 Mart 2026.
SSRN: 20 səhifəlik preprint; İyun 2026.
DOI: 10.2139/ssrn.6830019. Ayrı versiyada Zenodo DOI: 10.5281/zenodo.20389884.
Rəyçilik statusu: SSRN working paper / preprint. Yoxlanılan qeyd rəyli jurnal nəşri deyil.
Müəllif hüququ: SSRN qeydi All Rights Reserved kimi siyahıya alınır.
Maraq toqquşması: SSRN qeydinə görə bildirilməyib.
Maliyyələşdirmə: Müəllif tədqiqatın xarici maliyyə olmadan müstəqil aparıldığını bildirir.
Tədqiqat quruluşu: Riyazi SRL/SPA/PCM arxitekturası, nəzəri projection nəticələri, dörd aktivli portfolio backtest, model müqayisələri, block-bootstrap və ablation analizi.
Məlumat dövrü: Yanvar 2018–Mart 2026. Eksperiment protokoluna görə strict out-of-sample dövrü Yanvar 2024–Mart 2026-dır.
Aktivlər: SPY, BTC, TLT, GLD.
Benchmark modellər: LSTM Portfolio, A2C, PPO və SAC.
Mənbədə bildirilən SRL+PCM performansı: illik gəlir %17,21; illik volatillik %11,14; Sharpe 1,54; Sortino 2,08; maksimum drawdown -%7,65.
Kritik təkraristehsal qeydi: Algorithm 1-də yer alan fully-invested equality constraint PDF-nin sonundakı Python implementasiyasında yoxdur. Buna görə çap edilmiş kod ilə formal alqoritm eyni optimallaşdırma problemini tam şəkildə təmsil etmir.
Biblioqrafik diqqət: Mənbə siyahısındakı bəzi qeydlər bu yoxlama zamanı müstəqil nəşriyyat qeydi ilə təsdiqlənə bilmədiyindən Verianla izahının əsas elmi dayağı kimi istifadə edilməmişdir.
Maliyyə şərhi həddi: Nəticələr keçmiş məlumatlar üzərində qurulmuş tədqiqat nəticələridir. İnvestisiya məsləhəti, gözlənilən gələcək gəliri və ya kapital itkisinə qarşı zəmanət deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib