

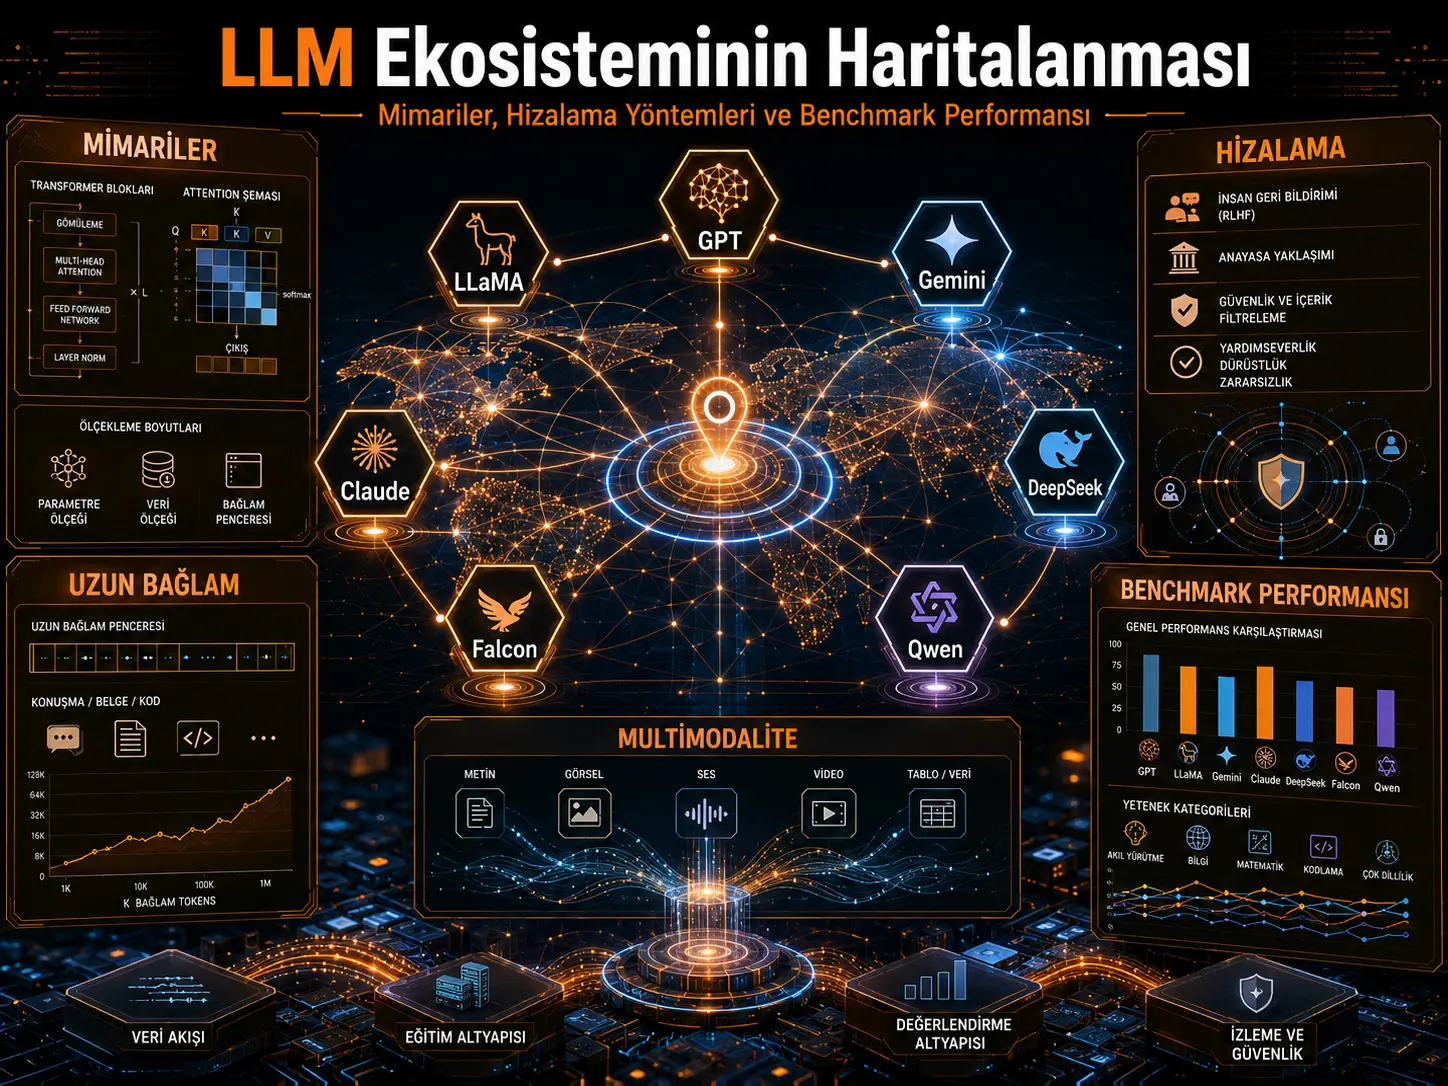
Ири тил моделдери эми жөн гана көбүрөөк параметрге ээ текст генераторлору катары өнүкпөй калды. Азыркы системалар; көңүл буруу механизми кандай эсептелери, кайсы эксперттер активдештирилери, жүз миңдеген же миллиондогон token узундугундагы context кандай иштетилери, сүрөт–үн–видео сыяктуу ар башка маалымат түрлөрү кандай бириктирилери жана адам артыкчылыктары менен коопсуздук эрежелери моделге кандай өткөрүлөрү сыяктуу көп сандагы архитектуралык жана окутуу чечимдеринин биригишинен турат. Бул сереп изилдөөсү GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon жана Qwen болуп жети ири LLM үй-бүлөсүн жалпы таксономиянын астында салыштырууну максат кылат.
Изилдөөчүлөр ачык техникалык отчетторду, model card-тарды жана модель документтерин пайдаланып, 50дөн ашык өкүлчүлүктүү LLM архитектурасын кайра түзүшкөн; моделдерди attention механизми, нормалдаштыруу, позициялык коддоо, dense же mixture-of-experts routing, context башкаруу, окутуу стратегиясы, alignment жана multimodal жөндөм сыяктуу өлчөмдөр боюнча коддошкон. Изилдөө бул таксономияны интерактивдүү карап чыгуу үчүн ачык коддуу LLM Model Explorer интерфейсин да сунуштайт.
Макаланын салыштырмалуу benchmark таблицасында GPT-4/GPT-4o үй-бүлөсү MMLU боюнча %86,4 жана GSM8K боюнча %92,0; Gemini 1.5 HumanEval боюнча %74,9; Claude 3.x SWE-bench боюнча %49,0; DeepSeek үй-бүлөсү GSM8K боюнча %89,4 жана SWE-bench боюнча %42,5 деп көрсөтүлгөн. Бирок бул сандар бир эле жалпы benchmark жүрүшүндө өндүрүлгөн эмес. Алар ар башка модель версияларынан, өндүрүүчү отчетторунан, leaderboard-дордон, prompting ыкмаларынан жана баалоо протоколдорунан чогултулган. Ошондуктан булак изилдөө бул маанилер индикативдүү мүнөздө экенин жана моделдердин ортосунда толук түз салыштырылбай турганын ачык белгилейт.
Изилдөөнүн негизги салымы белгилүү бир LLM “жеңүүчү” экенин жарыялоодон көбүрөөк, заманбап ири тил моделдери кайсы дизайн окторунда бири-биринен айырмаланарын көрүнүктүү кылуу болуп саналат. Сереп сунуштаган негизги тенденциялар; натыйжалуураак attention механизмдерине өтүү, узун context үчүн модулдук эсептөөнү издөө, ачык салмактуу моделдерде RoPE жана RMSNorm сыяктуу компоненттердин кеңири таралышы, multimodal системалардын өсүшү жана RLHF, RLAIF же Constitutional AI сыяктуу alignment ыкмаларынын модель иштеп чыгууда борбордук орунга келиши болуп саналат.
Муну менен бирге таксономиядан чыгарылган айрым күчтүү тыянактар эксперименттик түрдө ырасталган архитектуралык мыйзамдар эмес. Айрыкча “32Kдан узун context бар бардык моделдер sparse expert routing колдонот” деген тыянак изилдөөнүн өз GPT-4o жана Claude context таблицалары менен шайкеш келбейт. Benchmark айырмаларын белгилүү архитектуралык өзгөчөлүктөргө байланыштырган түшүндүрмөлөр да контролдолгон абляция эксперименттеринен эмес, үй-бүлөлөр аралык байкоочу салыштыруулардан чыгарылган.
| Изилдөөнүн камтуусу | Булакта билдирилген түзүлүш | Кантип чечмелениши керек? |
|---|---|---|
| LLM үй-бүлөсү | 7 | GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon жана Qwen |
| Кайра түзүлгөн архитектура | 50+ | Техникалык документтерден жана model card-тардан жогорку деңгээлде кайра түзүлгөн. |
| Негизги салыштыруу октору | Архитектура, окутуу, alignment, context, multimodality, коопсуздук, benchmark | Жалпы таксономиянын астында изилденген. |
| Benchmark ыкмасы | Экинчи булактардан билдирилген натыйжалар | Жалпы эксперименттик чөйрөдө кайра өлчөнгөн натыйжалар эмес. |
| Интерактивдүү курал | LLM Model Explorer | Таксономиядагы өзгөчөлүктөрдү модель негизинде салыштырууга мүмкүндүк берет. |
| Негизги илимий чек | Контролдолгон себептик архитектура салыштыруусу жок | Таксономиялык байланыштар гипотеза өндүрөт; себептүүлүктү далилдебейт. |
Эмне үчүн “канча миллиард параметр?” деген суроо гана эми жетишсиз?
Ири тил моделдеринин алгачкы муундарында масштабдын өсүшү негизги өнүгүү окторунун бири болгон. Изилдөөнүн тарыхый баянында GPT-2нин 2019-жылдагы ири масштабдагы алдын ала окутуу ыкмасынан GPT-3түн 175 миллиард параметрине, андан кийин узун context жана multimodal моделдердин пайда болушуна чейинки өзгөрүү баяндалат.
Бирок изилдөөчүлөрдүн айтымында, заманбап LLM дизайн мейкиндигин эми бир гана чоңдук огуна түшүрүүгө болбойт. Параметр саны жакын эки система; attention механизми, активдүү эксперт саны, нормалдаштыруу ыкмасы, позициялык коддоо, маалымат аралашмасы, instruction tuning, alignment же multimodal encoder түзүлүшү себептүү абдан айырмалуу эсептөө жана жүрүм-турум профилдерин көрсөтүшү мүмкүн.
Изилдөө кайсы жети модель үй-бүлөсүн карайт?
| Модель үй-бүлөсү | Булакта каралган өкүлчүлүктүү моделдер | Изилдөө баса белгилеген негизги өзгөчөлүк |
|---|---|---|
| GPT | GPT-2, GPT-3/3.5, GPT-4, GPT-4o, O1 | Decoder-only Transformer, ири масштабдуу алдын ала окутуу, multimodality жана RLHF |
| LLaMA | LLaMA, LLaMA 2, Code LLaMA | RoPE, GQA, RMSNorm жана ачык салмактуу экосистема |
| Gemini | Gemini 1.x жана Gemini 1.5 | Multimodality, узун context жана булакта MoE катары аныкталган түзүлүш |
| Claude | Claude 2, Claude 3 жана 3.5 варианттары | Узун context, Constitutional AI жана RLAIF |
| DeepSeek | DeepSeek-V2/V3 жана Reasoner/R1 | MLA, MoE жана reasoning багытталган окутуу |
| Falcon | Falcon 7B/40B/180B, Falcon 2, Falcon 3 жана Mamba | Multi-query/multigroup attention жана state-space варианттары |
| Qwen | Qwen, Qwen2 жана Qwen-Max | RoPE, RMSNorm, SwiGLU, көп тилдүүлүк жана код/математика адистешүүсү |
Attention механизмдери эмне үчүн айырмаланат?
Классикалык Transformerдеги multi-head attention ар бир attention head үчүн өзүнчө query, key жана value проекцияларын колдонот. Ири моделдерде өзгөчө key–value кэши узун context жана жогорку бир убакыттагы колдонуучу жүгү астында маанилүү эс тутум чыгымына айланат.
Изилдөө бул маселеге ар башка үй-бүлөлөр ар башка чечимдерди алып келгенин баса белгилейт. LLaMA 2де Grouped Query Attention (GQA), Falcon жана Qwen үй-бүлөсүндө multi-query же multigroup attention, DeepSeekте болсо Multi-Head Latent Attention (MLA) сыяктуу ыкмалар бул чыгымды азайтууну көздөйт.
DeepSeekтин MLA ыкмасы key–value өкүлчүлүктөрүн төмөн өлчөмдүү latent көрсөтүүлөргө кысып, эсептөө жана сактоо жүгүн азайтууну максат кылат. Falconдун multi-query/multigroup ыкмасы да key жана value проекцияларын attention head-деринин ортосунда көбүрөөк бөлүшүү жолу менен KV-cache жүгүн азайтууга багытталган.
Mixture-of-Experts эмне берет?
Mixture-of-Experts (MoE) ыкмасында моделдин бардык параметрлери ар бир token үчүн бир учурда активдештирилбейт. Бир routing механизми киргизүүгө жараша белгилүү эксперттик чакан тармактарды тандайт. Ошентип жалпы модель сыйымдуулугу чоңойгон учурда token башына активдүү эсептөө жалпы параметр санынан төмөн кармалышы мүмкүн.
Булак изилдөө бул ыкманы өзгөчө Gemini жана DeepSeek үй-бүлөлөрүнүн масштабдануу жана узун context стратегиялары менен байланыштырат. DeepSeek-R1 үчүн 671 миллиард жалпы параметрге каршы token башына болжол менен 37 миллиард активдүү параметр маалыматы берилет.
Бирок MoEнин болушу өз алдынча жакшыраак reasoning, узунураак context же жогорураак benchmark performansынын себеби катары кабыл алынбайт. Routing ыкмасы, окутуу маалыматы, активдүү эксперт саны, attention архитектурасы жана post-training процесси натыйжаларга бирге таасир этет.
Falcon Mamba эмне үчүн башкача?
Falcon Mamba 7B классикалык self-attention ордуна Mamba state-space моделин колдонгону үчүн изилдөөдөгү маанилүү архитектуралык айырмалардын бири. Булак бул узун тизмектерде сызыктуу убакыттагы иштетүүнү жана болжолдуу туруктуу эс тутум жүрүм-турумун максат кыларын билдирет.
Falcon 3 үй-бүлөсүндө Transformer жана state-space ыкмаларынын бирге болушу заманбап LLM иштеп чыгуу эми Transformer ичиндеги вариациялардан гана эмес, attention тышындагы узун-тизмек архитектураларынан да турарын көрсөтөт.
RMSNorm, RoPE жана SwiGLU эмне үчүн көп кездешет?
Изилдөөнүн таксономиясында ачык салмактуу модель үй-бүлөлөрүнүн бир бөлүгүндө үч компоненттин көп кайталанганы көрүнөт: RMSNorm, Rotary Positional Embedding (RoPE) жана SwiGLU.
RMSNorm нормалдаштыруу чыгымын жөнөкөйлөтөт; RoPE болсо attention механизминин ичине салыштырмалуу позиция маалыматын ташыйт. SwiGLU болсо gated activation түзүлүшүн колдонот. Изилдөө LLaMA 2 жана Qwenди бул компоненттердин айкын мисалдары катары карайт.
Multimodal моделдерде эмне өзгөрөт?
Тексттен тышкаркы сүрөт, үн жана видео маалыматын иштетүү үчүн моделдин бир гана tokenizer жана тил decoderинен турушу жетишсиз. Изилдөөдө Gemini, GPT-4o жана Claude 3 бул өзгөрүүнүн ар башка мисалдары катары каралат.
Gemini архитектуралык схемасында ар башка маалымат түрлөрү modality-specific encoder-лер аркылуу иштетилип, cross-modal attention жолу менен жалпы latent мейкиндикке өткөрүлөрү көрсөтүлөт. Изилдөө GPT-4oну болсо текст, код, сүрөт, үн жана видео иштете алган бирдиктүү multimodal дизайн катары карайт.
Alignment: RLHF эмне кылат?
Reinforcement Learning from Human Feedback (RLHF) алдын ала окутулган моделдин жөн гана кийинки token ыктымалдыгын оптималдаштыруунун ордуна, адам артыкчылыктарына көбүрөөк шайкеш чыгыштарды бериши үчүн колдонулган post-training ыкмаларынын бири.
Булак изилдөө GPT-4, LLaMA 2, Claude, DeepSeek жана Qwen сыяктуу үй-бүлөлөрдө ар түрдүү supervised fine-tuning жана артыкчылык оптималдаштыруу түрлөрү колдонулганын баяндайт.
Муну менен бирге авторлор RLHF коопсуздукту толук чечпей турганын баса белгилешет. Адамдын feedback-и кымбат; reward hacking пайда болушу мүмкүн; коопсуздук окутуусу ашыкча баш тартуу жүрүм-турумуна алып келиши мүмкүн жана jailbreak же adversarial prompting тобокелдери толугу менен жоголбойт.
Constitutional AI жана RLAIF деген эмне?
Claude үй-бүлөсү изилдөөдө alignment ыкмасы жагынан өзүнчө категория катары каралат. Constitutional AIда моделдин белгилүү принциптер алкагында өз чыгышын сындоосу жана кайра жөнгө салышы максат кылынат. Reinforcement Learning from AI Feedback (RLAIF) болсо адам баалоосунун бир бөлүгүн AI тарабынан берилген feedback менен колдоону камтыйт.
Булак авторлору бул ыкма адам аннотациясына көз карандылыкты азайтышы мүмкүн экенин, бирок AI feedback-и моделден келип чыккан бир жактуулуктарды кайра өндүрүү тобокелине ээ экенин билдиришет.
Таксономиянын үч негизги үлгүсү
Макала жети модель үй-бүлөсүн жалпы өлчөмдөргө жайгаштыргандан кийин үч үй-бүлөлөр аралык үлгү сунуштайт.
| Булактын үлгүсү | Салыштырылган октор | Авторлордун тыянагы | Verianla чечмелөө чеги |
|---|---|---|---|
| A — Alignment–Efficiency Divergence | Alignment стратегиясы × attention оптималдаштыруу | Терең alignment менен эң алдыңкы attention натыйжалуулугу бир эле моделде чогуу көрүнбөйт деген ой айтылат. | Сандык аныкталган эки окто контролдолгон performans тест эмес. |
| B — Context–Routing Co-Adoption | Context узундугу × expert routing | >32K context бар моделдер sparse/модулдук routing колдонот деген ой айтылат. | Булактын GPT-4o жана Claude таблицалары менен универсалдуу билдирүү шайкеш келбейт. |
| C — Open-Weight Convergence | Ачыктуулук × нормалдаштыруу × позициялык коддоо | Ачык салмактуу моделдер RMSNorm + RoPE айланасында топтолот деген ой айтылат. | Модель үй-бүлөсүнүн ичиндеги бардык варианттар үчүн бирдей деңгээлде техникалык ачыктуулук жок. |
Pattern Bдеги ички дал келбестик эмне үчүн маанилүү?
Изилдөөнүн Pattern B тексти каралган моделдердин ичинде 32Kдан узун context window берген “ар бир модель” sparse expert routing же selective state-space катмарларын колдонот деп билдирет.
Бирок ошол эле булакта турган салыштыруу таблицасы GPT-4/GPT-4o үчүн 128K, Claude 2/3 үчүн болсо 100K–200K context window билдирет. Бул эки үй-бүлөнүн тиешелүү архитектуралык кыскача баяндарында sparse MoE же selective state-space routing көрсөтүлбөйт.
Ошондуктан булактын ичиндеги маалыматтар “узун context менен модулдук эсептөө айрым үй-бүлөлөрдө бирге кездешет” деген чечмелөөнү колдошу мүмкүн; бирок “32Kдан жогору бардык моделдер муну колдонот” деген жыйынтыкты өз таблицалары аркылуу колдобойт.
“Ачык модель” менен “ачык булак” бир эле нерсеби?
Булак изилдөөдө моделдер жабык, ачык салмактуу, жарым-жартылай ачык же изилдөө лицензиялуу сыяктуу ар башка категорияларда каралат. Бул айырма маанилүү. Модель салмактарынын жарыяланышы; окутуу маалыматы, толук окутуу коду, post-training линиясы жана коопсуздук системасынын баары ачык дегенди билдирбейт.
Ошондуктан изилдөөдөгү “open-source ecosystem” сөз айкашын окуганда ар бир үй-бүлө үчүн чыныгы ачыктуулук деңгээли ар башка болушу мүмкүн экени эске алынышы керек.
Benchmark натыйжалары эмне үчүн бир эле лига таблицасы эмес?
Макаланын Tablo 2си беш benchmarkты жанаша берет: MMLU, HumanEval, GSM8K, SWE-bench жана MathVista. Бирок таблица клеткаларынын баары бир эле модель версиясы, бир эле дата, бир эле prompting стратегиясы же бир эле evaluation harness астында өлчөнгөн эмес.
Андан тышкары таблица айрым саптарда бир эле моделди эмес, үй-бүлө ичиндеги бир нече вариантты чогуу билдирет: “GPT-4/GPT-4o”, “Claude 3.x (Opus/Sonnet)”, “Gemini 1.5 (Pro/Ultra)” же “DeepSeek (V3/Reasoner)” сыяктуу.
Ошондуктан бир саптагы MMLU скору менен ошол эле саптагы SWE-bench скору сөзсүз ошол эле checkpoint же ошол эле модель вариантынан келген деп болжолдонбошу керек.
Өндүрүүчү жана көз карандысыз benchmark айырмасы
Изилдөө өндүрүүчүлөр билдирген натыйжалар менен көз карандысыз баалоолордун ортосунда айырмалар болушу мүмкүн экенин жана өндүрүүчү скорлору MMLUда болжол менен 2–8 пайыз пунктка, GPQA-Diamond жана SWE-bench сыяктуу жаңыраак benchmarkтарда айрым учурларда болжол менен 10–15 пунктка жогору болушу мүмкүн экенин билдирет.
Авторлор бул prompting ыкмасы, баалоо программасы, модель версиясы жана мүмкүн болгон evaluation-set contamination сыяктуу факторлордон келип чыгышы мүмкүн экенин белгилешет. Бирок бул 2–8 жана 10–15 пункттук айырмаларды түзгөн бардык жупташтырылган өлчөөлөрдүн чийки маалымат таблицасы макалада берилген эмес. Ошондуктан бул диапазондор көз карандысыз meta-analysis натыйжасы катары бааланбашы керек.
Изилдөө колдогон натыйжалар
- Заманбап LLM үй-бүлөлөрү ошол эле негизги Transformer тамырынан чыкса да, attention, нормалдаштыруу, routing, context, multimodality жана alignment өлчөмдөрүндө олуттуу айырмаланат.
- GQA, MQA, MLA, FlashAttention, MoE жана state-space ыкмалары ири масштабдуу моделдерде натыйжалуулук жана узун-тизмек иштетүү маселелерине ар башка техникалык чечимдерди сунуштайт.
- RLHF жалгыз alignment ыкмасы эмес; Constitutional AI жана RLAIF сыяктуу альтернативдүү же толуктоочу ыкмалар да колдонулат.
- Ачык салмактуу жана жабык модель иштеп чыгуу экосистемалары ачыктык, кайра өндүрүлө билүү, чыгым жана коопсуздук инженериясы жагынан ар башка компромистерди камтыйт.
- Модель тандоо benchmark скоруна гана эмес, колдонуу тармагына, context муктаждыгына, multimodality, чыгым, коопсуздук жана жайгаштыруу шарттарына жараша жасалышы керек.
- Benchmark натыйжаларын модель версиясы жана баалоо протоколу маалыматы жок түз салыштыруу ишенимдүү эмес.
Изилдөө далилдебеген натыйжалар
- Ар бир тапшырма үчүн бир эле LLM үй-бүлөсү абсолюттук эң жакшы экени далилденген эмес.
- Tablo 2 маанилери жалпы контролдолгон экспериментте алынган башма-баш модель салыштыруусу эмес.
- Бир benchmark айырмасын бир гана attention механизми, MoE же alignment ыкмасы жараткандыгы далилденген эмес.
- Constitutional AI attention натыйжалуулугу менен милдеттүү физикалык trade-off түзөрү эксперименттик түрдө көрсөтүлгөн эмес.
- Узун context үчүн sparse expert routing милдеттүү шарт экени булак маалыматтары менен далилденбейт.
- Ачык салмактуу моделдер жабык моделдерге салыштырмалуу жалпы түрдө коопсузураак же кооптуураак деген жыйынтык чыгарылбайт.
- Benchmarkтагы жогорку performans реалдуу дүйнөдөгү ишенимдүүлүк, factuality же коопсуз колдонуу кепилдиги эмес.
Түркия жагынан эмнени билдирет?
Изилдөө Түркияга өзгөчө LLM салыштыруусун жүргүзбөйт жана түркчө benchmark натыйжаларын өзүнчө эксперименттик топ катары сунуштабайт. Ошондуктан таблицада жогорку натыйжа көрсөткөн бир моделдин түркчө укук, саламаттык, билим берүү, өнөр жай же мамлекеттик колдонмолордо ошол эле performansты көрсөтөт деп болжолдоого болбойт.
Түркиядагы бир уюм үчүн модель тандалса, бул таксономия архитектура боюнча алдын ала тандоо куралы катары колдонулушу мүмкүн; бирок түркчө тил performansы, тармактык терминология, маалымат жайгашуусу, жеке маалыматтарды коргоо, кечигүү, чыгым, мекеме ичиндеги жайгаштыруу талаптары жана жергиликтүү колдонуу сценарийлери өзүнчө текшерилиши керек. Бул жергиликтүү текшерүү булак изилдөөнүн аткарган анализи эмес.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Бул изилдөө классикалык системалуу сереппи?
Макала кеңири сереп жана таксономия изилдөөсү болуп саналат; бирок булак текстте PRISMA сыяктуу системалуу адабият издөө протоколу, алдын ала аныкталган маалымат базасы издөө саптары, киргизүү/чыгаруу агым схемасы же изилдөө сапатынын meta-analysisи берилген эмес.
Авторлор модель тандоону үч критерийге таяндырат:
- техникалык документтештирүүнүн жеткиликтүүлүгү,
- архитектуралык ар түрдүүлүк,
- изилдөө жана өнөр жай колдонуу жагынан маанилүүлүк.
Бул критерийлер менен GPT, LLaMA 2, Gemini, Claude, DeepSeek, Falcon жана Qwen үй-бүлөлөрү тандалган.
Архитектуралар кантип кайра түзүлдү?
Авторлор моделдердин архитектура схемаларын коомчулукка ачык техникалык отчеттордон, system card-тардан жана модель документтеринен кайра түзүшкөн. Өзгөчө жабык системалардын implementation деталдары жарыяланбагандыктан схемалар жогорку деңгээлде жана жалпы абстракция деңгээлинде кармалган.
Бааланган негизги архитектуралык өлчөмдөр төмөнкүлөр:
- Multi-Head Attention (MHA), Grouped Query Attention (GQA), Multi-Query Attention (MQA) жана Multi-Head Latent Attention (MLA),
- LayerNorm жана RMSNorm,
- dense жана mixture-of-experts routing,
- context handling жана positional encoding,
- alignment жана training pipeline-дары.
Таксономия кантип түзүлдү?
Ар бир модель категориялык жана сандык өзгөчөлүктөрдөн турган өзгөчөлүк вектору менен көрсөтүлгөн. Изилдөө ачык документтештирүүдө гана бар өзгөчөлүктөр коддолгонун жана маалымат белгисиз болгондо ашыкча майдалоодон качуу үчүн “conservative labeling” колдонулганын билдирет.
Андан соң таксономия өлчөмдөрү экилик же көп тараптуу байланыштар аркылуу салыштырылган. Мисалы alignment ыкмасы attention натыйжалуулугу менен; context length expert routing менен; модель ачыктыгы нормалдаштыруу жана positional encoding менен бирге каралган.
Verianla Live: LLM таксономиясынын түзүлүү процесси
Бул процесс булак изилдөөнүн 3.1 бөлүмүндөгү методологияга таянат. “Натыйжа” баскычындагы структуралык үлгүлөр контролдолгон эксперименттик себептүүлүк эмес, салыштырмалуу таксономиядан чыгарылган тыянактар.
| Баскыч | Булак изилдөөдөгү иш-аракет |
|---|---|
| 1. Модель үй-бүлөсүн тандоо | Документтештирүү, архитектуралык ар түрдүүлүк жана изилдөө/өнөр жай мааниси критерийлери менен жети үй-бүлө тандалды. |
| 2. Техникалык булактарды чогултуу | Техникалык отчеттор, system card-тар жана модель документтери колдонулду. |
| 3. Архитектураны кайра түзүү | 50дөн ашык өкүлчүлүктүү архитектура жалпы абстракция деңгээлинде кайра түзүлдү. |
| 4. Өзгөчөлүк коддоо | Attention, нормалдаштыруу, routing, context, positional encoding, training жана alignment өлчөмдөрү коддолду. |
| 5. Үй-бүлөлөр аралык салыштыруу | Таксономия өлчөмдөрүнүн экилик жана көп тараптуу байланыштары каралды. |
| 6. Benchmark менен байланыштырууу | Таксономия үлгүлөрү булактарда билдирилген benchmark натыйжалары менен салыштырылды. |
| 7. Гипотеза өндүрүү | Alignment–efficiency, context–routing жана open-weight convergence үлгүлөрү сунушталды. |
Булактын benchmark таблицасы
Төмөндөгү маанилер макаланын Tablo 2синен алынган. Булак изилдөөнүн өз эскертүүсү сакталууга тийиш: натыйжалар ар башка булак жана протоколдордон келгендиктен так жана түз модель рейтинги эмес.
| Модель үй-бүлөсү | MMLU (%) | HumanEval Pass@1 (%) | GSM8K (%) | SWE-bench Pass@1 (%) | MathVista (%) |
|---|---|---|---|---|---|
| GPT-4 / GPT-4o | 86,4 | 67,0 | 92,0 | 33,2 | 63,8 |
| Claude 3.x (Opus/Sonnet) | 82,1 | 60,1 | 88,0 | 49,0 | 60,5 |
| Gemini 1.5 (Pro/Ultra) | 81,9 | 74,9 | 87,8 | 35,0 | 59,2 |
| LLaMA 2 (70B) | 68,9 | 48,1 | 56,8 | 18,0 | 44,1 |
| Falcon (180B/Falcon 2) | 66,5 | 45,2 | 55,4 | 15,3 | 41,6 |
| DeepSeek (V3/Reasoner) | 79,8 | 72,6 | 89,4 | 42,5 | 61,2 |
| Qwen (Qwen2/Qwen-Max) | 78,5 | 65,3 | 83,7 | 36,4 | 58,1 |
Benchmarkтардын мааниси
| Benchmark | Изилдөөдөгү колдонуу максаты |
|---|---|
| MMLU | Ар башка билим жана маселе тармактарында жалпы тил модели performansы |
| HumanEval | Программалоо/код өндүрүү performansы |
| GSM8K | Математикалык сөздүк маселе чечүү |
| SWE-bench | Чыныгы программалык инженерия маселелеринде коддоо жөндөмү |
| MathVista | Визуалдык жана математикалык ой жүгүртүү бириккен тапшырмалар |
Модель үй-бүлөлөрүнүн context жана multimodality салыштыруусу
| Үй-бүлө | Булакта билдирилген context | Multimodal түзүлүш | Alignment / коопсуздук |
|---|---|---|---|
| GPT-4 / GPT-4o | 128K GPT-4o | Текст, сүрөт, үн, видео | SFT, RLHF, PPO, модерация жана мазмун чыпкалары |
| GPT-O1 | 8K–32K | Текст | SFT, RLHF жана reasoning багытталган сыйлык моделдери |
| LLaMA 2 | 4K | Текст | SFT, RLHF, Ghost Attention жана safety reward моделдери |
| Gemini 1.5 | 1Mга чейин | Текст, сүрөт, үн, видео, код | RLHF, expert gating жана модерация |
| Claude 2/3 | 100K–200K | Текст; Claude 3тө сүрөт | Constitutional AI, RLAIF, self-critique жана red teaming |
| Falcon | 4K–32K | Негизги үй-бүлө текст; Falcon 2де VLM варианты | Safety classifier жана LoRA негизиндеги alignment |
| DeepSeek R1/V3 | 32K–128K | Изилдөөдө негизинен текст | GRPO, SFT, синтетикалык маалымат, rejection sampling |
| Qwen | 32K+ | Изилдөөнүн салыштыруу таблицасында текст | SFT, RLHF, preference optimization жана bias mitigation |
Таксономия benchmark айырмаларына кандай түшүндүрмө берет?
Булак изилдөөнүн Tablo 6сы үч мисал benchmark айырмасын архитектуралык өлчөмдөр менен байланыштырат:
| Benchmark | Үй-бүлө A | Үй-бүлө B | Скор айырмасы | Булак байланыштырган таксономиялык өлчөмдөр |
|---|---|---|---|---|
| GSM8K | DeepSeek-V3: %89,4 | LLaMA 2: %56,8 | +32,6 пайыз пункт | MLA/GQA, MTP/next-token prediction, rejection-sampled RL/Ghost Attention RLHF |
| SWE-bench | Claude 3.x: %49,0 | GPT-4o: %33,2 | +15,8 пайыз пункт | Constitutional AI + RLAIF/RLHF-PPO жана 200K/128K context |
| HumanEval | Gemini 1.5: %74,9 | LLaMA 2: %48,1 | +26,8 пайыз пункт | MoE/dense Transformer жана 1M/4K context |
Бул таблица түздөн-түз механизм тести эмес. Ар бир салыштырууда модель үй-бүлөлөрү маалымат, параметр, post-training, модель версиясы жана evaluation protocol кошо көп сандагы башка өзгөрмөлөрдө да айырмаланат. Булак изилдөө муну ачык кабыл алып, анализдер себептүүлүк эмес, “structured explanatory hypotheses” түзөрүн билдирет.
Alignment–efficiency тыянагы эмне үчүн гипотеза деңгээлинде?
Авторлор Claudeдогу Constitutional AI/RLAIF тереңдигинин азыраак efficiency-optimized attention менен бирге көрүнүшүн, DeepSeek, Falcon жана Gemini сыяктуу attention натыйжалуулугуна басым жасаган үй-бүлөлөрдө болсо жөнөкөйүрөөк alignment линиялары колдонулушун trade-off катары чечмелешет.
Бирок изилдөөдө “alignment depth” жана “attention efficiency” үчүн жалпы сандык скор аныкталган эмес; ошол эле модель үстүндө бир гана alignment же бир гана attention ыкмасы өзгөртүлүп контролдолгон абляция жасалган эмес. Ошондуктан байланыш изилдөөнүн таксономиялык байкоосу; эсептөө зарылдыгы катары далилденген эмес.
Context–routing тыянагындагы булак ичиндеги дал келбестик
Pattern Bнин негизги сүйлөмү 32Kдан чоң context window колдонгон ар бир модель sparse expert routing же selective state-space layer колдонот деп айтат.
Бирок ошол эле макаланын өз салыштыруу таблицасында:
- GPT-4o үчүн 128K context,
- Claude 2/3 үчүн 100K–200K context
билдирилгени менен бул үй-бүлөлөрдүн архитектуралык түшүндүрмөлөрүндө MoE же selective SSM routing берилбейт.
Ошондуктан “every >32K-context model” жалпылоосу булактын ичинде ырааттуу эмес. Бул Verianla макаласында сөз болгон үлгү авторлор сунуштаган гипотеза катары гана берилген.
Ачык салмактуу модель жакындашуусу
Изилдөөнүн Pattern C тыянагына ылайык LLaMA 2, Falcon жана Qwen сыяктуу ачык/ачык салмактуу системалар RoPE жана RMSNorm сыяктуу жакшы белгилүү компоненттердин айланасында көбүрөөк топтолсо, жабык моделдер көбүрөөк гетерогендүү дизайн мейкиндиктерине тарайт.
Авторлор муну ачык модель коомчулуктарында кайра өндүрүлө жана текшериле турган компоненттердин тандалышы менен байланыштырат. Бирок өзгөчө жабык моделдердин архитектуралык деталдары чектелүү болгондуктан жабык системалардын чыныгы дизайн мейкиндигинин баары байкалбайт. Бул тыянак да ырасталган себептик механизм катары эмес, салыштырмалуу таксономия чечмелөөсү катары бааланышы керек.
Иш дүйнөсү жана коомдук натыйжалар
Изилдөөгө ылайык LLMдер документ даярдоо, код өндүрүү, маалымат талдоо жана кардарларды колдоо сыяктуу билимге бай иштерде өндүрүмдүүлүк потенциалын алып жүргөнү менен, түшүнүктүү бирок ката мазмун өндүрүү, адам көзөмөлүнүн азайышы жана туура эмес чыгышка ашыкча ишенүү сыяктуу тобокелдерди жаратышы мүмкүн.
Билим берүүдө жекелештирилген feedback мүмкүнчүлүктөрү академиялык бүтүндүк жана сынчыл ой жүгүртүү көйгөйлөрү менен бирге каралат. Төмөн ресурстуу тилдердеги performans айырмалары болсо архитектура гана эмес, маалымат камтуусу жана маданий өкүлчүлүк да модель жүрүм-турумуна таасир этерин көрсөтөт.
Изилдөөнүн келечекке багытталган изилдөө темалары
- Стандартташтырылган жана кайра өндүрүлө турган LLM баалоосу,
- төмөн ресурстуу тилдер жана маданий contextтерде cross-lingual generalization,
- узун context жана memory-augmented моделдер,
- state-space жана attention–memory гибриддери,
- model card-тар, маалымат барактары жана bias audit механизмдери,
- red teaming жана ачыгыраак коопсуздук отчеттуулугу,
- эсептөө жана энергия чыгымдарын азайтуу,
- маалыматтын келип чыгышы, интеллектуалдык менчик, купуялык жана өкүлчүлүк адилеттиги.
Булак жана Ыкма Жөнүндө Эскертүү
| Толук түпнуска изилдөө аталышы | Mapping the LLM Landscape: A Cross-Family Survey of Architectures, Alignment Methods, and Benchmark Performance |
|---|---|
| Авторлор | Deepshikha Bhati; Fnu Neha; Devi Sri Bandaru; Matthew Weber; Ishan Dilipbhai Gajera |
| Авторлордун тартиби | 1. Deepshikha Bhati; 2. Fnu Neha; 3. Devi Sri Bandaru; 4. Matthew Weber; 5. Ishan Dilipbhai Gajera |
| Бирдей салым / тең биринчи автор | Булак изилдөөдө бирдей салым же тең биринчи автор билдирүүсү көрсөтүлгөн эмес. |
| Жооптуу автор | Deepshikha Bhati |
| Мекеме | Department of Computer Science, Kent State University, Kent, Ohio, АКШ |
| Булак түрү | Салыштырмалуу сереп, архитектуралык таксономия жана LLM модель үй-бүлөсү изилдөөсү. |
| Рецензия абалы | Рецензияланган журналда жарыяланган сереп макаласы; preprint эмес. |
| Журнал | AI |
| Басма | MDPI |
| Том / сан / макала | 2026, 7(4), 142 |
| DOI | 10.3390/ai7040142 |
| Келип түшкөн дата | 11 Март 2026 |
| Ревизия датасы | 7 Апрель 2026 |
| Кабыл алынган дата | 11 Апрель 2026 |
| Жарыяланган дата | 16 Апрель 2026 |
| Расмий шилтеме | https://doi.org/10.3390/ai7040142 |
| Лицензия | Creative Commons Attribution (CC BY). |
Изилдөөнүн маалымат жана анализ мүнөзү
Бул изилдөө жаңы негизги LLM окутпайт жана жети модель үй-бүлөсүн жалпы эсептөө инфраструктурасында кайра benchmark кылбайт. Негизги илимий маалымат булагы коомчулукка ачык техникалык отчеттор, system card-тар, модель документтери жана benchmark булактары болуп саналат.
Авторлор бул документтерден 50дөн ашык модель архитектурасын жалпы абстракция деңгээлинде кайра түзүп, өзгөчөлүктөрүн коддоп, LLM Model Explorer колдонмосунун ичинде жанаша салыштырыла турган абалга келтирген.
Макаланын маалымат жеткиликтүүлүгү билдирүүсүнө ылайык анализде колдонулган маалыматтар негизги тексттин ичинде берилген. Изилдөө иштеп чыккан LLM Model Explorerдин булак коду жана жандуу көрсөтүү даректери да макаланын ыкма бөлүмүндө бөлүшүлгөн.
Каржылоо
Изилдөө Kent State Universityнин Open Access APC Support Fund программасы тарабынан жарым-жартылай колдоого алынган.
Этикалык комитет жана маалымдалган макулдук
Булак изилдөөдө Institutional Review Board жана informed consent талаалары “Not applicable” деп билдирилген. Изилдөө адам катышуучуларында жаңы эксперимент же клиникалык маалымат чогултууну камтыбайт.
Кызыкчылыктардын кагылышы
Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Автордук салымдар
Концептуалдаштыруу: Deepshikha Bhati жана Devi Sri Bandaru. Методология: Deepshikha Bhati жана Devi Sri Bandaru. Валидация: Deepshikha Bhati, Fnu Neha жана Devi Sri Bandaru. Формалдуу анализ: Deepshikha Bhati жана Devi Sri Bandaru. Карап чыгуу жана редакциялоо: Deepshikha Bhati, Fnu Neha, Devi Sri Bandaru, Matthew Weber жана Ishan Dilipbhai Gajera.
Изилдөөнүн негизги методологиялык чектөөлөрү
- Модель үй-бүлөлөрү алдын ала аныкталган системалуу адабият издөө протоколунун ордуна документтештирүү, ар түрдүүлүк жана маанилүүлүк критерийлери менен тандалган.
- Жабык моделдердин архитектура жана окутуу деталдары толук ачылбагандыктан кайра түзүлгөн схемалар жогорку деңгээлдеги абстракциялар болуп саналат.
- 50дөн ашык архитектуранын бардык implementation деталдары көз карандысыз түрдө текшериле турган эмес.
- Benchmark скорлору бир эле жалпы evaluation harness колдонулуп кайра эсептелген эмес.
- Айрым benchmark саптары бир моделдин ордуна бир үй-бүлөдөгү бир нече вариантты чогуу билдирет.
- Vendor-reported жана independent benchmark натыйжаларынын булагы клетка деңгээлинде бир таблицада ажыратылган эмес.
- Benchmark натыйжалары prompting, модель версиясы, дата жана баалоо протоколу жагынан айырмаланышы мүмкүн.
- Таксономия өлчөмдөрүнүн ортосундагы байланыштар байкоочу/салыштырмалуу; контролдолгон абляция эксперименти жасалган эмес.
- Architecture–benchmark байланыштарынан себептүүлүк чыгарууга болбойт.
- Alignment depth жана attention efficiency үчүн жалпы сандык индекс аныкталган эмес.
- “32Kдан узун context бар бардык моделдер expert routing колдонот” деген тыянак ошол эле макаладагы GPT-4o жана Claude context маалыматтары менен шайкеш келбейт.
- Ачык салмактуу моделдердин RMSNorm + RoPE жакындашуусу тууралуу чечмелөө үй-бүлөнүн ичиндеги бардык модель варианттары үчүн бирдей документтештирүү деңгээлине негизделбейт.
- Булак изилдөө тез өзгөргөн технология тармагын белгилүү бир дата аралыгында карталайт; таксономия келечектеги модель муундарын автоматтык түрдө билдирбейт.
Булак ичиндеги критикалык дал келбестиктин ачык жазуусу
Булактын Pattern B тыянагында “every model in our survey supporting context windows exceeding 32K tokens” үчүн sparse expert routing же selective state-space ыкмасы бар деп айтылат. Бирок ошол эле изилдөөнүн салыштыруу таблицасы GPT-4o үчүн 128K жана Claude 2/3 үчүн 100K–200K context window берип жатканда, бул эки үй-бүлө үчүн аталган routing түзүлүштөрү көрсөтүлбөйт. Ошондуктан универсалдуу мүнөздөгү Pattern B сүйлөмү булактын ичиндеги башка маалыматтар менен шайкеш эмес.
Pattern A жана benchmark performans түшүндүрмөлөрү үчүн да ушуга окшош себептик тактык колдонулбашы керек. Изилдөөнүн өзү benchmark айырмаларын түшүндүрүп жатып, бул анализдер causality түзбөй турганын билдирет.
Жыйынтыктап айтканда, изилдөөнүн эң күчтүү салымы “кайсы LLM эң жакшы?” деген суроого так жооп берүү эмес. Негизги салым ири тил модели үй-бүлөлөрүнүн архитектура, окутуу, alignment, context, multimodality жана ачыктуулук өлчөмдөрүн бир жалпы салыштыруу алкагына жайгаштыруусу; модель документтеринен кайра түзүлгөн архитектураларды карала турган таксономия жана интерактивдүү куралга айландыруусу болуп саналат.
Бул Verianla текстиндеги илимий архитектура түшүндүрмөлөрү, салыштыруу маанилери, тыянактар жана чектөөлөр жүктөлгөн булак изилдөөгө негизделет. Библиографиялык идентификация жана рецензия абалынан тышкары тышкы булактардан жаңы LLM performans натыйжасы негизги илимий текстке кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген