

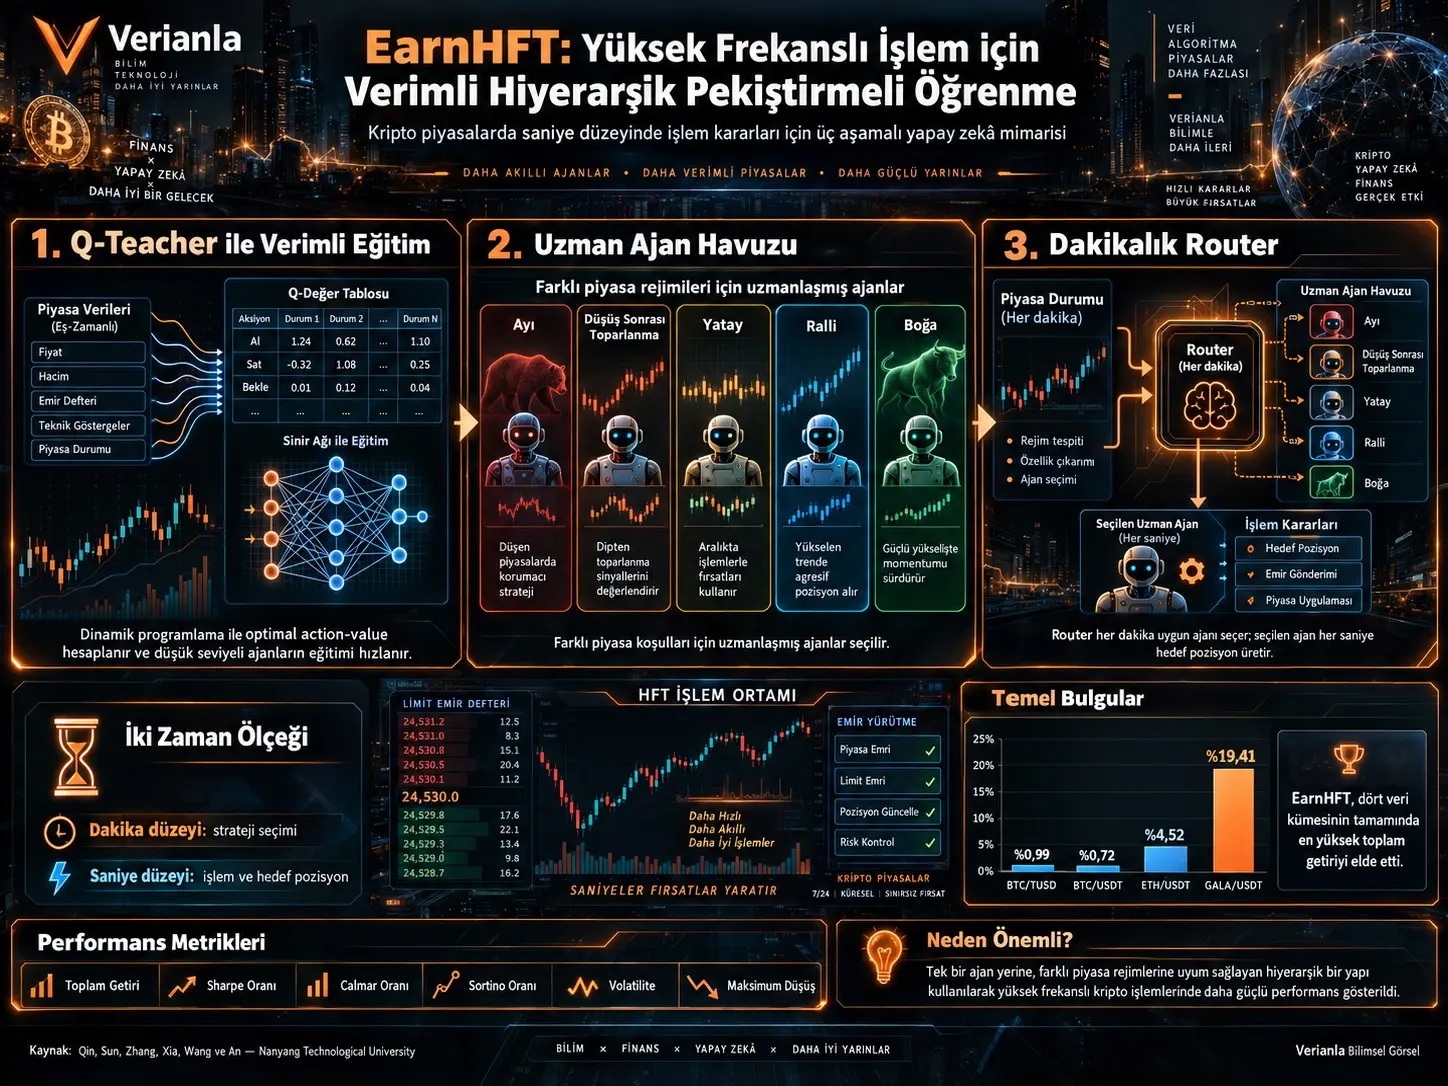
EarnHFT, криптовалюта базарларында секунддук деңгээлде соода жүргүзгөн бекемдөөчү үйрөнүү агенттеринин эки негизги көйгөйүн чечүү үчүн иштелип чыккан үч баскычтуу иерархиялык бекемдөөчү үйрөнүү системасы. Биринчи көйгөй — жогорку жыштыктагы соодада окутуу траекторияларынын өтө узун болушу. Изилдөөдөгү мисалда болгону 12 күндүк секунддук маалымат болжол менен 1.036.800 чечим кадамын түзөт; айлык масштабда бул миллиондогон кадамдарга жетиши мүмкүн. Экинчи көйгөй — крипто базарларындагы рынок режимдеринин тез өзгөрүшүнөн улам бир агент үйрөнгөн стратегия башка рынок шартында ийгиликсиз болуп калышы мүмкүн.
EarnHFT бул көйгөйлөрдү бир гана жалпы trading агентин окутуунун ордуна тапшырмаларды ар башка убакыт масштабдарына бөлүү аркылуу чечет. Секунддук деңгээлдеги төмөнкү деңгээлдеги агенттер реалдуу сатып алуу-сатуу чечимдерин жана максаттуу позицияны аныктаса, мүнөттүк деңгээлдеги жогорку деңгээлдеги router рыноктун учурдагы макро жүрүм-турумуна ылайык төмөнкү деңгээлдеги агентти тандайт. Ошентип система микро рынок кыймылдарын секунддук деңгээлде иштетип жатып, тренддин өзгөрүшүн мүнөттүк деңгээлде баалай алат.
Биринчи баскычта келечектеги баа маалыматын колдонуп динамикалык программалоо менен эсептелген Q-teacher, төмөнкү деңгээлдеги DDQN агентине өзүнүн сыноо-ката тажрыйбасын гана эмес, ошол эле абалдагы альтернативдүү аракеттердин эсептелген optimal action-value маалыматын да берет. Экинчи баскычта ар түрдүү bull, bear, pullback, sideways жана rally жүрүм-турумдарына адистешүүсү көздөлгөн жүздөгөн агент окутулат; алардын ар кандай рынок режимдеринде эң кирешелүү болгон чакан бөлүгү гана стратегиялар пулуна киргизилет. Үчүнчү баскычта мүнөттүк деңгээлдеги DDQN router ушул агенттердин бирин тандап, тандалган агент кийинки бир мүнөт бою секунд сайын максаттуу позиция чыгарат.
BTC/TUSD, BTC/USDT, ETH/USDT жана GALA/USDT маалымат топтомдорунда жүргүзүлгөн симуляциялык эксперименттерде EarnHFT төрт рыноктун тең тест мезгилиндеги эң жогорку жалпы кирешесин берген. Жалпы кирешелер тиешелүүлүгүнө жараша болжол менен %0,99, %0,72, %4,52 жана %19,41 деп билдирилген. Бирок ыкма бардык тобокелдик көрсөткүчтөрүндө эң мыкты эмес; авторлор EarnHFT profit-oriented Q-teacher түзүмүнөн улам салыштырмалуу агрессивдүү trader экенин жана айрым маалымат топтомдорунда тобокелдик көрсөткүчтөрү орточо деңгээлде калганын ачык белгилешет.
Кадимки бекемдөөчү үйрөнүү HFT үчүн эмне үчүн кыйналат?
Бекемдөөчү үйрөнүүдө агент учурдагы абалды байкап, бир аракетти тандайт жана ошол аракеттин натыйжасында алган сыйлыгына жараша саясатын жакшыртат. Күндүк же сааттык trading маселелеринде бир окутуу траекториясы салыштырмалуу кыска болушу мүмкүн. Ал эми жогорку жыштыктагы соодада модель ар секунд сайын чечим кабыл алса, маселе миллиондогон ырааттуу кадамдардан турат.
Изилдөөдө берилген мисал:
Мындай узун horizon RL агентине оң жана терс жүрүм-турумдардын узак мөөнөттүү таасирин үйрөнүүнү кыйындатат жана окутуу үчүн алда канча көп тажрыйба талап кылат.
Экинчи көйгөй non-stationary market dynamics абалы. Крипто рыногунда бир эле микро баа кыймылы ар башка макро рынок режимдеринде башкача мааниге ээ болушу мүмкүн. Мисалы, өсүп жаткан рыноктогу кыска мөөнөттүү баа төмөндөөсү убактылуу pullback болушу мүмкүн, ал эми төмөндөп жаткан рыноктогу окшош кыймыл чоңураак төмөндөө кыймылынын уландысына айланышы мүмкүн. Ошондуктан бир гана саясаттын бардык рынок режимдеринде бирдей ийгилик көрсөтүшү кыйындайт.
EarnHFT эмне үчүн иерархиялык түзүмдү колдонот?
EarnHFT рынок маалыматын эки башка убакыт масштабына бөлөт. Төмөнкү деңгээлдеги MDP секунддук деңгээлдеги микро рынок кыймылдарын жана соода execution процессин моделдейт. Жогорку деңгээлдеги MDP болсо мүнөттүк масштабда жайыраак өзгөргөн рынок тренддерин жана кайсы trading стратегиясы колдонуларын моделдейт.
Төмөнкү деңгээлдеги агент ар секунд сайын максаттуу позиция чыгарат, жогорку деңгээлдеги router болсо ар мүнөт сайын бир төмөнкү деңгээлдеги агентти тандайт. Ошентип “азыр канча coin кармалышы керек?” жана “бул рынок режиминде кайсы trader колдонулушу керек?” деген чечимдер бири-биринен бөлүнөт.
Төмөнкү деңгээлдеги абал кайсы маалыматтарды камтыйт?
Төмөнкү деңгээлдеги state эки негизги компоненттен турат. Биринчиси секунддук рынок маалыматынын негизинде алынган 54 техникалык өзгөчөлүк, экинчиси агент кармап турган учурдагы позиция. Техникалык өзгөчөлүктөр 60 секунддук rolling window ичиндеги OHLC маалыматы жана Limit Order Book snapshot-тарынан алынат.
Action түздөн-түз “buy” же “sell” белгиси эмес. Агент алдын ала белгиленген чектүү action pool ичинен бир максаттуу позиция тандайт. Учурдагы позиция максаттуу позициядан айырмаланса, айырма market order аркылуу дароо сатып алынат же сатылат.
Жогорку деңгээлдеги абал жана action деген эмне?
Жогорку деңгээлдеги state 60 мүнөттүк rolling OHLC window-дан алынган 19 макро өзгөчөлүк жана учурдагы позицияны камтыйт. Action болсо түздөн-түз позиция эмес, стратегиялар пулундагы төмөнкү деңгээлдеги RL агенттеринин бирин тандоо.
Router тандаган агент бир мүнөт иштеп, секунддук деңгээлде максаттуу позиция чыгарат. Router алган reward — ошол бир мүнөт ичинде тандалган төмөнкү деңгээлдеги агент түзгөн net-value өзгөрүүсү.
Limit Order Book эмне үчүн маанилүү?
EarnHFT симуляциясы соода жабылуу баасында гана аткарылат деп эсептебейт. Ал Limit Order Book ичиндеги bid жана ask бааларын жана ошол деңгээлдердеги жеткиликтүү көлөмдөрдү колдонот. Чоң market order биринчи баа деңгээлиндеги ликвиддүүлүктөн ашса, буйрутма кийинки баа деңгээлдерине өтөт.
Булак market-order чыгымын түшүндүрүү үчүн колдонгон түзүм:
Бул жерде \(p_t^i\) тиешелүү order-book деңгээлинин баасын, \(q_t^i\) ошол деңгээлдеги көлөмдү, \(R_{i-1}\) мурунку деңгээлдерден кийин калган буйрутма көлөмүн жана \(\sigma\) commission-fee катышын билдирет.
Мунун маанилүү жыйынтыгы — комиссия нөл болсо да trading акысыз болбойт. Market order сатып алууда ask тарабын, сатууда bid тарабын керектегендиктен bid–ask spread өзүнчө соода чыгымын жаратат.
I баскыч: Q-teacher кандай иштейт?
Кадимки RL агент кайсы аракет жакшы экенин сынап көрүү аркылуу үйрөнөт. EarnHFT колдонулган симуляция чөйрөсүндө баа катарлары агенттин аракеттеринен таасирленбейт деген божомолду пайдаланат. Келечектеги баалар окутуу учурунда белгилүү болгондуктан ар бир убакыт–позиция–action айкалышынын optimal action-value мааниси динамикалык программалоо менен артка карай эсептелиши мүмкүн.
Бул Q-таблица trading учурунда колдонулбайт; окутуу маалында мугалим сигналы болуп кызмат кылат.
DDQNнин кадимки temporal-difference катасына тармактын action-value бөлүштүрүүсү менен optimal action-value бөлүштүрүүсүнүн ортосундагы Kullback–Leibler divergence кошулат:
TD компоненти:
Бул жерде максат агент тандалган action натыйжасын гана эмес, ошол эле абалдагы башка action-дардын салыштырмалуу маанилерин да үйрөнүшүн камсыз кылуу. Булакта \(\alpha\) окутуу илгерилеген сайын азая турган коэффициент катары колдонулат.
Optimal Actor эмнени кошот?
Q-teacher гана колдонуу жетиштүү деп эсептелген эмес. Агент оптималдуу саясаттан алыстаганда, анын позициясы өзгөргөндүктөн мугалим сигналы да өзгөрүшү мүмкүн. Муну азайтуу үчүн EarnHFT экинчи тажрыйба булагын түзөт.
Бир тажрыйба тобун агент кадимки \(\epsilon\)-greedy саясаты менен түзөт, экинчи топ болсо түздөн-түз \(Q^*\) маанисинде максималдуу action-ды тандаган optimal actor тарабынан түзүлөт. Ошентип replay buffer изилдөө маалындагы өтүүлөрдү да, эсептелген оптималдуу саясат түзгөн өтүүлөрдү да камтыйт.
II баскыч: Эмне үчүн бир агенттин ордуна жүздөгөн агент окутулат?
Изилдөөнүн негизги гипотезаларынын бири — bull market үчүн жакшы саясат bear market үчүн ошондой эле жакшы болбой калышы мүмкүн. Ошондуктан окутуу маалыматы ар башка рынок тренддерин чагылдырган бөлүктөргө бөлүнөт жана агенттер бул бөлүктөрдү ар башка ыктымалдыкта көрүшөт.
Маалымат топтому үч миллиондон ашык убакыт кадамы бар multivariate time series бөлүктөрүнөн турат. Ар бир агент үчүн артыкчылык параметри \(\beta\) өзгөртүлөт. Buy-and-hold return жогору же төмөн болгон market segmentтеринин sampling салмагы ушул параметр аркылуу өзгөртүлүп, ар башка рынок режимдерине адистешкен агенттерди түзүүгө аракет жасалат.
Рынок сегменттери кандай белгиленет?
Булак адегенде жогорку жыштыктагы ызы-чууну low-pass filtering менен азайтат. Андан кийин баа/net-value ийри сызыгындагы жергиликтүү багыт өзгөрүүлөрүнөн сегменттер түзүлөт. Кошуна сегменттер slope айырмасы жана Dynamic Time Warping окшоштугу жетиштүү кичине болсо бириктирилет.
Андан кийин buy-and-hold return эңкейиштеринин quantile маанилери аркылуу сегменттер ар башка тренд класстарына бөлүнөт. Изилдөөнүн визуалдарында колдонулган беш категория:
- Bear,
- Pullback,
- Sideways,
- Rally,
- Bull.
Ар бир тренд жана баштапкы позиция үчүн validation маалыматында эң жогорку орточо profitability көрсөткүчүн берген агенттер тандалат. Ошентип жүздөгөн талапкерлердин баары router action space-ке берилбейт; чакан жана ар түрдүү стратегиялар пулу гана сакталат.
Канча агент окутулган?
Изилдөөдө sampling-preference параметри \(\beta\) үчүн \(-90\), \(-10\), \(30\) жана \(100\) маанилери колдонулган. Ар бир маани 50 epoch иштетилип, жалпысынан 200 төмөнкү деңгээлдеги агент түзүлгөн.
III баскыч: Router эмне кылат?
Router — DDQN негизиндеги жогорку деңгээлдеги агент. Ал ар мүнөт сайын учурдагы макро рынок абалын карап, agent pool ичинен бир trader тандайт.
Router секунд эмес, мүнөт деңгээлинде чечим кабыл алгандыктан high-level trajectory узундугун:
катышында, башкача айтканда булактын сөзү менен болжол менен %98,33 кыскартат.
Router учурдагы позицияга шайкеш баштапкы позициясы бар агенттерди гана карагандыктан action space дагы кичирейет. Авторлор high-level баскычта Q-teacher колдонгон эмес; траектория ансыз да кыйла кыскарган жана агент тандоодо optimal action-value эсептөө татаалыраак болгондуктан кадимки DDQNди натыйжалуураак деп эсептешкен.
Router чындап эле рынок режимине жараша башкача иштейби?
Булакта router тандоолорунун бөлүштүрүлүшү төрт тест маалымат топтомунда изилденген. Төмөнүрөөк волатилдүүлүккө ээ BTC/TUSD жана BTC/USDT маалыматтарында router тандоолору бир нече market-state агентинде топтолсо, ETH жана GALA сыяктуу өзгөрмөлүүрөөк рыноктордо тандоо беш рынок режимине тең салмактуураак тараган.
Мисалы, GALA тестинде тандоолордун болжол менен %67,6сы Bull агентине туура келген. BTC/USDT тестинде болсо болжол менен %64,8 Sideways жана %32,6 Rally агенти тандалган. ETHде Pullback агентине туура келген үлүш болжол менен %43,9. Бул көрсөткүчтөр router бардык рыноктордо бир эле төмөнкү агентти колдонбой турганын көрсөтөт.
Ыкма жана Жыйынтыктар
Маалымат топтомдору
| Trading Pair | Булакта берилген рынок динамикасы | Секунд саны | Мезгил |
|---|---|---|---|
| BTC/TUSD | Sideways | 4.057.140 | 30 Март 2023 – 15 Май 2023 |
| BTC/USDT | Sideways | 3.884.400 | 1 Сентябрь 2022 – 15 Октябрь 2022 |
| ETH/USDT | Bear | 3.970.800 | 1 Май 2022 – 15 Июнь 2022 |
| GALA/USDT | Bull | 3.970.740 | 1 Июль 2022 – 15 Август 2022 |
Ар бир маалымат топтомунда акыркы 9 күн test, анын алдындагы 9 күн validation, андан мурдагы маалыматтар training үчүн колдонулган. Бул хронологиялык бөлүү келечектеги тест маалыматын окутуу баскычында түз колдонбоону көздөйт.
Validation жана test мезгилдери бирдей болгон эмес
Изилдөө validation жана test рынок тренддеринин ортосунда атайын олуттуу айырмачылыктарды түзгөн. BTC/TUSD test setинде validationда болбогон ачык bear trend пайда болгон. ETH/USDTде айырма андан да чоң: validation мезгилинде тренд өсүп турганда, test мезгилинде булак болжол менен %30 төмөндөөнү билдирет.
Бул EarnHFT окутуу мезгилине окшош рыноктордо гана эмес, market regime өзгөргөн шартта да сыналганын көрсөтүү үчүн колдонулган.
Салыштырылган ыкмалар
EarnHFT төрт RL жана эки rule-based baseline менен салыштырылган: PPO, DRA, DQN, CDQNRP, MACD жана Imbalance Volume (IV). Ошентип policy-based RL, value-based RL жана классикалык рынок көрсөткүчтөрүнө негизделген ыкмалар бир экспериментте бааланган.
Баалоо көрсөткүчтөрү
Алты финансылык көрсөткүч колдонулган: Total Return (TR), Annual Sharpe Ratio (ASR), Annual Calmar Ratio (ACR), Annual Sortino Ratio (ASoR), Annual Volatility (AVOL) жана Maximum Drawdown (MDD).
Total Return:
Annual Sharpe Ratio:
Calmar Ratio:
Sortino Ratio жалпы волатилдүүлүктүн ордуна терс return-дардын downside deviation маанисин гана тобокелдик өлчөмү катары колдонот.
Негизги көрсөткүчтөр
| Рынок | TR (%) | ASR | ACR | ASoR | AVOL (%) | MDD (%) |
|---|---|---|---|---|---|---|
| BTC/USDT | 0,72 | 1,22 | 10,77 | 0,93 | 27,08 | 3,07 |
| BTC/TUSD | 0,99 | 1,34 | 7,76 | 1,01 | 32,40 | 5,61 |
| ETH/USDT | 4,52 | 2,92 | 14,30 | 1,78 | 67,92 | 13,89 |
| GALA/USDT | 19,41 | 9,77 | 79,08 | 7,79 | 74,94 | 9,26 |
EarnHFT төрт маалымат топтомунун баарында Total Return боюнча эң жогорку натыйжага жеткен. Булак төрт маалымат топтомунун үчөөндө risk-adjusted profit көрсөткүчтөрүндө да эң жакшы көрсөткүч EarnHFTге таандык экенин белгилейт.
BTC/TUSD өзгөчө учур. Бул маалымат топтомунда DQNнин айрым risk-adjusted метрикалары EarnHFTден жогору; мисалы, DQN үчүн ASR 4,21 жана ACR 27,94 болсо, EarnHFT үчүн тиешелүү көрсөткүчтөр 1,34 жана 7,76. Демек, системанын киреше артыкчылыгы бардык метрикаларда абсолюттук үстөмдүк дегенди билдирбейт.
ETH соодасынын мисалы
Булактын 2-сүрөтүндө ETH боюнча EarnHFT ачкан позиция болжол менен 30 секунд ичинде кайра жабылган мисал көрсөтүлгөн. Мүнөттүк масштабда майда pullback болуп көрүнгөн баа кыймылы секунддук агент тарабынан кыска мөөнөттүү trading мүмкүнчүлүгү катары пайдаланылган.
Бул мисал система эмне үчүн эки убакыт масштабын бөлгөнүн визуалдык түрдө көрсөтөт: router кененирээк рынок контекстин тандаса, төмөнкү деңгээлдеги агент ошол мүнөттөгү майда баа кыймылдарына жооп берет.
Q-teacher чындап эле окутууну тездеттиби?
Ablation экспериментинде Optimal Value Supervisor (OS) жана Optimal Actor (OA) таасирлери өз-өзүнчө изилденген.
GALA маалымат топтомунда кадимки DDQN болжол менен 30.720 кадамда жакындаганда, OS гана колдонулган түзүм 4.608 кадамда жакындаган. Бул булактын сөзү менен болжол менен %15тей окутуу кадамы дегенди билдирет. Converged reward sum ошол эле салыштырууда -0,01ден 2,89га жогорулаган.
OS жана OA чогуу колдонулганда GALA reward sum 4,43кө жеткен, бирок convergence step 78.848 болгон. Бул жыйынтык optimal actor кирешени көбөйтө алганы менен көбүрөөк окутуу кадамын талап кылышы мүмкүн экенин көрсөтөт.
ETHде OS гана колдонуу convergence stepти baselineга салыштырмалуу азайткан эмес; экөө тең 30.720 кадам деңгээлинде. Ошентсе да reward sum болжол менен -29,6дан 4,87ге жогорулаган. Эки компонент чогуу колдонулганда булак 12,32 reward sum билдирет.
EarnHFT эмне үчүн айрым тобокелдик көрсөткүчтөрүндө алсызыраак?
Авторлордун түшүндүрмөсүнө ылайык Q-teacher жана optimal actor өзгөчө кирешелүү тажрыйбаларды үйрөтөт. Тобокелдик жазасы optimal supervisionга ошол эле салмакта киргизилбегендиктен EarnHFT агрессивдүүрөөк trading жүрүм-турумун көрсөтүшү мүмкүн.
Ошондуктан жыйынтыктар “жогорку profit = төмөн тобокелдик” деп чечмеленбеши керек. Мисалы, GALAда EarnHFT %19,41 total return менен эң жогорку натыйжаны берген менен annual volatility %74,94 жана мындан төмөн волатилдүүлүккө ээ альтернативдүү моделдер бар.
Окутуу инфраструктурасы
Эксперименттер NVIDIA RTX 4090 GPUда жүргүзүлгөн. Булак төрт маалымат топтомундагы бардык эксперименттер болжол менен 10 саатка созулганын билдирет. EarnHFT replay buffer көлөмү \(10^6\), mini-batch size 512, learning rate \(5\times10^{-4}\), Q-teacher коэффициенти \(\alpha=128\) жана soft-update коэффициенти \(\tau=0.005\) деп берилген.
Комиссия катышындагы булак ичиндеги айырма
Негизги эксперимент бөлүмүндө BTC/TUSD үчүн комиссия катышы 0, башка маалымат топтомдору үчүн %0,02 деп жазылган. D.3 тиркемесиндеги parameter table болсо BTC/TUSD үчүн 0, BTC/USDT, ETH/USDT жана GALA/USDT үчүн %0,015 берет.
Булак бул эки маанинин ар башка эксперименттерге, ар башка мезгилдерге же жазуу катасына тиешелүү экенин түшүндүрбөйт. Ошондуктан Verianla тексти алардын бирин “туура маани” деп тандабайт.
Теориялык жакындашуу
C.2 тиркемесинде авторлор Q-teacher supervisor менен өзгөртүлгөн Q-learning оператору чектелген MDP шартында optimal action-value функциясы \(Q^*\)га жакындай турганын көрсөтүү үчүн математикалык чыгаруу беришет.
Ыкма адегенде \(Q^*\) аныкталган оператордун fixed point-и экенин, андан кийин оператор sup-norm шартында contraction экенин көрсөтүүгө аракет кылат. Бул жыйынтык изилдөөнүн теориялык аргументи; эксперименттик жыйынтыктардан өзүнчө бааланууга тийиш.
Изилдөө колдогон жыйынтыктар
Булак ар түрдүү рынок режимдерине адистешкен төмөнкү деңгээлдеги агенттер пулун мүнөттүк router тандашы сыналган крипто маалымат топтомдорунда бир агенттүү же rule-based baseline-дарга караганда жогорку жалпы киреше бере аларын көрсөтөт. Q-teacher айрыкча айрым маалымат топтомдорунда окутуу натыйжалуулугун жана converged rewardду жогорулатканы ablation эксперименттери менен колдоого алынат.
Изилдөө колдобогон жыйынтыктар
Жыйынтыктар EarnHFT реалдуу exchangeде жандуу акча менен ошол эле кирешени берет дегенди билдирбейт. Изилдөө симуляция чөйрөсүндө жүргүзүлгөн. Market impact, реалдуу order latency, exchange queue priority, packet loss, API throttling, co-location, атаандаш HFT системаларынын реакциясы жана жандуу рыноктун бардык execution белгисиздиктери эксперимент чөйрөсүндө толук көрсөтүлгөн эмес.
Мындан тышкары, тандалган төрт крипто trading pair боюнча ийгилик бардык крипто активдерге, акцияларга, фьючерстерге же башка market-microstructure түзүмдөрүнө автоматтык түрдө жалпыланбайт.
Булак жана Ыкма Эскертүүсү
Түп нуска иш: EarnHFT: Efficient Hierarchical Reinforcement Learning for High Frequency Trading.
Авторлор: Molei Qin, Shuo Sun, Wentao Zhang, Haochong Xia, Xinrun Wang жана Bo An.
Мекеме: Nanyang Technological University, Singapore.
Тең салым: Булак PDF Molei Qin жана Shuo Sunду тең салым кошкон авторлор катары белгилейт.
arXiv: 2309.12891v1 [q-fin.TR].
arXiv датасы: 22 Сентябрь 2023.
Булактагы жарыя белгиси: Copyright © 2024, Association for the Advancement of Artificial Intelligence (AAAI). Булак PDFтен тышкары библиографиялык текшерүү жүргүзүлбөгөндүктөн, рецензия/жарыя статусу мындан ары чечмеленген эмес.
Ыкма түрү: Жогорку жыштыктагы крипто trading үчүн үч баскычтуу hierarchical reinforcement learning; динамикалык программалоого негизделген Q-teacher; DDQN; ар башка рынок тренддерине адистешкен agent pool; мүнөттүк деңгээлдеги dynamic strategy router.
Төмөнкү деңгээлдеги убакыт масштабы: 1 секунд.
Жогорку деңгээлдеги убакыт масштабы: 1 мүнөт.
Төмөнкү деңгээлдеги market representation: 60 секунддук rolling OHLC + LOB терезесинен 54 өзгөчөлүк жана учурдагы позиция.
Жогорку деңгээлдеги market representation: 60 мүнөттүк rolling OHLC терезесинен 19 өзгөчөлүк жана учурдагы позиция.
Окутулган төмөнкү деңгээлдеги агенттердин саны: 200.
Trend preference параметрлери: \(\beta\in\{-90,-10,30,100\}\), ар бири 50 epoch.
GPU: NVIDIA RTX 4090.
Жалпы эксперимент убактысы: Булак болжол менен 10 саат деп билдирет.
Маалымат топтомдору: BTC/TUSD, BTC/USDT, ETH/USDT жана GALA/USDT секунддук рынок маалыматтары.
Validation/test бөлүнүшү: Акыркы 9 күн test, андан мурунку 9 күн validation, калган мурунку мезгил training.
Салыштыруулар: PPO, DRA, DQN, CDQNRP, MACD жана Imbalance Volume.
Финансылык көрсөткүчтөр: Total Return, Annual Sharpe Ratio, Annual Calmar Ratio, Annual Sortino Ratio, Annual Volatility жана Maximum Drawdown.
Негизги эксперименттик жыйынтык: EarnHFT төрт test маалымат топтомунун баарында эң жогорку Total Return маанисин жана үч маалымат топтомунда эң күчтүү risk-adjusted profit жыйынтыктарын билдирет.
Тобокелдик чектөөсү: Авторлор ыкма Q-teacher жана optimal actor себептүү profit-oriented жана салыштырмалуу агрессивдүү экенин, айрым тобокелдик көрсөткүчтөрүндө орточо гана натыйжа бергенин белгилешет.
Булак ичиндеги дал келбестик 1: Негизги тексттеги %0,02 комиссия катышы менен D.3 тиркемесиндеги %0,015 катышы дал келбейт.
Булак ичиндеги дал келбестик 2: Маалымат топтому таблицасы ETH/USDTни Bear деп классификацияласа, ablation түшүндүрмөсүнүн бир жеринде ETH үчүн “market is bull” деген сөз айкашы колдонулган. Ошол эле изилдөөнүн башка бөлүктөрү ETH test мезгилин төмөндөөчү рынок катары сүрөттөйт.
Негизги чектөө: Эксперименттер жогорку тактыктагы симуляция trading environment ичинде жүргүзүлгөн; жандуу өндүрүш HFT системасында башынан аягына чейинки реалдуу акча trading көрсөткүчү сыналган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген