

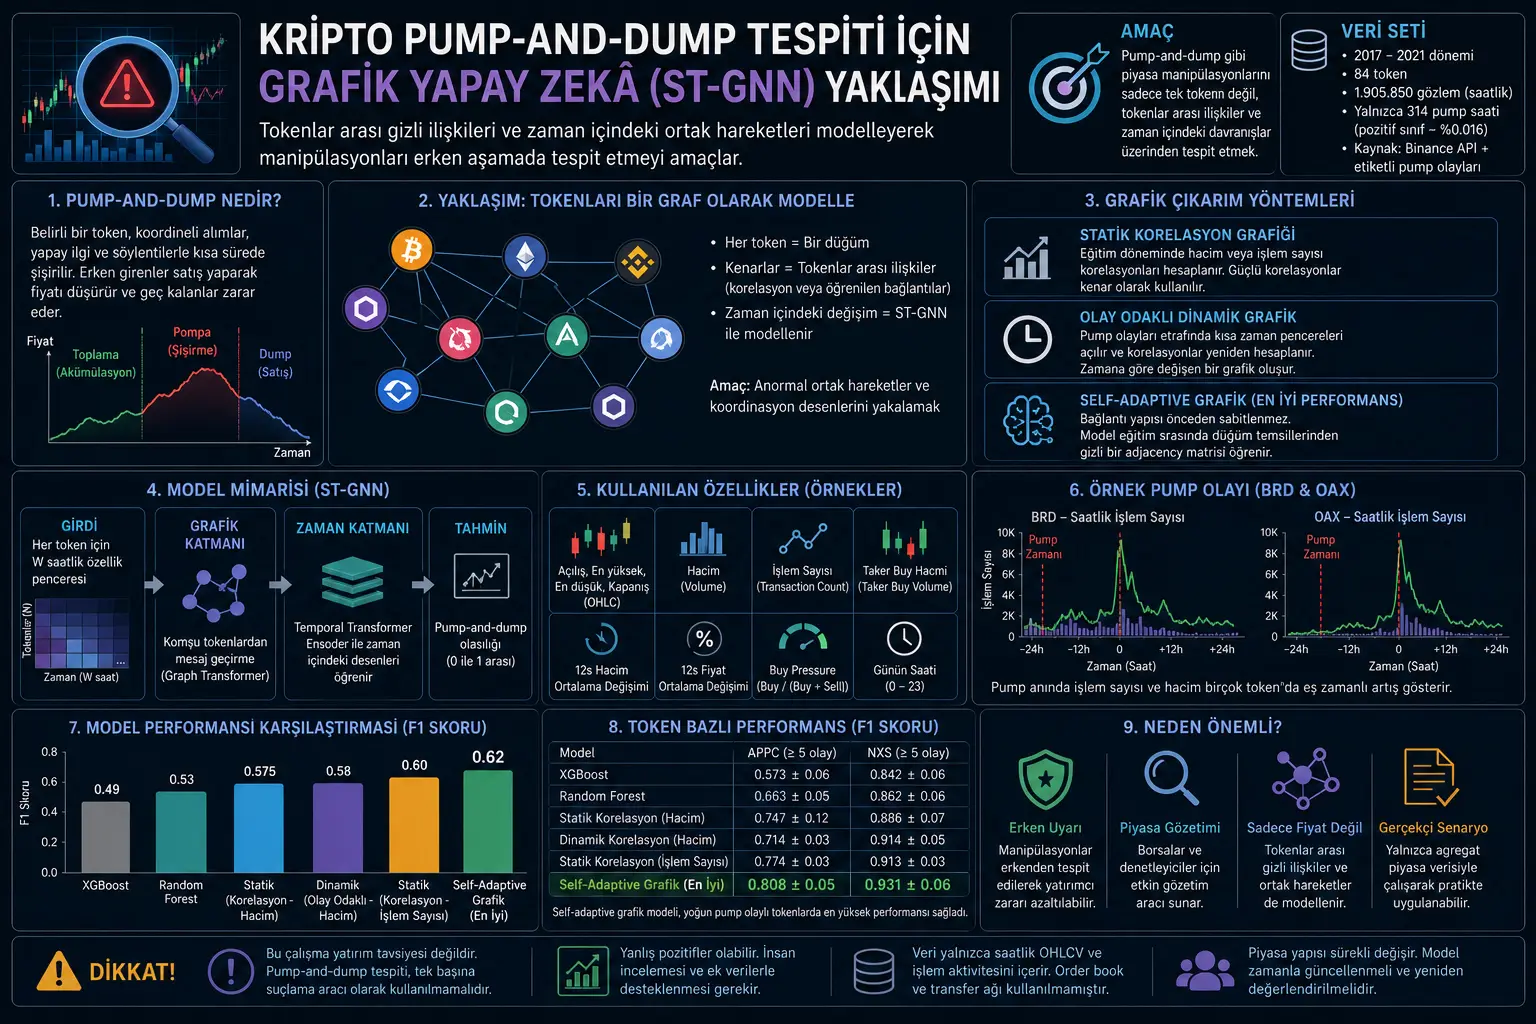
Kripto para piyasalarında pump-and-dump manipülasyonu, belirli bir tokenın kısa sürede yapay ilgiyle şişirilmesi ve ardından fiyat yükseldiğinde satış baskısıyla yatırımcıların zarara uğratılması üzerine kurulu bir piyasa suistimali türüdür. Bu olaylarda çoğu zaman ani hacim artışı, işlem sayısında sıçrama, kısa süreli fiyat hareketi ve bazen birden fazla token arasında eş zamanlı davranış görülebilir.
Bu çalışma, yalnızca tek bir tokenın geçmiş verisini inceleyen klasik makine öğrenmesi yöntemleri yerine, tokenlar arasında çıkarılan ilişkileri kullanan spatio-temporal Graph Neural Network yani uzamsal-zamansal grafik sinir ağı yaklaşımını öneriyor. Model, saatlik OHLCV verileri, işlem sayısı ve türetilmiş piyasa göstergeleriyle çalışıyor. Transaction-level veri veya emir defteri verisi bulunmasa bile, tokenlar arasındaki bağlantılar fiyat, hacim veya işlem sayısı korelasyonlarından ya da modelin öğrendiği gizli bağımlılıklardan çıkarılıyor.
Makalenin ana sonucu, grafik tabanlı modellerin Random Forest ve XGBoost gibi klasik karar ağacı tabanlı yöntemlerden daha iyi pump-and-dump tespiti yapabildiğidir. En iyi performans, bağlantı matrisini sabit kurallarla değil, eğitim sırasında öğrenen self-adaptive graph yaklaşımıyla elde ediliyor.
Problem Ne?
Finansal piyasa manipülasyonu, varlık fiyatlarının gerçek arz-talep bilgisini yansıtmayacak şekilde yapay olarak yönlendirilmesidir. Kripto piyasalarında bu risk daha görünür hâle gelebilir; çünkü likidite parçalıdır, bazı tokenlarda işlem derinliği düşüktür ve denetim mekanizmaları geleneksel piyasalara kıyasla daha sınırlı olabilir.
Pump-and-dump kampanyalarında koordinasyon genellikle kapalı mesajlaşma gruplarında veya topluluk kanallarında yapılabilir. Belirli bir saat etrafında çok sayıda kişi aynı tokenı alır, işlem sayısı ve hacim hızla yükselir, fiyat kısa süreli sıçrama yapar ve ardından erken girenler satış yaparak piyasadan çıkar. Bu süreç, tokenın saatlik piyasa verisinde iz bırakabilir.
Ancak pratikte çoğu veri kaynağı yalnızca token seviyesinde toplanmış OHLCV verisi, işlem sayısı ve bazı türetilmiş göstergeler sağlar. Yani araştırmacının elinde her zaman cüzdanlar arası transfer ağı veya emir defteri derinliği bulunmaz. Bu durumda önemli soru şudur: Yalnızca agregat piyasa verileriyle tokenlar arasında anlamlı bir ilişki grafiği kurulabilir mi ve bu grafik pump-and-dump tespitini iyileştirir mi?
Yöntem Ne Öneriyor?
Çalışma, her tokenı grafikte bir düğüm olarak ele alıyor. Tokenlar arasındaki kenarlar ise doğrudan gözlenen işlem ilişkilerinden değil, agregat piyasa verilerinden çıkarılıyor. Böylece transaction-level veri bulunmasa bile, tokenlar arasında ortak hareket, benzer hacim davranışı veya model tarafından öğrenilen gizli ilişki yapısı kullanılabiliyor.
Makale üç farklı grafik çıkarım yöntemi öneriyor:
1. Statik korelasyon grafiği: Eğitim döneminde tokenların hacim veya işlem sayısı gibi bir skalar serisi üzerinden korelasyon matrisi hesaplanıyor. En güçlü korelasyonlar kenar olarak tutuluyor ve aynı grafik tüm zamanlarda kullanılıyor.
2. Olay odaklı dinamik korelasyon grafiği: Eğitim dönemindeki pump olayları etrafında kısa zaman pencereleri açılıyor. Bu pencerelerde korelasyon yapısı güncelleniyor. Amaç, manipülasyon olayları etrafında değişen token ilişkilerini daha iyi yakalamak.
3. Self-adaptive graph: Bağlantı yapısı önceden korelasyonla sabitlenmiyor. Model, düğüm embedding’lerinden gizli bir adjacency matrisi öğreniyor. Bu yaklaşım, korelasyonla açıkça yakalanamayan ilişkileri de modelin keşfetmesine izin veriyor.
Bu üç grafik yöntemi, aynı uzamsal-zamansal GNN mimarisi içinde test ediliyor. Böylece performans farkının esas olarak grafik çıkarım stratejisinden kaynaklanıp kaynaklanmadığı daha kontrollü biçimde görülebiliyor.
Formüller Ne Anlatıyor?
PDF’teki formüller, pump-and-dump tespitinin token-zaman düzeyinde nasıl kurulduğunu, grafiklerin nasıl çıkarıldığını ve ST-GNN modelinin nasıl tahmin ürettiğini anlatıyor. Formüller MathJax uyumlu olarak aşağıda verilmiştir.
1. Token düzeyinde fraud olasılığı tahmini
Burada \(i\) tokenı, \(t\) saatlik zaman adımını temsil eder. \(x_{i,t}\), o tokenın o saatteki özellik vektörüdür. Model geçmiş \(W\) saatlik pencereye bakarak pump-and-dump olasılığı \(\hat{p}_{i,t}\) üretir. Eğer bu olasılık karar eşiği \(\gamma\)’yı aşarsa olay anomali olarak işaretlenir.
2. Genel GNN mesaj geçirme formülü
Bu formül, grafik sinir ağının temel mantığını gösterir. Bir tokenın yeni temsili, kendi önceki temsili ve komşu tokenlardan gelen bilgilerle güncellenir. \(\mathcal{N}(i)\), \(i\) tokenının grafikteki komşularını; \(AGG\), komşu bilgilerinin toplanma biçimini; \(U\) ise güncelleme fonksiyonunu ifade eder.
3. Sabit zaman penceresiyle token geçmişi
Bu ifade, her token için \(W\) saatlik geçmiş özellik dizisinin oluşturulduğunu gösterir. \(F\), özellik sayısıdır. Model yalnızca tek bir saati değil, geçmiş birkaç saatin davranışını birlikte değerlendirir.
Tüm tokenlar birlikte yığıldığında, modelin girdisi \(N\) token, \(W\) saatlik pencere ve \(F\) özellikten oluşan üç boyutlu bir tensöre dönüşür.
4. Zamanla değişen grafik çıkarım operatörü
Bu formül, adjacency matrix yani tokenlar arası bağlantı matrisinin yalnızca \(t\) zamanına kadar gözlenen veriden üretildiğini gösterir. Bu nokta önemlidir; çünkü gelecekteki veriyi kullanmak model değerlendirmesinde veri sızıntısı yaratabilir.
5. Statik korelasyon grafiği
Tokenların hacim veya işlem sayısı gibi skalar serileri önce log dönüşümden geçirilir. Böylece çok büyük değerlerin etkisi yumuşatılır.
Bu formül, token çiftleri arasındaki Pearson korelasyonunu hesaplar. Aynı tokenın kendisiyle bağlantısı sıfırlanır.
Korelasyon matrisindeki zayıf bağlantılar atılır. Eşik \(\tau\), hem minimum anlamlılık tabanına hem de korelasyonların kantiline göre belirlenir. Böylece yalnızca güçlü ilişkiler grafikte kenar olarak kalır.
6. Olay odaklı dinamik grafik
Her eğitim pump olayı \(p\) etrafında \(L\) saatlik geriye dönük pencere açılır. Bu pencere, olay anındaki ilişkilerin yakalanması için kullanılır.
Her pump penceresinde yeni korelasyonlar hesaplanır ve güçlü bağlantılar kenar olarak seçilir. Bu yapı, manipülasyon zamanlarındaki değişen ortak hareketleri yakalamaya çalışır.
Bu formül, zaman \(t\) için hangi dinamik grafiğin kullanılacağını gösterir. Henüz önceki pump olayı yoksa birim matris kullanılır; aksi durumda en son eğitim pump olayına ait güncellenmiş grafik kullanılır.
7. Self-adaptive adjacency
Bu formülde \(E_1\) ve \(E_2\), modelle birlikte öğrenilen kaynak ve hedef düğüm embedding matrisleridir. ReLU zayıf veya negatif ilişkileri bastırır; SoftMax ise satır bazlı normalize edilmiş bağlantı ağırlıkları üretir. Bu grafik simetrik olmak zorunda değildir.
Öğrenilen yoğun grafik daha sonra \(\epsilon\) eşiğiyle seyreltilir. Böylece yalnızca yeterince güçlü bağlantılar korunur.
8. ST-GNN tahmin akışı
Her saatte token özellikleri ve o saatteki grafik birlikte kullanılarak uzamsal embedding üretilir.
Bu embedding’ler zaman boyunca bir dizi hâline getirilir. Böylece model hem tokenlar arası ilişkileri hem de zaman içindeki değişimi kullanır.
Temporal Transformer Encoder, \(W\) saatlik geçmişi işler. Son zaman adımındaki temsil sigmoid katmanından geçirilerek pump-and-dump olasılığına dönüştürülür.
9. F1 skoru
Veri setinde pump saatleri çok nadir olduğu için yalnızca doğruluk oranına bakmak yanıltıcı olabilir. F1 skoru, precision ve recall dengesini ölçerek azınlık sınıfı olan manipülasyon olayları için daha anlamlı bir performans göstergesi sunar.
Grafik, Tablo ve Şema Ana Mesajı
Sayfa 5’teki pump örneği: BRD ve OAX tokenları için bir pump olayı etrafında saatlik işlem sayısı gösteriliyor. Grafik, olay çevresinde işlem sayısının sert biçimde sıçradığını ve farklı tokenlar arasında ortak hareket izleri olabileceğini gösteriyor. Ana mesaj, pump olaylarının yalnızca fiyatla değil, işlem aktivitesindeki ani yoğunlaşmayla da okunabileceğidir.
Sayfa 6’daki model karşılaştırma grafiği: XGBoost ve Random Forest, grafiğe dayalı modellere göre daha düşük F1 skoru veriyor. Statik ve dinamik korelasyon grafikleri klasik modellere göre iyileşme sağlıyor; en iyi genel performans ise self-adaptive graph yaklaşımında görülüyor.
Sayfa 6’daki precision-recall eğrileri: Sınıf dengesizliği çok yüksek olduğu için PR eğrileri özellikle önemli. Grafik tabanlı modeller, aynı recall düzeyinde daha yüksek precision sağlayarak yanlış alarm yükünü daha iyi kontrol edebiliyor.
Sayfa 7’deki token bazlı performans grafiği: APPC ve NXS gibi test setinde en az beş pump olayı bulunan tokenlarda self-adaptive model en yüksek F1 skorlarına ulaşıyor. Bu, modelin yalnızca genel ortalamada değil, belirli yoğun olaylı tokenlarda da güçlü çalışabildiğini gösteriyor.
Sayfa 9’daki özellik tablosu: Modelin kullandığı özellikler yalnızca OHLCV ile sınırlı değil. İşlem sayısı, taker buy hacmi, 12 saatlik rolling mean ve rolling standard deviation değişimleri, hacim ve fiyat değişimleri, buy pressure ve günün saati gibi göstergeler de kullanılıyor. Ana mesaj, manipülasyonun ani rejim değişimi olarak izlenmeye çalışılmasıdır.
Deneyler Nasıl Yapılmış?
Çalışmada gerçek pump-and-dump olaylarından oluşan bir veri seti kullanılıyor. Olaylar 2017–2021 dönemini kapsıyor ve etiketler, şifreli mesajlaşma platformlarının izlenmesiyle belirlenen manipülasyon kampanyalarından elde ediliyor.
Piyasa verileri Binance API üzerinden BTC quote currency ile toplanıyor. Veriler saatlik mumlar hâlinde temsil ediliyor. Her pump zamanı en yakın saat sınırına yuvarlanarak piyasa verisiyle hizalanıyor.
Toplam veri seti 84 token için 1.905.850 gözlem içeriyor. Pozitif sınıf, yani pump olarak işaretlenen saat sayısı yalnızca 314. Bu da yaklaşık %0.016 pozitif oranına karşılık geliyor. Dolayısıyla problem aşırı dengesiz bir sınıflandırma problemidir.
Model değerlendirmesi kronolojik ayrımla yapılıyor. Saatlik zaman çizelgesinin %60’ı eğitim, %20’si doğrulama, %20’si test için ayrılıyor. Eğitim ve test sınırlarında kısa süreli sızıntıyı azaltmak için 5 saatlik embargo uygulanıyor. Karar eşiği doğrulama setinde F1 skorunu maksimize edecek şekilde seçiliyor ve testte değiştirilmeden uygulanıyor.
Karşılaştırma için Random Forest ve XGBoost gibi klasik makine öğrenmesi modelleri kullanılıyor. Grafik tabanlı tarafta ise statik korelasyon grafiği, olay odaklı dinamik korelasyon grafiği ve self-adaptive graph olmak üzere üç ST-GNN varyantı test ediliyor.
Sonuçlar Ne Gösteriyor?
1. Grafik tabanlı modeller klasik yöntemleri geçti. XGBoost F1 = 0.49 ± 0.03, Random Forest ise F1 = 0.53 ± 0.01 seviyesinde kalıyor. Buna karşılık tüm grafik tabanlı modeller bu iki baseline’ı aşıyor.
2. Statik ve dinamik korelasyon grafikleri fayda sağladı. Hacim korelasyonuna dayalı statik grafik F1 = 0.575 ± 0.04, dinamik hacim grafiği F1 = 0.58 ± 0.02 veriyor. İşlem sayısı üzerinden kurulan statik grafik ise F1 = 0.60 ± 0.04 ile korelasyon tabanlı yaklaşımlar arasında güçlü sonuç üretiyor.
3. En iyi genel sonuç self-adaptive graph ile geldi. Öğrenilebilir bağlantı yapısı kullanan self-adaptive graph modeli F1 = 0.62 ± 0.05 değerine ulaşıyor. Bu sonuç, tokenlar arası gizli bağımlılıkları modelin kendisinin öğrenmesinin faydalı olabileceğini gösteriyor.
4. PR eğrileri graph yaklaşımının avantajını destekliyor. Pump olayları çok nadir olduğu için ROC eğrisi yanıltıcı olabilir. Makale bu nedenle precision-recall analizine ağırlık veriyor. Grafik tabanlı modeller, özellikle yüksek recall bölgesinde daha iyi precision sunuyor.
5. APPC ve NXS gibi yoğun olaylı tokenlarda performans daha yüksek. Test setinde en az beş pump olayı bulunan APPC ve NXS için self-adaptive model sırasıyla F1 = 0.808 ± 0.05 ve F1 = 0.931 ± 0.06 değerlerine ulaşıyor.
6. Kazanç yalnızca model kapasitesinden gelmiyor. Eklerdeki temporal-only baseline sonuçları, yalnızca daha büyük GRU veya TransformerEncoder kullanmanın graph yaklaşımındaki farkı kapatmadığını gösteriyor. Bu da iyileşmenin asıl kaynağının tokenlar arası ilişkileri modellemek olduğunu düşündürüyor.
Bu Neden Önemli?
Kripto piyasalarında manipülasyon tespiti çoğu zaman erken uyarı ve piyasa gözetimi açısından kritik bir problemdir. Ancak her zaman işlem düzeyi blockchain verisi, order book derinliği veya sosyal medya mesajları erişilebilir olmayabilir. Bu çalışma, yalnızca saatlik agregat piyasa verisiyle de tokenlar arası ilişki çıkarımı yapılabileceğini ve bunun tespit performansını artırabileceğini gösteriyor.
Özellikle pump-and-dump kampanyaları izole olaylar değildir. Aynı gruplar benzer zamanlarda birden fazla tokenı hedefleyebilir, işlem sayısı ve hacim belirli tokenlar arasında eş zamanlı hareket edebilir veya piyasa davranışı kısa süreli bir ağ etkisi yaratabilir. Grafik tabanlı yaklaşım, bu ortak hareketleri modele dahil eder.
Çalışmanın önemli tarafı, gerçek gözetim koşullarına daha yakın bir değerlendirme kurmasıdır. Sadece pump olaylarının etrafındaki küçük pencereleri seçmek yerine, tüm piyasa akışı içinde nadir anomali tespiti yapılır. Bu da problemi daha zor ama daha gerçekçi hâle getirir.
Dikkat Noktaları
1. Çalışma preprinttir. Bulgular nihai hakemli sürüm kesinliğiyle değerlendirilmemelidir.
2. Bu bir yatırım modeli değildir. Model pump-and-dump olaylarını tespit etmeyi amaçlar. Herhangi bir token için alım, satım veya fiyat tahmini sistemi olarak kullanılmamalıdır.
3. Yanlış pozitif riski vardır. Bir tokenın anomali olarak işaretlenmesi, tek başına manipülasyon kanıtı değildir. Piyasa gözetiminde insan incelemesi, ek veri ve bağlamsal doğrulama gerekir.
4. Veri yalnızca agregat piyasa verisidir. Model order book, cüzdan transfer ağı, sosyal medya sinyali veya borsa içi emir akışı gibi ek kaynakları kullanmaz. Bu nedenle bazı manipülasyon türleri görünmeyebilir.
5. Pozitif sınıf çok nadirdir. Yaklaşık %0.016 pozitif oranı, model değerlendirmesini zorlaştırır. F1 ve precision-recall analizi bu yüzden önemlidir.
6. Self-adaptive graph yorumlanabilirlik sorunu yaratabilir. Korelasyon grafikleri daha anlaşılırken, öğrenilen gizli adjacency yapısının ekonomik veya davranışsal anlamı ayrıca analiz edilmelidir.
Riskli alan notu: Konu kripto piyasalarında manipülasyon tespitiyle ilgilidir. Bu yazı yatırım tavsiyesi değildir. Burada anlatılan yöntemler herhangi bir token, borsa veya kişi hakkında tek başına kesin suçlama aracı olarak kullanılmamalıdır. Çalışma, akademik piyasa gözetimi ve anomali tespiti bağlamında değerlendirilmelidir.
Genel değerlendirme: Makale, kripto piyasa manipülasyonlarını tespit ederken yalnızca tek tek tokenların fiyat ve hacim hareketlerine bakmanın yetersiz kalabileceğini savunuyor. Pump-and-dump kampanyaları çoğu zaman koordinasyon, tekrar, kısa zaman aralığında yoğun işlem ve benzer varlıklar arasında ortak hareket izleri bırakır. Bu nedenle çalışma, tokenları birer düğüm olarak ele alıp aralarındaki gizli ilişkileri grafik yapısıyla modellemeyi öneriyor.
Sonuç
Bu çalışma, kripto pump-and-dump tespitinde grafik tabanlı düşünmenin neden önemli olabileceğini gösteriyor. Manipülasyonlar çoğu zaman tek bir tokenın izole fiyat sıçramasından ibaret değildir; koordinasyon, tekrar, işlem yoğunluğu ve tokenlar arası ortak hareket barındırabilir. Bu nedenle tokenları birbirinden bağımsız satırlar olarak değil, ilişkili bir piyasa ağı olarak modellemek tespit gücünü artırabilir.
Makalenin en güçlü sonucu, yalnızca agregat OHLCV ve işlem aktivitesiyle çıkarılan grafiklerin bile klasik Random Forest ve XGBoost yaklaşımlarından daha iyi performans vermesidir. En iyi sonuç ise bağlantıları model içinde öğrenen self-adaptive graph yaklaşımıyla elde edilmiştir.
Verianla okuru için ana mesaj şudur: Kripto piyasalarında manipülasyon tespiti yalnızca “bu tokenın hacmi arttı mı?” sorusuyla sınırlı kalmamalı. Daha doğru soru, “bu tokenın davranışı, aynı anda veya yakın zamanda hareket eden diğer tokenlarla birlikte nasıl bir ağ deseni oluşturuyor?” olabilir.
Kaynak ve Yöntem Notu
Bu yazı, “Fraud Detection in Cryptocurrency Markets with Spatio-Temporal Graph Neural Networks” başlıklı akademik PDF temel alınarak hazırlanmış özgün Türkçe editoryal içeriktir. Metin birebir çeviri değildir; çalışmadaki problem, yöntem, formüller, grafikler, deney tasarımı, sonuçlar ve sınırlılıklar sadeleştirilerek anlatılmıştır.
Formüller MathJax uyumlu LaTeX blokları olarak verilmiştir. PDF’te bazı formül satırları metin çıkarımında bölündüğü için, sembol dizilimi makaledeki bağlama sadık kalınarak düzenlenmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir