

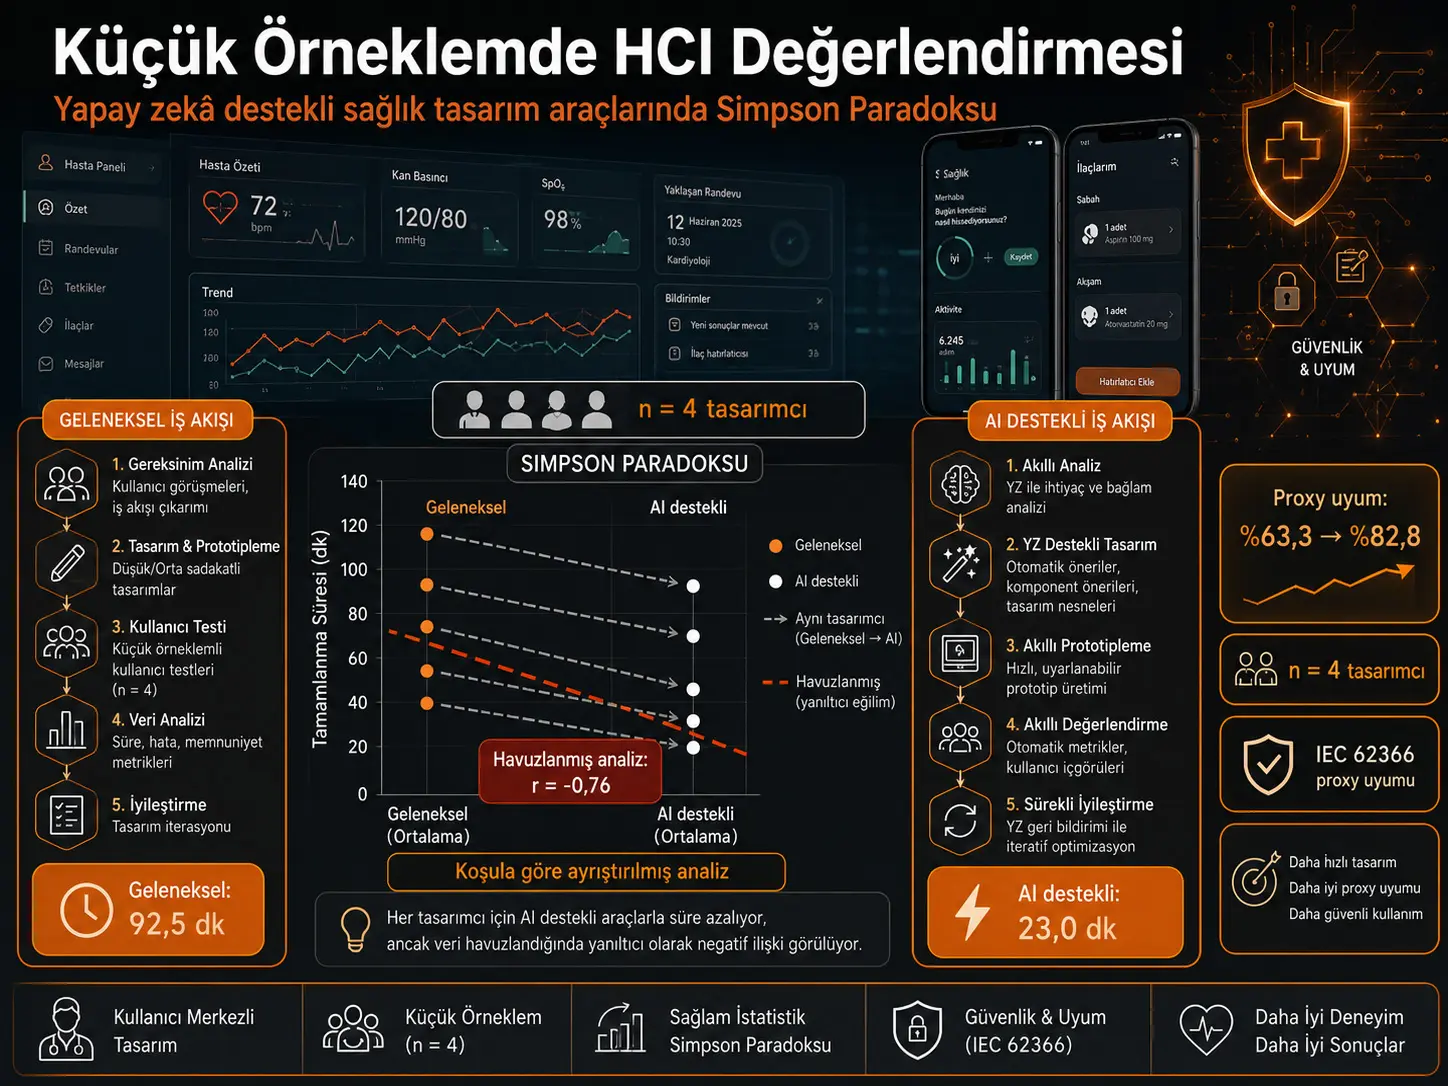
Bu çalışma, uzman katılımcı bulmanın zor olduğu sağlık alanındaki insan–bilgisayar etkileşimi (Human–Computer Interaction, HCI) araştırmalarında küçük örneklemlerin nasıl analiz edilmesi gerektiğini Simpson Paradoksu üzerinden inceliyor. Dört profesyonel UI/UX tasarımcısı aynı sağlık yazılımı arayüz görevlerini önce geleneksel yöntemle, ardından GPT tabanlı bir yapay zekâ destekli tasarım aracıyla tamamladı. Sekiz gözlemin tamamı tek veri kümesiymiş gibi birleştirildiğinde tasarım süresi ile otomatik IEC 62366 proxy-uyum puanı arasında güçlü ve istatistiksel olarak anlamlı negatif korelasyon bulundu: \(r=-0{,}76\), \(p=0{,}029\), \(n=8\). Buna karşılık geleneksel koşul kendi içinde \(r=-0{,}33\), \(p=0{,}67\); AI destekli koşul kendi içinde \(r=+0{,}18\), \(p=0{,}82\) verdi. Her iki koşul içi korelasyon da anlamlı değildi ve işaretleri birbirinden farklıydı. Dolayısıyla havuzlanmış korelasyon, “daha hızlı çalışmak daha iyi uyuma yol açıyor” biçiminde yorumlanabilecek gerçek bir bireysel ilişki değil, iki farklı deney koşulunun birbirinden ayrılmasının ürettiği bir aggregation artefact olarak değerlendirildi.
Ham verilerde bütün dört tasarımcının AI destekli koşulda hem daha kısa sürede çalıştığı hem de daha yüksek otomatik proxy-uyum puanı aldığı görüldü. Ortalama görev süresi 92,5 dakikadan 23,0 dakikaya; ortalama proxy-uyum puanı %63,3'ten %82,8'e değişti. Ancak bütün katılımcılar koşulları aynı sırayla tamamladığı için bu farkların tamamı doğrudan AI aracına atfedilemez; pratik, öğrenme ve göreve aşinalık etkileri sonuçlara katkıda bulunmuş olabilir. Ayrıca yalnız dört tasarımcının bulunması, Gaussian dağılım varsayımı, varyans değişiklikleri ve deneyim grupları arasındaki farklılıklar konusunda güçlü genelleme yapılmasını engellemektedir. Çalışmanın temel katkısı “dört kişi yeterlidir” iddiası değil; küçük örneklem kaçınılmaz olduğunda bilinen deney koşullarını ortadan kaldıran havuzlamanın yanıltıcı olabileceğini ve koşula göre ayrıştırılmış analizin verinin gerçek yapısını daha açık gösterebildiğini ortaya koymaktır.
Simpson Paradoksu nedir?
Simpson Paradoksu, alt gruplar ayrı ayrı incelendiğinde görülen ilişkilerin veriler birleştirildiğinde kaybolması, değişmesi veya ters yönde görünmesi durumudur. Sorun yalnız matematiksel bir merak değildir. Bir araştırmacı grup veya deney koşulu bilgisini dikkate almadan bütün gözlemleri tek dağılımdan geliyormuş gibi analiz ettiğinde, farklı grupların ortalamaları arasındaki mesafe yapay bir korelasyon oluşturabilir.
Bu araştırmadaki örnek oldukça açıktır. Geleneksel tasarım koşulu genel olarak yüksek süre–daha düşük uyum bölgesinde; AI destekli koşul ise düşük süre–daha yüksek uyum bölgesinde yer almaktadır. İki küme birlikte regresyona sokulduğunda grafik sol üstten sağ alta uzanan güçlü bir negatif eğilim üretmektedir.
Ancak araştırmanın asıl sorusu “sekiz bağımsız gözlemde süre ile uyum arasında ilişki var mı?” değildir. Aynı dört insan iki farklı koşul altında ölçülmüştür. Koşul üyeliği ve kişi eşleşmesi deney tasarımının temel parçalarıdır.
Havuzlanmış analiz neden yanıltıcı çıktı?
Sekiz gözlem birlikte hesaplandığında:
\[ r_{\mathrm{pooled}}=-0{,}76,\qquad p=0{,}029,\qquad n=8. \]
Bu sayı tek başına okunduğunda, daha kısa sürede tasarım yapmanın daha yüksek IEC 62366 uyumuyla sürekli biçimde ilişkili olduğu düşünülebilir. Yazarlar böyle bir yorumun desteklenmediğini özellikle belirtmektedir.
Koşullar ayrı tutulduğunda:
\[ r_{\mathrm{traditional}}=-0{,}33, \qquad p=0{,}67, \qquad n=4 \]
ve:
\[ r_{\mathrm{AI}}=+0{,}18, \qquad p=0{,}82, \qquad n=4 \]
elde edilmektedir.
Her iki korelasyon da istatistiksel olarak anlamlı değildir; üstelik biri negatif, diğeri pozitiftir. Bu nedenle kaynak çalışma, \(-0{,}76\)'lık havuzlanmış katsayının koşullar arasındaki konum farkından oluştuğunu ve tasarımcıların kendi içindeki bir hız–uyum mekanizmasını temsil etmediğini savunmaktadır.
Bireysel tasarımcılar gerçekte nasıl hareket etti?
| Tasarımcı | Geleneksel süre (dk) | AI destekli süre (dk) | Geleneksel proxy-uyum | AI destekli proxy-uyum |
|---|---|---|---|---|
| D1 | 90 | 33 | %64 | %93 |
| D2 | 88 | 32 | %50 | %75 |
| D3 | 120 | 10 | %63 | %83 |
| D4 | 72 | 17 | %76 | %80 |
Dört tasarımcının tamamı geleneksel koşuldan AI destekli koşula geçerken grafik üzerinde aynı genel yönde hareket etti: süre azaldı ve otomatik proxy-uyum puanı yükseldi. Bu bireysel eşleşmiş hareket, koşul bilgisini yok eden havuzlanmış korelasyonun neden dikkatle yorumlanması gerektiğini göstermektedir.
Koşullu Gaussian model ne yapıyor?
Çalışmanın önerdiği yaklaşımda her deney koşulu ayrı bir iki değişkenli Gaussian özet olarak temsil edilmektedir:
\[ p(x\mid k)= \mathcal N(x;\mu_k,\Sigma_k), \]
burada:
\[ x= \begin{bmatrix} \text{süre}\\ \text{proxy-uyum} \end{bmatrix} \]
ve \(k\), traditional veya AI-assisted koşulunu göstermektedir.
\(\mu_k\), her koşulun merkezini; \(\Sigma_k\) ise o koşuldaki gözlenen varyans ve covariance yapısını temsil eder.
Bu modelin amacı dört gözlemden güvenilir bir nüfus dağılımı tahmin etmek değildir. Yazarlar Gaussian bileşenlerini, koşula özgü merkezleri, saçılımı ve ortak değişim yönünü düzenli biçimde gösteren tanımlayıcı özetler olarak kullanmaktadır.
Bu gerçekten bir Gaussian Mixture Model mi?
Makale terminolojiyi özellikle açıklığa kavuşturmaktadır. Çalışmanın ilk geliştirildiği dönemde “conditional GMM” adı kullanılmış olsa da uygulanan yöntem klasik unsupervised Gaussian Mixture Model değildir.
Klasik GMM'de:
- hangi gözlemin hangi kümeye ait olduğu bilinmeyebilir,
- mixing weights tahmin edilir,
- Expectation–Maximisation gibi algoritmalar kullanılabilir,
- bileşen sayısı BIC gibi ölçütlerle seçilebilir.
Bu çalışmada ise geleneksel ve AI destekli koşul etiketleri deney tasarımından zaten bilinmektedir. İki bileşen keşfedilmemekte, baştan tanımlanmaktadır. EM kullanılmamış, latent cluster aranmış ve BIC ile bileşen sayısı seçilmiş değildir.
Bu nedenle yazarlar güncel metinde temel ad olarak conditional Gaussian model ifadesini kullanmaktadır.
Koşul merkezleri ne kadar farklı?
Geleneksel koşulun merkezi:
\[ \mu_{\mathrm{traditional}} = (92{,}5\ \mathrm{dk},\;63{,}3\%) \]
iken AI destekli koşulun merkezi:
\[ \mu_{\mathrm{AI}} = (23{,}0\ \mathrm{dk},\;82{,}8\%) \]
olarak verilmiştir.
Örneklemdeki merkez farkı, AI koşulunun geleneksel koşula göre ortalama olarak 69,5 dakika daha kısa ve 19,5 yüzde puanı daha yüksek otomatik proxy-uyum değerine sahip olduğunu göstermektedir.
Ancak sabit koşul sırası nedeniyle “AI aracı tek başına 69,5 dakika kazandırdı” veya “AI aracı tek başına uyumu 19,5 puan artırdı” sonucu çıkarılamaz. Bu değerler, araştırmanın uygulandığı sırada gözlenen koşul farklarıdır.
IEC 62366 puanı gerçekte neyi ölçüyor?
Çalışmanın kullandığı ikinci temel ölçüt, IEC 62366-1:2015 ile hizalanmayı değerlendirmek üzere ayrı bir GPT tabanlı aracın ürettiği yüzde puandır. Değerlendirme rubriği beş boyut içermektedir:
- Kullanım hatasının azaltılması: güvenlik açısından önemli etkileşimlerde hata fırsatlarının azaltılması.
- Bilgi hiyerarşisi: kritik ve birincil görev bilgisinin görsel ve yapısal önceliği.
- Geri bildirimin açıklığı: sistem yanıtları, hata durumları ve onayların açık olması.
- Erişilebilirlik: okunabilirlik, kontrast, hedef boyutu ve klinik kullanım ortamıyla ilişkili erişilebilirlik özellikleri.
- Tıbbi cihaz arayüzü konvansiyonları: bilinen terminoloji ve etkileşim beklentileriyle uyum.
Bu puan resmî IEC 62366 sertifikasyonu veya düzenleyici uygunluk kararı değildir. Rubrik, değerlendirme aracı tarafından standarttan çıkarılmıştır ve uzman insan değerlendiriciler karşısında doğrulanmamıştır. Yazarlar bu nedenle ölçütü “consistency-controlled proxy measure” olarak sınırlandırmaktadır.
Aynı model ailesinin hem üretmesi hem değerlendirmesi neden önemli?
AI destekli tasarım aracı, çalışma döneminde ChatGPT üzerinden erişilen GPT-4o tabanlı özel bir GPT'dir. Ayrı compliance scorer da GPT-4o model ailesi üzerinde çalışan başka bir özel GPT olarak kurulmuştur.
Yazarlar bunun olası bir model-family bias oluşturabileceğini açıkça kabul etmektedir. Tasarım üretiminde kullanılan model ailesinin ürettiği örüntüler, aynı aileden gelen değerlendirme sistemine yapısal olarak daha uygun görünebilir.
Dolayısıyla uyum puanlarının bağımsız uzmanlar tarafından doğrulanması gelecekte yapılması gereken temel metodolojik kontrollerden biridir.
Örneklemdeki standart sapmalar ne gösteriyor?
Kaynakta gözlenen örneklem standart sapmaları şöyledir:
| Ölçüt | Geleneksel koşul | AI destekli koşul |
|---|---|---|
| Görev süresi | 20,0 dk | 11,3 dk |
| Proxy-uyum | 10,6 yüzde puanı | 7,6 yüzde puanı |
Her iki ölçütte de örneklem standart sapması AI koşulunda daha küçüktür. Ancak yalnız dört gözlem bulunduğu için bu fark nüfus varyansının gerçekten azaldığını kanıtlamaz.
Brown–Forsythe biçimindeki Levene testinde süre için:
\[ W=0{,}16,\qquad p=0{,}70 \]
ve proxy-uyum için:
\[ W=0{,}12,\qquad p=0{,}74 \]
elde edilmiştir.
Yazarlar bu sonuçları “varyanslar eşittir” şeklinde yorumlamamaktadır. \(n=4\) nedeniyle testin gücü çok düşüktür; mevcut veri varyans daralmasını ne doğrulayabilir ne de dışlayabilir.
Deneyim düzeyine göre nasıl bir örüntü görüldü?
| Tasarımcı | Profil | Gözlenen süre azalması | Gözlenen proxy-uyum artışı |
|---|---|---|---|
| D1 | Orta UI / Yüksek AI | %63 | +29 yüzde puanı |
| D2 | Orta UI / Yüksek AI | %64 | +25 yüzde puanı |
| D3 | Düşük UI / Bir miktar AI | %92 | +20 yüzde puanı |
| D4 | Yüksek UI / Düşük AI | %76 | +4 yüzde puanı |
UI deneyimi en düşük tasarımcı D3, 120 dakikadan 10 dakikaya inerek örneklemdeki en büyük süre farkını göstermiştir. AI deneyimi yüksek D1 ve D2 ise sırasıyla +29 ve +25 yüzde puanıyla en büyük otomatik proxy-uyum artışlarına sahiptir.
Bu değerler deneyim grupları arasında kanıtlanmış etkileşim etkileri değildir. Her profil için tek tasarımcı veya çok az gözlem bulunması nedeniyle yazarlar bunları yalnız gelecek araştırmalar için hipotez üreten keşifsel örüntüler olarak değerlendirmektedir.
Tasarımcıların geri bildirimleri ne söyledi?
Phase 1'de dört tasarımcının tamamı AI destekli aracın fikirden görsel tasarıma geçiş sürecini hızlandırdığını belirtti. Üç tasarımcı aracın tasarım vizyonunu somut tasarıma dönüştürmede yararlı olduğunu bildirdi.
Buna karşılık iki daha deneyimli tasarımcı varsayılan adım-adım yönlendirmenin kendi uzman iş akışlarında gereksiz sürtünme oluşturduğunu söyledi. Kaynakta bu geri bildirim formal thematic analysis olarak sunulmamaktadır; yalnız küçük örneklemden elde edilen betimleyici tekrar eden konu özeti olarak raporlanmaktadır.
Bu gözlem aracı nasıl değiştirdi?
Araştırmacılar ilk aşamadaki heterojenliği yalnız raporlamakla kalmamış, ikinci aşamada aracı yeniden tasarlamak için kullanmıştır.
Yeni araç oturum başlangıcında kullanıcının:
- AI araçlarıyla deneyimini,
- UI tasarımı deneyimini
sormakta ve iki etkileşim modundan birini seçmektedir.
Daha az deneyimli kullanıcı: açık tasarım kararları, inline rehberlik ve adım-adım “handholding” modu.
Daha deneyimli kullanıcı: daha az scaffolding içeren açık uçlu/free-form mod.
Ayrıca ilk aracın yalnız görsel üretimine dayalı yaklaşımına ek olarak doğrudan UI öğelerinin düzenlenebildiği bir real-canvas yüzeyi eklenmiştir.
İkinci aşamada ne oldu?
Phase 2'ye D1, D2 ve D3 katıldı. D4 bu aşamada yer almadı.
| Tasarımcı | Phase 1 AI aracı (dk) | Phase 2 uyarlanabilir araç (dk) | Gözlenen zaman değişimi |
|---|---|---|---|
| D1 | 33 | 10 | −%70 |
| D2 | 32 | 17 | −%47 |
| D3 | 10 | 32 | +%220 |
AI deneyimi yüksek D1 ve D2, uyarlanmış araçla daha da hızlandı. UI deneyimi düşük D3 ise önceki 10 dakika yerine 32 dakika harcadı.
Kaynak bu artışı otomatik olarak kötüleşme olarak yorumlamamaktadır. D3 açık uçlu geri bildiriminde tasarım üzerinde daha uzun süre iterasyon yaptığını ve çıktıyı daha fazla geliştirdiğini belirtmiştir. Bununla birlikte çalışma, objektif Phase 2 kalite ölçütü bulunmadığı için:
“daha yavaş çünkü daha dikkatli”
ile:
“daha yavaş çünkü araç daha fazla kısıtladı”
olasılıklarını nicel olarak ayıramamaktadır.
Phase 2'nin kalite ölçütü neden Phase 1 ile karşılaştırılamaz?
Phase 1'de kalite/uyum için GPT tabanlı IEC 62366 proxy-puanı kullanılmıştır. Phase 2'de aynı otomatik değerlendirme tekrarlanmamış; bunun yerine katılımcılar beş puanlık bir memnuniyet/kalite değerlendirmesi yapmıştır.
Üç tasarımcı da 4/5 vermiş ve scaffolding'in uygun olduğunu bildirmiştir. Ancak:
\[ \text{IEC 62366 proxy-puanı} \neq \text{öznel 5 puanlık memnuniyet} \]
olduğu için Phase 1 ve Phase 2 kalite değerleri doğrudan karşılaştırılamaz.
Gaussian varsayımı gerçekten test edildi mi?
Hayır. Araştırmacılar \(n=4\) gözlemle bivariate normality varsayımının anlamlı biçimde doğrulanamayacağını açıkça belirtmektedir.
Shapiro–Wilk, Kolmogorov–Smirnov veya Anderson–Darling gibi testlerin bu büyüklükteki örneklemde yorumlanabilir gücü yoktur. Dört noktadan oluşan Q–Q grafiği de dağılım biçimini güvenilir olarak belirleyemez.
Bu nedenle conditional Gaussian model, formal likelihood inference için doğrulanmış bir olasılık modeli olarak değil, koşulları düzenleyen ve görsel olarak özetleyen bir araç olarak kullanılmaktadır.
Paired t-test ne gösterdi?
Aynı katılımcılar iki koşulda ölçüldüğü için araştırmacılar standart paired t-test karşılaştırmasını da yapmıştır.
Süre farkı için:
\[ \bar d=69{,}5\ \mathrm{dk}, \]
\[ t(3)=5{,}15, \qquad p=0{,}014, \]
\[ 95\%\ GA=[26{,}5,\;112{,}5], \qquad d_z=2{,}57. \]
Proxy-uyum farkı için:
\[ \bar d=19{,}5\ \text{yüzde puanı}, \]
\[ t(3)=3{,}56, \qquad p=0{,}038, \]
\[ 95\%\ GA=[2{,}0,\;37{,}0], \qquad d_z=1{,}78. \]
Yazarlar paired t-test'i iki koşulun ortalama farkı hakkında temel inferential comparator olarak kullanmaktadır. Conditional Gaussian model bunun yerine Simpson Paradoksunu ve koşullara/user profillerine göre yapısal heterojenliği görünür kılmaktadır. Yani conditional model, paired t-test'in yerine geçirilmemektedir.
Wilcoxon testi neden anlamlı çıkmadı?
Exact Wilcoxon signed-rank test her iki sonuç için:
\[ W=0,\qquad p=0{,}125 \]
vermiştir.
Ancak dört eşleşmenin tamamı aynı yönde olduğunda iki taraflı exact Wilcoxon testinin elde edebileceği en küçük p-değeri:
\[ 2\left(\frac12\right)^4=0{,}125 \]
olduğundan, çalışma bu sonucu “etki yok” şeklinde yorumlamamaktadır. Bu örneklem boyutunda testin p-değeri çözünürlüğü zaten 0,05'in altına inememektedir.
Neden mixed-effects model kullanılmadı?
Dört tasarımcı, random-effect varyans bileşenlerinin güvenilir tahmini için son derece sınırlı bir grup düzeyi sayısıdır. Araştırmacılar random-intercept modelini denemiş ancak maksimum likelihood çözümü üç optimizer ile yeniden denenmesine rağmen converge etmemiş; bir L-BFGS yapılandırmasında singular design matrix elde edilmiştir.
Random-slope modeli matematiksel olarak converge etmiş olsa da yalnız dört kişide aşırı parametrik olduğu için varyans bileşenlerinin yorumlanamaz olduğu kabul edilmiştir.
Bayesian hierarchical model neden uygulanmadı?
Çalışmanın değerlendirmesine göre \(n=4\)'te tasarımcılar arası varyansı temsil eden hyperparameter veriden yeterince belirlenemez. Zayıf prior kullanıldığında posterior büyük ölçüde prior'ı geri verebilir; güçlü prior kullanıldığında sonuç daha da doğrudan prior tarafından belirlenebilir.
Bu nedenle Bayesian hierarchical model daha büyük veri seti için gelecek çalışma olarak bırakılmıştır.
Çalışmanın desteklediği sonuçlar
Birinci olarak, bu örneklemde geleneksel ve AI destekli koşullar birleştirildiğinde güçlü negatif korelasyon oluşmuş, fakat koşullar ayrı analiz edildiğinde aynı ilişki görülmemiştir. Çalışmanın Simpson Paradoksu/aggregation artefact iddiasının doğrudan ampirik temeli budur.
İkinci olarak, dört tasarımcının tamamında AI destekli koşul geleneksel koşula göre daha kısa süre ve daha yüksek otomatik proxy-uyum puanıyla birlikte gözlenmiştir.
Üçüncü olarak, koşula özgü analiz tasarımcılar arasında farklı yanıt profilleri bulunduğunu göstermiştir; ancak bu profiller küçük örneklem nedeniyle hipotez üretici düzeydedir.
Dördüncü olarak, Phase 1'de gözlenen scaffolding heterojenliği aracın deneyime uyarlanmış ikinci sürümünün tasarlanmasına yol açmış ve Phase 2'de tasarımcılar arasında çift yönlü zaman yanıtı gözlenmiştir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
Çalışma dört kişinin küçük örneklem için genel olarak yeterli olduğunu göstermemektedir. Yazarlar bunun tersini açıkça kabul etmektedir.
Çalışma AI aracının gözlenen bütün iyileşmenin nedensel kaynağı olduğunu kanıtlamamaktadır. Koşullar counterbalanced olmadığı için pratik ve görev aşinalığı etkileri ayrıştırılmamıştır.
Çalışma GPT tabanlı uyum puanının gerçek düzenleyici IEC 62366 uygunluğuna eşdeğer olduğunu göstermemektedir.
Çalışma AI koşulunda gerçek nüfus varyansının daha düşük olduğunu kanıtlamamaktadır.
Çalışma belirli deneyim seviyelerindeki bütün tasarımcıların aynı biçimde yanıt vereceğini göstermemektedir.
Phase 2, uyarlanabilir aracın kalite açısından üstün olduğunu kanıtlamamaktadır. Phase 2'de Phase 1 ile aynı objektif/proxy kalite ölçütü kullanılmamıştır.
Conditional Gaussian model formal küçük-örneklem inferential çözümü olarak doğrulanmamıştır. Makalede esas işlevi koşul yapısını koruyan tanımlayıcı ve diagnostik analizdir.
Türkiye açısından ne ifade ediyor?
Çalışma Japonya'daki bir üniversiteye bağlı araştırmacılar tarafından yürütülmüş ve yalnız dört profesyonel tasarımcıdan oluşan kolayda örneklem kullanılmıştır. Türkiye'deki sağlık yazılım tasarımcıları veya tıbbi cihaz üreticileri için doğrudan performans sonucu sunmamaktadır.
Buna karşılık yöntemsel mesaj ülkeye özgü değildir: uzman katılımcıların az olduğu sağlık HCI, medikal yazılım, endüstriyel arayüz veya diğer güvenlik-kritik UX çalışmalarında koşulları tek havuzda birleştirmeden önce koşul içi desenlerin incelenmesi gerekir. Türkiye bağlamında aynı yöntemin uygulanması, yerel tasarımcılarla daha büyük ve koşul sırası dengelenmiş bağımsız çalışmalar gerektirir.
Çalışmanın Yöntemi ve Bulguları
Phase 1 deney tasarımı
Dört profesyonel UI/UX tasarımcısı sağlık yazılımı arayüzleri için aynı tasarım görevlerini iki koşulda tamamladı:
- Geleneksel iş akışı: AI tasarım aracı kullanılmadan manuel yaklaşım.
- AI destekli iş akışı: sağlık HCI ilkeleri ve IEC 62366 bilgisiyle yapılandırılmış GPT tabanlı araç.
Katılımcı özellikleri şöyledir:
| ID | UI deneyimi | AI deneyimi | Arka plan |
|---|---|---|---|
| D1 | Orta | Yüksek | Healthcare UX, 3+ yıl |
| D2 | Orta | Yüksek | Medical software, 4 yıl |
| D3 | Düşük | Bir miktar | Genel UX; sağlık alanına geçiş |
| D4 | Yüksek | Düşük | Kıdemli tasarımcı, 8+ yıl |
Görevler Portable Health Clinic mobil sistemi için güvenli giriş ekranı ve sağlık çalışanı dashboard'u gibi sağlık arayüzlerini içeriyordu. Gereksinimler hata önleme, bilgi hiyerarşisi ve erişilebilirlik boyutlarını kapsıyordu.
Oturumlar yaklaşık 90 dakika için planlanmış ancak sert bir süre sınırı uygulanmamıştır. Süre, görevin başlamasından tasarımcının son teslimine kadar kaydedilmiştir.
Koşul sırasının tasarımdaki etkisi
Dört katılımcının tamamı:
önce traditional → sonra AI-assisted
sırasını takip etmiştir.
Araştırmacılar bunu AI aracıyla önceden karşılaşmanın manuel tasarımı etkilemesini önlemek amacıyla tercih etmiştir. Buna karşılık bu karar, ikinci koşuldaki sonuçları görev öğrenimi ve aşinalıkla karıştırmaktadır.
Bu nedenle çalışma randomised veya counterbalanced causal trial olarak değil, sequentially unbalanced exploratory comparison olarak yorumlanmaktadır.
AI tasarım aracının yapısı
AI koşulunda kullanılan uygulama doğal dil istemleriyle çalışan GPT tabanlı bir tasarım aracıdır. Araç:
- metinsel açıklamalardan arayüz mockup'ları oluşturabiliyor,
- HCI ve kullanılabilirlik ilkelerine göre iyileştirmeler önerebiliyor,
- potansiyel kullanım hatalarını işaretleyebiliyor,
- sağlık UX örüntülerini ve IEC 62366 bilgisini tasarım sürecine dahil edebiliyordu.
Çalışma döneminde araç ChatGPT platformu üzerinde özel GPT biçiminde ve GPT-4o model ailesiyle çalışmıştır.
Ana ölçütler
İki birincil nicel ölçüt toplanmıştır:
- Görev tamamlama süresi: dakika.
- IEC 62366 proxy-uyum puanı: ayrı GPT tabanlı değerlendirme aracından elde edilen yüzde değer.
Ham süre verileri ve Verianla Live
Dört katılımcının tamamında AI destekli koşulda görev süresi daha düşüktür. Aşağıdaki Verianla Live grafiği yalnız aynı birimdeki süre verilerini karşılaştırmaktadır; compliance puanları süre eksenine karıştırılmamıştır.
Ortalama süre:
\[ 92{,}5\ \mathrm{dk} \rightarrow 23{,}0\ \mathrm{dk} \]
olarak değişmiştir. Kaynak bunu gözlenen ortalamada yaklaşık %75 azalma olarak rapor etmektedir. Sabit koşul sırası nedeniyle bu yüzde saf nedensel AI etkisi değildir.
Proxy-uyum sonuçları
| Tasarımcı | Geleneksel proxy-uyum | AI destekli proxy-uyum | Fark |
|---|---|---|---|
| D1 | %64 | %93 | +29 yüzde puanı |
| D2 | %50 | %75 | +25 yüzde puanı |
| D3 | %63 | %83 | +20 yüzde puanı |
| D4 | %76 | %80 | +4 yüzde puanı |
Örneklem ortalaması:
\[ 63{,}3\% \rightarrow 82{,}8\% \]
olarak değişmiş ve dört tasarımcının tamamında yön pozitif olmuştur. Ancak puanın otomatik ve uzman doğrulamasından geçmemiş bir proxy olduğu özellikle korunmalıdır.
Simpson Paradoksunun sayısal özeti
| Analiz | Korelasyon \(r\) | p | n | Kaynak yorumu |
|---|---|---|---|---|
| Tüm gözlemler havuzlanmış | −0,76 | 0,029 | 8 | Anlamlı görünen ancak koşullar arası fark tarafından oluşturulan aggregation artefact |
| Yalnız geleneksel koşul | −0,33 | 0,67 | 4 | Anlamlı değil |
| Yalnız AI destekli koşul | +0,18 | 0,82 | 4 | Anlamlı değil |
Kaynak çalışmanın metodolojik iddiası tam olarak bu ayrımdan doğmaktadır: koşulların ayrılması, havuzlanmış korelasyonda görünmeyen deney yapısını geri kazandırmaktadır.
Paired analiz ile conditional modelin görevleri farklı
| Yöntem | Bu çalışmadaki rolü |
|---|---|
| Paired t-test | Aynı katılımcının iki koşul arasındaki ortalama farkını inferential olarak test eder. |
| Conditional Gaussian model | Her koşulun merkezini, saçılımını ve ortak değişken yapısını ayrı tutar; aggregation artefact'ı görünür kılar. |
| Wilcoxon signed-rank | Rank temelli kontrol; \(n=4\)'te minimum iki taraflı p=0,125 nedeniyle inferential çözünürlüğü yetersizdir. |
| Repeated-measures ANOVA | İki koşullu tasarımda paired t-test ile matematiksel olarak eşdeğerdir. |
| Linear mixed-effects | Dört random-effect seviyesi nedeniyle güvenilir biçimde tahmin edilememiştir. |
| Bayesian hierarchical model | Bu örneklemde between-designer varyansı prior'a aşırı bağımlı olacağından uygulanmamıştır. |
Monte Carlo ek analizi ne gösteriyor?
Makalenin ek materyalinde, deney tasarımına eşleştirilmiş bir Monte Carlo simülasyonu rapor edilmektedir. Kaynak metnin özetlediği sonuçta within-condition correlation sıfır olacak biçimde tanımlanan veri üretim sürecinde, \(n=4\) kişi/koşul düzeyinde 10.000 simülasyonun %56'sında havuzlanmış analiz istatistiksel olarak anlamlı negatif korelasyon üretmiştir.
Bu simülasyon makaledeki tek parametre konfigürasyonuna aittir. Farklı örneklem büyüklükleri, etki büyüklükleri, korelasyon yapıları ve normal dağılımdan sapmalar için genel operating characteristics çalışması yapılmamıştır.
Phase 2'nin metodolojik anlamı
İkinci aşamanın temel katkısı, conditional analizden çıkan kullanıcı heterojenliği hipotezinin somut bir ürün tasarımı değişikliğine çevrilmesidir:
analiz → deneyime bağlı scaffolding hipotezi → aracın yeniden tasarımı → yeni kullanıcı yanıtlarının gözlenmesi.
Yazarlar bu döngünün iterative HCI design'a özgü benzersiz bir yöntem olmadığını kabul etmektedir. Conditional modelin katkısı, havuzlanmış analiz tarafından düzleştirilecek heterojenliği yapısal olarak korumasıdır.
Çalışmanın metodolojik önerileri
- Koşul farkı bekleniyorsa önce koşulları ayrı incele.
- Pooled korelasyon ile within-condition korelasyonları karşılaştırarak Simpson Paradoksu kontrolü yap.
- Her koşul için ortalama, saçılım ve korelasyonları ayrı raporla.
- Küçük örneklemde varyans farklarını inferential gerçekler gibi değil, tanımlayıcı istatistikler olarak sun.
- Deneyim ve uzmanlık gibi ilgili kullanıcı özelliklerine göre yanıtları keşifsel olarak incele.
- Within-subject tasarımın pairing yapısını inferential analiz sırasında koru.
Başlıca sınırlılıklar
- Phase 1 yalnız dört tasarımcı içerir.
- Phase 2 yalnız üç tasarımcı içerir.
- Katılımcılar convenience sampling ile profesyonel ağlardan seçilmiştir.
- Koşul sırası sabittir ve counterbalanced değildir.
- Pratik/öğrenme etkisi AI etkisinden ayrılamaz.
- Görevler yalnız tek mobil sağlık yazılımı bağlamındadır.
- IEC 62366 puanlama sistemi bağımsız insan uzmanlarla doğrulanmamıştır.
- Tasarım aracı ile compliance scorer aynı GPT-4o model ailesindedir.
- Gaussian dağılım varsayımı \(n=4\)'te test edilemez.
- Koşullar arası varyans farkı kanıtlanmamıştır.
- Experience-indexed sonuçlar tekil gözlemlerden türetilmiş keşifsel örüntülerdir.
- Phase 2'de D4 yer almamıştır.
- Phase 2'de Phase 1'deki IEC 62366 proxy-puanı tekrarlanmamıştır.
- Phase 2'nin 5 puanlık öznel kalite/memnuniyet ölçütü Phase 1'in proxy-compliance metriğiyle doğrudan karşılaştırılamaz.
Gelecek çalışmalar
Yazarların önerdiği sonraki adımlar daha büyük ve counterbalanced örneklemler, koşul varyanslarının yeterli güçle test edilmesi, Gaussian goodness-of-fit değerlendirmesi, modelin farklı örneklem ve korelasyon koşullarındaki simülasyonla kapsamlı karakterizasyonu ve otomatik IEC 62366 skorunun uzman insan değerlendiriciler karşısında inter-rater reliability analizidir.
Çerçevenin havacılık arayüzleri, finansal hizmetlerin compliance UI'ları ve erişilebilirlik zorunluluğu bulunan kamu arayüzleri gibi sağlık dışındaki güvenlik-kritik alanlarda sınanması da önerilmektedir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Conditional Gaussian Modelling for Small-Sample HCI Evaluation: Resolving Simpson’s Paradox in AI-Assisted Healthcare Design Tools
Yazarlar: Mohammad Bilal Firoz; Ashir Ahmed.
Eş birinci/eş katkı: Kaynakta belirtilmemiştir.
Sorumlu yazar: Mohammad Bilal Firoz.
Kurum: Department of Information Science and Technology, Kyushu University, Fukuoka 819-0395, Japan.
Kaynak türü: İnsan katılımcılı, küçük örneklemli HCI/usability araştırma makalesi; iki aşamalı keşifsel değerlendirme ve metodolojik analiz.
Hakemlik durumu: Hakemli dergi yayınıdır.
Dergi: AI.
Yayınevi: MDPI, Basel, İsviçre.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 6, Makale 199.
DOI: 10.3390/ai7060199.
Alınma / revizyon / kabul / yayın: 31 Mart 2026 / 22 Mayıs 2026 / 26 Mayıs 2026 / 30 Mayıs 2026.
Lisans: Creative Commons Attribution (CC BY).
Academic Editors: Zubaer Mannan; Asif Karim; Nur Alam Md.
Phase 1 örneklemi: Dört profesyonel UI/UX tasarımcısı.
Phase 2 örneklemi: İlk aşamadaki tasarımcılardan üçü; D4 katılmamıştır.
Araştırma tasarımı: Within-subjects fakat koşul sırası sabit, sequentially unbalanced exploratory comparison. Bütün tasarımcılar traditional koşulu önce, AI-assisted koşulu ikinci tamamlamıştır.
AI tasarım aracı: Çalışma döneminde ChatGPT platformu üzerinden erişilen GPT-4o tabanlı custom GPT.
Compliance değerlendirme aracı: Tasarım aracından ayrı, ancak yine GPT-4o model ailesi üzerine kurulmuş custom GPT.
Compliance metriğinin statüsü: IEC 62366-1:2015 hizalanması için otomatik ve consistency-controlled proxy ölçüttür; doğrulanmış düzenleyici uygunluk kararı değildir ve uzman insan değerlendirmesiyle inter-rater reliability kurulmamıştır.
Ana metodolojik yöntem: Bilinen deney koşullarına göre condition-stratified bivariate Gaussian summaries. Unsurpervised GMM, EM algoritması, BIC component selection veya latent cluster discovery kullanılmamıştır.
Başlıca istatistikler: Pearson korelasyonları, paired t-test, exact Wilcoxon signed-rank, Brown–Forsythe biçiminde Levene variance testi ve repeated-measures ANOVA eşdeğerliği. Linear mixed-effects fit denenmiş ancak güvenilir biçimde kullanılamamıştır; Bayesian hierarchical analiz uygulanmamıştır.
Phase 1 ana gözlenen fark: Ortalama süre 92,5 dakikadan 23,0 dakikaya; otomatik proxy-uyum ortalaması %63,3'ten %82,8'e değişmiştir. Koşul sırası sabit olduğu için değerler saf nedensel araç etkileri olarak yorumlanamaz.
Simpson Paradoksu sonucu: Pooled \(r=-0{,}76\), \(p=0{,}029\), \(n=8\); traditional \(r=-0{,}33\), \(p=0{,}67\), \(n=4\); AI-assisted \(r=+0{,}18\), \(p=0{,}82\), \(n=4\).
Paired t-test: Zaman tasarrufu için \(t(3)=5{,}15\), \(p=0{,}014\), \(d_z=2{,}57\); proxy-uyum artışı için \(t(3)=3{,}56\), \(p=0{,}038\), \(d_z=1{,}78\).
Finansman: Araştırma dış finansman almamıştır.
Etik kurul: Kaynağa göre ilgili Japon kurumsal yönergeleri kapsamında formal etik kurul onayı gerekli görülmemiştir. Çalışma hasta, klinik müdahale, biyolojik örnek veya kişisel sağlık verisi içermeyen, gönüllü yetişkin profesyonellerle yapılan non-medical ve non-interventional usability değerlendirmesi olarak tanımlanmıştır. Araştırmacılar çalışmanın Helsinki Bildirgesi ilkeleri doğrultusunda yürütüldüğünü belirtmektedir.
Bilgilendirilmiş onam: Bütün katılımcılardan onam alınmıştır; anonim katılımcı kodlarının, anonim tasarım notu alıntılarının ve görevlerde üretilen arayüz tasarımlarının yayımlanması için de onam verildiği belirtilmektedir.
Veri erişilebilirliği: Çalışmanın özgün katkılarının makale ve Supplementary Materials içinde bulunduğu, ilave soruların sorumlu yazara yöneltilebileceği belirtilmektedir.
Ek materyal: AI tasarım araçları, deneysel veriler, görev tanımları, örnek tasarımlar, çalışma protokolü, istatistik ayrıntıları, veri/araç erişimi, Q–Q grafikleri, Simpson Paradoksu Monte Carlo analizi ve yeniden üretilebilirlik betiği bölümlerinin bulunduğu bildirilmektedir.
Yazar katkıları: Kavramsallaştırma M.B.F. ve A.A.; metodoloji M.B.F.; formal analiz M.B.F.; araştırma M.B.F.; ilk taslak M.B.F.; gözden geçirme ve düzenleme A.A.; görselleştirme M.B.F.; danışmanlık A.A. tarafından gerçekleştirilmiştir.
Üretken AI kullanım beyanı: Deneyde UI/UX tasarım aracı ve IEC 62366 proxy-değerlendirme aracı GPT-4o tabanlı custom GPT'ler olarak kullanılmıştır. Kaynak ayrıca makale hazırlanırken dil düzeltme, editörlük ve istatistik hesaplarının kontrolüne destek amacıyla Claude Opus 4.7 kullanıldığını; bütün istatistiklerin yazarlar tarafından gözden geçirilip doğrulandığını ve içerikten yazarların sorumlu olduğunu bildirmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Bilimsel yorum sınırı
Çalışmanın ana metodolojik mesajı, küçük örneklemin yeterli hâle geldiği değil; kaçınılmaz küçük örneklemlerde deney yapısını yok eden havuzlamanın ayrıca hata üretebileceğidir. Conditional Gaussian yaklaşım bu çalışmada koşul yapısını koruyan tanımlayıcı/diagnostik çerçevedir ve büyük örneklemli doğrulayıcı istatistiksel çalışmaların yerine geçmemektedir.
AI koşulunda gözlenen daha kısa süre ve daha yüksek proxy-uyum puanı, sabit koşul sırası nedeniyle yalnız AI aracının nedensel etkisine atanamaz. Araştırmacılar aynı sınırı çalışma boyunca tekrar etmektedir.
IEC 62366 yüzdesi, gerçek bir tıbbi cihazın düzenleyici uygunluğunun doğrulandığı anlamına gelmez. Kullanılan GPT tabanlı rubrik bağımsız uzman değerlendirmesine karşı doğrulanmadığı için makaledeki değerler yalnız otomatik proxy-uyum ölçütü olarak ele alınmalıdır.
Phase 2'de gözlenen deneyime göre çift yönlü zaman yanıtı da doğrulayıcı bir etkileşim testi değildir. Üç tasarımcı, sabit görev sırası ve farklı kalite ölçütü nedeniyle sonuç yalnız tasarım hipotezi üretici niteliktedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir