

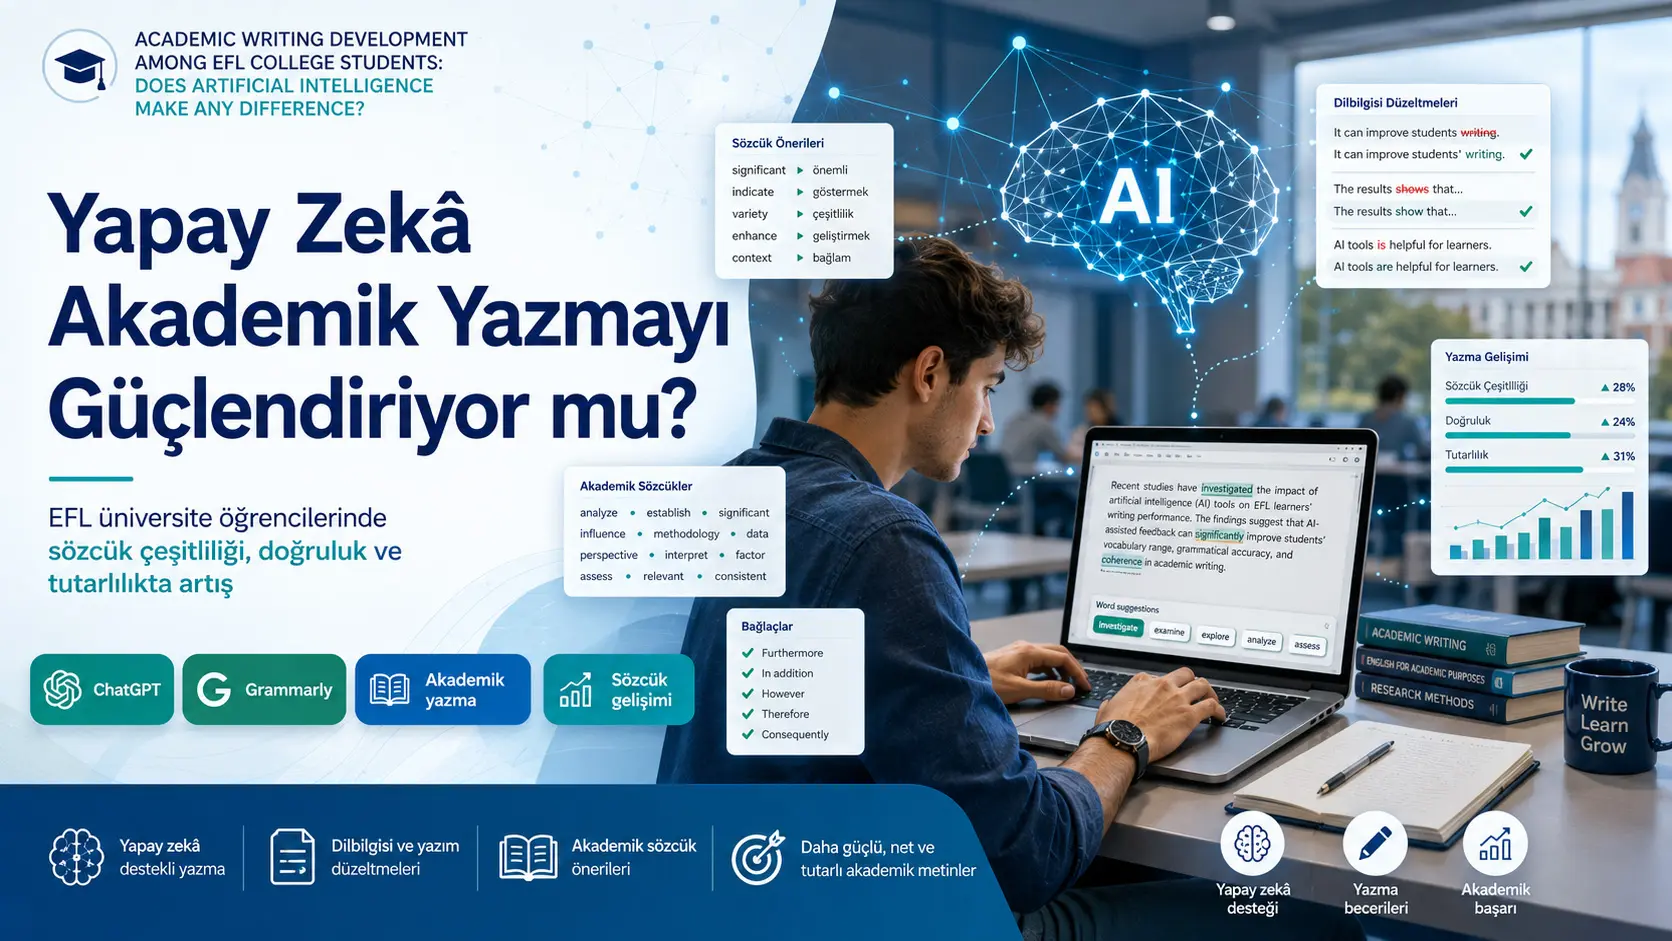
ChatGPT ve Grammarly gibi yapay zekâ destekli yazma araçları öğrencilere sözcük seçimi, tekrarların azaltılması, dilbilgisi, cümle yapısı ve metin düzeni hakkında hızlı öneriler sunmaktadır. Ancak bir öğrencinin bu araçlarla daha iyi bir metin oluşturması, aynı beceriyi araç kapatıldığında da edindiği anlamına gelmez. Bu araştırma, yapay zekâ destekli sözcük çalışmasının İngilizceyi yabancı dil olarak öğrenen üniversite öğrencilerinin akademik yazılarıyla nasıl ilişkilendiğini incelemiştir.
Araştırma Suudi Arabistan’daki orta büyüklükte bir üniversitede yürütülmüş; işletme, mühendislik ve bilgisayar bilimi alanlarından 160 lisans öğrencisi çalışmaya katılmıştır. Öğrenciler ENGL 101, ENGL 102 ve ENGL 201 derslerine kayıtlıdır. Katılımcıların yüzde 18’i B1, yüzde 58’i B2, yüzde 24’ü C1 düzeyinde sınıflandırılmıştır.
Öğrenciler bir dönem boyunca ChatGPT ve Grammarly ile desteklenen yazma etkinliklerine katılmıştır. Program; araç kullanım eğitimi, etik ve akademik dürüstlük bilgilendirmesi, kişiselleştirilmiş öğrenme planları, yönlendirilmiş yazma oturumları, bağımsız çalışma, oyunlaştırılmış etkinlikler ve aralıklı sözcük tekrarını birlikte içermiştir. Özette sekiz yönlendirilmiş yazma oturumu yapıldığı belirtilmektedir; yöntem bölümünde ise bu oturumların süresi ve haftalara dağılımı ayrıntılı olarak verilmemiştir.
Dönem başında ve sonunda yazılan 150–300 kelimelik metinler sözcüksel çeşitlilik, sözcük doğruluğu, akademik eşdizimler, alan terimleri, bağlaç kullanımı, tutarlılık ve düzen bakımından incelenmiştir. Sözcüksel çeşitliliği gösteren MTLD ortalaması 73’ten 92’ye, akademik sözcüklerin oranı yüzde 7,5’ten yüzde 12,2’ye ve doğru alan terimi kullanımı bin kelimede 18’den 28’e yükselmiştir. Sözcüksel hata oranı bin kelimede 28’den 16,5’e düşmüş; insan değerlendiricilerin verdiği tutarlılık puanı 6 üzerinden 3,4’ten 4,2’ye çıkmıştır.
Bu değişimlerin tamamı p<0,001 düzeyinde istatistiksel olarak anlamlı bildirilmiş ve birçok ölçütte büyük etki büyüklükleri hesaplanmıştır. Öğrenciler araçların yararlılığına 5 üzerinden 4,4, kullanım kolaylığına 4,3 ve genel memnuniyete 4,3 puan vermiştir. Yapay zekâ önerilerine güven ise 3,9 puanla yararlılık değerlendirmesinin altında kalmıştır.
Bununla birlikte araştırmada kontrol grubu bulunmamaktadır. Öğrenciler normal derslerine devam etmiş, öğretmenlerden destek almış, düzenli yazma çalışması yapmış ve sözcük öğretimi görmüştür. Bu nedenle değişimlerin ne kadarının yapay zekâdan, ne kadarının öğretimden, tekrarlı yazma deneyiminden, öğrencilerin doğal gelişiminden veya ölçüm koşullarından kaynaklandığı ayrılamamaktadır.
Araştırma ayrıca yapay zekâ araçlarının kullanılmadığı bağımsız bir son test veya haftalar sonra gerçekleştirilen kalıcılık ölçümü sunmamaktadır. Son değerlendirmelerde ChatGPT ve Grammarly kullanımına izin verilip verilmediği de açıkça belirtilmemiştir. Dolayısıyla öğrencilerin kendi başlarına daha iyi yazmayı öğrenip öğrenmediği ile yapay zekâ yardımı sayesinde daha iyi metin üretmesi birbirinden ayrılamamaktadır.
Çalışmanın en güvenli sonucu şudur: Öğretmen rehberliği, düzenli yazma uygulaması, sözcük öğretimi, aralıklı tekrar ve yapay zekâ araçlarını birleştiren dönemlik program sırasında öğrencilerin incelenen metin göstergeleri önemli ölçüde iyileşmiştir. Ancak araştırma, bu gelişmelerin yalnızca veya doğrudan yapay zekâ tarafından oluşturulduğunu kanıtlamamaktadır.
Araştırmanın temel sorusu nedir?
Çalışma üç temel soruya cevap aramaktadır:
- Yapay zekâ destekli sözcük araçlarının öğrencilerin sözcük gelişimi ve akademik yazma performansıyla ilişkisi nedir?
- Öğrenciler yapay zekânın sözcük öğrenme ve akademik yazmadaki rolünü nasıl değerlendirmektedir?
- Yapay zekâ araçlarının yabancı dil öğretiminde kullanılmasından hangi uygulama güçlükleri ve etik sorunlar doğmaktadır?
Araştırmanın odağı yalnızca öğrencilerin daha az dilbilgisi hatası yapıp yapmadığı değildir. Çalışmada sözcük çeşitliliği, akademik sözcükler, alan terminolojisi, eşdizimler, metin içindeki bağlantılar ve genel yazı düzeni birlikte incelenmiştir.
Akademik yazmada sözcük bilgisi neden önemlidir?
Bir öğrencinin çok sayıda İngilizce kelimeyi tanıması, bu kelimeleri akademik metinde doğru kullanabildiği anlamına gelmez. Akademik yazma için kelimenin anlamı kadar hangi bağlamda, hangi kelimelerle ve hangi dil düzeyinde kullanıldığı da önemlidir.
Öğrencinin aşağıdaki becerileri birlikte geliştirmesi gerekir:
- Farklı kelimeler kullanarak gereksiz tekrarı azaltmak
- Genel kelimeler yerine konuya uygun akademik ve teknik terimleri seçmek
- Kelimenin isim, fiil, sıfat veya zarf biçimini doğru kullanmak
- Birlikte doğal kullanılan sözcükleri doğru eşleştirmek
- Resmî akademik anlatıma uygun dil düzeyini korumak
- Fikirler arasında açık bağlantılar kurmak
- Paragrafları mantıklı sırayla düzenlemek
ChatGPT ve Grammarly bu alanlarda anlık öneri üretebilir. Ancak öğrencinin yalnızca öneriyi kabul etmesiyle neden doğru olduğunu anlaması aynı değildir. Kalıcı öğrenme için öğrencinin öneriyi değerlendirmesi, kendi anlamıyla karşılaştırması ve yeni kullanımını başka metinlerde bağımsız biçimde tekrarlaması gerekir.
Katılımcılar kimlerdir?
Çalışmaya Suudi Arabistan’daki tek bir üniversiteden 160 lisans öğrencisi katılmıştır. İngilizce bütün üniversite derslerinde öğretim dili olarak kullanılmaktadır.
| Katılımcı özelliği | Değer |
|---|---|
| Toplam öğrenci | 160 |
| Erkek | %56 |
| Kadın | %44 |
| 19–22 yaş | %76 |
| 23 yaş ve üzeri | %24 |
| İşletme öğrencileri | %24 |
| Mühendislik öğrencileri | %36 |
| Bilgisayar bilimi öğrencileri | %40 |
| B1 düzeyi | %18 |
| B2 düzeyi | %58 |
| C1 düzeyi | %24 |
Öğrencilerin yüzde 89’u daha önce en az bir yapay zekâ yazma aracından haberdardır. Ancak yalnızca yüzde 28’i bu araçları daha önce yoğun kullandığını bildirmiştir. Yüzde 17’sinin ücretli aboneliği, yüzde 81’inin gerekli teknik özellikleri karşılayan kişisel bilgisayarı ve yüzde 78’inin kampüs dışında kararlı internet erişimi bulunmaktadır.
Bu bilgiler öğrencilerin dijital olanaklarının aynı olmadığını göstermektedir. Ücretli hesapların daha gelişmiş özelliklere erişip erişmediği veya araç sürümlerinin öğrenciler arasında aynı olup olmadığı açıklanmamıştır.
Öğrenciler nasıl seçilmiştir?
Araştırmacılar farklı İngilizce yeterlik düzeylerinin temsil edilmesi için tabakalı örnekleme kullandıklarını belirtmektedir. Bununla birlikte öğrencilerin gönüllü başvuru yoluyla mı, ders şubelerinin tamamından mı veya başka bir seçim süreciyle mi alındığı ayrıntılı biçimde açıklanmamıştır.
Araştırmada şu üç ders bulunmaktadır:
- ENGL 101 — Birinci Yıl Yazma
- ENGL 102 — Rapor Yazımına Giriş
- ENGL 201 — Teknik Yazma
Sonuç tablosunda B1 düzeyi ENGL 101, B2 düzeyi ENGL 102 ve C1 düzeyi ENGL 201 ile eşleştirilmiştir. Ancak yöntem bölümünde her dersin yalnızca tek bir CEFR düzeyindeki öğrencilerden oluştuğu açıkça gösterilmemiştir. Her alt grubun kesin öğrenci sayısı da sonuç tablosunda verilmemiştir.
Müdahale gerçekte neleri içermektedir?
Araştırma yalnızca öğrencilere ChatGPT veya Grammarly hesabı verip dönem sonunda yazılarını karşılaştırmamıştır. Program çok bileşenli bir öğretim yaklaşımıdır:
- Yapay zekâ araçlarını kullanma eğitimi
- Etik kullanım, veri koruma ve akademik dürüstlük bilgilendirmesi
- Başlangıç yazma yeterliğine göre kişiselleştirilmiş öğrenme planı
- ChatGPT ve Grammarly üzerinden bağlama uygun eş anlamlı önerileri
- Tekrarlanan kelimelerin belirlenmesi
- Alanla ilişkili sözcük çalışmaları
- Oyunlaştırılmış görevler
- Aralıklı tekrar etkinlikleri
- Yönlendirilmiş yazma oturumları
- Bağımsız çalışma
- Öğretmen desteği ve yüz yüze dersler
Bu yapı eğitimsel açıdan güçlü olabilir; fakat araştırma açısından her bileşenin etkisini ayırmayı zorlaştırmaktadır. Öğrencilerin gelişimi yapay zekâdan, daha fazla yazma uygulamasından, öğretmen geri bildiriminden, aralıklı tekrardan veya bunların birleşiminden kaynaklanmış olabilir.
Hangi yapay zekâ sistemleri kullanılmıştır?
Yöntem bölümünde iki araç açıkça adlandırılmıştır:
- ChatGPT
- Grammarly
Ancak çalışmada kullanılan ChatGPT modelinin adı, sürümü, hesap türü, sistem ayarları veya öğrencilere verilen standart istemler açıklanmamıştır. Grammarly’nin hangi sürümünün ve hangi özelliklerinin kullanıldığı da belirtilmemiştir.
Öğrencilerin iki aracı birlikte mi kullandığı, birini seçip seçmediği veya kullanım miktarlarının ne olduğu belirsizdir. Araç kullanımının analitik panolarla izlendiği söylenmesine rağmen oturum sayısı, kabul edilen öneri sayısı, kullanılan süre ve araçlara göre kullanım dağılımı sonuçlarda verilmemiştir.
Bu eksiklik nedeniyle ChatGPT ile Grammarly’nin ayrı etkileri karşılaştırılamaz. Bulgular belirli bir modelin veya ürünün başarısı olarak sunulmamalıdır.
Yazma performansı nasıl ölçülmüştür?
Öğrenciler müdahale öncesinde ve sonrasında 150–300 kelimelik akademik metinler yazmıştır. Metinler otomatik derlem araçlarıyla ve insan değerlendiricilerle incelenmiştir.
Başlıca ölçüm alanları şunlardır:
- Type–Token Ratio
- Measure of Textual Lexical Diversity
- Genel ve akademik kelime listelerinin payı
- Orta ve düşük sıklıktaki kelimeler
- Doğru akademik eşdizimler
- Hatasız cümleciklerin oranı
- Sözcüksel hata oranı
- Uygunsuz dil düzeyi
- Yanlış sözcük türü seçimi
- Doğal olmayan eşdizimler
- Doğru alan terimleri
- Bağlayıcı ifadeler ve geçiş türleri
- İnsan değerlendiricilerin tutarlılık ve düzen puanları
Type–Token Ratio neyi göstermektedir?
Type–Token Ratio, bir metindeki farklı kelime sayısının toplam kelime sayısına oranıdır:
\[ TTR = \frac{Farklı\ kelime\ sayısı}{Toplam\ kelime\ sayısı} \]
Örneğin 200 kelimelik bir metinde 100 farklı kelime bulunması durumunda TTR değeri 0,50 olur. Oranın yükselmesi, metinde daha çeşitli kelimeler kullanıldığını düşündürür.
Ancak TTR metin uzunluğuna duyarlıdır. Metin uzadıkça zorunlu tekrarlar artabileceği için oran düşebilir. Araştırmadaki yazılar 150 ile 300 kelime arasında değişmektedir. Başlangıç ve son yazılarının ortalama uzunlukları verilmediğinden TTR değişiminin ne kadarının sözcük gelişiminden, ne kadarının metin uzunluğundan kaynaklandığı tam olarak değerlendirilememektedir.
MTLD neyi ölçmektedir?
MTLD, sözcüksel çeşitliliği metin uzunluğundan TTR’ye göre daha az etkilenecek biçimde ölçmeyi amaçlayan bir göstergedir. Metin boyunca sözcük çeşitliliğinin belirli bir eşiğin üzerinde ne kadar süre korunabildiğini değerlendirir.
MTLD’nin 73’ten 92’ye çıkması, öğrencilerin son metinlerde daha geniş ve metin boyunca daha sürdürülebilir bir sözcük çeşitliliği kullandığıyla uyumludur. Bununla birlikte yazma görevlerinin konu, tür, süre ve güçlük bakımından eşdeğer olup olmadığı açıklanmadığı için değişimin tamamı öğrenci becerisine bağlanamaz.
Başlangıç ve son yazma görevleri karşılaştırılabilir mi?
Çalışmada metinlerin 150–300 kelime olduğu belirtilmekte, ancak şu bilgiler verilmemektedir:
- Başlangıç ve son görevlerinin tam soru metinleri
- Görevlerin aynı yazı türünde olup olmadığı
- Konuların güçlük bakımından nasıl eşleştirildiği
- Yazma için verilen süre
- Öğrencilerin sözlük veya internet kullanıp kullanamadığı
- Son değerlendirmede ChatGPT ve Grammarly kullanımına izin verilip verilmediği
- Metin uzunluklarının başlangıç ve son aşamadaki ortalamaları
Bu bilgiler ölçümün yorumlanması için kritiktir. Son testte yapay zekâ kullanılmışsa sonuçlar bağımsız öğrenmeyle araç destekli ürün kalitesini birlikte yansıtabilir. Yapay zekâ kapalı bir test uygulanmışsa öğrencilerin aktarım becerisine ilişkin kanıt daha güçlü olurdu. Makale hangi koşulun uygulandığını açıkça belirtmemektedir.
Sözcüksel çeşitlilikte ne değişmiştir?
| Ölçüt | Başlangıç | Sonuç | Etki büyüklüğü |
|---|---|---|---|
| TTR | 0,43 | 0,51 | d = 1,23 |
| MTLD | 73,0 | 92,0 | d = 1,52 |
| Genel ve yüksek sıklıktaki kelimelerin payı | %66,0 | %54,0 | d = −1,41 |
| Akademik kelimelerin payı | %7,5 | %12,2 | d = 1,70 |
| Orta ve düşük sıklıktaki kelimelerin payı | %27,0 | %33,8 | d = 0,90 |
| Bin kelimede doğru akademik eşdizim | 22,0 | 33,0 | d = 1,62 |
Bütün karşılaştırmalar için p<0,001 bildirilmiştir. MTLD yaklaşık yüzde 26, doğru akademik eşdizim kullanımı yüzde 50 artmıştır. Akademik sözcüklerin payı 4,7 yüzde puan yükselmiştir.
Başlangıçta üç sıklık kategorisinin toplamı yüzde 100,5’tir. Bu küçük fark yuvarlamadan kaynaklanabilir. Son ölçümde toplam yüzde 100’dür.
Sözcük doğruluğunda ne değişmiştir?
| Ölçüt | Başlangıç | Sonuç | Etki büyüklüğü |
|---|---|---|---|
| Hatasız cümleciklerin oranı | %74,0 | %83,0 | d = 1,16 |
| Bin kelimede sözcüksel hata | 28,0 | 16,5 | d = −1,39 |
| Uygunsuz dil düzeyi | 7,5 | 3,6 | d = −1,30 |
| Yanlış sözcük türü seçimi | 9,2 | 5,0 | d = −1,16 |
| Doğal olmayan eşdizimler | 11,8 | 6,4 | d = −1,33 |
| Doğru alan terimleri | 18,0 | 28,0 | d = 1,53 |
Sözcüksel hata oranı yaklaşık yüzde 41 azalmış, doğru alan terimi kullanımı yaklaşık yüzde 56 artmıştır. Bunlar yalnızca istatistiksel bakımdan değil, büyüklük bakımından da dikkat çekici değişimlerdir.
Bununla birlikte tartışma bölümünde toplam sözcüksel hataların “yalnızca marjinal” biçimde azaldığı yazılmıştır. Bin kelimede 28’den 16,5’e düşüş ve d=−1,39 değeri marjinal bir değişim olarak nitelendirilemez. Bu ifade sonuç tablosuyla çelişmektedir.
Metin tutarlılığı ve düzeni nasıl değişmiştir?
| Ölçüt | Başlangıç | Sonuç | Etki büyüklüğü |
|---|---|---|---|
| Bin kelimede bağlayıcı ifade | 42,0 | 55,0 | d = 1,24 |
| Benzersiz geçiş türü | 9,0 | 14,0 | d = 1,53 |
| Değerlendirici tutarlılık puanı | 3,4/6 | 4,2/6 | d = 1,06 |
| Değerlendirici düzen puanı | 3,3/6 | 4,4/6 | d = 1,46 |
Bütün değerler için p<0,001 bildirilmiştir. Bağlayıcı ifadeler yaklaşık yüzde 31, farklı geçiş türlerinin sayısı yaklaşık yüzde 56 artmıştır.
Ancak insan değerlendiricilerin sayısı, eğitim süreci, kullandığı değerlendirme rubriği, başlangıç veya son metni okuduğunu bilip bilmediği ve değerlendiriciler arası güvenilirlik katsayısı verilmemiştir. Bu eksiklik, tutarlılık ve düzen puanlarının ne kadar güvenilir olduğunu değerlendirmeyi zorlaştırmaktadır.
Tartışma bölümünde metin düzenine ilişkin hata puanının “3 yüzde puan” iyileştiği belirtilmektedir. Sonuç tablolarında bu ifadeye karşılık gelen bir yüzde ölçütü bulunmamaktadır. Tutarlılık 3,4’ten 4,2’ye, düzen ise 3,3’ten 4,4’e çıkmıştır. Bu nedenle “3 yüzde puan” ifadesinin hangi hesaplamaya dayandığı anlaşılamamaktadır.
İngilizce düzeylerine göre sonuçlar nelerdir?
| Düzey | Ölçüt | Başlangıç | Sonuç | Cohen d |
|---|---|---|---|---|
| B1 / ENGL 101 | TTR | 0,41 | 0,48 | 1,05 |
| B1 / ENGL 101 | MTLD | 68 | 82 | 1,20 |
| B2 / ENGL 102 | TTR | 0,43 | 0,51 | 1,22 |
| B2 / ENGL 102 | MTLD | 73 | 92 | 1,50 |
| C1 / ENGL 201 | TTR | 0,45 | 0,54 | 1,35 |
| C1 / ENGL 201 | MTLD | 78 | 101 | 1,70 |
C1 grubunda sözcüksel çeşitlilik ölçütleri bakımından en büyük artış bildirilmiştir. Ancak tabloda grup başına öğrenci sayıları, standart sapmalar veya gruplar arasındaki farkı sınayan etkileşim testi bulunmamaktadır.
Metinde B1 grubunun hata düzeltmelerinde en büyük azalmayı gösterdiği yazılmıştır. Buna karşılık ilgili Tablo 7 yalnızca TTR ve MTLD sonuçlarını içermekte, hata oranlarını göstermemektedir. Bu iddia sunulan tablodan doğrulanamamaktadır.
Öğrenciler araçları nasıl değerlendirmiştir?
| Değerlendirilen özellik | Ortalama puan |
|---|---|
| Algılanan yararlılık | 4,4/5 |
| Kullanım kolaylığı | 4,3/5 |
| Alanla ilişkililik | 4,3/5 |
| Genel memnuniyet | 4,3/5 |
| Geri bildirimin açıklığı | 4,2/5 |
| Mobil ve bilgisayar arasında süreklilik | 4,2/5 |
| Yapay zekâ önerilerine güven | 3,9/5 |
| Oyunlaştırmanın yararlılığı | 3,8/5 |
Öğrencilerin araçları yararlı bulması, öğrenme etkisinin nesnel kanıtı değildir. Kullanım kolaylığı ve memnuniyet, beceri kazanımından farklı sonuçlardır. Buna karşılık güven puanının yararlılık puanından düşük olması, öğrencilerin yapay zekâ önerilerini tamamen güvenilir görmediğini düşündürebilir.
Ancak anketin kaç maddeden oluştuğu, daha önce doğrulanmış bir ölçek olup olmadığı, iç tutarlılık katsayısı ve soruların tam metni verilmemiştir. Bu nedenle anket sonuçlarının psikometrik niteliği değerlendirilememektedir.
Çalışma gerçekten karma yöntemli midir?
Yöntem bölümünde anketler, yarı yapılandırılmış görüşmeler ve odak grupları kullanıldığı belirtilmektedir. Açık uçlu cevapların tematik olarak kodlandığı ve katılımcı doğrulaması yapıldığı yazılmıştır.
Bununla birlikte sonuç bölümünde:
- Kaç öğrenciyle görüşme yapıldığı
- Kaç odak grubunun gerçekleştirildiği
- Görüşmelerin süresi
- Kodlama çerçevesi
- Kodlayıcı sayısı ve uyumu
- Ortaya çıkan ana temalar
- Katılımcı alıntıları
- Olumsuz veya karşıt vakalar
sunulmamıştır. Nitel verilerden söz edilmesine rağmen bulguların tamamına yakını sayısal ön-son karşılaştırmalar ve Likert ortalamalarından oluşmaktadır. Bu nedenle çalışmanın karma yöntemli yönü yeterince raporlanmamıştır.
Etki büyüklükleri nasıl hesaplanmıştır?
Çalışma Cohen d değerlerini başlangıç ve son ölçümlerin birleştirilmiş standart sapmasıyla hesapladığını belirtmektedir:
\[ SD_{birleşik} = \sqrt{\frac{SD_{ön}^{2}+SD_{son}^{2}}{2}} \]
\[ d = \frac{\overline{X}_{son}-\overline{X}_{ön}}{SD_{birleşik}} \]
- X̄ön: Müdahale öncesi ortalama
- X̄son: Müdahale sonrası ortalama
- SDön: Başlangıç standart sapması
- SDson: Sonuç standart sapması
Bu hesaplama tabloda verilen değerlerle uyumludur. Örneğin MTLD için:
\[ d = \frac{92-73}{\sqrt{(12^2+13^2)/2}} \approx 1{,}52 \]
Ancak veriler aynı öğrencilerden iki kez toplandığı için ölçümler bağımsız değildir. Birleştirilmiş standart sapmaya dayalı d değeri bildirilebilir; fakat öğrencilerin başlangıç ve son puanları arasındaki korelasyonu içermez. Eşleştirilmiş değişime özgü başka bir etki büyüklüğünün hesaplanabilmesi için fark puanlarının standart sapması veya ön-son korelasyonu gerekir. Bu bilgiler verilmemiştir.
İstatistiksel anlamlılık ne kadar yeniden üretilebilir?
Araştırmacılar eşleştirilmiş örneklem t testleri kullandıklarını ve bütün ana sonuçların p<0,001 olduğunu bildirmiştir. Ancak tablolar şu bilgileri içermemektedir:
- t istatistikleri
- Serbestlik dereceleri
- Ortalama değişimlerin güven aralıkları
- Fark puanlarının standart sapmaları
- Eksik gözlem sayıları
- Dağılım varsayımlarının kontrolleri
- Çoklu karşılaştırma düzeltmesi
Bu nedenle ortalama ve standart sapmalardan bağımsız gruplara ilişkin yaklaşık hesaplamalar yapılabilir; fakat bildirilen eşleştirilmiş testler tam olarak yeniden üretilemez.
Kontrol grubunun bulunmaması neden önemlidir?
Bir ön-son çalışmada öğrencilerin zaman içinde geliştiği görülebilir. Ancak bu gelişmenin nedenini belirlemek için karşılaştırılabilir bir kontrol koşulu gerekir.
Mevcut çalışmada aşağıdaki olasılıklar birbirinden ayrılamamaktadır:
- ChatGPT ve Grammarly önerilerinin etkisi
- Öğretmen geri bildiriminin etkisi
- Bir dönem boyunca alınan normal İngilizce dersinin etkisi
- Düzenli akademik yazma uygulamasının etkisi
- Aralıklı tekrar etkinliklerinin etkisi
- Başlangıç testine aşinalığın etkisi
- Öğrencilerin doğal gelişimi
- Başlangıç ve son yazma görevleri arasındaki güçlük farkı
- Son metinde yapay zekâ önerilerinin doğrudan bulunması
Yazarlar da tartışma bölümünde araştırmanın neden-sonuç ilişkisi kurmaya çalışmadığını ve kontrol grubunun bulunmadığını kabul etmiştir. Kontrol grubu kullanılmamasının, kurumun bütün öğrencilerin müdahaleden yararlanmasını istemesinden kaynaklandığı belirtilmiştir.
Bu etik kaygı anlaşılabilir; ancak bekleme listesi kontrolü, gecikmeli müdahale, normal öğretim karşılaştırması veya çapraz tasarım gibi seçenekler bütün öğrencilere daha sonra müdahale sunarken karşılaştırma yapılmasına imkân verebilirdi.
Öğrenciler yapay zekâ olmadan da gelişmiş midir?
Bu soruya mevcut çalışma cevap verememektedir. Gerçek beceri aktarımını değerlendirmek için öğrencilerin:
- Yapay zekâ kullanmadan yeni bir konu hakkında yazması
- Daha önce görmediği alan terimlerini bağlam içinde kullanması
- Yapay zekâ önerilerindeki hataları belirlemesi
- Haftalar veya aylar sonra aynı becerileri koruması
gerekirdi.
Çalışmada gecikmeli son test yapılmamıştır. Bu nedenle kazanımların dönem bittikten sonra devam edip etmediği bilinmemektedir.
Sonuç bölümündeki hangi iddialar doğrudan ölçülmemiştir?
Sonuç bölümünde teknolojinin öğretmen ve öğrencilere önemli ölçüde zaman kazandırdığı, eleştirel düşünmeyi geliştirdiği, üst dil farkındalığını artırdığı, özerkliği güçlendirdiği ve akademik dürüstlüğü desteklediği ileri sürülmektedir.
Ancak çalışmada:
- Öğretmen veya öğrenci zamanına ilişkin süre ölçümü
- Standartlaştırılmış eleştirel düşünme testi
- Üst dil farkındalığı ölçeği
- Öğrenen özerkliği ölçeği
- İntihal veya akademik dürüstlük davranışı
- Yapay zekâ önerisini reddetme doğruluğu
raporlanmamıştır. Bu iddialar çalışmanın doğrudan bulguları değil, uygulamaya ilişkin yorumlarıdır.
Çalışmanın içindeki önemli raporlama sorunları
| Konu | Çalışmada sunulan bilgi | Değerlendirme |
|---|---|---|
| Teslim tarihi | 02/215/2026 | Geçerli bir takvim tarihi değildir. |
| Ölçüm noktaları | Başlangıç, ara ve son ölçüm yapıldığı belirtiliyor. | Ara ölçüm sonuçları sunulmuyor. |
| Sözcük sınavları | Kelime tanıma, cümle tamamlama ve serbest yazma sınavları kullanıldığı belirtiliyor. | Bu sınavların sonuçları verilmemiştir. |
| Nitel veriler | Görüşme, odak grubu ve tematik kodlama bildiriliyor. | Örneklem, tema, kod ve alıntılar sunulmuyor. |
| Alt grup sonuçları | B1’in hata düzeltmelerinde en büyük gelişimi gösterdiği yazılıyor. | İlgili tablo yalnızca TTR ve MTLD içermektedir. |
| Düşük sıklıktaki kelimeler | Tartışmada son metinlerde daha az düşük sıklıklı kelime bulunduğu yazılıyor. | Tablo, oranın %27’den %33,8’e yükseldiğini göstermektedir. |
| Sözcüksel hata azalması | “Yalnızca marjinal” azalma olarak niteleniyor. | 28’den 16,5’e düşüş ve d=−1,39 büyük değişimdir. |
| Düzen puanı | Üç yüzde puanlık gelişimden söz ediliyor. | Tablolarda buna karşılık gelen yüzde ölçütü bulunmamaktadır. |
Türkiye açısından nasıl yorumlanmalıdır?
Suudi Arabistan’daki tek üniversiteden elde edilen sayısal sonuçlar Türkiye’deki öğrencilere doğrudan genellenemez. Bununla birlikte araştırma sorusu Türkiye’deki İngilizce hazırlık okulları, akademik yazma dersleri ve İngilizce öğretim yapan lisans programları için uygulanabilir niteliktedir.
Türkiye’de benzer bir uygulama, öğrencilere yapay zekâyı tamamen yasaklamak veya sınırsız biçimde serbest bırakmak yerine kullanımın hangi öğrenme aşamasında yararlı olduğunu sınayabilir.
Örneğin aşağıdaki üç grup karşılaştırılabilir:
- Öğretmen rehberliği ve yapay zekâ destekli yazma grubu
- Aynı öğretmen süresi ve sözcük çalışmasıyla, fakat yapay zekâ kullanılmayan grup
- Olağan akademik yazma öğretimine devam eden karşılaştırma grubu
Bütün gruplara dönem sonunda aynı, yapay zekâ kapalı yazma görevi uygulanmalıdır. Ardından dört veya sekiz hafta sonra gecikmeli test yapılarak kelime bilgisinin kalıcılığı ölçülebilir.
Türkiye’de daha güçlü bir araştırma nasıl tasarlanabilir?
- Birden fazla üniversite ve farklı akademik alanlar çalışmaya alınmalıdır.
- Öğrenciler mümkünse rastgele veya sınıf düzeyinde kümeli olarak gruplara atanmalıdır.
- Yapay zekâ ve kontrol gruplarında öğretmen süresi, görev sayısı ve geri bildirim miktarı eşit tutulmalıdır.
- ChatGPT model sürümü, Grammarly özellikleri ve kullanılan istemler kaydedilmelidir.
- Ücretsiz ve ücretli hesapların sunduğu özellikler ayrı değerlendirilmelidir.
- Başlangıç ve son yazma görevleri tür, konu, süre ve kelime sınırı bakımından eşleştirilmelidir.
- Son ve gecikmeli testler yapay zekâ kapalı gerçekleştirilmelidir.
- İnsan değerlendiriciler ölçüm zamanını ve öğrencinin grubunu bilmemelidir.
- Değerlendiriciler arası güvenilirlik raporlanmalıdır.
- Kelime çeşitliliğinin yanında argüman kalitesi, kaynak kullanımı ve özgünlük ölçülmelidir.
- Öğrencilerin hatalı yapay zekâ önerilerini belirleme becerisi sınanmalıdır.
- Gerçek araç kullanım kayıtlarıyla öğrenme sonuçları ilişkilendirilmelidir.
- Öğretmen zamanı ve öğrenci çalışma süresi doğrudan ölçülmelidir.
- Ham veriler, kodlama kılavuzu ve analiz kodu paylaşılmalıdır.
Çalışmanın güçlü yönleri nelerdir?
- 160 kişilik görece geniş bir üniversite öğrencisi örneklemi kullanmıştır.
- İşletme, mühendislik ve bilgisayar bilimi alanlarından öğrencileri kapsamıştır.
- Sözcük çeşitliliğini tek bir ölçüte dayandırmamış; TTR ve MTLD’yi birlikte kullanmıştır.
- Genel, akademik ve alanla ilişkili kelimeleri ayrı değerlendirmiştir.
- Eşdizim, dil düzeyi ve sözcük türü hatalarını incelemiştir.
- Cümle düzeyindeki doğruluğun yanında metin tutarlılığını ve düzenini değerlendirmiştir.
- Otomatik ölçümleri insan değerlendirmeleriyle desteklemeye çalışmıştır.
- Etki büyüklüklerini ortalamalar ve standart sapmalarla birlikte vermiştir.
- Farklı İngilizce yeterlik düzeyleri için ayrı sonuçlar sunmuştur.
- Öğrencilerin yararlılık, güven ve kullanım kolaylığı algılarını incelemiştir.
- Dijital erişim eşitsizliklerini raporlamıştır.
- Kontrol grubunun bulunmamasını ve uzun dönem kalıcılığın bilinmediğini kabul etmiştir.
- Yapay zekâ kullanımının öğretmen rehberliğiyle yapılandırılması gerektiğini vurgulamıştır.
Çalışmanın temel sınırlılıkları nelerdir?
- Kontrol veya karşılaştırma grubu bulunmamaktadır.
- Öğrenciler rastgele farklı öğretim koşullarına atanmamıştır.
- Yapay zekâ etkisi öğretmen desteği, aralıklı tekrar ve yazma uygulamasından ayrılamamaktadır.
- Tek üniversite ve tek dönemle sınırlıdır.
- Müdahalenin sekiz oturumunun süresi ve ayrıntılı içeriği açıklanmamıştır.
- ChatGPT modeli, Grammarly sürümü ve araç ayarları belirtilmemiştir.
- Öğrencilerin iki aracı ne ölçüde kullandığı raporlanmamıştır.
- Son yazma değerlendirmesinde yapay zekâ kullanımına izin verilip verilmediği açık değildir.
- Başlangıç ve son yazma görevlerinin karşılaştırılabilirliği gösterilmemiştir.
- Metinlerin ortalama uzunlukları verilmemiştir.
- TTR metin uzunluğundan etkilenebilir.
- İnsan değerlendiricilerin sayısı, körlenmesi ve güvenilirliği belirtilmemiştir.
- Anketin geçerliği ve güvenilirliği raporlanmamıştır.
- Görüşme ve odak grubu sonuçları sunulmamıştır.
- Ara ölçüm verileri raporlanmamıştır.
- Sözcük sınavlarının sonuçları verilmemiştir.
- Eşleştirilmiş t testlerinin t değerleri, serbestlik dereceleri ve güven aralıkları yoktur.
- Çoklu karşılaştırma düzeltmesi raporlanmamıştır.
- Alt grup tablolarında örneklem sayısı ve standart sapmalar bulunmamaktadır.
- Gecikmeli kalıcılık testi yapılmamıştır.
- Yapay zekâ kapalı bağımsız yazma yeterliği ölçülmemiştir.
- Ham veri ve analiz kodu paylaşılmamıştır.
- Etik kurulun adı ve onay numarası belirtilmemiştir.
- Bazı metinsel yorumlar sonuç tablolarıyla çelişmektedir.
Çalışma neyi göstermektedir?
- Çok bileşenli program sırasında öğrencilerin yazılarında sözcüksel çeşitlilik artmıştır.
- Akademik kelimelerin ve doğru alan terimlerinin kullanımı yükselmiştir.
- Sözcüksel hata, uygunsuz dil düzeyi ve doğal olmayan eşdizim oranları düşmüştür.
- Bağlayıcı ifadelerin ve geçiş türlerinin sayısı artmıştır.
- İnsan değerlendiricilerin tutarlılık ve düzen puanları yükselmiştir.
- Öğrenciler araçları genel olarak yararlı ve kolay kullanılır bulmuştur.
- Öğrencilerin yapay zekâ önerilerine güveni, algılanan yararlılıktan daha düşük kalmıştır.
- Dijital cihaz ve internet erişiminin bütün öğrencilerde eşit olmadığı görülmüştür.
Çalışma neyi kanıtlamamaktadır?
- Gelişmelerin yalnızca ChatGPT veya Grammarly tarafından oluşturulduğunu kanıtlamamaktadır.
- ChatGPT ile Grammarly’den hangisinin daha etkili olduğunu göstermemektedir.
- Yapay zekâ destekli öğretimin geleneksel öğretimden üstün olduğunu göstermemektedir.
- Öğrencilerin yapay zekâ olmadan daha iyi yazabildiğini kesinleştirmemektedir.
- Kazanımların dönem sonrasına taşındığını göstermemektedir.
- Öğrencilerin eleştirel düşünmesinin geliştiğini doğrudan ölçmemektedir.
- Akademik dürüstlük ihlallerinin azaldığını göstermemektedir.
- Öğretmen veya öğrenci zamanından ne kadar tasarruf edildiğini ölçmemektedir.
- Yapay zekâ araçlarının bütün İngilizce düzeylerinde aynı biçimde etkili olduğunu kanıtlamamaktadır.
- Sonuçların Türkiye’de aynı büyüklükte ortaya çıkacağını göstermemektedir.
- Ücretli ve ücretsiz yapay zekâ hizmetlerinin eşit eğitim fırsatı sunduğunu göstermemektedir.
Çalışmanın Yöntemi ve Bulguları
Teknik yöntem özeti
| Yöntem bileşeni | Çalışmada uygulanan yaklaşım |
|---|---|
| Araştırma alanı | İngilizcenin yabancı dil olarak öğretimi, akademik yazma ve yapay zekâ destekli sözcük öğrenimi |
| Araştırma türü | Tek gruplu ön-son ölçümlü, karma yöntemli olarak tanımlanan uygulama araştırması |
| Ülke | Suudi Arabistan |
| Kurum | University of Prince Mugrin |
| Katılımcı sayısı | 160 lisans öğrencisi |
| Akademik alanlar | İşletme, mühendislik ve bilgisayar bilimi |
| Dersler | ENGL 101, ENGL 102 ve ENGL 201 |
| İngilizce düzeyleri | B1 %18, B2 %58, C1 %24 |
| Örnekleme | Tabakalı örnekleme olarak tanımlanmıştır. |
| Yapay zekâ araçları | ChatGPT ve Grammarly |
| Uygulama süresi | Bir akademik dönem |
| Yönlendirilmiş oturum | Özette sekiz oturum; ayrıntılı süre belirtilmemiştir. |
| Öğretim bileşenleri | Araç eğitimi, öğretmen desteği, kişiselleştirilmiş plan, oyunlaştırma, aralıklı tekrar ve bağımsız çalışma |
| Yazma görevi | 150–300 kelimelik dönem başı ve dönem sonu akademik metinleri |
| Ölçüm noktaları | Başlangıç, ara ve son; ara sonuçlar raporlanmamıştır. |
| Sözcük çeşitliliği | TTR ve MTLD |
| Sözcük doğruluğu | Hatasız cümlecik, sözcüksel hata, dil düzeyi, sözcük türü ve eşdizim |
| Alan dili | Akademik kelimeler ve doğru alan terimleri |
| Metin düzeyi | Bağlayıcı ifadeler, geçiş türleri, tutarlılık ve düzen |
| İstatistiksel analiz | Eşleştirilmiş örneklem t testleri ve birleştirilmiş standart sapmaya dayalı Cohen d |
| Nitel yöntem | Görüşmeler, odak grupları, açık uçlu cevaplar ve tematik kodlama; sonuçları ayrıntılı sunulmamıştır. |
| Kontrol grubu | Bulunmamaktadır. |
| Rastgele atama | Bulunmamaktadır. |
| Gecikmeli test | Bulunmamaktadır. |
| Yapay zekâ kapalı test | Uygulanıp uygulanmadığı belirtilmemiştir. |
Ana sonuçların düzenli özeti
| Ana sonuç | Başlangıç | Sonuç | İstatistiksel değerlendirme |
|---|---|---|---|
| MTLD | 73,0 ± 12,0 | 92,0 ± 13,0 | d=1,52; p<0,001 |
| Sözcüksel hata / 1000 kelime | 28,0 ± 9,0 | 16,5 ± 7,5 | d=−1,39; p<0,001 |
| Değerlendirici tutarlılık puanı | 3,4 ± 0,7 | 4,2 ± 0,8 | d=1,06; p<0,001 |
| Akademik kelime payı | %7,5 | %12,2 | d=1,70; p<0,001 |
| Doğru akademik eşdizim / 1000 kelime | 22,0 | 33,0 | d=1,62; p<0,001 |
| Doğru alan terimi / 1000 kelime | 18,0 | 28,0 | d=1,53; p<0,001 |
| Değerlendirici düzen puanı | 3,3 ± 0,8 | 4,4 ± 0,7 | d=1,46; p<0,001 |
Sonuçların kanıt düzeyine göre ayrılması
| İddia | Çalışmadaki dayanak | Güvenli yorum |
|---|---|---|
| Öğrencilerin son yazılarında sözcük çeşitliliği daha yüksektir. | TTR ve MTLD ön-son karşılaştırmaları | Doğrudan ölçülen bulgudur. |
| Sözcüksel hata oranı azalmıştır. | Bin kelime başına hata sayımları | Doğrudan ölçülen bulgudur. |
| Metinlerin tutarlılık puanı yükselmiştir. | İnsan değerlendirici puanları | Ölçülmüştür; ancak değerlendirici güvenilirliği raporlanmamıştır. |
| Program öğrenciler tarafından yararlı bulunmuştur. | Likert anketi | Algılanan yararlılığı gösterir; nesnel öğrenme etkisini tek başına göstermez. |
| Yapay zekâ gelişmeye neden olmuştur. | Kontrolsüz ön-son tasarım | Nedensel olarak gösterilmemiştir. |
| Öğrenciler yapay zekâ olmadan daha iyi yazmaktadır. | Yapay zekâ kapalı son test açıklanmamıştır. | Gösterilmemiştir. |
| Eleştirel düşünme ve akademik dürüstlük gelişmiştir. | Bu sonuçlara özgü ölçüm bulunmamaktadır. | Çalışmanın doğrudan kanıtı değildir. |
Bilimsel olarak en güvenli sonuç
Bir akademik dönem boyunca ChatGPT ve Grammarly’yi öğretmen yönlendirmesi, sözcük öğretimi, düzenli yazma uygulaması, oyunlaştırma ve aralıklı tekrarla birlikte kullanan 160 öğrencinin son metinlerinde sözcük çeşitliliği, doğruluk ve metin düzeni göstergeleri başlangıca göre belirgin biçimde iyileşmiştir.
Kontrol grubu ve yapay zekâ kapalı bağımsız son test bulunmadığı için bu kazanımların ne kadarının yapay zekâya ait olduğu ve öğrencilerin araç olmadan aynı gelişimi koruyup korumadığı belirlenememektedir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Academic Writing Development Among EFL College Students: Does Artificial Intelligence Make Any Difference?
Yazarlar ve sıraları:
- Ahmed T. M. Braima
- Asad F. Shafi
- Jamal Mohammed Hussien
Eş birinci yazarlık veya eş katkı: Belirtilmemiştir.
Sorumlu yazar: Ahmed T. M. Braima
Kurumsal bağlantılar:
- Ahmed T. M. Braima — English Department, University of Prince Mugrin, Medine, Suudi Arabistan
- Asad F. Shafi — English Department, University of Prince Mugrin, Medine, Suudi Arabistan
- Jamal Mohammed Hussien — ICT Department, University of Prince Mugrin, Medine, Suudi Arabistan
Yazar kimlikleri:
- Ahmed T. M. Braima — ORCID: 0009-0008-7303-6027
- Asad F. Shafi — ORCID: 0009-0009-9277-8330
- Jamal Mohammed Hussien — ORCID: 0000-0002-9015-2694
Dergi: Arab World English Journal
Cilt ve sayı: 17(2)
Sayfa aralığı: 3–18
Yayın tarihi: 15 Haziran 2026
Resmî çalışma bağlantısı:Arab World English Journal makale sayfası
Özgün yayınevi: Arab World English Journal
ISSN: 2229-9327
Kaynak türü: Tek gruplu ön-son ölçümlü, karma yöntemli olarak tanımlanan eğitim araştırması
Hakemlik durumu: Hakemli dergi makalesidir. Arab World English Journal, araştırma makaleleri için editör ön incelemesi ve en az iki anonim değerlendiricinin yer aldığı çift kör hakemlik uyguladığını bildirmektedir.
Teslim tarihi: Makalede ve derginin resmî sayfasında “02/215/2026” yazmaktadır. Geçerli bir tarih olmadığı için doğru teslim günü belirlenememektedir.
Kabul tarihi: 17 Nisan 2026
Finansman: Araştırmanın özel bir finansman almadığı bildirilmiştir.
Teşekkür: University of Prince Mugrin bünyesindeki English Department, ICT Department ve Research Initiatives Program’a teşekkür edilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını açıklamıştır.
Etik açıklama: Katılımcılardan bilgilendirilmiş onam alındığı, araştırmadan çekilme hakkı tanındığı ve verilerin anonim, şifreli ve güvenli biçimde saklandığı belirtilmiştir. Etik kurulun adı, onay tarihi ve karar numarası verilmemiştir.
Veri ve kod erişimi: Ham öğrenci verilerinin, değerlendirme kodlarının veya istatistiksel analiz kodunun paylaşımına ilişkin bir erişim açıklaması bulunmamaktadır.
Yapay zekâ kullanım açıklaması: Yazarlar makalenin hazırlanmasında yalnızca okunabilirlik ve dil düzenlemesi için Grammarly kullandıklarını, metni kendilerinin gözden geçirdiğini ve içerikten bütünüyle sorumlu olduklarını bildirmiştir.
Temel yöntem uyarısı: Uygulama; yapay zekâ araçlarını, öğretmen rehberliğini, kişiselleştirilmiş öğretimi, oyunlaştırmayı, aralıklı tekrarı ve düzenli yazma uygulamasını birlikte içermektedir. Kontrol grubu olmadığı için yapay zekânın bağımsız katkısı hesaplanamamaktadır.
Temel ölçüm uyarısı: Son yazma görevlerinin yapay zekâ kapalı yürütülüp yürütülmediği açıklanmamıştır. Bu nedenle araç destekli metin kalitesi ile öğrencinin bağımsız yazma yeterliği ayrılamamaktadır.
Temel istatistik uyarısı: Cohen d değerleri başlangıç ve son standart sapmalarının birleştirilmesiyle hesaplanmıştır. Eşleştirilmiş puanların korelasyonu, t istatistikleri, serbestlik dereceleri ve güven aralıkları raporlanmadığından analiz tam olarak yeniden üretilememektedir.
Temel raporlama uyarısı: Ara ölçümler, sözcük sınavları, görüşmeler ve odak grupları yöntem bölümünde bulunmasına rağmen bunların ayrıntılı sonuçları sunulmamıştır. İnsan değerlendiricilerin sayısı ve puanlama güvenilirliği de açıklanmamıştır.
Bu Türkçe değerlendirme çalışmanın başlık sayfası, özeti, kuramsal çerçevesi, katılımcı tablosu, araştırma araçları, uygulama süreci, yedi sonuç tablosu, tartışması, sınırlılıkları, sonuç bölümü, etik ve yapay zekâ açıklamaları ile kaynakçası incelenerek hazırlanmıştır. Bilimsel bulgulara dış kaynaklardan yeni sonuç eklenmemiştir. Dış kaynaklar yalnızca makalenin resmî kaydını, kurum adını, DOI bilgisini, yayın tarihini ve derginin hakemlik sürecini doğrulamak için kullanılmıştır.
Araştırmanın en değerli yönü, yapay zekâ destekli yazmayı yalnızca dilbilgisi hataları üzerinden değerlendirmemesi; sözcük çeşitliliği, akademik eşdizimler, alan terminolojisi ve metin düzeni gibi daha geniş sonuçlara bakmasıdır. En önemli sınırlılığı ise görülen büyük ön-son farkların yapay zekâya özgü bir etkiden kaynaklandığını gösterecek karşılaştırmalı tasarıma sahip olmamasıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir