

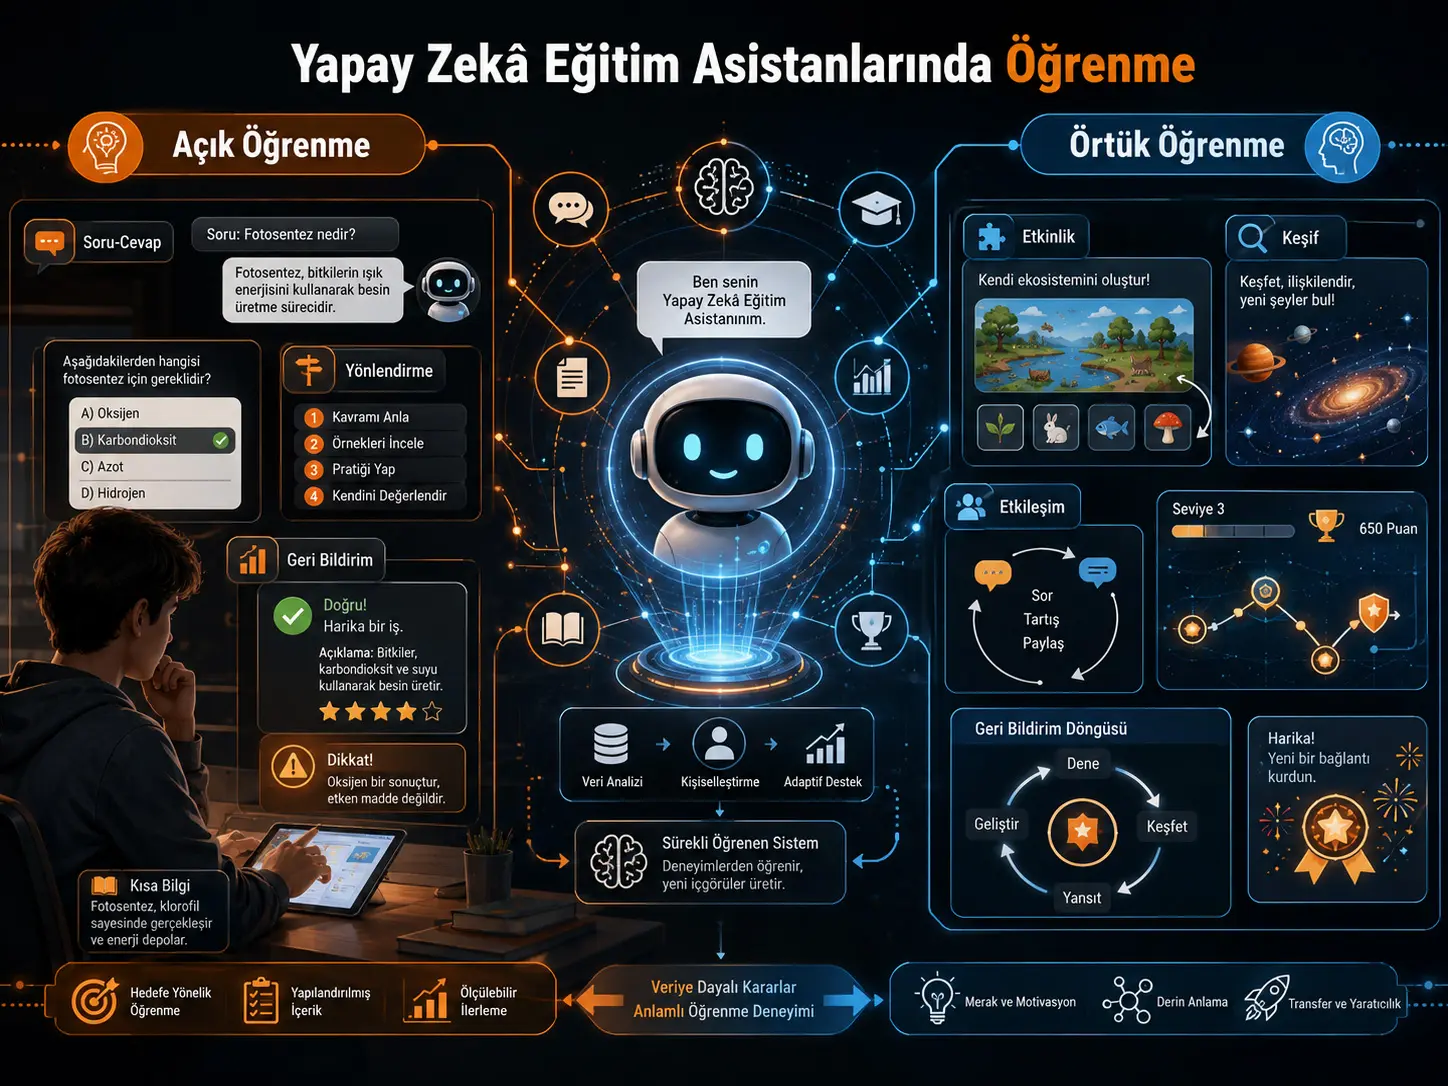
Yapay zekâ destekli eğitim asistanları yalnızca öğrenciye bir sorunun cevabını veren sistemler değildir. Bazıları doğrudan açıklama, yönlendirme, uyarı veya geri bildirim sağlayarak öğrenmeyi bilinçli biçimde desteklerken bazıları kullanıcının deneyerek, soru sorarak, sistem çıktısını gözlemleyerek veya bir etkinlik gerçekleştirerek farkında olmadan bilgi ve beceri edinmesine aracılık eder. Bu sistematik derleme, 2000–2024 arasında yayımlanan 38 çalışmayı inceleyerek AI eğitim asistanlarındaki bu iki öğrenme biçimini açık öğrenme ve örtük öğrenme olarak ortak bir taksonomi altında sınıflandırmaktadır.
Derlemedeki 38 çalışmanın 34'ü bütün değişkenler açısından ayrıntılı veri çıkarımına alınmıştır; kalan dört çalışma yalnız araştırmanın motivasyon örneğinde kullanılmıştır. Tam çıkarım yapılan 34 çalışmanın 27'si baskın olarak açık öğrenme, 7'si örtük öğrenme mekanizmalarını destekleyen sistemler olarak sınıflandırılmıştır. Bu dağılım sırasıyla yaklaşık %79 ve %21'e karşılık gelir. Buradaki yüzdeler AI sistemlerinin öğrenme başarısı veya eğitimdeki etki büyüklüğü değildir; sistematik derlemede incelenen sistemlerin hangi öğrenme mekanizmasına sınıflandırıldığını gösteren çalışma dağılımıdır.
Açık öğrenme için araştırmacılar 11 etkileşim özelliği belirlemiştir: soru sorma, evet/hayır soruları, çoktan seçmeli sorular, soruları yanıtlama, yönlendirme, uyarı mesajları, görev üretme veya çözme, öneriler, bildirimler, geri bildirim ve geri bildirimi düzenleme. Örtük öğrenmede ise dört temel özellik belirlenmiştir: soru sorma, soruları yanıtlama, etkinlik gerçekleştirme ve geri bildirim. Aynı yüzeysel etkileşim, örneğin “geri bildirim”, kullanıcının bilinçli öğrenme amacı taşıyıp taşımamasına ve çalışmadaki işlevine göre iki kategoride de bulunabilmektedir.
Etkileşim modalitelerinde yazılı iletişim en yaygın biçimdir. Araştırmacılar 25 çalışmada yazılı, 19'unda görsel, 7'sinde eylem tabanlı ve 5'inde konuşmaya dayalı etkileşim belirlemiştir. Bir çalışma birden fazla modalite içerebildiği için bunlar birbirini dışlayan gruplar değildir. Toplam 56 modalite oluşumu üzerinden normalize edilen dağılım yazılı etkileşim için %45, görselleştirme için %34, eylem için %12 ve konuşma için %9'dur.
Derleme aynı zamanda önemli bir güncellik sınırını ortaya koymaktadır. İncelenen 38 çalışmanın yalnız dördü LLM veya üretken yapay zekâ kullanmaktadır. Dolayısıyla taksonomi, günümüzde hızla yaygınlaşan LLM tabanlı eğitim asistanlarını kısmen kapsasa da kanıt tabanının büyük bölümü kural tabanlı sistemler, klasik makine öğrenmesi, akıllı öğretim sistemleri, sohbet botları ve daha erken dönem AI araçlarından oluşmaktadır.
| Temel bulgu | Kaynakta bildirilen değer | Doğru yorum |
|---|---|---|
| Sistematik derlemeye dahil edilen çalışmalar | 38 | 2000–2024 dönemindeki dahil edilmiş çalışmaların toplamı |
| Tam veri çıkarımı yapılan çalışmalar | 34 | Taksonomi ve ayrıntılı uygulama analizinin temel örneklemi |
| Açık öğrenme | 27 çalışma, yaklaşık %79 | 34 tam çıkarımlı çalışma içindeki baskın öğrenme sınıflandırması |
| Örtük öğrenme | 7 çalışma, yaklaşık %21 | 34 tam çıkarımlı çalışma içindeki baskın öğrenme sınıflandırması |
| Açık öğrenme özellikleri | 11 | Kullanıcının bilinçli olarak öğrenme amacıyla etkileşime girdiği mekanizmalar |
| Örtük öğrenme özellikleri | 4 | Etkinlik ve etkileşim sırasında dolaylı öğrenmeyi destekleyen mekanizmalar |
| LLM/GenAI içeren çalışmalar | 4 / 38 | Taksonominin büyük bölümünün LLM yaygınlaşmasından önceki sistemlere dayandığını gösterir |
Verianla Live: Tam veri çıkarımındaki açık ve örtük öğrenme dağılımı
Yüzdelerin paydası 38 değil, ayrıntılı veri çıkarımına alınan 34 çalışmadır. Bu grafik sistemlerin eğitimdeki başarı oranını değil, çalışmaların baskın öğrenme mekanizmasına göre sınıflandırılmasını gösterir.
| Öğrenme türü | Çalışma sayısı | Pay (%) |
|---|---|---|
| Açık öğrenme | 27 | 79 |
| Örtük öğrenme | 7 | 21 |
Açık öğrenme ile örtük öğrenme arasındaki temel fark nedir?
Çalışmadaki temel ayrım, kullanıcının öğrenme sürecindeki bilinçli niyetidir. Açık öğrenmede kullanıcı açıklama, yönerge, soru, geri bildirim veya eğitim görevi yoluyla doğrudan öğrenmeye yönlendirilir. Örtük öğrenmede ise bilgi veya beceri, kullanıcının bir etkinlik yapması, AI ile konuşması, bir çıktıyı gözlemlemesi veya deneme–yanılma yoluyla etkileşimde bulunması sırasında daha dolaylı biçimde edinilir.
Araştırmacılar bu ayrımı yalnız arayüz biçimine göre yapmamıştır. Örneğin “soru sorma” veya “geri bildirim” hem açık hem örtük öğrenme içinde görülebilir. Sınıflandırmayı belirleyen unsur, ilgili çalışmada etkileşimin hangi işlevi gördüğüdür. Kullanıcı bilinçli biçimde bilgi istemek için soru soruyorsa bu açık öğrenmeye; doğal bir etkileşim sırasında farkında olmadan beceri geliştiriyorsa örtük öğrenmeye sınıflandırılabilir.
Açık öğrenmede belirlenen 11 mekanizma
| Açık öğrenme mekanizması | Derlemedeki işlevi |
|---|---|
| Soru sorma | Öğrencinin AI sisteminden doğrudan bilgi veya açıklama istemesi |
| Evet / hayır soruları | Özellikle erken yaş veya düşük bilişsel yük gerektiren etkileşimlerde yapılandırılmış cevap verme |
| Çoktan seçmeli sorular | Öğrenciyi sınırlı seçenekler arasında değerlendirme yapmaya yöneltme |
| Soruları yanıtlama | Quiz, kelime bilgisi, dil bilgisi veya ders içeriği üzerinden yapılandırılmış aktif katılım |
| Yönlendirme | Özellikle acemi kullanıcılara adım adım görev desteği sağlama |
| Uyarı mesajları | Hatanın gerçekleştiğini gerçek zamanlı olarak kullanıcıya bildirme |
| Görev üretme / görev çözme | Kodlama, devre, okuma veya görsel etkinlik gibi alanlarda yapılandırılmış uygulama |
| Öneri | İpucu, içerik, fikir veya ilgili kaynak sunarak öğrenme sürecini yönlendirme |
| Bildirim / alerting | Örneğin yaklaşan teslim tarihleri gibi önemli olayları hatırlatma |
| Geri bildirim | Başarı, hata veya ilerleme konusunda dinamik bilgi sağlama |
| Geri bildirimi düzenleme | Kullanıcının aldığı geri bildirim doğrultusunda çalışmasını yeniden düzenlemesine olanak verme |
Derleme geri bildirimi özellikle merkezi bir mekanizma olarak ele almaktadır. Programlama eğitiminde sözdizimi veya çalışma zamanı hataları, mühendislikte problem çözme adımlarının doğruluğu, dil eğitiminde gramer hataları ve tasarım çalışmalarında düşük kaliteli eskizin geliştirilmesi gibi çok farklı kullanım alanlarında geri bildirim görülmektedir.
Bununla birlikte araştırmacılar her açık öğrenme özelliğini otomatik olarak olumlu kabul etmemektedir. Örneğin adım adım yönlendirmenin acemi kullanıcıların hata yapmasını azaltabileceğini fakat aşırı yapılandırılmış destek durumunda bağımsız akıl yürütmeye bağımlılık riski oluşturabileceğini tartışmaktadır. Benzer şekilde yalnız “hata yaptın” mesajı vermek, hatanın nedenini açıklamıyorsa derin kavramsal öğrenmeye yetmeyebilir.
Örtük öğrenmede belirlenen dört mekanizma
| Örtük öğrenme mekanizması | Derlemedeki işlevi |
|---|---|
| Soru sorma | Doğal diyalog sırasında kullanıcının farkında olmadan bilgi veya beceri geliştirmesi |
| Soruları yanıtlama | Konuşma veya ortak problem çözme sırasında dolaylı beceri kazanımı |
| Etkinlik gerçekleştirme | Bir sistemi kullanarak, deney yaparak veya model eğiterek kavramları uygulama içinde öğrenme |
| Geri bildirim | AI çıktısının sonucu üzerinden davranışını değiştirerek öğrenme |
Etkinlik gerçekleştirme özellikle AI eğitimi alanında öne çıkmıştır. Öğrencilerin görsel programlama ortamlarında algoritmalarla çalışması, kod yazmadan makine öğrenmesi sınıflandırmasını denemesi veya çocukların bir konuşma ajanına hayvanlar hakkında bilgi öğretip sonrasında sistemin verdiği cevapları gözlemlemesi gibi örnekler bu gruba alınmıştır.
İncelenen literatür zaman içinde nasıl değişmiş?
Derleme, 2000–2024 döneminde belirgin bir tarihsel değişim gözlemlemektedir. Erken dönem çalışmaların çoğu programlama, okuryazarlık ve yapılandırılmış öğretim bağlamlarında açık öğrenme özelliklerine odaklanmıştır. 2019–2020 civarında ses tabanlı sistemler ve etkinlik yoluyla öğrenme örnekleriyle örtük öğrenme daha görünür hâle gelmiştir.
2021–2024 döneminde ise LLM ve üretken yapay zekâ kullanan sistemler görülmeye başlamıştır. Araştırmacılar bu dönemde açık ve örtük öğrenme arasındaki sınırların daha az keskinleştiğini; aynı sistemin hem doğrudan açıklama ve geri bildirim hem de keşfetme ve deneyimleme yoluyla öğrenmeyi destekleyebildiğini belirtmektedir.
Bununla birlikte bu tarihsel yorumun önemli bir sınırı vardır: sistematik derlemede yalnız dört LLM/GenAI çalışması bulunmaktadır. Bu nedenle LLM çağındaki öğrenme mekanizmalarının yaygınlığı veya etkinliği hakkında güçlü nicel sonuç üretmek mümkün değildir.
AI eğitim asistanları hangi biçimlerde uygulanmış?
Çalışma uygulama yaklaşımlarını dört ana grupta toplar:
- Konuşmaya dayalı AI: chatbot veya conversational agent gibi kullanıcıyla doğal dil üzerinden etkileşim kuran sistemler.
- AI sistemleri: etkileşimli sistemler, akıllı öğretim sistemleri, eğitim platformları ve öneri sistemleri.
- AI assistance: öğrencinin veya tasarımcının görevini kolaylaştıran yardımcı sistemler.
- AI araçları: programlama, devre, görselleştirme, AI öğretimi veya tasarım gibi belirli görevleri destekleyen araçlar.
Verianla Live: Sistematik derlemenin çalışma seçim süreci
PRISMA akışı ilk aramadan nihai 38 çalışmaya nasıl ulaşıldığını gösterir. 38 çalışmanın dört tanesi yalnız motivasyon örneğinde kullanılmış, 34 çalışma tam veri çıkarımına alınmıştır.
| Aşama | Kayıt / çalışma sayısı | Açıklama |
|---|---|---|
| İlk veri tabanı kayıtları | 16335 | Google Scholar ve manuel ACM, IEEE, MDPI, Springer ve Taylor & Francis aramaları |
| Tekrar kayıtlar çıkarıldı | 5685 | Tarama öncesinde kaldırılan mükerrer kayıtlar |
| Tarih filtreleriyle çıkarıldı | 2500 | Tarama öncesindeki ek filtreleme |
| Başlık taramasına kalan kayıtlar | 8150 | Başlık düzeyinde incelenen kayıtlar |
| Başlık aşamasında çıkarıldı | 8030 | 120 veri tabanı kaydı sonraki aşamaya kaldı |
| Snowballing ile eklenen kayıtlar | 11 | İleri ve geri atıf taraması |
| Tam metin için aranan raporlar | 131 | Bütün raporlar elde edildi |
| Özet ve sonuç taramasında çıkarıldı | 73 | 58 çalışma tam metin uygunluk değerlendirmesine kaldı |
| Tam metinde çıkarıldı | 20 | 7 ilgisiz, 5 AI öğrenme tekniği sunmayan, 6 robotik odaklı, 2 İngilizce olmayan çalışma |
| Nihai sistematik derleme | 38 | 34 tam veri çıkarımı + 4 yalnız motivasyon örneğinde kullanılan çalışma |
Bilgi nasıl depolanıyor ve güncelleniyor?
İncelenen sistemlerin bilgi mimarileri oldukça heterojendir. Bazıları sabit veya dinamik veritabanları, bazıları bilgi tabanları, ontolojiler veya veri setleri kullanırken birçok erken dönem çalışma bilgi deposunun veya güncelleme mekanizmasının ayrıntılarını raporlamamıştır.
Örneğin bazı sohbet botları kullanıcı girdisini bir diyalog yöneticisi aracılığıyla bilgi tabanındaki içerikle eşleştirirken; öneri sistemleri öğrenci, yükseköğretim ve iş bilgilerini ontolojiler üzerinden temsil edebilmektedir. Daha yeni sistemlerde dinamik kullanıcı etkileşimleri kaydedilmekte veya LLM tabanlı üretim, yapılandırılmış bilgi kaynaklarıyla bir arada kullanılmaktadır.
Yazarların araştırma açıklarından biri tam olarak bu noktadır: çok sayıda çalışma bilgi tabanının statik mi dinamik mi olduğunu veya güncelleme stratejisinin nasıl işlediğini yeterince açıklamamaktadır.
Hangi algoritmalar kullanılmış?
Derlemede tek bir baskın algoritma bulunmamaktadır. İncelenen sistemler doğal dil işleme, makine öğrenmesi, derin sinir ağları, karar ağaçları, öneri algoritmaları, bağlamsal bandit yöntemleri, görüntü tanıma, kümeleme, bilgi grafikleri ve daha yeni dönemde LLM/GenAI bileşenleri kullanmıştır.
Örnekler arasında Dialogflow ve Rasa tabanlı konuşma sistemleri, J48 karar ağacı kullanan eğitim platformu, cooperative contextual bandit kullanan tasarım yardımcısı, görüntü işleme ve derin öğrenmeye dayanan eskiz dönüştürme sistemi ve GPT/ChatGPT veya OpenAI API'lerini kullanan 2024 dönemindeki eğitim/tasarım sistemleri bulunmaktadır.
Dolayısıyla çalışma “eğitimde en iyi algoritma şudur” sonucuna ulaşmamaktadır. Aynı öğrenme mekanizması birbirinden oldukça farklı teknik mimarilerle gerçekleştirilebilmektedir.
Kullanıcılar AI ile en çok nasıl etkileşiyor?
Yazılı etkileşim açık ara en yaygın modalitedir. Ancak yüzde değerleri çalışma sayısının doğrudan yüzdesi değildir; bir araştırma birden fazla modaliteye sahip olabildiği için toplam etkileşim oluşumları üzerinden normalize edilmiştir.
Kaynak Tablo 6'da sütun “Number of Papers” biçiminde adlandırılmış olmasına rağmen hücreler %45, %9, %12 ve %34 şeklinde yüzdeler vermektedir. Aynı bölümün açıklama metni ise gerçek çalışma sayılarını 25, 5, 7 ve 19 olarak bildirir. Bu nedenle Verianla tablosunda her iki bilgi ayrı sütunlarda tutulmuştur.
LLM'ler eğitim asistanlarını nasıl değiştiriyor?
Derlemeye göre LLM ve üretken yapay zekâ, sabit kural ve sınırlı cevap akışlarına dayanan eski eğitim sistemlerinden daha esnek, bağlama duyarlı ve konuşmaya açık sistemlere geçiş olanağı sağlıyor. İncelenen yeni sistemlerde LLM'ler kullanıcı sorularına dinamik cevap verme, açıklama üretme, tasarım önerisi sunma ve farklı modaliteler arasında etkileşim kurma amacıyla kullanılmıştır.
Yazarlar bu esnekliğin açık öğrenmede kişiselleştirilmiş açıklama, yönlendirilmiş soru ve adaptif geri bildirimi; örtük öğrenmede ise deneyerek, soru biçimini değiştirerek ve sistem çıktısını gözlemleyerek öğrenmeyi destekleyebileceğini savunmaktadır.
Ancak çalışma, LLM tabanlı eğitim asistanlarının geleneksel yöntemlerden genel olarak daha etkili olduğunu gösteren bir meta-analiz yapmamaktadır. Üstelik yalnız dört dahil edilmiş araştırma LLM/GenAI kullanmıştır. Bu nedenle LLM bölümündeki birçok gelecek yönü, mevcut derlemenin güçlü karşılaştırmalı etki kanıtından çok gelişmekte olan araştırma alanına ilişkin sentez ve öneridir.
LLM tabanlı eğitimde temel risk ne?
Kaynak çalışma LLM'lerin esnekliğinin yeni bir değerlendirme problemi oluşturduğunu vurgulamaktadır. Klasik sistemlerde doğruluk, görev tamamlama veya kullanılabilirlik gibi ölçüler yeterli görülebilirken üretken sistemlerde yanıtın gerçekliği ve güvenilirliği ayrıca değerlendirilmelidir.
Yazarlar özellikle halüsinasyon riskine dikkat çeker. Yanlış bir AI cevabının eleştirel değerlendirme yapılmadan kabul edilmesi öğrenenleri yanıltabilir; bu risk mahremiyet, güvenlik ve sağlık gibi yanlış yönlendirmenin ciddi sonuçlar yaratabileceği alanlarda daha kritik olabilir. Bu nedenle LLM tabanlı eğitim asistanları için koruyucu mekanizmalar ve güvenilir bilgiye dayalı doğrulama önerilmektedir.
Çalışmanın desteklediği sonuçlar
- İncelenen AI eğitim asistanlarında açık öğrenme mekanizmaları örtük öğrenmeden daha sık temsil edilmektedir.
- 34 tam çıkarımlı çalışmanın 27'si açık, 7'si örtük öğrenme ağırlıklı olarak sınıflandırılmıştır.
- Açık öğrenme için 11, örtük öğrenme için dört etkileşim mekanizmasından oluşan bir taksonomi oluşturulmuştur.
- Aynı etkileşim özelliği, işlevine bağlı olarak açık veya örtük öğrenmede farklı roller üstlenebilir.
- Yazılı etkileşim, incelenen sistemlerde en sık görülen modalitedir.
- Konuşma temelli etkileşim incelenen literatürde görece az temsil edilmektedir.
- Bilgi depolama ve güncelleme yöntemleri birçok çalışmada eksik raporlanmaktadır.
- Değerlendirme yaklaşımları çalışma tasarımı, örneklem, süre ve ölçüt açısından oldukça heterojendir.
- LLM/GenAI sistemleri incelenen literatürün yalnız küçük bir bölümünü oluşturduğu için yeni nesil eğitim asistanları için ek sistematik araştırmaya ihtiyaç vardır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- %79 değeri AI eğitim asistanlarının %79 oranında etkili olduğu anlamına gelmez.
- Açık öğrenmenin örtük öğrenmeden pedagojik olarak daha başarılı olduğu kanıtlanmamıştır.
- Yazılı etkileşimin sesli veya görsel etkileşimden daha etkili olduğu gösterilmemiştir; yalnız daha sık kullanıldığı saptanmıştır.
- LLM tabanlı eğitim asistanlarının kural tabanlı veya klasik makine öğrenmesi sistemlerinden genel olarak üstün olduğu kanıtlanmamıştır.
- Çalışma ortak etki büyüklüğü hesaplayan bir meta-analiz değildir.
- 38 çalışmanın tamamı aynı kalite düzeyinde değildir ve resmi çalışma düzeyi risk-of-bias değerlendirmesi yapılmamıştır.
- Kısa süreli kullanılabilirlik veya katılım sonuçları uzun dönem öğrenme kazanımı olarak kabul edilemez.
- Önerilen taksonominin bütün kültürler, eğitim seviyeleri, diller ve gelecekteki AI mimarileri için eksiksiz olduğu gösterilmemiştir.
Türkiye açısından ne ifade ediyor?
Bu sistematik derleme Türkiye'ye özgü bir öğrenci popülasyonunu veya Türkçe eğitim asistanlarını ayrı bir analiz grubu olarak değerlendirmemektedir. Bu nedenle %79–%21 dağılımı ya da modalite yüzdeleri Türkiye'deki okulların, üniversitelerin veya eğitim teknolojilerinin doğrudan profili olarak yorumlanamaz.
Bununla birlikte çalışma, Türkiye'de geliştirilecek bir AI eğitim asistanının yalnız “hangi model kullanılacak?” sorusuyla tasarlanmaması gerektiğine işaret eden yararlı bir çerçeve sunmaktadır. Sistemin öğrenmeyi doğrudan mı dolaylı mı destekleyeceği, hangi geri bildirim biçimlerini kullanacağı, bilginin nasıl güncelleneceği, yazı–görsel–ses–eylem modalitelerinin nasıl birleştirileceği ve öğrenme kazanımının uzun dönemli olarak nasıl doğrulanacağı ayrı tasarım kararlarıdır. Bunlar kaynak çalışmadan türeyen tasarım boyutlarıdır; Türkiye'de ayrıca yerel deneysel doğrulama gerektirir.
Çalışmanın Yöntemi ve Bulguları
Sistematik derleme nasıl yürütüldü?
Çalışma PRISMA 2020 raporlama çerçevesini ve yazılım mühendisliği literatüründe kullanılan snowballing yöntemlerini esas almıştır. İlk aramalar Haziran–Eylül 2022 arasında yürütülmüş, Kasım 2023'te güncellenmiş ve LLM tabanlı eğitim asistanlarındaki gelişmeleri yakalamak amacıyla Eylül–Aralık 2024 arasında ek bir arama yapılmıştır.
Aramalar Google Scholar, ACM Digital Library, IEEE Xplore, MDPI, Springer ve Taylor & Francis kaynaklarında gerçekleştirilmiştir. Araştırmacılar otomatik arama, manuel arama ve ileri/geri snowballing yöntemlerini birlikte kullanmıştır.
İlk taramada toplam 16.335 kayıt belirlenmiştir:
| Kaynak | İlk belirlenen kayıt |
|---|---|
| Google Scholar — otomatik | 15900 |
| ACM Digital Library — manuel | 180 |
| IEEE Xplore — manuel | 120 |
| MDPI — manuel | 45 |
| Springer — manuel | 60 |
| Taylor & Francis — manuel | 30 |
| Toplam | 16335 |
5685 tekrar kayıt ve tarih filtresiyle 2500 kayıt çıkarıldıktan sonra 8150 kayıt başlık taramasına kalmıştır. Başlık aşamasında 8030 kayıt çıkarılmıştır. Kalan 120 kayda snowballing yoluyla 11 kayıt eklenerek 131 rapor tam metin için aranmış, bütün raporlar elde edilmiştir. Özet ve sonuç incelemesinden sonra 73 çalışma çıkarılmış; 58 tam metin uygunluk değerlendirmesine alınmış ve bunlardan 20'si dışlandıktan sonra 38 çalışma nihai derlemeye dahil edilmiştir.
20 tam metin neden dışlandı?
| Dışlama nedeni | Çalışma sayısı |
|---|---|
| AI destekli öğrenme mekanizmalarıyla ilgili değil | 7 |
| AI öğrenme tekniği sunmuyor | 5 |
| Derleme kapsamı dışında kalan robotik odaklı çalışma | 6 |
| İngilizce değil | 2 |
| Toplam | 20 |
38 çalışmanın neden yalnız 34'ü tam analiz edildi?
Araştırmacılar 38 dahil edilmiş çalışmanın 34'ü için yayın yılı, alan, öğrenme türü, etkileşim mekanizması, uygulama yaklaşımı, bilgi temsili, kullanıcı grubu, algoritma, etkileşim modalitesi, değerlendirme yaklaşımı, veri toplama yöntemi, katılımcı sayısı ve ölçütler gibi 15 değişkeni tam olarak çıkarmıştır.
Kalan dört çalışma yalnız Bölüm 3'teki motivasyon örneğini desteklemek amacıyla kullanılmış ve tam veri çıkarımına dahil edilmemiştir. Dolayısıyla açık/örtük öğrenme dağılımında kullanılan 27 ve 7 çalışma toplamının 34 olması yöntem bölümüyle tutarlıdır.
Bu ayrım özellikle özetin “38 çalışma” ifadesi ile “%79 / %21” sonuçlarının aynı cümlede görülmesi nedeniyle önemlidir. Yüzdeler, aritmetik olarak 34 tam çıkarımlı çalışmayı temel almaktadır:
\[ \frac{27}{34}\times100 \approx 79.4\% \]
\[ \frac{7}{34}\times100 \approx 20.6\% \]
Makale bunları yuvarlayarak %79 ve %21 olarak raporlamaktadır.
Çalışmaların yayın türleri
Kaynağın Şekil 3'ünde incelenen literatürün %50'si dergi makalesi, %43'ü konferans yayını ve %7'si web sitesi kaynağı olarak gösterilmektedir. Yayın sayısının özellikle 2019–2020 döneminde belirgin biçimde yükseldiği; sonrasında bir miktar düşmekle birlikte erken dönemlerin üzerinde kaldığı belirtilmektedir.
Bu dağılım alanın büyüme eğilimini göstermektedir ancak yayın sayısındaki değişim öğrenme etkinliğinin zaman içinde arttığı anlamına gelmez.
Değerlendirme yöntemleri ne kadar güçlü?
Derlemede çalışmaların büyük bölümünün deneysel değerlendirme kullandığı ve nicel ile nitel yöntemleri bir arada kullanan karma tasarımların yaygın olduğu görülmektedir. Katılımcı sayıları ise oldukça değişkendir: bazı araştırmalar yalnız 6–16 kişilik küçük kullanıcı çalışmalarına dayanırken başka bir chatbot çalışmasında 14.000 kullanıcı etkileşimi raporlanmıştır.
Ölçülen sonuçlar da standart değildir. Çalışmalar kullanılabilirlik, görev süresi, öğrenci güveni, öğrenme kazanımı, problem çözme davranışı, katılım, kullanıcı memnuniyeti, AI bilgisi, tasarım kalitesi veya model doğruluğu gibi çok farklı ölçütler kullanmıştır.
Bu heterojenlik nedeniyle sistematik derleme bütün çalışmaları tek bir öğrenme etki büyüklüğünde birleştirmemiştir. Yazarların da vurguladığı üzere mevcut kanıt, kesin nicel etkinlik oranlarından çok genel tasarım ve araştırma eğilimlerini göstermektedir.
Resmî risk-of-bias değerlendirmesi yapıldı mı?
Hayır. Çalışma formal çalışma düzeyi risk-of-bias değerlendirmesi yapmadığını açıkça belirtmektedir. Araştırmacılar bunun yerine tarama ve seçim sonuçlarının diğer yazarlar tarafından gözden geçirilmesi ve başlangıçta tek bir yayıncıya bağımlı arama yapmak yerine Google Scholar kullanılması gibi süreç önlemleri uygulamıştır.
Bu önlemler araştırma sürecini güçlendirebilir fakat çalışma düzeyi metodolojik kalite değerlendirmesinin yerine geçmez. Bu nedenle derlemede yer alan küçük örneklemli veya sınırlı değerlendirmeli çalışmalarla daha güçlü tasarımların kanıt ağırlığı nicel biçimde ayrıştırılmamıştır.
Tarama sürecinde kim görev aldı?
Yöntem bölümünde tarama ve seçim sürecinin ilk yazar tarafından yürütüldüğü, dördüncü yazar tarafından her aşamada gözden geçirilip doğrulandığı belirtilmektedir. Risk azaltma açıklamasının başka bir bölümünde ise çalışma seçimlerinin ikinci ve dördüncü yazarlarla gözden geçirilip tartışıldığı yazmaktadır. Bu ifadeler zorunlu olarak birbirini dışlamasa da aşamalardaki bağımsız değerlendirici rolünün ayrıntılı bir inter-rater katsayısı veya çift-kör tarama protokolüyle raporlanmadığını gösterir.
Protokol ne zaman kaydedildi?
Derleme protokolünün Open Science Framework üzerinde `8x4ed` kayıt kimliğiyle retrospektif olarak kaydedildiği belirtilmektedir. Retrospektif kayıt, inceleme yöntemi için bir şeffaflık kaydı sağlar; ancak araştırma başlamadan önce yapılmış prospektif protokol kaydıyla aynı yöntemsel korumayı sağlamaz.
LLM çağının kanıtı neden sınırlı?
Çalışmanın kendi sınırlılık bölümünde 38 araştırmanın yalnız dördünün LLM veya generative AI kullandığı açıkça belirtilmektedir. Bu nedenle çalışma tarafından oluşturulan açık/örtük öğrenme taksonomisi esas olarak LLM yaygınlaşmasından önceki AI eğitim sistemlerini yansıtır.
Yazarlar gelecekte yalnız LLM tabanlı eğitim tekniklerini inceleyen ayrı bir sistematik derlemenin, modern AI eğitim asistanlarındaki öğrenme mekanizmalarını daha temsil edici biçimde sınıflandırabileceğini önermektedir.
Gelecek araştırmalar için dört ana açık
- Konuşmaya dayalı uyarlanabilirlik: Daha açık uçlu diyalog, kişiselleştirilmiş geri bildirim ve iteratif etkileşim gereksinimi.
- Bilgi temsili ve mimari: Statik bilgi tabanlarının sınırlarını aşan, doğrulanabilir ve güncellenebilir bilgi mimarileri.
- Heterojen AI yaklaşımlarının bütünleştirilmesi: Makine öğrenmesi, yapılandırılmış bilgi ve LLM tabanlı konuşma katmanlarını birlikte kullanabilen hibrit sistemler.
- Daha güçlü değerlendirme: Tek oturumluk kullanılabilirlik testleri yerine uzun süreli öğrenme kazanımı, yanlış kavrama ve güvenilirlik ölçümleri.
Bilgi mimarisi açısından çalışma retrieval-augmented generation (RAG) yaklaşımını, üretken çıktıların doğrulanmış bilgi kaynaklarına dayandırılabilmesi için gelecekte değerlendirilebilecek yöntemlerden biri olarak göstermektedir. Bu, derlemede karşılaştırmalı olarak doğrulanmış üstün bir yöntem değil, geleceğe yönelik mimari öneridir.
Kaynak ve Yöntem Notu
| Tam özgün çalışma adı | Explicit and Implicit Learning Mechanisms in AI Educational Assistants: A Systematic Review |
|---|---|
| Yazarlar | Fatmah Alqarni; Nada Alhirabi; Omer Rana; Charith Perera |
| Yazar sırası | 1. Fatmah Alqarni; 2. Nada Alhirabi; 3. Omer Rana; 4. Charith Perera |
| Eş katkı / eş birinci yazar | Kaynak çalışmada eş katkı veya eş birinci yazar beyanı belirtilmemiştir. |
| Sorumlu yazar | Fatmah Alqarni |
| Kurumlar | Computer Science and Informatics, Cardiff University, Cardiff, Birleşik Krallık; Department of Computer Science and Engineering, College of Applied Studies, King Saud University, Riyadh, Suudi Arabistan. |
| Kaynak türü | Sistematik derleme. |
| Hakemlik durumu | Hakemli dergide yayımlanmış sistematik derlemedir; preprint değildir. |
| Dergi | AI |
| Yayınevi | MDPI |
| Cilt / sayı / makale | 2026, 7(5), 160 |
| DOI | 10.3390/ai7050160 |
| Alınma tarihi | 26 Şubat 2026 |
| Revizyon tarihi | 6 Nisan 2026 |
| Kabul tarihi | 16 Nisan 2026 |
| Yayın tarihi | 1 Mayıs 2026 |
| Resmî bağlantı | https://doi.org/10.3390/ai7050160 |
| Lisans | Creative Commons Attribution (CC BY). |
| Derleme protokolü | Open Science Framework, 8x4ed; kaynakta retrospektif kayıt olarak belirtilmiştir. |
Finansman ve destek
Çalışma kısmen EPSRC PETRAS programı tarafından `EP/S035362/1` proje numarasıyla desteklenmiştir. Teşekkür bölümünde ayrıca Najran University tarafından sağlanan burs ve destek belirtilmektedir.
Veri erişilebilirliği
Çalışmada üretilen veriler, dahil edilen araştırmalardan çıkarılmış ve kodlanmış bilgilerdir. Dahil edilen çalışmaların listesi ile öğrenme türü, uygulama yaklaşımı ve değerlendirme özellikleri gibi çıkarılmış değişkenlerin Supplementary Materials içinde sağlandığı bildirilmektedir.
Etik ve çıkar çatışması
Institutional Review Board ve bilgilendirilmiş onam alanları kaynakta “uygulanamaz” olarak belirtilmiştir. Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Yazar katkıları
Kavramsallaştırma: Fatmah Alqarni ve Charith Perera. Metodoloji: Fatmah Alqarni, Charith Perera ve Nada Alhirabi. Biçimsel analiz: Fatmah Alqarni. Veri düzenleme: Fatmah Alqarni. İlk taslak: Fatmah Alqarni. Gözden geçirme ve düzenleme: Fatmah Alqarni, Charith Perera ve Nada Alhirabi. Review: Omer Rana. Gözetim: Charith Perera ve Omer Rana. Finansman edinimi: Charith Perera.
Kaynak içi ve yöntemsel dikkat noktaları
- 38 çalışma nihai derlemeye alınmasına karşın yalnız 34 çalışma tam veri çıkarımına dahil edilmiştir.
- %79 açık / %21 örtük öğrenme dağılımının fiilî paydası 34'tür; bu oranlar eğitim etkinliği değildir.
- Resmî çalışma düzeyi risk-of-bias değerlendirmesi yapılmamıştır.
- Derleme protokolü prospektif değil retrospektif olarak kaydedilmiştir.
- Yalnız İngilizce çalışmalar dahil edildiği için dil yanlılığı olasılığı vardır.
- Açık/örtük öğrenme sınıflandırması teorik tanımlara dayanmakla birlikte yazarlar sınıflandırmanın öznel bir unsur içerdiğini kabul etmektedir.
- Bir çalışma yalnız tek baskın öğrenme türüne atanmıştır; buna karşın etkileşim özellikleri açık ve örtük kategoriler arasında örtüşebilir.
- Etkileşim yüzdeleri birbirini dışlayan çalışma yüzdeleri değildir; toplam modalite oluşumları üzerinden normalize edilmiştir.
- Tablo 6'nın “Number of Papers” sütununda sayı yerine yüzdelerin gösterilmesi kaynakta editoryal bir sunum belirsizliği yaratmaktadır.
- Çalışmaların değerlendirme tasarımları, örneklem büyüklükleri, süreleri ve ölçütleri çok heterojendir.
- Birçok araştırma kısa süreli deney veya tek oturumlu workshop kullanmıştır; uzun dönem öğrenme etkisine ilişkin kanıt sınırlıdır.
- 38 çalışmanın yalnız dördü LLM veya üretken yapay zekâ kullandığından sonuçlar modern LLM eğitim asistanlarını tam temsil etmemektedir.
- Meta-analitik etki büyüklüğü hesaplanmadığı için farklı AI eğitim yaklaşımlarının karşılaştırmalı pedagojik üstünlüğü belirlenmemiştir.
Çalışmanın en sağlam sonucu, yapay zekâ eğitim asistanlarının tek bir teknolojik kategori olmadığı ve öğrenme desteğinin yalnız kullanılan AI algoritmasına bakılarak anlaşılamayacağıdır. Kullanıcının AI ile nasıl etkileşime girdiği, desteğin bilinçli öğretim mi yoksa deneyim yoluyla dolaylı öğrenme mi sağladığı, bilginin nasıl temsil edildiği, sistemin nasıl güncellendiği ve öğrenme etkisinin nasıl değerlendirildiği birlikte ele alınmalıdır.
Buna karşılık çalışma, AI eğitim asistanlarının genel olarak geleneksel öğretimden üstün olduğunu veya LLM'lerin eğitimde daha başarılı olduğunu kanıtlamamaktadır. Kaynak yazarlarının kendi değerlendirmesi de mevcut literatürde daha uzun süreli, daha büyük ve çeşitli kullanıcı gruplarına dayanan, öğrenme kazanımını doğrudan ölçen ve LLM çıktılarının doğruluğunu denetleyen daha güçlü değerlendirme çerçevelerine ihtiyaç bulunduğu yönündedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir