

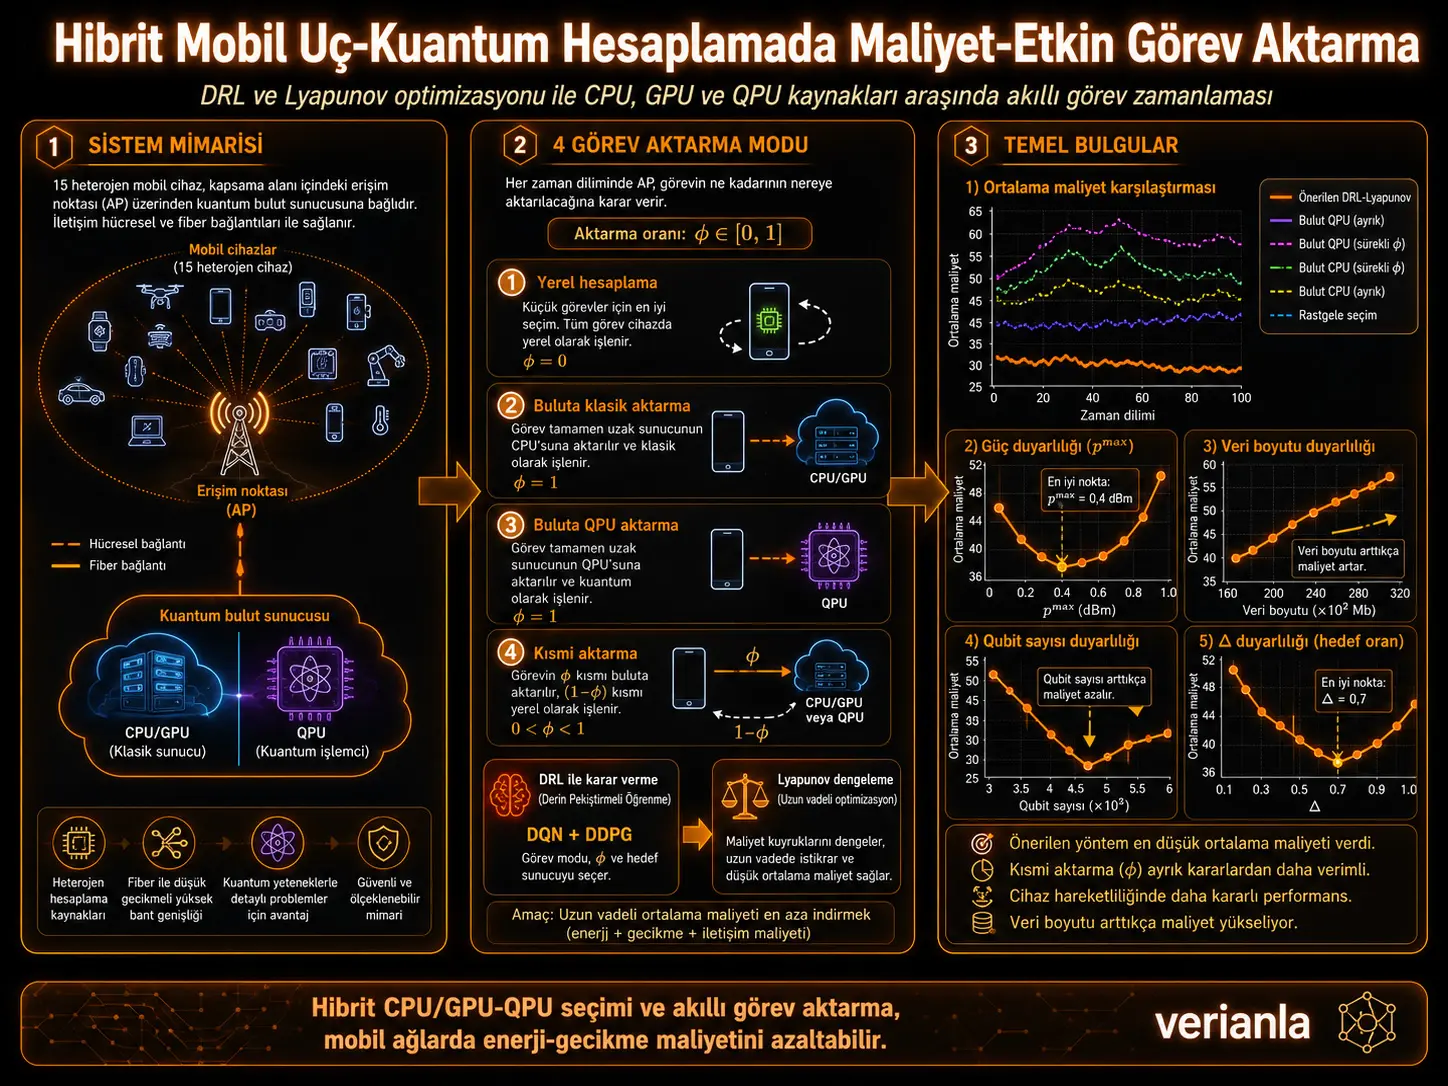
Bu çalışma, hareketli cihazların hesaplama görevlerini yerel işlemci, uzak CPU/GPU veya QPU kaynakları arasında dinamik olarak nasıl dağıtacağını inceleyen hibrit bir mobil uç-kuantum hesaplama modeli geliştiriyor. Araştırmacılar zamanla birbirine bağlı görev aktarma problemine Lyapunov optimizasyonunu, ayrık görev modu seçimi için Deep Q-Network (DQN) yaklaşımını ve kısmi görev aktarma oranı için Deep Deterministic Policy Gradient (DDPG) algoritmasını birleştiriyor; 15 mobil cihazlı, Gauss-Markov hareketlilik modeli kullanılan sayısal simülasyonlarda önerilen DRL tabanlı Lyapunov yaklaşımı karşılaştırılan CPU-only, QPU-only ve rastgele seçim yöntemlerinden daha düşük zaman-ortalama maliyet sağlıyor. İncelenen koşullarda pmax=0,4 dBm ve uzun dönem uzaktan aktarma hedefi Δ=0,7 en düşük ortalama maliyetle ilişkilendiriliyor. Bununla birlikte sonuçlar gerçek bir mobil kuantum ağında veya fiziksel QPU üzerinde uçtan uca doğrulama değil; kuantum işlem süresi, enerji tüketimi ve hata olasılığı dahil olmak üzere çok sayıda bileşenin matematiksel olarak modellendiği bir simülasyon çalışmasına dayanıyor.
Çalışmanın temel fikri, her hesaplama görevini zorunlu olarak yalnız klasik veya yalnız kuantum kaynağa göndermek yerine, cihazın konumu, kablosuz kanal koşulu, görev büyüklüğü, gecikme sınırı, CPU kapasitesi, QPU için gerekli qubit sayısı ve modellenen kuantum başarı olasılığı gibi değişkenlere göre karar vermektir. Dördüncü seçenek olan kısmi aktarmada görevin bir bölümü cihazda yerel olarak çalışırken kalan bölüm uzak klasik ya da kuantum kaynağa gönderilebilir.
Araştırma hangi problemi çözmeye çalışıyor?
Mobil edge computing sistemlerinde hesaplama yoğun görevlerin tamamını telefon, IoT cihazı veya başka bir uç cihaz üzerinde çalıştırmak enerji ve işlem kapasitesi bakımından pahalı olabilir. Görevin uzak sunucuya aktarılması ise kablosuz veri iletim süresi ve enerji maliyeti oluşturur. Buna mobil cihazın hareket etmesi, kanal kalitesinin zamanla değişmesi ve görevlerin farklı büyüklük ve gecikme gereksinimlerine sahip olması eklendiğinde karar problemi tek bir zaman anının optimizasyonundan çıkar ve uzun dönemli bir zamanlama problemine dönüşür.
Kaynak çalışmanın araştırma boşluğu da burada tanımlanıyor. Önceki hibrit mobil uç-kuantum hesaplama çalışmalarının ağırlıklı olarak anlık veya statik kaynak tahsisine odaklandığını belirten araştırmacılar, cihaz hareketliliğini ve görevlerin zaman içinde değişmesini hesaba katan uzun dönemli bir görev aktarma sistemi kurmayı amaçlıyor.
Hibrit MEQC mimarisi nasıl kuruluyor?
Şekil 1'deki sistem modeli, kapsama alanındaki heterojen mobil cihazların bir erişim noktası üzerinden merkezi bir bulut sunucusuna bağlandığı bir mimari gösteriyor. Sunucu yalnız klasik CPU/GPU kaynaklarına değil, QPU kaynaklarına da sahip kabul ediliyor. Mobil cihaz ile erişim noktası arasındaki bağlantı hücresel, erişim noktası ile merkezi bulut arasındaki bağlantı ise fiber olarak modelleniyor.
Sistemde \(M\) adet mobil cihaz bulunuyor ve her cihaz zaman dilimi \(r\) içinde farklı bir hesaplama görevi alabiliyor. Klasik hesaplama açısından görev kaynakta yaklaşık olarak
\[ \mathcal{J}_m[r]= \left\{ d_m[r], q_m[r], t_m^{\max}[r] \right\} \]
biçiminde tanımlanıyor. Burada \(d_m[r]\) görev verisinin büyüklüğünü, \(q_m[r]\) veri başına gereken CPU çevrimlerini, \(t_m^{\max}[r]\) ise görevin izin verilen maksimum gecikmesini temsil ediyor.
Dört farklı görev aktarma modu
Şekil 2, çalışmanın karar mekanizmasının temelini oluşturan dört modu görsel olarak ayırıyor.
| Mod | Hesaplama konumu | Temel özellik | Başlıca maliyet/kısıt |
|---|---|---|---|
| Yerel hesaplama | Mobil cihaz CPU'su | Görev cihaz üzerinde yürütülür | Yerel işlem süresi ve enerji tüketimi |
| Buluta klasik aktarma | Uzak CPU/GPU | Görev erişim noktası üzerinden klasik sunucuya gönderilir | Yükleme + klasik hesaplama + sonuç indirme |
| Buluta QPU aktarma | Uzak QPU | Uygun görev kuantum devresine dönüştürülür | Qubit kapasitesi, başarı olasılığı, kapı süresi, QEC ve iletişim |
| Kısmi aktarma | Yerel + uzak kaynak | Görevin yalnız belirli bölümü buluta gönderilir | Yerel ve uzak maliyetlerin birlikte optimizasyonu |
Kısmi aktarma oranı
\[ \phi_m[r]\in[0,1] \]
ile ifade ediliyor. \(\phi_m=0\) görevin tamamen yerel yürütülmesine, \(\phi_m=1\) tamamen uzak sunucuya aktarılmasına, \(0<\phi_m<1\) ise görevin bölünmesine karşılık geliyor.
Kablosuz iletişim maliyeti nasıl hesaplanıyor?
Cihaz ile erişim noktası arasındaki veri hızı Shannon tipi bir ifadeyle modelleniyor:
\[ R_{m,0}[r] = B\log_2 \left( 1+ \frac{p_{m,0}[r]g_{m,0}[r]} {\sigma^2} \right). \]
Burada \(B\) tahsis edilen bant genişliği, \(p_{m,0}[r]\) cihazın gönderim gücü, \(g_{m,0}[r]\) anlık kanal kazancı, \(\sigma^2\) ise gürültü terimidir. Kanal kazancının yol kaybı, gölgelenme ve hızlı sönümleme etkilerini içerdiği kabul ediliyor.
Uzak CPU/GPU kullanımında toplam gecikme; görevin sunucuya gönderilmesi, uzak işlemcide hesaplanması ve sonuç paketinin cihaza geri gönderilmesinin toplamı olarak modelleniyor:
\[ t^C_{m,0}[r] = t^{C,1}_{m,0}[r] + t^{C,2}_{m,0}[r] + t^{C,3}_{m,0}[r]. \]
QPU seçimi hangi koşullarda mümkün?
Kuantum moda geçildiğinde görev yalnız veri büyüklüğü ve CPU çevrimiyle değil, kuantum devresinin gerektirdiği qubit sayısı ve devre derinliğiyle de tanımlanıyor. Kaynak, \(o_m[r]\) değişkenini gerekli qubit sayısı, \(l_m[r]\) değişkenini ise kuantum devresinin derinliği olarak kullanıyor.
Kuantum hesaplama süresi bir-qubit kapıları, iki-qubit kapıları ve ölçüm kapılarının süreleri üzerinden modelleniyor. Enerji modelinde ise bu kapıların tüketiminin yanı sıra fiziksel qubitlerin ve hata düzeltme altyapısının maliyeti hesaba katılıyor. Kaynağın özellikle vurguladığı noktalardan biri, QPU enerji tüketiminde soğutmanın ve kuantum hata düzeltmenin göz ardı edilmemesidir.
QPU seçimi iki temel uygunluk koşuluna bağlıdır:
\[ S_m[r]\geq \frac{2}{3} \]
ve
\[ o_m^C\geq o_m[r]. \]
Birinci koşul modellenen kuantum hesaplama başarı olasılığının en az \(2/3\) olmasını, ikinci koşul ise cihazın kiraladığı/erişebildiği kuantum kapasitesinin devrenin istediği qubit sayısını karşılamasını şart koşuyor.
Başarı olasılığı nasıl modele ekleniyor?
Çalışma ideal ve hatasız bir QPU varsaymıyor. Fiziksel kapı hata olasılığı, hata düzeltme eşiği, hata düzeltme bağlantı seviyesi, qubit sayısı ve devre derinliği kullanılarak kuantum görevinin başarı olasılığı için bir yaklaşım oluşturuluyor. Devre büyüdükçe potansiyel hata konumlarının sayısının yükselmesi modelde başarı olasılığını etkiliyor.
Bu önemli bir ayrıntıdır çünkü model, “QPU varsa her görev QPU'ya gönderilmelidir” varsayımını kullanmaz. Kuantum seçeneği hem kaynak kapasitesine hem de beklenen hesaplama doğruluğuna bağlı olarak elenebilir.
Uzun dönem problemi neden Lyapunov optimizasyonuna ihtiyaç duyuyor?
Araştırmacılar yalnız o anki enerji ve gecikmeyi azaltmak istemiyor. Mobil cihazların uzun dönemde bulut kaynaklarını belirli bir oranın altında kullanmaması için zaman ortalamalı bir kısıt da getiriliyor:
\[ \lim_{R\rightarrow\infty} \frac{1}{R} \sum_{r=1}^{R} \mathbb{E}\{\phi_m[r]\} \geq \Delta. \]
\(\Delta\), uzun dönem uzaktan aktarma hedefini temsil ediyor. Bu koşul farklı zaman dilimlerindeki kararları birbirine bağladığı için problem zamanla bağlı hale geliyor.
Bunu yönetebilmek için sanal bir kuyruk oluşturuluyor:
\[ z_m[r+1] = \max \left\{ 0, z_m[r] + \Delta\,\mathbf{1}_{[\phi_m[r]=0]} - \phi_m[r] \right\}. \]
Sanal kuyruğun kararlı tutulması, uzun dönem kısıtının yerine getirilmesiyle ilişkilendiriliyor. Ardından karesel Lyapunov fonksiyonu
\[ L[r] = \frac{1}{2} \sum_{m=1}^{M} z_m[r]^2 \]
kullanılarak uzun dönem problemi her zaman diliminde çözülebilecek bir drift-plus-penalty biçimine dönüştürülüyor.
DQN ve DDPG neden birlikte kullanılıyor?
Görev aktarma kararı yalnız ayrık veya yalnız sürekli değildir. Cihazın yerel, klasik uzak veya kuantum uzak moda geçmesi ayrık bir seçimken, görevin ne kadarının uzaktaki kaynağa aktarılacağı \(\phi_m\) ile ifade edilen sürekli bir karardır.
Kaynak bu nedenle iki farklı derin pekiştirmeli öğrenme yaklaşımını birlikte kullanmayı öneriyor. DQN görev aktarma modunun ayrık seçimiyle, DDPG ise kısmi görev aktarma kararındaki sürekli eylem bileşeniyle ilişkilendiriliyor. Mobil cihazın gözlem uzayında sunucu kaynakları, görev özellikleri, kanal kazancı ve yerel CPU kapasitesi bulunuyor.
Pekiştirmeli öğrenme ödülü kaynakta
\[ R=-C(\phi[r],Y[r]) \]
olarak tanımlanıyor; yani ajan toplam enerji-gecikme maliyetini azaltacak kararlar almaya yönlendiriliyor.
Çalışmanın desteklediği sonuçlar
- İncelenen simülasyon ortamında hibrit CPU/GPU-QPU seçimini ve kısmi aktarmayı birlikte kullanan DRL tabanlı Lyapunov yaklaşımı karşılaştırılan temel yöntemlerden daha düşük zaman-ortalama maliyet üretmiştir.
- Kısmi görev aktarmaya izin veren sürekli karar yöntemleri, yalnız tam aktarma/tam yerel kararına izin veren ayrık karşılıklarından daha düşük maliyet göstermiştir.
- Cihaz hareketliliği altında önerilen yaklaşım düşük maliyetini diğer yöntemlere kıyasla daha kararlı biçimde korumuştur.
- Veri büyüklüğü arttığında bütün yöntemlerin maliyeti yükselmiştir.
- İncelenen koşullarda pmax=0,4 dBm ve Δ=0,7 minimum ortalama maliyet noktalarıyla ilişkilendirilmiştir.
- Kaynak modelinde fiziksel qubit kapasitesindeki artış, uygun koşullarda daha fazla görevin QPU'ya aktarılabilmesine imkân vermektedir.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- Gerçek bir kuantum işlemci üzerinde görev aktarma deneyi yapılmamıştır.
- Gerçek bir 5G/6G baz istasyonu, mobil kullanıcı ağı ve kuantum bulutu üzerinde saha doğrulaması bulunmamaktadır.
- Çalışma klasik hesaplamaya karşı deneysel bir quantum speedup göstermemektedir.
- QPU'nun bütün görevlerde CPU/GPU'dan daha hızlı veya enerji açısından daha avantajlı olduğu gösterilmemektedir.
- Simülasyondaki maliyet azalması doğrudan karbon emisyonu veya yaşam döngüsü sürdürülebilirliği ölçümü değildir.
- Protein katlama görevleri gerçek biyolojik deneylerden veya gerçek kullanıcı iş yükü kayıtlarından değil, kaynakta belirtilen sentetik varsayımlardan oluşturulmuştur.
- Grafiklerdeki sonuçlar farklı ağ topolojileri, farklı QPU teknolojileri veya farklı hata düzeltme mimarileri için otomatik olarak genellenemez.
Çalışmanın Yöntemi ve Bulguları
Simülasyon ortamı
Deneysel değerlendirme fiziksel saha deneyi yerine Python/PyTorch tabanlı sayısal simülasyonla gerçekleştiriliyor. Kaynakta kullanılan başlıca ayarlar şunlardır:
| Parametre | Kaynakta kullanılan değer/ayar | Bilimsel rolü |
|---|---|---|
| Mobil cihaz sayısı | 15 | Heterojen kullanıcı ortamı |
| Kapsama alanı | π(50×50) m² | Hareketlilik bölgesi |
| Cihaz başına fiziksel qubit kapasitesi | Rastgele 1000-5000 | Uzak QPU erişim sınırı |
| Alt bant genişliği | 0,1 GHz | Kablosuz iletim modeli |
| Gönderim gücü | 0,01-0,2 dBm | Cihaz heterojenliği |
| Yerel CPU frekansı | {1, 2, 3} GHz | Yerel hesaplama kapasitesi |
| DDPG gizli katmanları | 3 tam bağlı katman, her biri 512 birim | Sürekli aktarma politikası |
| İndirim faktörü | 0,913 | Gelecek ödüllerin ağırlığı |
| Öğrenme oranı | 0,001 | DDPG optimizasyonu |
| Yazılım | Python 3.8, PyTorch 1.12.1, CUDA 12.0 | Simülasyon altyapısı |
Protein katlama örnek senaryosu için kaynak, protein başına amino asit sayısını 30-90 arasında rastgele seçiyor ve all-atom moleküler dinamik simülasyon süresini 100 µs ile 1 ms arasında modelliyor. Ancak veri büyüklüğü konusunda kaynak içinde iki farklı yazım vardır: model ayarları bölümünde “[160,320] × 102 Mb”, deney ayarlarında ise “[160,320] MB” ifadesi yer alır. Bu fark burada düzeltilmemiştir.
Hareketlilik modeli
Cihazların konumlarının zaman içinde değişebilmesi için Gauss-Markov Mobility Model kullanılıyor. Çalışma özellikle yaklaşık 3-5 m/s'lik yavaş hareketliliği dikkate aldığını belirtiyor. Hız ve yön, önceki zaman diliminin değerleri, uzun dönem ortalamaları ve normal dağılımdan gelen rastgele bileşenlerle güncelleniyor:
\[ v_m[r] = \delta v_m[r-1] + (1-\delta)\bar v_m + (1-\delta^2)\tilde v_m[r], \]
\[ \eta_m[r] = \delta\eta_m[r-1] + (1-\delta)\bar\eta_m + (1-\delta^2)\tilde\eta_m[r]. \]
Konum ise hız ve yönün yatay/dikey bileşenlerinden hesaplanıyor. Böylece görev aktarma politikasının yalnız sabit kanal koşullarında değil, kullanıcının baz istasyonu çevresinde hareket ettiği durumda da değerlendirilmesi amaçlanıyor.
Şekil 3: Algoritma yakınsıyor mu?
Şekil 3(a), farklı gecikme ağırlıkları altında ortalama maliyetin epoch sayısıyla değişimini gösteriyor. İlk aşamadaki yüksek maliyet, politikanın henüz öğrenilmemiş ve daha rastgele davranmasıyla açıklanıyor. Eğitim ilerledikçe maliyet düşüyor.
Kaynağın metinsel değerlendirmesine göre enerjiye duyarlı durumda kararlı hale gelme yaklaşık 200 epoch, gecikmeye duyarlı durumda yaklaşık 250 epoch, enerji ve gecikmenin birlikte ağırlıklandırıldığı \(\lambda_m^t=0,5\) durumunda ise yaklaşık 350 epoch sürüyor. Karma hedefin daha yavaş yakınsaması, aynı anda enerji, gecikme ve uzun dönem bulut aktarma koşulunun birlikte optimize edilmesine bağlanıyor.
Şekil 3(b), Lyapunov denge parametresi \(V=1\), \(50\) ve \(1000\) için zaman-ortalama maliyet eğrilerini gösteriyor. Kaynak bu eğrilerin zamanla asimptotik olarak kararlı hale geldiğini bildiriyor.
Şekil 3(c): Hibrit yaklaşım temel yöntemlere karşı
Şekil 3(c)'de DRL çözümü şu yöntemlerle karşılaştırılıyor: yalnız uzak CPU kullanan ayrık karar, yalnız uzak CPU kullanan sürekli/kısmi karar, yalnız uzak QPU kullanan ayrık karar, yalnız uzak QPU kullanan sürekli/kısmi karar ve rastgele mod seçimi.
DRL tabanlı hibrit MEQC yöntemi kaynak grafiğinde en düşük ortalama maliyeti gösteriyor. Rastgele seçim en yüksek maliyetle sonuçlanıyor. Ayrıca CPU ve QPU senaryolarının her ikisinde de kısmi görev aktarımına izin veren sürekli değişkenli yöntemlerin ayrık “tamamen aktar veya aktarma” yöntemlerinden daha düşük maliyet üretmesi, görev bölünebilirliğinin model içindeki önemini ortaya koyuyor.
Şekil 4: Cihazlar hareket ettiğinde ne oluyor?
Şekil 4, GMMM hareketlilik senaryosunda 100 zaman dilimi boyunca yöntemlerin ortalama maliyetini karşılaştırıyor. DRL tabanlı Lyapunov yaklaşımı tüm zaman aralığında grafik üzerindeki en düşük maliyet bandında kalıyor ve görece küçük dalgalanmalar sergiliyor.
Rastgele görev aktarma politikasında maliyet hem daha yüksek hem daha değişken. Kaynak bunu kanal durumunun dikkate alınmamasına bağlıyor. Yalnız QPU'ya dayalı yöntemlerde de cihaz hareketliliği sırasında belirgin maliyet salınımları görülüyor; bu sonuç, kuantum kaynağının tek başına kullanılmasının değişken ağ koşullarında otomatik olarak sağlam bir çözüm oluşturmadığını gösteriyor.
Şekil 5(a): Gönderim gücü arttıkça ne oluyor?
Maksimum gönderim gücü \(p^{max}\), 0 ile 1 dBm arasında değiştirilmiştir. Önerilen yöntemin ortalama maliyeti önce düşüyor, ardından belirli bir seviyede dengeleniyor. Kaynağın açık ifadesine göre incelenen senaryoda en düşük maliyet yaklaşık \(p^{max}=0,4\) dBm değerinde elde ediliyor.
\(p^{max}\) 0,8-1 dBm aralığına ulaştığında maliyetin görece sabit kalması, algoritmanın yüksek iletişim maliyetine karşı buluta aktarılan görev miktarını azaltabilmesiyle açıklanıyor.
Şekil 5(b): Veri büyüklüğünün etkisi
Görev verisi büyüdükçe incelenen bütün yöntemlerin ortalama maliyeti artıyor. Bunun nedeni daha büyük görevin hem kablosuz aktarım hem de hesaplama süresini/enerjisini yükseltmesidir. Buna rağmen kaynak grafiğinde DRL tabanlı hibrit yaklaşım karşılaştırılan yöntemlerin altında kalmaya devam ediyor.
Şekil 5(c): Daha fazla fiziksel qubit ne değiştiriyor?
Şekil 5(c), fiziksel qubit sayısının yaklaşık \(3\times10^3\) ile \(6\times10^3\) arasında değiştirilmesini ele alıyor. Önerilen yöntemin ortalama maliyeti qubit sayısındaki artıştan diğer bazı yöntemler kadar güçlü etkilenmiyor.
Kaynağın yorumu, daha yüksek qubit kapasitesinin mobil cihazların belirli görevleri QPU'ya gönderebilme olasılığını yükselttiği yönündedir. Ancak bunun faydası ağ koşulları ve kuantum görevin uygunluğu sağlandığında ortaya çıkmaktadır; salt qubit sayısının yükselmesi tek başına maliyetin monoton biçimde düşmesini garanti etmez.
Şekil 6: Uzaktan aktarma hedefi Δ
Uzun dönem bulut aktarma hedefi \(\Delta\), 0,1 ile 1 arasında taranıyor. Önerilen yöntemde maliyet önce azalıyor ve kaynakta \(\Delta=0,7\) civarında minimuma ulaştıktan sonra yeniden yükseliyor.
Bu U-benzeri davranış, iki uç durumun da maliyetli olabileceğini gösteriyor. Çok düşük \(\Delta\) bulut kaynaklarının yeterince kullanılmamasına, çok yüksek \(\Delta\) ise cihazları ağ koşulları uygun olmasa bile daha fazla uzak işlemeye zorlayan bir kısıta dönüşebiliyor.
Verianla Live: Hibrit MEQC görev aktarma karar döngüsü
Bu süreç gösterimi çalışmanın sistem modeli, Lyapunov çerçevesi ve DQN/DDPG görev ayrımına dayanır. Aşağıdaki görünür tablo bilimsel source-of-truth'tur; süreçte kaynakta bulunmayan ara aşama veya nicel değer eklenmemiştir.
| Aşama | İşlem | Kullanılan bilgi/yöntem | Çıktı | Kaynak |
|---|---|---|---|---|
| 1 | Sistem durumunun gözlenmesi | Görev özellikleri, kanal kazancı, yerel CPU ve kiralanan sunucu kaynakları | DRL durum uzayı | Bölüm V-A |
| 2 | Görev aktarma modunun belirlenmesi | DQN / ayrık karar bileşeni | Yerel, klasik bulut veya QPU yönelimi | Özet ve Bölüm V |
| 3 | Kısmi aktarma oranının belirlenmesi | DDPG / sürekli φ kararı | Yerel ve uzak çalıştırma payı | Bölüm V-B |
| 4 | Fizibilite ve maliyet kontrolü | Gecikme sınırı, QPU başarı oranı, qubit kapasitesi, enerji ve iletişim maliyeti | Uygulanabilir eylem ve maliyet | Denklem 11-12 |
| 5 | Uzun dönem kısıtının güncellenmesi | Lyapunov sanal kuyruğu zm[r] | Yeni kuyruk durumu | Denklem 13-18 |
| 6 | Sonraki zaman dilimine geçiş | Yeni görev, kanal ve cihaz konumu | Dinamik karar döngüsünün tekrarı | Bölüm VI |
Verianla açıklayıcı süreç gösterimi: Görselleştirme görünür tablodan üretilir; tablo bilimsel kaynak-of-truth olarak kalır.
Teorik garanti ve kaynak içi işaret sorunu
Çalışma, C-additive yaklaşım ve Lyapunov drift analizi üzerinden iki teorem veriyor. Theorem 1, çözümün optimumla ilişkisini \(V\), \(B\) ve \(C\) parametrelerine bağlayan bir sınır; Theorem 2 ise uzun dönem kısıta yakınsama süresinin \(O(V/\tau)\) biçimindeki ilişkisini sunuyor.
Bununla birlikte kaynakta başlangıç problemi “maliyeti minimize etme” biçiminde kurulurken Eq. (16)'daki \(-VC\) terimi ve Theorem 1'de yazılan
\[ \lim_{r\rightarrow\infty}\inf C[r] \geq C^{opt} - \frac{B+C}{V} \]
ifadesi, minimizasyon problemi açısından işaret/yön bakımından dikkat gerektiriyor. Kaynak bu noktayı ayrıca açıklamadığından burada denklem ters çevrilmemiş veya yeniden türetilerek düzeltilmemiştir. Bu nedenle teorik optimalite garantisi, kaynakta belirtilenden daha güçlü bir iddiaya dönüştürülmemelidir.
Çalışmanın en güçlü ve en zayıf tarafı
Çalışmanın güçlü yönü, görev bölünebilirliği, mobilite, kanal durumu, gecikme sınırı, klasik ve kuantum kaynak kapasitesi, kuantum hata olasılığı ve uzun dönem bulut kullanım hedefini aynı dinamik karar probleminde bir araya getirmesidir. Özellikle yalnız CPU veya yalnız QPU seçmek yerine hibrit bir eylem uzayı kullanılması, sistem modelinin önemli tarafıdır.
En belirgin sınırlılık ise kuantum katmanın tamamının parametrik model olarak ele alınmasıdır. Sonuçlar gerçek QPU kuyruk süreleri, gerçek devre derleme maliyeti, donanıma özgü fidelity değişimleri, fiziksel hata düzeltme uygulaması veya gerçek soğutma sisteminin ölçülmüş enerji tüketimiyle doğrulanmamıştır. Bu nedenle çalışma, uygulanabilir bir karar çerçevesi sunarken fiziksel kuantum altyapının gerçek dünyadaki maliyet avantajını kanıtlayan bir donanım deneyi değildir.
Kaynak ve Yöntem Notu
Özgün çalışma: Cost-Effective Task Offloading Scheduling for Hybrid Mobile Edge-Quantum Computing
Yüklenen kaynak yazarları: Ziqiang Ye; Yulan Gao; Yue Xiao; Minrui Xu; Han Yu; Dusit Niyato.
Eş katkı/eş birinci yazarlık: Yüklenen kaynakta belirtilmemiştir.
Sorumlu yazar: Yüklenen kaynakta açık bir sorumlu yazar işareti bulunmadığından doğrulanamamıştır.
Yüklenen kaynak afiliyasyonları: Ziqiang Ye ve Yue Xiao — National Key Laboratory of Wireless Communications, University of Electronic Science and Technology of China, Chengdu, China. Yulan Gao, Minrui Xu, Han Yu ve Dusit Niyato — School of Computer Science and Engineering, Nanyang Technological University, Singapore.
Kaynak türü: arXiv preprint; algoritma geliştirme, matematiksel modelleme ve sayısal simülasyon çalışması.
Kaynak sürümü: arXiv:2306.14588v1 [eess.SY], 26 Haziran 2023.
ArXiv DOI kaydı: 10.48550/arXiv.2306.14588.
Hakemlik durumu: Yüklenen v1 dosyası bir preprinttir ve bu kaynak sürümü hakemli dergi nüshası değildir.
Daha sonraki yayın kaydı: Aynı başlıklı bir makale 2026 yılında IEEE Transactions on Cognitive Communications and Networking, Cilt 12, sayfalar 7789-7802 içinde yayımlanmış olarak bibliyografik kayıtlarda yer almaktadır.
Yayımlanmış sürüm DOI: 10.1109/TCCN.2026.3688510.
Yayınevi: IEEE.
Önemli bibliyografik sürüm farkı: 2023 v1 preprintin yazarları Ziqiang Ye, Yulan Gao, Yue Xiao, Minrui Xu, Han Yu ve Dusit Niyato iken, 2026 dergi kaydının yazarları Ziqiang Ye, Yulan Gao, Yue Xiao, Ming Xiao, Minrui Xu ve Han Yu olarak listelenmektedir. Dolayısıyla Ming Xiao daha sonraki kayıtta yer alırken Dusit Niyato yer almamaktadır. Bilimsel içerik bu fark nedeniyle dergi sürümünden aktarılmamış, yalnız yüklenen v1 çalışmasına dayandırılmıştır.
Lisans: Yüklenen dosyada açık bir Creative Commons lisansı belirtilmemiştir. Kaynak şekilleri bu nedenle doğrudan kopyalanmamıştır.
Finansman: Yüklenen v1 kaynakta ayrı bir finansman veya teşekkür bölümü tespit edilmemiştir.
Veri erişilebilirliği: Ayrı bir veri erişilebilirliği beyanı bulunmamaktadır.
Çıkar çatışması: Yüklenen kaynakta ayrı bir çıkar çatışması beyanı bulunmamaktadır.
CRediT/yazar katkıları: Ayrı bir CRediT katkı beyanı bulunmamaktadır.
Veri ve deney niteliği: Çalışma gerçek kullanıcı trafiği veya fiziksel kuantum donanım deneyi kullanmamaktadır. Mobil kullanıcı hareketleri GMMM ile simüle edilmiş; protein katlama görevleri kaynakta tanımlanan sentetik parametrelerle oluşturulmuş; QPU gecikmesi, enerji tüketimi ve başarı olasılığı matematiksel modeller üzerinden temsil edilmiştir.
Sürdürülebilirlik yorumu: Çalışmadaki “sustainable” ifadesi esas olarak enerji tüketimi ve zaman gecikmesinden oluşan operasyonel maliyet hedefi bağlamındadır. Karbon emisyonu, yaşam döngüsü analizi, veri merkezi embodied carbon değeri veya gerçek soğutma sisteminin çevresel etkisi ölçülmemiştir.
Kaynak içi terminoloji farkı: Çalışmada “weighted sum of energy consumption and time latency” için WSET ve SWET kısaltmaları farklı yerlerde kullanılmaktadır. Bu farklılık düzeltilmeden belirtilmiştir.
Kaynak içi matematiksel not: Maliyetin minimizasyonu olarak tanımlanan amaç ile Lyapunov reformülasyonundaki bazı eksi işaretleri ve Theorem 1'in yönü arasında yorum gerektiren bir tutarsızlık bulunmaktadır. Kaynağın denklemleri sessizce düzeltilmemiştir.
Kaynak içi veri büyüklüğü notu: Protein-folding model ayarlarında “[160,320] × 10² Mb”, deney ayarlarında ise “[160,320] MB” yazılmıştır. Bu iki ifade aynı değer olarak varsayılmamıştır.
Bilimsel yorum sınırı: Sonuçlar, incelenen ağ modeli ve parametrik QPU varsayımları altında hibrit klasik-kuantum görev aktarma politikasının maliyet avantajı sağlayabileceğini desteklemektedir. Gerçek QPU üzerinde quantum advantage, quantum speedup veya gerçek saha enerji üstünlüğü gösterilmemiştir.
Kaynak sadakati: Bu içerikteki bütün bilimsel yöntem, denklem, parametre, simülasyon sonucu ve yorum sınırı yüklenen 12 sayfalık v1 kaynağa dayanmaktadır. Harici kaynaklar yalnız bibliyografik kimliği, arXiv kaydını ve daha sonraki dergi yayınının durumunu doğrulamak için kullanılmıştır.
Türkiye bağlamı: Çalışmada Türkiye'ye ait mobil şebeke, enerji fiyatı, cihaz dağılımı, frekans tahsisi veya kuantum altyapısı verisi bulunmadığından sonuçlar Türkiye'ye doğrudan aktarılmamıştır. Yerel uygulama için gerçek operatör ağı, veri merkezi/QPU erişimi, enerji maliyetleri ve düzenleyici koşullarla yeniden doğrulama gerekir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir