

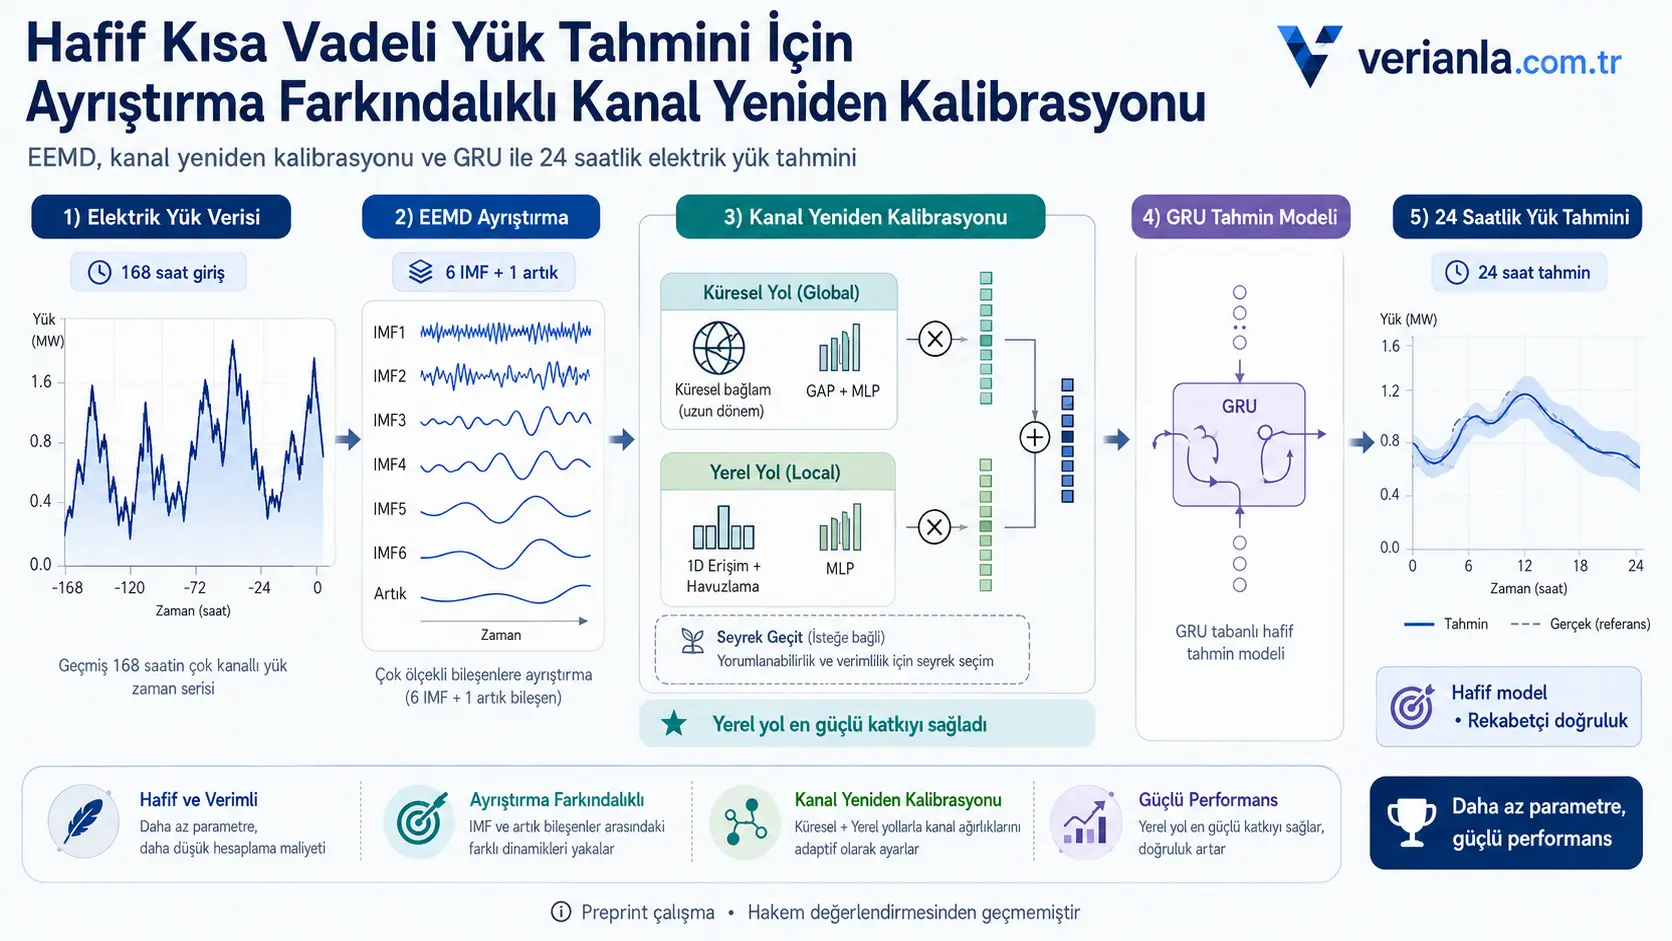
Bu çalışma, büyük Transformer mimarilerine dayanmadan 24 saat ilerisine yönelik elektrik yükü tahmininin doğruluğunu artırmak amacıyla EEMD tabanlı ayrıştırma, kanal yeniden kalibrasyonu ve GRU modelini bir araya getirmiştir. Model, geçmiş 168 saatlik yük verisini kullanarak sonraki 24 saati tahmin etmiş; GEFCom2014 ve dört PJM veri alt kümesinde beş farklı rastgele başlangıçla değerlendirilmiştir. GEFCom2014 üzerinde seyrek kapılı tam model %7,90 MAPE değerine ulaşırken yalnızca yerel yeniden kalibrasyon yolunu kullanan LocalOnly modeli %7,76 ile en düşük MAPE değerini vermiştir. Bununla birlikte PJM sonuçları modelin bütün bölgelerde ve bütün ölçütlerde üstün olmadığını, ayrıca çevrim içi nedensel EEMD denemelerinde kanal yeniden kalibrasyonunun anlamlı bir kazanç sağlamadığını göstermektedir.
Araştırmanın temel yaklaşımı, karmaşık yük serisini farklı zaman ölçeklerini temsil eden bileşenlere ayırmak ve tahmin modeline girmeden önce bu bileşenlerin önemini yeniden ağırlıklandırmaktır. Ensemble Empirical Mode Decomposition ya da Topluluk Ampirik Kip Ayrıştırması (EEMD), yük serisini altı içsel kip fonksiyonu ve bir artık eğilim bileşenine ayırmıştır. Küresel ve yerel kanal yolları daha sonra hangi ayrıştırılmış bileşenlerin, sıcaklık veya zaman özelliklerinin tahmin açısından daha yararlı olduğunu öğrenmiştir.
GEFCom2014 deneyinde seyrek kapılı EEMD-DCA-GRU-SG modeli 167,5 bin eğitilebilir parametreyle %7,90 MAPE elde etmiştir. Informer modeli 2,41 milyon parametreyle %8,36, PatchTST ise 615,5 bin parametreyle %8,49 MAPE vermiştir. Çalışmanın en düşük benchmark hatasını ise tam birleşik model değil, yalnızca yerel zamansal kanıtı kullanan LocalOnly varyantı üretmiştir. Bu sonuç, ayrıştırma sonrasında kısa dönemli yerel örüntülerin kanal önemini belirlemede küresel ortalamalardan daha güçlü olabileceğini göstermektedir.
Türkiye açısından yöntem, elektrik dağıtım ve üretim planlamasında kullanılan yerel yük serilerinin farklı zaman ölçeklerine ayrılması için araştırılabilecek hafif bir modelleme yaklaşımı sunmaktadır. Ancak çalışma Türkiye elektrik sistemi üzerinde gerçekleştirilmemiştir. Türkiye’deki sıcaklık, tatil, bölgesel tüketim, sanayi profili ve şebeke koşullarıyla ayrı eğitim ve doğrulama yapılmadan operasyonel başarı sonucu çıkarılamaz. Özellikle çevrim içi kullanım için EEMD işleminin yalnızca tahmin anına kadar mevcut verilerle nedensel biçimde uygulanması ve modelin aynı protokolle yeniden eğitilmesi gerekir.
Araştırmanın temel sorusu nedir?
Araştırma şu soruya odaklanmaktadır: Elektrik yükü serisini çoklu zaman ölçeklerine ayıran EEMD ile kanal bazında yeniden ağırlıklandırma birleştirildiğinde, büyük Transformer modellerine gerek kalmadan daha doğru ve daha dayanıklı kısa vadeli yük tahmini yapılabilir mi?
Kısa vadeli yük tahmini; ekonomik yük dağıtımı, üretim birimi planlaması, elektrik piyasası işletimi, fiyatlandırma ve talep tarafı yönetimi gibi süreçler için önemlidir. Ancak elektrik tüketimi günlük ve haftalık döngülerin yanında sıcaklık değişimleri, düzensiz olaylar ve farklı frekanslardaki dalgalanmaları aynı seri içinde taşır. Ham serinin tek parça olarak modellenmesi, hızlı dalgalanmalarla yavaş eğilimlerin birbirini maskelemesine yol açabilir.
Literatürde hedeflenen boşluk nedir?
Çalışma üç teknik soruna odaklanmaktadır:
- Ham yük serisi günlük, haftalık, hava koşullarına bağlı ve düzensiz hareketleri aynı anda içerdiği için çok ölçekli yapının doğrudan öğrenilmesi güçleşebilir.
- EEMD gibi ayrıştırma yöntemleri çok sayıda IMF ve yardımcı kanal üretir; bütün kanalları eşit kabul etmek gürültülü veya zayıf bilgi taşıyan bileşenlerin etkisini artırabilir.
- Transformer tabanlı modeller güçlü temsil kapasitesi sağlayabilse de parametre ve hesaplama maliyetleri daha yüksek olabilir.
Önerilen çerçeve, EEMD ile bileşen ayrıştırmasını ve hafif kanal yeniden kalibrasyonunu iki katmanlı bir GRU tahmin başlığıyla birleştirerek bu üç soruna birlikte yanıt vermeyi amaçlamaktadır.
Modelin genel iş akışı nasıl kurulmuştur?
Çalışmadaki mimari şema şu işlem sırasını göstermektedir:
- Ham elektrik yükü ve mevcut yardımcı özellikler alınır.
- Yük serisi EEMD ile altı IMF ve bir artık bileşene ayrılır.
- Ayrıştırılmış kanallara sıcaklık ve döngüsel zaman özellikleri eklenir.
- Küresel, yerel veya birleşik kanal yeniden kalibrasyonu uygulanır.
- İsteğe bağlı yumuşak seyrek kapı, zayıf kanalları bastırır.
- İki katmanlı GRU geçmiş 168 saatten sonraki 24 saatlik yük vektörünü üretir.
Mimari şema, kanal yeniden kalibrasyonunun GRU’dan önce konumlandığını göstermektedir. Böylece GRU, bütün bileşenleri eşit ağırlıkla almak yerine model tarafından önemleri ayarlanmış bir özellik dizisi üzerinde çalışmaktadır.
Tahmin problemi matematiksel olarak nasıl tanımlanmıştır?
Zaman t anındaki yük değeri lt, giriş penceresi uzunluğu L = 168 saat ve tahmin ufku H = 24 saat olarak tanımlanmıştır. Hedef vektör şu şekildedir:
\[ \mathbf{y}_t = [l_{t+1},l_{t+2},\ldots,l_{t+H}]^{\mathsf{T}} \in \mathbb{R}^{H} \]
Bu vektör, tahmin anından sonraki 24 yük değerini birlikte temsil eder. Çok kanallı geçmiş veri penceresi ise şöyledir:
\[ \mathbf{X}_{t-L+1:t} = [\mathbf{x}_{t-L+1},\mathbf{x}_{t-L+2},\ldots,\mathbf{x}_{t}] \in \mathbb{R}^{C \times L} \]
Burada C kanal sayısını, L ise her kanal için kullanılan geçmiş saat sayısını gösterir. Modelin çıktısı:
\[ \hat{\mathbf{y}}_t = f_{\theta}(\mathbf{X}_{t-L+1:t}) \in \mathbb{R}^{H} \]
ifadesiyle verilmiştir. fθ, öğrenilebilir parametreleri θ olan tahmin modelidir; şapka işareti model tarafından tahmin edilen değeri belirtir.
Eğitim sırasında çok ufuklu ortalama karesel hata en aza indirilmiştir:
\[ \mathcal{L}(\theta)=\frac{1}{BH}\sum_{i=1}^{B}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2 \]
B mini parti büyüklüğü, H tahmin edilen saat sayısıdır. Karesel hata, büyük tahmin sapmalarını daha fazla cezalandırır. Çalışmada mini parti büyüklüğü 64 olarak belirlenmiştir.
EEMD ayrıştırması ne yapmaktadır?
EEMD, yük sinyalini farklı frekans ve zaman ölçeklerine ait içsel kip fonksiyonlarına ayırmaktadır:
\[ l_t=\sum_{k=1}^{K}c_k(t)+r(t) \]
Burada ck(t), k numaralı içsel kip fonksiyonunu; r(t) ise yavaş değişen artık veya eğilim bileşenini ifade eder. Çalışmada K = 6 seçilmiş, dolayısıyla altı IMF ve bir artık kanal tutulmuştur.
Bu işlem, tek bir karmaşık dalgayı hızlı titreşimler, orta ölçekli döngüler ve yavaş eğilimler halinde ayrı ayrı incelemeye benzetilebilir. Çalışmadaki 720 saatlik örnek ayrıştırma grafiğinde IMF1 yüksek frekanslı ve küçük ölçekli değişimleri, IMF3 orta ölçekli periyodik hareketleri, IMF5 daha yavaş dalgalanmaları, artık bileşen ise genel yük eğilimini göstermektedir. Grafikte okunabilirliği korumak amacıyla bütün IMF’ler gösterilmemiştir.
GEFCom2014 için oluşturulan özellik vektörü şu biçimde tanımlanmıştır:
\[ \mathbf{x}^{EEMD}_t=[c_1(t),\ldots,c_6(t),r(t),temp_t,a^0_t,h^{sin}_t,h^{cos}_t,w^{sin}_t,w^{cos}_t]^{\mathsf{T}}\in\mathbb{R}^{13} \]
Bu vektörde tempt sıcaklık bilgisini, a0t ise dış bilgi taşımayan sıfır değerli uyumluluk kanalını temsil eder:
\[ a^0_t=0 \]
Sıfır kanalının amacı deneyler arasında aynı yardımcı özellik düzenini korumaktır; kanala herhangi bir dış veri yüklenmemiştir.
Saat ve hafta döngüleri nasıl kodlanmıştır?
Saat ve haftanın günü kategorik sayılar olarak değil, sinüs ve kosinüs çiftleriyle döngüsel biçimde kodlanmıştır:
\[ h^{sin}_t=\sin\left(\frac{2\pi\cdot hour_t}{24}\right), \qquad h^{cos}_t=\cos\left(\frac{2\pi\cdot hour_t}{24}\right) \]
\[ w^{sin}_t=\sin\left(\frac{2\pi\cdot weekday_t}{7}\right), \qquad w^{cos}_t=\cos\left(\frac{2\pi\cdot weekday_t}{7}\right) \]
Bu gösterim, örneğin günün 23. saati ile 0. saatinin sayısal olarak uzak görünmesi sorununu azaltır. Sinüs ve kosinüs birlikte kullanıldığında günün veya haftanın döngüsel konumu iki boyutlu olarak korunur.
Küresel kanal yolu nasıl çalışmaktadır?
Küresel yol, her kanalın 168 saatlik giriş penceresindeki ortalama değerini hesaplar:
\[ s^g_c=\frac{1}{L}\sum_{\ell=1}^{L}X_{c,\ell} \]
Bu işlem global average pooling, yani küresel ortalama havuzlama olarak ifade edilmiştir:
\[ \mathbf{s}^{g}=GAP(\mathbf{X})\in\mathbb{R}^{C} \]
Ardından iki katmanlı doğrusal olmayan bir projeksiyon kanal puanlarını üretir:
\[ \mathbf{u}^{g}=\mathbf{W}^{g}_{2}\phi(\mathbf{W}^{g}_{1}\mathbf{s}^{g}+\mathbf{b}^{g}_{1})+\mathbf{b}^{g}_{2} \]
φ, ReLU etkinleştirme işlevidir. Küresel yol, her kanalın pencere boyunca genel düzeyini ve ortalama davranışını özetler; ancak kısa süreli yerel örüntülerin tam konumunu doğrudan korumaz.
Yerel kanal yolu nasıl çalışmaktadır?
Yerel yol, zaman ekseni boyunca bir boyutlu evrişim uygular:
\[ \mathbf{H}^{l}=\phi(Conv1D(\mathbf{X}))\in\mathbb{R}^{C\times L} \]
Bu işlem, ani yükseliş, kısa döngü veya yakın zamanlı dalgalanma gibi yerel zamansal örüntüleri çıkarmayı amaçlar. Evrişim çıktısı zaman boyunca ortalanır:
\[ \mathbf{s}^{l}=GAP(\mathbf{H}^{l})\in\mathbb{R}^{C} \]
Yerel kanal puanı ikinci bir iki katmanlı projeksiyonla hesaplanır:
\[ \mathbf{u}^{l}=\mathbf{W}^{l}_{2}\phi(\mathbf{W}^{l}_{1}\mathbf{s}^{l}+\mathbf{b}^{l}_{1})+\mathbf{b}^{l}_{2} \]
Ablasyon sonuçlarına göre en güçlü doğruluk katkısı bu yerel yoldan gelmiştir.
Küresel ve yerel bilgiler nasıl birleştirilmiştir?
İki yolun katkısı öğrenilebilir bir skalerle birleştirilmiştir:
\[ \alpha=\sigma(a) \]
\[ \mathbf{u}=\alpha\mathbf{u}^{g}+(1-\alpha)\mathbf{u}^{l} \]
σ sigmoid işlevidir. α değeri 1’e yaklaştığında küresel yol, 0’a yaklaştığında yerel yol daha baskın olur. Başlangıç değeri, doğrulama deneylerine dayanarak yerel yolu önceleyecek biçimde ayarlanmış; ancak eğitim sırasında iki yolun oranının öğrenilmesine izin verilmiştir.
Yoğun kanal kapısı şu aralığa sınırlandırılmıştır:
\[ \mathbf{m}=\frac{1}{2}+\frac{1}{2}\sigma(\mathbf{u}), \qquad \mathbf{m}\in(0.5,1)^{C} \]
Yeniden kalibre edilen giriş:
\[ \tilde{\mathbf{X}}=\mathbf{X}\odot\mathbf{m} \]
şeklindedir. ⊙, kanal ağırlığının bütün zaman adımlarına uygulanmasını ifade eder. Çarpanın 0,5 ile 1 arasında tutulması nedeniyle sistem kanalları büyütmekten veya işaretini değiştirmekten çok, daha az yararlı bulunan kanalları yumuşak biçimde zayıflatmaktadır.
Seyrek kapı kanalları tamamen kaldırıyor mu?
Hayır. Çalışmadaki seyrek kapı, kanalları sıfıra indiren sert bir özellik seçimi değildir. Eğitim sırasında Gumbel gürültüsü kullanılır:
\[ \epsilon\sim Gumbel(0,1) \]
Seyrek kapı değeri:
\[ \mathbf{g}=\sigma\left(\frac{\mathbf{u}+b-\tau+\epsilon}{\gamma}\right) \]
ifadesiyle hesaplanır. Burada b öğrenilebilir kaydırma, τ seyrek eşik, γ ise sıcaklık parametresidir.
Yumuşak kapı çarpanı:
\[ \mathbf{m}^{SG}=\frac{1}{2}+\frac{1}{2}\mathbf{g} \]
\[ \tilde{\mathbf{X}}_{SG}=\mathbf{X}\odot\mathbf{m}^{SG} \]
şeklindedir. Bu nedenle en zayıf kanallar bile en az 0,5 çarpanıyla korunur. Seyreklik düzeyi ise 0,5’in altında kapı değeri alan kanalların oranı olarak raporlanmıştır:
\[ S=\frac{1}{C}\sum_{c=1}^{C}\mathbb{I}(g_c<0.5) \]
Bu tasarım, yorumlanabilir kanal bastırması sağlarken gradyan akışını sürdürmeyi ve aşırı agresif özellik silmeyi önlemeyi amaçlamaktadır.
GRU tahmin başlığı nasıl çalışmaktadır?
Yeniden kalibre edilen özellik matrisi zaman sıralı biçime dönüştürülür:
\[ \tilde{\mathbf{X}}^{\mathsf{T}}\in\mathbb{R}^{L\times C} \]
İki katmanlı GRU, her zaman adımında gizli durumu günceller:
\[ \mathbf{h}_{\ell}=GRU(\tilde{\mathbf{x}}_{\ell},\mathbf{h}_{\ell-1}), \qquad \ell=1,\ldots,L \]
Son gizli durum 24 saatlik çıktı uzayına doğrusal olarak yansıtılır:
\[ \hat{\mathbf{y}}_t=\mathbf{W}_{o}\mathbf{h}_{L}+\mathbf{b}_{o} \]
Model böylece 24 farklı saati tek bir çok adımlı çıktı vektörü içinde tahmin etmektedir.
Hangi veri setleri kullanılmıştır?
| Veri seti | Dönem ve kapsam | Kullanılan özellikler | Deney amacı |
|---|---|---|---|
| GEFCom2014 Zone 1 | 2005-2010 arasında 50.376 saatlik gözlem | Yük, sıcaklık, zaman kodları ve EEMD bileşenleri | Standart benchmark üzerinde doğruluk ve parametre verimliliği |
| PJM-CE-pre | 2017-2019 | Yük ve zaman bilgileri | Pandemi öncesi gerçek işletme verisinde dayanıklılık |
| PJM-CE-post | 2023-2025 | Yük ve zaman bilgileri | Pandemi sonrası gerçek işletme verisinde dayanıklılık |
| PJM-AEPOPT-pre | 2017-2019 | Yük ve zaman bilgileri | Farklı yük ölçeği ve bölgesel yapı |
| PJM-AEPOPT-post | 2023-2025 | Yük ve zaman bilgileri | Farklı dönem ve bölgesel yapı |
PJM alanları, kaydırmalı pencerelerin çok yıllı boşlukları aşmasını önlemek ve pandemi dönemini diğer dönemlerle karıştırmamak amacıyla iki ayrı sürekli döneme bölünmüştür. Her alt küme bağımsız olarak değerlendirilmiştir.
GEFCom2014 sıcaklık bilgisi içerirken PJM deneylerinde hava değişkeni kullanılmamıştır. Çalışma EEMD tabanlı modeller için 13 giriş kanalı bildirmektedir; ancak PJM deneylerinde sıcaklık kanalının ortak kanal düzeni içinde tam olarak nasıl ikame edildiği ayrıntılı bir kanal listesiyle yeniden açıklanmamıştır.
Performans ölçütleri ne anlama gelmektedir?
Ortalama mutlak yüzde hata:
\[ MAPE=\frac{100}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}\left|\frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}}\right| \]
MAPE, tahmin hatasını gerçek değerin yüzdesi olarak verir. Daha düşük değer daha iyi performans anlamına gelir.
Kök ortalama karesel hata:
\[ RMSE=\sqrt{\frac{1}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2} \]
RMSE büyük hataları karesel işlem nedeniyle daha güçlü biçimde cezalandırır. Çalışma RMSE ve MAE değerlerinin fiziksel yük birimini tabloda açıkça belirtmemiştir; bu nedenle değerler kaynak veri ölçeğinde değerlendirilmelidir.
Ortalama mutlak hata:
\[ MAE=\frac{1}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}|y_{i,h}-\hat{y}_{i,h}| \]
Belirleme katsayısı:
\[ R^2=1-\frac{\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2}{\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\bar{y})^2} \]
R² değeri 1’e yaklaştıkça model gözlenen değişimin daha büyük bölümünü açıklamaktadır. Negatif R², modelin ortalama değer tahmininden bile zayıf kalabildiğini gösterir.
Bir temel modele göre göreli iyileşme şu şekilde hesaplanmıştır:
\[ RI=\frac{M_{baseline}-M_{model}}{M_{baseline}}\times100\% \]
Burada M, MAPE, RMSE veya MAE gibi daha düşük olması tercih edilen bir hata ölçütüdür.
GEFCom2014 sonuçları ne göstermektedir?
GEFCom2014 üzerinde en düşük MAPE değeri %7,76 ile LocalOnly modelinde elde edilmiştir. Seyrek kapılı tam EEMD-DCA-GRU-SG modeli %7,90 MAPE ile ikinci güçlü sonuç grubunda yer almış ve EEMD-GRU, GRU, Informer ve PatchTST modellerinden daha düşük hata üretmiştir.
| Model | MAPE (%) | RMSE | MAE | R² |
|---|---|---|---|---|
| NaiveMean | 26,59 ± 0,00 | 57,28 ± 0,00 | 45,07 ± 0,00 | -0,1848 |
| NaivePersistence | 24,34 ± 0,00 | 50,81 ± 0,00 | 38,18 ± 0,00 | 0,0676 |
| NaiveLastDay | 11,45 ± 0,00 | 26,11 ± 0,00 | 18,52 ± 0,00 | 0,7538 |
| XGBoost | 8,68 ± 0,00 | 20,98 ± 0,00 | 14,51 ± 0,00 | 0,8411 |
| GRU | 8,52 ± 0,08 | 20,47 ± 0,23 | 14,17 ± 0,15 | 0,8487 |
| LSTM | 9,24 ± 0,11 | 21,76 ± 0,25 | 15,37 ± 0,21 | 0,8290 |
| CNN-LSTM | 8,91 ± 0,14 | 21,12 ± 0,46 | 14,76 ± 0,26 | 0,8388 |
| DCA-GRU-SG, EEMD olmadan | 8,55 ± 0,07 | 20,31 ± 0,24 | 14,23 ± 0,17 | 0,8509 |
| Informer | 8,36 ± 0,08 | 19,86 ± 0,32 | 13,75 ± 0,23 | 0,8575 |
| PatchTST | 8,49 ± 0,06 | 19,95 ± 0,18 | 13,86 ± 0,13 | 0,8563 |
| EEMD-GRU | 8,34 ± 0,23 | 17,96 ± 0,53 | 13,41 ± 0,40 | 0,8834 |
| GlobalOnly | 7,88 ± 0,10 | 16,77 ± 0,17 | 12,46 ± 0,12 | 0,8984 |
| LocalOnly | 7,76 ± 0,08 | 16,60 ± 0,10 | 12,28 ± 0,13 | 0,9005 |
| EEMD-DCA-GRU, yoğun kapı | 8,20 ± 0,18 | 17,70 ± 0,39 | 13,23 ± 0,28 | 0,8868 |
| EEMD-DCA-GRU-SG, seyrek kapı | 7,90 ± 0,10 | 16,78 ± 0,17 | 12,46 ± 0,12 | 0,8983 |
Sonuçlar iki ayrı mesaj vermektedir. Birincisi, EEMD sonrasında kanal yeniden kalibrasyonu benchmark doğruluğunu artırabilmektedir. İkincisi, tam küresel-yerel birleşim her zaman en iyi yapı değildir. En iyi sonuç, yalnızca yerel yolu kullanan ablasyon modelinden gelmiştir.
Parametre ve hesaplama verimliliği nasıldır?
| Model | Eğitilebilir parametre | Eğitim süresi (dakika) | Örnek başına çıkarım (ms) | MAPE (%) |
|---|---|---|---|---|
| GRU | 161,5 bin | 1,33 | 0,0055 | 8,52 |
| Informer | 2,41 milyon | 4,50 | 0,0757 | 8,36 |
| PatchTST | 615,5 bin | 1,89 | 0,0139 | 8,49 |
| EEMD-GRU | 163,8 bin | 1,78 | 0,0057 | 8,34 |
| GlobalOnly | 167,5 bin | 4,35 | 0,0124 | 7,88 |
| LocalOnly | 167,5 bin | 3,68 | 0,0120 | 7,76 |
| EEMD-DCA-GRU | 167,5 bin | 4,74 | 0,0127 | 8,20 |
| EEMD-DCA-GRU-SG | 167,5 bin | 4,09 | 0,0127 | 7,90 |
Seyrek kapılı tam model, Informer’ın yaklaşık onda birinden daha az parametreyle daha düşük benchmark MAPE değeri üretmiştir. Buna karşılık EEMD ve kanal yeniden kalibrasyonu, temel GRU’ya göre eğitim ve çıkarım maliyetini artırmıştır. Ayrıca tabloda verilen eğitim süreleri aynı iş istasyonunda ölçülmüş olsa da donanım özellikleri çalışmada ayrıntılı olarak bildirilmemiştir; bu nedenle süreler farklı sistemlere doğrudan taşınmamalıdır.
Ablasyon deneyleri hangi bileşenin etkili olduğunu göstermektedir?
| Model varyantı | MAPE (%) | RMSE | Seyreklik | Parametre |
|---|---|---|---|---|
| EEMD-GRU | 8,34 ± 0,23 | 17,96 ± 0,53 | 0,000 | 163,8 bin |
| GlobalOnly | 7,88 ± 0,10 | 16,77 ± 0,17 | 0,265 | 167,5 bin |
| LocalOnly | 7,76 ± 0,08 | 16,60 ± 0,10 | 0,106 | 167,5 bin |
| EEMD-DCA-GRU | 8,20 ± 0,18 | 17,70 ± 0,39 | 0,000 | 167,5 bin |
| EEMD-DCA-GRU-SG | 7,90 ± 0,10 | 16,78 ± 0,17 | 0,145 | 167,5 bin |
LocalOnly modeli EEMD-GRU’ya göre MAPE değerini ortalama 0,579 yüzde puan azaltmış ve eşleştirilmiş t-testinde p = 0,0063 sonucu vermiştir. Seyrek kapılı tam modelde ortalama azalma 0,438 yüzde puan, göreli iyileşme %5,21 ve p = 0,0051 olarak bildirilmiştir. Yoğun NoSparse modelin iyileşmesi yalnızca 0,135 yüzde puandır ve istatistiksel olarak anlamlı bulunmamıştır; p = 0,2061.
Ancak deneyler yalnızca beş rastgele başlangıca dayanmaktadır. Yazar, Wilcoxon testinin beş örnekle sınırlı çözünürlüğe sahip olduğunu ve istatistiksel testlerin sıralama tutarlılığı ile etki büyüklükleriyle birlikte yorumlanması gerektiğini açıkça belirtmektedir.
PJM sonuçları modelin genellenebilirliği hakkında ne söylemektedir?
| PJM alt kümesi | GRU RMSE / R² | EEMD-GRU RMSE / R² | Yoğun EEMD-DCA-GRU RMSE / R² | Ana sonuç |
|---|---|---|---|---|
| CE-pre | 751,88 / 0,8625 | 756,44 / 0,8608 | 782,79 / 0,8509 | GRU daha başarılıdır. |
| CE-post | 716,31 / 0,8831 | 684,77 / 0,8932 | 676,41 / 0,8958 | Yoğun EEMD-DCA-GRU en iyi sonucu vermiştir. |
| AEPOPT-pre | 334,08 / 0,9092 | 434,46 / 0,8458 | 423,07 / 0,8529 | Ana özet tabloda GRU daha başarılıdır. |
| AEPOPT-post | 406,77 / 0,8552 | 353,57 / 0,8906 | 361,76 / 0,8853 | EEMD-GRU en iyi sonucu vermiştir. |
Çalışma metni, daha kapsamlı tamamlayıcı sonuçlarda AEPOPT-pre için seyrek kapılı EEMD-DCA-GRU-SG modelinin en düşük RMSE değerini verdiğini bildirmektedir. Ancak bu modelin söz konusu sayısal RMSE değeri ana belgede yer alan özet Tablo 3 içinde gösterilmemiştir. Bu nedenle metindeki sıralama aktarılabilir, fakat eksik değer tahmin edilmemelidir.
PJM bulguları modelin evrensel üstünlük sağlamadığını göstermektedir. Ayrıştırma bazı bölgelerde yapısal hata ölçütlerini iyileştirirken bazı bölgelerde yalın GRU veya yalnızca EEMD kullanan model daha başarılıdır. Kanal yeniden kalibrasyonunun yararı yük alanına ve döneme bağlıdır.
Kanal önem grafiği ne göstermektedir?
Seyrek kapılı modelin kanal önem grafiğinde IMF ve artık kanalların büyük bölümü yüksek tutulma puanları almıştır. Özellikle IMF5, artık bileşen, IMF4 ve IMF6 üst sıralarda görünmektedir. Gün içi döngüyü temsil eden saat sinüs ve kosinüs özellikleri de yüksek önem kazanmıştır.
Haftanın günü kodları daha düşük puan almıştır. Grafik üzerinden yaklaşık olarak weekday_sin kanalının sıfıra oldukça yakın, weekday_cos kanalının ise diğer zaman özelliklerinden belirgin biçimde düşük olduğu görülmektedir. Bu sonuç, fitted model içinde EEMD bileşenleri ve günlük döngünün haftalık kodlara kıyasla daha fazla korunduğunu göstermektedir; ancak önem puanları nedensel etki veya genel geçer fiziksel önem olarak yorumlanmamalıdır.
Tahmin grafikleri model davranışını nasıl açıklamaktadır?
168 ardışık test adımındaki yuvarlanan bir saatlik tahmin grafiği, EEMD tabanlı modellerin düşük frekanslı yük eğilimini GRU ve Informer’a göre daha düzenli izlediğini göstermektedir. Buna karşılık yaklaşık 75-100. test adımları arasındaki hızlı ve yüksek genlikli değişimlerde bütün modellerin mutlak hataları yükselmektedir.
24 saatlik örnek tahmin grafiğinde EEMD-GRU ve EEMD-DCA-GRU daha yumuşak eğriler üretmektedir. Bu yumuşatma, genel günlük eğilimin yakalanmasına yardımcı olurken gerçek serideki keskin saatlik tepe ve çukurların eksik temsil edilmesine de yol açabilmektedir. Grafik, modelin her tahmin saatinde üstün olduğunu değil, daha kararlı ve düşük frekans odaklı tahminler ürettiğini desteklemektedir.
Çevrim içi ve nedensel kullanımda ne olmuştur?
Ana deneylerde EEMD, veri kronolojik olarak eğitim, doğrulama ve test kümelerine ayrıldıktan sonra her küme üzerinde uygulanmıştır. Bu yaklaşım, normalizasyon ve ayrıştırma ayarlarının farklı veri kümeleri arasında birlikte öğrenilmesini önlemektedir; ancak her tahmin anında yalnızca geçmiş gözlemlerin kullanılabildiği katı çevrim içi sistemle aynı değildir.
Yazar, bu sınırlılığı incelemek için yalnızca tahmin anına kadar olan tarihsel ön eki kullanan küçük bir nedensel EEMD deneyi gerçekleştirmiştir:
| Model | Nedensel ön ek MAPE (%) | Nedensel ön ek RMSE | Yorum |
|---|---|---|---|
| EEMD-GRU | 16,01 | 32,45 | Karşılaştırma tabanı |
| EEMD-DCA-GRU | 16,06 | 33,50 | Tabandan daha iyi değildir. |
| EEMD-DCA-GRU-SG | 16,21 | 33,11 | Tabandan daha iyi değildir. |
Bu tanı deneyi, günlük aralıklarla seçilen 30 tahmin başlangıcı ve yalnızca 10 EEMD topluluk denemesiyle yapılmıştır. Tek yönlü eşleştirilmiş Wilcoxon testleri iki DCA varyantı için de anlamlı bulunmamıştır. Dolayısıyla çevrim dışı benchmark başarısı katı nedensel çevrim içi uygulamaya doğrudan aktarılmamaktadır.
Çalışmanın desteklediği sonuçlar nelerdir?
- EEMD sonrasında kanal yeniden kalibrasyonu GEFCom2014 benchmark verisinde tahmin hatasını azaltabilmektedir.
- Yerel zamansal kanal yolu, benchmark deneyinde en güçlü bireysel doğruluk katkısını sağlamıştır.
- Seyrek kapı, tam küresel-yerel modelde yoğun kapıya göre daha iyi sonuç vermiş ve kanal düzeyinde yorumlanabilir bastırma sağlamıştır.
- Önerilen modeller, Transformer tabanlı karşılaştırmalardan belirgin biçimde daha az eğitilebilir parametre kullanmıştır.
- EEMD tabanlı yöntemler bazı PJM alt kümelerinde RMSE ve R² sonuçlarını iyileştirmiştir.
Çalışma neyi kanıtlamamaktadır?
- Önerilen modelin bütün elektrik şebekelerinde veya bütün veri setlerinde en iyi yöntem olduğu kanıtlanmamıştır.
- Tam seyrek kapılı model benchmark üzerinde en düşük hatayı vermemiştir; LocalOnly daha başarılıdır.
- Çevrim dışı EEMD sonuçları gerçek zamanlı çevrim içi başarı kanıtı değildir.
- Model Türkiye elektrik sistemi üzerinde doğrulanmamıştır.
- Çalışma ekonomik tasarruf, üretim maliyeti düşüşü veya saha işletme başarısı ölçmemiştir.
- Olasılıksal tahmin veya tahmin belirsizliği aralıkları değerlendirilmemiştir.
- Kanal önem puanları fiziksel nedensellik kanıtı değildir.
- Beş rastgele başlangıçtan elde edilen istatistiksel sonuçlar geniş örneklemli bir belirsizlik analizi yerine geçmez.
Güçlü yönler ve sınırlılıklar nelerdir?
Güçlü yönler:
- Model bileşenlerinin etkisi GlobalOnly, LocalOnly, yoğun kapı ve seyrek kapı ablasyonlarıyla ayrı ayrı incelenmiştir.
- Benchmark veri setine ek olarak farklı dönemlere ayrılan gerçek PJM yük serileri kullanılmıştır.
- Sonuçlar beş rastgele başlangıcın ortalama ve standart sapmalarıyla raporlanmıştır.
- Doğrulukla birlikte parametre, eğitim süresi ve çıkarım süresi karşılaştırılmıştır.
- Yazar, modelin başarısız veya sınırlı kaldığı PJM ve nedensel çevrim içi sonuçlarını da açıkça sunmuştur.
Temel sınırlılıklar:
- Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir.
- Ana EEMD protokolü katı çevrim içi nedensel ayrıştırmayla aynı değildir.
- Nedensel ön ek deneyinde DCA varyantları EEMD-GRU’yu geçmemiştir.
- EEMD işlemi ham GRU modellerine göre ek ön işleme maliyeti yaratmaktadır.
- PJM deneyleri yalnızca CE ve AEPOPT alanlarıyla sınırlıdır.
- PJM verisinde hava değişkenleri kullanılmamıştır.
- İstatistiksel karşılaştırma yalnızca beş rastgele başlangıca dayanmaktadır.
- Tamamlayıcı PJM tablosundaki bazı sonuçların sayısal değerleri ana belgede verilmemiştir.
- Kod, işlenmiş veri bölümleri ve eğitimli modeller doğrudan bağlantıyla yayımlanmamış; yazarın makul talep üzerine sunabileceği belirtilmiştir.
Çalışmanın Yöntemi ve Bulguları
Deney düzeninin teknik özeti
| Deney unsuru | Uygulanan değer veya yöntem |
|---|---|
| Tahmin görevi | Geçmiş 168 saatten sonraki 24 saatin tahmini |
| Veri bölme | Kronolojik %70 eğitim, %15 doğrulama, %15 test |
| EEMD bileşenleri | 6 IMF ve 1 artık bileşen |
| EEMD topluluk denemesi | Ana deneylerde 100 |
| Derin öğrenme altyapısı | PyTorch |
| Optimizasyon | Adam |
| Öğrenme oranı | 1 × 10⁻⁴ |
| Mini parti büyüklüğü | 64 |
| Durdurma | Doğrulama kaybına göre erken durdurma |
| Tekrar sayısı | Her derin model için 5 rastgele başlangıç |
| Tahmin başlığı | İki katmanlı GRU ve doğrusal 24 saatlik çıktı |
| Değerlendirme ölçütleri | MAPE, RMSE, MAE ve R² |
Karşılaştırılan modeller
- Ortalama, süreklilik ve son gün değerini kullanan naif tahminciler
- XGBoost
- GRU, LSTM ve CNN-LSTM
- Informer ve PatchTST
- EEMD-GRU
- EEMD kullanılmadan çalışan DCA-GRU-SG
- GlobalOnly ve LocalOnly ablasyonları
- Yoğun EEMD-DCA-GRU
- Seyrek kapılı EEMD-DCA-GRU-SG
Ana bulguların teknik özeti
- Benchmark doğruluğu: LocalOnly modeli GEFCom2014 üzerinde %7,76 MAPE, 16,60 RMSE, 12,28 MAE ve 0,9005 R² elde etmiştir.
- Tam seyrek model: EEMD-DCA-GRU-SG %7,90 MAPE ve 16,78 RMSE üretmiştir.
- Ayrıştırma etkisi: EEMD-GRU, ham GRU’ya göre MAPE’de sınırlı; RMSE, MAE ve R² ölçütlerinde daha belirgin iyileşme sağlamıştır.
- Yerel yolun etkisi: LocalOnly, GlobalOnly ve iki birleşik varyanttan daha düşük hata vermiştir.
- Seyrek kapının etkisi: Tam birleşik modelde seyrek kapı, yoğun varyantın MAPE değerini %8,20’den %7,90’a düşürmüştür.
- Parametre verimliliği: Tam seyrek model 167,5 bin parametre kullanırken Informer 2,41 milyon, PatchTST 615,5 bin parametre kullanmıştır.
- PJM sınırları: CE-pre ve ana AEPOPT-pre özetinde GRU; CE-post’ta yoğun EEMD-DCA-GRU; AEPOPT-post’ta EEMD-GRU daha başarılıdır.
- Çevrim içi sınır: Nedensel ön ek testinde DCA varyantları EEMD-GRU’ya göre anlamlı bir iyileşme üretmemiştir.
Uygulama açısından sonuç
Çalışma, kısa vadeli yük tahmininde model büyüklüğünü artırmak yerine sinyal yapısını ayrıştırmanın ve giriş kanallarını seçici biçimde zayıflatmanın etkili olabileceğini göstermektedir. Bununla birlikte en iyi benchmark yapı, önerilen tam küresel-yerel model değil, yalnızca yerel yeniden kalibrasyon yoludur. Bu durum daha karmaşık birleşimin otomatik olarak daha iyi sonuç vermediğini ortaya koymaktadır.
Gerçek zamanlı uygulama için modelin yalnızca geçmiş verileri kullanan yuvarlanan veya pencere bazlı EEMD ile yeniden eğitilmesi gerekir. EEMD hesaplama yükünün, veri geldiği anda tahmin üretmesi gereken sistemlerde ayrıca ölçülmesi zorunludur. Çalışmanın mevcut sonuçları çevrim dışı benchmark başarısını desteklemekte, fakat hazır bir saha sistemi veya gerçek zamanlı işletme başarısı sunmamaktadır.
Kaynak ve Yöntem Notu
- Çalışmanın tam özgün adı: Decomposition-Aware Channel Recalibration for Lightweight Short-Term Load Forecasting
- Yazar: Jiezhuo Zhang
- Yazar sıralaması: Tek yazarlı çalışma
- Eş birinci yazar: Bulunmamaktadır.
- Sorumlu yazar: Jiezhuo Zhang
- Kurum: School of Information Science and Engineering, East China University of Science and Technology, Shanghai 200237, China
- DOI:10.2139/ssrn.7192485
- Dergi: Hakemli bir dergi bilgisi bulunmamaktadır.
- Yayın platformu: SSRN
- Platform işletmecisi: Elsevier Inc.
- Yayın yılı: 2026
- SSRN kayıt tarihi: 27 Temmuz 2026
- Kaynak türü: Modelleme ve veri analizi içeren preprint araştırma çalışması
- Hakemlik durumu: Bu çalışma bir preprinttir ve hakem değerlendirmesinden geçmemiştir.
- Resmî çalışma bağlantısı:SSRN resmî çalışma sayfası
Bu Türkçe açıklama, yüklenen çalışmanın metni, formülleri, tabloları, mimari şeması, ayrıştırma grafikleri, ablasyon sonuçları, PJM karşılaştırmaları, kanal önem grafiği ve tahmin görselleri incelenerek hazırlanmıştır. Çalışmada bulunmayan yeni bir deney sonucu, bilimsel başarı iddiası veya dış kaynaktan alınmış bilimsel bulgu eklenmemiştir. Dış kaynak kontrolü yalnızca DOI, SSRN tarihi, platform ve yayın durumu gibi bibliyografik kimlik bilgilerinin doğrulanması için kullanılmıştır.
Çalışmanın başlıca sınırlılıkları; hakem değerlendirmesinden geçmemesi, ana EEMD değerlendirmesinin katı çevrim içi nedensel protokolle aynı olmaması, nedensel ön ek testinde DCA kazancının doğrulanmaması, EEMD’nin hesaplama maliyeti, yalnızca iki PJM alanının kullanılması, PJM deneylerinde hava verisinin bulunmaması ve istatistiksel deneylerin beş rastgele başlangıçla sınırlı olmasıdır.
Yazar, herhangi bir rekabet eden finansal çıkar veya kişisel ilişki bildirmemiş ve araştırmanın kamu, ticari ya da kâr amacı gütmeyen fon kuruluşlarından özel bir destek almadığını belirtmiştir. GEFCom2014 ve PJM Data Miner verileri kamuya açık kaynaklardan alınmıştır; işlenmiş veri bölümleri, kod ve eğitimli model çıktılarının makul talep üzerine sunulabileceği ifade edilmiştir.
Çalışmanın yapay zekâ beyanına göre OpenAI ChatGPT ve Codex; dil iyileştirmesi, kod incelemesi, belge biçimlendirmesi ve tutarlılık kontrollerinde kullanılmıştır. Yazar, yapay zekâ destekli çıktıları sonradan gözden geçirip düzenlediğini, deneysel işlemleri ve sonuçları bağımsız olarak doğruladığını ve yayının içeriğine ilişkin sorumluluğu üstlendiğini bildirmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir