

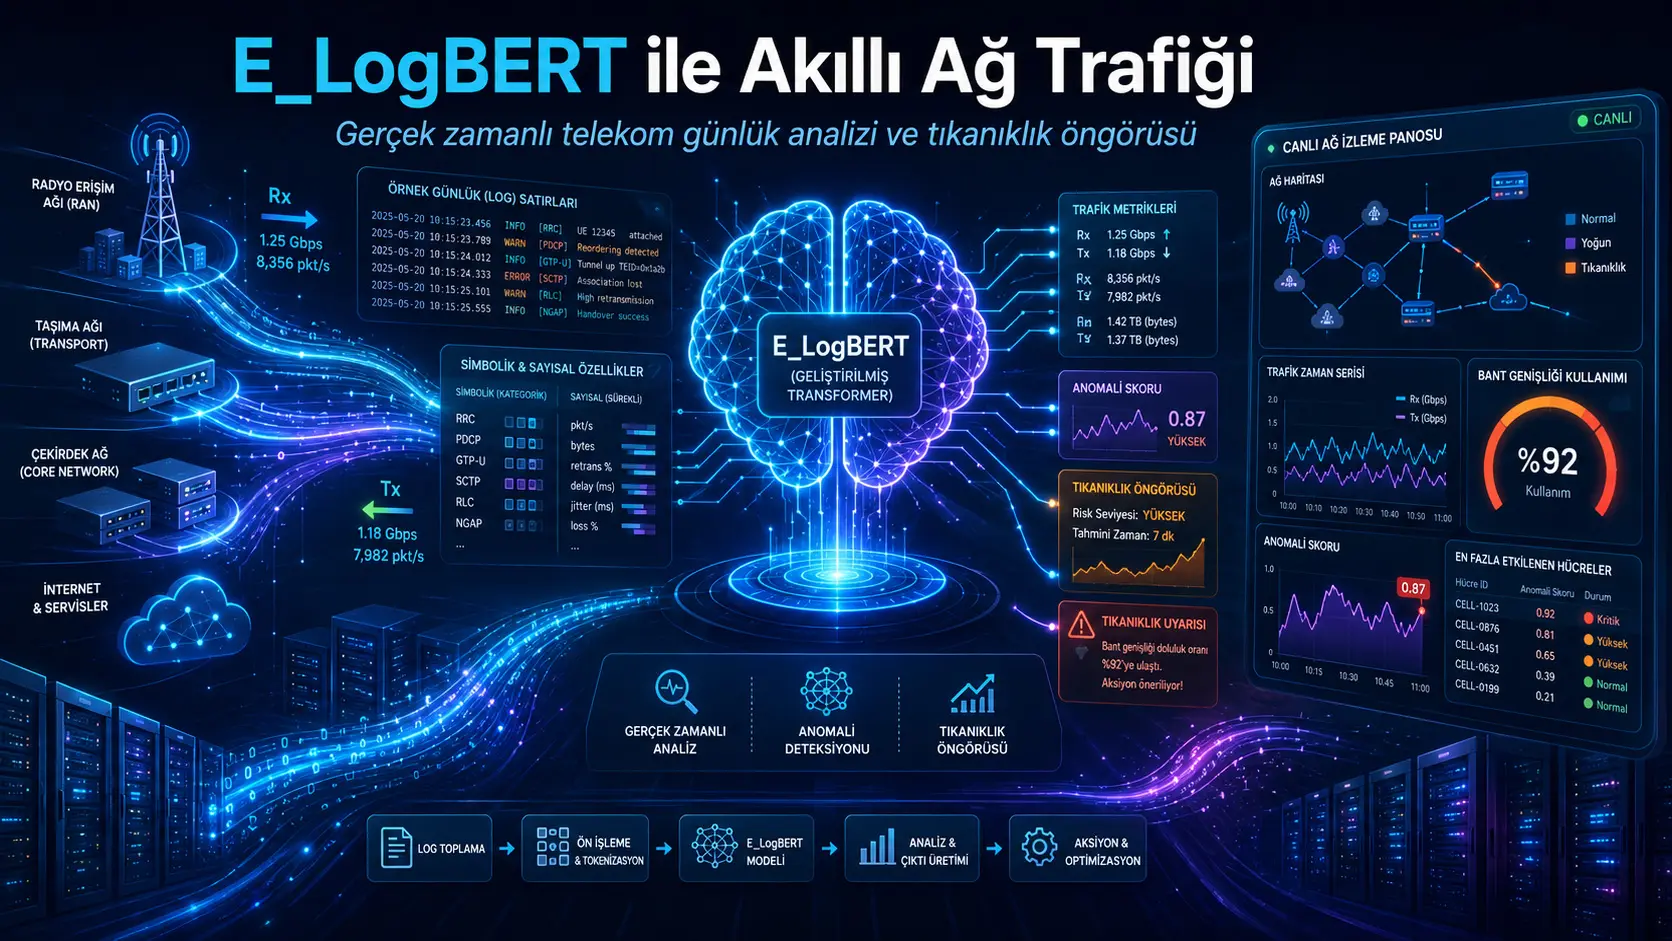
Bu çalışma, telekom ağlarında üretilen günlüklerdeki olay adlarını ve sayısal trafik değerlerini birlikte işlemek amacıyla E_LogBERT adlı öz-denetimli bir yapay zekâ yaklaşımı geliştirmiştir. Araştırmacılar, bmon aracından her iki saniyede bir alınan 45 alım–gönderim metriğini zaman damgalı açıklayıcı cümlelere dönüştürmüş; yedi gün boyunca 13.608.000 günlük satırı ve 27.216.000 sembolik-sayısal belirteç toplamıştır. Model, sembolik metrik kimliğini BERT gömmesiyle, dinamik olarak normalleştirilmiş sayısal değeri ise öğrenilebilir bir doğrusal katmanla aynı 768 boyutlu uzayda birleştirmektedir. Çalışmada E_LogBERT için %92 doğruluk, %90 kesinlik, %89 duyarlılık, %89,5 F1 ve %96 AUC bildirilmiştir. Ancak tıkanıklık etiketlerinin nasıl oluşturulduğu, eğitim ve bağımsız test verilerinin nasıl ayrıldığı, sonuçların kaç tekrarın ortalaması olduğu ve sistemin tıkanıklığı ne kadar önceden öngördüğü açıklanmamıştır.
Yaklaşımın temel farkı, klasik LogBERT modellerinde çoğu zaman silinen veya tek bir [NUM] belirtecine indirgenen sayısal büyüklükleri korumaya çalışmasıdır. Örneğin modelin yalnızca “Bytes_Rx” olayını değil, bu metriğin güncel değerinin olağan aralığın neresinde olduğunu da öğrenmesi hedeflenmektedir. E_LogBERT normal günlüklerde maskelenen metrikleri tahmin eden Masked Log Key Prediction ve normal ağ pencerelerini ortak bir gömme merkezi çevresinde toplayan Volume of Hypersphere Minimization hedefleriyle eğitilmektedir. Anomali puanı bu iki sinyalin birleşiminden üretilmektedir.
Türkiye açısından değerlendirme: Çalışmanın yaklaşımı Türkiye’deki telekom operatörleri, internet servis sağlayıcıları, veri merkezleri, kurumsal ağlar, belediye ağ altyapıları ve ağ operasyon merkezlerinde trafik yoğunluğu ile performans sapmalarının erken izlenmesi için araştırılabilir. Uygulamaya geçmeden önce modelin gerçek operatör ağlarından alınmış ve kişisel verilerden arındırılmış günlüklerle; farklı cihaz üreticileri, 4G–5G çekirdek ağları, sabit erişim sistemleri, IPv4–IPv6 trafiği ve farklı yoğunluk dönemlerinde doğrulanması gerekir. Gerçek tıkanıklık başlangıcı, tahmin ufku, yanlış alarm maliyeti ve müdahalenin hizmet kalitesine etkisi açık biçimde ölçülmelidir. Çalışma Türkiye’deki bir operatörde saha deneyi, ulusal ağ verisi, üretim ortamı güvenilirliği veya siber saldırı tespit başarısı sunmadığından ülkeye özgü başarı oranı doğrudan çıkarılamaz.
Telekom ağ günlükleri neden zor bir veri türüdür?
Modern iletişim ağlarında yönlendiriciler, sanal ağ işlevleri, güvenlik duvarları, ses platformları ve izleme araçları sürekli günlük üretmektedir. Bu günlükler yalnızca “olay gerçekleşti” bilgisini değil; alınan ve gönderilen bayt miktarı, paket sayısı, düşürülen paket, CRC hatası, yeniden birleştirme sorunu ve çok noktaya yayın trafiği gibi sürekli değişen sayısal değerleri de taşır.
Çalışmanın çıkış noktası, geleneksel günlük analiz modellerinin önemli bir bölümünün sayısal değerleri:
- tamamen kaldırması,
- tek bir
[NUM]belirtecine dönüştürmesi, - metinden bağımsız ayrı istatistikler olarak işlemesi
nedeniyle miktar bilgisini kaybetmesidir. “Bytes_Rx = 100” ile “Bytes_Rx = 100.000” aynı sembolik olayı temsil etse de ağın durumu açısından aynı anlama gelmez. Tıkanıklık ve bazı güvenlik olayları çoğu zaman olay adından değil, değerlerin büyüklüğü ve zaman içindeki değişiminden anlaşılabilir.
LogBERT’in temel yaklaşımı nedir?
LogBERT, günlük dizilerini doğal dil cümlelerine benzetir. Bir günlük olayını sözcük, zaman içinde art arda gelen günlükleri ise cümle veya dizi olarak ele alır. BERT’in çift yönlü dikkat mekanizması sayesinde bir olayın hem önceki hem de sonraki olaylarla ilişkisi öğrenilebilir.
Çalışmada LogBERT’in iki öz-denetimli hedefi temel alınmıştır:
- Masked Log Key Prediction: Dizideki bazı günlük anahtarları maskelenir ve modelden bağlama bakarak eksik anahtarı tahmin etmesi istenir.
- Volume of Hypersphere Minimization: Normal kabul edilen günlük dizilerinin genel gömmeleri ortak bir merkez çevresinde sıkıştırılır.
Normal örüntülerden ayrılan yeni dizilerin maskeli tahmin doğruluğunun düşmesi veya gömme merkezinden uzaklaşması anomali işareti olarak kullanılmaktadır.
E_LogBERT hangi boşluğu hedeflemektedir?
Araştırmacılara göre ana boşluk, sembolik günlük anahtarlarıyla ilişkili sürekli değerlerin aynı bağlamsal model içinde işlenememesidir. E_LogBERT aşağıdaki dört katkıyı öne sürmektedir:
- Ham bmon çıktılarını zaman damgalı açıklayıcı günlük cümlelerine dönüştürmek,
- Değişen trafik dağılımına göre dinamik min–maks normalleştirme yapmak,
- Sembolik ve sayısal girdiler için MLKP ile VHM hedeflerini birlikte kullanmak,
- Veri toplama, eğitim, anomali puanlama, alarm ve görselleştirmeyi 13 modülde birleştirmek.
Veriler nasıl toplanmıştır?
Ağ istatistikleri Linux sistemlerinde çalışan bmon, yani Bandwidth Monitor aracıyla elde edilmiştir. bmon her ağ arabirimi için 45 farklı metrik sağlamaktadır. Her metriğin alınan trafik için Rx ve gönderilen trafik için Tx değeri bulunduğundan her ölçüm turunda toplam 90 sembolik metrik oluşmaktadır.
Ölçülen metriklerden bazıları şunlardır:
- Bytes ve Packets,
- Dropped ve Errors,
- CRC Error, Frame Error ve FIFO Error,
- Collisions ve Carrier Error,
- IPv6 paket, teslim, yönlendirme ve yeniden birleştirme sayaçları,
- Multicast ve ICMPv6 göstergeleri.
Veri toplama betiği her dakikanın başlangıcına eşitlenmekte, 60 saniyelik başlangıç kararlılığı beklemekte ve WANbridge arabiriminden iki saniyede bir 45 satır okumaktadır. Her satır şu genel kalıba dönüştürülmektedir:
[zaman damgası]: Arabirim: Metric_Rx değeri X iken Metric_Tx değeri Y.
Beşinci sayfadaki Şekil 1, solda bmon’un sütunlu ve insan tarafından yorumlanması zor ham çıktısını, sağda ise her ölçümü zaman damgalı cümleye dönüştüren biçimlendirilmiş günlükleri göstermektedir. Bu işlem metrik adını, trafik yönünü, birimi ve sayısal değeri korumaktadır.
Test ortamı gerçek bir operatör ağı mıydı?
Hayır. Çalışma gerçekçi bir test ortamı kurmuştur; ancak veri ticari bir mobil operatörün üretim ağından alınmamıştır. Unified Telecom Platform olarak adlandırılan düzenek şu bileşenlerden oluşmaktadır:
- Zorin OS kullanan fiziksel ana makine,
- 8 çekirdekli 3,0 GHz işlemci,
- 32 GB RAM ve 200 GB SSD,
- 16 GB belleğe sahip NVIDIA T4 GPU,
- KVM/QEMU tabanlı sanal makine yöneticisi,
- internet servis sağlayıcı geçidi rolündeki pfSense sanal makinesi,
- VoIP operatör platformu rolündeki Issabel sanal makinesi,
- iki sanal makineyi bağlayan ve izlenen WANbridge arabirimi.
On beşinci sayfadaki Şekil 6, iki sanal makine üzerinde çalışan sanallaştırılmış ağ işlevlerini, yerel ağ erişimini ve geniş alan ağı bağlantısını göstermektedir. Bu yapı kontrollü deney yapılmasına izin vermektedir; ancak gerçek operatör ağındaki cihaz çeşitliliği, kullanıcı davranışı, protokol karmaşıklığı ve ölçek aynı düzeyde temsil edilmemektedir.
Veri kümesinin büyüklüğü
| Veri özelliği | Çalışmada bildirilen değer |
|---|---|
| Toplama süresi | 168 saat, 7 gün |
| Ölçüm aralığı | 2 saniye |
| Her ölçümde günlük satırı | 45 |
| Günlük satır sayısı | 1.944.000 |
| Yedi günlük satır sayısı | 13.608.000 |
| Satır başına sayısal yön | Rx ve Tx olmak üzere 2 |
| Toplam karma belirteç | 27.216.000 |
| On saniyelik dizi sayısı | 60.480 |
Her iki saniyelik ölçümde 45 satır ve 90 Rx/Tx değeri oluşmaktadır. Beş ölçüm turu birleştirilerek on saniyelik 450 belirteçlik pencere hazırlanmakta, dizinin başına [CLS] eklenerek toplam giriş uzunluğu 451’e çıkarılmaktadır.
Ham sayaçlardan hangi ağ göstergeleri çıkarılabilir?
Çalışma bmon sayaçlarının bazı üst düzey göstergeler için kullanılabileceğini belirtmektedir. Ağ arabirimi kullanım oranı:
\[ U=\frac{T}{C} \]
şeklinde tanımlanmıştır. Burada \(T\) trafik hızı, \(C\) ise arabirimin toplam kapasitesidir.
Paket teslim oranı:
\[ PDR=\frac{\sum N_R}{\sum N_S}\times100 \]
olarak verilmiştir. \(\sum N_S\) gönderilen, \(\sum N_R\) alınan paket sayısını göstermektedir.
Etkin aktarım hızı ise kaynakta:
\[ \mathrm{Throughput}=PDR\times\mathrm{Data\ Rate} \]
ilişkisiyle ifade edilmiştir.
Araştırmacılar belirli sayaçların birlikte artmasını operasyonel ipucu olarak yorumlamaktadır:
- Dropped ve FIFO Error artışı tampon taşmasına,
- CRC Error ile Frame Error artışı fiziksel bağlantı sorunlarına,
- Collision ile Carrier Error artışı çift yön ayarı veya donanım sorununa,
- yüksek paket sayısı ile düşük bayt miktarı küçük paketli trafik taşmasına
işaret edebilir. Bunlar çalışmanın teşhis açıklamalarıdır; E_LogBERT deneylerinde her bir olay için ayrı neden sınıflandırması yapılmamıştır.
Sayısal değerler BERT’e nasıl aktarılmıştır?
Çalışma her giriş konumunda iki bilgi kaynağı bulunduğunu belirtmektedir:
- Metrik adı gibi ayrık sembolik kimlik,
- Normalleştirilmiş sürekli sayısal büyüklük.
Sembolik metrik adı, BERT’in sözcük gömme matrisinden 768 boyutlu bir vektöre dönüştürülmektedir. Sayısal değer ise:
nn.Linear(1, 768)
katmanı aracılığıyla aynı boyuta izdüşürülmektedir. İki vektör toplanarak modele aktarılmaktadır. Toplama işlemi, BERT’in sözcük, konum ve tür gömmelerini toplamasına benzetilmiştir.
Bu yaklaşımın amaçladığı temsil şu şekilde özetlenebilir:
\[ \mathbf{e}_i= \mathbf{e}_{metric,i} + \mathbf{e}_{numeric,i} + \mathbf{e}_{position,i}. \]
Ancak kaynak metinde aynı süreç başka bir yerde “metrik adı ile normalleştirilmiş değerin tek karma belirteçte birleştirilmesi” şeklinde açıklanmaktadır. Eğer her farklı sayısal değer sözcük dağarcığının parçası olsaydı 92 belirteçlik sabit sözlük mümkün olmazdı. Bu nedenle gerçek uygulamanın ayrı sembolik gömme ve sayısal izdüşüm yaklaşımı olması daha tutarlı görünmektedir; fakat kaynak bu ayrımı açık ve çelişkisiz biçimde vermemektedir.
Dinamik min–maks normalleştirme
Sayısal değerler güncel en küçük ve en büyük değerlere göre normalize edilmektedir. Genel min–maks dönüşümü:
\[ v_{norm}= \frac{v-v_{min}} {v_{max}-v_{min}} \]
biçimindedir.
Çalışma bu sınırların yeni trafik değerleri geldikçe güncellendiğini belirtmektedir. Böylece sistemin sabit elle ayarlanmış aralıklara bağımlılığı azaltılmak istenmektedir. Ancak:
- minimum ve maksimum değerlerin hangi zaman penceresinde tutulduğu,
- uç değerlerin ölçeği bozmasının nasıl önlendiği,
- test verisinin normalleştirme istatistiklerine sızıp sızmadığı,
- ani dağılım değişiminde geçmiş değerlerin nasıl unutulduğu
açıklanmamıştır.
Masked Log Key Prediction hedefi
[CLS] dışındaki belirteçlerin %15’i rastgele maskelenmektedir. Son Transformer katmanındaki gizli vektör, 92 sembolik sınıf üzerinde olasılık dağılımına çevrilmektedir:
\[ \mathbf{y}_m= \operatorname{softmax} \left( \mathbf{W}_{MLKP}\mathbf{H}_m+\mathbf{b}_{MLKP} \right). \]
Model normal günlük dizilerinde maskelenen metrikleri doğru tahmin etmeyi öğrenmektedir. Yeni bir dizi olağan bağlamsal örüntülere uymuyorsa maskeli tahmin doğruluğunun düşmesi beklenmektedir.
Kaynakta çapraz entropi denkleminin gösterimi açık değildir; tahmin olasılığı ile gerçek sınıf göstergesi aynı sembolle yazılmış görünmektedir. Amaçlanan kayıp, gerçek sınıf göstergesi ile tahmin edilen olasılığın standart çapraz entropisidir.
Volume of Hypersphere Minimization hedefi
Her dizinin genel durumu [CLS] belirtecinin 768 boyutlu gömmesiyle temsil edilmektedir. Başlangıçtaki normal dizilerden bir merkez hesaplanmaktadır:
\[ \mathbf{c}= \frac{1}{N_{init}} \sum_{n=1}^{N_{init}} \mathbf{H}_{[CLS],n}. \]
Merkez daha sonra sabit tutulmakta ve normal dizilerin gömmeleri bu merkeze yaklaştırılmaktadır:
\[ L_{VHM}= \frac{1}{B} \sum_{b=1}^{B} \left\| \mathbf{H}_{[CLS],b}-\mathbf{c} \right\|_2^2. \]
Böylece normal ağ durumlarının yüksek boyutlu uzayda kompakt bir küme oluşturması amaçlanmaktadır. Olağan çapraz metrik ilişkilerini bozan dizilerin merkezden daha uzakta kalması beklenmektedir.
Toplam eğitim hedefi
İki öz-denetimli kayıp ağırlıklı olarak birleştirilmiştir:
\[ L_{total}= \alpha L_{MLKP} + \beta L_{VHM}. \]
Kaynakta genellikle \(\alpha=0{,}5\) ve \(\beta=0{,}5\) kullanıldığı, ayrıca:
\[ \alpha+\beta=1 \]
koşulunun korunduğu belirtilmektedir.
Anomali puanı nasıl hesaplanmaktadır?
Modelin anomali puanı, maskeli tahmin doğruluğu ile VHM merkez uzaklığını bir araya getirmektedir:
\[ A(S)= 1- \left[ \alpha\,MLKP_{norm}(S) + \beta\left(1-VHM_{norm}(S)\right) \right]. \]
Puan sıfıra yaklaştıkça dizinin normal, bire yaklaştıkça anormal kabul edilmesi amaçlanmaktadır. Çalışmada üç operasyonel bölge belirtilmiştir:
| Anomali puanı | Kaynakta kullanılan yorum |
|---|---|
| 0–0,825 | Tıkanıklık yok |
| 0,825–0,960 | Olası tıkanıklık |
| 0,960 ve üzeri | Yaklaşan tıkanıklık |
Bu eşiklerin ROC analizi, validasyon optimizasyonu veya operasyonel maliyet hesabıyla nasıl belirlendiği gösterilmemiştir. Ayrıca kaynak, \(\alpha\) ve \(\beta\) değerlerinin ikisi de sıfır olduğunda puanın 1 olacağını açıklamaktadır. Bu durum daha önce verilen \(\alpha+\beta=1\) kısıtıyla bağdaşmamaktadır.
E_LogBERT model büyüklüğü
Model değiştirilmiş BERT-Base çekirdeği kullanmaktadır:
- 12 Transformer katmanı,
- 768 gizli boyut,
- 12 dikkat başlığı,
- 451 giriş konumu,
- 90 metrik ve 2 özel belirteçten oluşan 92 öğelik sözlük.
Çalışmada toplam eğitilebilir parametre sayısı 86.691.164 olarak verilmiştir. Standart BERT-Base’in yaklaşık 30 bin sözcüklük gömme tablosu yerine 92 metriklik küçük sözlük kullanılması sözcük gömme katmanını küçültmektedir. Transformer çekirdeğinin büyük bölümü ise korunmaktadır.
Parametre tablosundaki sorunlar
On birinci ve yirmi dördüncü sayfalardaki parametre tablosunda bazı teknik belirsizlikler bulunmaktadır:
- Dikkat bölümünde \(W_V\) iki kez yazılmıştır; satırlardan birinin çıkış izdüşümü \(W_O\) olması muhtemeldir.
- Sayısal değer için açıklanan
Linear(1,768)katmanının 768 ağırlık ve 768 bias parametresi tabloda görünmemektedir. - VHM için 768’den 1’e dönüşüm 768 parametre olarak verilmiş, olası bias belirtilmemiştir.
- Tablodaki tek tek kalemler standart BERT katmanındaki bütün bias terimlerini açık biçimde göstermemektedir.
Bu nedenle bildirilen toplam sayı model kodu olmadan yalnızca tablodan bağımsız biçimde doğrulanamamaktadır.
On üç modüllü sistem mimarisi
Sekizinci sayfadaki Şekil 2, model çevresinde çalışan 13 yazılım modülünü bir kilit biçiminde göstermektedir:
| Modül | Çalışmadaki görevi |
|---|---|
config.py | Sistem parametreleri ve merkezi yapılandırma |
data_structures.py | Standart veri nesneleri |
logger_config.py | Sistem olaylarının kaydı |
utils.py | Ortak yardımcı işlevler |
extract_normalize_format_embed.py | Günlük ayrıştırma, normalleştirme ve karma belirteç üretimi |
sequence_buffer.py | Beş ölçüm turundan 450 belirteçlik pencere oluşturma |
dataloader.py | Dizileri PyTorch tensörlerine dönüştürme ve maskeleme |
train.py | Sürekli model eğitimi |
log_model.py | E_LogBERT modeli |
anomaly.py | Anomali puanı ve karar mekanizması |
livemonitor.py | İş akışının zamanlanması |
predict_log.py | Tarihsel analiz ve gelecek durum kestirimi |
dashboard.py | Canlı ölçümler, alarmlar ve model performansı |
Dokuzuncu sayfadaki Şekil 3, sistemi altı aşamaya ayırmaktadır:
- Altyapı ve veri üretimi,
- Yapılandırma ve veri nesneleri,
- Ön işleme ve on saniyelik pencerelerin hazırlanması,
- Model eğitimi ve çıkarım,
- Anomali puanlama ve kayıt,
- Görselleştirme ile tahmin.
On dördüncü sayfadaki Şekil 5 bütün modüllerin dosya, parametre, model ağırlığı, alarm ve günlük akışlarını ayrıntılı olarak göstermektedir. Mimari kapsamlıdır; ancak şeklin karmaşıklığı, sistemin yeniden uygulanabilmesi için tek başına yeterli değildir. Modül kaynak kodları ve arayüz şemaları paylaşılmamıştır.
Gerçek zamanlı çalışma nasıl tanımlanmıştır?
Sistem iki saniyede bir yeni ölçüm almakta, beş ölçüm turundan on saniyelik dizi oluşturmakta ve eğitim, çıkarım ile alarm sürecini on saniyelik döngüde yürütmeyi hedeflemektedir.
Beşinci sayfada veri toplama betiğinin test donanımında işlemci kullanımının %5’in altında kaldığı belirtilmiştir. Ancak:
- BERT modelinin tek dizi çıkarım süresi,
- dokuz dönemlik eğitimin gerçek süresi,
- on saniyelik zaman sınırının kaç döngüde karşılandığı,
- GPU belleği ve enerji tüketimi,
- eş zamanlı birden fazla arabirimde ölçeklenme
ölçülmemiştir. Bu nedenle “gerçek zamanlı” niteliği mimari hedef ve gösterim düzeyindedir; tam performans kıyaslamasıyla doğrulanmış değildir.
Canlı gösterge paneli
On ikinci ve yirmi yedinci sayfalardaki Şekil 4, Streamlit tabanlı canlı izleme panelini göstermektedir. Görselde:
- 156 toplam olay,
- 0,408 anomali puanı,
- “No Congestion” durumu,
- 0,874 F1 değeri,
- “Excellent” veri kalitesi,
- zaman içinde anomali puanı,
- olası ve yaklaşan tıkanıklık eşikleri
yer almaktadır. Gösterge paneli sistemin çalışır bir prototipinin bulunduğunu desteklemektedir. Ancak tek ekran görüntüsü, alarm doğruluğunu veya uzun süreli üretim güvenilirliğini kanıtlamaz.
Karşılaştırmalı sonuçlar
| Ölçüt | E_LogBERT | KTeleBERT | Fark |
|---|---|---|---|
| Doğruluk | %92 | %78 | 14 yüzde puanı |
| Kesinlik | %90 | %75 | 15 yüzde puanı |
| Duyarlılık | %89 | %74 | 15 yüzde puanı |
| F1 | %89,5 | %74,5 | 15 yüzde puanı |
| AUC | %96 | %84 | 12 yüzde puanı |
On yedinci sayfadaki Şekil 7, beş ölçütte E_LogBERT sütunlarının KTeleBERT sütunlarından yüksek olduğunu göstermektedir. Ancak karşılaştırma protokolü açıklanmamıştır:
- KTeleBERT’in aynı veri üzerinde yeniden eğitilip eğitilmediği,
- hiperparametrelerin nasıl seçildiği,
- iki modelin aynı eğitim ve test bölünmesini kullanıp kullanmadığı,
- sonuçların tek çalışma mı yoksa tekrarların ortalaması mı olduğu
belirtilmemektedir.
Özet LogBERT’in de geride bırakıldığını söylemektedir; buna karşın sonuç tablosu veya grafiğinde temel LogBERT için sayısal değer sunulmamıştır.
Dönem sayısının etkisi
| Dönem | Senkronize E_LogBERT doğruluğu | Senkronize olmayan temel doğruluk |
|---|---|---|
| 3 | %78 | %65 |
| 5 | %85 | %70 |
| 7 | %89 | %74 |
| 9 | %92 | %78 |
| 11 | %92 | %80 |
| 13 | %90 | %81 |
| 15 | %88 | %80 |
Şekil 8, E_LogBERT doğruluğunun dokuzuncu dönemde %92’ye ulaştığını, on birinci dönemde aynı kaldığını ve daha sonra azaldığını göstermektedir. Araştırmacılar dokuz dönemi doğruluk ile zaman maliyeti arasındaki uygun denge olarak seçmiştir.
Düşüş fazla eğitime veya veri akışındaki değişime bağlanabilir; ancak çalışma eğitim ve doğrulama kayıplarını, rastgele tohumları veya tekrarlı deneyleri vermediğinden bunun gerçekten aşırı öğrenme olduğu kesinleştirilemez.
“Tıkanıklık tahmini” ile “anomali tespiti” arasındaki ayrım
Çalışmanın değerlendirmesinde önemli bir kavramsal sınır bulunmaktadır. Anomali tespiti, güncel veya geçmiş penceredeki örüntünün normalden sapıp sapmadığını belirler. Gelecek tıkanıklık tahmini ise:
- gelecekteki hedef zamanı,
- öngörü ufkunu,
- gerçekleşen tıkanıklık başlangıcını,
- tahminden olaya kadar geçen süreyi,
- erken uyarının yanlış alarm ve kaçırma oranlarını
gerektirir.
E_LogBERT’in anomali puanı ayrıntılı biçimde verilmiş, fakat gelecek durum kestiriminin hedefi ve değerlendirme ölçütleri sunulmamıştır. Bu nedenle çalışma, gerçek zamanlı anomali izleme yeteneğine ilişkin kanıt sunmakta; tıkanıklığı belirli bir süre önceden tahmin ettiğini aynı açıklıkta kanıtlamamaktadır.
Siber saldırı tespiti gösterilmiş midir?
Çalışma DDoS, küçük paketli sel trafiği ve olağan dışı bant genişliği artışlarının teorik olarak bmon sayaçlarında görülebileceğini belirtmektedir. Ancak deneylerde:
- belirli bir saldırı senaryosu,
- kontrollü saldırı enjeksiyonu,
- saldırı türü etiketi,
- saldırı başına duyarlılık,
- yanlış pozitif analizi
sunulmamıştır. Bu nedenle E_LogBERT’in siber saldırıları erken tespit ettiği sonucu bu çalışmadan çıkarılamaz.
Çalışmanın güçlü yönleri
- Sayısal değerlerin günlük analizinde kaybolması açık bir uygulama sorunu olarak ele alınmıştır.
- Yedi gün boyunca yüksek zaman çözünürlüklü veri toplanmıştır.
- Ham ağ sayaçları zaman damgalı ve açıklayıcı biçime dönüştürülmüştür.
- Rx ve Tx değerleri ayrı kimliklerle korunmuştur.
- Öz-denetimli öğrenme, etiketlenmiş anomali gereksinimini azaltmayı hedeflemektedir.
- Veri toplama, model, alarm ve görselleştirme tek modüler sistemde birleştirilmiştir.
- Çalışan canlı izleme paneli sunulmuştur.
- Parametre sayısı, yazılım bağımlılıkları ve test donanımı bildirilmiştir.
- Kesinlik, duyarlılık, F1 ve AUC yalnızca doğruluğa ek olarak verilmiştir.
- LoRA, federatif öğrenme ve farklı operatörlerde doğrulama gereksinimi gelecek çalışma olarak kabul edilmiştir.
Çalışmanın sınırlılıkları
- Çalışma hakem değerlendirmesinden geçmemiştir.
- Veriler ticari bir operatörün üretim ağı yerine kontrollü bir sanal test ortamından alınmıştır.
- Veri yalnızca yedi günlük tek bir ortamı kapsamaktadır.
- Tıkanıklık örneklerinin nasıl üretildiği ve gerçek etiketlerin nasıl belirlendiği açıklanmamıştır.
- Eğitim, doğrulama ve test bölünmesi verilmemiştir.
- Zamansal veri sızıntısının nasıl önlendiği açıklanmamıştır.
- Sınıf dağılımı ve karışıklık matrisi ham değerleri bulunmamaktadır.
- Çoklu eğitim tekrarı, standart sapma ve güven aralığı verilmemiştir.
- KTeleBERT karşılaştırmasının aynı koşullarda yapıldığı gösterilmemiştir.
- Temel LogBERT için sayısal karşılaştırma sonucu sunulmamıştır.
- Gelecek tahmin ufku ve erken uyarı süresi ölçülmemiştir.
- Dinamik normalleştirmenin ayrıntılı algoritması açıklanmamıştır.
- Karma belirteç açıklaması kendi içinde tutarlı değildir.
- Parametre tablosunda eksik veya yinelenen satırlar vardır.
- Anomali eşikleri için doğrulama analizi sunulmamıştır.
- Sürekli eğitimin model sürüklenmesi veya anormal veriyi normal olarak öğrenmesi riski incelenmemiştir.
- Model çıkarım süresi ve uçtan uca gecikme ölçülmemiştir.
- Kod, veri, model ağırlıkları ve yeniden üretim betikleri paylaşılmamıştır.
- Siber saldırı tespit performansı deneysel olarak sınanmamıştır.
Çalışma neyi desteklemektedir?
- Sembolik metrik adı ile sayısal büyüklüğün aynı BERT tabanlı modelde işlenebileceğini göstermektedir.
- bmon çıktılarının zaman damgalı açıklayıcı günlük dizilerine dönüştürülebileceğini göstermektedir.
- MLKP ve VHM hedeflerinin karma metrik dizilerinde birlikte uygulanabileceğini göstermektedir.
- On saniyelik pencereler üzerinde anomali puanı üreten çalışan bir prototip sunmaktadır.
- Kontrollü UTP verisinde bildirilen ölçütlerde KTeleBERT temel sonucundan daha yüksek değerler elde edildiğini göstermektedir.
- Gerçek zamanlı gösterge paneli ve alarm kayıt altyapısının aynı mimariye bağlanabileceğini göstermektedir.
Çalışma neyi kanıtlamamaktadır?
- E_LogBERT’in gerçek bir mobil operatör ağında %92 doğrulukla çalışacağını kanıtlamamaktadır.
- Tıkanıklığı belirli bir süre önceden tahmin ettiğini nicel olarak göstermemektedir.
- KTeleBERT ve LogBERT’ten bütün veri kümelerinde daha iyi olduğunu kanıtlamamaktadır.
- Modelin farklı cihaz üreticileri ve operatör günlüklerine yeniden eğitim olmadan aktarılacağını göstermemektedir.
- Siber saldırı türlerini tespit veya sınıflandırdığını göstermemektedir.
- 0,825 ve 0,960 eşiklerinin evrensel olarak geçerli olduğunu göstermemektedir.
- Sürekli çevrim içi eğitimin güvenli biçimde model sürüklenmesini önlediğini kanıtlamamaktadır.
- On saniyelik bütün eğitim ve çıkarım işlemlerinin belirtilen donanımda her zaman tamamlandığını göstermemektedir.
- Üretim ortamı kullanılabilirliği, hata toleransı veya uzun süreli işletme kararlılığı sunmamaktadır.
- Güneş enerjili UTP yapısının enerji verimliliğini veya karbon etkisini ölçmemektedir.
Geçmiş, bugün ve gelecek açısından önemi
Geçmişte ağ izleme büyük ölçüde sabit eşiklere, kural tabanlı alarm sistemlerine ve insan tarafından hazırlanan gösterge panellerine dayanmıştır. Daha sonra istatistiksel yöntemler ve günlük dizilerini öğrenen derin ağlar geliştirilmiştir. LogBERT gibi modeller bağlamsal olay ilişkilerini öğrenmiş, ancak çoğu uygulamada sayısal değerler ikincil veya kayıp bilgi olarak kalmıştır.
Bugün açısından E_LogBERT’in önemli yönü, günlük olayının adı ile ölçülen sayısal büyüklüğü ortak bir bağlam içinde ele almaya çalışmasıdır. Bu fikir ağ tıkanıklığı dışında sunucu yükü, veri merkezi performansı, bulut hizmetleri ve endüstriyel telemetri gibi karma günlük sistemlerine de uyarlanabilir.
Gelecekte yöntemin gerçek değeri, farklı operatörlerde bağımsız doğrulama, açık veri ve kod, gelecekteki tıkanıklık için tanımlı tahmin ufku, çevrim içi öğrenme güvenliği ve uç cihaz performansı gösterildiğinde anlaşılabilecektir. Araştırmacıların önerdiği LoRA ve federatif öğrenme, veri gizliliği ile hesaplama maliyetini azaltma açısından araştırılabilir; ancak bu özellikler mevcut çalışmada uygulanmış değildir.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımının teknik özeti
| Bileşen | Çalışmada uygulanan yaklaşım |
|---|---|
| Araştırma türü | Öz-denetimli yapay zekâ modeli ve gerçek zamanlı ağ izleme prototipi |
| Veri kaynağı | bmon ağ arabirimi sayaçları |
| Test ortamı | pfSense ve Issabel sanal makinelerinden oluşan UTP |
| İzlenen arabirim | WANbridge |
| Metrik sayısı | 45 metrik × Rx/Tx = 90 sembolik metrik |
| Toplama aralığı | 2 saniye |
| Toplama süresi | 7 gün |
| Günlük satırı | 13.608.000 |
| Karma belirteç | 27.216.000 |
| Dizi sayısı | 60.480 |
| Dizi uzunluğu | 450 metrik belirteci + [CLS] = 451 |
| Model | 12 katmanlı değiştirilmiş BERT-Base |
| Gizli boyut | 768 |
| Dikkat başlığı | 12 |
| Sözlük | 90 metrik + [CLS] + [MASK] = 92 |
| Sayısal temsil | Dinamik normalleştirme ve Linear(1,768) izdüşümü |
| Öz-denetimli hedefler | MLKP ve VHM |
| Maskeleme oranı | %15 |
| Kayıp ağırlıkları | Genellikle α = 0,5 ve β = 0,5 |
| Bildirilen parametre | 86.691.164 |
| Yazılım modülü | 13 |
| Donanım | 8 çekirdek CPU, 32 GB RAM, NVIDIA T4 16 GB |
| Veri paylaşımı | Bulunmamaktadır |
| Kod paylaşımı | Bulunmamaktadır |
Bildirilen temel performans
| Ölçüt | E_LogBERT | KTeleBERT |
|---|---|---|
| Doğruluk | 0,92 | 0,78 |
| Kesinlik | 0,90 | 0,75 |
| Duyarlılık | 0,89 | 0,74 |
| F1 | 0,895 | 0,745 |
| AUC | 0,96 | 0,84 |
Şekillerin bilimsel işlevi
| Şekil | Gösterilen içerik | Bilimsel işlevi |
|---|---|---|
| Şekil 1 | Ham bmon çıktısından açıklayıcı zaman damgalı günlüklere dönüşüm | Veri hazırlama sürecini göstermek |
| Şekil 2 | 13 modüllü E_LogBERT mimarisi | Yazılım bileşenlerini ve görevlerini özetlemek |
| Şekil 3 | Altı aşamalı sistem iş akışı | Veri üretiminden alarm ve tahmine kadar işlem sırasını göstermek |
| Şekil 4 | Canlı tıkanıklık izleme paneli | Anomali puanı ve ağ durumunun görselleştirildiğini göstermek |
| Şekil 5 | Ayrıntılı modül ve dosya akışı | Sistem bileşenleri arasındaki bağlantıları göstermek |
| Şekil 6 | Unified Telecom Platform test ortamı | Verinin toplandığı sanallaştırılmış ağ yapısını açıklamak |
| Şekil 7 | E_LogBERT ve KTeleBERT performans sütunları | Bildirilen doğruluk, kesinlik, duyarlılık, F1 ve AUC farklarını göstermek |
| Şekil 8 | Dönem sayısına göre doğruluk | Dokuz dönemlik eğitim seçimini gerekçelendirmek |
Sonuçların yeniden üretilebilmesi için eksik bilgiler
- Tıkanıklık sınıfının açık ve ölçülebilir tanımı,
- Normal ve tıkanık örnek sayıları,
- Etiketleme veya olay üretme protokolü,
- Zamana dayalı eğitim–doğrulama–test bölünmesi,
- Rastgele tohumlar ve eğitim tekrarları,
- KTeleBERT ve LogBERT hiperparametreleri,
- Dinamik normalleştirme penceresi,
- Anomali eşiklerinin seçim yöntemi,
- Model çıkarım ve eğitim gecikmeleri,
- Kaynak kodu ve sürüm bilgileri,
- Eğitilmiş model ağırlıkları,
- Ham veya anonimleştirilmiş veri kümesi.
Teknik yorum
E_LogBERT’in en anlamlı araştırma fikri, ağ günlüğündeki metrik kimliğini ve sayısal büyüklüğü ayrı fakat ortak boyutlu gömmeler olarak işlemektir. Bu yaklaşım, yalnızca olay sırasını öğrenen modellerin kaçırdığı miktar ilişkilerini dikkat mekanizmasına taşıyabilir.
Bununla birlikte bildirilen yüksek sınıflandırma değerlerinin kanıt gücü değerlendirme protokolüne bağlıdır. Aynı yedi günlük zaman dizisinden rastgele ayrılmış örtüşen pencereler eğitim ve testte birlikte kullanıldıysa, komşu pencereler arasındaki büyük benzerlik sonuçları yapay olarak yükseltebilir. Kaynak bölme yöntemini açıklamadığı için bu olasılık dışlanamamaktadır.
Benzer biçimde, gerçek tıkanıklık etiketi tanımlanmadan %92 doğruluk tek başına operasyonel anlam taşımaz. Tıkanıklığın kapasite kullanımı, gecikme, paket kaybı veya hizmet kalitesi eşiğiyle ilişkilendirilmesi ve modelin bu eşiği ne kadar önceden öngördüğünün ölçülmesi gerekir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: E_LogBERT: Enhanced LogBERT for Realistic Telecom Networks Traffic
Yazarlar: Kareem A. Mostafa, El-Sayed Soliman A. Said, Abdelhady A. Ammar, Sayed A. Nouh ve M. Zaki.
Yazar sıralaması: SSRN resmî kaydındaki sıra korunmuştur.
Eş katkı: Çalışmanın katkı beyanı bütün yazarların makalenin hazırlanmasına eşit katkı sağladığını belirtmektedir.
Sorumlu yazar: Kareem A. Mostafa. SSRN kaydında “Contact Author” olarak gösterilmektedir.
Kurum 1: Al-Azhar University, Cairo – Faculty of Engineering, Nasr City, Cairo 11371, Mısır. Kareem A. Mostafa için bildirilmiştir.
Kurum 2: Al-Azhar University, Qena 83513, Mısır. El-Sayed Soliman A. Said için bildirilmiştir.
Diğer kurumlar: Abdelhady A. Ammar, Sayed A. Nouh ve M. Zaki’nin kurum bağlantıları yüklenen sürümde ve SSRN resmî kaydında yer almamaktadır.
Resmî kaynak bağlantısı:SSRN resmî kayıt sayfası
Yayın platformu: SSRN.
Yükleme tarihi: 24 Haziran 2026.
Yayın yılı: 2026.
Sayfa sayısı: 30.
Dergi: Belirli bir hakemli dergi adı veya kabul edilmiş dergi sürümü bu kaynakta yer almamaktadır.
Hakemli yayınevi: Bulunmamaktadır. SSRN bir preprint dağıtım platformudur.
Kaynak türü: Ağ test ortamında veri toplayan, karma sembolik-sayısal BERT modeli ve modüler gerçek zamanlı izleme prototipi sunan preprint araştırma makalesi.
Hakemlik durumu: Çalışma hakem değerlendirmesinden geçmemiştir. Dosyanın bütün sayfalarında “Preprint not peer reviewed” uyarısı bulunmaktadır.
Finansman: Açık erişim finansmanının Science, Technology & Innovation Funding Authority ile Egyptian Knowledge Bank iş birliği tarafından sağlandığı belirtilmiştir. Araştırmanın teknik geliştirme bütçesi veya ayrı proje numarası bildirilmemiştir.
Yazar katkıları: Bütün yazarların özgün fikirlerin geliştirilmesine, makalenin yazılmasına ve bütün bölümlerin incelenmesine eşit katkı sağladığı belirtilmiştir.
Çıkar çatışması: Yazarlar rekabet eden menfaat bulunmadığını beyan etmiştir.
Veri ve materyal erişimi: “Not applicable” olarak bildirilmiştir. Veri deposu veya anonimleştirilmiş günlük kümesi sunulmamıştır.
Kod ve model erişimi: Kaynak kodu, model ağırlığı, bağımlılık kilit dosyası veya yeniden üretim paketi bağlantısı verilmemiştir.
Temel doğrulama sınırı: Çalışma, kontrollü UTP test ortamında yüksek performans değerleri bildirmektedir; ancak bağımsız test bölünmesi, tıkanıklık etiketleme yöntemi, tahmin ufku ve tekrar belirsizlikleri sunulmadığından %92 doğruluk gerçek operatör ağı için doğrulanmış performans olarak yorumlanamaz.
Mimari tutarlılık uyarısı: Karma belirteç üretimi kaynakta iki farklı biçimde açıklanmıştır. Parametre tablosunda yinelenen \(W_V\) satırı ve eksik sayısal izdüşüm katmanı bulunmaktadır. Bu noktalar sessizce düzeltilmemiştir.
Anomali puanı uyarısı: Eğitim ağırlıkları için \(\alpha+\beta=1\) koşulu verilirken, daha sonra \(\alpha=\beta=0\) durumu yorumlanmıştır. Bu iki tanım matematiksel olarak birlikte geçerli değildir.
Tahmin iddiası sınırı: Çalışma anlık anomali puanı ve tıkanıklık sınıflandırması sunmaktadır; gelecekteki tıkanıklığın kaç saniye veya dakika önceden öngörüldüğünü ölçen ayrı bir deney bulunmamaktadır.
Bu Türkçe içerik yalnızca yüklenen çalışmanın metni, denklemleri, tabloları, sistem şemaları, gösterge paneli ve bildirilen deney sonuçları temel alınarak hazırlanmıştır. Çalışmada bulunmayan bir operatör saha başarısı, siber saldırı tespit doğruluğu, üretim ortamı güvenilirliği veya Türkiye’ye özgü performans iddiası eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir