

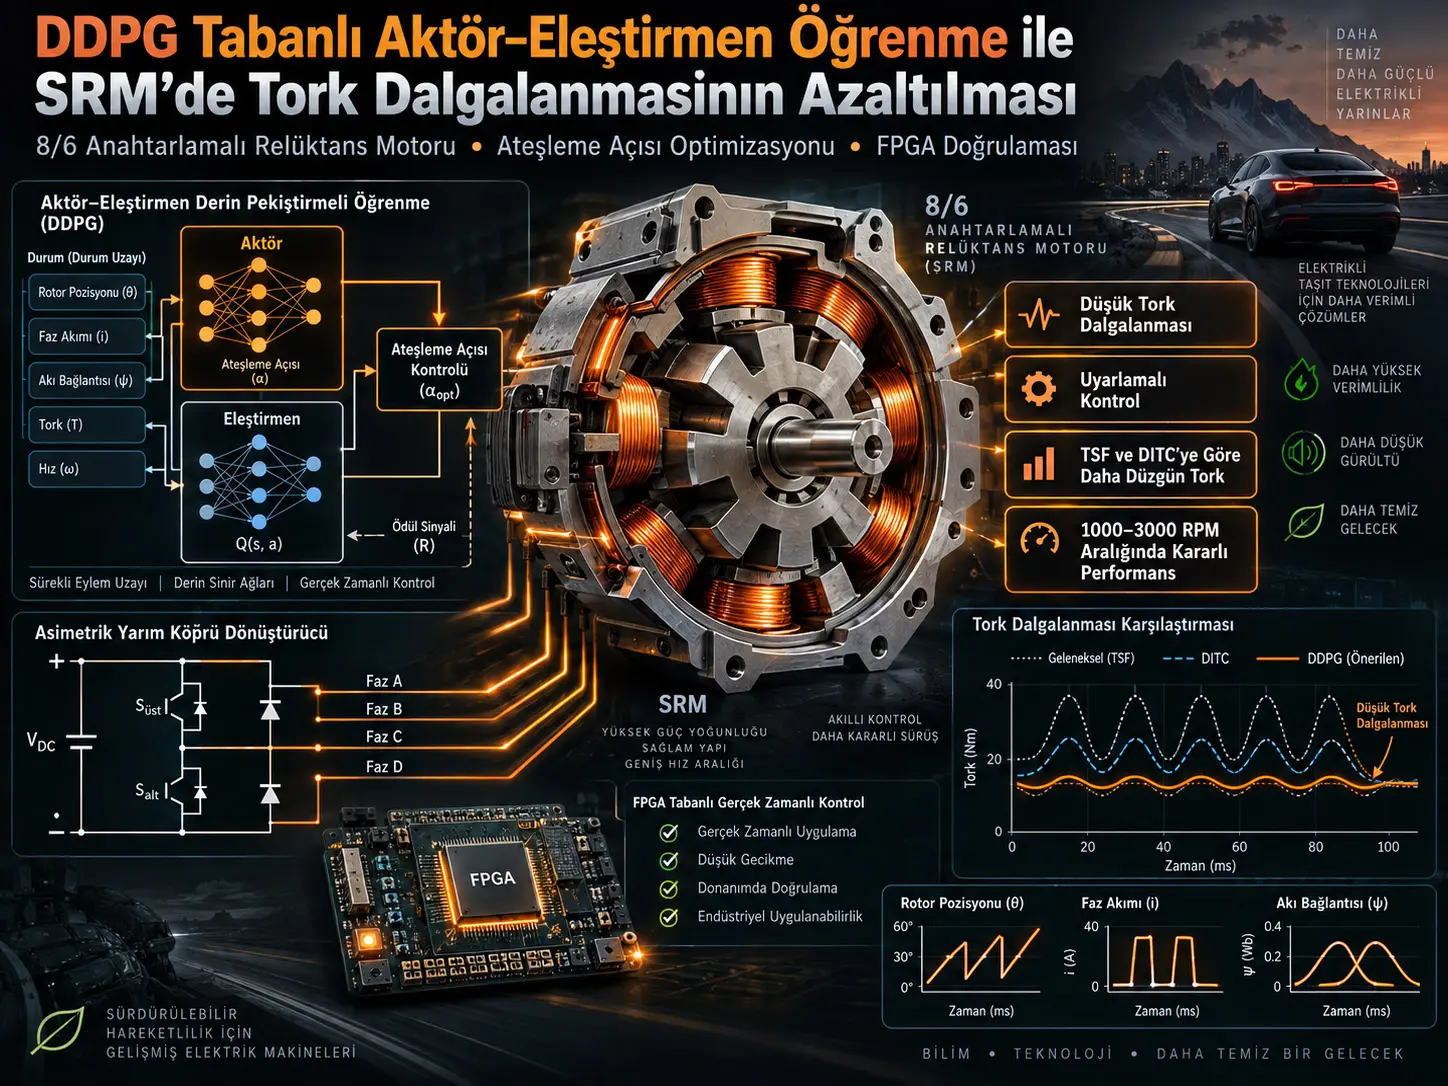
DDPG tabanlı aktör–eleştirmen SRM denetleyicisi, Anahtarlamalı Relüktans Motorunun (Switched Reluctance Motor, SRM) akım, elektromanyetik tork, akı bağlanımı, rotor hızı ve rotor konumu gibi çalışma durumlarını gözleyerek dört fazın ateşleme açısı ofsetlerini sürekli değerli eylemler olarak öğrenen bir pekiştirmeli öğrenme denetim sistemidir. Çalışma, 8/6 kutuplu dört fazlı bir SRM'yi Asymmetrical Half-Bridge (ASHB) dönüştürücü üzerinden sürmekte; Deep Deterministic Policy Gradient (DDPG) aktör–eleştirmen mimarisini MATLAB Simulink R2024b ortamında eğitmekte ve öğrenilmiş politikayı FPGA tabanlı Wavect dijital kontrolcü üzerinde gerçek zamanlı olarak uygulamaktadır. Simülasyonda 20 Nm yük ve 1000–3000 RPM aralığında raporlanan tepe-tepe tork dalgalanması %1,29 ile %2,08 arasındadır. Bununla birlikte deneysel donanım doğrulaması anlık tork dalgalanmasını doğrudan ölçmemiş; esas olarak ortalama mekanik tork ve hızın simülasyon sonuçlarıyla yakınlığını göstermiştir.
SRM'ler kalıcı mıknatıs gerektirmeyen, basit rotor yapısına sahip, sağlam, hata toleranslı ve geniş hız aralığında çalışabilen elektrik makineleridir. Buna karşılık çift çıkıntılı stator–rotor geometrisi, rotor konumuna bağlı doğrusal olmayan endüktans ve ayrık faz komütasyonu tork üretimini dalgalı hâle getirir. Bu dalgalanmalar titreşim, akustik gürültü, mekanik aşınma ve sürüş konforunda bozulmaya neden olabilir.
Kaynak çalışmanın önerdiği çözüm, sabit bir akım profili veya önceden belirlenmiş komütasyon tablosu kullanmak yerine ateşleme açısını çalışma koşullarına göre öğrenen bir DDPG ajanıdır. Aktör ağı uygun ateşleme ofsetlerini üretirken eleştirmen ağı bu eylemlerin uzun vadeli tork düzgünlüğüne katkısını Q-değeri üzerinden değerlendirir. Deneyim tekrar belleği, hedef ağlar ve yumuşak güncellemeler eğitimin kararlılığını destekler.
SRM'de Tork Dalgalanması Neden Oluşur?
Anahtarlamalı Relüktans Motorunda tork dalgalanmasının temel nedeni, elektromanyetik torkun faz akımının karesiyle ve rotor açısına göre değişen faz endüktansının eğimiyle bağlantılı olmasıdır; faz komütasyonunda çıkan fazın akımı azalırken gelen fazın akımı yeterince hızlı oluşmazsa toplam tork sürekliliği bozulur ve bu etki manyetik doyum, rotor konumuna bağlı doğrusal olmayan endüktans ve yanlış komütasyon örtüşmesiyle büyüyebilir.
SRM'nin elektromanyetik tork mekanizması
SRM'de rotor sargısı veya kalıcı mıknatıs bulunmaz. Rotor, manyetik devrenin relüktansını azaltacak hizalanmış konuma doğru hareket etmeye çalışır. Bir faz için kaynakta verilen temel tork ilişkisi:
\[ T_{e,i}(\theta,t)=\frac{1}{2}i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Burada \(i_i(t)\) faz akımıdır; \(L_i(\theta)\) fazın rotor açısına bağlı endüktansıdır. \(dL_i/d\theta\), rotor dönerken endüktansın hangi hızda değiştiğini gösterir.
Denklem iki kritik ilişki içerir. Birincisi, tork faz akımının karesiyle ilişkilidir; dolayısıyla akımdaki değişimin tork üzerindeki etkisi doğrusal değildir. İkincisi, pozitif tork üretimi esas olarak endüktansın rotor açısıyla arttığı \(dL/d\theta>0\) bölgesinde gerçekleşir. Denetleyicinin fazı doğru rotor bölgesinde enerjilendirmesi bu nedenle önemlidir.
Dört fazın toplam elektromanyetik torku kaynakta şu şekilde verilmektedir:
\[ T_e(\theta,t)=\sum_{i\in\{A,B,C,D\}}T_{e,i}(\theta,t) =\frac{1}{2}\sum_i i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Bu toplam, tork dalgalanmasını azaltma stratejisinin fiziksel temelini açıklar: her fazın tork katkısı uygun zamanlamayla birbirine bindirilebilirse toplam elektromanyetik tork daha düzgün hâle gelir.
Tork dalgalanması nasıl ölçülüyor?
Kaynağın temel tepe-tepe tork dalgalanması metriği:
\[ TR(\%)=\frac{T_{\max}-T_{\min}}{T_{\mathrm{avg}}}\times100 \]
\(T_{\max}\), bir elektriksel çevrimdeki en yüksek torku; \(T_{\min}\) en düşük torku; \(T_{\mathrm{avg}}\) ise ortalama torku gösterir. Oran küçüldükçe tork üretimi daha düzgün kabul edilir.
Çalışma sürekli-zaman değerlendirmesi için ayrıca normalize edilmiş RMS biçimini verir:
\[ TR_{\mathrm{RMS}}= \frac{ \sqrt{\frac{1}{T}\int_0^T [T_e(t)-T_{\mathrm{avg}}]^2dt} } {T_{\mathrm{avg}}} \]
Bu biçim, yalnız en yüksek ve en düşük noktaları değil, bir elektriksel dönem boyunca ortalama torktan sapmaların enerji benzeri toplam büyüklüğünü dikkate alır.
Elektriksel faz dinamiği
Bir SRM fazının gerilim denklemi kaynakta:
\[ V_s(t)=R_i i_i(t)+\frac{d}{dt}[L_i(\theta(t))i_i(t)] \]
şeklindedir. Türev açıldığında:
\[ V_s(t)=R_i i_i(t)+L_i(\theta)\frac{di_i(t)}{dt} +i_i(t)\dot{\theta}\frac{dL_i(\theta)}{d\theta} \]
elde edilir. Son terim elektrik ve mekanik hareket arasındaki bağı gösterir. Rotor hızı değiştiğinde, aynı gerilim ve komütasyon stratejisi aynı akım davranışını üretmek zorunda değildir. Sabit ateşleme açılarına dayanan yöntemlerin geniş hız aralığında güçlük yaşamasının fiziksel nedenlerinden biri budur.
Deneysel endüktans haritası
Çalışmada faz endüktansı yalnız teorik bir eğri olarak kabul edilmemiştir. Sayfa 10–11'de gösterilen deney düzeneğinde hassas LCR metre kullanılmış; rotor manuel olarak 10 derecelik adımlarla döndürülmüş ve her konumdaki faz endüktansı kaydedilmiştir. Rotor konum referansı, şaftın tahrik edilmeyen ucuna bağlanan ve 5 V DC ile beslenen incremental encoder ile izlenmiştir.
Kaynak, hizalanmış endüktansı 55 mH, hizalanmamış endüktansı 12 mH olarak raporlamaktadır. Ölçülen endüktans profilleri, ajan tarafından yüksek pozitif \(dL/d\theta\) bölgelerinin belirlenmesine yardım eden fiziksel referans olarak kontrol ortamına dahil edilmiştir.
Neden Asymmetrical Half-Bridge dönüştürücü?
Dört fazlı ASHB dönüştürücü her faz için iki kontrollü anahtar ve iki diyot kullanır. Çalışmada üç temel elektriksel durum tanımlanmaktadır:
| Durum | Faz gerilimi | Temel işlev |
|---|---|---|
| Mıknatıslanma | +\(V_{DC}\) | Her iki kontrollü anahtar açıktır; faz akımı hızlı biçimde yükselir. |
| Serbest dolaşım | 0 V | Anahtarlardan biri açık, diğeri kapalıdır; faz akımı dolaşıma devam eder. |
| Demanyetizasyon | −\(V_{DC}\) | İki anahtar da kapalıdır; sargıdaki manyetik enerji DC bara geri gönderilir ve faz akımı düşürülür. |
ASHB'nin bağımsız faz kontrolü ve hızlı akım yükselme/düşme kapasitesi, DDPG ajanının ateşleme zamanını faz bazında ayarlayabilmesi açısından merkezîdir.
DDPG Tork Dalgalanmasını Nasıl Azaltır?
DDPG denetleyicisi, motorun ölçülen durumunu sürekli değerli dört faz ateşleme açısı ofsetlerine dönüştürür; aktör ağı kontrol eylemini üretirken eleştirmen ağı bu eylemin gelecekteki toplam ödülünü değerlendirir ve eğitim boyunca daha düşük tork dalgalanması oluşturan komütasyon zamanlamaları pekiştirilir.
Kontrol problemi Markov Karar Süreci olarak tanımlanıyor
Kaynak, pekiştirmeli öğrenme ortamını:
\[ M=(S,A,P,R,\gamma) \]
biçiminde bir Markov Karar Süreci olarak tanımlar.
- Durum uzayı \(S\): faz akımları, elektromanyetik tork, akı bağlanımı, rotor hızı, rotor konumu ve önceki kontrol eylemleri.
- Eylem uzayı \(A\): dört faza ait sürekli ateşleme açısı ofsetleri.
- Geçiş \(P\): bir eylem uygulandıktan sonra motorun yeni duruma geçişi.
- Ödül \(R\): düşük tork dalgalanmasını ve düzgün çalışma koşullarını teşvik eden performans sinyali.
- İskonto faktörü \(\gamma\): gelecekteki ödüllerin bugünkü optimizasyondaki ağırlığı.
Politikanın amacı beklenen iskonto edilmiş toplam ödülü büyütmektir:
\[ J(\pi)=E_{\pi}\left[\sum_{k=0}^{\infty}\gamma^k r(s_k,a_k)\right] \]
Aktör ağı
Aktörün deterministik politikası:
\[ a=\mu(s|\theta^\mu) \]
şeklindedir. Kaynakta aktör ağı 13 boyutlu motor durum vektörünü almakta; 256, 128 ve 64 nöronlu üç fully-connected gizli katman kullanmakta ve dört çıkış nöronuyla dört faz ateşleme açısı ofseti üretmektedir. Gizli katmanlarda ReLU, çıkışta tanh etkinleştirmesi kullanılmaktadır.
Tanh çıktısı fiziksel açı sınırına dönüştürülerek eylemin motorun uygulanabilir komütasyon alanında kalması sağlanır.
Eleştirmen ağı
Eleştirmen ağı hem motor durumunu hem aktörün eylemini alır ve:
\[ Q(s,a|\theta^Q) \]
ile temsil edilen uzun dönem eylem değerini tahmin eder. Kaynakta eleştirmenin 13 boyutlu durum ile dört boyutlu eylemi toplam 17 boyutlu girişte birleştirdiği; 256 ve 128 nöronlu katmanlardan sonra tek bir skaler Q-değeri ürettiği açıklanmaktadır.
Eleştirmen için hedef:
\[ y_k=r_k+\gamma Q'\left(s_{k+1}, \mu'(s_{k+1}|\theta^{\mu'})|\theta^{Q'}\right) \]
olarak kurulmuştur. Tahmin edilen Q-değeri ile bu hedef arasındaki farkın karesi küçültülerek critic eğitilir.
Aktör–eleştirmen etkileşimi
Aktör doğrudan doğru eylemi “bilmez”. Eleştirmenin Q-değerinin eyleme göre gradyanından yararlanır:
\[ \nabla_{\theta^\mu}J \approx \frac{1}{N}\sum_{k=1}^{N} \nabla_aQ(s,a|\theta^Q)|_{a=\mu(s)} \nabla_{\theta^\mu}\mu(s|\theta^\mu) \]
Bu gradyan, aktörü eleştirmenin daha yüksek uzun vadeli ödülle ilişkilendirdiği ateşleme açılarına yönlendirir.
Deneyim tekrar belleği ve hedef ağlar
Her etkileşim:
\[ (s_k,a_k,r_k,s_{k+1}) \]
dörtlüsü olarak replay buffer'a kaydedilir. Eğitim sırasında geçmiş deneyimlerden rastgele mini-batch örneklenmesi zaman ardışıklığından kaynaklanan korelasyonu azaltır.
Aktör ve eleştirmenin ayrıca yavaş güncellenen hedef kopyaları bulunur. Çalışmada soft-update faktörü \(\tau=0.005\) olarak kullanılmıştır. Amaç, öğrenen ağlardaki hızlı değişimin hedef değerlerini aynı anda aşırı oynatmasını engellemektir.
Keşif gürültüsü
Eğitimin başında eyleme Ornstein–Uhlenbeck gürültüsü eklenmektedir:
\[ a_t=\mu(s_t|\theta^\mu)+N_t \]
Kaynakta gürültü parametreleri \(\mu=0\) ve \(\sigma=0.25\) olarak verilmiştir. Bu yaklaşım sürekli eylem uzayında farklı ateşleme zamanlarının araştırılmasını sağlar.
Temel eğitim hiperparametreleri
| Parametre | Değer |
|---|---|
| Aktör öğrenme oranı | 1 × 10⁻⁴ |
| Eleştirmen öğrenme oranı | 2 × 10⁻⁴ |
| İskonto faktörü \(\gamma\) | 0,99 |
| Hedef ağ güncellemesi \(\tau\) | 0,005 |
| Replay buffer | 1 × 10⁶ örnek |
| Mini-batch | 128 |
| Keşif gürültüsü | Ornstein–Uhlenbeck, μ = 0, σ = 0,25 |
| Maksimum eğitim | 500 episode |
| Episode uzunluğu | 1 s simülasyon |
Kaynak, bu hiperparametrelerin davranışsal yorumlarını “heuristic” olarak nitelendirir ve bunların biçimsel kararlılık veya yakınsama garantisi oluşturmadığını açıkça belirtir.
Ödül ve tork dalgalanması arasındaki ilişki
Sonuç analizinde verilen basit ödül ilişkisi:
\[ r=100-TR(\%) \]
şeklindedir. Tork dalgalanması küçüldükçe ödül büyür. Şekil 24'te eğitimin başlangıcındaki yüksek dalgalanma ve düşük ödülün, yaklaşık 0,15 s sonrasında daha düşük dalgalanma ve yüksek ödüle doğru geçtiği gösterilmektedir.
Bununla birlikte makale başka bölümlerde ödül fonksiyonunun tork izleme hatası ve kontrol varyasyonlarını da cezalandırdığını ifade etmektedir. Bu nedenle Equation 30, sonuç grafiğinin yorumlanmasında kullanılan açık lineer ilişki olarak değerlendirilmelidir; kaynakta verilen bütün ödül tasarım ayrıntılarının tek eşitliği olduğu varsayılmamalıdır.
Çalışmanın Yöntemi ve Bulguları
Simülasyon sistemi
MATLAB Simulink R2024b ortamındaki sistem dört ana fiziksel/kontrol bileşeninden oluşmaktadır:
- 8/6 kutuplu dört fazlı SRM,
- dört fazlı ASHB güç dönüştürücüsü,
- motor durumlarını toplayan observation/state bloğu,
- ateşleme açısı ofsetlerini üreten DDPG aktör–eleştirmen ajanı.
Kaynak Tablo 3'te simülasyon için 220 V DC link, 20 Nm yük, 1000–3000 RPM hız aralığı, 55 mH hizalanmış ve 12 mH hizalanmamış endüktans ile 1,5 Wb maksimum faz akı bağlanımı vermektedir.
Öğrenmenin yakınsaması
Şekil 16'da episode reward ve critic'in tahmin ettiği Episode Q0 değerlerinin eğitim boyunca yükseldiği, yaklaşık 300–350 episode sonrasında kararlı bölgeye girdiği gösterilmektedir. Eğitim en fazla 500 episode olarak yapılandırılmıştır.
Kaynak bu davranışı aktör–eleştirmen politikasının yakınsaması olarak yorumlamaktadır. Bununla birlikte çalışma teorik veya matematiksel bir global yakınsama kanıtı sunmamaktadır; Tablo 2 de kullanılan ayarların biçimsel kararlılık garantisi olmadığını açıkça belirtmektedir.
Faz akımları ve akı bağlanımı
Şekil 17 dört faz akımının sıralı ve kısmen örtüşen profillerini göstermektedir. Kaynak, yaklaşık 20–22 A tepe akımlarındaki fazlar arası eşitsizliği rotor konumu ve endüktans farklılıklarını telafi eden öğrenilmiş akım modülasyonu olarak yorumlamaktadır.
Şekil 18'de akı bağlanımı her fazda sıralı olarak yükselip azalmakta ve tepe seviyeleri yaklaşık 1,3–1,5 Wb aralığında raporlanmaktadır. Bu örtüşen manyetik enerji profili toplam elektromanyetik torkun sürekliliğine katkı sağlamaktadır.
1000–3000 RPM arasındaki sonuçlar
| Referans hız (RPM) | Kararlı hız (RPM) | Yük (Nm) | Ortalama tork (Nm) | Tmax (Nm) | Tmin (Nm) | Yerleşme süresi (s) | Tork dalgalanması (%) |
|---|---|---|---|---|---|---|---|
| 1000 | 1012,4 | 20 | 20,53 | 20,74 | 20,31 | 0,3 | 2,08 |
| 1500 | 1513,3 | 20 | 20,79 | 20,96 | 20,65 | 0,3 | 1,48 |
| 2000 | 2008,6 | 20 | 21,06 | 21,21 | 20,94 | 0,3 | 1,29 |
| 2500 | 2506,9 | 20 | 21,32 | 21,51 | 21,22 | 0,3 | 1,38 |
| 3000 | 3038,6 | 20 | 21,61 | 21,89 | 21,51 | 0,3 | 1,75 |
Bu sonuçlarda en düşük raporlanan dalgalanma 2000 RPM'deki %1,29; en yüksek değer ise 1000 RPM'deki %2,08'dir. İncelenen bütün simülasyon noktalarında değer %3'ün altındadır.
DDPG-RL, TSF ve DITC karşılaştırması
| Hız | DDPG-RL | TSF | DITC |
|---|---|---|---|
| 1500 RPM | 1,48% | 16,16% | 24,26% |
| 3000 RPM | 1,75% | 23,01% | 32,16% |
Karşılaştırma aynı 8/6 motor modeli, dört fazlı ASHB dönüştürücü, 220 V DC link, 20 Nm yük ve aynı hız noktaları altında gerçekleştirilmiştir. TSF için sabit cubic torque-sharing lookup table, DITC için sabit hysteresis band ve komütasyon açıları kullanılmıştır. DDPG-RL ise ateşleme açılarını öğrenilmiş politika üzerinden adaptif biçimde değiştirmektedir.
Bu sonuç, yalnız kaynakta uygulanan TSF ve DITC yapılandırmalarıyla yapılan karşılaştırmayı destekler. “DDPG bütün olası klasik kontrol yöntemlerinden her durumda üstündür” gibi daha geniş bir sonuç bu çalışmadan çıkarılamaz.
Donanım doğrulaması
Sayfa 35–38'de gösterilen deney düzeneğinde 8/6 SRM, mekanik olarak ayrı uyartımlı DC jeneratöre bağlanmıştır. Jeneratör, ayarlanabilir mekanik yük oluşturur. ASHB dönüştürücü üzerinden sürülen motorun denetimi Wavect FPGA tabanlı dijital kontrolcü tarafından gerçekleştirilmiştir.
Kaynak deneysel motor için şu özellikleri raporlamaktadır:
| Özellik | Değer |
|---|---|
| Şaft gücü | 3,7 kW / 5 HP |
| Besleme | 220 V |
| Akım | 5–10 A |
| Konfigürasyon | 8 stator / 6 rotor kutbu |
| Nominal hız | 3000 RPM |
| Nominal tork | 8–25 Nm |
| Faz direnci | 0,22 Ω/faz |
| Atalet momenti | 0,0055 kg·m² |
| Encoder | 24 PPR |
| Raporlanan verim | 90% |
Tork-hız ölçer cihazın kg·m cinsinden verdiği mekanik tork:
\[ T_{\mathrm{Nm}}=T_{\mathrm{kg\cdot m}}\times 9.81 \]
eşitliğiyle Nm'ye çevrilmiştir.
Deneysel ortalama tork sonuçları
| Hız (RPM) | Tork (kg·m) | Tork (Nm) | Çıkış gücü (kW) |
|---|---|---|---|
| 1002 | 2,09 | 20,51 | 2,16 |
| 1503 | 2,11 | 20,71 | 3,26 |
| 2001 | 2,13 | 20,90 | 4,38 |
| 2504 | 2,15 | 21,09 | 5,55 |
| 3005 | 2,17 | 21,28 | 6,67 |
Deneysel Doğrulamada Tork Dalgalanması Doğrudan Ölçüldü mü?
Hayır. Kaynak çalışmada deneysel düzenek ortalama mekanik tork, şaft hızı ve çıkış gücü ölçümlerini sağlamaktadır; tepe-tepe tork dalgalanması ise gerekli yüksek bant genişlikli anlık tork ölçümü yapılmadığı için simüle edilmiş elektromanyetik tork dalga biçimlerinden hesaplanmıştır.
Bu ayrım çalışmanın kanıt düzeyini doğru yorumlamak için kritiktir. Donanım sonuçları, eğitilmiş DDPG politikasının FPGA üzerinde gerçek zamanda çalıştırılabildiğini ve deneysel ortalama torkun simülasyondaki ortalama torkla yakın olduğunu göstermektedir. Ancak Tablo 7'deki %1,29–%2,08 değerleri doğrudan deneysel tork sensörüyle ölçülmüş ripple değerleri değildir.
Kaynak içindeki sayısal raporlama farklılıkları
Kaynak bazı parametreleri farklı bölümlerde farklı ölçeklerde raporlamaktadır ve bunların sessizce tek bir değere indirgenmesi uygun değildir.
- Simülasyon Tablo 3'te 75 kW rated power belirtilmektedir; deneysel motor Tablo 10'da 3,7 kW / 5 HP olarak verilmiştir.
- Tablo 3'te simüle edilmiş faz akımı 5–10 A olarak belirtilirken Şekil 17'nin yorumunda faz akımlarının yaklaşık 20–22 A tepe değerlere ulaştığı ifade edilmektedir.
- Deneysel motor için 3,7 kW şaft gücü verildiği hâlde Tablo 11'de yüksek hız noktalarında 5,55 kW ve 6,67 kW çıkış gücü raporlanmaktadır.
Bu değerlerin nasıl uzlaştırılması gerektiğine ilişkin kaynakta yeterli açıklama bulunmadığından Verianla bunları yeniden hesaplayarak veya varsayım ekleyerek düzeltmemektedir. Yeniden üretilebilirlik veya tasarım ölçeklendirmesi amacıyla kullanılacaksa bu noktaların corresponding author tarafından açıklığa kavuşturulması gerekir.
Çalışmanın desteklediği sonuçlar
- DDPG ajanı dört fazın ateşleme açısı ofsetlerini sürekli kontrol eylemleri olarak öğrenebilmektedir.
- İncelenen simülasyon koşullarında tork dalgalanması %1,29–%2,08 arasında raporlanmıştır.
- Aynı çalışmadaki TSF ve DITC yapılandırmalarına göre DDPG-RL daha düşük tork dalgalanması üretmiştir.
- Öğrenilmiş politika FPGA tabanlı kontrolcüye aktarılmış ve gerçek motor düzeneğinde çalıştırılmıştır.
- Deneysel ortalama mekanik tork değerleri, raporlanan simülasyon ortalama torklarına yakın bulunmuştur.
- DDPG'nin sürekli eylem uzayı, ateşleme açısının faz bazında ince ayarlanmasına uygundur.
Çalışmanın desteklemediği sonuçlar
- Deneysel sistemde %1,29–%2,08 tork dalgalanmasının doğrudan sensörle ölçüldüğü söylenemez.
- 1000–3000 RPM dışındaki performans bu deneylerle doğrulanmamıştır.
- Düşük maliyetli tüm gömülü kontrolcülerde online öğrenmenin uygulanabilir olduğu gösterilmemiştir.
- DDPG'nin bütün SRM geometrilerinde, güç sınıflarında ve yük koşullarında aynı performansı vereceği sonucu çıkarılamaz.
- Akustik gürültü azaltımı doğrudan ölçülmemiştir; gelecek çalışma konusu olarak bırakılmıştır.
- Enerji verimliliği–tork ripple çok amaçlı optimizasyonu mevcut çalışmanın bir parçası değildir.
- Kaynakta biçimsel global kararlılık veya DDPG yakınsama kanıtı sunulmamaktadır.
Sınırlılıklar ve gelecek çalışmalar
Yazarlar ilk olarak eğitimin ve doğrulamanın belirli bir 1000–3000 RPM çalışma bölgesiyle sınırlı olduğunu belirtmektedir. Bu bölgenin çok dışına çıkılması yeni eğitim veya ek adaptasyon gerektirebilir.
İkinci sınırlılık offline eğitim maliyetidir. DDPG'nin politika öğrenmesi çok sayıda simülasyon episode'u gerektirir; ancak eğitim tamamlandıktan sonra gerçek zamanlı uygulamada politika sabit denetleyici gibi kullanılmaktadır.
Üçüncü sınır hesaplama platformudur. Çalışma FPGA gibi yüksek performanslı dijital kontrol platformlarında uygulanabilirlik göstermektedir; düşük maliyetli donanım üzerinde özellikle online öğrenme için işlemci ve bellek kısıtları bulunabilir.
Gelecek çalışma yönleri; daha geniş hız bölgesi, daha kısa eğitim süresi, verim–tork dalgalanması arasında çok amaçlı optimizasyon, akustik gürültünün doğrudan bastırılması, batarya beslemeli elektrikli araç platformuyla entegrasyon ve daha verimli online adaptasyon yöntemleridir.
Kaynak ve Yöntem Notu
Özgün çalışma: Deep Deterministic Policy Gradient-Based Actor–Critic Reinforcement Learning for Torque Ripple Minimization in Switched Reluctance Motors
Yazarlar: Divya Ramasamy; Sundaram Maruthachalam.
Kurumlar: Department of Electrical and Electronics Engineering, PSG Institute of Technology and Applied Research; Department of Electrical and Electronics Engineering, PSG College of Technology, Tamilnadu, India.
Corresponding author: Divya Ramasamy.
Dergi: Machines.
Yayıncı: MDPI.
Cilt / sayı / makale: 14(3), 333.
DOI: 10.3390/machines14030333.
Gönderim: 9 Ocak 2026.
Revizyon: 25 Şubat 2026.
Kabul: 11 Mart 2026.
Yayın: 16 Mart 2026.
Kaynak türü ve hakemlik: Hakem değerlendirmesinden geçmiş araştırma makalesi.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Finansman: Araştırmanın kamu, ticari veya kâr amacı gütmeyen finansman kuruluşlarından belirli bir fon almadığı bildirilmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemektedir.
Veri erişilebilirliği: Çalışmanın özgün katkılarının makale içinde bulunduğu ve ek soruların corresponding author'a yöneltilebileceği belirtilmektedir.
Yazar katkıları: Kavramsallaştırma D.R. ve S.M.; yöntem, yazılım ve doğrulama D.R.; formal analiz ve kaynaklar S.M.; özgün taslak D.R.; inceleme/düzenleme D.R.; görselleştirme D.R. ve S.M.; danışmanlık S.M.
Yöntem: Deneysel endüktans karakterizasyonu + MATLAB Simulink DDPG eğitimi + 8/6 SRM simülasyonu + TSF ve DITC karşılaştırması + FPGA tabanlı gerçek zamanlı donanım uygulaması.
Temel deney sınırı: Donanım deneyi ortalama mekanik tork ve hız davranışını doğrulamaktadır; tork dalgalanması yüzdesi doğrudan deneysel anlık tork ölçümünden değil simüle edilmiş elektromanyetik torktan hesaplanmıştır.
Kaynak içi raporlama uyarısı: Simülasyon ve deney motor gücü ile bazı akım değerleri farklı bölümlerde birbiriyle doğrudan uyuşmayan biçimde raporlanmaktadır. Kaynak yeterli açıklama vermediği için bu değerler Verianla tarafından düzeltilmemiş veya tek bir ortak değere zorlanmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir