

Herkes Aynı Anda Aynı Şeyi Bilmeyebilir
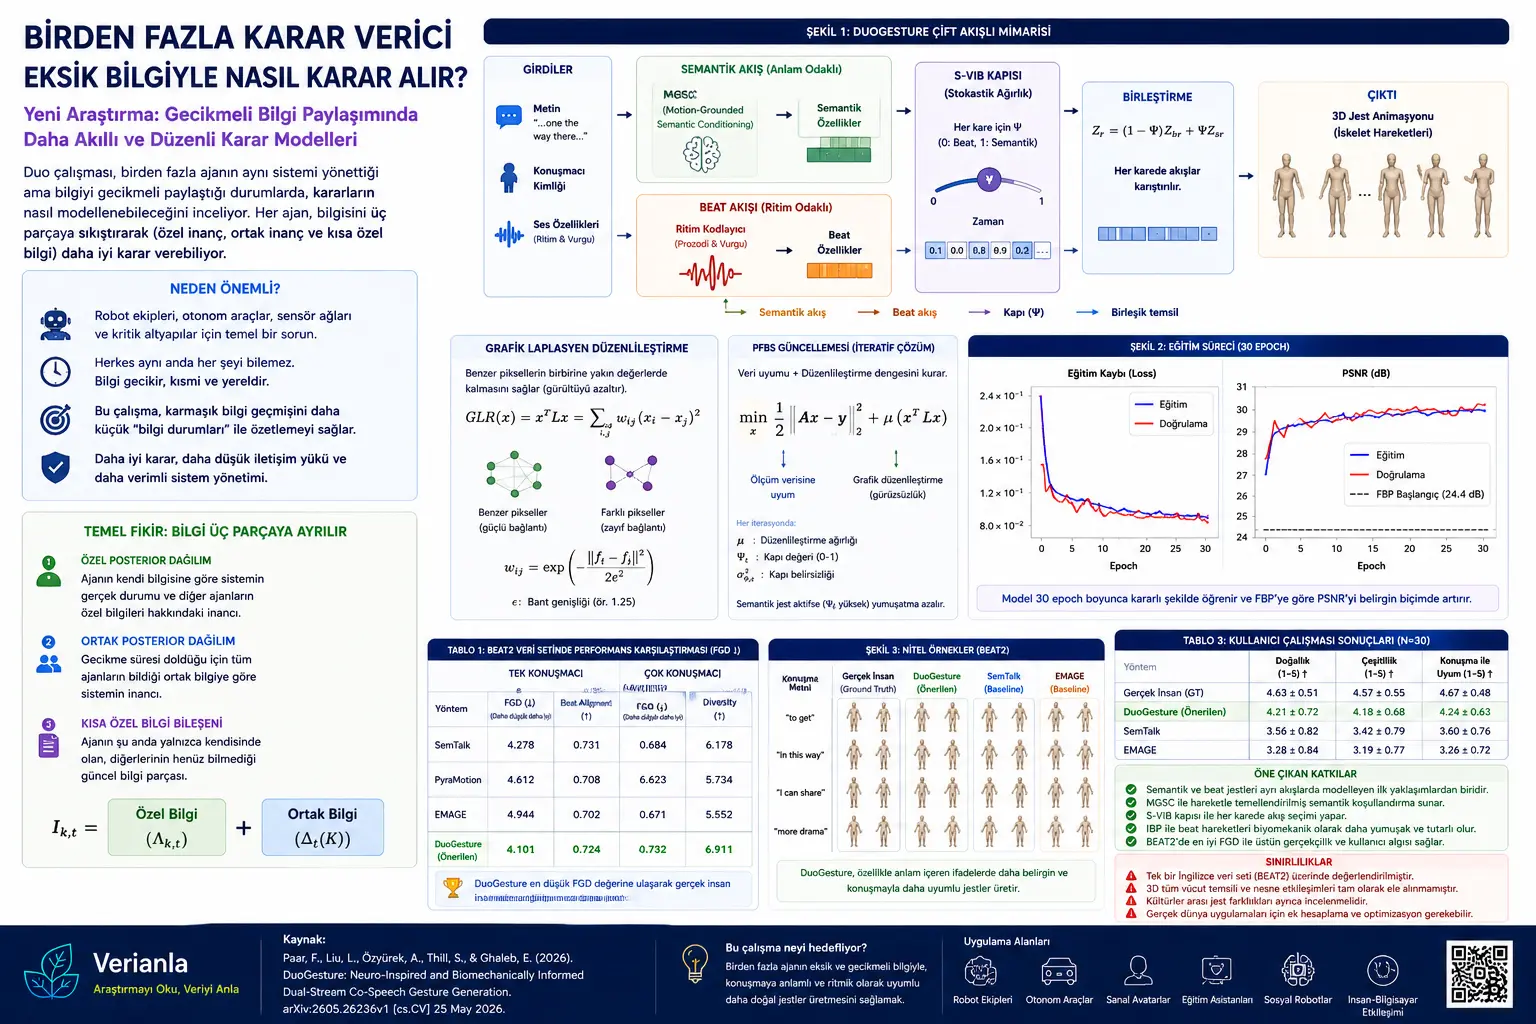
Günlük hayatta birçok sistem tek bir karar verici tarafından yönetilmez. Birden fazla kişi, sensör, robot, kontrol merkezi veya yazılım ajanı aynı sistem üzerinde karar alabilir.
Örneğin:
Bir robot ekibi aynı depoda çalışabilir.
Bir enerji şebekesinde farklı kontrol merkezleri farklı bölgeleri izleyebilir.
Bir otonom araç filosunda her araç kendi sensörlerini görür ama diğer araçların bilgisini gecikmeli alır.
Bir savunma, haberleşme veya afet izleme ağında farklı gözlem noktaları farklı bilgiye sahip olabilir.
Bu tür sistemlerde en büyük sorun şudur:
Her karar verici sistemin tamamını görmez.
Bir ajan kendi ölçümlerini hemen bilir, ama diğer ajanların gördüğü bilgileri daha sonra öğrenebilir. Bazı bilgiler ortak hale gelir, bazıları özel kalır. Bu durumda iyi karar vermek, yalnızca “ne gördüm?” sorusuna değil, “diğerleri ne biliyor, neyi henüz bilmiyor, neyi gecikmeli öğrenecek?” sorusuna da bağlıdır.
Bu makalenin ilgilendiği ana problem tam olarak budur.
POMDP Ne Demek?
Makalenin temel kavramlarından biri POMDP’dir. Açılımı Partially Observable Markov Decision Process’tir. Türkçeye “kısmi gözlemlenebilir Markov karar süreci” olarak çevrilebilir.
Bunu sadeleştirirsek:
Bir sistemin gerçek durumu vardır, ama karar verici bu durumu tam olarak göremez. Bunun yerine gürültülü veya eksik gözlemler alır. Karar verici bu gözlemlerle sistemin hangi durumda olabileceğine dair bir inanç oluşturur ve ona göre eylem seçer.
Tek karar vericili POMDP’de bu zaten zordur. Ama bu makalede problem daha da zorlaşır: Birden fazla karar verici vardır ve her biri farklı bilgiye sahiptir.
Bu nedenle konu “merkezi olmayan POMDP” haline gelir.
Gecikmeli Bilgi Paylaşımı Ne Anlama Geliyor?
Makalede T-adım gecikmeli bilgi paylaşımı inceleniyor. Bunun anlamı şudur:
Bir karar verici kendi yeni gözlemini hemen bilir. Fakat diğer karar vericiler bu bilgiyi ancak T zaman adımı sonra öğrenir.
Örneğin T = 2 ise, bir ajanın şu anda gördüğü bilgi diğerleri için iki adım sonra ortak bilgi haline gelir.
Bu durumda her ajanın bilgisi iki parçaya ayrılır:
Özel bilgi: Ajanın şu anda bildiği ama diğerlerinin henüz bilmediği bilgi.
Ortak bilgi: Gecikme süresi dolduğu için tüm ajanların artık bildiği bilgi.
Bu ayrım önemlidir. Çünkü karar verici hem kendi yeni bilgisini hem de herkesin bildiği ortak geçmişi kullanarak karar verir.
Makaledeki Temel Bilgi Formülü Ne Anlatıyor?
Makaledeki bilgi yapısı sade biçimde şöyle okunabilir:
Ik,t = Λk,t ∪ Δt(K)
Bu formülde:
Ik,t, k numaralı ajanın t anındaki toplam bilgisidir.
Λk,t, o ajanın özel bilgisidir.
Δt(K), tüm ajanların ortak paylaştığı gecikmiş bilgidir.
Günlük dille:
Bir ajanın kararı = kendi özel bilgisi + herkesin bildiği ortak bilgi üzerine kurulur.
Bu basit gibi görünür, ama çok ajanlı karar problemlerinde kritik bir ayrımdır. Çünkü hangi bilginin özel, hangi bilginin ortak olduğunu bilmeden doğru karar modeli kurulamaz.
Karar Stratejisi Ne Demek?
Makaledeki bir diğer temel ifade şudur:
Uk,t = γk,t(Ik,t)
Bu formülün sade anlamı:
Ajanın eylemi, o anda sahip olduğu bilgiye göre seçilir.
Burada:
Uk,t, k numaralı ajanın t anındaki eylemidir.
γk,t, ajanın karar stratejisidir.
Ik,t, ajanın o anki bilgi yapısıdır.
Yani ajan rastgele karar vermez; elindeki bilgiye göre bir strateji uygular.
Fakat sorun şudur: Zaman ilerledikçe bilgi geçmişi büyür. Eğer ajan tüm geçmişi olduğu gibi taşımak zorunda kalırsa problem hızla hesaplanamaz hale gelir. Bu yüzden bilgi sıkıştırma gerekir.
Bilgi Sıkıştırma Neden Önemli?
Bir karar vericinin tüm geçmiş gözlemleri, geçmiş eylemleri ve diğer ajanlardan gecikmeli gelen tüm bilgileri sakladığını düşünelim. Zaman arttıkça bu bilgi yığını büyür.
Bu, iki açıdan sorunludur:
Birincisi, karar hesaplaması zorlaşır.
İkincisi, strateji tanımı büyüyen geçmişe bağlı hale gelir.
Klasik POMDP teorisinde bu sorun “inanç durumu” ile çözülür. Karar verici tüm geçmişi saklamak yerine, sistemin hangi durumda olabileceğine dair bir olasılık dağılımı taşır.
Bu makale de benzer bir fikri merkezi olmayan sistemlere taşımaya çalışıyor. Ama burada tek bir inanç yetmez. Çünkü her ajan farklı özel bilgiye ve ortak bilgiye sahiptir.
Çalışmanın Ana Fikri: Üç Parçalı Bilgi Durumu
Makalenin en önemli sonucu, her ajanın gecikmeli bilgi yapısını üç parçaya sıkıştırabileceğini söylemesidir.
1. Özel posterior dağılım
Ajanın kendi bilgisine göre sistemin gerçek durumu ve diğer ajanların görmediği özel bilgiler hakkında oluşturduğu olasılıksal inançtır.
Sade anlatımla:
“Benim gördüklerime göre sistem ve diğer ajanların özel tarafları hakkında neye inanıyorum?”
2. Ortak posterior dağılım
Tüm ajanların ortak bilgisine göre sistem hakkında oluşan ortak olasılıksal inançtır.
Sade anlatımla:
“Herkesin bildiği ortak geçmişe göre sistem hakkında ortak tahminimiz ne?”
3. Ajanın kısa özel bilgi bileşeni
Ajanın hâlâ yalnızca kendisinde bulunan güncel özel bilgi parçasıdır.
Sade anlatımla:
“Şu anda sadece benim bildiğim ama herkesin henüz öğrenmediği kısa bilgi ne?”
Bu üçlü yapı, ajanların sonsuz büyüyen geçmişe bakmadan karar üretmesini sağlayabilecek teorik bir sıkıştırma sunar.
“Özel İnanç” ve “Ortak İnanç” Farkı Nedir?
Bu makaleyi anlamanın en önemli yolu, özel inanç ile ortak inanç farkını kavramaktır.
Bir depoda çalışan iki robot düşünelim.
Robot A, önünde bir engel gördü. Robot B henüz bunu bilmiyor. Ama ikisi de birkaç saniye önce paylaşılan harita bilgisini biliyor.
Bu durumda:
Ortak inanç, iki robotun da bildiği eski harita ve eski gözlemlerden oluşur.
Robot A’nın özel inancı, kendi yeni engel gözlemini de içerir.
Robot B’nin özel inancı ise kendi gördüğü başka şeyleri içerir.
Robot A karar verirken hem ortak haritayı hem kendi yeni bilgisini kullanır. Fakat Robot B’nin henüz neyi bilmediğini de hesaba katmak gerekebilir.
Makalenin önerdiği çerçeve bu tür karmaşık bilgi asimetrilerini matematiksel olarak yönetmeye çalışır.
Dinamik Programlama Neden Kullanılıyor?
Dinamik programlama, büyük karar problemlerini zaman adımlarına bölerek çözmeye yarayan bir yöntemdir. Bugünkü karar, gelecekteki olası maliyetleri veya kazançları etkiler. Bu yüzden karar problemi geriye doğru veya adım adım analiz edilir.
Klasik tek ajanlı POMDP’de dinamik programlama, inanç durumu üzerinden yapılabilir. Bu çok önemlidir çünkü ajan tüm geçmişi değil, yalnızca güncel inanç durumunu kullanarak karar verir.
Bu makalenin katkısı, merkezi olmayan ve gecikmeli bilgi paylaşımı olan sistemlerde de benzer bir dinamik programlama yapısı kurmaya çalışmasıdır.
Ancak klasik yaklaşımdan farkı vardır: Tek bir ortak değer fonksiyonu yerine, her ajan için ayrı maliyet-devam fonksiyonları ve ayrı DP denklemleri kullanılır.
Neden Tek DP Denklemi Yetmeyebilir?
Önceki bazı çalışmalar, tüm ajanlar için ortak bilgiye dayanan tek bir dinamik programlama denklemi kullanmaya çalışmıştır.
Bu yaklaşım bazı özel durumlarda işe yarayabilir. Ancak makaleye göre, özellikle daha uzun gecikmeli paylaşım durumlarında bu tek denklemin önemli sınırlamaları vardır.
Çünkü tek ortak bilgi denklemi, her ajanın kendi özel bilgisini ve özel inancını yeterince temsil etmeyebilir. Ayrıca bazı eski yaklaşımlarda optimizasyon doğrudan eylem uzayı yerine strateji uzayı üzerinde yapılır. Bu da problemi daha ağır hale getirir.
Bu makale farklı bir yol önerir:
Her ajan için kendi bilgi yapısına bağlı ayrı bir dinamik programlama denklemi kurmak.
Böylece her ajan kendi eylem uzayı üzerinde optimizasyon yapar. Bu, klasik POMDP dinamik programlamasına daha benzer bir yapı sağlar.
Decentralized Team Equilibrium Ne Demek?
Makaledeki önemli kavramlardan biri “decentralized sequential team equilibrium”dur. Bunu sade biçimde “merkezi olmayan sıralı takım dengesi” olarak çevirebiliriz.
Buradaki fikir şudur:
Birden fazla ajan vardır. Hepsi ortak bir takım hedefini iyileştirmeye çalışır. Ama her biri kendi bilgisine göre karar verir.
Bir ajanın stratejisi değerlendirilirken, diğer ajanların stratejileri sabit tutulur. Sonra bu ajanın kendi stratejisini iyileştirip iyileştiremeyeceğine bakılır.
Bu, oyun teorisindeki Nash dengesi fikrine benzer. Ancak önemli fark şudur: Burada ajanların ayrı çıkarları değil, ortak bir takım maliyeti veya takım hedefi vardır.
Yani sistemin amacı “herkes kendi kazancını maksimize etsin” değil, “her ajan kendi bilgi sınırı içinde ortak takım hedefi için en iyi tepkiyi versin” yaklaşımıdır.
Ayrıştırma İlkesi Ne Anlama Geliyor?
Makalede “separation principle”, yani ayrıştırma ilkesi önemli bir sonuç olarak ele alınıyor.
Klasik kontrol teorisinde ayrıştırma ilkesi kabaca şunu söyler:
Önce sistemin durumunu tahmin et.
Sonra bu tahmine göre kontrol kararını ver.
Yani tahmin ve kontrol birbirinden kavramsal olarak ayrılabilir.
Bu makale, merkezi olmayan ve gecikmeli bilgi paylaşımı olan sistemlerde bunun daha genel bir versiyonunu sunmaya çalışıyor.
Her ajan önce özel ve ortak bilgi durumlarını günceller. Sonra kararını bu sıkıştırılmış bilgi durumları üzerinden verir.
Bu şu açıdan önemlidir:
Ajanın karar vermek için tüm ham geçmişi taşıması gerekmez. Tahmin edilen bilgi durumları yeterli istatistik olarak kullanılabilir.
Formüller Bize Ne Öğretiyor?
Makaledeki formüller çok teknik görünse de okuyucu için üç ana fikir taşır.
Birincisi: Her ajanın bilgisi özel ve ortak bileşenlere ayrılır.
Bu, gecikmeli paylaşımın matematiksel karşılığıdır.
İkincisi: Her ajanın eylemi kendi bilgi durumuna bağlıdır.
Yani karar stratejisi, ajanın ne bildiğiyle sınırlıdır.
Üçüncüsü: Özel ve ortak posterior dağılımlar Markov tarzı güncellenebilir.
Bu, geçmişin tamamını taşımak yerine güncel inanç durumuyla ilerlemeyi mümkün kılar.
Bu nedenle formüller yalnızca soyut semboller değildir. Asıl amaç, büyüyen bilgi geçmişini daha küçük ve karar için yeterli parçalara indirmektir.
Araştırma Ne Söylüyor?
Çalışmanın ana mesajı şudur:
Merkezi olmayan, kısmi gözlemlenebilir ve gecikmeli bilgi paylaşımı olan karar sistemlerinde her ajan, karar için gerekli bilgiyi üç parçalı bir yapıya sıkıştırabilir.
Bu üç parça:
- özel posterior dağılım,
- ortak posterior dağılım,
- kısa özel bilgi bileşimi.
Araştırmacılar ayrıca bu bilgi durumlarıyla yeni dinamik programlama denklemleri kurulabileceğini ve bu denklemlerin klasik merkezi POMDP dinamik programlamasındaki bazı temel özellikleri koruduğunu savunuyor.
Bu özelliklerden biri, optimizasyonun strateji uzayında değil, eylem uzayında yapılmasıdır. Bu teorik olarak önemlidir çünkü strateji uzayı çok daha büyük ve karmaşıktır.
Bir diğer önemli nokta, bilgi durumlarının Markov tipi güncellenebilmesidir. Bu da zamanla büyüyen veri geçmişi yerine daha yönetilebilir karar değişkenleri kullanılabileceğini gösterir.
Bu Neden Önemli?
Bu çalışma teorik görünse de günümüz teknolojileriyle güçlü bağlantıları vardır.
Çünkü birçok modern sistem merkezi değildir:
Robot ekipleri birlikte çalışır.
Otonom araç filoları bilgi paylaşır.
Enerji şebekeleri bölgesel kontrol merkezleriyle yönetilir.
Dağıtık sensör ağları çevre, afet veya güvenlik izleme yapar.
Çok ajanlı yapay zekâ sistemleri ortak görevlerde karar alır.
Bu sistemlerde herkes her şeyi aynı anda bilmez. Bilgi eksik, gecikmeli veya yalnızca yerel olabilir. Bu yüzden karar verme teorisinin yalnızca merkezi sistemler için değil, bilgi asimetrisi içeren dağıtık sistemler için de geliştirilmesi gerekir.
Makalenin önemi, bu zor problemi daha düzenli hale getiren bir matematiksel çerçeve sunmasındadır.
Dikkat Edilmesi Gereken Noktalar
Bu çalışma doğrudan hazır bir yazılım, robot kontrol algoritması veya endüstriyel uygulama değildir. Temel katkısı teorik ve matematiksel düzeydedir.
İlk olarak, çalışma preprinttir. Hakem değerlendirmesinden geçtiği varsayılmamalıdır.
İkinci olarak, makale genel dinamik programlama denklemleri ve bilgi durumu yapıları sunar. Bunların büyük gerçek sistemlerde hesaplama açısından ne kadar verimli uygulanacağı ayrı bir araştırma konusudur.
Üçüncü olarak, merkezi olmayan POMDP problemleri zaten çok zor problem sınıflarıdır. Bilgi sıkıştırma yapısı teorik olarak önemli olsa da pratik algoritmalar için ek yaklaşık çözüm yöntemleri gerekebilir.
Dördüncü olarak, çalışma takım dengesi ve kişi-kişi optimalite yaklaşımı üzerinden ilerler. Bu, her durumda tam küresel takım optimalitesi garantisi anlamına gelmeyebilir; bazı ek koşullar gerekebilir.
Beşinci olarak, gerçek robotik, enerji, savunma, finansal ağ veya trafik sistemlerine uygulanmadan önce model varsayımları, veri gecikmeleri, iletişim hataları ve güvenlik sınırları ayrıca incelenmelidir.
Sonuç
Bu araştırma, çok ajanlı ve merkezi olmayan karar sistemlerinde önemli bir soruya yanıt arıyor:
Bir ajan, tüm geçmişi taşımadan eksik ve gecikmeli bilgiyle nasıl karar verebilir?
Makalenin önerdiği yanıt, bilgiyi üç temel parçaya sıkıştırmaktır: ajanın özel inancı, herkesin ortak inancı ve ajanın kısa özel bilgisi.
Bu çerçeve, gecikmeli bilgi paylaşımı olan POMDP problemleri için yeni dinamik programlama denklemleri ve ayrıştırma ilkesi sunar. Çalışma doğrudan pratik uygulama iddiası taşımasa da, geleceğin robot ekipleri, dağıtık sensör ağları ve çok ajanlı yapay zekâ sistemleri için önemli bir teorik yön gösterir.
Bu yazının en sade mesajı şudur:
Dağıtık sistemlerde iyi karar vermek, her şeyi bilmekten değil; kimin neyi bildiğini doğru özetlemekten geçebilir.
Kaynak ve Yöntem Notu
Bu içerik, Charalambos D. Charalambous, Umarbek Guvercin ve Seddik Djouadi tarafından hazırlanan “Private & Common Information States in Decentralized Team Equilibrium via Dynamic Programming for POMDPs with Delayed Sharing” başlıklı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Çalışma arXiv üzerinde yayımlanmış preprint niteliğindedir. İçerik bilgilendirme ve eğitim amacı taşır. Kontrol sistemleri, robotik, kritik altyapı, savunma teknolojileri, finansal sistemler veya profesyonel mühendislik uygulamaları için teknik danışmanlık yerine geçmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir