

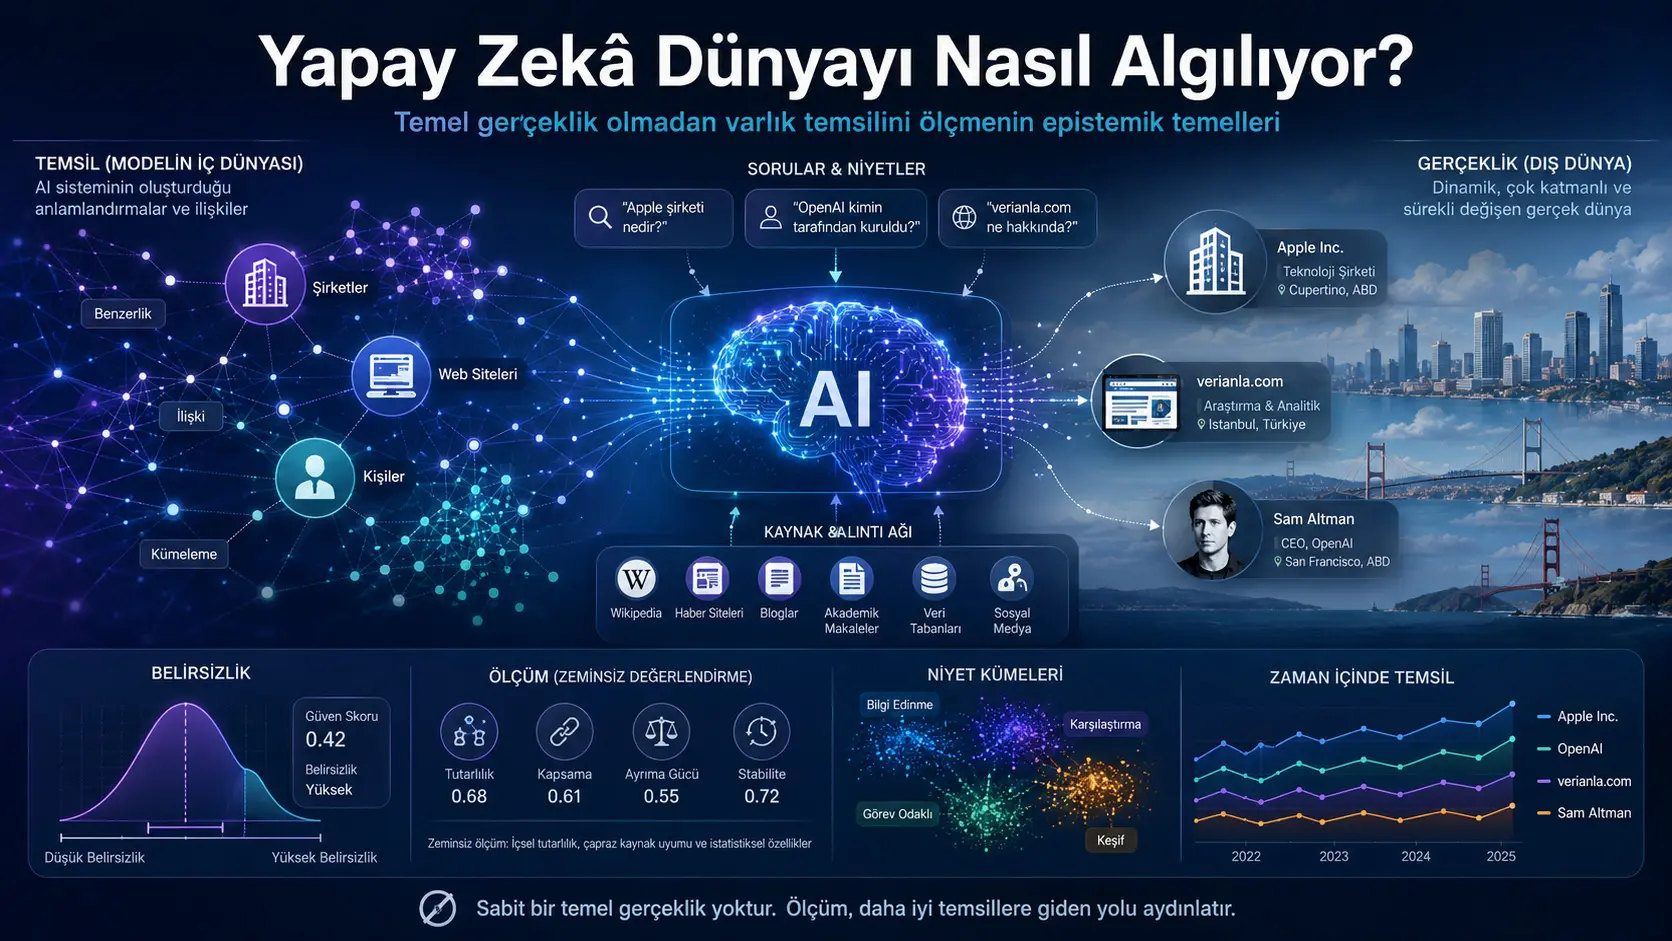
Bu iş böyük dil modellərinin şirkəti, internet saytını, şəxsi və ya başqa varlığı cavablarında necə təmsil etdiyini ölçmək üçün istifadə olunan mövcud üsulların əsas konseptual çatışmazlığa malik olduğunu müdafiə edir. Sənayedə istifadə edilən süni intellekt görünürlük alətləri çox vaxt varlığın cavablarda neçə dəfə qeyd edildiyini, nə qədər tez-tez mənbə kimi göstərildiyini və ya rəqiblərinə qarşı görünürlük payını hesablayır. Lakin işə görə bu ölçmələr əldə edilən rəqəmin hansı hədəf kəmiyyəti təmsil etdiyini əvvəlcədən kifayət qədər müəyyənləşdirmir.
Məqalənin mərkəzindəki texniki anlayış estimanddır. Estimand ölçmənin və ya statistik təxminin çatmağa çalışdığı açıq şəkildə müəyyən edilmiş hədəf kəmiyyətdir. Süni intellekt görünürlük işi yüzde 30 istinad nisbəti bildirdikdə, bu yüzde 30-un hansı sual kainatını, hansı istifadəçi niyyətlərini və hansı sorğu paylanmasını təmsil etdiyi izah edilməlidir. Əks halda rəqəm hesablanmış olsa belə nəyin ölçüldüyü qeyri-müəyyən qalır.
Müəllif böyük dil modelinin cavabını istifadəçi sorğusundan asılı təsadüfi dəyişən kimi nəzərdən keçirir. X varlığının cavabda qeyd edilmə və ya mənbə göstərilmə ehtimalı yalnız X-in xüsusiyyətlərindən deyil, modelə yönəldilən q sorğusunun kontekstindən də asılıdır. “Yaxşı avtomobil şirkəti hansıdır?” sualı ilə “Ən sürətli avtomobili hansı şirkət istehsal edir?” sualı eyni şirkətləri önə çıxarmaq məcburiyyətində deyil. Bu fərq səhv deyil, sualların fərqli informasiya ehtiyaclarını əks etdirməsinin təbii nəticəsidir.
Buna görə müəyyən sual dəstindəki bütün istinad ehtimallarını vahid ortalamada toplamaq ölçülən varlığa aid dəyişməz və kontekstdən asılı olmayan xüsusiyyət yaratmır. Nəticə sualları seçən şəxsin ölçmə dizaynından asılıdır. Tövsiyə suallarının üstünlük təşkil etdiyi dəst yüksək, müqayisə və ya texniki performans suallarının üstünlük təşkil etdiyi başqa dəst aşağı görünürlük yarada bilər. Eyni varlıq və eyni model üçün fərqli ölçmə aparanlar fərqli nəticələr əldə edə bilər.
İş bu problemi həll etmək üçün sorğuların istifadəçi niyyətlərinə görə qruplaşdırılmasını təklif edir. Varlığın süni intellektdəki təmsili vahid ümumi istinad nisbəti ilə deyil; tövsiyə, müqayisə, etibarlılıq, texniki qiymətləndirmə və digər niyyət qruplarının hər birindəki istinad nisbətlərindən ibarət təmsil sahəsi kimi müəyyənləşdirilməlidir.
Niyyət qrupları yalnız sorğularda istifadə olunan sözlərə görə yaradılmamalıdır. İşin təklifinə görə oxşar mənbə və istinad nümunələrinə çatan sorğular süni intellektin təmsil sahəsində oxşar informasiya ehtiyaclarına uyğun gələ bilər. Başqa sözlə, sorğular arasındakı niyyət yaxınlığı yalnız səthi mətn oxşarlığına deyil, cavabların hansı mənbələrə yönəldiyinə görə müəyyənləşdirilə bilər.
Estimand bu formada müəyyənləşdirildikdən sonra ölçmənin üç əsas xüsusiyyəti mənalı şəkildə araşdırıla bilər: etibarlılıq ölçmə təkrarlandıqda oxşar nəticələrin əldə edilməsini; keçərlilik ölçmənin həqiqətən ölçdüyünü iddia etdiyi konstruktı ölçməsini; əhatə isə süni intellektin təmsil sahəsinin nə qədərinin müşahidə edildiyini ifadə edir.
İşin mühüm fərqlərindən biri etibarlılıqla keçərliliyin eyni şey olmamasıdır. Səhv və ya kifayət qədər müəyyən edilməmiş sorğu dəsti yüzlərlə dəfə işlədilərək son dərəcə sabit nəticə yarada bilər. Lakin bu nəticə müvafiq varlığın təmsil sahəsini kifayət qədər əhatə etmirsə, ölçmə etibarlı olduğu halda keçərli olmaya bilər. Daha çox təkrar etmək hədəf kəmiyyətin yanlış müəyyənləşdirilməsini düzəltmir.
Varlıq təmsilinin vahid və birbaşa müşahidə edilə bilən əsas həqiqəti olmadığı üçün iş psixometriya və sosial elmlərdə inkişaf etdirilən konstrukt keçərliliyi yanaşmasından istifadə edilməsini təklif edir. Buna görə fərqli ölçmə üsullarının oxşar nəticələr verib-vermədiyi, ölçmənin nəzəri olaraq əlaqəsiz dəyişənlərdən ayrılıb-ayrılmadığı və əlaqəli olması gözlənilən xarici göstəricilərlə proqnozlaşdırılan istiqamətdə əlaqə qurub-qurmadığı qiymətləndirilməlidir.
Əhatənin ölçülməsi üçün isə ekologiyadakı “görünməmiş növlər” probleminə oxşar yanaşma təklif olunur. Yalnız bir dəfə müşahidə edilmiş istinad nümunələrinin nisbəti hələ kəşf edilməmiş təmsil bölgələrinin böyüklüyü haqqında məlumat verə bilər. Yeni sorğuların əvvəllər görünməmiş istinad nümunəsi yaratma ehtimalı kifayət qədər azaldıqda ölçmənin doyma nöqtəsinə yaxınlaşdığı düşünülə bilər.
Lakin süni intellektin özünün yaratdığı sorğular qərəzsiz deyil. Model təlim məlumatlarında tez-tez rast gəlinən və tanış sual strukturlarını daha asan yarada bilər; nadir informasiya ehtiyaclarını isə nəzərdən qaçıra bilər. Buna görə çoxlu sayda sorğu yaratmaq təmsil sahəsinin hamısının əhatə olunduğunu təkbaşına sübut etmir. Süni intellektin heç bir şəkildə yarada bilmədiyi ehtiyacların kəşfi üçün istifadəçi müsahibələri, institusional bilik və sahə ekspertizası kimi süni intellektdən kənar mənbələrə ehtiyac var.
İş riyazi ölçmə ilə insan şərhini aydın şəkildə ayırır. Niyyət sahəsinin müəyyənləşdirilməsi, tələb olunan təkrar sayının müəyyən edilməsi, keçərlilik sübutlarının araşdırılması və əhatənin təxmin edilməsi prinsip etibarilə riyazi və statistik üsullarla həll edilə bilər. Bunun əksinə süni intellekt təmsili ilə real vəziyyət arasındakı fərqin problem yaradıb-yaratmadığı və bu fərqə necə müdaxilə edilməli olduğu insan qiymətləndirməsi tələb edir.
Ən mühüm şərh məhdudiyyəti budur: İş təklif etdiyi çərçivəni real şirkətlər, şəxslər, internet saytları və ya böyük dil modelləri üzərində tətbiq etməyib. Niyyət qrupları yaradılmayıb, əhatə nisbəti hesablanmayıb, konstrukt keçərliliyi testləri həyata keçirilməyib və təklif olunan yanaşma mövcud kommersiya görünürlük alətləri ilə eksperimental olaraq müqayisə edilməyib. İşin töhfəsi doğrulanmış ölçmə sistemi təqdim etmək deyil, gələcəkdə hazırlanacaq ölçmələr üçün epistemik və riyazi təməl təklif etməkdir.
Türkiyə baxımından qiymətləndirmə: İş Türkiyədə markaların, universitetlərin, dövlət qurumlarının, şirkətlərin, ekspertlərin və internet saytlarının ChatGPT kimi sistemlərdə görünürlüğünü ölçən araşdırmalar baxımından birbaşa əhəmiyyətlidir. Məhdud sayda türkcə sorğuda əldə olunan qeyd edilmə nisbəti qurumun ümumi süni intellekt görünürlüğü kimi təqdim edilməməlidir. Ölçmədə istifadəçi niyyətləri, dil, model, model versiyası, axtarış funksiyası, tarix, təkrar sayı və təmsil sahəsinin əhatə səviyyəsi açıqlanmalıdır. Bununla belə iş türkcə sorğular, Türkiyədəki istifadəçi davranışları və ya yerli qurumlar üzərində eksperiment aparmayıb. Çərçivənin Türkiyədə istifadə edilə bilməsi üçün türkcə niyyət qrupları və yerli informasiya ehtiyacları üzərində ayrıca doğrulanması lazımdır.
Süni intellektdə varlıq təmsili nə deməkdir?
İşdə “varlıq” anlayışı şirkət, internet saytı, şəxs və ya süni intellekt cavablarında qeyd edilə bilən başqa tanınan obyekti ifadə edir. Varlıq təmsili isə modelin bu obyekti yalnız necə təsvir etməsi ilə məhdudlaşmır. Varlığın hansı sorğularda qeyd edilməsi, hansı mənbələrlə əlaqələndirilməsi, hansı kontekstlərdə önə çıxması və hansı kontekstlərdə görünməməsi də təmsilin hissələridir.
Böyük dil modelləri axtarış, tövsiyə və dialoq sistemlərinə yerləşdirildikcə bu təmsil ictimai nəticələr yarada bilər. İşə qəbul mütəxəssisi namizəd haqqında, kredit əməkdaşı şirkət haqqında və ya istehlakçı məhsul haqqında süni intellektə sual verə bilər. Modelin istifadə etdiyi təriflər və göstərdiyi mənbələr insanların formalaşdırdığı qənaətlərə təsir edə bilər.
Müəllif süni intellekt təmsilinin klassik insan qavrayışından struktur baxımından fərqli olduğunu müdafiə edir. İnsanların fikirləri cəmiyyət daxilində çoxsaylı şəxslər arasında yayılıb. Buna qarşılıq çoxlu sayda istifadəçi eyni əsas model ilə qarşılıqlı əlaqəyə girərsə, modeldəki təmsil meyli çoxsaylı insana eyni istiqamətdə ötürülə bilər. Buna görə vahid modeldəki təmsil dəyişikliyinin təsiri tək şəxsin fikrindəki dəyişiklikdən daha geniş ola bilər.
Mövcud görünürlük ölçmələrinin əsas problemi nədir?
Mövcud tətbiqlər çox vaxt əvvəlcədən seçilmiş sorğu dəstini modelə yönəldir və aşağıdakı göstəricilərdən birini və ya bir neçəsini hesablayır:
- Varlığın cavablarda qeyd edilmə nisbəti,
- İnternet saytının mənbə kimi göstərilmə nisbəti,
- Rəqiblərə görə süni intellekt görünürlük payı,
- Cavab daxilində görünürlük sırası və ya mövqeyi,
- Varlıqla birlikdə istifadə olunan müsbət və ya mənfi ifadələr,
- Fərqli modellərdə və ya zamanlarda baş verən görünürlük dəyişikliyi.
İş bu göstəricilərin əməliyyat baxımından heç bir dəyəri olmadığını demir. Tənqid göstəricinin hansı hədəf kəmiyyəti ölçdüyü izah edilmədən ümumi varlıq xüsusiyyəti kimi təqdim olunmasına yönəlir.
Estimand niyə ölçmədən əvvəl müəyyənləşdirilməlidir?
Estimand ölçmənin təxmin etməyi məqsəd qoyduğu kəmiyyətdir. Ölçmə nəticəsində əldə edilən rəqəm estimandın təxminidir; estimand isə bu rəqəmin nəyi təmsil etdiyini müəyyən edir.
Qurum üçün “süni intellekt görünürlüğü yüzde 25-dir” deyiləndə ən azı aşağıdakı sualların cavabı verilməlidir:
- Bu nisbət hansı sorğu kainatına aiddir?
- Hansı istifadəçi niyyətləri əhatə olunub?
- Sorğular hansı paylanmaya görə çəkiləndirilib?
- Hansı model və model versiyası istifadə olunub?
- Sorğular hansı dil və regional kontekstdə verilib?
- Eyni sorğu neçə dəfə təkrarlanıb?
Bu elementlər müəyyən edilməzsə görünürlük nisbəti hesablana bilər, lakin bu nisbətin qurumun hansı təmsil xüsusiyyətinə uyğun gəldiyi izah edilə bilməz.
Xam istinad nisbəti necə formullaşdırılır?
İş böyük dil modelinin cavabını giriş sorğusuna şərtlənmiş təsadüfi proses kimi nəzərdən keçirir. X varlığının q sorğusuna verilən cavabda qeyd edilmə və ya mənbə göstərilmə ehtimalı belə müəyyən edilir:
\[ p(X\mid q) \]
Burada ehtimal eyni sorğunun fərqli işə salınmalarda fərqli cavablar yarada bilməsini də əhatə edir.
Xam ölçmə yanaşması \(Q=\{q_1,\ldots,q_n\}\) formasında seçilmiş sorğu dəsti üzərində orta istinad nisbətini hesablayır:
\[ \theta= \frac{1}{|Q|} \sum_{q\in Q}p(X\mid q) \]
Bu formulda \(\theta\), X varlığının seçilmiş Q dəstindəki orta istinad nisbətidir. Problem bu dəyərin X-ə aid kontekstdən asılı olmayan xüsusiyyət kimi şərh edilməsidir.
Niyə θ yalnız X varlığının xüsusiyyəti deyil?
\(\theta\) dəyəri seçilmiş Q sorğu dəstindən asılıdır. Eyni varlıq üçün fərqli sorğu dəstləri seçildikdə ümumiyyətlə fərqli nəticələr əldə olunur:
\[ Q\neq Q' \quad\Rightarrow\quad \theta\neq\theta' \]
Məsələn, avtomobil şirkəti haqqında sorğu dəsti əsasən alış tövsiyələrindən ibarətdirsə şirkət tez-tez qeyd oluna bilər. Sorğu dəsti sürət, texniki xidmət xərci və ya konkret texniki xüsusiyyətlər üzrə müqayisələrdən ibarət olduqda eyni şirkətin qeyd edilmə nisbəti dəyişə bilər.
Buna görə nəticə yalnız süni intellektin X haqqında davranışını deyil, ölçməni aparan şəxsin hansı sualları seçdiyini də əks etdirir. Çərçivə fərqli ölçmə aparanların əldə etdiyi nəticələrdən hansının ümumi və doğru təmsil olduğunu müəyyən edəcək daxili meyar təqdim etmir.
Heterogen sorğular niyə vahid ortalamada qarışdırılmamalıdır?
Fərqli istifadəçi niyyətləri fərqli şərti ehtimallara uyğun gəlir. Tövsiyə istəmək, performansı müqayisə etmək və texniki dəstək axtarmaq eyni informasiya ehtiyacı deyil. Bu kontekstlərdəki istinad nisbətlərini vahid rəqəmdə birləşdirmək fərqli növ kəmiyyətləri eyni ortalamaya qatmaq deməkdir.
Ümumi orta alt sorğu növlərinin dəstdəki payına görə dəyişir. Ölçmə dizaynında tövsiyə sorğularına daha çox yer verilərsə nəticə tövsiyə kontekstinin davranışına yaxınlaşır. Müqayisə sorğularının payı artırılarsa fərqli nəticə yarana bilər.
İş bunu Simpson paradoksu ilə əlaqəli aqreqasiya problemi kimi qiymətləndirir. Alt qruplardakı fərqli meyllər qrupların hansı nisbətlərdə qarışdırılmasından asılı olaraq ümumi statistikada fərqli və ya aldadıcı görünüş yarada bilər.
Əvvəlki işlərin töhfəsi tamamilə rədd edilirmi?
Xeyr. İş böyük dil modellərinin təsadüfi cavab dəyişkənliyini araşdıran və etibarlı ölçmə üçün təkrarların zəruri olduğunu göstərən əvvəlki tədqiqatların vacib olduğunu bildirir. Tək müşahidə varlığın modeldəki davranışını etibarlı şəkildə təmsil etməyə bilər.
Lakin təkrar sayı və etimad intervalı ölçmənin yalnız etibarlılıq problemini həll edir. Ölçmənin həqiqətən nəzərdə tutulan konstruktı ölçüb-ölçməməsi isə keçərlilik problemidir. Ölçmə təkrarlana bilən olduğu halda yanlış və ya qeyri-müəyyən müəyyən edilmiş kəmiyyəti ölçə bilər.
İşin əlavə etdiyi mərhələ təkrar və etimad intervalından əvvəl estimandın müəyyənləşdirilməsidir.
“Təmsilçi sorğu dəsti” ifadəsi problemi həll edirmi?
Məqalə bu iddianı gözlənilən ilk etiraz kimi nəzərdən keçirir. Sorğu dəstinin təmsilçi olduğunu demək təmsil ediləcək sorğu sahəsinin və bu sahədəki paylanmanın əvvəlcədən müəyyən edilməsini tələb edir.
Hansı istifadəçi niyyətlərinin nə qədər yayğın və ya əhəmiyyətli olduğu müəyyən edilmədən bütün sorğulara bərabər çəki vermək təmsilçilik iddiasını əsaslandırmır. “Təmsilçi sorğu dəsti” ifadəsi buna görə estimand problemini aradan qaldırmaq əvəzinə yenidən gündəmə gətirir.
İnsan qavrayışı da kontekstdən asılıdırsa süni intellekt niyə ayrıca nəzərdən keçirilir?
Məqalə insan qavrayışının da kontekstdən asılı olduğunu qəbul edir. Lakin iki fərq vurğulanır:
- İnsan fikirləri çoxsaylı şəxslər arasında yayılarkən, konkret modelin təmsil davranışı çoxsaylı istifadəçiyə eyni mərkəzdən ötürülə bilər.
- Süni intellekt təmsilinin paylanması model yeniləmələri ilə dəyişə və kiçik ifadə fərqlərinə yüksək həssaslıq göstərə bilər.
Buna görə insanlar üçün hazırlanmış ölçmə nəzəriyyələrinin heç bir dəyişiklik edilmədən süni intellektə tətbiqi təhlükəsiz fərziyyə deyil.
İş süni intellekt təmsilinin ölçülə bilməyəcəyini müdafiə edirmi?
Xeyr. İşin üçüncü gözlənilən etiraza verdiyi cavab ölçməni rədd etmək əvəzinə ölçüləcək obyekti yenidən müəyyənləşdirməkdir. Vahid və kontekstdən asılı olmayan istinad nisbəti əvəzinə istifadəçi niyyətlərinə şərtlənmiş istinad sahəsi təklif olunur.
Niyyət şərtləndirməsi estimandı necə müəyyən edir?
Sorğu sahəsi istifadəçilərin qarşılamağa çalışdığı informasiya ehtiyacına görə niyyət qruplarına ayrılır. Müəyyən \(c\) niyyət qrupundakı istinad nisbəti belə müəyyən edilir:
\[ \theta_c= \mathbb{E} \left[ p(X\mid q) \mid q\in c \right] \]
Buradakı \(\theta_c\), X varlığının bütün sorğulardakı ümumi görünürlüğü deyil. Yalnız konkret niyyət kontekstindəki orta istinad ehtimalıdır.
Məsələn, eyni avtomobil istehsalçısı üçün aşağıdakı dəyərlər ayrıca ölçülə bilər:
- Ailə avtomobili tövsiyəsi kontekstində istinad nisbəti,
- Elektrikli avtomobil müqayisələrində istinad nisbəti,
- Performans avtomobili sorğularında istinad nisbəti,
- Texniki xidmət xərci qiymətləndirmələrində istinad nisbəti,
- Təhlükəsizlik qiymətləndirmələrində istinad nisbəti.
İşə görə varlığın süni intellektdəki təmsili vahid \(\theta\) dəyəri deyil, niyyət sahəsi boyunca müəyyən edilmiş \(\theta_c\) dəyərlərinin bütövlüyüdür.
Niyyət qrupları necə yaradılmalıdır?
Müəllif yalnız söz oxşarlığına əsaslanan təsnifatın niyyəti düzgün tuta bilməyəcəyini bildirir. Heç bir ortaq söz işlətməyən iki sorğu eyni informasiya ehtiyacını daşıya bilər. Bunun əksinə bir-birinə çox oxşayan iki sorğu fərqli məqsədlərə sahib ola bilər.
İşin təklif etdiyi əməliyyat yanaşması sorğuların cavablarda yaratdığı istinad nümunələrindən istifadə etməkdir. Eyni və ya oxşar mənbə dəstlərinə yönələn sorğular süni intellekt baxımından oxşar informasiya ehtiyacları ilə əlaqəli qəbul edilə bilər.
Bu yanaşma aşağıdakı fərziyyəyə əsaslanır:
Oxşar istinad nəticələrinə çatan sorğular süni intellektin təmsil sahəsində bir-birinə yaxın niyyətləri əks etdirir.
Bu fərziyyə məqalədə eksperimental olaraq sınaqdan keçirilməyib. İnsanlar tərəfindən etiketlənmiş real istifadəçi niyyətləri ilə istinad nümunəsinə əsaslanan qrupların nə qədər üst-üstə düşdüyü açıq tədqiqat sualıdır.
Niyyət sahəsi yalnız ölçmə dəqiqliyini artıran alətdirmi?
Xeyr. Məqaləyə görə niyyət sahəsi ölçməni daha dəqiq edən ikinci dərəcəli texnika deyil. Estimandın müəyyənləşdirilməsi üçün məntiqi baxımdan zəruri komponentdir.
Kontekst fərqləri ayrılmadan sorğular birləşdirildikdə ölçməni aparan şəxsə bağlılıq və qarışdırma qərəzi davam edir. Təmsil yalnız niyyət qruplarına şərtlənmiş \(\theta_c\) dəyərləri şəklində açıq hədəf kəmiyyətə çevrilir.
Etibarlılıq necə həll edilməlidir?
Hər niyyət qrupundakı \(\theta_c\) dəyərinin yenidən istehsal edilə bilən şəkildə təxmin olunması üçün kifayət qədər müşahidə lazımdır. Tələb olunan təkrar sayı bütün qruplarda eyni olmaq məcburiyyətində deyil.
- Sabit istinad nümunələrinə malik qruplarda az sayda müşahidə kifayət edə bilər.
- Yüksək cavab dəyişkənliyi göstərən qruplarda daha çox təkrar tələb oluna bilər.
- Xəta tolerantlığı və etimad səviyyəsi əvvəlcədən müəyyən edilə bilər.
- İstinad nümunəsi kifayət qədər sabitliyə çatdıqda nümunələmə dayandırıla bilər.
İş bu yanaşmanı uyğunlaşan müşahidə proseduru kimi təqdim edir. Konkret sabit təkrar sayı və ya orijinal nümunə ölçüsü formulu hazırlamır.
Az sayda sorğu ilə statistik ölçmə aparmaq mümkündürmü?
Çoxsaylı niyyət qruplarının hər birində kifayət qədər təkrar aparmaq yüksək hesablama və sorğu xərci yarada bilər. Müəllif az sayda ucuz müşahidə ilə daha az saydakı yüksək keyfiyyətli müşahidənin birlikdə istifadə edilməsini təklif edir.
İşdə bu məqsədlə iki mövcud metod sahəsi qeyd olunur:
- Proqnoz dəstəkli çıxarım,
- Aktiv statistik çıxarım.
Əsas fikir az təkrara əsaslanan kobud təxminlərdəki sistematik qərəzin çox təkrarlı və daha dəqiq məhdud saydakı müşahidə ilə düzəldilməsidir. Kalibrasiya tamamlandıqdan sonra daha az müşahidə ilə statistik təminat əldə etmək hədəflənə bilər.
Bu üsullar iş çərçivəsində tətbiq edilməyib və xərc azalması nisbəti ölçülməyib.
Əsas həqiqət olmadan ölçmə keçərliliyi necə sınaqdan keçirilə bilər?
Varlıq təmsili birbaşa müşahidə edilə bilən fiziki xüsusiyyət deyil. Həmçinin müəyyən sorğuda hansı varlığın mütləq qeyd edilməli olduğunu müəyyən edən vahid və mübahisəsiz doğru siyahı olmaya bilər. Buna görə klassik dəqiqlik ölçüsü birbaşa tətbiq edilə bilməz.
İş psixometriya və sosial elmlərdə istifadə edilən konstrukt keçərliliyi yanaşmasını təklif edir. Bu yanaşma keçərliliyi vahid referens dəyər əvəzinə fərqli sübut mənbələrinin birləşməsi ilə qiymətləndirir.
| Keçərlilik növü | Əsas sual | Varlıq təmsili üçün nümunə |
|---|---|---|
| Yaxınlaşan keçərlilik | Eyni konstruktı fərqli üsullarla ölçən nəticələr bir-biri ilə uyğun gəlirmi? | Fərqli istinad müəyyənləşdirmə üsulları və ya fərqli modellər varlıqları oxşar şəkildə sıralayırmı? |
| Ayırdedici keçərlilik | Ölçmə nəzəri olaraq əlaqəsiz xüsusiyyətlərdən ayrılırmı? | Təmsil balı varlığın ad uzunluğu kimi əlaqəsiz xüsusiyyətlə izah olunurmu? |
| Meyar keçərliliyi | Ölçmə əlaqəli olması gözlənilən xarici göstəricilərlə proqnozlaşdırılan istiqamətdə əlaqə qururmu? | İctimai məlumatda mühüm yenilənmə olduqda müvafiq niyyət qruplarındakı təmsil gözlənilən istiqamətdə dəyişirmi? |
Bu testlər süni intellekt təmsilinin mütləq doğru olduğunu göstərmir. Ölçmənin nəzəri olaraq gözlənilən əlaqələrlə uyğun olub-olmadığını qiymətləndirir.
İnsanlar üçün hazırlanmış psixometriya LLM-lərə birbaşa köçürülə bilərmi?
İş bu köçürmənin doğruluğunu fərz etmir. İnsanlarda ölçülən bəzi konstruktlar müəyyən müddət ərzində nisbətən sabit qəbul edilir. Böyük dil modelinin varlığa dair təmsili isə model yenilənməsi, sistem istəyi, axtarış infrastrukturu və yeni informasiya mənbələri səbəbindən dəyişə bilər.
Buna görə psixometrik konstrukt keçərliliyinin LLM təmsilinə tətbiqi hazır və doğrulanmış həll deyil, ayrıca sınaqdan keçirilməsi lazım olan tədqiqat təklifidir.
Əhatə nəyi ölçür?
Varlığın təmsili bütün niyyət qruplarındakı \(\theta_c\) dəyərlərinin sahəsidir. Buna görə yalnız müşahidə edilən qruplardakı nisbətləri hesablamaq kifayət deyil. Ölçmənin təmsil sahəsinin nə qədərini əhatə etdiyi də bilinməlidir.
Uzun sorğu siyahısından istifadə etmək yüksək əhatəyə zəmanət vermir. Yüzlərlə sorğu eyni tez-tez istifadə edilən niyyət bölgəsində cəmləşə və nadir ehtiyacları tamamilə nəzərdən qaçıra bilər.
Əhatə ölçməsi aşağıdakı suala cavab verməlidir:
Müşahidə edilən istinad nümunələri süni intellektin təmsil sahəsinin nə qədərini ortaya çıxarıb və yeni müşahidənin əvvəllər görülməmiş nümunə yaratma ehtimalı nədir?
Görülməmiş növlər problemi necə uyğunlaşdırılır?
Ekologiyada müşahidə edilmiş nümunələrdən hələ görünməmiş növlərin sayını təxmin etmə problemi var. Yalnız bir dəfə müşahidə olunan kateqoriyaların nisbəti hələ müşahidə olunmamış kateqoriyalar haqqında məlumat verə bilər.
İş bu yanaşmanı istinad nümunələrinə uyğunlaşdırmağı təklif edir. Yalnız bir dəfə görünmüş istinad nümunələrinin nisbəti yüksəkdirsə təmsil sahəsinin mühüm hissəsi hələ kəşf edilməmiş ola bilər. Yeni sorğular əvvəllər görünməmiş nümunə yaratmağı dayandırdıqca doyma nöqtəsinə yaxınlaşma qəbul edilə bilər.
Məqalə bu üsulu real istinad məlumatları üzərində tətbiq etməyib və əhatə təxmini hesablamayıb.
Görünən doyma ilə real doyma arasındakı fərq nədir?
Süni intellektdən sorğu yaratmaq istənildikdə model təlim məlumatlarında geniş yayılan və asan yaradılan sual formalarına meyl edə bilər. Bu tez-tez istifadə olunan bölgədə yeni istinad nümunəsi qalmadıqda ölçmə doymuş kimi görünə bilər.
Lakin nadir niyyət bölgələri hələ kəşf edilməmiş ola bilər. Bu görünən doymadır. Daha geniş doyma iddiası üçün model nadir bölgələrə yönəldilməli və yeni nümunə kəşf etmə ehtimalı yenə də aşağı qalmalıdır.
İş yalnız bir dəfə görünən nümunələrin nisbəti ilə yaradılan sorğuların semantik yayılmasının birlikdə qiymətləndirilməsini təklif edir.
Sorğu müxtəlifliyi necə sayısallaşdırıla bilər?
İşdə yaradılmış sorğuların embedding vektorlarından qurulan Gram matrisinin determinantının semantik yayılma ölçüsü kimi istifadə oluna biləcəyi bildirilir. Aşağı yayılma yaradılan sorğuların təmsil sahəsinin dar və oxşar hissəsində cəmləşdiyinə işarə edə bilər.
Bu üsul bütün insan ehtiyaclarının əhatə olunduğunu sübut etmir. Yalnız yaradılan sorğu dəstinin öz daxilindəki semantik müxtəliflik haqqında məlumat verir.
Tam kor nöqtələr niyə süni intellekt tərəfindən tapılmaya bilər?
Modelin heç bir istəklə yarada bilmədiyi və ya təmsil edə bilmədiyi istifadəçi ehtiyacları modelin təmsil sahəsindən kənarda qalır. Süni intellekt öz təmsil sahəsinin xaricində olan ehtiyacı yalnız öz istehsalı ilə kəşf edə bilməyə bilər.
Bu sahələri tapmaq üçün aşağıdakı mənbələr lazım ola bilər:
- İstifadəçi müsahibələri,
- Müştəri və dəstək qeydləri,
- Sahə ekspertlərinin təcrübəsi,
- Qurumdaxili bilik,
- Yerli və mədəni kontekst,
- Hələ modeldə əks olunmamış yeni ehtiyaclar.
İşin çərçivəsi bu çatışmazlığı aradan qaldırdığını iddia etmir. Çatışmazlığın əhatə nisbəti ilə açıq şəkildə bildirilməsini təklif edir.
Təmsil ilə reallıq arasındakı fərq necə araşdırılır?
Niyyət qrupları boyunca varlıq təmsili ölçüldükdən sonra nəticələr xarici dünyadakı doğrulana bilən göstəricilərlə müqayisə edilə bilər. Süni intellekt şirkəti real mövqeyindən daha çox və ya daha az önə çıxara bilər.
İş iki mərhələni ayırır:
- Fərqin aşkarlanması: Təmsil ölçüsü ilə xarici göstəricilər arasındakı uyğunsuzluğun müəyyən edilməsi.
- Fərqin şərhi: Uyğunsuzluğun xəta, gecikmə, legitim qiymətləndirmə və ya mənbə çatışmazlığı olub-olmadığının müəyyən edilməsi.
Birinci mərhələ ölçmə və statistika çərçivəsində həll oluna bilər. İkinci mərhələ kontekstdən asılı insan qiymətləndirməsi tələb edir.
Hansı hissələr riyazi olaraq həll edilə bilər?
| Ölçmə sahəsi | İşin təklif etdiyi yanaşma |
|---|---|
| Estimandın müəyyənləşdirilməsi | İstinad nisbətini niyyət qruplarına şərtləndirmək |
| Tələb olunan müşahidə sayı | Dəyişkənlik, xəta tolerantlığı və etimad səviyyəsinə görə uyğunlaşan nümunələmə |
| Az müşahidə ilə təxmin | Proqnoz dəstəkli və aktiv statistik çıxarım |
| Keçərlilik | Yaxınlaşan, ayırdedici və meyar keçərliliyi sübutları |
| Əhatə | Görülməmiş növlər yanaşması və təklik istinad nümunələri |
| Sorğu müxtəlifliyi | Semantik yayılma və embedding məkanındakı paylanma |
Hansı hissələr insan qiymətləndirməsi tələb edir?
| İnsan qiymətləndirməsi tələb edən sahə | Səbəbi |
|---|---|
| Təmsil–reallıq fərqinin mənası | Hər uyğunsuzluq xəta və ya ədalətsizlik deyil. |
| Təmsilə müdaxilə qərarı | Hansı təmsilin uyğun olduğu kontekstual və normativ qiymətləndirmə tələb edir. |
| Gizli ehtiyacların kəşfi | Model öz təmsil sahəsinin xaricindəki ehtiyacları yarada bilməyə bilər. |
| Mühüm niyyətlərin seçilməsi | İqtisadi, ictimai və ya institusional əhəmiyyət sahə biliyindən asılıdır. |
| Yerli və mədəni şərh | Eyni təmsil fərqli dil və cəmiyyətlərdə fərqli nəticələr yarada bilər. |
GEO və AEO ölçmələri üçün nəticəsi nədir?
Generativ mühərrik optimallaşdırması və cavab mühərriki optimallaşdırmasında uğur çox vaxt markanın və ya mənbənin süni intellekt cavablarında daha çox görünməsi ilə qiymətləndirilir. İş bu artımın hansı niyyət kontekstində baş verdiyi göstərilmədən ümumi uğur kimi şərh edilməməli olduğunu müdafiə edir.
Məzmun işi alış tövsiyəsi kontekstində görünürlüğü artıra bilər; lakin texniki müqayisə, etibarlılıq və ya yerli xidmət sorğularındakı görünürlüğü dəyişdirməyə bilər. Bu təsirlər ayrı niyyət qruplarında ölçülməlidir.
Həmçinin daha çox istinad almaq təmsillə reallıq arasındakı fərqin mütləq azaldığını göstərmir. İstinadın kontekstə uyğunluğu və mənbənin keyfiyyəti ayrıca qiymətləndirilməlidir.
İşin dəstəklədiyi və dəstəkləmədiyi nəticələr
| İşin konseptual olaraq dəstəklədiyi fikir | İşin sübut etmədiyi nəticə |
|---|---|
| Ümumi istinad nisbəti seçilən sorğu dəstindən asılıdır. | Konkret kommersiya görünürlük alətinin yanlış nəticə verdiyi eksperimental olaraq göstərilməyib. |
| Fərqli istifadəçi niyyətlərini vahid ortalamada toplamaq qarışdırma problemi yarada bilər. | Bütün ümumi görünürlük indekslərinin faydasız olduğu sübut edilməyib. |
| Niyyət şərtləndirməsi estimandı daha aydın müəyyən edir. | İstinad nümunələrinə əsaslanan qrupların real insan niyyətləri ilə tam üst-üstə düşdüyü göstərilməyib. |
| Etibarlılıq, keçərlilik və əhatə ayrı ölçmə xüsusiyyətləridir. | Bu üç xüsusiyyəti birlikdə doğrulayan tətbiq olunmuş sistem təqdim edilməyib. |
| Əsas həqiqəti olmayan konstruktlar konstrukt keçərliliyi yanaşması ilə araşdırıla bilər. | İnsan psixometriyasındakı üsulların LLM-lərə dəyişdirilmədən köçürülə biləcəyi göstərilməyib. |
| Təklik istinad nümunələri kəşf edilməmiş sahənin böyüklüyü haqqında məlumat verə bilər. | Süni intellektin bütün kor nöqtələrinin model sorğuları ilə tapıla biləcəyi irəli sürülmür. |
| Təmsil fərqinin ölçülməsi ilə şərhi ayrı mərhələlərdir. | Hər təmsil fərqinin optimallaşdırma ilə düzəldilməli olduğu müdafiə edilmir. |
Açıq tədqiqat problemləri nələrdir?
- Konstruktun qeyri-sabit olması: Model yenilənmələri ilə dəyişən təmsilin etibarlılığı və keçərliliyi necə müəyyən edilməlidir?
- İkiölçülü müşahidə paylanması: Hansı niyyət qruplarının seçiləcəyi və hər qrupun neçə dəfə müşahidə ediləcəyi birlikdə necə optimallaşdırılmalıdır?
- İstinad identifikasiyası: Domen adı, açıq keçid, marka adı, dolayı qeyd və fərqli yazılış formaları nə zaman eyni istinad sayılmalıdır?
- Manipulyasiya altında keçərlilik: Qurumlar süni intellekt istinadlarına təsir etməyə çalışdıqda ölçmə keçərliliyi necə qorunmalıdır?
- Psixometrik köçürmə: İnsanlar üçün inkişaf etdirilmiş konstrukt keçərliliyi nəzəriyyəsi LLM-lərə hansı dəyişikliklərlə tətbiq edilməlidir?
- Kor nöqtələr: Modelin təmsil edə bilmədiyi insan ehtiyacları sistematik şəkildə necə kəşf edilməlidir?
İşin Metodu və Tapıntıları
Tədqiqatın növü
İş eksperimental tədqiqat, kəmiyyət sahə işi, sistematik icmal və ya meta-analiz deyil. Süni intellektdə varlıq təmsili ölçməsinin konseptual obyektini müəyyən edən və mövcud statistik üsulların bu problemə necə uyğunlaşdırıla biləcəyini müzakirə edən nəzəri və metodoloji işdir.
Müəllifin yanaşması üç əsas iddiaya əsaslanır:
- Mövcud varlıq təmsili ölçmələrində estimand kifayət qədər müəyyənləşdirilmir.
- Estimand istinad nisbətini istifadəçi niyyəti kontekstinə şərtləndirməklə müəyyən edilə bilər.
- Bu tərif üzərində etibarlılıq, keçərlilik və əhatə riyazi olaraq işlənə bilər; nəticələrin şərhi isə insan qiymətləndirməsi tələb edir.
Metodoloji struktur
| Metod addımı | İşdə tətbiqi | Məhdudiyyəti |
|---|---|---|
| LLM cavabının formallaşdırılması | Cavab sorğuya şərtlənmiş təsadüfi proses; istinad ehtimalı \(p(X\mid q)\) kimi müəyyən edilir. | Real model cavablarından ehtimal təxmini aparılmayıb. |
| Xam ortalamanın tənqidi | Sorğu dəsti üzərindəki \(\theta\) ortalamasının sorğu seçiminə bağlı olduğu göstərilir. | Kommersiya alətlərinin real nəticələri yenidən analiz edilməyib. |
| Estimandın yenidən müəyyənləşdirilməsi | İstinad nisbəti niyyət qrupuna şərtləndirilərək \(\theta_c\) formasında müəyyən edilir. | Real niyyət qrupları yaradılmayıb. |
| Niyyət sahəsinin əməliyyat tərifi | Oxşar istinad nümunələrinə çatan sorğuların oxşar niyyət daşıdığı təklif olunur. | İnsan etiketləri ilə müqayisə edilməyib. |
| Etibarlılıq təklifi | Təkrar sayının qrupdaxili dəyişkənliyə görə uyğunlaşdırılması təklif olunur. | Tətbiq edilmiş dayandırma həddi verilməyib. |
| Az müşahidə ilə təxmin | Proqnoz dəstəkli və aktiv statistik çıxarımdan istifadə edilə biləcəyi qeyd olunur. | Xərc və ya xəta qazancı ölçülməyib. |
| Keçərlilik | Yaxınlaşan, ayırdedici və meyar keçərliliyi təklif olunur. | LLM təmsili üzərində sınaqdan keçirilməyib. |
| Əhatə | Görülməmiş növlər problemi, təklik nümunələri və semantik yayılma istifadə olunur. | Real əhatə nisbəti hesablanmayıb. |
| Ölçmə–şərh fərqi | Riyazi aşkarlama ilə kontekstual insan qərarı bir-birindən ayrılır. | İnsan qiymətləndirməsi üçün standart protokol hazırlanmayıb. |
İşin əsas konseptual tapıntıları
- Vahid ümumi istinad nisbəti varlığın özünə aid dəyişməz xüsusiyyət deyil. Nəticə sorğu dəstindən və sorğuların qarışımından asılıdır.
- Heterogen sorğuları birləşdirmək qarışdırma qərəzi yarada bilər. Fərqli istifadəçi niyyətləri ayrı hədəf kəmiyyətlər kimi nəzərdən keçirilməlidir.
- Varlıq təmsili niyyət qruplarındakı istinad nisbətlərinin sahəsi kimi müəyyən edilə bilər.
- Niyyət sahəsi ölçmə üçün ikinci dərəcəli deyil, estimandın müəyyənləşdirilməsi üçün zəruri komponentdir.
- Etibarlılıq keçərliliyi əvəz etmir. Çoxlu təkrar yanlış müəyyən edilmiş hədəfi düzəltmir.
- Əsas həqiqəti olmayan təmsil konstruktı çoxsaylı konstrukt keçərliliyi sübutları ilə qiymətləndirilə bilər.
- Əhatə keyfiyyət xarakterli “müxtəliflik” ifadəsi əvəzinə kəmiyyətcə bildirilməlidir.
- Süni intellektin sorğu istehsalı təmsil sahəsinin nadir bölgələrini nəzərdən qaçıra bilər.
- Təmsilin ölçülməsi ilə təmsilin mənalandırılması ayrı fəaliyyətlərdir.
Bu nəticələr eksperimental məlumat analizindən əldə edilmiş tapıntılar deyil. İşin formal arqumentlərindən və mövcud üsulların konseptual uyğunlaşdırılmasından çıxarılan nəzəri nəticələrdir.
İşdə məlumat və eksperiment varmı?
Xeyr. İşdə:
- Konkret böyük dil modeli eksperimental şəkildə sorğulanmayıb.
- Real şirkət, internet saytı və ya şəxs ölçülməyib.
- Sorğu məlumat dəsti yaradılmayıb.
- Niyyət qrupları hesablanmayıb.
- İstinad aşkarlama üsulu tətbiq edilməyib.
- Təkrar sayı və ya etimad intervalı hesablanmayıb.
- Əhatə nisbəti təxmin edilməyib.
- Statistik əhəmiyyətlilik testi aparılmayıb.
- Təklif olunan çərçivə başqa üsullarla müqayisə edilməyib.
Formulların funksiyası nədir?
Birinci formul seçilmiş sorğu dəstindəki ümumi istinad nisbətini və bu nisbətin sorğu seçiminə bağlılığını ifadə edir:
\[ \theta= \frac{1}{|Q|} \sum_{q\in Q}p(X\mid q) \]
İkinci formul hədəf kəmiyyəti konkret niyyət qrupuna şərtləndirərək hansı kontekstin ölçüldüyünü açıq edir:
\[ \theta_c= \mathbb{E} \left[ p(X\mid q) \mid q\in c \right] \]
Bu formullar yeni süni intellekt modeli və ya birbaşa tətbiq edilə bilən təxmin alqoritmi deyil. İşin ölçmə obyektinə dair konseptual fərqini riyazi şəkildə ifadə edir.
Süni intellekt istifadəsi bəyanatı
Müəllif işin hazırlanmasında Anthropic Claude adlı böyük dil modelindən tədqiqat və yazı köməkçisi kimi istifadə etdiyini açıqlayır. Bəyanatda istifadə sahələri ədəbiyyat araşdırması, arqumentlərin strukturlaşdırılması və mətn redaktəsi kimi göstərilir.
İşə görə mərkəzi tezis, bütün iddialar, mənbələrin doğrulanması və son mətn müəllifin məsuliyyətindədir; müəllif tərəfindən nəzərdən keçirilib və doğrulanıb. Bu bəyanat Claude-un işin müəllifi və ya müstəqil elmi doğrulayıcısı olduğu demək deyil.
Əsas məhdudiyyətlər
- Təklif olunan çərçivə real böyük dil modellərində empirik olaraq sınaqdan keçirilməyib.
- İstinad nümunələrinə əsaslanan niyyət qruplarının real istifadəçi niyyətlərini düzgün təmsil edib-etmədiyi məlum deyil.
- İstinad kimliyinin necə müəyyənləşdiriləcəyinə dair tətbiq olunmuş standart yoxdur.
- Niyyət qruplarının sayını və sərhədlərini müəyyən edən orijinal alqoritm təqdim edilməyib.
- Hər qrupda tələb olunan təkrar sayını müəyyən edən tətbiqi hesablama aparılmayıb.
- Proqnoz dəstəkli çıxarımın sorğu xərcini nə qədər azaldacağı ölçülməyib.
- Psixometrik konstrukt keçərliliyinin LLM təmsilinə köçürülməsi doğrulanmayıb.
- Görülməmiş növlər üsulunun istinad nümunələrindəki xəta xüsusiyyətləri sınaqdan keçirilməyib.
- Süni intellekt tərəfindən yaradılan sorğuların istehsal qərəzi hesablanmayıb.
- Modelin yarada bilmədiyi tam kor nöqtələr riyazi çərçivədən kənarda qalır.
- Model, versiya, sistem istəyi, dil, region və axtarış infrastrukturu təsirləri ayrılmayıb.
- Manipulyativ məzmun və generativ mühərrik optimallaşdırması altında keçərlilik sınaqdan keçirilməyib.
- Mənbələr sistematik icmal protokolu ilə seçilməyib.
- İşin müstəqil ekspert qiymətləndirməsindən keçdiyi doğrulanmayıb.
Nəticə necə şərh edilməlidir?
İşin nəticəsi “süni intellekt görünürlüğü ölçülə bilməz” deyil. Nəticə görünürlüğün vahid və kontekstdən asılı olmayan varlıq xüsusiyyəti kimi müəyyən edilə bilməməsidir. Ölçmə açıq şəkildə müəyyən edilmiş istifadəçi niyyətləri və bu niyyətlərə şərtləndirilmiş hədəf kəmiyyətlər üzərindən aparılmalıdır.
İş vahid üst səviyyəli görünürlük balının heç bir halda istifadə edilə bilməyəcəyini də iddia etmir. Fərqli niyyət qrupları açıq şəkildə müəyyənləşdirilmiş və əsaslandırılmış paylanmaya görə birləşdirilə bilər. Lakin belə indeksin hansı istifadəçi icmasını, hansı sorğu sahəsini və hansı biznes məqsədini təmsil etdiyi açıqlanmalıdır.
Məqalənin əsas töhfəsi hazır ölçmə məhsulu təqdim etmək deyil, süni intellekt görünürlük araşdırmalarından əvvəl verilməli fundamental sualı müəyyənləşdirməkdir: Bildirilən rəqəm hansı estimandı, hansı istifadəçi niyyətlərini və hansı təmsil sahəsini təxmin edir?
Mənbə və Metod Qeydi
İşin tam orijinal başlığı: How AI Perceives the World: Epistemic Foundations for Measuring Entity Representation without Ground Truth
Birbaşa Azərbaycan dilində qarşılığı: Süni İntellekt Dünyanı Necə Qavrayır: Əsas Həqiqət Olmadan Varlıq Təmsilini Ölçməyin Epistemik Təməlləri
Müəllif: Shota Nagafuchi
Müəllif sırası: İş tək müəlliflidir.
Bərabər töhfə və ya bərabər birinci müəlliflik: Yoxdur.
Məsul/əlaqə müəllifi: Shota Nagafuchi
Əlaqə ünvanı: shota_nagafuchi@tkbase.co.jp
Qurum əlaqəsi: Tech Knowledge Base, Inc. (TKBase)
SSRN qeydiyyat nömrəsi: 6898142
Jurnal: İşdə ekspert rəyi olan jurnal adı göstərilməyib.
Konfrans: İşdə konfrans nəşri məlumatı göstərilməyib.
Nəşr platforması: SSRN – Social Science Research Network
İşin tarixi: İyun 2026
Səhifə sayı: 12
Mənbə növü: Süni intellektdə varlıq təmsili və görünürlük ölçməsinə dair konseptual və metodoloji iş mətni
Ekspert rəyi vəziyyəti: İşdə və ya doğrulanmış biblioqrafik qeyddə müstəqil ekspert qiymətləndirməsinin tamamlandığına dair məlumat yoxdur. Buna görə iş ekspert rəyi olan jurnal məqaləsi kimi təqdim edilməməlidir.
Rəsmi iş keçidi:SSRN iş qeydiyyatı səhifəsi
Qurum keçidi:Tech Knowledge Base rəsmi internet saytı
Süni intellekt istifadəsi bəyanatı: Müəllif Anthropic Claude-dan ədəbiyyat araşdırması, arqumentlərin strukturlaşdırılması və mətn redaktəsində yardımçı alət kimi istifadə etdiyini; mərkəzi tezis, iddialar, mənbə doğrulaması və son mətnin öz məsuliyyətində olduğunu açıqlayıb.
Bu Azərbaycan dilində izah işin 12 səhifəsi, iki formulu, bütün əsas bölmələri, açıq tədqiqat problemləri, süni intellekt istifadəsi bəyanatı və mənbə siyahısı daxil olmaqla başdan sona araşdırılaraq hazırlanıb. İşdə olmayan eksperimental tapıntı, məlumat dəsti, uğur nisbəti, statistik nəticə, şirkət qiymətləndirməsi və ya məhsul performansı əlavə edilməyib.
Xarici mənbələr yalnız orijinal başlığın, müəllifin, qurum əlaqəsinin, SSRN qeydiyyat nömrəsinin, DOI-nin və nəşr platformasının biblioqrafik doğrulanması üçün istifadə olunub. Elmi və metodoloji izahlar yalnız işin məzmununa əsaslanır.
İşin əsas məhdudiyyəti süni intellekt görünürlük ölçməsinin fundamental konseptual problemini ətraflı ortaya qoymasına baxmayaraq təklif etdiyi niyyət sahəsi, keçərlilik və əhatə üsullarını real böyük dil modellərində tətbiq etməməsidir. Buna görə təklif olunan çərçivə doğrulanmış standart və ya tamamlanmış ölçmə sistemi deyil, empirik olaraq sınaqdan keçirilməli metodoloji təməldir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib