

Nəqliyyat planlaşdırılmasında ən kritik suallardan biri budur: İnsanlar hansı bölgədən hansı bölgəyə, hansı saatlarda və hansı sıxlıqla hərəkət edirlər? Bu suala verilən cavab ictimai nəqliyyat tutumundan trafik idarəetməsinə, yol baxımının planlaşdırılmasından xüsusi tədbir günlərində əməliyyat qərarlarına qədər bir çox sahəyə birbaşa təsir edir.
Bu cür hərəkətlilik məlumatı adətən başlanğıc-təyinat matrisləri ilə ifadə olunur. Başlanğıc-təyinat matrisi müəyyən zaman intervalında bir bölgədən digər bölgəyə neçə nəfərin səfər etdiyini göstərən məlumat strukturudur. Məsələn, şəhərin rayonları sətir və sütunlara yerləşdirildikdə sətir başlanğıc bölgəsini, sütun təyinat bölgəsini təmsil edir. Matrisin hər xanasi də müəyyən başlanğıc-təyinat cütü arasındakı səfər sayını göstərir.
Tədqiqatın əsas problemi bu hərəkətlilik tələbini keçmiş məlumatlardan öyrənərək gələcək üçün proqnozlaşdırmaq və gözlənilən davranışdan qeyri-adi sapmaları aşkar etməkdir. Nəqliyyat sistemində anomaliya; bayram, tətil, tətil aksiyası, idman tədbiri, hava şəraiti, qəza, infrastruktur kəsintisi və ya gözlənilməz ictimai hərəkətlilik səbəbindən normal nümunədən fərqlənən tələb demək ola bilər. Belə sapmalar erkən aşkar edilərsə, nəqliyyat operatorları reys tezliyini artıra, müəyyən bölgələrdə tutumu tənzimləyə, trafik idarəetmə mərkəzləri tədbir görə və ya xüsusi vəziyyət planlarını işə sala bilər.
Bu problem niyə vacibdir?
Şəhər hərəkətliliyi təsadüfi deyil. Həftə içi səhər işə gediş, günorta saatlarında daha aşağı hərəkətlilik, axşam işdən çıxış sıxlığı, həftə sonu fərqli meyllər və bayram günlərində dəyişən səfər davranışı kimi təkrarlanan nümunələr mövcuddur. Lakin bu nümunələr həmişə eyni qalmır. Konsert, futbol oyunu, pis hava, tətil aksiyası və ya yol bağlanması müəyyən bölgələrdə tələbi normaldan xeyli yüksək və ya aşağı edə bilər.
Nəqliyyat idarəetməsi baxımından problem yalnız “neçə nəfər hərəkət edəcək?” sualı deyil. Daha vacib sual “gözlənilən tələbə görə qeyri-adi vəziyyət varmı və bu vəziyyət harada yaranır?” sualıdır. Çünki sistem normal gündə yaxşı işləsə də, qeyri-adi gündə eyni plan kifayət etməyə bilər. Əgər anomal tələb əvvəlcədən və ya erkən mərhələdə aşkar edilərsə, nəqliyyat sistemi daha proaktiv idarə edilə bilər.
Bu tədqiqat hərəkətlilik proqnozu və anomaliya aşkarlanmasını eyni çərçivədə nəzərdən keçirdiyi üçün vacibdir. Yalnız yaxşı proqnoz verən model qərar verənə anomal vəziyyətin harada və nə vaxt yarandığını deməyə bilər. Yalnız anomaliya aşkarlayan sistem isə güclü gözlənilən tələb proqnozuna malik deyilsə, normal dalğalanmaları səhvən anomaliya saya bilər. Tədqiqat bu iki ehtiyacı birləşdirərək əvvəlcə gözlənilən tələbi hesablamağı, sonra bu gözləntiyə görə sapmaları qiymətləndirməyi məqsəd qoyur.
Mobil şəbəkə məlumatları niyə istifadə olunur?
Tədqiqatda istifadə olunan məlumatlar mobil şəbəkə məlumatlarından yaradılmış başlanğıc-təyinat matrisləridir. Mobil şəbəkə məlumatları insanların telefonlarının baza stansiyaları ilə qurduğu bağlantılardan hərəkət nümunələrini çıxarmağa imkan verir. Bu məlumatlar fərdi izləmə məqsədi ilə deyil, hərəkətlilik axınlarını toplu və anonimləşdirilmiş şəkildə anlamaq üçün istifadə olunduqda şəhər miqyasında çox dəyərli məlumat mənbəyi ola bilər.
Mobil şəbəkə məlumatlarının nəqliyyat planlaşdırılmasında mühüm üstünlükləri vardır. Ənənəvi sorğular bahalıdır, məhdud nümunə ilə aparılır və müəyyən dövrləri əhatə edir. Sensorlar, kameralar və ya turniket məlumatları isə yalnız müəyyən nöqtələrdəki hərəkəti görə bilər. Mobil şəbəkə məlumatları isə geniş sahəni, uzun zaman aralığını və müxtəlif bölgələrarası hərəkəti daha bütöv şəkildə təmsil edə bilər.
Tədqiqatda istifadə olunan OD matrisləri Nommon tərəfindən İspaniyanın Nəqliyyat və Davamlı Mobillik Nazirliyi üçün hazırlanmışdır. Mobil şəbəkə məlumatları Nommon Mobility Insights həlli ilə işlənmiş, nümunəyə daxil edilmiş mobil telefon istifadəçiləri üçün fəaliyyət-səfər gündəlikləri yaradılmış və siyahıyaalma məlumatları ilə ümumi əhaliyə genişləndirilmişdir. Matrislər yalnız regional hərəkəti deyil; günün saatı, səfər məqsədi, məsafə, yaş, cins, yaşayış yeri və gəlir kimi xüsusiyyətlərə görə də seqmentləşdirilə bilən zəngin məlumat strukturu təqdim edir.
Ədəbiyyatdakı boşluq nədir?
Nəqliyyat tələbinin proqnozlaşdırılması və anomaliya aşkarlanması ədəbiyyatında müxtəlif metodlardan istifadə edilmişdir. Bəzi tədqiqatlar statistik metodlara əsaslanır. Kalman filtrləri, Gaussian kernel əsaslı metodlar, Z-score meyarları və etibar intervalları bu sahədə istifadə olunan klassik alətlərdir. Bu metodların şərh edilə bilməsi yüksəkdir; lakin böyükmiqyaslı, çoxölçülü OD matrislərində miqyaslana bilmə problemi yaşaya bilərlər.
Maşın öyrənməsi metodları bu məhdudiyyətləri azaltmaq üçün istifadə edilməyə başlanmışdır. Dəstək vektor maşınları, təsadüfi meşələr, k-ən yaxın qonşu, xətti modellər və ölçü azaltmaq üçün PCA kimi metodlar müxtəlif tədqiqatlarda tətbiq edilmişdir. Lakin güclü anomalilər və stasionar olmayan hərəkətlilik nümunələri bu modellərin sabitliyinə təsir edə bilər.
Dərin öyrənmə, xüsusilə LSTM şəbəkələri zaman sıralarındakı uzunmüddətli asılılıqları tuta bildiyi üçün nəqliyyat tələbi proqnozunda önə çıxmışdır. Lakin ədəbiyyatda hələ də vacib boşluq var: Əksər tədqiqatlar ya proqnoz dəqiqliyinə, ya da anomaliya aşkarlanmasına fokuslanır; müxtəlif dərin öyrənmə arxitekturalarının həm proqnoz, həm də anomaliya aşkarlanmasına təsirini böyükmiqyaslı OD məlumatları ilə sistematik müqayisə edən tədqiqatlar daha məhduddur.
Bu tədqiqat bu boşluğa fokuslanır. Dörd müxtəlif dərin öyrənmə arxitekturasını eyni məlumat və qiymətləndirmə çərçivəsində müqayisə edir. Beləliklə LSTM, diqqət mexanizmi və CNN komponentlərinin hansı şəraitdə daha yaxşı işlədiyini, aşağı tələb və pik saatlarda necə fərqləndiyini və anomaliya aşkarlanmasında yanlış işarələmə davranışına necə təsir etdiyini göstərir.
Təklif olunan iki mərhələli metod necə işləyir?
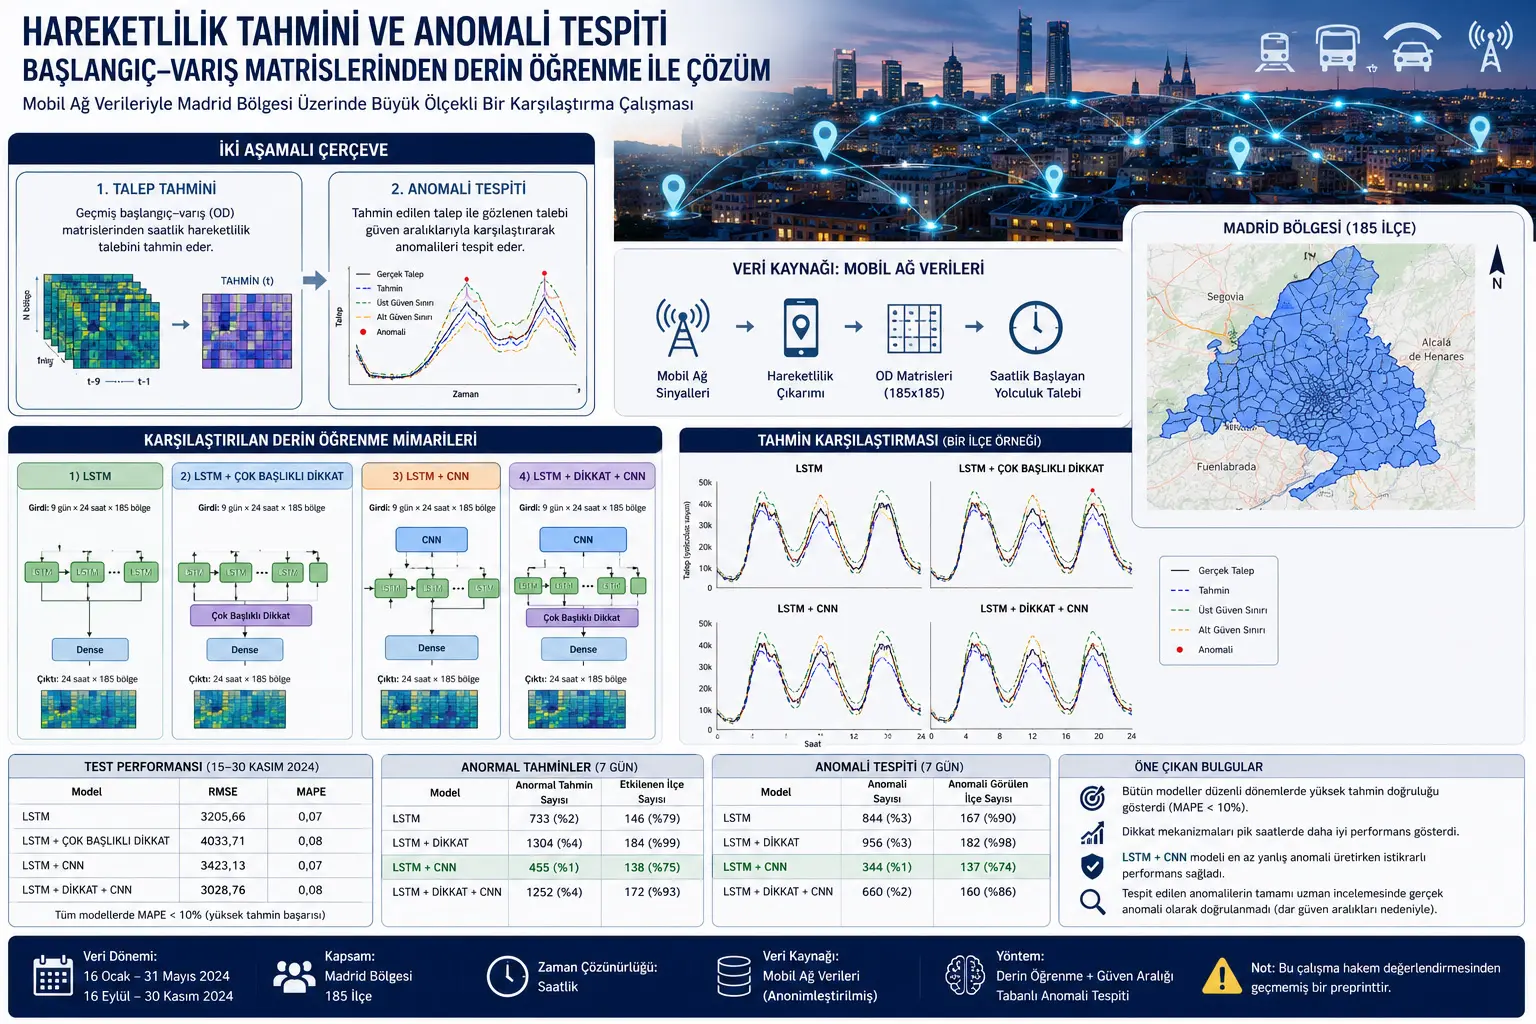
Tədqiqatın metodu iki mərhələlidir. Birinci mərhələ tələb proqnozudur. Dərin öyrənmə əsaslı zaman sırası modeli keçmiş çoxölçülü OD tələb məlumatlarından istifadə edərək növbəti günün saatlıq tələbini yaradır. Modelin girişi əvvəlki doqquz günün saatlıq tələbidir; çıxışı isə 185 rayon üçün 24 saatlıq tələb proqnozudur. Yəni hər proqnoz 185 × 24 ölçülü tələb matrisi yaradır.
İkinci mərhələ anomaliya aşkarlanmasıdır. Bu mərhələdə modelin proqnozu birbaşa “doğru istinad” kimi qəbul edilmir. Əvvəlcə proqnozlaşdırılan tələbin tarixi tələb davranışı ilə uyğun olub-olmadığı yoxlanılır. Daha sonra real müşahidə olunan tələb doğrulanmış proqnozla müqayisə edilir. Əgər real tələb etibar intervalının xaricinə çıxarsa, anomaliya namizədi kimi işarələnir.
Bu iki mərhələli quruluş vacibdir. Çünki zəif proqnozun yaratdığı fərq real anomaliya kimi görünə bilər. Tədqiqat bu riski azaltmaq üçün əvvəlcə proqnozun tarixi nümunə ilə uyğunluğunu yoxlayır. Beləliklə sistem “real tələb anormaldırmı?” sualını verməzdən əvvəl “modelin gözlədiyi tələb məntiqlidirmi?” sualını yoxlayır.
Gözlənilən tələbin tarixi davranışla doğrulanması
Tədqiqatda birinci etibar intervalı proqnozlaşdırılan tələbin keçmiş eyni gün nümunəsi ilə uyğun olub-olmadığını sınaqdan keçirmək üçün istifadə olunur. Məsələn, çərşənbə axşamı üçün proqnoz verilirsə, əvvəlki çərşənbə axşamları nəzərə alınır. Bu günlər üzrə orta tələb və standart sapma hesablanır.
Tədqiqatda verilən etibar intervalı belədir:
\[ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] \]
Burada avg_n əvvəlki n eyni həftə günü üçün hesablanan orta tələbi ifadə edir. std_n eyni tarixi müşahidələrin standart sapmasıdır. k etibar intervalının standart sapma vahidi ilə nə qədər genişləndiriləcəyini müəyyən edən parametrdir. n neçə keçmiş dövrün istifadə ediləcəyini göstərir. α isə tələbə standart sapma ilə tam tutulmayan kiçik dalğalanmalar üçün elastiklik əlavə etmək məqsədi ilə istifadə olunur.
Bu formulun gündəlik mənası belədir: “Keçmişdə bənzər günlərdə bu bölgədə tələb təxminən hansı intervalda idi? Modelin bugünkü proqnozu bu gözlənilən davranış zolağının içindədirmi?” Əgər proqnoz bu intervalda qalırsa, modelin proqnozu tarixi davranışla uyğun qəbul edilir. Əgər xaricdə qalırsa, bu ya həqiqətən dəyişən tələb nümunəsinə, ya da model performansında pisləşməyə işarə edə bilər.
Real tələb ilə proqnozlaşdırılan tələbin müqayisəsi
Proqnoz tarixi davranış baxımından məntiqli hesab edildikdən sonra ikinci mərhələdə real müşahidə ilə müqayisə olunur. Burada etibar intervalı bu dəfə proqnoz dəyərinin ətrafında qurulur:
\[ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] \]
Burada prediction modelin proqnozlaşdırdığı tələb dəyəridir. std_n əvvəlki n bənzər günün standart sapmasıdır. ℓ anomaliya aşkarlanmasında istifadə ediləcək intervalın genişliyini müəyyən edən kalibrasiya parametridir. α əvvəlki addımla uyğun şəkildə elastiklik təmin edir.
Bu intervalın daxilində qalan real müşahidələr normal qəbul edilir. Xaricdə qalan dəyərlər isə anomaliya namizədi kimi işarələnir. Burada “anomaliya namizədi” ifadəsi xüsusilə vacibdir. Tədqiqatda işarələnən hər dəyər avtomatik olaraq real anomaliya sayılmamış, ekspert doğrulamasının lazım olduğu vurğulanmışdır. Çünki statistik olaraq intervaldan çıxan kiçik sapmalar real hadisədən deyil, çox dar etibar intervallarından və ya təbii dəyişkənlikdən qaynaqlana bilər.
Madrid Bölgəsi tətbiqi
Metod Madrid Bölgəsi üzərində sınaqdan keçirilmişdir. Bölgə 185 rayona bölünmüşdür. Tədqiqatda bölgə xəritəsi üzərində bu rayonların məkan paylanması göstərilir və mavi sahələrlə analiz bölgəsinin əhatəsi ifadə olunur. Bu xəritə tədqiqatın kiçik dəhliz və ya tək stansiya məlumatı ilə deyil, geniş regional hərəkətlilik məlumatı ilə işlədiyini göstərmək baxımından vacibdir.
OD matrisləri hər rayon üçün saatlıq başlayan səfərlərə çevrilmişdir. Beləliklə model eyni anda 185 müxtəlif rayonun saatlıq tələb zaman sırasını proqnozlaşdırmışdır. Bu klassik tək zaman sırası proqnozundan daha çətin problemdir; çünki hər rayonun öz tələb ritmi olduğu kimi, bölgələrarası əlaqələr və ortaq zaman nümunələri də mövcuddur.
Təcrübə məlumat dəsti yalnız 2024-cü ildəki tam və nizamlı həftələrdən yaradılmışdır. Bayramlar və ya böyük pozuntular xaric edilmişdir. Analiz dövrü 16 Yanvar–31 May 2024 və 16 Sentyabr–30 Noyabr 2024 intervallarını əhatə edir. Pasxa həftəsi və Madrid regional bayram həftəsi xaric edilmişdir. Bu seçim metodun əvvəlcə nizamlı tələb şəraitində nə qədər yaxşı işlədiyini anlamağa yönəlib. Bayram və böyük hadisə dövrləri daha mürəkkəb olduğu üçün gələcək tədqiqatlarda ayrıca qiymətləndirilməli sahədir.
Müqayisə edilən dərin öyrənmə arxitekturaları
Tədqiqatda dörd sinir şəbəkəsi arxitekturası müqayisə edilmişdir. Birinci model baza LSTM arxitekturasıdır. LSTM şəbəkələri uzunmüddətli zaman asılılıqlarını öyrənmək üçün hazırlanmışdır. Buna görə keçmiş gün və saatlardakı hərəkətlilik nümunələrindən gələcək tələbi proqnozlaşdırmaq üçün uyğundur. Baza arxitekturada üç 128 vahidli LSTM qatı, 0,3 dropout nisbəti, 1024 neyronlu tam əlaqəli qat və 24 × 185 ölçülü çıxış qatı istifadə edilmişdir.
İkinci model çoxbaşlı diqqət mexanizmalı LSTM-dir. Diqqət mexanizmi modelin keçmiş müşahidələr arasında daha vacib olan zaman addımlarına daha çox çəki verməsinə imkan yaradır. Məsələn, bölgənin tələbi müəyyən saatlarda və ya müəyyən həftə günlərində daha mənalı nümunələr daşıyırsa, diqqət mexanizmi bu əlaqələri daha yaxşı tuta bilər. Bu tədqiqatda diqqət modulu dörd başlıq, 32 açar ölçüsü və 0,1 dropout nisbəti ilə LSTM yığını və sıx qatlar arasına əlavə edilmişdir.
Üçüncü model LSTM ilə CNN birləşməsidir. CNN qatı giriş mərhələsində yerli zaman və məkan nümunələrini tutmaq üçün istifadə olunur. Hərəkətlilik məlumatlarında qonşu və ya funksional olaraq əlaqəli bölgələr arasında münasibətlər ola bilər. Bir bölgədə yaranan sıxlıq başqa bölgədəki tələbə təsir edə bilər. CNN komponenti belə qısamüddətli və yerli nümunələri çıxarmağa kömək edir. Bu modeldə baza LSTM arxitekturasına 64 filtrli və kernel ölçüsü 5 olan konvolyusiya qatı əlavə edilmişdir.
Dördüncü model isə LSTM, çoxbaşlı diqqət və CNN komponentlərini birlikdə istifadə edir. Bu ən mürəkkəb arxitektura konvolyusiya qatı, üç LSTM qatı, çoxbaşlı diqqət modulu, global average pooling və sıx çıxış qatlarından ibarətdir. Məqsəd CNN-in yerli nümunə tutma gücünü, LSTM-in uzunmüddətli asılılıq öyrənmə qabiliyyətini və diqqət mexanizminin mühüm zaman addımlarına fokuslanma bacarığını birləşdirməkdir.
Təlim və test quruluşu
Bütün modellər MAE, yəni orta mütləq xəta itki funksiyası ilə öyrədilmiş və Adam optimallaşdırma alqoritmi ilə optimallaşdırılmışdır. Məlumat dəsti təlim və test alt dəstlərinə bölünmüşdür. Təlim dəsti 14 Noyabr 2024-ə qədər olan bütün müşahidələri ehtiva edir. Test dəsti isə 15–30 Noyabr 2024 arasındakı növbəti 16 günü əhatə edir və yalnız ümumiləşdirmə performansını qiymətləndirmək üçün istifadə edilmişdir.
Giriş-çıxış nümunələri doqquz günlük sürüşən pəncərə ilə yaradılmışdır. Model əvvəlki doqquz günün saatlıq tələbinə baxaraq bir günün 24 saatlıq tələbini proqnozlaşdırır. Hər proqnoz 185 rayon və 24 saatdan ibarət olduğuna görə çıxış matrisi 185 × 24 ölçülüdür.
Model performansı RMSE və MAPE ilə qiymətləndirilmişdir. RMSE böyük xətaları daha çox cəzalandırır; buna görə yüksək tələb dövrlərindəki böyük sapmaları daha görünən edir. MAPE isə müşahidə olunan dəyərə görə nisbi xətanı ölçür; aşağı tələb dövrlərində kiçik mütləq fərqlər belə yüksək faiz xətasına çevrilə bilər. Buna görə iki metrikin birlikdə istifadəsi vacibdir.
RMSE və MAPE nə deməkdir?
Tədqiqatda formulları açıq verilməsə də, istifadə olunan metrikləri anlamaq üçün əsas əlaqələr belə ifadə edilə bilər. Bu formullar tədqiqatın məntiqini izah etmək üçün verilən fon formullarıdır:
\[ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} \]
Burada y_i real tələbi, \hat{y}_i proqnozlaşdırılan tələbi, N ümumi müşahidə sayını ifadə edir. RMSE xətaların kvadratını aldığı üçün böyük xətalara daha həssasdır. Pik saatlarda proqnoz çox saparsa RMSE bunu güclü şəkildə cəzalandırır.
\[ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| \]
Burada MAPE xətanı real dəyərin faizi kimi verir. Tələb aşağı olduqda kiçik mütləq sapmalar belə böyük faiz xətasına çevrilə bilər. Buna görə tədqiqat diqqət mexanizmalı modellərin pik saatlarda yaxşı, aşağı tələbdə isə daha zəif görünməsini RMSE və MAPE-nin fərqli həssaslıqları ilə izah edir.
Proqnoz nəticələri: Hansı model daha uğurludur?
Test dəsti üzərində dörd modelin xəta dəyərləri belədir:
| Model | RMSE | MAPE |
|---|---|---|
| LSTM | 3205,66 | 0,07 |
| LSTM + çoxbaşlı diqqət | 4033,71 | 0,08 |
| LSTM + CNN | 3423,13 | 0,07 |
| LSTM + çoxbaşlı diqqət + CNN | 3028,76 | 0,08 |
Bütün modellər yüksək proqnoz uğuru göstərmişdir. MAPE dəyərlərinin hamısı 0,07–0,08 aralığındadır; yəni nisbi xəta yüzdə 10-dan aşağıdır. Bu, nizamlı istismar dövrlərində hərəkətlilik tələbinin dərin öyrənmə modelləri ilə uğurla proqnozlaşdırıla bildiyini göstərir.
Ən aşağı RMSE LSTM + çoxbaşlı diqqət + CNN modelində 3028,76 kimi əldə edilmişdir. Bu, modelin xüsusilə yüksək tələb dövrlərində böyük sapmaları azaltmaqda güclü olduğunu göstərir. Lakin eyni modelin MAPE dəyəri 0,08-dir; bu da aşağı tələb saatlarında nisbi xəta baxımından daha zəif ola biləcəyini düşündürür. Baza LSTM və LSTM-CNN modelləri MAPE baxımından 0,07 ilə daha yaxşı görünür.
Tədqiqatın mühüm şərhi belədir: Diqqət mexanizmalı modellər pik tələb saatlarını daha yaxşı tutur; lakin aşağı tələb dövrlərində daha zəif performans göstərə bilər. Diqqət olmayan daha sadə modellər aşağı tələb saatlarını daha yaxşı təmsil edir; lakin gündəlik tələbin üç pik nöqtəsini tutmaqda daha məhdud qala bilər. Buna görə “ən yaxşı model” üçün tək cavab yoxdur. Əgər tətbiq pik saat proqnozuna daha çox əhəmiyyət verirsə, diqqət əsaslı modellər üstün ola bilər. Əgər aşağı tələb saatlarında nisbi xəta və ya yanlış anomaliya yaratmamaq daha vacibdirsə, daha sadə LSTM və ya LSTM-CNN modelləri daha uyğun ola bilər.
Şəkillərdə proqnoz əyriləri nə göstərir?
Tədqiqatdakı proqnoz müqayisəsi qrafikləri seçilmiş təmsilçi rayon üçün dörd modelin real tələb ilə proqnoz əyrisini göstərir. Gündəlik hərəkətlilikdə aydın dalğa quruluşu var: gecə və səhərin erkən saatlarında aşağı tələb, gün ərzində yüksələn hərəkətlilik və bəzi saatlarda pik nöqtələr müşahidə olunur.
Qrafiklər bütün modellərin ümumi gündəlik nümunəni tutduğunu göstərir. Lakin arxitekturalar arasında sistematik fərqlər mövcuddur. Diqqət mexanizmi olmayan modellər aşağı tələb saatlarında real əyriyə daha yaxın görünür, pik saatlarda isə pik nöqtələri tam tutmaqda çətinlik çəkir. Diqqət mexanizmalı modellər isə pik saatları daha dəqiq təmsil edir; lakin aşağı tələb dövrlərində nisbi sapmalar arta bilər.
Bu qrafiklərin vacib tərəfi yalnız xəta cədvəlini vizual olaraq doğrulaması deyil. Eyni zamanda hərəkətlilik proqnozunda müxtəlif saatların fərqli çətinlik daşıdığını göstərir. Model yüksək tələb saatlarında uğurlu olarkən, gecə aşağı tələb dövründə artıq və ya əskik proqnoz verə bilər. Bu fərq anomaliya aşkarlanmasında da kritik olur; çünki aşağı dəyişkənlikli saatlarda etibar intervalları daralır və kiçik sapmalar yanlış anomaliya kimi işarələnə bilər.
Anomaliya aşkarlanması nəticələri
Tədqiqatda saatlıq proqnozlar 185 rayon üçün yeddi günlük analizdə qiymətləndirilmişdir. Ümumi proqnoz sayı 31.080-dir. Hər model üçün anormal proqnoz sayı və təsirlənən rayon sayı belədir:
| Model | Anormal proqnoz sayı | Anormal proqnoz görülən rayon sayı |
|---|---|---|
| LSTM | 733 (%2) | 146 (%79) |
| LSTM + çoxbaşlı diqqət | 1304 (%4) | 184 (%99) |
| LSTM + CNN | 455 (%1) | 138 (%75) |
| LSTM + çoxbaşlı diqqət + CNN | 1252 (%4) | 172 (%93) |
Bu cədvəl LSTM-CNN modelinin ən az anormal proqnoz yaradan model olduğunu göstərir. Çoxbaşlı diqqət ehtiva edən modellər daha çox anormal proqnoz yaratmışdır. Bu vəziyyət xüsusilə aşağı tələb dövrlərində nisbi proqnoz zəifliyi və dar etibar intervalları ilə əlaqələndirilmişdir.
Növbəti mərhələdə real müşahidə olunan tələbə görə anomaliya kimi işarələnən dəyərlər qiymətləndirilmişdir:
| Model | Anomaliya sayı | Anomaliya görülən rayon sayı |
|---|---|---|
| LSTM | 844 (%3) | 167 (%90) |
| LSTM + çoxbaşlı diqqət | 956 (%3) | 182 (%98) |
| LSTM + CNN | 344 (%1) | 137 (%74) |
| LSTM + çoxbaşlı diqqət + CNN | 660 (%2) | 160 (%86) |
Burada da LSTM-CNN modelinin ən yaxşı anomaliya aşkarlama davranışını yaratdığı görünür. Bu model 344 anomaliya işarələmiş, digər modellərdən nəzərəçarpacaq dərəcədə daha az yanlış işarələmə yaratmışdır. Tədqiqatın şərhinə görə LSTM-CNN LSTM-in uzunmüddətli zaman asılılıqlarını öyrənmə gücü ilə CNN-in qısamüddətli və məkan nümunələrini tutma qabiliyyətini birləşdirdiyi üçün daha sabit proqnozlar və daha etibarlı etibar intervalları yaradır.
Aşkarlanan anomalilər real anomalidirmi?
Tədqiqatda çox vacib nəticə var: Analiz edilən test dəstində aşkarlananların heç biri real anomal vəziyyət kimi qiymətləndirilməmişdir. İşarələnən dəyərlər etibarlı tələb müşahidələridir. Anomaliya kimi görünmələrinin səbəbi əksər hallarda etibar intervallarının həddən artıq dar olmasıdır.
Etibar intervalı dar olduqda real tələb normal davranışa çox yaxın olsa belə intervalın xaricinə çıxa bilər. Bu, xüsusilə əvvəlki günlərdə tələb dəyişkənliyi çox aşağı olduqda baş verir. Standart sapma kiçik olanda formuldakı std_n termini etibar zolağını daraldır. Beləliklə çox kiçik dalğalanmalar belə statistik olaraq anomaliya namizədi kimi işarələnə bilər.
Tədqiqatdakı şəkillər anormal proqnozların və aşkarlanan anomalilərin etibar intervalı sərhədlərinə çox yaxın olduğunu göstərir. Bu, real nəqliyyat pozuntusu və ya böyük tələb dəyişikliyi olmadığını; daha çox kalibrasiya həssaslığı ilə əlaqəli olduğunu düşündürür.
Bollinger zolağına bənzər etibar intervalları niyə diqqətlə kalibrasiya edilməlidir?
Tədqiqatda etibar intervalları Bollinger zolağı yanaşmasının variasiyası kimi qurulmuşdur. Bu quruluş orta və standart sapmaya əsaslandığı üçün anlaşılan və tətbiq edilə bilən metoddur. Lakin standart sapma aşağı olduqda interval həddən artıq darala bilər; standart sapma yüksək olduqda isə interval həddən artıq genişlənə və real anomalilər gözdən qaça bilər.
Buna görə tədqiqatda parametr kalibrasiyası ekspert doğrulaması ilə dəstəklənmişdir. Nommon hərəkətlilik ekspertləri aşkarlanan hadisələrin zaman sıralarını araşdıraraq bunların real anomaliya olub-olmadığını qiymətləndirmişdir. Son seçilən quruluş; altı dövrlük hərəkətli orta, k = ℓ = 2 standart sapma əmsalı və α = 1 elastiklik parametridir. Bu konfiqurasiyanın həssaslıq ilə davamlılıq arasında uyğun balans təqdim etdiyi qeyd edilmişdir.
Tədqiqatda həmçinin cümə günləri üçün etibar intervallarının daha geniş olduğu müşahidə edilmişdir. Bunun səbəblərindən biri tarixi nümunədə 1 Noyabrın, yəni İspaniyada rəsmi bayram olan günün yer almasıdır. Bu bayram tarixi cümə nümunəsində dəyişkənliyi artırmış və sonrakı cümələr üçün etibar zolağının genişlənməsinə səbəb olmuşdur. Bu detal təqvim təsirlərinin anomaliya aşkarlanmasında nə qədər vacib olduğunu göstərir.
Gündəlik həyata təsiri nə ola bilər?
Belə sistem şəhər idarəetməsində çoxsaylı praktik fayda verə bilər. Məsələn, ictimai nəqliyyat operatoru müəyyən rayonda müəyyən saatlarda gözləniləndən çox başlayan səfər olduğunu erkən aşkar edərsə, əlavə reys və ya nəqliyyat vasitəsi yönləndirilməsi planlaşdıra bilər. Trafik idarəetmə mərkəzi gözləniləndən yüksək hərəkətliliyin müəyyən tədbir, qəza və ya hava şəraitindən qaynaqlanıb-qaynaqlanmadığını araşdıra bilər. Uzun müddətdə isə planlaşdırıcılar şəhərdəki nizamlı və nizamsız hərəkətlilik nümunələrini daha yaxşı anlayaraq infrastruktur və xidmət qərarlarını gücləndirə bilərlər.
Bu yanaşma yalnız böhran günləri üçün deyil, normal günləri daha yaxşı anlamaq üçün də dəyərlidir. Əgər model nizamlı dövrlərdə etibarlı proqnozlar yarada bilirsə, qeyri-adi dövrlər daha aydın fərq edilə bilər. Başqa sözlə, “normalın nə olduğunu” yaxşı müəyyənləşdirmək “anormalı” düzgün tutmağın ilkin şərtidir.
Tədqiqatın güclü tərəfləri
Tədqiqatın güclü tərəflərindən biri böyükmiqyaslı və yüksəkölçülü hərəkətlilik məlumatı üzərində işləməsidir. 185 rayon üçün saatlıq tələb proqnozu yalnız tək yol və ya kiçik OD cütü proqnozu deyil. Bu miqyas metodun real regional nəqliyyat planlaşdırılmasına daha yaxın problem üzərində sınaqdan keçirildiyini göstərir.
İkinci güclü tərəf dörd müxtəlif dərin öyrənmə arxitekturasının sistematik müqayisəsidir. Baza LSTM modelinin istinad kimi istifadəsi diqqət mexanizmi və CNN komponentlərinin töhfəsini daha aydın şərh etməyə imkan verir. Tədqiqat yalnız “ən mürəkkəb model ən yaxşıdır” demir; model seçiminin pik tələb, aşağı tələb və anomaliya aşkarlanması məqsədlərinə görə dəyişə biləcəyini göstərir.
Üçüncü güclü tərəf insan ekspert doğrulamasının prosesə daxil edilməsidir. Anomaliya aşkarlanması tam avtomatik buraxılmamış, işarələnən dəyərlərin real anomaliya olub-olmadığı hərəkətlilik ekspertlərinin qiymətləndirməsi ilə şərh edilmişdir. Bu, xüsusilə nəqliyyat planlaşdırılması kimi əməliyyat qərarları ilə əlaqəli sahələrdə vacibdir.
Tədqiqatın məhdudiyyətləri
Tədqiqatın ən mühüm məhdudiyyəti təcrübə məlumat dəstinin nizamlı həftələrdən seçilməsidir. Bayramlar, böyük pozuntular və mühüm nizamsızlıqlar xüsusi olaraq xaric edilmişdir. Bu seçim modelin normal şəraitdə proqnoz və yanlış anomaliya davranışını anlamaq üçün uyğundur; lakin real anomalilərin çox olduğu hadisə dövrlərində metodun necə işləyəcəyini birbaşa göstərmir.
İkinci məhdudiyyət analiz olunan test həftəsində aşkarlanan anomalilərin real anomaliyaya uyğun gəlməməsidir. Bu, metodun yanlış pozitiv yaratmasını anlamaq baxımından dəyərlidir; lakin real hadisələri tutma uğurunu ölçmək üçün daha nizamsız və hadisə ehtiva edən məlumat dəstləri lazımdır.
Üçüncü məhdudiyyət anomaliya şərhinin xarici dəyişənlərlə tam inteqrasiya edilməməsidir. Tədqiqat gələcəkdə hava şəraiti, tədbir məlumatları, təqvim təsirləri və digər xarici amillərin inteqrasiyasını təklif edir. Bu inteqrasiya olmadan sistem sapmanı işarələyə bilər; lakin sapmanın səbəbini avtomatik izah etməkdə məhdud qala bilər.
Dördüncüsü, tədqiqat preprintdir və hakem qiymətləndirilməsindən keçməmişdir. Buna görə nəticələr dəyərli texniki müqayisə kimi qəbul edilməli, lakin yekun doğrulanmış elmi sübut və ya tətbiq standartı kimi təqdim edilməməlidir.
Tədqiqat nə deyir, nə demir?
Tədqiqat mobil şəbəkə məlumatlarından yaradılan OD matrisləri ilə Madrid Bölgəsində saatlıq hərəkətlilik tələbinin dərin öyrənmə modelləri ilə yüksək dəqiqlikdə proqnozlaşdırıla bildiyini göstərir. Nizamlı dövrlərdə bütün modellərin MAPE dəyərləri yüzdə 10-dan aşağı qalmışdır. Həmçinin LSTM-CNN arxitekturası anomaliya aşkarlanması baxımından daha az yanlış işarələmə yaradan, sabit seçim kimi önə çıxmışdır.
Tədqiqat real nizamsız hadisələrdə bütün anomalilərin mütləq tutulacağını demir. Real zamanlı əməliyyat sisteminə birbaşa hazır məhsul təqdim etdiyini iddia etmir. Mobil şəbəkə məlumatlarının hər şəhərdə eyni keyfiyyət və əhatədə olacağına zəmanət vermir. Həmçinin anomaliya səbəblərinin avtomatik təsnifatı bu tədqiqatın əsas əhatəsinə daxil deyil; bu, gələcəkdə hava şəraiti və tədbir məlumatları kimi xarici dəyişənlərin əlavə olunması ilə inkişaf etdiriləcək sahə kimi saxlanılmışdır.
Tədqiqatın Metodu və Tapıntıları
Metod addımları
- Məlumat mənbəyi: Mobil şəbəkə məlumatlarından yaradılmış başlanğıc-təyinat matrislərindən istifadə edilmişdir.
- Tədqiqat sahəsi: Madrid Bölgəsi 185 rayona bölünmüşdür.
- Tələb sıraları: OD matrisləri saatlıq başlayan səfər tələbinə çevrilmiş və 185 paralel saatlıq zaman sırası əldə edilmişdir.
- Məlumat seçimi: 2024-cü ildəki nizamlı və tam həftələr seçilmiş; bayram və böyük pozuntu dövrləri xaric edilmişdir.
- Giriş-çıxış quruluşu: Əvvəlki doqquz günün saatlıq tələbindən istifadə edilərək növbəti bir günün 24 saatlıq tələbi proqnozlaşdırılmışdır.
- Model müqayisəsi: LSTM, LSTM + çoxbaşlı diqqət, LSTM + CNN və LSTM + çoxbaşlı diqqət + CNN arxitekturaları sınaqdan keçirilmişdir.
- Performans ölçümü: Proqnoz performansı RMSE və MAPE ilə qiymətləndirilmişdir.
- Anomaliya aşkarlanması: Proqnoz və müşahidə dəyərləri Bollinger zolağına bənzər etibar intervalları ilə müqayisə edilmişdir.
- Ekspert doğrulaması: Aşkarlanan sapmalar hərəkətlilik ekspertləri ilə araşdırılmış və kalibrasiya buna görə qiymətləndirilmişdir.
Əsas formullar
| Formul | İzah |
|---|---|
| [ [(1-\alpha)avg_n-k\cdot std_n,\ (1+\alpha)avg_n+k\cdot std_n] ] | Proqnozun keçmiş eyni həftə günü davranışı ilə uyğun olub-olmadığını yoxlayan etibar intervalıdır. |
| [ [(1-\alpha)prediction-\ell\cdot std_n,\ (1+\alpha)prediction+\ell\cdot std_n] ] | Real müşahidə olunan tələbin proqnoz ətrafındakı normal intervalda qalıb-qalmadığını müəyyən edən anomaliya aşkarlama intervalıdır. |
| [ RMSE=\sqrt{\frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2} ] | Tədqiqatda istifadə olunan RMSE metrikinə aid fon formuludur; böyük xətaları daha güclü cəzalandırır. |
| [ MAPE=\frac{100}{N}\sum_{i=1}^{N}\left|\frac{y_i-\hat{y}_i}{y_i}\right| ] | Tədqiqatda istifadə olunan MAPE metrikinə aid fon formuludur; xətanı müşahidə olunan dəyərə görə faizlə ifadə edir. |
Proqnoz performansı
| Model | RMSE | MAPE | Şərh |
|---|---|---|---|
| LSTM | 3205,66 | 0,07 | Güclü ümumi performans; aşağı tələb dövrlərində nisbi xəta baxımından uğurludur. |
| LSTM + çoxbaşlı diqqət | 4033,71 | 0,08 | Pik dövrləri tutmaqda faydalıdır; lakin aşağı tələb saatlarında nisbi xəta arta bilər. |
| LSTM + CNN | 3423,13 | 0,07 | Proqnoz dəqiqliyi və anomaliya aşkarlanması sabitliyi baxımından balanslı nəticə verir. |
| LSTM + çoxbaşlı diqqət + CNN | 3028,76 | 0,08 | Ən aşağı RMSE dəyərini verir; yüksək tələb dövrlərində güclü, aşağı tələbdə MAPE daha yüksəkdir. |
Anormal proqnoz və anomaliya aşkarlanması
| Model | Anormal proqnoz | Anomaliya | Texniki şərh |
|---|---|---|---|
| LSTM | 733 | 844 | Ümumilikdə yaxşı proqnoz versə də etibar intervalı xarici işarələmələr LSTM-CNN-dən daha çoxdur. |
| LSTM + çoxbaşlı diqqət | 1304 | 956 | Aşağı tələb saatlarındakı nisbi sapmalar səbəbindən daha çox yanlış işarələmə yaratmışdır. |
| LSTM + CNN | 455 | 344 | Ən az yanlış anomaliya yaradan və anomaliya aşkarlanması baxımından ən balanslı modeldir. |
| LSTM + çoxbaşlı diqqət + CNN | 1252 | 660 | RMSE baxımından güclü olsa da anomaliya aşkarlanmasında LSTM-CNN qədər sabit deyil. |
Şəkil və cədvəllərin göstərdiyi əsas nəticələr
Madrid Bölgəsinin rayonlara bölündüyünü göstərən xəritə tədqiqatın geniş regional miqyasda aparıldığını və 185 məkan vahidini əhatə etdiyini ortaya qoyur. Bu, metodun kiçik laboratoriya məlumatı ilə deyil, real regional hərəkətlilik strukturuna yaxın yüksəkölçülü məlumatla sınaqdan keçirildiyini göstərir.
Proqnoz müqayisəsi qrafikləri bütün modellərin gündəlik tələb dalğasını tutduğunu; lakin diqqət mexanizmalı modellərin pik saatları, diqqət olmayan modellərin isə aşağı tələb saatlarını daha yaxşı təmsil etdiyini göstərir. Bu tapıntı RMSE və MAPE nəticələri ilə uyğundur.
Anormal proqnoz və anomaliya qrafiklərində işarələnən nöqtələr etibar intervalı sərhədlərinə çox yaxın görünür. Bu vizual nəticə tədqiqatın mətn şərhini dəstəkləyir: Test həftəsində aşkarlanan dəyərlər real anomaliya deyil, dar etibar intervallarından qaynaqlanan kiçik sapmalardır.
Cədvəllər LSTM-CNN modelinin anomaliya aşkarlanması baxımından ən üstün arxitektura olduğunu açıq göstərir. Bu model həm proqnoz dəqiqliyini qorumuş, həm də yanlış anomaliya işarələmələrini azaltmışdır.
Ümumi texniki nəticə
Tədqiqatın əsas texniki nəticəsi böyükmiqyaslı hərəkətlilik tələbi proqnozu üçün dərin öyrənmə arxitekturalarının güclü performans göstərməsi; lakin model seçiminin istifadə məqsədinə görə aparılmalı olmasıdır. Pik tələb saatlarını tutmaq prioritetdirsə, diqqət əsaslı arxitekturalar üstün ola bilər. Aşağı tələb dövrlərində sabit nisbi xəta və daha az yanlış anomaliya istənirsə, LSTM-CNN kimi diqqət olmayan hibrid arxitekturalar daha balanslı nəticə verə bilər.
Anomaliya aşkarlanması baxımından nəticələr yalnız yaxşı proqnoz verməyin kifayət olmadığını göstərir. Etibar intervallarının genişliyi, tarixi dəyişkənlik, təqvim təsirləri və ekspert doğrulaması aşkarlama uğuruna birbaşa təsir edir. Buna görə tədqiqat avtomatik anomaliya aşkarlanmasını insan ekspert doğrulaması ilə birlikdə nəzərdən keçirən daha təhlükəsiz əməliyyat yanaşmasını təklif edir.
Mənbə və Metod Qeydi
Bu məqalə Raquel Sánchez-Cauce, Oliva G. Cantú Ros, Miguel Picornell, Pablo Ruiz və Sergio Teso tərəfindən hazırlanmış “Mobility Demand Forecasting and Anomaly Detection from Origin–Destination Matrices: A Benchmark of Deep Learning Architectures” adlı tədqiqata əsaslanaraq hazırlanmışdır. Müəlliflər Nommon Solutions and Technologies ilə əlaqəlidir. Tədqiqat Avropa İttifaqının Horizon Europe proqramı çərçivəsində maliyyələşdirilən CONDUCTOR layihəsinin bir hissəsidir.
Mənbə mətn SSRN-də yerləşən preprint tədqiqat məqaləsidir. Mətndə açıq şəkildə “This preprint research paper has not been peer reviewed” ifadəsi olduğu üçün tədqiqat hakem qiymətləndirilməsindən keçməmişdir. Buna görə nəticələr hakemli jurnalda qəti şəkildə doğrulanmış tapıntılar kimi deyil, texniki baxımdan ətraflı, lakin hakemlik prosesi tamamlanmamış preprint nəticələri kimi oxunmalıdır.
Bu məzmun PDF-dəki tədqiqat əsasında hazırlanmışdır. PDF-də olmayan sahə tətbiqi zəmanəti, kommersiya uğuru, real zamanlı sistemdə qəti performans, bütün şəhərlərə ümumiləşdirilə bilmə və ya bütün anomaliləri mütləq tutma iddiası əlavə edilməmişdir. Tədqiqatın metodu mobil şəbəkə məlumatlarından yaradılan OD matrislərinə, dərin öyrənmə əsaslı zaman sırası proqnozuna və etibar intervalı əsaslı anomaliya aşkarlanmasına söykənir.
Tədqiqat nizamlı həftələr üzərində sınaqdan keçirilmişdir; bayram və böyük pozuntu dövrləri xüsusi olaraq xaric edilmişdir. Buna görə metod nizamlı tələb şəraitində proqnoz dəqiqliyi və yanlış anomaliya davranışı baxımından qiymətləndirilmişdir. Real anomaliya hadisələrinin olduğu daha nizamsız dövrlərdə performans ayrıca sınaqdan keçirilməlidir. Həmçinin hava şəraiti, tədbir məlumatları və təqvim təsirləri kimi xarici dəyişənlərin modelə daha güclü inteqrasiyası gələcək tədqiqat mövzusu kimi göstərilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib