

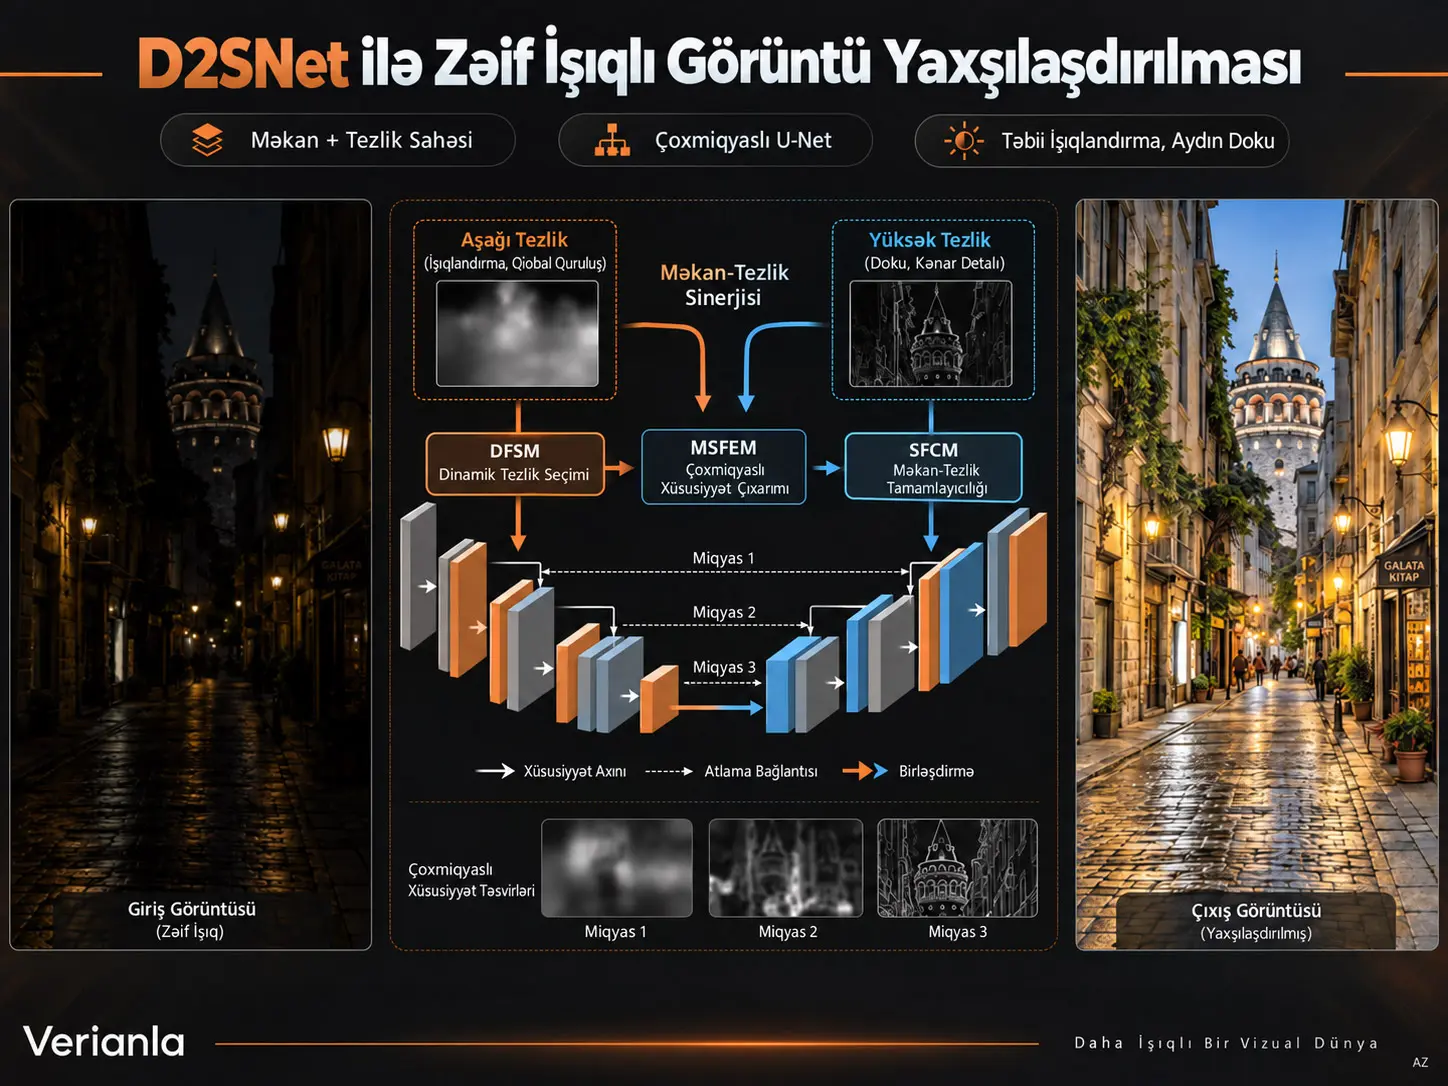
Dual-Domain Synergy Network (D2SNet), zəif işıqlı görüntülərin yaxşılaşdırılması problemində görüntünün məkan quruluşu ilə tezlik komponentlərini çoxmiqyaslı U-Net daxilində birlikdə emal edən dərin öyrənmə arxitekturasıdır. Modelin əsas məqsədi yalnız görüntünü işıqlandırmaq deyil; işıqlandırma düzəldilərkən küyün lazımsız şəkildə güclənməsini məhdudlaşdırmaq, rəngləri qorumaq və incə teksturaları yenidən bərpa edə bilməkdir. D2SNet bunu Dinamik Tezlik Seçimi Modulu (Dynamic Frequency Selection Module, DFSM), Çoxmiqyaslı Xüsusiyyət Çıxarma Modulu (Multi-Scale Feature Extraction Module, MSFEM) və Məkan-Tezlik Tamamlayıcılığı Modulu (Spatial-Frequency Complementarity Module, SFCM) vasitəsilə həyata keçirir.
DFSM sabit Fourier, kosinus və ya dalğacıq bazaları ilə birbaşa parçalama aparmaq əvəzinə giriş xüsusiyyətlərindən öyrənilən aşağıkeçirən filtr qrupları yaradır. Bu filtrlər aşağı tezlikli və yüksək tezlikli xüsusiyyətləri ayırır; kanal və məkan diqqət mexanizmləri daha sonra hansı tezlik komponentlərinin yaxşılaşdırma üçün daha faydalı olduğuna çəki verir. MSFEM isə 3 × 3, 5 × 5 və 7 × 7 genişləndirilmiş dərinlik-ayrılan konvolyusiyaları 1 × 1 lokal qol ilə birləşdirərək həm geniş konteksti, həm də lokal detalları tutmağa çalışır. SFCM bu iki yanaşmanı kiçik SU-Net strukturu vasitəsilə əsas U-Net-in yüksək ayırdetmə səviyyəsinə bağlayır.
Mənbə tədqiqatında D2SNet; LOLv1, LOLv2-Real, LOLv2-Synthetic, LOL-Blur, Sony-Total-Dark, beş cütləşdirilməmiş zəif işıqlı verilənlər toplusu və ExDark obyekt aşkarlama təcrübələri daxil olmaqla geniş benchmark dəsti üzərində qiymətləndirilmişdir. Məsələn, LOLv1-də 25.09 dB PSNR və 0.874 SSIM, LOLv2-Synthetic-də 26.60 dB PSNR və 0.947 SSIM, LOL-Blur-da 27.78 dB PSNR və 0.906 SSIM bildirilmişdir. Model 5.62 milyon parametr və 256 × 256 giriş yaması üçün 36.82 G FLOPs ilə işləyir.
Bu nəticələr D2SNet-in tədqiqatda istifadə olunan verilənlər topluları və təlim protokolu çərçivəsində güclü zəif işıq bərpası modeli olduğunu göstərir. Bununla belə, nəticələr rəyçi qiymətləndirməsindən keçməmiş preprintdən gəlir və konkret benchmark nəticələri real dünyadakı bütün kamera, sensor, işıq səviyyəsi və ya pozulma növləri üçün universal üstünlük demək deyil.
Tədqiqat problemi: yalnız parlaqlığı artırmaq niyə kifayət etmir?
Zəif işıqda çəkilmiş görüntüdə problem yalnız orta piksel intensivliyinin aşağı olması deyil. Sensor küyü daha nəzərə çarpa bilər, rənglər pozula bilər, lokal kontrast azala bilər, incə teksturalar itə bilər və uzun ekspozisiyadan istifadə olunubsa hərəkət və ya kamera mənşəli bulanıqlıq yarana bilər. Buna görə yaxşı zəif işıq görüntü yaxşılaşdırma sistemi bir tərəfdən qlobal işıqlandırmanı düzəldərkən digər tərəfdən detalları qorumalı, küyü gücləndirməməli və qeyri-təbii həddindən artıq ekspozisiyalı sahələr yaratmamalıdır.
Mənbə tədqiqatı mövcud yanaşmaları iki əsas aspektdən müzakirə edir. CNN və Transformer əsaslı üsulların böyük hissəsi əsasən məkan oblastında işləyir. Tezlik oblastından istifadə edən üsullar isə çox vaxt FFT, DCT və ya DWT kimi əvvəlcədən müəyyən edilmiş çevirmələrdən istifadə edir. Bu sabit çevirmələrin zəif işıq pozulmasının görüntüdən görüntüyə dəyişən strukturuna birbaşa uyğunlaşa bilməməsi D2SNet-in çıxış nöqtəsidir.
D2SNet Nədir və Niyə İki Fərqli Oblastı Birlikdə İstifadə Edir?
D2SNet zəif işıqlı görüntünün məkan quruluşunu və aşağı-yüksək tezlik xüsusiyyətlərini eyni çoxmiqyaslı bərpa şəbəkəsində qarşılıqlı şəkildə istifadə edən U-Net əsaslı görüntü yaxşılaşdırma modelidir. Məkan oblastı obyektlərin, sahələrin və lokal kontekstin harada yerləşdiyini daşıyarkən tezlik ayrılması daha yavaş dəyişən işıqlandırma komponentləri ilə kənar, tekstura və küy kimi daha sürətli dəyişən komponentlərin fərqli şəkildə emalına imkan verir.
Şəbəkənin ümumi verilənlər axını
Giriş \(3 \times H \times W\) ölçüsündə zəif işıqlı RGB görüntüdür. İlk 3 × 3 konvolyusiya görüntünü \(C \times H \times W\) ölçüsündə səthi xüsusiyyət təsvirinə çevirir. Ardınca üçmiqyaslı əsas U-Net kodlayıcısı ayırdetməni mərhələli şəkildə azaldarkən kanal sayını artırır. Dekoder əks istiqamətdə işləyir və kodlayıcıdan gələn xüsusiyyətlərlə skip bağlantıları vasitəsilə birləşir.
Hər ayırdetmə səviyyəsinin son ResBlock əməliyyatından sonra DFSM tətbiq olunur. MSFEM isə davamlı olaraq hər səviyyəyə yerləşdirilmir; SU-Net və əsas U-Net darboğazlarında istifadə olunur. Mənbəyə görə bu seçim, çox sayda genişləndirilmiş konvolyusiyanın ardıcıl tətbiqi zamanı yarana biləcək müntəzəm nümunələmə boşluqlarını və məkan informasiyası itkisini azaltmağı hədəfləyir.
Son mərhələdə 3 × 3 konvolyusiya tətbiq olunur və şəbəkə çıxışı orijinal zəif işıqlı görüntü ilə residual bağlantı vasitəsilə birləşdirilərək yekun yaxşılaşdırılmış görüntü əldə edilir.
Üç əsas modul
| Modul | Tam adı | Əsas vəzifə | Elmi rolu |
|---|---|---|---|
| DFSM | Dynamic Frequency Selection Module | Öyrənilə bilən filtrlərlə tezlik parçalanması və çəkiləndirmə | Görüntü məzmununa görə faydalı aşağı/yüksək tezlik komponentlərini seçmək |
| MSFEM | Multi-Scale Feature Extraction Module | Bir neçə qəbul sahəsi ölçüsündən məkan xüsusiyyətləri çıxarmaq | Tezlik seçiminə qlobaldan lokala uzanan semantik kontekst təmin etmək |
| SFCM | Spatial-Frequency Complementarity Module | SU-Net, MSFEM və DFSM-ni ortaq emal xəttində birləşdirmək | Yüksək ayırdetmə səviyyəsində məkan-tezlik tamamlayıcılığı qurmaq |
DFSM Öyrənilə Bilən Tezlik Seçimini Necə Edir?
DFSM giriş xüsusiyyətlərini kanal qruplarına ayırır, girişin özündən öyrənilən aşağıkeçirən filtr nüvələri yaradır, aşağı tezlik komponentini filtrləmə yolu ilə çıxarır və yüksək tezlik komponentini girişlə aşağı tezlik komponenti arasındakı residual kimi formalaşdırır; daha sonra kanal və məkan diqqət çəkiləri aşağı və yüksək tezliklərin çıxışdakı töhfəsini dinamik şəkildə müəyyən edir.
FFE: tezlik komponentlərinin dinamik ayrılması
Giriş xüsusiyyət xəritəsi \(X \in \mathbb{R}^{C \times H \times W}\), kanal oxunda \(g\) qrupa bölünür:
Tənlik (1)
\[ X=[X^{1},X^{2},\ldots,X^{g}] \]
Hər qrupun kanal sayı \(C_i=C/g\) kimi təyin olunur. Filtr generasiya yolu qlobal orta hovuzlama, 1 × 1 konvolyusiya, batch normalization və Softmax istifadə edir:
Tənlik (2)
\[ LPF=\operatorname{Softmax}\left(BN\left(Conv_{1\times1}(GAP(X))\right)\right) \]
Yaradılan aşağıkeçirən filtrlərin ölçüsü \(k^{2}\times g\)-dir. \(k\) filtr nüvəsi ölçüsünü, \(g\) kanal qruplarının sayını göstərir. Softmax əməliyyatı \(k^{2}\) nüvə elementi üzərində normallaşdırılmış çəkilər yaradır.
Tənlik (3), mənbədə çap olunduğu kimi
\[ X^{i}_{low}= \sum_{p,q\in\mathcal{N}_{k}} \left( X^{i}(h+p,w+q)\cdot LPS^{i} \right) \]
Burada \(h,w\) cari məkan mövqeyini; \(\mathcal{N}_{k}\) isə \(k\times k\) lokal qonşuluğu göstərir. Mənbə mətninin izahında müvafiq filtr LPF adlandırıldığı halda Tənlik (3) vizualında LPS simvolu çap olunub. Mənbə bunun yazı xətası olduğunu açıq şəkildə bildirmədiyindən iki göstərim arasındakı uyğunsuzluq burada dəyişdirilmədən qeyd olunur.
Yüksək tezlik komponenti orijinal xüsusiyyətdən bütün aşağı tezlik qruplarının birləşdirilmiş təsvirinin çıxılması ilə əldə edilir:
Tənlik (4)
\[ X_{high}=X-[X^{1}_{low},X^{2}_{low},\ldots,X^{g}_{low}] \]
Bu riyazi quruluş vacibdir: yüksək tezlik komponenti ayrıca sabit yüksəkkeçirən filtrlə hesablanmaq əvəzinə öyrənilə bilən aşağı tezlik təxmininin residualı kimi təyin olunur.
DAGG və ikili diqqət mexanizmi
Aşağı və yüksək tezlik xüsusiyyətləri əvvəlcə ayrı-ayrı 3 × 3 depth-wise konvolyusiyalardan keçirilir. Ardınca iki fərqli füziya yolu yaradılır: element üzrə toplama ilə \(X_{add}\), kanal istiqamətində birləşdirmə ilə \(X_{con}\). \(X_{add}\), paralel kanal və məkan diqqət yollarından ibarət Dual Attention Module-a göndərilir.
Tənlik (5)
\[ W_{ca}=Conv_{1\times1}\left( ReLU\left( Conv_{1\times1}(GAP(X_{add})) \right) \right) \]
\(W_{ca}\in\mathbb{R}^{C\times1\times1}\), hansı xüsusiyyət kanallarının yaxşılaşdırma baxımından daha mühüm olduğunu çəkiləndirən kanal diqqət terminidir.
Tənlik (6)
\[ W_{sa}=Conv_{7\times7}\left( [GAP(X_{add}),GMP(X_{add})] \right) \]
\(W_{sa}\in\mathbb{R}^{1\times H\times W}\), məkan sahələri arasında çəki paylanması yaradır. Mənbə izahına görə məqsəd daha ağır pozulmuş sahələrin daha çox nəzərə alınmasıdır.
Kanal və məkan çəkiləri bir araya gətirilərək Sigmoid ilə \(W_{casa}\) yaradılır. İki füziya yolunun birləşməsi aşağıdakı kimidir:
Tənlik (7)
\[ X_{fuse}= W_{casa}\cdot X_{add} + (1-W_{casa})\cdot Conv_{1\times1}(X_{con}) \]
Ardınca aşağı və yüksək tezlik komponentlərinə xas normallaşdırılmış çəkilər əldə edilir:
Tənlik (8)
\[ W_{low},W_{high} = Split\left( Softmax(GAP(X_{fuse})) \right) \]
DFSM çıxışı:
Tənlik (9)
\[ X_{out} = W_{low}\cdot X_{low} + W_{high}\cdot X_{high} \]
Bu son ifadə DFSM-nin əsas funksiyasını ümumiləşdirir. Model aşağı və yüksək tezlik xüsusiyyətlərini sabit nisbətlərdə toplamır; hər giriş üçün öyrənilən çəkilərlə yenidən birləşdirir.
MSFEM: qlobal kontekst ilə lokal detalın eyni modulda saxlanılması
MSFEM giriş xüsusiyyətlərini əvvəlcə batch normalization, 1 × 1 point-wise konvolyusiya və GELU aktivləşdirməsindən keçirir:
Tənlik (10)
\[ \hat{X} = GELU\left( Conv_{1\times1}(BN(X)) \right) \]
Böyük qolda üç paralel depth-wise dilated convolution istifadə olunur:
Tənlik (11)
\[ X_{k} = DWDConv_{k\times k,d=3}(\hat{X}), \qquad k\in\{3,5,7\} \]
Dilation nisbəti \(d=3\)-dür. Mənbənin verdiyi effektiv qəbul sahəsi əlaqəsi:
\[ k_{eff}=k+(k-1)(d-1) \]
Buna görə 3 × 3, 5 × 5 və 7 × 7 nüvələr müvafiq olaraq 7 × 7, 13 × 13 və 19 × 19 effektiv qəbul sahələrinə çatır. Beləliklə tək nüvə miqyasından asılı qalmadan qısa, orta və daha uzun məsafəli məkan kontekstini tutmağa çalışılır.
Böyük qolun çıxışı:
Tənlik (12)
\[ X_{large} = Conv_{1\times1} \left( GELU \left( Conv_{1\times1} ([X_{3},X_{5},X_{7}]) \right) \right) \]
Kiçik qol yalnız 1 × 1 depth-wise konvolyusiya istifadə edərək lokal informasiyanı tamamlayır:
Tənlik (13)
\[ X_{small} = Conv_{1\times1} \left( GELU \left( DWConv_{1\times1}(\hat{X}) \right) \right) \]
MSFEM-in diqqətçəkən dizayn seçimi modulun bütün səviyyələrdə ardıcıl istifadə edilməməsidir. Mənbə genişləndirilmiş konvolyusiyaların çox sayda ardıcıl miqyasda istifadə olunmasının müntəzəm şəkildə nümunələnməyən piksellər və məkan informasiyası itkisi yarada biləcəyini bildirərək MSFEM-i yalnız SU-Net və əsas U-Net darboğazlarına yerləşdirir.
SFCM və kiçik U-Net-in mövqeyi
SFCM \(C\times H\times W\) girişini əvvəlcə iki ədəd 3 × 3 konvolyusiya və ReLU ehtiva edən ResBlock ilə emal edir. Daha sonra xüsusiyyətlər kernel=2 və stride=2 depth-wise konvolyusiya ilə \(C\times H/2\times W/2\) ölçüsünə endirilir və MSFEM-ə göndərilir. Bilinear interpolation ilə yenidən orijinal ayırdetməyə qaldırıldıqdan sonra DFSM tətbiq olunur və səthi xüsusiyyətlərlə skip bağlantısı qurulur.
Bu struktur əsas U-Net-in yalnız ən yüksək ayırdetməli birinci miqyasında istifadə edilmişdir. Ablasiya nəticələri SU-Net-in ikinci və üçüncü miqyaslara da əlavə edilməsinin FLOPs-u azaltmasına baxmayaraq PSNR-ı azaltdığını göstərir. Bu tapıntı, aşağı ayırdetmə səviyyələrində yeni downsampling əməliyyatının faydalı məkan detallarını itirə bilməsi şərhi ilə əlaqələndirilmişdir.
İtki funksiyası
D2SNet təlimində həm məkan oblastı, həm də tezlik oblastı üçün \(L_{1}\) itkisi istifadə olunur.
Tənlik (14)
\[ L_{spatial} = \|Pred-GT\|_{1} \]
Burada \(Pred\) şəbəkənin yaratdığı görüntünü, \(GT\) isə istinad normal-işıq görüntüsünü göstərir.
Tənlik (15)
\[ L_{frequency} = \|F(Pred)-F(GT)\|_{1} \]
\(F\), sürətli Fourier çevirməsini (FFT) ifadə edir. Bu tezlik itkisi proqnozlaşdırılan görüntü ilə istinad görüntünün tezlik təsvirlərini bir-birinə yaxınlaşdırmağı hədəfləyir.
Tənlik (16)
\[ L = L_{spatial} + \lambda L_{frequency} \]
Tədqiqatda \(\lambda=0.2\) seçilmişdir. Beləliklə ümumi optimallaşdırma məkan yenidənqurma xətasını əsas komponent kimi saxlayarkən tezlik oblastı uyğunluğuna da əlavə çəki verir.
Qiymətləndirmə metrikləri nəyi ölçür?
PSNR, piksel səviyyəsində yenidənqurma xətası ilə əlaqəli keyfiyyət ölçüsüdür və bu tədqiqatda yüksək dəyər üstün tutulur. SSIM, struktur oxşarlığını ölçür və yenə yüksək dəyər daha yaxşıdır. LPIPS, dərin xüsusiyyət fəzasında qavrayış fərqini qiymətləndirir; aşağı dəyər daha yaxşıdır. İstinad görüntüsü olmayan verilənlər toplularında BRISQUE və NIQE istifadə olunmuşdur və hər ikisində aşağı dəyər üstün tutulur.
Tədqiqatın Metodu və Nəticələri
Verilənlər topluları
Əsas cütləşdirilmiş qiymətləndirmələrdə LOLv1 ilə LOLv2-Real və LOLv2-Synthetic istifadə olunmuşdur. LOLv1-də 485 zəif/normal işıq görüntü cütü təlim, 15 cüt test üçün ayrılmışdır. LOLv2-Real təlim:test nisbəti 689:100, LOLv2-Synthetic nisbəti 900:100-dür.
LOL-Blur verilənlər toplusu 200 səhnə əsasında yaradılmış 12.000 zəif-işıq/bulanıq və yüksək-kəskinlik görüntü cütündən ibarətdir; 10.200 cüt təlim, 1.800 cüt test üçün istifadə edilmişdir. Sony-Total-Dark bölməsində 2.697 qısa və uzun ekspozisiyalı RAW görüntü cütü var; 2.099 cüt təlim, 598 cüt test üçün istifadə olunmuşdur.
İstinad görüntüsü olmayan ümumiləşdirmə təcrübələri DICM, LIME, MEF, NPE və VV üzərində aparılmışdır. Bundan əlavə, zəif işıq yaxşılaşdırmasının daha yüksək səviyyəli kompüter görməsi tapşırığına təsirini qiymətləndirmək üçün ExDark obyekt aşkarlama verilənlər toplusundan istifadə edilmişdir.
Təlim və tətbiq detalları
| Parametr | Mənbədə istifadə olunan dəyər |
|---|---|
| Çərçivə | PyTorch |
| Avadanlıq | Tək NVIDIA A100 GPU |
| Optimizer | Adam |
| \(\beta_1\) | 0.9 |
| \(\beta_2\) | 0.999 |
| \(\epsilon\) | \(1\times10^{-8}\) |
| Başlanğıc öyrənmə sürəti | \(1\times10^{-3}\) və ya \(1.2\times10^{-3}\) |
| Son öyrənmə sürəti | \(5\times10^{-7}\) |
| Öyrənmə sürəti planlaması | Cosine annealing |
| Batch size | 32 |
| Patch size | 256 × 256 |
| DFSM filtr nüvələri | 3 × 3 və 5 × 5 |
| FFE qrup sayı | 8 |
| LOLv1 / LOLv2 təlim müddəti | 2.500 epoch |
| LOL-Blur təlim müddəti | 1.500 epoch |
| Sony-Total-Dark | LOL-Blur ilə eyni əsas parametr ayarları |
Əsas cütləşdirilmiş benchmark nəticələri
| Verilənlər toplusu | PSNR | SSIM | LPIPS |
|---|---|---|---|
| LOLv1 | 25.09 dB | 0.874 | 0.082 |
| LOLv2-Real | 23.80 dB | 0.877 | 0.076 |
| LOLv2-Synthetic | 26.60 dB | 0.947 | 0.027 |
| LOL-Blur | 27.78 dB | 0.906 | 0.075 |
| Sony-Total-Dark | 21.70 dB | 0.676 | 0.387 |
D2SNet-in hesablama ölçüsü mənbə cədvəllərində 5.62 milyon parametr və 36.82 G FLOPs kimi verilir. LOLv1-də model 25.09 dB PSNR ilə Diff-Retinex++-ın 24.67 dB dəyərini 0.42 dB üstələmişdir. LOLv2-Synthetic-də D2SNet 26.60 dB PSNR, 0.947 SSIM və 0.027 LPIPS əldə etmişdir.
LOLv2-Real üçün D2SNet-in 23.80 dB PSNR və 0.877 SSIM dəyərləri mənbə Cədvəl 1-də ən yüksək dəyərlərdir. Buna qarşılıq LPIPS dəyəri 0.076-dır və eyni cədvəldə CWNet üçün 0.063 bildirilmişdir. Buna görə mənbə mətninin “PSNR, SSIM və LPIPS-in hamısında ən yaxşı” ifadəsi cədvəlin LPIPS sütunu ilə uyğun gəlmir.
LOL-Blur: yaxşılaşdırma və bulanıqlığın aradan qaldırılması birlikdə
LOL-Blur təcrübəsində D2SNet 27.78 dB PSNR, 0.906 SSIM və 0.075 LPIPS əldə etmişdir. Mənbə Cədvəl 2-də bu üç dəyər də siyahıya alınmış digər end-to-end və ardıcıl üsullardan daha yaxşı görünür. Modelin 36.82 G FLOPs hesablama dəyəri bəzi daha ağır üsullardan nəzərəçarpacaq dərəcədə aşağı olsa da, müqayisə olunan ən yüngül model deyil.
Mənbənin keyfiyyət müqayisələrində D2SNet çıxışlarında rəng bərpası, detal qorunması və bulanıqlığın azaldılması vurğulanır. Bunlar vizual nümunələrlə dəstəklənir; lakin keyfiyyət nümunələrinin seçimi bütün mümkün səhnələri təmsil edən müstəqil istifadəçi tədqiqatı deyil.
Sony-Total-Dark: çox qaranlıq RAW görüntülər
Sony-Total-Dark üzərində D2SNet 21.70 dB PSNR, 0.676 SSIM və 0.387 LPIPS əldə etmişdir. Mənbə müqayisəsində LEDNet müvafiq olaraq 20.83 dB, 0.648 və 0.471 dəyərlərinə malikdir. Bu təcrübə arxitekturanın yalnız standart LOL görüntülərində deyil, çox aşağı ekspozisiyalı RAW verilənləri üzərində də qiymətləndirildiyini göstərir.
İstinad görüntüsü olmayan verilənlər topluları
| Verilənlər toplusu | BRISQUE | NIQE |
|---|---|---|
| DICM | 18.16 | 3.77 |
| LIME | 14.63 | 3.66 |
| MEF | 13.22 | 3.38 |
| NPE | 13.21 | 4.01 |
| VV | 18.54 | 2.80 |
LIME, MEF və VV üzərində D2SNet güclü dəyərlər verir. DICM-də BRISQUE 18.16 ilə mənbə cədvəlindəki ən aşağı dəyərdir; NIQE 3.77 isə DarkIR-ın 3.76 dəyərindən çox cüzi yüksəkdir. NPE-də D2SNet-in 13.21 BRISQUE dəyəri DarkIR-ın 12.88 dəyərindən, 4.01 NIQE dəyəri isə CIDNet-in 3.74 dəyərindən yüksəkdir. Buna görə nəticələr “bütün cütləşdirilməmiş verilənlər toplularında və bütün metriklərdə ən yaxşı” kimi şərh edilməməlidir.
Ablasiya Təcrübələri D2SNet-in Hansı Komponentlərinin Töhfəsini Göstərir?
Mənbə ablasiya təcrübələri ən böyük tək modul töhfəsinin DFSM-dən gəldiyini, MSFEM-in əlavə qazanc verdiyini və SU-Net-in yalnız ən yüksək ayırdetməli miqyasda istifadəsinin performans-hesablama balansı baxımından daha uyğun olduğunu göstərir; tam struktur LOLv1 üzərində 25.09 dB PSNR və 0.874 SSIM-ə çatmışdır.
Əsas modulların töhfəsi
Baza şəbəkə 20.19 dB PSNR və 0.815 SSIM əldə etmişdir. Əsas U-Net darboğazına MSFEM əlavə edilməsi PSNR-ı 21.06 dB-ə yüksəldərkən DFSM-nin müvafiq miqyaslarda istifadəsi 23.68 dB-ə çatmışdır. Mənbə müəllifləri bunu DFSM üçün baza ilə müqayisədə 3.49 dB PSNR artımı kimi bildirirlər.
SU-Net-in birinci miqyasa əlavə edilməsi ilə PSNR 23.74 dB olur, FLOPs isə 38.13 G-dən 35.01 G-yə düşür. Sonrakı MSFEM yerləşdirmələri ilə tam şəbəkə 25.09 dB PSNR, 0.874 SSIM, 5.62 M parametr və 36.82 G FLOPs dəyərinə çatmışdır.
Niyə yalnız bir SU-Net?
| SU-Net sayı | PSNR | SSIM | FLOPs |
|---|---|---|---|
| 0 | 23.68 | 0.858 | 38.13 G |
| 1 | 23.74 | 0.858 | 35.01 G |
| 2 | 23.42 | 0.850 | 31.89 G |
| 3 | 23.27 | 0.850 | 28.77 G |
SU-Net sayı artdıqca hesablama azalmasına baxmayaraq görüntü keyfiyyəti aşağı düşür. Mənbənin şərhi budur ki, daha aşağı ayırdetməli laylarda əlavə downsampling edilməsi geri qaytarıla bilməyən məkan detal itkisinə səbəb ola bilər.
FFE qrup sayı
FFE üçün \(g=2\) və \(g=4\) hallarında PSNR 23.57 dB, \(g=8\) halında 23.68 dB, \(g=16\) halında 23.48 dB-dir. Buna görə yekun modeldə 8 qrup seçilmişdir. Mənbə 16 qrupdakı enişi mümkün overfitting ilə əlaqələndirir; bu izah birbaşa sübut olunmuş mexanizm deyil, müəllif şərhidir.
Öyrənilə bilən filtr və diqqət dizaynı
FFE müqayisəsində Gaussian filtr 23.22 dB, Wavelet filtr 23.21 dB və öyrənilə bilən aşağıkeçirən filtr 23.68 dB PSNR əldə etmişdir. DAGG tərəfində CBAM ilə 23.19 dB, tədqiqatın DAM strukturu ilə 23.68 dB əldə edilmişdir. Beləliklə mənbə təcrübələri həm məzmuna adaptiv tezlik parçalanmasının, həm də istifadə olunan paralel ikili diqqət mexanizminin seçilmiş benchmark-da töhfə verdiyini göstərir.
MSFEM miqyaslarının töhfəsi
Üç paralel 3 × 3 DWDConv 20.34 dB, üç paralel 5 × 5 struktur 20.56 dB, üç paralel 7 × 7 struktur 20.64 dB PSNR əldə etmişdir. Çoxmiqyaslı Large Branch 20.81 dB-ə, Large Branch ilə Small Branch-in birlikdə istifadəsi isə 21.06 dB-ə yüksəlmişdir. Kiçik qolun əlavə edilməsi 0.19 dB PSNR qazancı verərkən mənbə cədvəlinə görə yalnız 0.07 G əlavə FLOPs gətirmişdir.
ExDark obyekt aşkarlama tətbiqi
Tədqiqat görüntü yaxşılaşdırmasının yalnız vizual keyfiyyət metrikasına deyil, sonrakı kompüter görməsi tapşırığına təsirini də sınaqdan keçirmişdir. ExDark verilənlər toplusundakı 7.363 görüntü 5.890 təlim, 737 doğrulama və 736 test görüntüsü kimi ayrılmışdır. Görüntülər LOLv2-Synthetic üzərində təlim keçmiş D2SNet modeli ilə yaxşılaşdırıldıqdan sonra YOLO-V5 obyekt detektoru istifadə edilmişdir.
D2SNet ön emalı ilə mənbə Cədvəl 10-da ümumi mAP 73.6 kimi bildirilmişdir. İkinci ən yüksək orta dəyər SRENet üçün 67.9-dur; fərq 5.7 baldır. “Dog” kateqoriyasında D2SNet 80.0, Diff-Retinex++ 72.8 dəyərinə çatmış və fərq 7.2 bal olmuşdur. Mənbə Şəkil 9-dakı nümunələrdən birində zəif işıq görüntüsündə aşkarlanmayan qayıq, D2SNet yaxşılaşdırmasından sonra YOLO-V5 tərəfindən 0.82 güvən balı ilə aşkarlanmışdır.
D2SNet Nəticələri Necə Şərh Edilməlidir?
D2SNet-in nəticələri tədqiqatda istifadə olunan benchmark verilənlər topluları və təlim ayarları altında məkan-tezlik sinerjisinin güclü bərpa yanaşması ola biləcəyini dəstəkləyir; lakin preprint statusu, verilənlər toplularının məhdud əhatəsi və bəzi mətn-cədvəl uyğunsuzluqları səbəbilə nəticələr bütün real kamera sistemləri və ya bütün zəif işıq şəraitləri üçün qəti və universal üstünlük iddiasına çevrilməməlidir.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə təcrübələri DFSM-nin güclü ablasiya töhfəsi verdiyini, MSFEM-in fərqli qəbul sahəsi miqyaslarını birləşdirməsinin təkmiqyaslı versiyalardan daha yüksək PSNR verdiyini və ən yüksək ayırdetmə səviyyəsinə yerləşdirilmiş tək SU-Net-in hesablama xərci ilə keyfiyyət arasında daha uyğun balans yaratdığını göstərir. D2SNet həmçinin cütləşdirilmiş, cütləşdirilməmiş, bulanıq və həddindən artıq qaranlıq verilənlər toplularında sınaqdan keçirilmiş; ExDark təcrübəsi ilə obyekt aşkarlama ön emal təsiri də qiymətləndirilmişdir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
Tədqiqat D2SNet-in bütün kamera sensorlarında, bütün küy modellərində, bütün işıqlandırma səviyyələrində və ya real vaxtlı embedded cihazlarda eyni performansı verəcəyini sübut etmir. Mənbə konkret mobil cihaz, edge accelerator və ya real vaxtlı sənaye sistemi üzərində gecikmə ölçümü bildirmir. Bundan əlavə, benchmark görüntü metrikalarındakı yaxşılaşma hər vizual qavrayış və ya təhlükəsizlik-kritik kompüter görməsi tapşırığında eyni miqyasda qazanc yaranacağı demək deyil.
Mənbə və Metod Qeydi
Orijinal başlıq: D2SNet: Dual-domain Synergy Network for Low-Light Image Enhancement
Müəlliflər: Feng Huang; Jing Guo; Jing Wu; Jiong Huang.
Müəllif sırası: Feng Huang → Jing Guo → Jing Wu → Jiong Huang.
Qurum: SSRN rəsmi qeydinə görə dörd müəllifin hamısı Fuzhou University ilə əlaqəlidir.
Əlaqə müəllifi: SSRN qeydində Jing Guo “Contact Author” kimi göstərilir. PDF-in görünən versiyası ayrıca corresponding-author işarəsi təqdim etmir.
DOI: 10.2139/ssrn.7003581
Platforma: SSRN.
Rəsmi qeyd:SSRN Abstract 7003581
Göndərim/qeyd tarixi: 26 iyun 2026.
Mənbə növü: Preprint tədqiqat məqaləsi.
Rəyçi statusu: Mənbə PDF işin açıq şəkildə rəyçi qiymətləndirməsindən keçmədiyini bildirir.
Jurnal/cild/say: Mənbədə rəyli jurnal nəşri, cild və ya say məlumatı verilmir.
Lisenziya/müəllif hüququ: SSRN qeyd səhifəsində hüquqların qorunduğu və icazə olmadan təkrar istifadəyə icazə verilmədiyi göstərilir. Buna görə Verianla mətni mənbə şəkil və cədvəl dizaynını kopyalamır; yalnız yoxlanıla bilən elmi məlumatı, metodu, tənlikləri və nəticələri müstəqil öyrədici strukturda izah edir.
Maraqların toqquşması: Müəlliflər tədqiqata təsir edə biləcək məlum maliyyə marağı və ya şəxsi əlaqə olmadığını bəyan edirlər.
Verilənlərin əlçatanlığı: Mənbə tədqiqatda istifadə olunan verilənlərin sorğu əsasında əlçatan olduğunu bildirir.
Maliyyələşdirmə: Araşdırılan PDF-də ayrıca maliyyələşdirmə bəyanatı yoxdur.
CRediT/müəllif töhfələri: Araşdırılan PDF-də müəllif üzrə CRediT töhfə bəyanatı verilmir.
Mənbədaxili göstərim uyğunsuzluğu: Tənlik (3) vizualında \(LPS^{i}\), müvafiq izah mətnində isə aşağıkeçirən filtr üçün \(LPF^{i}\) yazılışı istifadə olunur. Mənbə bu fərqin səbəbini izah etmir.
Mənbədaxili nəticə uyğunsuzluğu: Mətn LOLv2-Real üzərində D2SNet-in PSNR, SSIM və LPIPS-in hər üçündə ən yaxşı olduğunu deyərkən Cədvəl 1-də CWNet-in LPIPS dəyəri 0.063, D2SNet-in dəyəri 0.076-dır. LPIPS üçün aşağı dəyər üstün olduğundan Verianla qiymətləndirməsində cədvəl dəyərləri əsas götürülmüşdür.
Metodoloji məhdudiyyət: Nəticələr öyrənilmiş görüntü bərpası modelinin seçilmiş benchmark verilənlər toplularındakı performansına əsaslanır. Rəyçi qiymətləndirməsi, müstəqil təkrarlama, müxtəlif avadanlıq gecikmə ölçmələri və geniş sahə təsdiqi bu mənbə tərəfindən göstərilmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib