

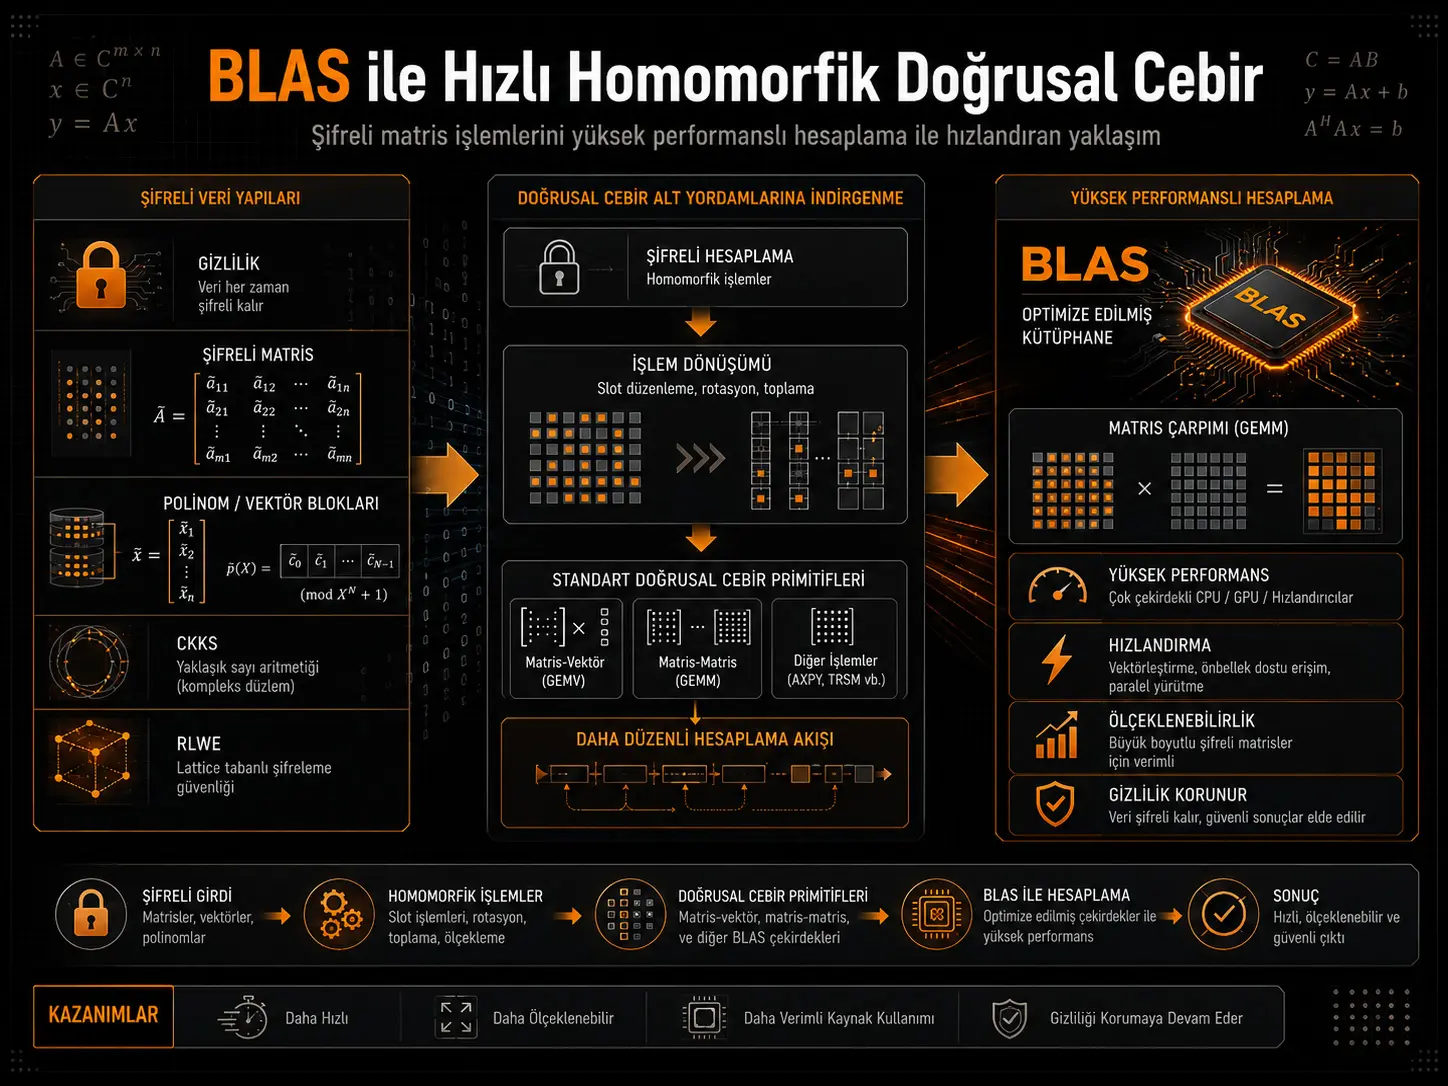
Araşdırma, homomorfik şifrələmə altında aparılan böyük miqyaslı matris-vektor və matris-matris əməliyyatlarını birbaşa mürəkkəb şifrəli əməliyyatlar ardıcıllığı kimi icra etmək əvəzinə, yüksək məhsuldarlıqlı açıq mətn xətti cəbr hesablamalarına endirməyi məqsəd qoyur. İşin mərkəzində təxmini real ədəd arifmetikasını dəstəkləyən CKKS tam homomorfik şifrələmə sistemi ilə onilliklər ərzində optimallaşdırılmış BLAS (Basic Linear Algebra Subroutines) kitabxanaları arasındakı əlaqə dayanır. Tədqiqatçılar fərqli RLWE, MLWE, shared-a və RGSW əsaslı şifrələmə formalarından istifadə edərək plaintext–ciphertext, ciphertext–plaintext və ciphertext–ciphertext matris əməliyyatlarının mühüm hissəsini standart matris vurmasına çevirən alqoritmlər hazırlamışdır. HEaaN və OpenBLAS ilə aparılan təcrübələrdə müəlliflər müəyyən böyük kvadrat matris ssenarilərində CKKS əsaslı şifrəli matris vurmasının ikiqat dəqiqlikli üzən nöqtəli açıq mətn matris vurması ilə müqayisədə hesablamaya görə itkisinin təxminən 4–12 dəfə səviyyəsinə endirilə bildiyini bildirirlər. Bu nisbət konkret alqoritm, ölçü, şifrələmə forması və ön hesablama şərtlərinə aiddir; bütün homomorfik hesablamalar üçün universal göstərici deyil.
Əsas fikir şifrəli məlumatı açıb BLAS-a vermək deyil. Məlumat şifrəli qalır. Tədqiqatçılar RLWE əsaslı şifrəli matris quruluşunu cəbri olaraq yenidən ifadə edir və şifrəli matris vurmasının böyük hissəsini şifrələnmiş mesajın özünə çıxış olmadan standart ədədi matris vurmalarına çevirirlər. Beləliklə, BLAS-ın CPU və GPU arxitekturaları üçün illərlə optimallaşdırılmış yaddaş girişi və hesablama düzənlərindən yararlanmaq hədəflənir.
Təklif edilən çərçivədə plaintext–ciphertext matris vurması bəzi hallarda iki standart plaintext matris vurmasına, ön hesablama mümkün olduqda isə onlayn mərhələdə tək plaintext matris vurmasına qədər endirilə bilir. Böyük kvadrat ciphertext–ciphertext matris vurması dörd modular plaintext matris vurmasına və şifrəli matris transpozisiyalarına ayrılmışdır. Daha ümumi RGSW əsaslı metod müxtəlif ölçü və şifrələmə formalarını dəstəklədiyi üçün daha yüksək sabit xərc daşıyır.
Təcrübələr HEaaN, OpenBLAS 0.3.26 və tək iş parçacığında çalışan Intel Xeon Gold 6342 2,80 GHz prosessor üzərində aparılmış, vaxtlar 10 icranın ortalaması kimi verilmişdir. Parametrlər tədqiqatçıların lattice estimator qiymətləndirməsinə görə təxminən 128 bit təhlükəsizlik təmin edəcək şəkildə seçilmişdir. Buna görə nəticələr homomorfik xətti cəbrin praktik olaraq sürətləndirilə biləcəyini göstərir; lakin bunlar birbaşa çoxnüvəli CPU, GPU və ya ucdan-uca məxfiliyi qoruyan böyük dil modeli performansı kimi oxunmamalıdır.
Azərbaycan/Türkiyə baxımından qiymətləndirmə: İş kriptoqrafiya, məlumat məxfiliyi, təhlükəsiz bulud hesablaması və məxfiliyi qoruyan süni intellekt üzərində çalışan tədqiqat və mühəndislik qrupları üçün diqqətəlayiq üsul təqdim edir. Böyük matris əməliyyatlarının mövcud BLAS ekosisteminə endirilməsi xüsusi homomorfik aparat hazırlamadan əvvəl mövcud CPU/GPU xətti cəbr infrastrukturundan faydalanmağın mümkün olduğunu göstərir. Bununla belə, araşdırma konkret bir milli məlumat mərkəzini, tətbiqi və ya hüquqi mühiti sınamır; buna görə birbaşa infrastruktur performansı və tətbiq maliyyəti nəticəsi çıxarılmamalıdır.
Homomorfik şifrələmə niyə vacibdir?
Adi şifrələmədə məlumat üzərində əməliyyat aparmaq üçün çox vaxt məlumat əvvəlcə açılmalıdır. Homomorfik şifrələmənin məqsədi isə serverin məlumatın açıq formasını görmədən şifrəli məlumat üzərində hesablama aparmasıdır. Hesablama bitdikdən sonra nəticə yenə şifrəli olaraq istifadəçiyə qayıdır və yalnız uyğun açara malik tərəf nəticəni aça bilir.
Bu xüsusiyyət xam məlumatını hesablama aparan serverə vermək istəməyən məlumat sahibləri üçün xüsusilə önəmlidir. Araşdırmada nümunə kimi məxfiliyi qoruyan süni intellekt nəticəçıxarması, private information retrieval, təxmini vektor axtarışı, federativ principal component analysis və böyük dil modellərinin özəl qiymətləndirilməsi göstərilir.
Matris vurması niyə darboğaz yaradır?
Müasir maşın öyrənməsi və elmi hesablama sistemlərinin böyük hissəsi matris-vektor və matris-matris vurmasına dayanır. Açıq mətn dünyasında bu əməliyyatlar yetkin BLAS kitabxanaları ilə çox səmərəli görülür. RLWE əsaslı homomorfik şifrələmədə isə bir şifrəli mətn tək ədədi deyil, çoxlu dəyərləri birlikdə daşıyan polinom quruluşunu ehtiva edir.
Şifrəli məlumatın bu quruluşda yenidən düzülməsi üçün key-switching, homomorfik avtomorfizm və oxşar əməliyyatlar lazım ola bilər. Müəlliflər əvvəlki bir çox üsulda xüsusilə key-switching sayının praktik icra vaxtını dominə etdiyini və mürəkkəb yaddaş girişi sxemlərinin optimallaşdırmanı çətinləşdirdiyini bildirirlər.
Bu səbəbdən əsas sual belədir: Şifrəli matris vurmasının böyük hesablama hissəsini, şifrəni açmadan, standart açıq mətn xətti cəbr probleminə çevirmək mümkündürmü?
BLAS nədir və bu işdə niyə istifadə olunur?
BLAS, Basic Linear Algebra Subroutines ifadəsinin qısaltmasıdır. Matris-vektor və matris-matris vurması kimi əsas xətti cəbr əməliyyatları üçün standart proqramlaşdırma interfeysləri müəyyən edir. Bu işdə xüsusilə ikiqat dəqiqlikli ümumi matris vurması dgemm və matris-vektor vurması dgemv rutinlərindən istifadə edilir.
BLAS-ın dəyəri yalnız sürətli kod olması deyil. O, CPU keşləri, vektor əmrləri, paralellik və GPU arxitekturaları üçün uzun illər optimallaşdırılmışdır. Homomorfik əməliyyatlar mümkün qədər BLAS çağırışlarına çevrildikdə bu optimallaşdırma birikimindən birbaşa faydalanmaq olur.
CKKS niyə seçilmişdir?
İş CKKS homomorfik şifrələmə sisteminə fokuslanır. CKKS təxmini real və kompleks ədəd arifmetikasını dəstəkləyir və SIMD-ə bənzər paralel məlumat işləmə imkanı verir. Bu xüsusiyyətlər ədədi xətti cəbr və süni intellekt tətbiqləri ilə təbii uyğunluq yaradır.
CKKS təxmini sistem olduğu üçün hesablanan dəyərlər tam xətasız tam ədəd arifmetikası kimi düşünülməməlidir. Tədqiqatçılar üç xəta mənbəyini ayırırlar: başlanğıc məlumatın sayısallaşdırılmasından gələn kodlama xətası, RLWE şifrələməsindən gələn kriptoqrafik xəta və rescaling/key-switching kimi homomorfik əməliyyatların yaratdığı əlavə xəta.
RLWE şifrəli mətni necə ifadə olunur?
Əsas RLWE şifrəli mətni işdə təxminən belə göstərilir:
\[ a\cdot sk+b\approx m\pmod q \]
Burada \(a\) və \(b\) şifrəli mətnin iki polinom komponentini, \(sk\) gizli açarı, \(m\) şifrələnmiş mesajı və \(q\) şifrəli mətn modulunu bildirir. Təxmini bərabərlik işarəsi CKKS kodlama və homomorfik əməliyyat xətalarının olduğunu göstərir.
Kritik addım bu polinom əlaqəsini matris əlaqəsi kimi yenidən yazmaqdır. Bir matrisin sütunları şifrəli olduqda ümumi quruluş belə yazıla bilər:
\[ S^{*}A+B\approx \Delta M\pmod q \]
Burada \(M\) əsas mesaj matrisi, \(\Delta\) CKKS miqyas faktoru, \(S^{*}\) gizli açarın struktur matris göstərimi, \(A\) və \(B\) isə şifrəli mətn komponentlərindən törəyən matrislərdir. Bu cəbri yenidən yazım BLAS-a endirmə yanaşmasının əsasıdır.
Plaintext–ciphertext matris vurması necə sadələşir?
Şifrəli \(M\) matrisi \[ S^{*}A+B\approx \Delta M \] formasında, açıq mətn \(U\) matrisi isə məlumdursa, hər iki tərəf sağdan \(U\) ilə vurula bilər:
\[ S^{*}(AU)+(BU)\approx \Delta(MU) \]
Beləliklə əsas homomorfik \(M\cdot U\) əməliyyatı böyük ölçüdə iki standart matris vurmasına, yəni \(A\cdot U\) və \(B\cdot U\) hesablamalarına çevrilir. Bu matrislər istifadəçi mesajının açıq forması deyil; şifrəli mətnin cəbri komponentləridir.
Shared-a forması nə verir?
RLWE şifrəli mətn \((a,b)\) cütü kimi düşünüləndə tədqiqatçılar bir neçə şifrəli mətnin eyni \(a\) komponentini paylaşdığı shared-a formasından istifadə edirlər. Böyük matrislərdə bu yanaşma xüsusilə \(A\) matrisinin ölçüsünü kiçildə və bahalı matris vurmasında əməliyyat sayını azalda bilir.
İşin \(2^{14}\times2^{14}\times2^{14}\) CP-MM nümunəsində müəlliflər shared-s forması istifadə olunsaydı təxminən 400 saniyə gözlədiklərini, structured-S shared-a ilə müddətin 176 saniyə olduğunu bildirirlər. Təxminən 60 saniyəlik format çevirmə xərci əlavə edilsə belə shared-a yanaşmasının aydın qazanc verdiyi qeyd edilir.
Kiçik matrislərdə niyə MLWE istifadə olunur?
Matris ölçüsü RLWE halqa dərəcəsi \(N\)-dən kiçik olduqda standart RLWE paketləməsi səmərəsiz ola bilər. Bu halda Module Learning With Errors (MLWE) formasından istifadə edilir. Beləliklə çərçivə yalnız \(d=N\) vəziyyətinə bağlı qalmır; \(d<N\), \(d=N\) və \(d>N\) ölçüləri üçün fərqli, lakin ortaq matris tənlikləri ilə ifadə edilə bilən formalar istifadə olunur.
Ön hesablama mümkün olduqda nə dəyişir?
Açıq mətn matrisi, məsələn süni intellekt modelinin sabit çəki matrisi, dəfələrlə istifadə olunacaqsa çevrimdənkənar ön hesablama təklif olunur. Structured-A shared-a yanaşmasında onlayn CP-MM əməliyyatı \[ A^{*}S+B\approx \Delta M \] əlaqəsindən \[ A^{*}(SU)+BU\approx \Delta(MU) \] formasına çevrilir.
\(S\cdot U\) ilə bağlı açar əməliyyatları əvvəlcədən hazırlandıqda onlayn mərhələdə yalnız \(B\cdot U\) matris vurması qala bilər. Bu üstünlüyün dəyəri ön hesablamadır; yalnız eyni açıq mətn matrisi təkrar istifadə olunanda amortizasiya edilə bilər.
Şifrəli matris transpozisiyası niyə yeni problemdir?
Açıq mətn matrisinin transpozisiyası sadə məlumat yenidən düzülməsidir. Şifrəli matrislərdə isə satır əsaslı şifrələmədən sütun əsaslı şifrələməyə keçid homomorfik avtomorfizmlər və key-switching tələb edə bilər. Müəlliflər Ciphertext Matrix Transpose (C-MT) adlı yeni alqoritm hazırlayırlar. \(N\times N\) şifrəli matris üçün asimptotik xərc \[ \widetilde{O}(N^2) \] modular arifmetik əməliyyatdır. Tweak böl-və-idarə-et yanaşması birbaşa üsulun \(O(N^3)\) xərcini quasi-quadratic səviyyəyə endirir.
Transpozisiyanın eksperimental vaxtı nə idi?
| Matris / halqa ölçüsü N | Şifrəli matris transpozisiya vaxtı |
|---|---|
| 212 | 5,60 s |
| 213 | 25,4 s |
| 214 | 117 s |
Dəyərlər ölçü böyüdükcə quasi-quadratic davranışla uyğun artım göstərir. Lakin CC-MM nəticələrində transpozisiya nəzəri olaraq matris vurmasından aşağı mürəkkəbliyə malik olsa da sınaq ölçülərində vaxtın mühüm hissəsini tutur.
Niyə “lightweight” transpozisiya hazırlanmışdır?
İlk C-MT yanaşması \(N\) fərqli avtomorfizm üçün \(N\) switching key tələb edir və bu açarların ümumi ölçüsü böyük ola bilər. Buna görə yalnız üç switching key istifadə edən yüngül üsul hazırlanmışdır. Bu üsulda tək avtomorfizm açarı iş zamanı yenilənir və müxtəlif çevirmələr üçün təkrar istifadə olunur. Asimptotik mürəkkəblik yenə \(\widetilde{O}(N^2)\) qalır.
Ciphertext–ciphertext matris vurması necə endirilir?
Hər iki matrisin şifrəli olması plaintext–ciphertext halından çətindir. Algorithm 8-də iki RLWE şifrəli matris uyğun satır və sütun formalarına çevrilərək vurma dörd standart modular matris vurmasına ayrılır. Böyük kvadrat \(N\times N\) matrislər üçün nəticə 4 ədəd Mod-PP-MM, 3 ədəd C-MT, \(\widetilde{O}(N^2)\) əlavə əməliyyat, relinearization və rescaling mərhələlərindən ibarətdir.
RGSW əsaslı ümumi üsul nə təmin edir?
RLWE əsaslı Algorithm 8 böyük kvadrat matrislərdə səmərəli olsa da ölçü çevikliyi məhduddur. Daha ümumi istifadə üçün RGSW-bənzər matris şifrələmə forması genişləndirilir. Bu yanaşma klassik RGSW × RLWE xarici hasilini matris-vektor səviyyəsinə daşıyır və fərqli halqa dərəcələrinə, matris ölçülərinə və RLWE/MLWE/shared-a formalarına malik məlumatların birlikdə işlənməsinə imkan verir.
Ümumi CC-Mv alqoritminin əsas əməliyyatı \[ a'= \left\lfloor \frac{A_1a+A_0b}{p} \right\rceil \] və \[ b'= \left\lfloor \frac{B_1a+B_0b}{p} \right\rceil \] formasındadır. Köməkçi \(p\) modulu şifrələmə xətalarının matris vurması zamanı nəzarətsiz böyüməməsi üçün istifadə olunur.
Xəta və dəqiqlik necə ele alınır?
CKKS təxmini hesabladığı üçün yalnız vaxt deyil, nəticə dəqiqliyi də önəmlidir. Algorithm 9 üçün xəta üst sərhədi çıxarılır və uyğun miqyaslama ilə gözlənən dəqiqlik itkisinin matris ölçüsü ilə loqarifmik əlaqəli ola biləcəyi göstərilir. Təcrübələrdə Algorithm 6 üçün təxminən 13,4–14,0 bit, Algorithm 8 üçün 8,3–9,1 bit, RGSW əsaslı Algorithm 9 üçün 17,2–17,5 bit bildirilir. Bu fərq seçilən modul büdcəsi, key-switching sayı və bəzi hesablamaların daha böyük \(pq\) modulunda aparılması ilə bağlıdır.
Modular matris vurması BLAS-a necə çevrilir?
Teorik endirmələr modular plaintext matris vurmasına çatır. Standart BLAS isə ikiqat dəqiqlikli üzən nöqtəli arifmetikadan istifadə edir. Tədqiqatçılar üç strategiya verirlər.
Strategiya 1: Ədədləri parçalara ayırmaq
IEEE-754 double arifmetikasında \(2^{53}\)-dən kiçik tam ədədlər dəqiq təmsil olunduğu üçün böyük tam ədədlər kiçik bloklara ayrılır, hər blok BLAS ilə dəqiq vurulur və nəticə sonra birləşdirilir.
Strategiya 2: Truncation
CKKS onsuz da təxmini sistem olduğundan bəzi hallarda şifrəli mətnin aşağı əhəmiyyətli bitləri atılır, yalnız yüksək əhəmiyyətli hissə double arifmetikasıyla işlənir. Bu daha sürətlidir, amma idarə olunan əlavə ədədi xəta gətirir.
Strategiya 3: Modulus switching və CRT
Şifrəli mətn modulu daha kiçik modulların hasilinə çevrilir, hər kiçik modulda matris vurması BLAS-a endirilir və nəticə Çin qalıq teoremi (CRT) ilə yenidən birləşdirilir.
İşin süni intellektlə əlaqəsi nədir?
Transformer arxitekturalarında attention və feed-forward qatları böyük matris vurmaları ehtiva edir. Məxfiliyi qoruyan inference-də model çəkiləri açıq mətn, istifadəçinin aktivasiya və ya giriş məlumatı isə şifrəli ola bilər. Bu halda CP-MM birbaşa vacib olur. İş GPT, BERT və LLaMA kimi ailələri nümunə kimi müzakirə edir; lakin ucdan-uca GPT, BERT və ya LLaMA modeli işlədilmir.
Çalışmanın dəstəklədiyi nəticələr
- CKKS/RLWE əsaslı bəzi böyük şifrəli xətti cəbr əməliyyatları standart plaintext matris vurmalarına endirilə bilir.
- CP-MM uyğun şifrələmə formasında iki Mod-PP-MM-yə, ön hesablama olduqda onlayn mərhələdə bir PP-MM-yə qədər endirilə bilir.
- Böyük kvadrat CC-MM dörd Mod-PP-MM və üç sürətli şifrəli transpozisiyaya ayrılır.
- Yeni C-MT alqoritmi \(\widetilde{O}(N^2)\) arifmetik mürəkkəbliyə malikdir.
- Shared-a forması böyük matrislərdə xərcin azalmasına kömək edir.
- RGSW yanaşması daha geniş ölçü və şifrələmə kombinasiyalarına imkan verir.
- BLAS istifadəsi homomorfik matris hesablamalarını mövcud yüksək məhsuldarlıqlı xətti cəbr infrastrukturuna bağlayır.
- Tədqiqatçılar müəyyən böyük kvadrat matris ssenarilərində homomorfik və double-precision açıq matris vurması arasındakı fərqi təxminən 4–12 dəfə səviyyəsinə endirdiklərini bildirirlər.
Çalışmanın dəstəkləmədiyi və test etmədiyi nəticələr
- Hər homomorfik əməliyyatın plaintext hesabdan yalnız 4–12 dəfə yavaş olduğu nəticəsi çıxarıla bilməz.
- Bütün matris ölçülərində eyni sürətlənmə göstərilmir.
- GPU üzərində eksperimental vaxt ölçümü aparılmamışdır.
- Ucdan-uca özəl LLM inference vaxtı ölçülməmişdir.
- Həqiqi səhiyyə, maliyyə və ya smart-contract tətbiqi üzərində sahə qiymətləndirməsi yoxdur.
- Bütün tətbiqlər üçün Algorithm 8 və ya Algorithm 9-un universal ən yaxşı seçim olduğu göstərilmir.
Çalışmanın Yöntemi ve Bulguları
Əsas alqoritmik endirmələr
| Tapşırıq | Əsas yanaşma | Plaintext xətti cəbr endirməsi | Vacib şərt / qeyd |
|---|---|---|---|
| CP-MM / CP-Mv | RLWE, shared-a və ya MLWE | 1 və ya 2 PP-MM / PP-Mv | Ölçüyə və ön hesablamaya bağlıdır |
| Ön hesablamalı CP-MM | Structured-A shared-a | Onlayn mərhələdə 1 PP-MM | Açıq matris əvvəlcədən bilinməli və təkrar istifadə olunmalıdır |
| PC-MM | C-MT + CP-MM + C-MT | CP-MM endirməsinə əsaslanır | Kvadrat matrislərdə tətbiqlidir |
| CC-MM Algorithm 8 | RLWE + C-MT | 4 Mod-PP-MM | Böyük kvadrat matrislər üçün |
| CC-Mv / ümumi CC-MM | RGSW × RLWE xarici hasil | Çoxlu Mod-PP-Mv/MM | Daha çevik, daha yüksək sabit xərc |
Verianla Live: Şifrəli matris əməliyyatı BLAS-a necə endirilir?
Bu proses işin ümumi hesablama fikrini xülasə edir. Şifrəli məlumat heç bir mərhələdə istifadəçi mesajı kimi açıq mətnə çevrilmir; BLAS-ın işlədiyi strukturlar homomorfik şifrəli mətnin cəbri komponentlərindən törəyən matrislərdir.
| Mərhələ | Əməliyyat | Elmi məna |
|---|---|---|
| 1 | CKKS/RLWE şifrəli matris | Mesaj matrisi şifrəli mətn komponentləri içində saxlanılır. |
| 2 | Matris formasında yenidən ifadə | Şifrələmə əlaqəsi S* A + B ≈ ΔM formasına çevrilir. |
| 3 | Uyğun ciphertext formatı | Ölçüyə görə RLWE, shared-a, MLWE və ya RGSW seçilir. |
| 4 | Homomorfik problemin endirilməsi | Şifrəli MM/Mv standart modular plaintext MM/Mv əməliyyatlarına ayrılır. |
| 5 | Modular əməliyyatın BLAS-a çevrilməsi | Parçalama, truncation və ya modulus switching + CRT tətbiq olunur. |
| 6 | OpenBLAS dgemm / dgemv | Hesabın böyük hissəsi yüksək məhsuldarlıqlı standart xətti cəbr rutinlərində aparılır. |
| 7 | Rescale / Relin / format çevirmə | Nəticə uyğun CKKS şifrəli mətn formasına gətirilir. |
| 8 | Şifrəli nəticə | Nəticə sonrakı FHE əməliyyatlarında istifadə ediləcək şəkildə şifrəli qalır. |
Eksperimental mühit
| Deney komponenti | İstifadə olunan quruluş |
|---|---|
| Homomorfik şifrələmə kitabxanası | HEaaN |
| BLAS tətbiqi | OpenBLAS 0.3.26 |
| CPU | Intel Xeon Gold 6342 @ 2,80 GHz |
| İş parçacığı | 1 |
| Təkrar | Hər zamanlama 10 icranın ortalaması |
| Təhlükəsizlik hədəfi | Lattice estimator-a görə təxminən 128 bit |
| Giriş matrisləri | Elementləri [−1, 1] aralığında uniform seçilən matrislər |
Algorithm 6: plaintext–ciphertext matris vurması
Algorithm 6 təcrübələrində A komponenti Strategy 1 ilə üç üzən nöqtəli PP-MM çağırışına, B komponenti isə Strategy 2 ilə tək PP-MM çağırışına endirilmişdir. Rescaling vaxtı ihmal edilə bilən tapıldığı üçün Tablo 9 yalnız Mod-PP-MM hesablamalarını bildirir.
| Ölçü d1 × d2 × d3 | A komponenti (s) | B komponenti (s) | Cəmi (s) | Ən pis dəqiqlik (bit) |
|---|---|---|---|---|
| 212 × 212 × 1 | 0,178 | 0,249 | 0,427 | 13,5 |
| 212 × 212 × 26 | 0,253 | 0,270 | 0,523 | 13,5 |
| 212 × 212 × 212 | 5,00 | 1,78 | 6,78 | 13,4 |
| 213 × 213 × 1 | 0,402 | 1,20 | 1,60 | 13,8 |
| 213 × 213 × 27 | 0,699 | 1,42 | 2,12 | 13,6 |
| 213 × 213 × 213 | 19,1 | 13,3 | 32,4 | 13,7 |
| 214 × 214 × 1 | 0,914 | 6,19 | 7,10 | 14,0 |
| 214 × 214 × 27 | 1,45 | 6,74 | 8,19 | 13,5 |
| 214 × 214 × 214 | 73,7 | 102 | 176 | 13,5 |
Algorithm 8: böyük kvadrat ciphertext–ciphertext matris vurması
Verianla Live: Algorithm 8 vaxtı böyüyən matrislərdə necə dəyişir?
Verilər Tablo 10 nəticələridir. Vaxtlar tək iş parçacığında Intel Xeon Gold 6342 üzərində 10 icranın ortalamasıdır.
| Kvadrat matris ölçüsü | Transpozisiya (s) | Mod-PP-MM (s) | Relinearization (s) | Rescale (s) | Cəmi (s) | Dəqiqlik (bit) |
|---|---|---|---|---|---|---|
| 2^12 × 2^12 | 16,8 | 22,1 | 1,17 | 1,07 | 41,2 | 9,1 |
| 2^13 × 2^13 | 73,6 | 162 | 5,17 | 4,81 | 245 | 8,8 |
| 2^14 × 2^14 | 352 | 1300 | 24,0 | 21,0 | 1710 | 8,3 |
Algorithm 9: RGSW əsaslı ümumi yanaşma
| Ölçü d1 × d2 × d3 | Halqa dərəcəsi | Mod-PP-MM vaxtı (s) | Ən pis dəqiqlik (bit) |
|---|---|---|---|
| 212 × 212 × 1 | 212 | 0,882 | 17,5 |
| 212 × 212 × 26 | 212 | 1,44 | 17,4 |
| 212 × 212 × 212 | 212 | 42,6 | 17,4 |
| 213 × 213 × 1 | 213 | 4,35 | 17,2 |
| 213 × 213 × 26 | 213 | 6,47 | 17,3 |
| 213 × 213 × 213 | 213 | 291 | 17,3 |
| 214 × 214 × 1 | 213 | 10,5 | 17,4 |
| 214 × 214 × 27 | 213 | 19,0 | 17,4 |
| 214 × 214 × 214 | 213 | 1270 | 17,4 |
Algorithm 8 və Algorithm 9 müqayisəsində nə görünür?
Kvadrat \(2^{14}\) matris təcrübəsində Algorithm 8-in Mod-PP-MM hissəsi təxminən 1300 saniyə, Algorithm 9-un uyğun hissəsi təxminən 1270 saniyədir. Bunun shared-a sayəsində Algorithm 9-un fərqli ölçülü BLAS çağırışlarına bölünməsindən qaynaqlandığı izah edilir. Lakin Algorithm 9-un ümumiliyi pulsuz deyil; RGSW formatının hazırlanması və format çevirmələri xüsusilə matris-vektor kimi kiçik çıxış ölçülərində üstün xərcə çevrilə bilər.
4–12 dəfə iddiası necə oxunmalıdır?
Məqalənin xülasəsindəki əsas performans mesajı, müəyyən böyük kvadrat matris vəziyyətlərində CKKS əsaslı şifrəli matris vurması ilə ikiqat dəqiqlikli floating-point matris vurması arasındakı səmərəlilik fərqinin təxminən 4–12 dəfə səviyyəsinə endirilə bilməsidir. Bu ifadə bütün homomorfik proqramların, format çevirmələrinin, bootstrapping mərhələlərinin və ucdan-uca süni intellekt modellərinin plaintext hesablamaya görə yalnız 4–12 dəfə yavaş olması demək deyil.
Çalışmanın güclü tərəfləri
- Nəzəri alqoritmi HEaaN/OpenBLAS tətbiqi ilə birləşdirir.
- Böyük, bərabər və kiçik halqa ölçüləri üçün fərqli şifrələmə formatları verir.
- Şifrəli hesablamanı BLAS kimi yetkin hesablama infrastrukturu ilə əlaqələndirir.
- Xəta analizi və hesablama mürəkkəbliyini birlikdə nəzərə alır.
- Şifrəli transpozisiya üçün quasi-quadratic alqoritm təqdim edir.
- Təhlükəsizlik, dəqiqlik və vaxt birlikdə raporlanır.
Çalışmanın əsas məhdudiyyətləri
- Əsas təcrübələr tək iş parçacıklı Intel Xeon CPU üzərində aparılıb.
- GPU vaxtlaması verilməyib.
- Test matrisləri real tətbiq məlumatından deyil, [−1,1] aralığında uniform paylanmadan yaradılıb.
- İş ucdan-uca transformer və ya LLM inference benchmarkı deyil.
- Format çevirməsi bəzi Mv və kiçik \(d_3\) problemlərində əsas hesablama qədər vacib ola bilir.
- Ön hesablamalı üsullar yalnız eyni plaintext matrisi təkrar istifadə olunan ssenarilərdə amortizasiya olunur.
Mənbə və metod qeydi
Tam orijinal çalışma adı: Fast Homomorphic Linear Algebra with BLAS
Müəlliflər: Youngjin Bae, Jung Hee Cheon, Guillaume Hanrot, Jai Hyun Park və Damien Stehlé.
Məsul müəllif: Jai Hyun Park.
Qurumlar: CryptoLab Inc., Seoul, Republic of Korea; Seoul National University, Seoul, Republic of Korea; CryptoLab Inc., Lyon, France.
Rəsmi jurnal: Journal of Cryptology.
Nəşriyyat: Springer Nature.
Biblioqrafik məlumat: Journal of Cryptology, 2026, cild 39, məqalə 25; Volume 39, Issue 3.
DOI:10.1007/s00145-026-09580-x
Rəsmi yayın tarixi: 12 Mayıs 2026.
Yüklənmiş versiya: arXiv:2503.16080v2 [cs.CR], 27 aprel 2026.
Mənbə növü və rəy statusu: Yüklənən fayl arXiv müəllif versiyasıdır, lakin çalışma Journal of Cryptology-də rəsmi tədqiqat məqaləsi kimi yayımlanmışdır.
Lisenziya/telif: Yüklənmiş versiyada CC BY kimi açıq yenidən istifadə lisenziyası göstərilmir; buna görə Verianla məzmununda orijinal fiqurlar kopyalanmamış, elmi məzmun mətn və Verianla Live strukturu ilə yenidən izah edilmişdir.
İcra: Algorithm 2, Algorithm 4, Algorithm 6, Algorithm 8 və Algorithm 9-un müvafiq hissələri HEaaN üzərində tətbiq edilmiş, plaintext xətti cəbr üçün OpenBLAS 0.3.26 istifadə olunmuşdur.
Deney sərhədi: Zamanlama təcrübələri Intel Xeon Gold 6342 2,80 GHz prosessorda tək iş parçacığı ilə aparılmış, hər vaxt 10 icranın ortalaması kimi raporlanmışdır. GPU performans ölçümü yoxdur.
Təhlükəsizlik sərhədi: Parametrlər lattice estimator-a görə təxminən 128 bit təhlükəsizliyi dəstəkləyir; fərqli CKKS parametrləri ayrıca qiymətləndirilməlidir.
Dəqiqlik sərhədi: CKKS təxmini homomorfik şifrələmə olduğu üçün nəticələr exact arithmetic kimi qiymətləndirilməməlidir.
Performans sərhədi: 4–12 dəfəlik fərq yalnız müəyyən böyük kvadrat matris və BLAS endirmə şərtlərinə aiddir; bütün homomorfik proqramlara, bootstrapping addımlarına və ucdan-uca AI modellərinə genişləndirilə bilməz.
Elmi məzmun sərhədi: Bu Verianla məqaləsindəki texniki nəticələr, alqoritmlər, vaxtlar, dəqiqlik dəyərləri və tətbiq şərhləri incələnən çalışmaya əsaslanır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib