

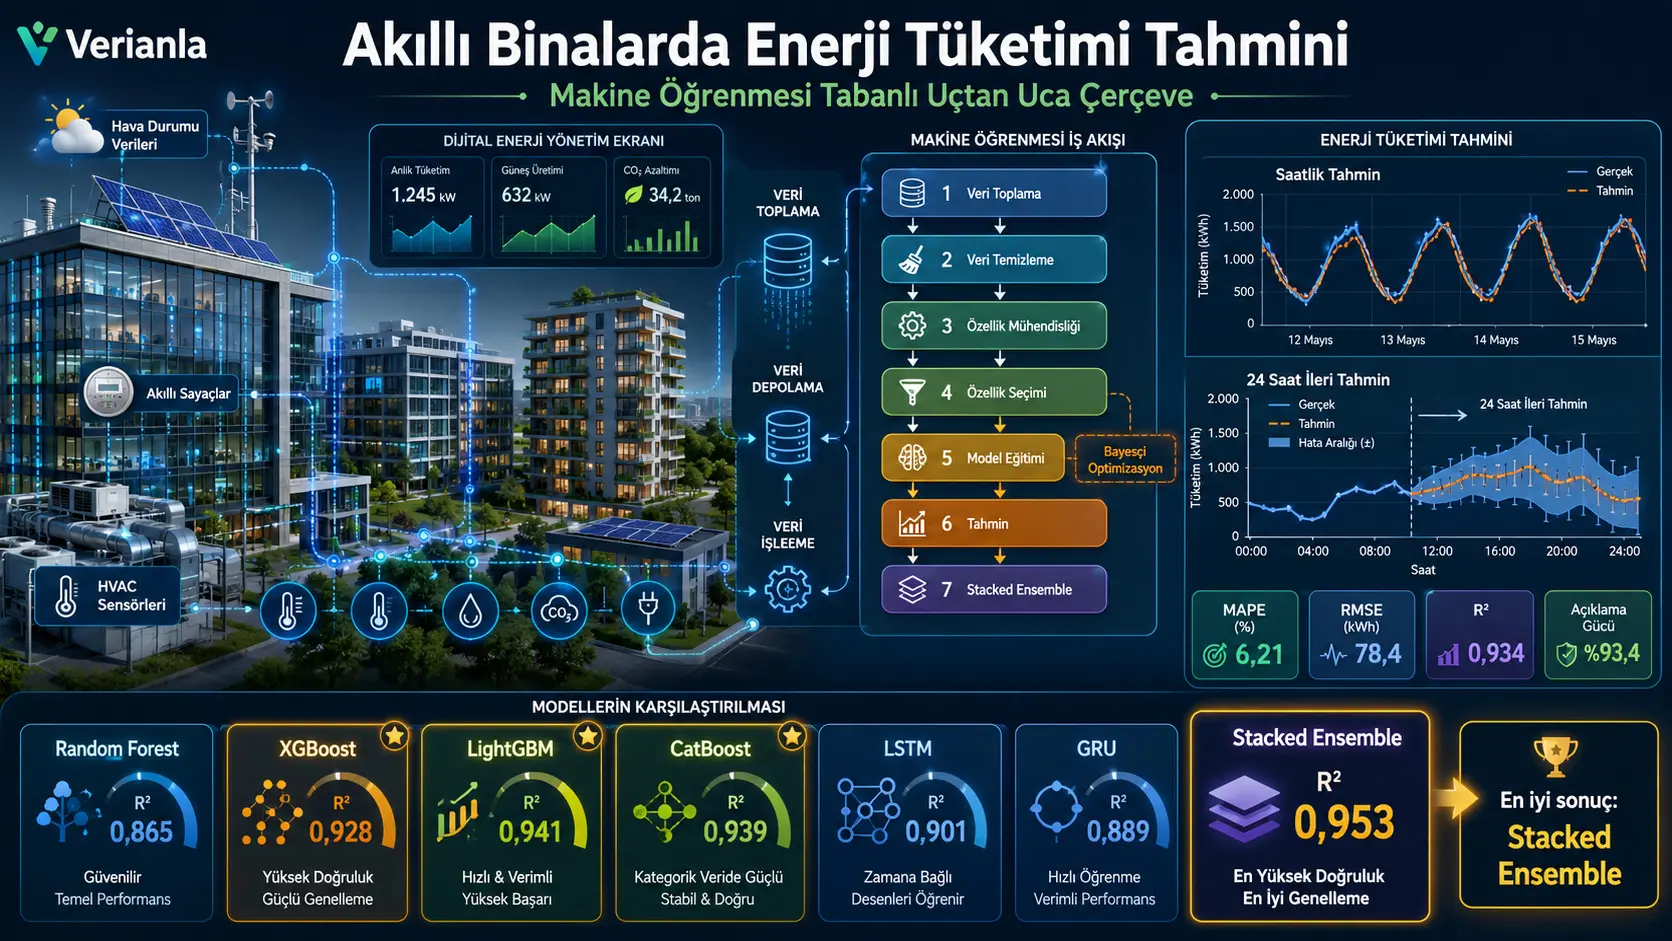
Bu çalışma, akıllı binaların saatlik enerji tüketimini kısa ve orta vadede tahmin etmek amacıyla ham sensör verisinden nihai tahmine kadar uzanan bütünleşik bir makine öğrenmesi çerçevesi önermektedir. Çerçeve; veri temizleme, zaman ve hava koşullarına bağlı özellik mühendisliği, hibrit özellik seçimi, kronolojik eğitim-doğrulama-test ayrımı, altı farklı makine öğrenmesi ve derin öğrenme modelinin karşılaştırılması, Bayesçi hiperparametre optimizasyonu ve en başarılı modellerin stacking yöntemiyle birleştirilmesinden oluşmaktadır.
Araştırmada Random Forest, XGBoost, LightGBM, CatBoost, Long Short-Term Memory (LSTM) ve Gated Recurrent Unit (GRU) modelleri aynı deney protokolü altında karşılaştırılmıştır. Ayrıca doğrulama performansı en yüksek üç model olan LightGBM, CatBoost ve XGBoost'un tahminleri ridge regresyon tabanlı bir meta-öğreniciyle birleştirilerek stacked ensemble oluşturulmuştur.
Çerçeve iki kamuya açık veri kaynağında değerlendirilmiştir: ASHRAE Great Energy Predictor III (GEPIII) ve Building Data Genome Project 2 (BDG2). GEPIII analizinde 380, BDG2 analizinde ise 250 bina kullanılmıştır. Performans MAE, RMSE, MAPE ve R² ölçütleriyle değerlendirilmiştir.
24 saat ileriye yönelik GEPIII tahmininde tekil modeller arasında en iyi sonuç LightGBM'den gelmiş; model 15,47 kWh MAE, 23,58 kWh RMSE, %7,96 MAPE ve 0,929 R² değerine ulaşmıştır. LightGBM, CatBoost ve XGBoost'u birleştiren stacked ensemble ise aynı testte MAE'yi 13,92 kWh'ye, RMSE'yi 21,34 kWh'ye ve MAPE'yi %7,11'e düşürürken R² değerini 0,941'e yükseltmiştir.
BDG2 veri kümesinde de aynı genel sıralama korunmuştur. Stacked ensemble 16,18 kWh MAE, 24,39 kWh RMSE, %8,60 MAPE ve 0,921 R² ile çalışmadaki en başarılı yaklaşım olmuştur. Böylece ensemble yaklaşımının en iyi tekil model olan LightGBM'ye göre MAE açısından GEPIII'de yaklaşık %10,0, BDG2'de yaklaşık %9,5 iyileşme sağladığı raporlanmıştır.
Çalışmanın diğer önemli sonucu, bina enerji tahmininde yalnızca algoritma seçiminin değil özellik mühendisliğinin de kritik olmasıdır. GEPIII üzerindeki ablation analizinde yalnızca takvim değişkenleri kullanıldığında MAPE %13,24 iken geçmiş enerji tüketiminin gecikmeli değerleri eklendiğinde %10,02'ye düşmüş; rolling istatistikler, sıcaklık tabanlı derece-saat değişkenleri ve bina meta verileri eklendikçe MAPE %7,96'ya kadar gerilemiştir.
Türkiye açısından çalışma doğrudan yerel bir bina enerji modeli veya ulusal tasarruf oranı vermemektedir. Bununla birlikte akıllı sayaç, bina otomasyon sistemi, HVAC ve meteoroloji verilerinin mevcut olduğu yapılarda benzer bir tahmin mimarisinin nasıl kurulabileceğine ilişkin yöntemsel bir örnek sunmaktadır. Türkiye'deki uygulamalar için modellerin yerel iklim, kullanım programı, bina tipi, enerji tarifesi, tesisat sistemi ve kullanıcı davranışı verileriyle yeniden eğitilmesi ve bağımsız saha doğrulamasından geçirilmesi gerekir.
Çalışmanın çözmeye çalıştığı problem nedir?
Akıllı binalarda enerji yönetiminin önemli gereksinimlerinden biri, binanın birkaç saat veya bir gün sonra ne kadar elektrik, ısıtma ya da soğutma enerjisine ihtiyaç duyacağını mümkün olduğunca doğru tahmin etmektir. Böyle bir tahmin talep tarafı yönetimi, pik yük azaltma, HVAC çizelgelemesi, yenilenebilir enerji entegrasyonu ve arıza tespiti gibi birçok uygulamada kullanılabilir.
Bununla birlikte bina enerji tüketimi doğrusal ve sabit bir süreç değildir. Dış hava sıcaklığı, nem, güneş ışınımı, haftanın günü, günün saati, bina kullanım amacı ve özellikle geçmiş saatlerdeki tüketim birlikte etkili olabilir. Kullanıcıların binaya geliş-gidişleri ve HVAC ekipmanlarının çalışma programları da tüketimde ani geçişlere neden olabilir.
Araştırmacı bu nedenle tek bir algoritmayı değerlendirmek yerine, aynı veri hazırlama ve değerlendirme koşullarında hem ağaç tabanlı makine öğrenmesi modellerini hem de tekrarlayan sinir ağlarını karşılaştıran uçtan uca bir iş akışı oluşturmuştur.
Önerilen makine öğrenmesi iş akışı nasıl çalışıyor?
Çalışmanın 11. sayfasındaki kavramsal akış şeması ham veriden enerji yönetiminde kullanılabilecek tahmine kadar uzanan sıralı bir yapı göstermektedir. Süreç temel olarak şu aşamalardan oluşmaktadır:
- Akıllı sayaçlar, HVAC sensörleri, meteoroloji verileri ve bina meta verilerinin toplanması.
- Eksik değerlerin, aykırı değerlerin ve zaman damgalarının işlenmesi.
- Takvim, geçmiş tüketim, hareketli istatistik ve meteoroloji tabanlı yeni özelliklerin oluşturulması.
- Filtre ve wrapper yöntemlerini birleştiren hibrit özellik seçimi.
- Verilerin kronolojik eğitim, doğrulama ve test kümelerine ayrılması.
- Random Forest, XGBoost, LightGBM, CatBoost, LSTM ve GRU modellerinin eğitilmesi.
- Bayesçi hiperparametre optimizasyonu.
- En başarılı üç modelin ridge regresyon ile stacking yöntemiyle birleştirilmesi.
- MAE, RMSE, MAPE ve R² kullanılarak performansın değerlendirilmesi.
Bu yapı modülerdir. Araştırmacının yaklaşımına göre belirli bir algoritma veya özellik seçim yöntemi daha sonra değiştirilebilirken veri hazırlama ve değerlendirme protokolü korunabilir.
Ham bina verileri nasıl temizleniyor?
Tüm veri akışları çalışma kapsamında ortak bir saatlik zaman çözünürlüğüne getirilmektedir. Üç saat veya daha kısa eksik veri blokları doğrusal enterpolasyonla doldurulmaktadır. Daha uzun boşluklarda önceki haftanın aynı saat ve aynı gün tipindeki değerinin kullanılması önerilmektedir.
Aykırı değerlerin belirlenmesinde hareketli yedi günlük medyanın üç IQR dışına çıkan gözlemleri ve negatif enerji tüketimi gibi fiziksel olarak gerçekçi olmayan değerler işaretlenmektedir. Bu gözlemler de eksik değerler için kullanılan yaklaşımla yeniden doldurulmaktadır.
Sinir ağı modellerinde özelliklere sıfır ortalama ve birim varyans ölçeklemesi uygulanırken ağaç tabanlı modeller için aynı ölçekleme yapılmamaktadır.
Zaman bilgisi neden sinüs ve kosinüsle kodlanıyor?
Günün saati gibi değişkenler döngüseldir. Saat 23 ile saat 00 sayısal olarak birbirinden uzak görünse de gerçekte komşu zaman noktalarıdır. Çalışmada saat bilgisi bu sürekliliği korumak amacıyla sinüs ve kosinüs çiftine dönüştürülmektedir:
\[ x_{\sin}=\sin\left(\frac{2\pi h}{24}\right), \qquad x_{\cos}=\cos\left(\frac{2\pi h}{24}\right) \]
Burada h günün saatini temsil etmektedir. Benzer döngüsel kodlama haftanın günü için de uygulanmaktadır.
Geçmiş tüketim bilgisi nasıl kullanılıyor?
Enerji tüketimi zaman serileri genellikle güçlü otokorelasyon içerir. Bir binanın mevcut tüketimi, kısa süre önceki veya aynı saatin bir gün ve bir hafta önceki tüketimiyle ilişkili olabilir. Bu nedenle çalışmada tüketimin:
- 1 saat önceki değeri,
- 24 saat önceki değeri,
- 168 saat önceki değeri
özellik olarak kullanılmaktadır.
Ayrıca son 3, 24 ve 168 saatlik pencereler için hareketli ortalama ve standart sapma oluşturulmaktadır. Hareketli ortalama genel eğilimi, hareketli standart sapma ise tüketimin son dönemdeki değişkenliğini modele taşımaktadır.
Çalışmanın 25. sayfasındaki SHAP tabanlı LightGBM özellik önem grafiğinde de en belirleyici özellik lag_1h olarak görünmektedir. Bunu lag_24h, 24 saatlik hareketli ortalama ve dış hava sıcaklığı izlemektedir. Bu görsel bulgu, ablation analizindeki gecikmeli özelliklerin yüksek katkısıyla tutarlıdır.
Isıtma ve soğutma derece-saatleri nasıl hesaplanıyor?
Dış hava sıcaklığının bina enerji tüketimi üzerindeki etkisini daha doğrudan temsil etmek için 18 °C temel sıcaklığa dayalı Heating Degree Hours ve Cooling Degree Hours değişkenleri oluşturulmuştur:
\[ HDH_t=\max(0,T_b-T_t) \]
\[ CDH_t=\max(0,T_t-T_b) \]
Burada Tb temel sıcaklığı, Tt ise t anındaki dış hava kuru termometre sıcaklığını göstermektedir. Bu dönüşüm, sıcaklık ile ısıtma/soğutma ihtiyacı arasındaki ilişkiyi modele daha açık bir biçimde sunmayı amaçlamaktadır.
Toplam hangi özellikler değerlendirildi?
Çalışmanın özellik havuzu birkaç ana gruba ayrılmıştır:
| Özellik grubu | Örnekler |
|---|---|
| Takvim | Saat sin/cos, haftanın günü sin/cos, hafta sonu, tatil, ay |
| Gecikmeli tüketim | lag_1h, lag_24h, lag_168h |
| Hareketli istatistik | 3, 24 ve 168 saatlik ortalama ve standart sapma |
| Meteoroloji | Sıcaklık, nem, rüzgâr hızı, güneş ışınımı, HDH, CDH |
| Bina meta verileri | Bina tipi, taban alanı, yapım yılı, site kimliği |
Başlangıçtaki 27 aday özellik, hibrit özellik seçimi sonrasında bina portföyüne bağlı olarak yaklaşık 16–19 özelliğe indirilmektedir.
Özellik seçimi nasıl yapılıyor?
Çalışma iki aşamalı bir filtre-wrapper yaklaşımı kullanmaktadır. İlk aşamada hedefle ilişkisi daha yüksek özellikleri belirlemek için mutual information ve korelasyon bilgisi kullanılmakta; yüksek ölçüde ilişkili özelliklerden birinin çıkarılması hedeflenmektedir.
İkinci aşamada Recursive Feature Elimination (RFE) uygulanmaktadır. En az katkı sağlayan özellikler sırayla kaldırılmakta ve doğrulama performansındaki gelişme durana kadar süreç devam etmektedir.
Kaynak metinde bu bölümün tanımında mutual information kavramıyla |r| > 0,9 korelasyon eşiği aynı açıklama içinde kullanılmaktadır. Dolayısıyla filtreleme adımının uygulama ayrıntısı metinsel olarak tam tek anlamlı değildir. Çalışmanın kodu da bu sürümde verilmediğinden söz konusu adımın bire bir yeniden üretimi yalnız makale metni üzerinden tam olarak doğrulanamamaktadır.
Random Forest nasıl kullanılıyor?
Random Forest, bootstrap örnekleri üzerinde eğitilen B adet regresyon ağacının tahminlerini ortalamaktadır:
\[ \hat y_{RF}=\frac{1}{B}\sum_{b=1}^{B}T_b(x) \]
Çalışmada model özellikle heterojen ve gürültülü bina verileri için karşılaştırma algoritmalarından biri olarak kullanılmıştır.
XGBoost, LightGBM ve CatBoost neyi temsil ediyor?
Üç model de gradient boosting ailesindedir. Zayıf öğreniciler ardışık olarak eklenerek önceki modelin hatası azaltılmaya çalışılmaktadır. Kaynakta genel boosting güncellemesi şu biçimde ifade edilmektedir:
\[ F_m(x)=F_{m-1}(x)+\eta h_m(x) \]
Burada η öğrenme oranıdır. XGBoost düzenlileştirme ve ikinci dereceden gradyan bilgisini kullanırken LightGBM histogram tabanlı, leaf-wise ağaç büyütme yaklaşımına sahiptir. CatBoost ise özellikle kategorik değişkenlerin doğrudan işlenmesi ve ordered boosting yaklaşımıyla ayrılmaktadır.
Deneysel sonuçlarda bu üç gradient boosting modeli, yapılandırılmış ve özellik mühendisliği uygulanmış bina verilerinde LSTM ve GRU'dan daha yüksek doğruluk sağlamıştır.
LSTM ve GRU neden karşılaştırıldı?
LSTM ve GRU, zaman içindeki uzun bağımlılıkları modellemek için tasarlanmış tekrarlayan sinir ağı mimarileridir. LSTM giriş, unutma ve çıkış kapıları üzerinden geçmiş bilginin ne kadarının saklanacağını denetlemektedir. GRU daha az kapı ve daha az parametreyle benzer bir işlev gerçekleştirmektedir.
Çalışmanın 28. sayfasındaki eğitim ve doğrulama kayıp eğrileri, GRU'nun yaklaşık 27. epoch civarında erken durdurmaya ulaştığını; LSTM'nin ise yaklaşık 33. epoch'a kadar devam ettiğini göstermektedir. Araştırmacı bunu GRU'nun daha basit kapı yapısı ve daha az parametresiyle ilişkilendirmektedir.
Bu çalışma bağlamında iki tekrarlayan ağın tek başına gradient boosting modellerini geçemediği görülmüştür. Bununla birlikte araştırmacı, düzensiz doluluk geçişleri ve daha uzun zaman bağımlılıklarında recurrent modellerin farklı hata karakteristiğine sahip olabileceğini belirtmektedir.
Stacked ensemble nasıl oluşturuluyor?
Doğrulama R² performansı en yüksek üç temel modelin tahminleri yeni bir veri matrisi olarak kullanılmakta ve ridge regresyon meta-öğrenici eğitilmektedir:
\[ \hat y_{ens}=\sum_{k=1}^{3}\beta_k\hat y_k+\beta_0 \]
Ridge düzenlileştirmesi ise meta-modelin tek bir temel öğreniciye aşırı ağırlık vermesini azaltmayı amaçlamaktadır:
\[ \boldsymbol{\beta} =\arg\min_{\boldsymbol{\beta}} \left\|y-X\boldsymbol{\beta}\right\|_2^2 +\lambda\left\|\boldsymbol{\beta}\right\|_2^2 \]
Son ensemble LightGBM, CatBoost ve XGBoost'tan oluşmuştur.
Hiperparametreler nasıl optimize edildi?
Her model için Bayesçi optimizasyon ve Tree-structured Parzen Estimator yaklaşımı kullanılmıştır. GEPIII doğrulama kümesinde model başına 50 optimizasyon denemesi gerçekleştirilmiştir.
Örneğin Random Forest için ağaç sayısı 100–800, XGBoost için 100–1.000, LightGBM için yaprak sayısı 15–255 aralıklarında aranmıştır. LSTM ve GRU için 32–256 hidden unit, 1–3 katman, 0–0,5 dropout, 32–256 batch size ve 10−4–10−2 öğrenme oranı değerlendirilmiştir.
Hangi veri kümeleri kullanıldı?
| Özellik | ASHRAE GEPIII | BDG2 |
|---|---|---|
| Analize alınan bina | 380 | 250 |
| Bina kullanımı | Ofis, eğitim, konut | Ofis, eğitim, kamusal toplanma, perakende |
| İklim bölgesi | 8 | 6 |
| Zaman çözünürlüğü | Saatlik | Saatlik |
| Ortalama saatlik elektrik tüketimi | 158,4 kWh | 172,6 kWh |
| Standart sapma | 142,7 kWh | 156,3 kWh |
| Temizleme öncesi eksik okuma | %4,8 | %6,2 |
| Düzeltilen aykırı gözlem | %1,3 | %1,7 |
| Ortalama bina alanı | 8.240 m² | 9.510 m² |
GEPIII veri kümesinin asıl kaynağı 1.400'den fazla binayı içerirken araştırmada bir yıllık verisinin en az %90'ı eksiksiz olan ve belirlenen kullanım türlerine giren yaklaşık 380 bina tutulmuştur. BDG2 için elektrik ölçümü ve meteorolojik kayıtları yeterli olan 250 bina seçilmiştir.
Eğitim ve test verileri nasıl ayrıldı?
Gelecek gözlemlerin geçmişe sızmasını önlemek amacıyla zaman serisi kronolojik olarak %70 eğitim, %15 doğrulama ve %15 test bölümlerine ayrılmıştır. Eğitim ve doğrulama bölümlerinde ayrıca kronolojik, çakışmayan beş katlı blocked time-series cross-validation uygulanmıştır.
Sinir ağlarında validation loss için patience = 10 epoch erken durdurma kullanılmış ve stokastik değişkenliği azaltmak amacıyla beş farklı rastgele başlangıcın sonuçları değerlendirilmiştir.
Model performansı hangi ölçütlerle değerlendirildi?
Mean Absolute Error (MAE):
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat y_i| \]
Root Mean Squared Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat y_i)^2} \]
Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100\%}{n}\sum_{i=1}^{n} \left|\frac{y_i-\hat y_i}{y_i}\right| \]
Determination coefficient (R²):
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat y_i)^2} {\sum_{i=1}^{n}(y_i-\bar y)^2} \]
MAE ortalama mutlak hata büyüklüğünü, RMSE büyük hataları daha ağır biçimde cezalandıran hata düzeyini, MAPE göreli yüzdelik hatayı ve R² ise gözlenen varyansın model tarafından açıklanabilen bölümünü göstermektedir.
GEPIII üzerinde hangi model daha başarılı oldu?
| Model | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Random Forest | 18,42 | 27,85 | 9,87 | 0,902 |
| XGBoost | 16,21 | 24,63 | 8,42 | 0,921 |
| LightGBM | 15,47 | 23,58 | 7,96 | 0,929 |
| CatBoost | 15,63 | 23,71 | 8,05 | 0,927 |
| LSTM | 16,85 | 25,12 | 8,71 | 0,916 |
| GRU | 17,10 | 25,47 | 8,89 | 0,913 |
| Stacked Ensemble | 13,92 | 21,34 | 7,11 | 0,941 |
24 saat ileri tahmininde ensemble dört metrikte de en iyi değeri vermiştir. Çalışmanın 24. sayfasındaki gözlenen–tahmin edilen tüketim grafiğinde de noktaların büyük bölümü 1:1 referans çizgisi çevresinde kümelenmektedir.
Sonuçlar başka bir veri kümesinde korundu mu?
BDG2 analizinde de stacked ensemble en düşük hata ve en yüksek R² değerlerine ulaşmıştır:
| Model | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Random Forest | 21,05 | 31,44 | 11,62 | 0,879 |
| XGBoost | 18,63 | 27,92 | 10,05 | 0,901 |
| LightGBM | 17,88 | 26,77 | 9,48 | 0,909 |
| CatBoost | 18,02 | 26,95 | 9,61 | 0,907 |
| LSTM | 18,94 | 27,63 | 9,92 | 0,898 |
| GRU | 19,31 | 28,10 | 10,14 | 0,894 |
| Stacked Ensemble | 16,18 | 24,39 | 8,60 | 0,921 |
Ancak bu deney doğrudan sıfırdan eğitim yapılmadan bir binadan diğerine model transferi anlamına gelmemektedir. Çalışmanın açıklamasına göre aynı özellik mühendisliği çerçevesi ve hiperparametre yaklaşımı BDG2 üzerinde yeniden eğitilmektedir. Dolayısıyla sonuçlar yöntemsel transfer edilebilirliği desteklemektedir; eğitilmiş tek bir GEPIII modelinin BDG2 binalarında doğrudan çalıştığını kanıtlamamaktadır.
Özellik mühendisliği performansı ne kadar değiştirdi?
| Özellik kümesi | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Yalnız takvim | 22,87 | 33,96 | 13,24 | 0,847 |
| + Gecikmeli tüketim | 18,05 | 27,11 | 10,02 | 0,892 |
| + Hareketli istatistik | 16,31 | 24,68 | 8,64 | 0,914 |
| + HDH/CDH | 15,72 | 23,89 | 8,11 | 0,925 |
| + Bina meta verileri | 15,47 | 23,58 | 7,96 | 0,929 |
En büyük tek sıçrama geçmiş tüketim değişkenleri eklendiğinde görülmektedir. Yalnız takvim özelliklerine kıyasla MAPE %13,24'ten %10,02'ye düşmektedir. Bu bulgu enerji tüketiminin yakın geçmişinin 24 saat ileri tahmin açısından güçlü bilgi taşıdığını göstermektedir.
Daha karmaşık model daha hızlı mı?
Hayır. Çalışmanın hesaplama maliyeti tablosunda LightGBM hem yüksek doğruluk hem düşük hesaplama maliyetiyle öne çıkmaktadır.
| Model | Eğitim süresi (s) | Tahmin gecikmesi (ms/örnek) | Model boyutu (MB) |
|---|---|---|---|
| Random Forest | 148 | 0,42 | 86,4 |
| XGBoost | 96 | 0,18 | 12,1 |
| LightGBM | 41 | 0,09 | 7,8 |
| CatBoost | 112 | 0,21 | 15,6 |
| LSTM | 1.284 | 1,35 | 4,2 |
| GRU | 967 | 1,02 | 3,6 |
| Stacked Ensemble | 1.637 | 1,85 | 39,7 |
LightGBM'nin 41 saniyelik raporlanan eğitim süresi, LSTM'nin 1.284 saniyelik süresinden yaklaşık 31 kat daha düşüktür. Ancak bu değerler yalnızca çalışmada kullanılan donanım ve deney düzeni için geçerlidir; farklı veri büyüklüğü ve donanımda aynı sürelerin elde edilmesi beklenmemelidir.
Ensemble üstünlüğü istatistiksel olarak sınandı mı?
GEPIII test kümesinde stacked ensemble'ın mutlak hataları ile her temel modelin mutlak hataları arasında eşleştirilmiş t-testleri uygulanmıştır. Tüm karşılaştırmalarda p < 0,001 raporlanmıştır.
| Karşılaştırma | Ortalama hata farkı (kWh) | t-istatistiği | p-değeri |
|---|---|---|---|
| Ensemble – Random Forest | 4,50 | 14,82 | <0,001 |
| Ensemble – XGBoost | 2,29 | 9,47 | <0,001 |
| Ensemble – LightGBM | 1,55 | 6,63 | <0,001 |
| Ensemble – CatBoost | 1,71 | 7,02 | <0,001 |
| Ensemble – LSTM | 2,93 | 10,15 | <0,001 |
| Ensemble – GRU | 3,18 | 10,88 | <0,001 |
Bu testler çalışmanın kendi GEPIII örnekleminde ensemble'ın hata azalmasının örnekleme değişkenliğiyle açıklanma olasılığının düşük olduğuna işaret etmektedir. Bununla birlikte istatistiksel anlamlılık, farklı gerçek bina filolarında aynı büyüklükte performans kazanımının garanti edildiği anlamına gelmez.
Tahmin süresi 48 saate çıktığında ne oluyor?
Çalışmanın 32. sayfasındaki duyarlılık grafiği 1 saatten 48 saate kadar beş başarılı modelin MAPE değişimini göstermektedir. Tahmin ufku uzadıkça tüm modellerde hata artmaktadır.
Stacked ensemble bütün incelenen tahmin ufuklarında en düşük MAPE'yi korumuştur. En iyi tekil model LightGBM ile ensemble arasındaki fark yaklaşık 1 saatlik tahminde 0,7 yüzde puanıyken 48 saatte 1,1 yüzde puanına yükselmiştir.
LSTM ve GRU'nun hata artış eğimleri bazı boosting modellerine kıyasla daha yatık olmasına rağmen çalışmada incelenen 1–48 saat aralığında gradient boosting modellerinin doğruluğunu geçmemişlerdir.
Çalışma gerçek bina yönetiminde ne öneriyor?
Araştırmacı elde edilen tahminlerin talep tarafı katılımı, HVAC set değerlerinin önceden ayarlanması, pik yük yönetimi ve tahmin-gerçek tüketim farklarının anomali göstergesi olarak kullanılması gibi uygulamalara aktarılabileceğini belirtmektedir.
Özellikle LightGBM'nin düşük eğitim ve çıkarım maliyeti, donanım kaynaklarının sınırlı olduğu yerel BEMS veya edge uygulamaları açısından avantaj olarak değerlendirilmektedir. Ensemble ise doğruluğun ekonomik olarak daha önemli olduğu uygulamalarda tercih edilebilecek daha ağır bir seçenek olarak önerilmektedir.
Ancak araştırmada gerçek bir binanın HVAC kontrol döngüsü çalıştırılmamış, enerji faturası veya fiziksel enerji tüketimi üzerinde deneysel tasarruf ölçülmemiş ve gerçek talep yanıt piyasasında teklif verilmemiştir. Bunlar araştırmacının sonuçlardan türettiği potansiyel kullanım alanlarıdır.
Çalışmanın söylediği ve söylemediği nedir?
Çalışmanın söylediği: İki kamuya açık bina veri kümesinde, aynı veri hazırlama ve değerlendirme çerçevesi altında gradient boosting modelleri tekil LSTM ve GRU modellerinden daha iyi tahmin doğruluğu sağlamıştır. En iyi üç gradient boosting modelinin stacking ile birleştirilmesi her iki veri kümesinde de ek doğruluk kazanımı sağlamıştır. Özellikle geçmiş tüketim, hareketli istatistikler ve hava koşullarından oluşturulan özellikler tahmin performansında önemli rol oynamıştır.
Çalışmanın söylemediği: LightGBM'nin bütün bina tiplerinde veya bütün iklimlerde her zaman LSTM'den üstün olduğunu kanıtlamamaktadır. Çalışma gerçek zamanlı bir bina otomasyon sistemi üzerinde saha deneyi değildir. Raporlanan daha düşük tahmin hatasının doğrudan belirli bir yüzde enerji tasarrufu oluşturduğunu göstermemektedir. Aynı şekilde BDG2 analizi eğitilmiş GEPIII modelinin yeniden eğitim olmadan başka binalara taşınabildiğini kanıtlamamaktadır.
Çalışmanın Yöntemi ve Bulguları
Deneysel tasarımın özeti
- Temel problem: Saatlik akıllı bina enerji tüketimi tahmini.
- Temel tahmin ufku: 24 saat ileri.
- Ek duyarlılık: 1–48 saat ileri tahmin.
- Veri kümeleri: ASHRAE GEPIII ve Building Data Genome Project 2.
- GEPIII örneklemi: 380 bina.
- BDG2 örneklemi: 250 bina.
- Temel zaman çözünürlüğü: Saatlik.
- Modeller: Random Forest, XGBoost, LightGBM, CatBoost, LSTM ve GRU.
- Ensemble: LightGBM + CatBoost + XGBoost; ridge regression meta-öğrenici.
- Veri ayrımı: %70 eğitim, %15 doğrulama, %15 test; kronolojik.
- Cross-validation: Beş katlı blocked time-series cross-validation.
- Hiperparametre optimizasyonu: Bayesçi optimizasyon; model başına 50 doğrulama denemesi.
- Değerlendirme: MAE, RMSE, MAPE ve R².
GEPIII'deki ana bulgu
24 saat ileri tahminde en iyi tekil model LightGBM'dir: MAE 15,47 kWh, RMSE 23,58 kWh, MAPE %7,96 ve R² 0,929. Stacked ensemble bu değerleri sırasıyla 13,92 kWh, 21,34 kWh, %7,11 ve 0,941'e taşımıştır.
LightGBM ile karşılaştırıldığında ensemble'ın MAE'sindeki azalma yaklaşık:
\[ \frac{15.47-13.92}{15.47}\times100 \approx 10.0\% \]
düzeyindedir.
BDG2'deki ana bulgu
En iyi tekil model yine LightGBM olmuş ve 17,88 kWh MAE, 26,77 kWh RMSE, %9,48 MAPE ve 0,909 R² üretmiştir. Stacked ensemble 16,18 kWh MAE, 24,39 kWh RMSE, %8,60 MAPE ve 0,921 R² değerine ulaşmıştır.
LightGBM'ye göre ensemble MAE azalması yaklaşık:
\[ \frac{17.88-16.18}{17.88}\times100 \approx 9.5\% \]
olarak hesaplanmaktadır.
Özellik mühendisliğinin ana bulgusu
LightGBM ablation deneyinde yalnız takvim özellikleriyle R² 0,847 ve MAPE %13,24 iken bütün özellikler kullanıldığında R² 0,929'a yükselmiş, MAPE %7,96'ya düşmüştür. En büyük tek aşamalı kazanç, lagged consumption özelliklerinin eklenmesiyle oluşmuştur.
Hız-doğruluk dengesi
Tekil modeller arasında LightGBM, hem yüksek doğruluğu hem de 41 saniyelik raporlanan eğitim süresi ve 0,09 ms/örnek çıkarım gecikmesi nedeniyle çalışmanın en güçlü doğruluk-hesaplama maliyeti dengelerinden birini sunmaktadır.
Stacked ensemble daha yüksek doğruluk üretirken 1.637 saniyelik toplam eğitim süresi ve 1,85 ms/örnek gecikmeyle daha yüksek hesaplama maliyetine sahiptir. Bu nedenle araştırmanın sonuçları “her durumda ensemble kullanılmalıdır” şeklinde yorumlanmamalıdır; performans ihtiyacı ile hesaplama kaynağı arasında bir seçim bulunmaktadır.
Bilimsel sınırlılıklar
- Sonuçlar iki kamuya açık veri kümesine dayanmaktadır; canlı bir bina otomasyon sisteminde saha doğrulaması yapılmamıştır.
- BDG2 karşılaştırması aynı metodolojik çerçevenin farklı veri üzerinde yeniden eğitilmesidir; sıfırdan eğitim olmadan cross-building transfer testi değildir.
- Raporlanan hesaplama süreleri yalnız kullanılan donanım ve deney düzeni için geçerlidir.
- Çalışma nokta tahmini yapmaktadır; tahmin belirsizliği veya kalibre edilmiş olasılık aralıkları değerlendirilmemiştir.
- Transformer veya attention tabanlı modeller aynı deney düzeninde karşılaştırılmamıştır.
- Gerçek zamanlı enerji tarifesi, ayrıntılı doluluk algılama ve plug-load ayrıştırması temel deneylerde yer almamaktadır.
- Kaynak kodu ve eğitilmiş model artefaktlarının açık paylaşımı bu sürümde gösterilmediğinden tam bağımsız yeniden üretilebilirlik doğrulanamamaktadır.
- Özellik filtreleme açıklamasındaki mutual information ve korelasyon eşiği terminolojisi tam tek anlamlı değildir.
- Kaynak metinde bazı şekil numaralandırmaları ile model adlandırmalarında editoryal tutarsızlıklar bulunmaktadır.
Gelecek araştırma önerileri
Çalışma gelecekte nokta tahminleri yerine olasılıksal tahminlerin, Transformer ve attention mimarilerinin, federated learning'in, transfer learning'in, daha ayrıntılı doluluk ve plug-load verilerinin ve dinamik elektrik fiyatlarının değerlendirilmesini önermektedir.
Özellikle federated learning, farklı bina veya kurumların ham enerji tüketim verilerini tek bir merkezde toplamadan ortak model eğitebilmesi açısından araştırma yönü olarak belirtilmektedir. Transfer learning ise yeni veya veri açısından yetersiz binalarda başlangıç veri ihtiyacını azaltabilecek potansiyel yaklaşım olarak sunulmaktadır.
Kaynak ve Yöntem Notu
Özgün çalışma adı: A Machine Learning-Based Framework for Predicting Energy Consumption in Smart Buildings
Yazar: Sun Tao
Yazar kimliği hakkında not: Yüklenen çalışma metninin görünür ilk sayfasında yazar veya kurum bilgisi bulunmamaktadır. Sun Tao ve Zhejiang University bilgileri çalışmanın işaret ettiği SSRN Abstract 7199510 resmî bibliyografik kaydı üzerinden doğrulanmıştır.
Eş katkı/eş birinci yazar: Tek yazarlı kayıt olduğundan eş birinci yazarlık bilgisi bulunmamaktadır.
İletişim yazarı: SSRN kaydında Sun Tao contact author olarak gösterilmektedir.
Kurum: Zhejiang University.
DOI: 10.2139/ssrn.7199510
Yayın platformu: SSRN, Abstract 7199510.
Dergi: Hakemli bir dergi yayını doğrulanmamıştır.
Yayın yılı: 2026.
Kaynak türü: Makine öğrenmesi ve bina enerji tüketimi tahmini üzerine deneysel model karşılaştırması içeren araştırma preprinti.
Hakemlik durumu: Çalışmanın mevcut sürümü hakem değerlendirmesinden geçmemiş bir preprinttir. Kaynağın her sayfasında “Preprint not peer reviewed” ibaresi bulunmaktadır.
Resmî bağlantı: SSRN Abstract 7199510.
Bibliyografik kimlik notu: Aynı çalışma başlığı ve büyük ölçüde aynı özetle farklı bir yazar ve farklı SSRN numarası altında indekslenen başka bir kayıt da çevrimiçi kaynaklarda görülmektedir. Yüklenen çalışma her sayfada 7199510 numaralı kayda bağlandığından bu içerikte yalnızca 7199510 bibliyografik kimliği esas alınmıştır.
Bu Verianla içeriğindeki yöntem, veri kümesi, formül, performans değeri, özellik önem sırası, hesaplama maliyeti ve araştırma sonucu yalnızca incelenen çalışmaya dayanmaktadır. Dış kaynaklar bilimsel bulguları genişletmek için kullanılmamış; yalnızca çalışmanın bibliyografik kimliği, yazarı, kurumu ve DOI bilgisini doğrulamak amacıyla kullanılmıştır.
Çalışmanın sonuçları kamuya açık benchmark veri kümelerinde elde edilen tahmin performansıdır. Gerçek bir binada enerji tasarrufu, HVAC kontrol başarısı, maliyet azaltımı veya talep yanıt gelirinin saha ortamında doğrulandığı sonucuna ulaşılamaz. Ayrıca başka bina ve iklimlere uygulanabilirlik, aynı veri hazırlama ve modelleme çerçevesinin yerel veriler üzerinde yeniden eğitilmesini ve bağımsız doğrulamayı gerektirir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir