

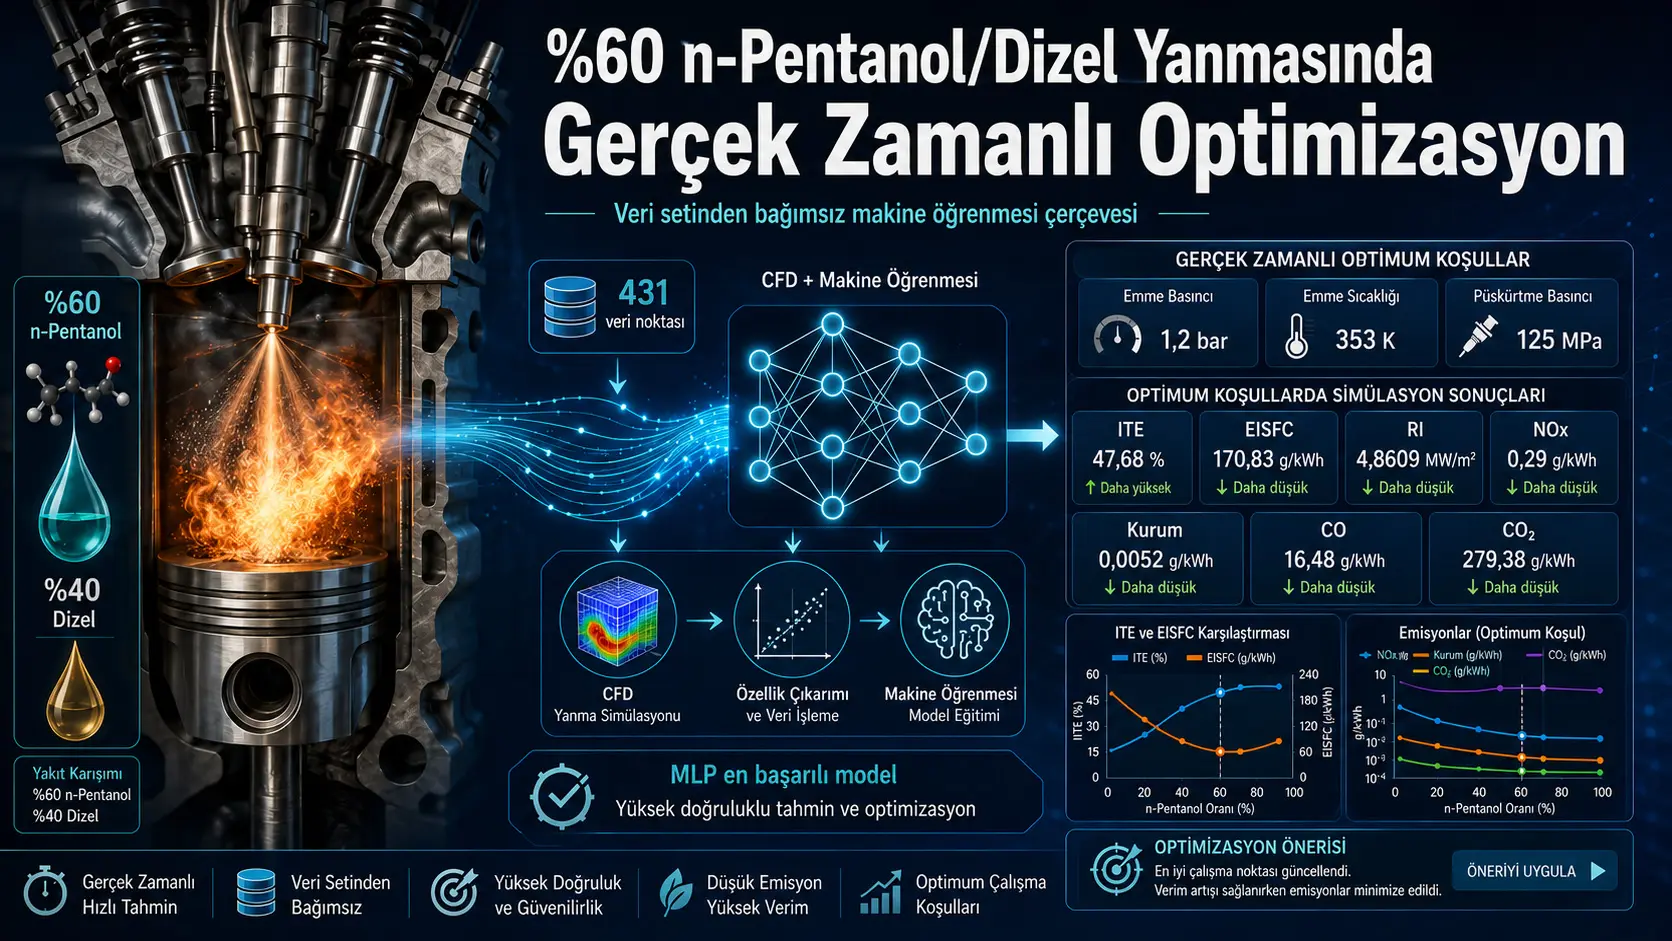
Bu çalışma, %60 n-pentanol ve %40 dizel yakıt karışımıyla çalışan sıkıştırma ateşlemeli bir motorun performansını, yanma şiddetini ve egzoz emisyonlarını üç motor kontrol değişkeninden tahmin etmek için veri setinden bağımsız bir makine öğrenmesi çerçevesi geliştirmiştir. Araştırmada doğrulanmış üç boyutlu hesaplamalı akışkanlar dinamiği modeliyle üretilen 431 veri örneği kullanılmış; emme basıncı, emme sıcaklığı ve püskürtme basıncından indike termal verim, eşdeğer indike özgül yakıt tüketimi, yanma çınlama şiddeti, NOx, kurum, CO ve CO2 değerleri tahmin edilmiştir. Çok katmanlı algılayıcı sinir ağı genel olarak en başarılı model olurken yanma çınlama şiddeti ve NOx için destek vektör makinesi bazı ölçütlerde küçük bir üstünlük göstermiştir. Bununla birlikte çalışma hakem değerlendirmesinden geçmemiştir; eğitim verileri yeni bağımsız motor deneylerinden değil, daha önce doğrulanmış bir CFD modelinden üretilmiştir ve sistemin farklı bağımsız veri setlerindeki genellenebilirliği doğrudan gösterilmemiştir.
Beş denetimli öğrenme modeli karşılaştırılmıştır: çok katmanlı algılayıcı sinir ağı (multilayer perceptron, MLP), rastgele orman (random forest, RF), aşırı gradyan artırma (XGBoost), destek vektör makinesi (support vector machine, SVM) ve k-en yakın komşu (k-nearest neighbors, KNN). Veri örneklerinin %80’i eğitim, %20’si test için ayrılmış; ölçekleyici yalnızca eğitim verisine uydurularak veri sızıntısı azaltılmaya çalışılmıştır.
MLP modeli indike termal verimde R² = 0,9491, eşdeğer indike özgül yakıt tüketiminde R² = 0,9439, kurumda R² = 0,9513, CO’da R² = 0,9612 ve CO2’de R² = 0,8983 değerlerine ulaşmıştır. Yanma çınlama şiddetinde SVM’nin R² değeri 0,8959, MLP’nin değeri 0,8953’tür. NOx için SVM R² = 0,8856 ile MLP’nin 0,8791 değerinin biraz üzerinde kalmıştır.
Çalışmada en uygun olarak sunulan giriş koşulları 1,2 bar emme basıncı, 353 K emme sıcaklığı ve 125 MPa püskürtme basıncıdır. Bu noktada CFD simülasyonu %47,68 indike termal verim, 170,83 g/kWh eşdeğer indike özgül yakıt tüketimi, 4,8609 MW/m² yanma çınlama şiddeti, 0,29 g/kWh NOx, 0,0052 g/kWh kurum, 16,48 g/kWh CO ve 279,38 g/kWh CO2 vermiştir. MLP tahminleri verim, yakıt tüketimi, CO ve CO2 için simülasyona çok yakınken NOx ve çınlama şiddetindeki farklar daha büyüktür.
Geliştirilen Python/Django arayüzü kullanıcıların CSV veya XLSX dosyalarını yüklemesine, giriş ve hedef sütunlarını seçmesine, modelleri yeniden eğitmesine, R², MAE ve RMSE sonuçlarını görüntülemesine ve belirlenen motor koşulları için anlık tahmin üretmesine imkân vermektedir. “Gerçek zamanlı” ifadesi burada eğitilmiş modelin hızlı tahmin yapmasını anlatmaktadır; çalışma motor kontrol ünitesine bağlanmış kapalı çevrimli bir gerçek zamanlı motor kontrolü göstermemektedir.
Araştırmanın temel sorusu nedir?
Araştırmanın temel sorusu, %60 n-pentanol içeren yüksek oranlı bir n-pentanol/dizel karışımının düşük yükteki motor performansı ve emisyonlarının, uzun süren yeni deneyler veya her çalışma noktası için yeniden yürütülen CFD hesaplamaları olmadan yeterli doğrulukla tahmin edilip edilemeyeceğidir.
Çalışma daha özel olarak şu sorulara yanıt aramaktadır:
- Emme basıncı, emme sıcaklığı ve püskürtme basıncı kullanılarak yedi motor çıktısı aynı anda tahmin edilebilir mi?
- Beş farklı makine öğrenmesi algoritmasından hangisi genel olarak en iyi sonucu verir?
- Eğitilmiş model, CFD’nin yerine daha hızlı bir vekil model olarak kullanılabilir mi?
- Veri ve hedef sütunları sabit kodlanmadan, farklı araştırmacıların kendi veri setlerini yükleyebileceği bir arayüz oluşturulabilir mi?
- Belirli motor koşullarında verim, tüketim, çınlama ve emisyonlar birlikte kabul edilebilir düzeyde tutulabilir mi?
Çalışma neden önemlidir?
Bir sıkıştırma ateşlemeli motorun emme basıncı, emme sıcaklığı, püskürtme basıncı, püskürtme zamanlaması, yükü ve yakıt bileşimi birbirini etkileyen çok sayıda değişken oluşturur. Her kombinasyonun deneysel olarak ölçülmesi; motorun kararlı duruma gelmesini, yakıt tüketimi ve basınç verilerinin kaydedilmesini ve egzoz numunesinin analiz edilmesini gerektirir. Yüksek çözünürlüklü CFD simülasyonları da yanma kimyası, püskürtme parçalanması ve emisyon modelleri nedeniyle önemli hesaplama süresi tüketir.
Makine öğrenmesi, önceden oluşturulmuş bir veri setindeki ilişkiyi öğrenerek yeni bir giriş kombinasyonunun olası sonuçlarını çok daha kısa sürede hesaplayabilir. Bu yaklaşım fiziksel motorun veya CFD modelinin yerine geçmekten çok, daha önce doğrulanmış veri alanı içinde çalışan bir vekil model oluşturmayı amaçlamaktadır.
N-pentanol neden incelenmiştir?
n-Pentanol, dizelle karışabilen oksijenli bir yüksek alkoldür. Çalışmanın giriş bölümünde n-pentanolün enerji yoğunluğunun etanol ve bütanol gibi daha düşük alkollere göre dizel yakıtına daha yakın olduğu, dizelle iyi karıştığı ve depolama sırasında faz ayrışmasına karşı görece dayanıklı olduğu belirtilmektedir.
Yakıtın kendi moleküler yapısında oksijen bulunması, yakıtça zengin bölgelerde kurum oluşumunu azaltabilecek bir özellik olarak değerlendirilmektedir. Bununla birlikte yüksek n-pentanol oranları, yakıtın tutuşma davranışını, buharlaşmasını, silindir basınç artışını ve yakıt tüketimini de değiştirebilir. Bu nedenle tek bir çıktıyı iyileştirmek yeterli değildir; verim, tüketim, yanma şiddeti ve farklı emisyonların birlikte değerlendirilmesi gerekir.
Literatürde hangi boşluk hedeflenmiştir?
Makalenin literatür değerlendirmesine göre, daha düşük n-pentanol oranlarıyla veya başka biyoyakıt karışımlarıyla makine öğrenmesi uygulamaları bulunmasına rağmen %60 n-pentanol içeren P60D40 karışımının düşük yük koşullarında emme basıncı, emme sıcaklığı ve püskürtme basıncı birlikte değiştirilerek kapsamlı biçimde modellenmesi sınırlıdır.
Araştırmacılar iki temel boşluk tanımlamıştır:
- %60 n-pentanol karışımı için üç kontrol değişkenini ve yedi motor çıktısını birlikte içeren geniş bir düşük yük veri setinin bulunmaması.
- Model eğitimini, karşılaştırmayı, tahmin üretimini ve veri dışa aktarımını aynı ortamda sunan, tek bir sabit veri setine bağlı olmayan gerçek zamanlı karar destek arayüzünün eksikliği.
Makalenin bir bölümünde “altı makine öğrenmesi modeli” ifadesi kullanılmasına rağmen yöntem, tablolar, grafikler ve yazılım arayüzü yalnızca beş modeli tanımlamaktadır. Altıncı bir algoritmanın adı, hiperparametresi veya sonucu verilmemiştir. Bu nedenle çalışmanın fiilen beş model karşılaştırdığı kabul edilmelidir.
CFD veri seti nasıl oluşturulmuştur?
Makine öğrenmesi modellerinin eğitim verisi doğrudan yeni bir motor test kampanyasından değil, CONVERGE v3.0 kullanılarak oluşturulmuş üç boyutlu bir CFD modelinden elde edilmiştir. Model, dört silindirli, dört zamanlı ve elektronik kontrollü bir dizel motoru temsil etmektedir.
Hesaplama maliyetini azaltmak için yanma odasının 45 derecelik sektörü modellenmiştir. Temel hücre boyutu 3 mm olarak belirlenmiş, enjektör nozulu çevresinde ikinci seviye uyarlanabilir ağ inceltmesi uygulanmıştır.
| Fiziksel süreç | Kullanılan model veya yaklaşım |
|---|---|
| Türbülans | RNG k-ε modeli |
| Püskürtme parçalanması | Kelvin-Helmholtz-Rayleigh-Taylor (KH-RT) modeli |
| Yanma kimyası | SAGE ayrıntılı kimyasal çözücüsü |
| Yakıt kimyası | 75 tür ve 367 reaksiyon içeren indirgenmiş n-pentanol/n-dodekan mekanizması |
| Dizel yakıt vekili | n-Dodekan |
| NOx oluşumu | Genişletilmiş Zeldovich modeli |
| Kurum oluşumu | Hiroyasu modeli |
Yazarlar CFD modelinin önceki çalışmalarında deneysel verilerle olumlu uyum gösterdiğini bildirmektedir. Bununla birlikte mevcut makalede yeni bir deneysel doğrulama grafiği veya yeni ham motor testi verisi sunulmamış; önceki doğrulamaya atıf yapılmıştır. Bu nedenle makine öğrenmesinin doğruluğu, temel CFD modelinin doğruluğundan bağımsız değildir.
Motor hangi koşullarda çalıştırılmıştır?
Veri üretimi düşük yük koşulunda gerçekleştirilmiştir:
- Motor devri: 1.500 dev/dak
- İndike ortalama efektif basınç: yaklaşık 3,8 bar
- Toplam yakıt enerjisi: çevrim başına 400 J
- Egzoz gazı devridaimi: %0
- Emme basıncı aralığı: 1,1-1,4 bar
- Emme sıcaklığı aralığı: 343-353 K
- Püskürtme basıncı aralığı: 75-125 MPa
Çevrim başına yakıt enerjisinin 400 J’de sabit tutulması, farklı giriş koşullarının aynı yaklaşık motor yükünde karşılaştırılmasını sağlamayı amaçlamıştır. EGR’nin %0 tutulması ise emme termodinamiğinin etkisini egzoz gazı seyreltmesiyle karıştırmamak için seçilmiştir.
Girişler ve hedef çıktılar nelerdir?
| Tür | Değişken | Birim veya anlam |
|---|---|---|
| Giriş | Emme basıncı | bar |
| Giriş | Emme sıcaklığı | K |
| Giriş | Püskürtme basıncı | MPa |
| Çıktı | İndike termal verim (ITE) | % |
| Çıktı | Eşdeğer indike özgül yakıt tüketimi (EISFC) | g/kWh |
| Çıktı | Yanma çınlama şiddeti (RI) | MW/m² |
| Çıktı | Azot oksitler (NOx) | g/kWh |
| Çıktı | Kurum | g/kWh |
| Çıktı | Karbon monoksit (CO) | g/kWh |
| Çıktı | Karbondioksit (CO2) | g/kWh |
Yanma çınlama şiddeti, silindir içi basıncın çok hızlı yükselmesiyle ilişkili akustik ve mekanik yanma şiddetini temsil etmektedir. Daha yüksek RI değeri, daha sert ve potansiyel olarak daha riskli bir yanma davranışına işaret eder.
Hangi çalışma noktaları veri setinden çıkarılmıştır?
Makine öğrenmesi veri setinin oluşturulması sırasında aşağıdaki sınırları aşan çalışma noktalarının dışlandığı belirtilmektedir:
- EISFC > 240 g/kWh
- NOx > 0,4 g/kWh
- Kurum > 0,01 g/kWh
- RI > 8 MW/m²
Bu filtreleme, modellerin teknik açıdan kabul edilemez görülen çalışma noktalarına değil, önceden belirlenen uygulanabilir bölgeye odaklanmasını sağlamıştır. Ancak bunun önemli bir yorum sınırı vardır: Model, filtrelenen sınırların dışındaki yüksek emisyonlu veya şiddetli yanma koşullarını öğrenmemiş olabilir. Dolayısıyla güvenli çalışma bölgesinin dışına taşan girişler için tahmin güvenilirliği gösterilmemiştir.
Arayüzün veri kayıt ekranında 8 MW/m²’nin veya 0,4 g/kWh NOx değerinin üzerindeki bazı örnekler görünmektedir. Bu ekranın filtrelenmiş P60D40 eğitim veri setini mi yoksa yazılımın veri yükleme işlevini göstermek için kullanılan farklı bir örnek dosyayı mı temsil ettiği açıklanmamıştır.
Makine öğrenmesi-CFD iş akışı nasıl kurulmuştur?
Çalışmanın birinci şekli beş aşamalı bir iş akışı göstermektedir:
- Emme basıncı, emme sıcaklığı ve püskürtme basıncı için sınırların belirlenmesi.
- Bu giriş kombinasyonlarının CFD ile çalıştırılarak motor çıktılarının üretilmesi.
- CFD veri setiyle MLP, RF, XGBoost, SVM ve KNN modellerinin eğitilmesi.
- Tahminlerin CFD sonuçlarıyla R², MAE ve RMSE üzerinden karşılaştırılması.
- Seçilen model ve arayüzle anlık motor performansı ve emisyon tahmini yapılması.
Şekilde ilk çalışma noktalarının oluşturulmasında genetik algoritma ifadesi yer almaktadır. Ancak genetik algoritmanın popülasyon boyutu, amaç fonksiyonu, çaprazlama, mutasyon veya durdurma ölçütleri yöntem bölümünde açıklanmamıştır. Bu nedenle genetik algoritmanın veri noktalarını tam olarak nasıl seçtiği yeniden üretilebilir düzeyde verilmemiştir.
Çok katmanlı algılayıcı sinir ağı nasıl çalışmaktadır?
MLP, üç motor girişini birbirine bağlı gizli katmanlardan geçirerek yedi motor çıktısındaki doğrusal olmayan ilişkileri öğrenmektedir. Bir nöronun çıktısı çalışmada şu biçimde verilmiştir:
\[ MLP = \phi\left(\sum_{j=1}^{n} w_jx_j+b\right) \]
\[ \phi(x)=\max(0,x) \]
Burada xj giriş değişkenini, wj öğrenilen ağırlığı, b sapma terimini ve φ doğrultulmuş doğrusal birim (ReLU) aktivasyonunu göstermektedir. ReLU, negatif değerleri sıfıra dönüştürürken pozitif değerleri korur.
Çalışmada iki gizli katmanın her birinde 100 nöron kullanılmıştır. Modelin en fazla 2.000 yineleme çalışmasına izin verilmiş ve rastgelelik tohumu 42 olarak belirlenmiştir.
Rastgele orman modeli nasıl tahmin üretmektedir?
Rastgele orman, aynı veri setinin farklı örneklem ve değişken alt kümeleriyle çok sayıda karar ağacı kurar. Regresyon tahmini ağaç çıktılarının ortalamasıyla elde edilir:
\[ \hat{y}=\frac{1}{M}\sum_{m=1}^{M}T_m(x) \]
M toplam karar ağacı sayısı, Tm(x) ise m’inci ağacın x girişi için ürettiği tahmindir. Çalışmada 100 ağaç kullanılmıştır. Her yaprak için en az bir örnek, bölünme için en az iki örnek ve bootstrap örneklemesi seçilmiştir.
XGBoost modeli nasıl çalışmaktadır?
XGBoost, karar ağaçlarını birbirinden bağımsız kurmak yerine ardışık biçimde ekler. Her yeni ağaç önceki ağaçların hatalarını azaltmaya çalışır. Amaç fonksiyonu şu biçimde verilmiştir:
\[ L = l(y,\hat{y})+\sum_{k=1}^{K}\Omega(f_k) \]
l(y,\hat{y}) gerçek ve tahmin edilen değer arasındaki kaybı, Ω(fk) ise k’inci ağacın karmaşıklığını cezalandıran düzenlileştirme terimini temsil eder. Böylece yalnızca eğitim hatasını azaltan değil, gereksiz derecede karmaşıklaşmayan bir model amaçlanır.
Çalışmada kare hata regresyon amacı, 0,3 öğrenme oranı ve 100 ağaç kullanılmıştır.
Destek vektör makinesi nasıl kullanılmıştır?
SVM, girdiler ile hedef çıktılar arasındaki ilişkiyi belirli bir hata toleransı içinde yaklaşık olarak tanımlayan bir regresyon yüzeyi oluşturur. Makalede doğrusal çekirdek için şu temel ilişki verilmiştir:
\[ F(X_i,X_j)=X_i\cdot X_j \]
Xi ve Xj giriş vektörleridir. Ancak gerçek modelde doğrusal çekirdek yerine radyal tabanlı fonksiyon (RBF) çekirdeği kullanılmıştır. RBF çekirdeği doğrusal olmayan motor davranışlarını temsil edebilir.
SVM için C = 1, ε = 0,1 ve gamma = “scale” olarak bırakılmıştır.
K-en yakın komşu tahmini nasıl yapılmıştır?
KNN, yeni bir motor koşulunu eğitim verisindeki en benzer çalışma noktalarıyla karşılaştırır ve komşu çıktıların ağırlıklı ortalamasını kullanır:
\[ \hat{y}_i=\sum_{j=1}^{k}w_{ij}y_{ij} \]
\[ \sum_{j=1}^{k}w_{ij}=1 \]
yij i’inci yeni örneğin j’inci en yakın komşusundaki gözlenen çıktı, wij ise o komşuya verilen ağırlıktır. Çalışmada k = 5 seçilmiş ve yaprak boyutu 30 olarak belirlenmiştir.
Model eğitimi nasıl gerçekleştirilmiştir?
Toplam 431 veri örneğinin %80’i eğitim ve %20’si test için rastgele ayrılmıştır. Bu oran yaklaşık olarak 345 eğitim ve 86 test örneğine karşılık gelmektedir; PDF tam sayı dağılımını ayrıca vermemektedir.
Giriş ve hedef değişkenlerinin ölçekleri birbirinden büyük ölçüde farklıdır. Örneğin emme basıncı 1,1-1,4 aralığında, püskürtme basıncı 75-125 MPa aralığında, kurum ise binde birler düzeyindedir. Ölçek farkının öğrenmeyi yönlendirmemesi için bütün girişler ve hedefler standartlaştırılmıştır.
Ölçekleyicinin yalnızca eğitim verisine uydurulması, test verisinin ortalama veya standart sapma bilgisinin eğitim aşamasına sızmasını önlemeyi amaçlamaktadır.
Hiperparametreler nelerdir?
| Model | Hiperparametre | Değer |
|---|---|---|
| RF | Ağaç sayısı | 100 |
| RF | random_state | 42 |
| RF | min_samples_split | 2 |
| RF | min_samples_leaf | 1 |
| RF | bootstrap | True |
| XGBoost | Amaç fonksiyonu | reg:squarederror |
| XGBoost | Öğrenme oranı | 0,3 |
| XGBoost | Ağaç sayısı | 100 |
| MLP | Gizli katman boyutları | (100, 100) |
| MLP | Azami yineleme | 2.000 |
| MLP | Aktivasyon | ReLU |
| MLP | random_state | 42 |
| KNN | Komşu sayısı | 5 |
| KNN | Yaprak boyutu | 30 |
| SVM | Çekirdek | RBF |
| SVM | ε | 0,1 |
| SVM | C | 1 |
| SVM | Gamma | scale |
Makale hiperparametrelerin “titizlikle ayarlandığını” ifade etse de kapsamlı bir grid search, random search, Bayes optimizasyonu veya çapraz doğrulama sonuçları sunmamaktadır. Birçok parametrenin varsayılan değerde bırakıldığı belirtilmiştir. Dolayısıyla model karşılaştırması, her algoritmanın ulaşabileceği mutlak en iyi yapıdan çok seçilen belirli yapılandırmaların karşılaştırmasıdır.
R², MAE ve RMSE neyi ölçmektedir?
Model performansı üç ölçütle değerlendirilmiştir.
Belirleme katsayısı
PDF’de Denklem 6 şu biçimde dizilmiştir:
\[ R^2=1-\frac{\sum_{k=1}^{N}(y_k-\hat{y}_k)}{\sum_{k=1}^{N}(y_k-\bar{y})} \]
Dizgi uyarısı: Basılı denklemde farkların kareleri görünmemektedir. Bu biçim, metinde açıklanan standart R² tanımıyla uyumlu değildir. Çalışmanın mantığını açıklamak için standart ilişki şu biçimde düşünülür:
\[ R^2=1-\frac{\sum_{k=1}^{N}(y_k-\hat{y}_k)^2}{\sum_{k=1}^{N}(y_k-\bar{y})^2} \]
yk gerçek değer, ŷk model tahmini, ȳ gerçek değerlerin ortalaması ve N örnek sayısıdır. R²’nin 1’e yaklaşması, modelin veri değişkenliğinin daha büyük bölümünü açıkladığını gösterir.
Ortalama mutlak hata
\[ MAE=\frac{1}{n}\sum_{k=1}^{n}|y_k-\hat{y}_k| \]
MAE, bütün tahmin hatalarının mutlak büyüklüğünü ortalar. Hedef değişken hangi birimdeyse MAE de aynı birimdedir.
Kök ortalama kare hata
PDF’de Denklem 8 şu biçimde görünmektedir:
\[ RMSE=\sqrt{\frac{1}{N}(y_k-\hat{y}_k)^2} \]
Dizgi uyarısı: Denklemde örnekler üzerindeki toplam sembolü görünmemektedir. Metindeki RMSE tanımını açıklamak için standart biçim şöyledir:
\[ RMSE=\sqrt{\frac{1}{N}\sum_{k=1}^{N}(y_k-\hat{y}_k)^2} \]
Hatalar kareye alındığı için RMSE büyük hataları MAE’ye göre daha güçlü biçimde cezalandırır.
Hangi model en başarılı olmuştur?
MLP, yedi hedefin beşinde en yüksek R² değerini vermiştir. SVM ise yanma çınlama şiddeti ve NOx için bazı ölçütlerde küçük bir üstünlük sağlamıştır.
| Hedef | En yüksek R² veren model | R² | MAE | RMSE |
|---|---|---|---|---|
| ITE | MLP | 0,9491 | 0,0750 | 0,0970 |
| EISFC | MLP | 0,9439 | 0,2895 | 0,3763 |
| RI | SVM | 0,8959 | 0,7376 | 1,1006 |
| NOx | SVM | 0,8856 | 0,0374 | 0,0604 |
| Kurum | MLP | 0,9513 | 0,0002 | 0,0002 |
| CO | MLP | 0,9612 | 0,5269 | 0,7425 |
| CO2 | MLP | 0,8983 | 1,5484 | 2,1746 |
RI için SVM’nin R² ve RMSE değerleri MLP’den az farkla daha iyidir; ancak MLP’nin MAE değeri 0,7106 ile SVM’nin 0,7376 değerinden daha düşüktür. Bu nedenle RI için hangi modelin “en iyi” olduğu seçilen ölçüte bağlıdır.
NOx için SVM üç ölçütte de MLP’den daha iyi sonuç vermiştir: R² değeri 0,8856’ya karşı 0,8791, MAE değeri 0,0374’e karşı 0,0398 ve RMSE değeri 0,0604’e karşı 0,0621’dir.
Diğer modeller nasıl performans göstermiştir?
| Model | ITE R² | EISFC R² | RI R² | NOx R² | Kurum R² | CO R² | CO2 R² |
|---|---|---|---|---|---|---|---|
| RF | 0,9263 | 0,9273 | 0,8231 | 0,8032 | 0,9117 | 0,9465 | 0,8772 |
| XGBoost | 0,9009 | 0,9041 | 0,8331 | 0,8210 | 0,9315 | 0,9481 | 0,8600 |
| MLP | 0,9491 | 0,9439 | 0,8953 | 0,8791 | 0,9513 | 0,9612 | 0,8983 |
| KNN | 0,8914 | 0,8910 | 0,8476 | 0,8550 | 0,9412 | 0,9446 | 0,8718 |
| SVM | 0,9327 | 0,9323 | 0,8959 | 0,8856 | 0,9305 | 0,9340 | 0,8966 |
Rastgele orman verim ve tüketimde güçlü sonuç üretmiş, ancak NOx tahmininde R² = 0,8032 ile MLP ve SVM’nin gerisinde kalmıştır. XGBoost kurum ve CO için güçlü olmasına rağmen MLP’yi geçememiştir. KNN’nin verim ve tüketim R² değerleri yaklaşık 0,89 düzeyinde kalmış; araştırmacılar genel tahmin yeteneğinin diğer modellere göre daha sınırlı olduğunu değerlendirmiştir.
Tahmin-gerçek grafiklerinde hangi eğilimler görülmektedir?
MLP için çizilen yedi tahmin-gerçek grafiğinde ideal tahmin, noktaların 45 derecelik doğru üzerinde toplanmasıyla temsil edilmektedir. İndike termal verim, yakıt tüketimi, kurum ve CO noktaları bu doğru çevresinde görece sıkı biçimde kümelenmiştir.
Yanma çınlama şiddeti ve NOx grafiklerinde özellikle yüksek gerçek değerlerde saçılma artmaktadır. Bu görsel eğilim, bu iki değişkenin daha düşük R² ve daha yüksek göreli hatalara sahip olmasıyla uyumludur.
CO2 grafiğinde genel doğrusal eğilim korunmakla birlikte bazı düşük değerli örnekler tahmin doğrusundan daha fazla uzaklaşmıştır. Grafikteki kırmızı gölgeli bantların istatistiksel olarak güven aralığı mı, tahmin aralığı mı veya yalnızca regresyon görselleştirmesi mi olduğu metinde açıklanmamıştır.
Web arayüzü nasıl çalışmaktadır?
Çalışmada Python ve Django ile web tabanlı bir grafik kullanıcı arayüzü geliştirilmiştir. Sistem mimarisinde şu işlem akışı yer almaktadır:
- Kullanıcı kimlik doğrulaması.
- Yönetici yetkisi varsa kullanıcı hesabı oluşturma, güncelleme veya görüntüleme.
- CSV veya XLSX veri seti yükleme, görüntüleme veya silme.
- Giriş özellikleri ve hedef sütunlarının dinamik olarak okunması.
- Eğitim-test oranının kullanıcı tarafından seçilmesi.
- Beş makine öğrenmesi modelinin yeniden eğitilmesi.
- R², MAE ve RMSE sonuçlarının hesaplanması.
- Tahmin-gerçek grafiklerinin yüklenmesi.
- Belirli girişler için anlık tahmin üretilmesi.
- Sonuçların CSV dosyası olarak dışa aktarılması.
Yükleme sistemi .csv ve .xlsx biçimlerini kabul etmekte ve dosya büyüklüğünü 10 MB ile sınırlamaktadır. Kullanıcı yüklenen veri setini tablo biçiminde önizleyebilmekte, modellerin hata ölçütlerini görebilmekte ve sonuç grafiklerini dışa aktarabilmektedir.
“Veri setinden bağımsız” ne anlama gelmektedir?
Çerçevenin veri setinden bağımsız olması, yazılımın yalnızca P60D40 veri sütunlarına sabitlenmemesi anlamına gelmektedir. Kullanıcı yeni bir dosya yüklediğinde sistem sütunları dinamik biçimde okuyabilmekte, giriş ve hedef alanlarını seçebilmekte ve modelleri yeniden eğitebilmektedir.
Ancak makalenin tahmin doğruluğu yalnızca 431 örnekli tek P60D40 veri setinde ölçülmüştür. Farklı motor, yakıt, yük, sensör veya kurumlara ait bağımsız veri setleriyle karşılaştırmalı bir genelleme deneyi sunulmamıştır. Bu nedenle “veri setinden bağımsızlık”, doğrulanmış evrensel model doğruluğundan çok yazılım mimarisinin esnekliğini ifade etmektedir.
Güvenlik ve kullanıcı yetkilendirmesi nasıl ele alınmıştır?
Sistem, doğrulanmış kullanıcıların giriş yapmasını gerektiren bir kimlik doğrulama mekanizması içermektedir. Yalnızca yöneticiler kullanıcı hesaplarını yönetebilmektedir. Giriş yapan araştırmacılar analiz paneline yönlendirilmekte ve veri seti işlemlerini gerçekleştirebilmektedir.
Bununla birlikte makalede parola saklama yöntemi, şifreleme, erişim günlüğü, saldırı testi, rol tabanlı yetki matrisi veya veri gizliliği denetimi hakkında teknik güvenlik testi verilmemiştir. “Güvenli” nitelemesi arayüzde kimlik doğrulama ve yönetici yetkisi bulunmasına dayanmaktadır.
En uygun çalışma noktası nasıl belirlenmiştir?
Model optimizasyon arayüzünde en uygun olarak sunulan motor girişleri şunlardır:
- Emme basıncı: 1,2 bar
- Emme sıcaklığı: 353 K
- Püskürtme basıncı: 125 MPa
Bu koşulda CFD simülasyonu ve beş modelin tahminleri aşağıdaki gibidir:
| Hedef çıktı | CFD simülasyonu | RF | MLP | SVM | XGBoost | KNN |
|---|---|---|---|---|---|---|
| ITE (%) | 47,68 | 47,6003 | 47,6622 | 47,4706 | 47,5978 | 47,5220 |
| EISFC (g/kWh) | 170,83 | 171,1014 | 171,0043 | 171,5918 | 170,9177 | 171,3840 |
| RI (MW/m²) | 4,8609 | 5,2923 | 5,2824 | 5,2817 | 5,9876 | 5,0680 |
| NOx (g/kWh) | 0,29 | 0,2477 | 0,2309 | 0,2103 | 0,2448 | 0,2100 |
| Kurum (g/kWh) | 0,0052 | 0,0052 | 0,0054 | 0,0053 | 0,0056 | 0,0054 |
| CO (g/kWh) | 16,48 | 16,9377 | 16,6609 | 17,3225 | 17,4381 | 17,5120 |
| CO2 (g/kWh) | 279,38 | 279,1731 | 279,1059 | 277,5332 | 280,3731 | 277,6280 |
MLP bu çalışma noktasında CFD’ye ne kadar yaklaşmıştır?
| Hedef | MLP-CFD mutlak farkı | CFD değerine göre yaklaşık göreli fark |
|---|---|---|
| ITE | 0,0178 yüzde puanı | %0,04 |
| EISFC | 0,1743 g/kWh | %0,10 |
| RI | 0,4215 MW/m² | %8,67 |
| NOx | 0,0591 g/kWh | %20,38 |
| Kurum | 0,0002 g/kWh | %3,85 |
| CO | 0,1809 g/kWh | %1,10 |
| CO2 | 0,2741 g/kWh | %0,10 |
Bu karşılaştırma MLP’nin ITE, EISFC, CO ve CO2 için CFD’ye çok yakın tahmin verdiğini göstermektedir. Kurum değerindeki mutlak fark çok küçük olmakla birlikte taban değer de çok küçük olduğu için göreli fark yaklaşık %3,85’tir.
RI değeri yaklaşık %8,67 yüksek tahmin edilmiş, NOx ise yaklaşık %20,38 düşük tahmin edilmiştir. Dolayısıyla modelin “bütün çıktılarda %1-2 sapmayla” çalıştığı söylenemez.
Sonuç bölümünde ITE, EISFC, kurum, CO ve CO2 tahminlerinin %1-2 sapmayla uyuştuğu belirtilmektedir. Tablo 5’e göre ITE, EISFC ve CO2 farkları %1’in çok altındadır, CO yaklaşık %1,10’dur, fakat kurumun göreli farkı yaklaşık %3,85’tir. Bu nedenle metinsel genelleme ile tablodaki kurum değeri arasında küçük bir uyumsuzluk bulunmaktadır.
Radar grafik ne göstermektedir?
Model performansının aynı çalışma koşulundaki radar grafiğinde simülasyon, MLP, RF, SVM, XGBoost ve KNN aynı yedi eksende karşılaştırılmıştır. MLP eğrisi ITE, EISFC, kurum, CO ve CO2 eksenlerinde simülasyon şekline yakın görünmektedir.
NOx ve RI eksenlerinde modeller arasındaki ayrışma daha belirgindir. Ancak radar grafiğindeki her eksen farklı birim ve farklı ölçek kullandığından, çokgen alanı tek başına genel başarı ölçütü olarak yorumlanmamalıdır. Sayısal tablo ve ayrı hata ölçütleri daha güvenilir karşılaştırma sunmaktadır.
Önceki çalışmanın sonuçlarıyla mevcut model arasındaki ayrım
Özet bölümünde %47,68 ITE, %98,76 NOx azalması ve Euro VI uygunluğu ifadeleri yer almaktadır. Ancak mevcut makalede %98,76 NOx azalmasını yeniden hesaplayan bir temel dizel karşılaştırma tablosu sunulmamaktadır. Bu değerler yazarların önceki P60D40 optimizasyon çalışmasının bulguları olarak aktarılmaktadır.
Mevcut çalışmanın doğrudan katkısı, daha önce oluşturulan CFD veri alanını makine öğrenmesi modellerine dönüştürmek ve web arayüzünde hızlı tahmin üretmektir. Bu nedenle önceki çalışmanın emisyon azaltımı, mevcut makine öğrenmesi modelinin bağımsız deneysel emisyon başarısı olarak sunulmamalıdır.
Ayrıca veri seti oluşturulurken Euro VI veya pratik sınırları aşan çalışma noktalarının dışlanması, geriye kalan tahmin bölgesinin uyumlu koşullardan oluşmasını sağlamaktadır. Bu yöntem, motorun her koşulda Euro VI standardını karşıladığını tek başına kanıtlamaz.
Çalışmanın güçlü yönleri nelerdir?
- Üç kontrol değişkeninden yedi motor çıktısını aynı çerçevede tahmin etmektedir.
- Sinir ağı, ağaç tabanlı, çekirdek tabanlı ve komşuluk tabanlı beş farklı algoritmayı karşılaştırmaktadır.
- Veri sızıntısını azaltmak için ölçekleyicinin yalnızca eğitim verisine uydurulduğu belirtilmiştir.
- Model sonuçları yalnızca R² ile değil, MAE ve RMSE ile de değerlendirilmiştir.
- CFD ve model tahminleri aynı çalışma noktasında doğrudan karşılaştırılmıştır.
- Veri yükleme, model eğitme, grafik görüntüleme ve CSV dışa aktarma işlevleri tek web arayüzünde birleştirilmiştir.
- Yazılım, giriş ve hedef sütunlarını dinamik olarak okuyabilecek biçimde tasarlanmıştır.
- Çalışma, MLP’nin genel üstünlüğünün yanında SVM’nin RI ve NOx için daha iyi olduğu durumları da açıkça bildirmiştir.
Çalışmanın sınırlılıkları nelerdir?
- Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir.
- Makine öğrenmesi verileri yeni bağımsız motor deneylerinden değil, CFD simülasyonlarından üretilmiştir.
- CFD doğrulamasının ayrıntıları mevcut makalede yeniden gösterilmemiş, önceki çalışmaya yönlendirme yapılmıştır.
- Veri seti yalnızca 431 örnek içermektedir.
- Çalışma yalnızca 1.500 dev/dak, yaklaşık 3,8 bar IMEP ve düşük yük koşulunu kapsamaktadır.
- EGR yalnızca %0’dır; farklı EGR oranları öğrenilmemiştir.
- Yakıt bileşimi sabit P60D40’tır; model farklı n-pentanol oranlarında doğrulanmamıştır.
- Üç giriş değişkeni dışında püskürtme zamanlaması, püskürtme sayısı, yük ve motor devri model girdisi değildir.
- Veri alanı dışındaki giriş kombinasyonlarında tahmin güvenilirliği değerlendirilmemiştir.
- Uygunsuz çalışma noktalarının eğitimden çıkarılması, modelin sınır dışı koşulları tanıma yeteneğini azaltabilir.
- Yalnızca tek bir rastgele %80-%20 ayırma kullanılmıştır; k-katlı çapraz doğrulama veya çoklu rastgele bölme sonucu verilmemiştir.
- Hiperparametre aramasının kapsamı ayrıntılı olarak sunulmamıştır.
- Model belirsizliği, tahmin aralığı veya güven sınırı nicel biçimde raporlanmamıştır.
- Farklı araştırma gruplarından alınan dış veri setleriyle dataset-agnostic performans doğrulanmamıştır.
- Gerçek motor kontrol ünitesi, sensör akışı, donanım döngüsü veya kapalı çevrim kontrol deneyi yapılmamıştır.
- NOx ve RI tahminleri, en uygun noktada diğer çıktılara göre daha yüksek göreli fark göstermiştir.
- R² ve RMSE denklemlerinin basılı biçimlerinde matematiksel dizgi eksiklikleri bulunmaktadır.
- Metinde bir yerde altı model denmesine rağmen yalnızca beş model sunulmuştur.
Çalışmanın desteklediği sonuçlar
- Seçilen P60D40 CFD veri alanında beş makine öğrenmesi modeli yedi motor çıktısını kullanılabilir doğrulukta tahmin edebilmiştir.
- MLP, hedeflerin çoğunda en yüksek R² ve düşük hata değerleriyle genel olarak en güçlü model olmuştur.
- SVM, NOx tahmininde MLP’den daha iyi sonuç vermiştir.
- 1,2 bar, 353 K ve 125 MPa koşulunda MLP; ITE, EISFC, CO ve CO2 için CFD’ye yakın tahmin üretmiştir.
- Makine öğrenmesi modeli, yeni CFD çalıştırmasına kıyasla eğitildikten sonra daha hızlı tahmin üretebilir.
- Python/Django arayüzü veri yükleme, yeniden eğitim, model karşılaştırma ve sonuç dışa aktarma işlevlerini bir araya getirmiştir.
Çalışmanın kanıtlamadığı sonuçlar
- Modelin bütün sıkıştırma ateşlemeli motorlarda geçerli olduğu gösterilmemiştir.
- Çerçevenin bütün yakıt karışımlarında aynı doğruluğu koruduğu kanıtlanmamıştır.
- Gerçek zamanlı motor kontrol ünitesinde kapalı çevrimli optimizasyon gerçekleştirilmemiştir.
- Makine öğrenmesi modeli fiziksel deney veya CFD ihtiyacını tamamen ortadan kaldırmamaktadır.
- Modelin eğitim aralığı dışındaki çalışma noktalarında güvenli tahmin verdiği gösterilmemiştir.
- %60 n-pentanolün bütün yük ve devirlerde dizelden daha verimli veya daha temiz olduğu kanıtlanmamıştır.
- Mevcut çalışma tek başına %98,76 NOx azalmasını yeniden doğrulamamıştır.
- Filtrelenen veri seti, motorun her olası çalışma koşulunda Euro VI uyumu sağladığını göstermemektedir.
- Web arayüzündeki kullanıcı girişi, kapsamlı siber güvenlik doğrulaması anlamına gelmemektedir.
Gelecekteki olası etkisi nedir?
Bu tür vekil modeller, alternatif yakıt geliştirme sürecinde binlerce olası çalışma noktasının önce hızlı biçimde taranmasını sağlayabilir. En umut verici bölgeler daha sonra yüksek çözünürlüklü CFD veya motor testleriyle doğrulanabilir. Böylece pahalı deneylerin tüm tasarım alanına eşit biçimde dağıtılması yerine daha hedefli kullanılması mümkün olabilir.
Çalışmanın kendi gelecek planı, veri setini daha yüksek yük koşullarını içerecek şekilde genişletmek ve arayüze otomatik optimizasyon algoritmaları eklemektir. Buna ek olarak farklı motor devri, EGR oranı, püskürtme zamanlaması, çoklu püskürtme stratejisi ve farklı n-pentanol oranları modele dâhil edilirse daha kapsamlı bir kalibrasyon aracı oluşturulabilir.
Gerçek uygulamaya geçiş için modelin bağımsız motor deneyleri, farklı araştırma kurumlarının veri setleri, belirsizlik analizi ve motor kontrol donanımıyla çevrim içi test edilmesi gerekir.
Çalışmanın Yöntemi ve Bulguları
Teknik yöntem özeti
| Teknik unsur | Uygulanan yöntem |
|---|---|
| Yakıt | %60 n-pentanol/%40 dizel; CFD’de dizel vekili olarak n-dodekan |
| Motor | Dört silindirli, dört zamanlı, elektronik kontrollü sıkıştırma ateşlemeli motor |
| Çalışma koşulu | 1.500 dev/dak, yaklaşık 3,8 bar IMEP, düşük yük |
| Yakıt enerjisi | 400 J/çevrim |
| EGR | %0 |
| CFD yazılımı | CONVERGE v3.0 |
| Geometri | 45° yanma odası sektör modeli |
| Temel ağ boyutu | 3 mm |
| Nozul ağ inceltmesi | Seviye 2 uyarlanabilir inceltme |
| Kimyasal mekanizma | 75 tür, 367 reaksiyon |
| Girişler | Emme basıncı, emme sıcaklığı, püskürtme basıncı |
| Hedefler | ITE, EISFC, RI, NOx, kurum, CO, CO2 |
| Veri sayısı | 431 örnek |
| Eğitim-test ayrımı | %80-%20 rastgele hold-out |
| Modeller | MLP, RF, XGBoost, SVM, KNN |
| Değerlendirme | R², MAE, RMSE |
| Arayüz | Python/Django web uygulaması |
| Dosya desteği | CSV ve XLSX, en fazla 10 MB |
Temel bulguların özeti
| Bulgular | Sayısal sonuç | Yorum sınırı |
|---|---|---|
| ITE tahmini | MLP R² = 0,9491 | Yalnızca mevcut düşük yük CFD veri alanı için |
| EISFC tahmini | MLP R² = 0,9439 | Farklı yüklar test edilmemiştir |
| RI tahmini | SVM R² = 0,8959; MLP R² = 0,8953 | En uygun noktada MLP yaklaşık %8,67 yüksek tahmin vermiştir |
| NOx tahmini | SVM R² = 0,8856 | En uygun noktada bütün modeller CFD NOx değerini düşük tahmin etmiştir |
| Kurum tahmini | MLP R² = 0,9513 | Mutlak değerlerin çok küçük olması göreli hatayı büyütebilir |
| CO tahmini | MLP R² = 0,9612 | Çalışmanın en yüksek R² sonucudur |
| CO2 tahmini | MLP R² = 0,8983 | Diğer güçlü hedeflere göre daha düşük açıklama gücü |
| En uygun giriş | 1,2 bar, 353 K, 125 MPa | Otomatik çok amaçlı optimizasyon ayrıntıları verilmemiştir |
| CFD’ye en yakın MLP çıktıları | ITE, EISFC, CO ve CO2 | RI ve NOx farkları daha büyüktür |
| Yazılım çerçevesi | Dinamik veri yükleme ve yeniden eğitim | Dış veri setleriyle doğruluk testi yapılmamıştır |
Teknik sonuçlar birlikte değerlendirildiğinde MLP, genel motor performansı ve emisyon tahmini için en dengeli model olarak öne çıkmaktadır. Bununla birlikte bütün hedeflerde aynı algoritmayı kullanmak zorunlu değildir. NOx için SVM, kurum ve CO için MLP gibi hedefe özgü model seçimi daha doğru bir yaklaşım olabilir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: A dataset-agnostic machine learning framework for real-time optimization of 60% n-Pentanol/diesel combustion in compression ignition engines
Yazarlar ve PDF’deki sıraları: Sunday B. Ogunjide; Wenjun Zhong; Omolayo Abegunde; Tamilselvan Pachiannan; Oluropo F. Dairo; Sunday A. Salimon; Olubunmi F. Atilola; Zhixia He; Qian Wang.
Eş birinci yazar veya eş katkı: PDF’de belirtilmemiştir.
Sorumlu yazar: Wenjun Zhong.
Kurumsal bağlantılar:
- School of Energy and Power Engineering, Jiangsu University, Zhenjiang 212013, Çin.
- Department of Electrical and Electronic Engineering, Redeemer’s University, Ede 232102, Nijerya.
- Department of Computer Engineering, Redeemer’s University, Ede 232102, Nijerya.
- Hangzhou International Innovation Institute, Beihang University, Hangzhou 311115, Çin.
- Institute for Energy Research, Jiangsu University, Zhenjiang 212013, Çin.
Yazar-kurum eşleşmeleri: Sunday B. Ogunjide: Jiangsu University ve Redeemer’s University; Wenjun Zhong: Jiangsu University; Omolayo Abegunde: Redeemer’s University Department of Computer Engineering; Tamilselvan Pachiannan: Beihang University Hangzhou International Innovation Institute; Oluropo F. Dairo, Sunday A. Salimon ve Olubunmi F. Atilola: Redeemer’s University; Zhixia He: Jiangsu University School of Energy and Power Engineering ile Institute for Energy Research; Qian Wang: Jiangsu University.
DOI: 10.2139/ssrn.6945187
Dergi: Hakemli bir dergi adı veya kabul bilgisi bu PDF sürümünde belirtilmemiştir.
Yayın platformu: SSRN.
Özgün yayınevi: Hakemli dergi yayınevi bilgisi doğrulanmamıştır. SSRN, Elsevier’in preprint platformudur; bu durum dergide yayımlanmış makale statüsü anlamına gelmez.
Belge yılı: 2026. Kesin resmî SSRN gönderim günü PDF üzerinden doğrulanamamıştır.
Hakemlik durumu: Bu çalışma bir preprinttir ve hakem değerlendirmesinden geçmemiştir.
Kaynak türü: CFD ile üretilmiş veriler üzerinde makine öğrenmesi karşılaştırması, optimizasyon ve web tabanlı karar destek yazılımı geliştiren preprint araştırma makalesi.
Resmî SSRN bağlantısı:https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6945187
DOI bağlantısı:https://doi.org/10.2139/ssrn.6945187
Bu Türkçe makale, yüklenen 32 sayfalık PDF’nin metni, denklemleri, tabloları, model grafikleri, akış diyagramları ve yazılım arayüzü görselleri incelenerek hazırlanmıştır. PDF dışında yeni bir motor deneyi, emisyon sonucu, klinik veya ticari başarı iddiası eklenmemiştir. Dış doğrulama yalnızca DOI, SSRN kaydı, platform ve hakemlik durumunun bibliyografik kontrolü için kullanılmıştır.
Çalışmanın temel yöntemsel sınırları; eğitim verilerinin CFD’den üretilmesi, tek motor-yakıt-yük alanına odaklanılması, dış veri seti doğrulamasının bulunmaması, tek bir eğitim-test bölünmesi kullanılması, model belirsizliğinin raporlanmaması ve gerçek motor donanımında kapalı çevrimli kontrol gösterilmemesidir.
Metinde “altı model” denmesine rağmen yalnızca beş model sunulması, R² ve RMSE denklemlerindeki dizgi eksiklikleri ve sonuç bölümündeki %1-2 sapma ifadesinin kurum tahminiyle tam örtüşmemesi, çalışmayı yorumlarken dikkate alınması gereken belge içi tutarsızlıklardır.
Preprint uyarısı: Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; sonuçları bu sınırlılık dikkate alınarak okunmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir