

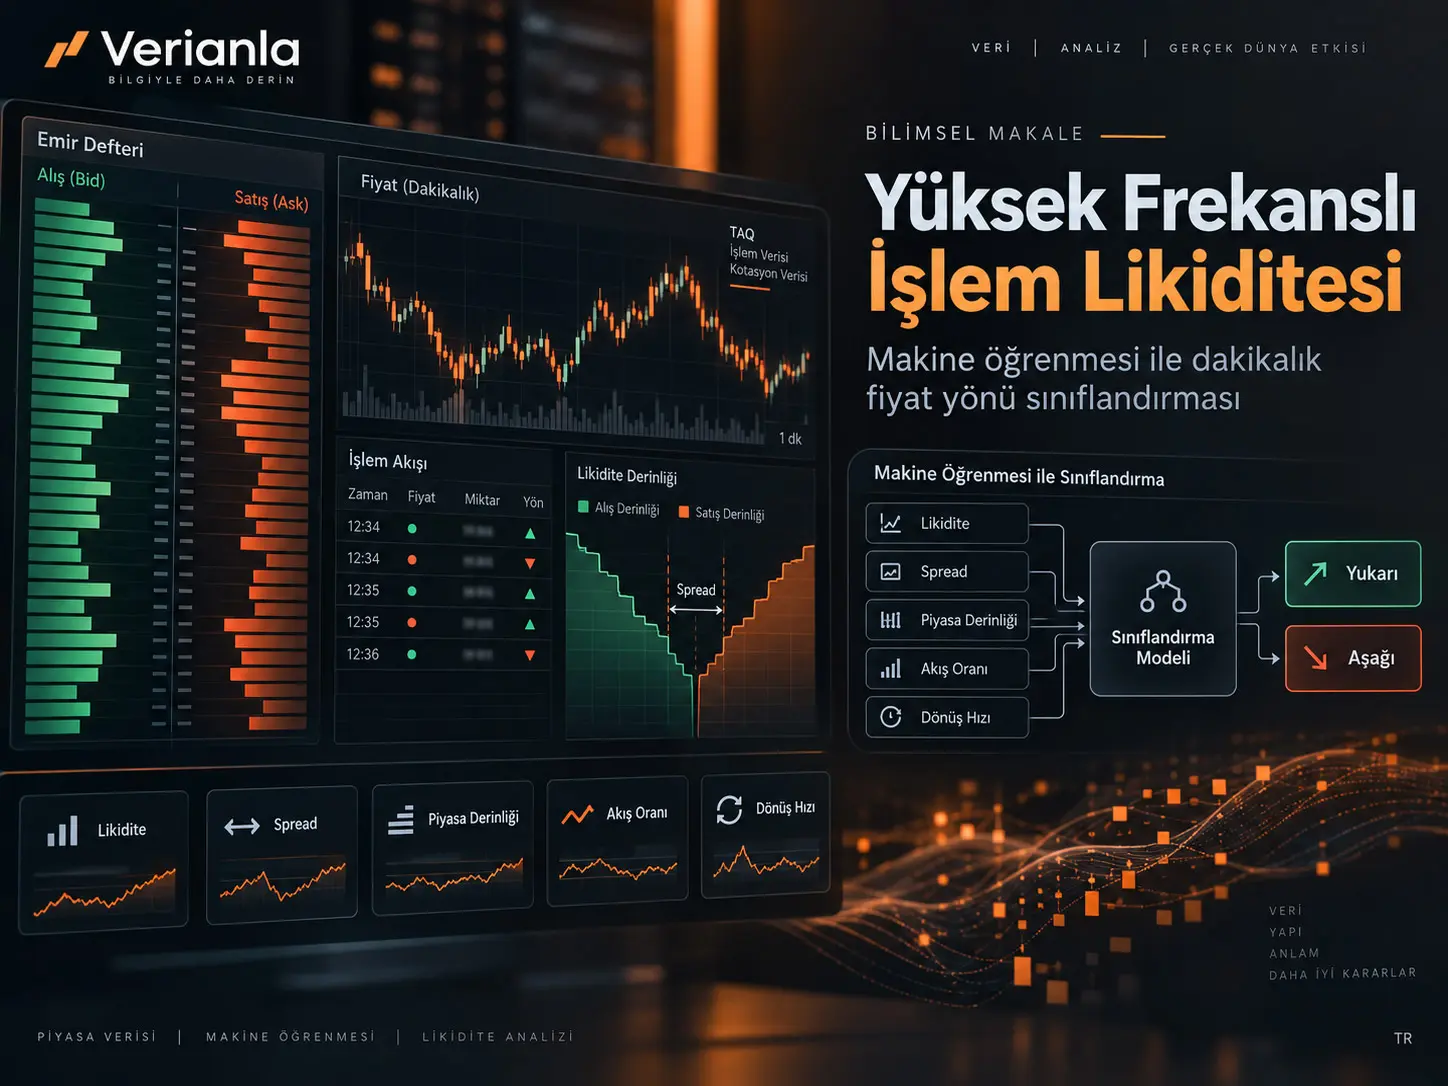
Bu çalışma, yüksek frekanslı finansal verilerden türetilen likidite ölçütlerini kullanarak dakikalık fiyat hareketinin yönünü “Up” veya “Down” olarak sınıflandırmayı incelemektedir. Çalışmanın tahmin çerçevesi, Refinitiv Tick History içindeki Trade and Quote (TAQ) verisinden dakika düzeyinde oluşturulan likidite değişkenlerini Lojistik Regresyon (LR), Destek Vektör Makinesi (SVM) ve Random Forest (RF) sınıflandırıcılarına girdi olarak veren bir makine öğrenmesi yaklaşımıdır. Veri 11:00-16:00 arasına sınırlandırılmış, 1 dakikalık örnekleme dönüştürülmüş ve kaynakta ticker başına günlük yaklaşık 300 gözlem elde edildiği belirtilmiştir. Tüm özelliklerle bildirilen doğruluklar LR için %62,75, SVM için %62,79 ve RF için %60,78; seçilmiş özellik kombinasyonuyla ise sırasıyla %54,90, %50,98 ve %62,74'tür. Bununla birlikte kaynakta tablo, karışıklık matrisi ve sonuç metni arasında bazı iç tutarsızlıklar bulunduğu için model üstünlüğü hakkında tek ve koşulsuz bir hüküm vermek doğru değildir.
Yazarların özellik önemine ilişkin yorumunda Liquidity Ratio, Flow Ratio ve Turnover en etkili likidite ölçütleri arasında öne çıkmaktadır. Çalışma, kısa zaman aralığındaki yön tahmininin çok sayıda likidite boyutundan yararlanabileceğini savunur; ancak kullanılan hisselerin kimliği, tarih aralığı, toplam örneklem büyüklüğü, sınıf dengesi, SVM çekirdeği, Random Forest hiperparametreleri, özellik seçimi algoritması ve ayrıntılı hedef etiketleme kuralı raporlanmadığı için sonuçların yeniden üretilebilirliği ve farklı piyasalara genellenebilirliği sınırlıdır.
Araştırma problemi: likiditeyi tek bir sayı yerine çok boyutlu bir sinyal olarak ele almak
Finansal piyasa likiditesi, bir varlığın işlem maliyetini ve fiyat etkisini sınırlı tutarak alınıp satılabilmesiyle ilişkili çok boyutlu bir piyasa özelliğidir. Kaynak çalışma likiditeyi yalnız tek bir spread veya derinlik göstergesine indirgemek yerine; tightness, depth, resiliency ve trading dynamics gibi farklı piyasa özelliklerinden türetilen ölçütlerin birlikte değerlendirilmesini temel alır. Araştırmanın ana sorusu, bu çoklu likidite göstergelerinin kısa zaman aralıklarındaki fiyat yönünü sınıflandırmak için anlamlı girdiler sağlayıp sağlamadığıdır.
Çalışma daha önceki likidite kümelendirme ve nadir olay araştırmalarına dayanarak, yüksek frekanslı veri üzerinde likidite riskini anlamaya ve fiyat hareketleri için öngörücü modeller geliştirmeye yönelir. Literatür bölümünde Brexit gibi makroekonomik veya siyasi şokların likidite üzerindeki etkisi, Zonoid depth işlevleriyle nadir olay tespiti, yüksek frekanslı veride likidite kümelendirmesi ve çok boyutlu likidite analizi örnekleri tartışılır. Bu literatür çerçevesi çalışmanın doğrudan test ettiği yeni bir jeopolitik olay anlamına gelmez; yalnızca likiditenin dış şoklara duyarlı ve tek boyutlu olmayan bir piyasa özelliği olduğunu gerekçelendirmek için kullanılır.
Likidite Ölçütleri Fiyat Yönü Tahmininde Nasıl Kullanılıyor?
Çalışmada likidite ölçütleri, her 1 dakikalık zaman dilimi için TAQ verisinden türetilen bağımsız değişkenler olarak kullanılır; bu değişkenler Lojistik Regresyon, SVM ve Random Forest modellerine verilerek fiyat hareketi yönü “Up” veya “Down” sınıfına atanır. Kaynak, dakika içindeki ilk trade kaydını ve o dakikadaki tüm quote kayıtlarını toplar; ortalama kotasyon alış ve satış fiyatları ile kotasyon büyüklüklerini hesaplar ve bunlardan oluşturulan likidite göstergelerini sınıflandırma girdisi haline getirir.
Veri akışı
| Aşama | Kaynakta bildirilen işlem | Bilimsel anlamı |
|---|---|---|
| Veri kaynağı | Refinitiv Tick History; TAQ ve araştırma gündeminde LOB | İşlem ve kotasyon düzeyindeki yüksek frekanslı piyasa kayıtları |
| Zaman filtresi | Her gün 11:00-16:00 | Analiz gün içinin belirli bir bölümüne sınırlandırılır |
| Zaman çözünürlüğü | 1 dakika | Ticker başına günlük yaklaşık 300 zaman dilimi |
| Dakika içi veri | İlk trade ve o dakikadaki tüm quote kayıtları | Fiyat yönü ve likidite ölçütleri için temel kayıtlar |
| Kotasyon özetleme | Ortalama bid, ask ve ilgili büyüklükler | Dakika düzeyinde temsil edici kotasyon değişkenleri |
| Hedef | Fiyat hareketi yönü: Up / Down | İkili sınıflandırma problemi |
| Veri bölümü | %70 eğitim, %15 doğrulama, %15 test | Model kurma, seçim ve son değerlendirmeyi ayırma |
Kullanılan likidite değişkenleri
Kaynak, modele verilen bağımsız değişkenleri dört ana kümede listeler. Ancak bu metriklerin matematiksel formülleri, hesaplama pencereleri veya normalizasyon ayrıntıları kaynakta verilmemektedir. Bu nedenle aşağıdaki açıklamalar metriklerin çalışmadaki rolünü açıklar; kaynakta yer almayan kesin formüller yeniden üretilmemiştir.
| Kaynakta listelenen ölçütler | Çalışmadaki işlevi | Kaynakta formül var mı? |
|---|---|---|
| Turnover, Market Depth, Log Depth, Dollar Depth | İşlem etkinliği ve emir/kotasyon derinliğiyle ilişkili girdiler | Hayır |
| Spread, Effective Spread, Relative Spread türleri | Alış-satış fiyatları arasındaki tightness ve işlem maliyeti boyutunu temsil eden girdiler | Hayır |
| Quote Slope, Log Quote Slope, Adjusted Log Quote Slope | Kotasyon yapısının fiyat ve miktar ilişkisini özetleyen girdiler | Hayır |
| Composite Liquidity, Liquidity Ratio 1 (Amivest), Flow Ratio, Order Ratio, Illiquidity (Amihud) | Likiditenin işlem akışı, fiyat etkisi ve birleşik boyutlarını temsil eden girdiler | Hayır |
“Tüm Özellikler” ile “Özellik Kombinasyonu” Arasındaki Fark Nedir?
“Tüm Özellikler” koşulu, kaynakta listelenen mevcut likidite ölçütlerinin modelde birlikte kullanılmasını; “Özellik Kombinasyonu” koşulu ise sınıflandırma hatasını azaltması beklenen daha küçük bir likidite ölçütleri alt kümesinin kullanılmasını ifade eder. Kaynak alt küme seçiminin amacını açıklar, ancak hangi özellik seçme algoritmasının kullanıldığını, aramanın nasıl yapıldığını veya her model için seçilen nihai değişken listesini metin içinde ayrıntılı biçimde raporlamaz.
Üç sınıflandırıcı neden birlikte deneniyor?
Lojistik Regresyon doğrusal karar yapısına dayanan bir temel sınıflandırıcı, SVM sınıflar arasında ayırıcı bir karar sınırı arayan bir yöntem, Random Forest ise çok sayıda karar ağacının birleşiminden oluşan ansambl bir sınıflandırıcıdır. Bu tanımlar çalışmanın bulgusu değildir; model ailelerinin işlevini anlamaya yönelik öğretici açıklamadır. Kaynakta bu modellerin ayrıntılı hiperparametreleri verilmediği için hangi çekirdek, düzenlileştirme değeri, ağaç sayısı, maksimum derinlik veya sınıf ağırlığının kullanıldığı bilinmemektedir.
Karışıklık matrisi nasıl okunuyor?
Kaynak, karışıklık matrisinin sol üst hücresini doğru tahmin edilen “Up”, sağ alt hücresini doğru tahmin edilen “Down” hareketleri olarak tanımlar. Sağ üst ve sol alt hücreler yanlış sınıflandırmalardır. Kaynak ayrıca doğruluğu, fiyat yönüne ilişkin doğru tahminlerin yüzdesi olarak tanımlar.
Verianla kavramsal açıklaması: Kaynağın bu tanımı standart biçimde şu ilişkiyle ifade edilebilir: \(\mathrm{Accuracy}=\frac{N_{\mathrm{correct}}}{N_{\mathrm{total}}}\times 100\). Bu denklem kaynak makalede ayrı bir formül olarak verilmemiştir; yalnızca kaynakta yazılı doğruluk tanımını matematiksel olarak görünür kılmak ve tablo içi tutarlılığı değerlendirmek için kullanılmıştır.
Çalışmanın Yöntemi ve Bulguları
Model geliştirme düzeni
Üç model önce bütün bağımsız değişkenlerle eğitilir. Ardından kaynak, sınıflandırma hatasını azaltmayı amaçlayan bir özellik alt kümesi seçimi yapıldığını belirtir. Veri %70 eğitim, %15 doğrulama ve %15 test olarak ayrılır. Bu ayrım, özellik veya model seçiminin test kümesine doğrudan dayandırılmasını önlemeyi amaçlayan temel bir makine öğrenmesi düzenidir; ancak kaynak, bölmenin zamansal mı yoksa rastgele mi yapıldığını açıklamaz. Yüksek frekanslı finansal veride bu ayrıntı önemlidir, çünkü zamansal sızıntı riski model performansının yorumunu değiştirebilir.
Kaynakta bildirilen karışıklık matrisleri ve doğruluklar
| Model | Tüm özellikler karışıklık matrisi | Accuracy_AF | Özellik kombinasyonu karışıklık matrisi | Accuracy_FC |
|---|---|---|---|---|
| LOG / LR | [[25, 4], [4, 7]] | %62,75 | [[28, 1], [22, 0]] | %54,90 |
| SVM | [[28, 1], [18, 4]] | %62,79 | [[16, 13], [12, 10]] | %50,98 |
| RF | [[22, 7], [13, 9]] | %60,78 | [[27, 2], [17, 5]] | %62,74 |
Kaynak Sonuçlarında En Yüksek Doğruluk Hangi Modelde Görülüyor?
Kaynak tablosundaki raporlanan sayılar esas alındığında en yüksek tek doğruluk değeri, tüm özelliklerle çalışan SVM için %62,79'dur; Random Forest'ın özellik kombinasyonu sonucu %62,74'tür. Buna karşın sonuç bölümünde yazarlar Random Forest'ın diğer modelleri geride bıraktığını ve en yüksek doğruluğu verdiğini ifade eder. Bu iki ifade aynı kaynak içinde tam olarak örtüşmediğinden, Verianla makalesi model üstünlüğünü kesinleştirmek yerine bu bibliyografik ve sayısal tutarsızlığı açıkça korur.
Kaynak içi tutarlılık kontrolü
| Kontrol noktası | Kaynakta görülen durum | Yorum sınırı |
|---|---|---|
| LR, tüm özellikler | Karışıklık matrisi [[25, 4], [4, 7]] iken tablo doğruluğu %62,75 olarak verilmiştir. | Matris hücreleri doğrudan doğru/yanlış sayıları olarak yorumlanırsa 32/40 = %80 çıkar. Bu nedenle matris ile raporlanan yüzde arasında ciddi bir iç tutarsızlık vardır; Verianla değeri düzeltmez. |
| SVM, tüm özellikler | Matris [[28, 1], [18, 4]], doğruluk %62,79. | Matris üzerinden 32/51 yaklaşık %62,75 elde edilir; kaynak yüzdeyle küçük bir fark vardır. |
| RF, tüm özellikler ve alt küme | %60,78'den %62,74'e yükselir. | Kaynağın “baseline modeller tuned modellere göre daha yüksek” genellemesi RF için geçerli değildir; LR ve SVM'de ise alt küme sonucu düşmektedir. |
| Model üstünlüğü | Sonuç metni RF'nin en yüksek doğruluğu verdiğini söyler; tablo en yüksek raporlanan değeri SVM için %62,79 gösterir. | Şekil tabanlı ek bir sonuç bunu açıklıyor olabilir, ancak yüklenen PDF'deki ilgili şekil sayfaları yalnız harici PNG yönlendirme metni içerdiğinden bu olasılık doğrulanamamaktadır. |
Özellik önemi bulgusu
Kaynak, Liquidity Ratio, Flow Ratio ve Turnover ölçütlerinin özellik önemi analizinde sürekli olarak öne çıktığını belirtir. Bu bulgu, modelin yön kararlarında yalnız spread türü göstergelere değil, işlem akışı ve işlem etkinliğiyle ilişkili değişkenlere de ağırlık verdiğini düşündüren bir model-içi önem bulgusudur. Ancak kaynakta bu üç değişkenin kesin katsayıları veya önem skorları metinsel tabloda verilmemektedir; bu nedenle Verianla sayısal önem derecesi üretmez.
Tüm değişkenler mi, azaltılmış özellik kümesi mi?
LR ve SVM için kaynakta raporlanan doğruluk, bütün likidite değişkenleri kullanıldığında daha yüksektir: LR %62,75'ten %54,90'a, SVM %62,79'dan %50,98'e düşmektedir. RF'de ise tersine, seçilmiş özellik kombinasyonu %60,78'den %62,74'e yükselmektedir. Dolayısıyla kaynak metnindeki “geniş özellik kümesi daha iyi sonuç verir” yorumu iki model tarafından desteklenirken, RF sonucu bu genellemeye istisna oluşturur. Çalışmanın güvenli yorumu, özellik azaltmanın etkisinin model ailesine bağlı göründüğü ve kaynakta sunulan tek deney düzeniyle bütün modeller için tek yönlü bir sonuç çıkarılamayacağıdır.
Bu Sonuçlar Farklı Hisselere ve Piyasa Koşullarına Genellenebilir mi?
Kaynak çalışma bu genellenebilirliği göstermemektedir. Yazarlar farklı hisse veri kümelerinde benzer doğruluk ve özellik önemi kalıplarının sürüp sürmediğinin gelecekte test edilmesini açıkça önerir; ayrıca mevcut metin kullanılan ticker listesini, tarih aralığını, piyasa rejimlerini ve toplam örneklem büyüklüğünü ayrıntılı olarak vermediği için sonuçlar yalnız raporlanan veri ve deney düzeni çerçevesinde değerlendirilmelidir.
Çalışmanın desteklediği sonuçlar
- TAQ tabanlı likidite ölçütleri, kaynakta kurulan test düzeninde dakikalık fiyat yönünü sınıflandırmak için kullanılabilmiştir.
- Kaynakta bildirilen doğruluk değerleri yaklaşık %50,98 ile %62,79 aralığındadır.
- LR ve SVM'de bütün özellikler, seçilmiş özellik kombinasyonundan daha yüksek raporlanan doğruluk vermiştir.
- RF'de seçilmiş özellik kombinasyonu, tüm özellikler koşulundan daha yüksek raporlanan doğruluk vermiştir.
- Yazarların özellik önemi yorumuna göre Liquidity Ratio, Flow Ratio ve Turnover öne çıkan girdilerdir.
Çalışmanın desteklemediği sonuçlar
- Bu modellerin kârlı bir canlı işlem stratejisi oluşturduğunu göstermez; işlem maliyeti, slippage, piyasa etkisi ve net getiri analizi sunulmamıştır.
- Likidite ölçütlerinin fiyat hareketlerine nedensel olarak yol açtığını kanıtlamaz; çalışma öngörücü sınıflandırma çerçevesidir.
- Farklı hisseler, borsalar, dönemler veya kriz rejimleri için aynı doğrulukların elde edileceğini göstermez.
- Gerçek zamanlı üretim ortamında gecikme, veri erişimi, işlem hızı veya operasyonel dayanıklılık başarısını test etmez.
- Kaynakta raporlanmayan hiperparametreler ve veri bölme ayrıntıları nedeniyle sonuçların bağımsız olarak aynı biçimde yeniden üretilebileceğini garanti etmez.
Yeniden üretilebilirlik açısından eksik kalan bilgiler
| Bilgi | Kaynak durumu | Neden önemli? |
|---|---|---|
| Ticker/hisse listesi | Raporlanmıyor | Varlık seçiminin sonuçlara etkisini değerlendirmek için |
| Tarih aralığı ve piyasa rejimi | Raporlanmıyor | Zamansal genellenebilirlik ve rejim bağımlılığı için |
| Toplam örneklem büyüklüğü | Raporlanmıyor | Test sonuçlarının istatistiksel güvenilirliğini anlamak için |
| Up/Down etiketinin tam matematiksel tanımı | Ayrıntılandırılmıyor | Tahmin ufku ve etiketleme mantığını yeniden kurmak için |
| Özellik formülleri | Raporlanmıyor | Likidite değişkenlerini aynı şekilde hesaplamak için |
| Özellik seçimi algoritması | Raporlanmıyor | “Feature Combination” koşulunu yeniden üretmek için |
| LR/SVM/RF hiperparametreleri | Raporlanmıyor | Model davranışını ve performansını yeniden üretmek için |
| Ölçekleme, standardizasyon ve eksik veri işlemleri | Raporlanmıyor | Özellikle SVM ve LR için girdilerin işlenişini doğrulamak için |
| Bölmenin zamansal/rastgele niteliği | Raporlanmıyor | Zamansal veri sızıntısı riskini değerlendirmek için |
| İstatistiksel belirsizlik / güven aralığı | Raporlanmıyor | Küçük doğruluk farklarının anlamlı olup olmadığını değerlendirmek için |
Kaynak ve Yöntem Notu
Tam özgün başlık: High-Frequency Trading Liquidity Analysis | Application of Machine Learning Classification
Yazarlar: Sid Bhatia, Sidharth Peri, Sam Friedman, Michelle Malen.
Kurum: Stevens Institute of Technology. Yüklenen sürümde kurum belge düzeyinde belirtilmiş, yazar bazında ayrı afiliyasyon eşlemesi verilmemiştir.
Belge tarihi: 5 Ağustos 2024. arXiv gönderim tarihi: 19 Ağustos 2024.
Platform ve sınıf: arXiv, q-fin.TR — Trading and Market Microstructure. arXiv kimliği: 2408.10016v1. arXiv/DataCite DOI: 10.48550/arXiv.2408.10016.
Kaynak türü ve hakemlik: Yüklenen belge bir arXiv preprint sürümüdür. Resmî arXiv kaydında bu sürüm için dergi, cilt, sayı veya hakemli yayın bilgisi verilmemektedir; bu nedenle Verianla metni çalışmayı hakemli dergi makalesi olarak sunmaz.
Lisans: arXiv kaydı CC BY 4.0 lisansını göstermektedir. Yeniden kullanımda uygun atıf, lisans bağlantısı ve değişiklik yapıldıysa bunun belirtilmesi gerekir.
Veri ve yöntem: Çalışma Refinitiv Tick History içindeki TAQ verisini temel alır; araştırma gündeminde Limit Order Book verisi de anılır. Analiz 11:00-16:00 aralığına ve 1 dakikalık zaman çözünürlüğüne indirilmiştir. Modeller LR, SVM ve RF; veri ayrımı %70/%15/%15'tir.
Corresponding author, finansman, çıkar çatışması, veri erişilebilirliği ve CRediT katkıları: Yüklenen kaynakta açık biçimde raporlanmamıştır.
Şekiller: Yüklenen PDF'nin 6-13. sayfaları all-feat-log, all-feat-rf, all-feat-svm, feat-combo-log, feat-combo-rf, feat-combo-svm, feature-import-mdi ve svm-feature-impor adlı PNG görsellerine yönlendirme metni içermektedir; görüntülerin kendisi bu PDF kopyasında gömülü değildir. Bu nedenle kaynakta metin olarak verilmeyen kesin özellik önem katsayıları veya şekil geometrileri Verianla tarafından uydurulmamıştır.
Temel yöntemsel sınır: Çalışma bir fiyat yönü sınıflandırma deneyidir; canlı işlem kârlılığı, nedensellik, başka piyasalara genellenebilirlik veya üretim ortamı performansı hakkında doğrudan kanıt sunmaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir