

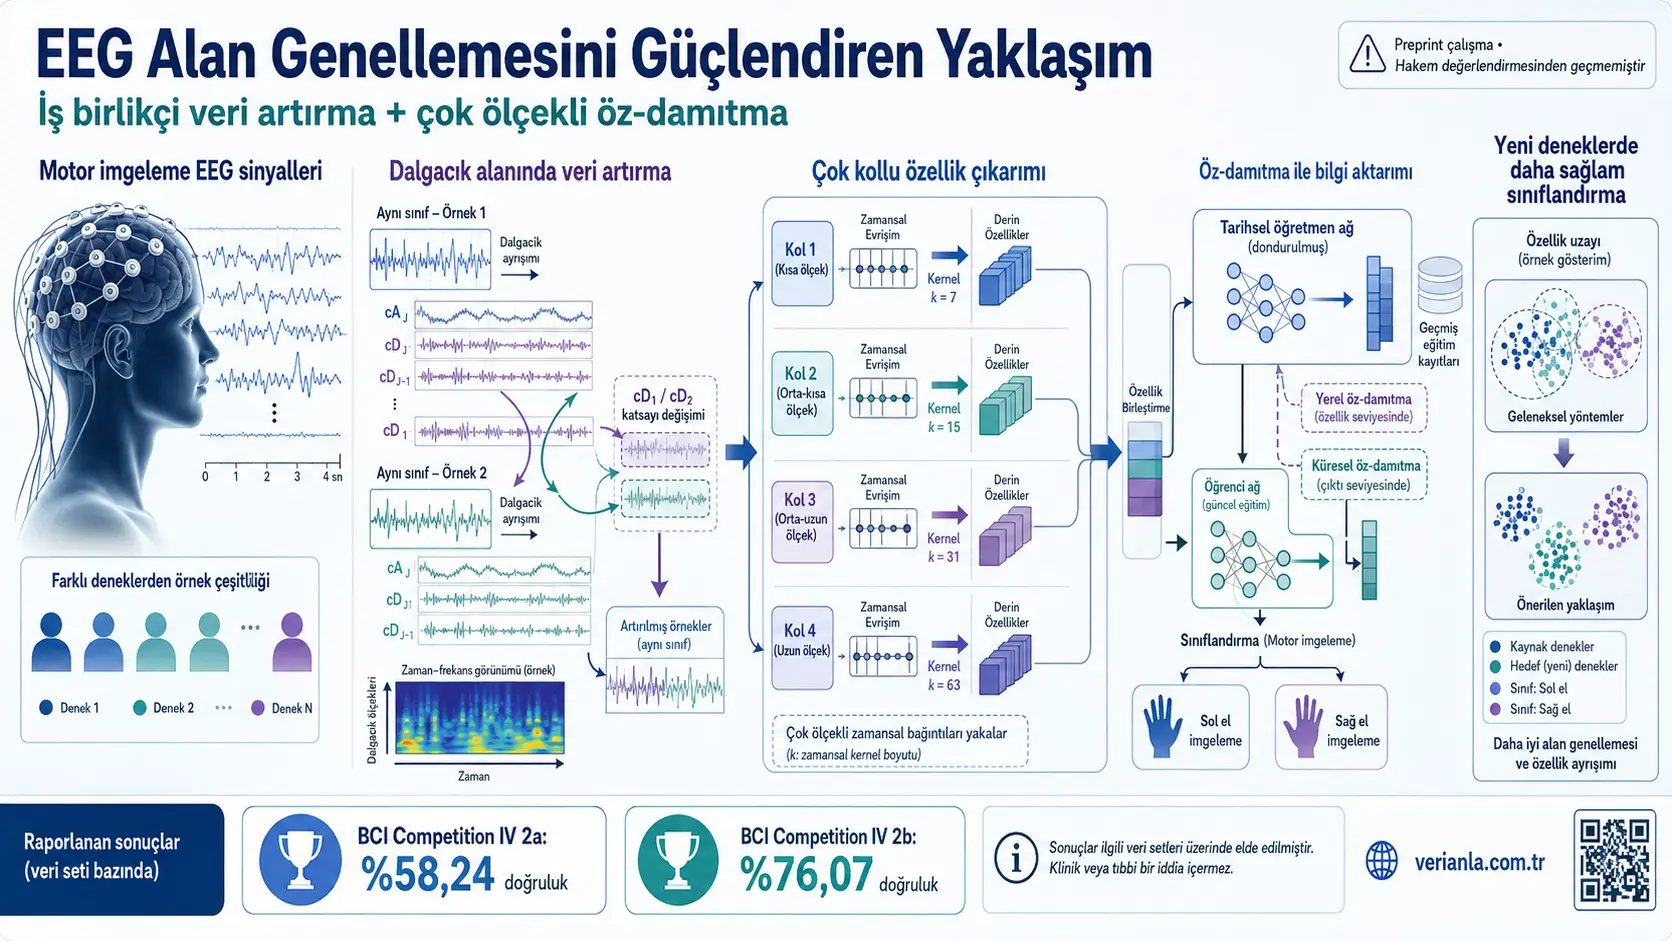
Ushbu tadqiqot motor tasavvuri elektroensefalografiya signallarini turli shaxslar o‘rtasida ishonchli tasniflashni yaxshilash maqsadida to‘lqincha sohasidagi ma’lumotlarni ko‘paytirish, to‘rt tarmoqli konvolyutsion neyron tarmoq va global-mahalliy o‘z-o‘zini distillashni birlashtiruvchi MGLSDNet modelini baholadi. Model har biri to‘qqiz ishtirokchini o‘z ichiga olgan BCI Competition IV 2a va 2b ma’lumotlar to‘plamlarida leave-one-subject-out baholash orqali sinovdan o‘tkazildi. O‘rtacha tasniflash aniqligi to‘rt sinfli 2a ma’lumotlar to‘plamida %58,24, ikki sinfli 2b ma’lumotlar to‘plamida %76,07 deb xabar qilingan. Biroq tadqiqot taqrizdan o‘tmagan preprintdir; u faqat ikkita ochiq ma’lumotlar to‘plamiga tayangan va real vaqt tizimi, klinik bemor guruhlari, yangi ishtirokchilar yoki dala amaliyotida tasdiqlashni taqdim etmaydi.
Tadqiqotda taklif qilingan Ko‘p O‘lchovli Global-Mahalliy O‘z-o‘zini Distillash Tarmog‘i (Multi-scale Global-Local Self-Distillation Network, MGLSDNet) ma’lumot va model darajasidagi ikki muammoni birgalikda hal qiladi. Ma’lumot darajasida bir xil motor tasavvuri sinfiga mansub EEG namunalarining ayrim to‘lqincha tafsilot koeffitsiyentlari almashtirilib yangi o‘quv namunalar yaratilgan. Model darajasida esa turli vaqt o‘lchovlarini tekshiruvchi to‘rtta parallel tarmoq shoxobchasi ishlatilgan; har bir shoxobcha va shoxobchalarning birlashtirilgan qarori tarmoqning avval saqlangan tarixiy versiyalari tomonidan yo‘naltirilgan.
BCI Competition IV 2a ma’lumotlar to‘plamida MGLSDNetning %58,24 aniqligi eng yaqin taqqoslash modeli bo‘lgan MSVTNetning %57,16 aniqligidan 1,08 foiz punkt yuqori. Biroq bu ikki model orasidagi farq statistik jihatdan ahamiyatli emas; juftlangan t-testda p=0,6507 deb xabar qilingan. BCI Competition IV 2b ma’lumotlar to‘plamida MGLSDNet %76,07 aniqlikka erishib, eng yuqori o‘rtacha natijaga ega taqqoslash usuli TIDNetning %73,24 natijasidan 2,83 foiz punkt yuqori bo‘lgan. Ushbu taqqoslashdagi farq p=0,0308 bilan statistik ahamiyatlilik chegarasidan past deb berilgan.
Turkiya nuqtai nazaridan baholash: Tadqiqot Turkiyada miya-kompyuter interfeysi, yordamchi texnologiya va neyroreabilitatsiya bo‘yicha ish olib borayotgan jamoalar uchun shaxslararo EEG tasniflashda sinab ko‘rilishi mumkin bo‘lgan metodologik doira taklif etadi. Ayniqsa yangi foydalanuvchidan ko‘p kalibrlash ma’lumotlarini yig‘ish ehtiyojini kamaytirish maqsadi amaliy jihatdan muhim. Biroq usul Turkiyadagi ishtirokchilar, turli EEG qurilmalari, mahalliy laboratoriya sharoitlari va klinik maqsad guruhlarida qayta tasdiqlanishi kerak. Ushbu preprint bemorlarda yaxshilanish, protez boshqaruvida dala muvaffaqiyati, kalibrlash vaqtining o‘lchangan qisqarishi yoki klinik samaradorlik dalilini bermaydi.
Tadqiqotning asosiy savoli nima?
Tadqiqotning asosiy savoli faqat manba shaxslardan olingan motor tasavvuri EEG ma’lumotlari bilan o‘qitilgan model trening davomida umuman ko‘rmagan yangi shaxs signallarini yanada ishonchli tasniflay oladimi yoki yo‘qmi, degan savoldir. Ushbu maqsad tadqiqotda domen umumlashtirish (domain generalization) deb atalgan. Domen umumlashtirishda nishon shaxs ma’lumotlari modelni o‘qitish paytida ishlatilmaydi; maqsad bir nechta manba shaxslarda umumiy bo‘lgan vazifa bilan bog‘liq naqshlarni o‘rganib, yangi shaxsga bevosita qo‘llanadigan model yaratishdir.
Motor tasavvuri (motor imagery) — insonning haqiqiy harakat bajarmasdan qo‘l, oyoq yoki til harakatini xayolan tasavvur qilishi. Tadqiqot ushbu aqliy vazifalar davomida yuzaga keladigan EEG naqshlarini tasniflaydi. BCI Competition IV 2a ma’lumotlar to‘plamida to‘rtta motor tasavvuri sinfi, 2b ma’lumotlar to‘plamida esa chap va o‘ng qo‘l bo‘yicha ikki sinf mavjud.
Tadqiqot nega muhim?
Tadqiqotda motor tasavvuri EEG tasnifi uchta asosiy qiyinchilikka duch kelishi qayd etilgan: EEG signallarining signal-shovqin nisbati pastligi, signallarning vaqt bo‘yicha o‘zgaruvchanligi va turli odamlarning miya signallari orasidagi sezilarli taqsimot farqlari. Chuqur o‘rganish modellari kam sonli ishtirokchi va cheklangan namunalar bilan o‘qitilganda, motor tasavvuri vazifasiga xos umumiy xususiyatlar o‘rniga ma’lum shaxslarning shovqini yoki individual naqshlarini o‘rganishi mumkin.
Bu holat yangi foydalanuvchini tizimga qo‘shishdan oldin uzoq kalibrlash sessiyalari va shaxsga xos model treningini talab qilishi mumkin. Tadqiqotning maqsadi kalibrlash ehtiyojini bevosita o‘lchash emas, balki nishon shaxsdan trening ma’lumotini ishlatmasdan yaxshiroq tasniflash qila oladigan model ishlab chiqishdir.
Adabiyotdagi qaysi bo‘shliq nishonga olingan?
Tadqiqotga ko‘ra, oldingi usullar asosan ma’lumotlarni ko‘paytirish va modelni regulyarizatsiya qilishni alohida ko‘rib chiqqan. Vaqt sohasida shovqin qo‘shish, vaqtni siljitish yoki amplitudani masshtablash kabi amallar motor tasavvuri signallarining vaqt-chastota tuzilishini buzishi mumkin. GAN va VAE kabi generativ modellar esa o‘qitish beqarorligi va yaratilgan namunalar fiziologik mazmunining tasdiqlanishi bo‘yicha muammolarga duch kelishi mumkin.
Ko‘p shoxobchali tarmoqlar turli vaqt yoki chastota o‘lchovlaridan bir-birini to‘ldiruvchi xususiyatlarni ajrata olsa-da, har bir shoxobchaning mustaqil optimallashtirilishi umumiy qarorning yetarli darajada regulyarizatsiya qilinmasligiga olib kelishi mumkin. MGLSDNet ushbu ikki yo‘nalishni birlashtiradi: avval to‘lqincha koeffitsiyentlarini o‘zgartirib trening taqsimotini kengaytiradi, so‘ng tarmoqning tarixiy holatlarini o‘qituvchi sifatida ishlatadigan o‘z-o‘zini distillash orqali ko‘p o‘lchovli xususiyatlarni regulyarizatsiya qiladi.
To‘lqincha sohasidagi ma’lumotlarni ko‘paytirish qanday ishlaydi?
To‘lqincha o‘zgartirish EEG signalini turli vaqt-chastota komponentlariga ajratish uchun ishlatilgan. Tadqiqotda yaqinlashish koeffitsiyentlari cA, tafsilot koeffitsiyentlari esa cD bilan ko‘rsatilgan. Bir xil sinfga mansub ikki namuna tanlanadi, faqat muayyan tafsilot darajasidagi koeffitsiyentlar o‘zaro almashtiriladi va o‘zgartirilgan komponentlardan ikkita yangi EEG namunasi qayta tiklanadi. Sinf yorlig‘i o‘zgarmaydi.
- cD1: Tadqiqotda 20–40 Hz diapazoni bilan bog‘langan birinchi darajali tafsilot koeffitsiyentlari.
- cD2: Tadqiqotda 10–20 Hz diapazoni bilan bog‘langan ikkinchi darajali tafsilot koeffitsiyentlari.
- Shaxslararo almashtirish: Bir xil sinfdagi namunalar turli manba shaxslardan tanlanadi.
- Shaxs ichidagi almashtirish: Bir xil sinfdagi namunalar ayni manba shaxsdan tanlanadi.
2-rasmda ikkita signalning to‘lqincha komponentlariga ajratilishi, cD1 yoki cD2 koeffitsiyentlarining o‘zaro almashtirilishi va yangi signallarning qayta tiklanishi ko‘rsatiladi. Yaqinlashish koeffitsiyentlari hamda almashtirilmagan tafsilot darajasi saqlanadi. Mualliflarning maqsadi signalning sinf ma’nosini saqlagan holda shaxslar orasidagi ritmik amplituda va faza farqlarini taqlid qilishdir.
Tajribalarda Daubechies 4 (db4) to‘lqincha bazasi, uch karra ma’lumot ko‘paytirish koeffitsiyenti va 0,02 darajadagi past shovqin ishlatilgan. Biroq tadqiqot yaratilgan namunalar fiziologik haqiqiyligini mustaqil spektral o‘xshashlik mezoni, ekspert baholashi yoki alohida biologik tasdiqlash testi bilan ko‘rsatmaydi. “Fiziologik ma’no saqlanadi” degan ifoda mualliflarning metodologik asoslanishi va tasniflash natijalari bilan bilvosita qo‘llab-quvvatlangan da’vodir; u bevosita isbotlangan biologik natija emas.
Ko‘p shoxobchali xususiyat ajratuvchi qanday tuzilgan?
MGLSDNet bir xil uch qatlamli tuzilishga ega to‘rtta parallel shoxobchadan iborat. Shoxobchalar orasidagi asosiy farq birinchi vaqt konvolyutsiyasi yadrosining o‘lchamidir. Yadro o‘lchamlari namunalash chastotasi \(F_s\) orqali \(F_s/16\), \(F_s/8\), \(F_s/4\) va \(F_s/2\) tarzida aniqlangan. Katta yadrolar uzoqroq davom etuvchi ritmik naqshlarga, kichik yadrolar esa qisqaroq vaqt o‘zgarishlariga e’tibor qaratadi.
Har bir shoxobcha uchta asosiy amalni bajaradi:
- Vaqt konvolyutsiyasi: \(1 \times L_k\) yadrosi bilan shoxobchaga xos vaqt naqshlarini ajratadi.
- Fazoviy depthwise separable convolution: \(C \times 1\) yadrosi bilan EEG elektrodlari orasidagi munosabatlarni modellashtiradi. Bu yerda \(C\) ishlatilgan EEG kanallari soni.
- Ajratiladigan vaqt konvolyutsiyasi: Dastlabki ikki qatlamdan kelgan xususiyatlarni birlashtirib murakkabroq vaqt kontekstlarini ajratishni maqsad qiladi.
Shoxobchalarning oraliq xususiyatlari erta bosqichda birlashtirilmaydi. Har bir shoxobcha o‘z tasniflash chiqishini ishlab chiqaradi va yakuniy qaror uchun ushbu xom chiqish ballari, ya’ni logit qiymatlarining elementlar bo‘yicha o‘rtachasi olinadi. 1-rasmda talaba tarmoqning to‘rtta shoxobchasi, talaba tarmoqdan ko‘chirilgan tarixiy o‘qituvchi tarmoq, shoxobcha darajasidagi mahalliy yo‘qotish bog‘lanishlari va ikki tarmoqning birlashtirilgan qarorlari orasidagi global yo‘qotish ko‘rsatiladi.
Global-mahalliy o‘z-o‘zini distillash qanday qo‘llanadi?
O‘z-o‘zini distillash tashqi va oldindan o‘qitilgan o‘qituvchi modeldan foydalanmaydi. Talaba tarmoq parametrlari ma’lum oraliqlarda ko‘chiriladi, ko‘chirilgan versiya muzlatiladi va tarixiy o‘qituvchi sifatida ishlatiladi. Tadqiqotda o‘qituvchini yangilash oralig‘i 10 epoch deb belgilangan. Shu tariqa joriy talaba modeli ham haqiqiy sinf yorliqlaridan, ham o‘zining avvalgi versiyasi ishlab chiqargan ehtimollik taqsimotlaridan o‘rganadi.
Mahalliy o‘z-o‘zini distillash har bir talaba shoxobchasini uning tarixiy o‘qituvchi shoxobchasi bilan taqqoslaydi. Global o‘z-o‘zini distillash esa talaba shoxobchalarining birlashtirilgan yakuniy chiqishini o‘qituvchi shoxobchalarining umumiy chiqishi bilan moslashtiradi. Bu ikki darajani birgalikda ishlatish har bir o‘lchovning o‘z ichida regulyarizatsiya qilinishini va to‘rtta shoxobchaning umumiy qarori izchil bo‘lishini maqsad qiladi.
Yo‘qotish funksiyalari nimani hisoblaydi?
Birinchi tenglama \(k\)-raqamli talaba shoxobchasining yumshatilgan chiqish taqsimoti bilan mos tarixiy o‘qituvchi shoxobcha taqsimoti orasidagi Kullback-Leibler ajralishini hisoblaydi:
\[ L_{\mathrm{soft}}^{k} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_k/\tau)\,\|\,\operatorname{softmax}(z_k^{\mathrm{teacher}}/\tau)\right) \]
Bu yerda \(z_k\) talaba shoxobchasining tasniflashdan oldingi xom chiqish ballarini; \(z_k^{\mathrm{teacher}}\) ayni shoxobchaning tarixiy o‘qituvchi chiqishini; \(\tau\) esa harorat parametrini ko‘rsatadi. Tadqiqotda \(\tau=2{,}0\) ishlatilgan. Ushbu kattaliklar fizik birlikka ega emas. Harorat sinflar orasidagi ehtimollik farqlarini yumshatib, o‘qituvchi qaysi sinflarni bir-biriga yaqin deb baholashiga oid ma’lumotni uzatishni maqsad qiladi.
Ikkinchi tenglama haqiqiy sinf yorlig‘i bilan hisoblangan qattiq yorliq yo‘qotishini o‘qituvchi chiqishidan kelgan yumshoq yorliq yo‘qotishi bilan birlashtiradi:
\[ L_{\mathrm{local}}^{k} = \alpha L_{\mathrm{hard}}^{k} + (1-\alpha)L_{\mathrm{soft}}^{k} \]
\(L_{\mathrm{hard}}^{k}\), \(k\)-raqamli shoxobchaning haqiqiy yorliqlar bilan hisoblangan cross-entropy yo‘qotishidir. \(L_{\mathrm{soft}}^{k}\) o‘z-o‘zini distillash yo‘qotishidir. \(\alpha\) ikki nazorat manbasining og‘irligini belgilaydi va tadqiqotda 0,5 sifatida ishlatilgan. Shu tariqa haqiqiy yorliq va tarixiy o‘qituvchi mahalliy shoxobcha yo‘qotishiga teng og‘irlik bilan qo‘shiladi.
Uchinchi tenglama to‘rtta tarixiy o‘qituvchi shoxobchaning xom chiqish ballarini o‘rtachalaydi:
\[ z_{\mathrm{final}}^{\mathrm{teacher}} = \frac{1}{K}\sum_{k=1}^{K}z_k^{\mathrm{teacher}} \]
Bu yerda \(K\) shoxobchalar soni bo‘lib, MGLSDNet uchun \(K=4\). Tenglama bitta shoxobcha qarorini emas, to‘rtta tarixiy o‘qituvchi shoxobchaning umumiy qarorini ifodalaydi.
To‘rtinchi tenglama joriy talaba tarmoqning birlashtirilgan chiqishi bilan tarixiy o‘qituvchi tarmoqning umumiy chiqishi orasidagi global distillash yo‘qotishini hisoblaydi:
\[ L_{\mathrm{global}} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_{\mathrm{final}}/\tau)\,\|\,\operatorname{softmax}(z_{\mathrm{final}}^{\mathrm{teacher}}/\tau)\right) \]
\(z_{\mathrm{final}}\) to‘rtta talaba shoxobchaning birlashtirilgan chiqishidir. \(z_{\mathrm{final}}^{\mathrm{teacher}}\) to‘rtta o‘qituvchi shoxobchaning o‘rtacha chiqishidir. Ushbu yo‘qotish joriy modelning umumiy qarorini tarmoqning tarixiy umumiy qarori bilan moslashtirishni maqsad qiladi.
Beshinchi tenglama umumiy trening maqsadini belgilaydi:
\[ L_{\mathrm{total}} = \sum_{k=1}^{K}L_{\mathrm{local}}^{k} + L_{\mathrm{global}} + L_{\mathrm{hard}}^{\mathrm{final}} \]
Umumiy yo‘qotish to‘rtta shoxobchaning mahalliy yo‘qotishlari, global o‘z-o‘zini distillash yo‘qotishi va birlashtirilgan yakuniy qarorning haqiqiy yorliqlar bilan hisoblangan cross-entropy yo‘qotishini birga o‘z ichiga oladi. Ushbu yo‘qotish hadlari o‘lchovsizdir. Tadqiqot bu birikma shoxobcha darajasidagi barqarorlik va tarmoq darajasidagi qaror izchilligini bir vaqtda oshirishini ilgari suradi.
Xususiyatlarni vizuallashtirish nimani ko‘rsatadi?
3-rasm va 4-rasm BCI Competition IV 2b ma’lumotlar to‘plamidagi B01 kodli birinchi shaxsning to‘rtta tarmoq shoxobchasidan olingan xususiyatlarining ikki o‘lchamli t-SNE proyeksiyalarini ko‘rsatadi. t-SNE o‘qlari fizik EEG kattaliklari yoki chastotalar emas; ular yuqori o‘lchamli xususiyatlarning vizual tekshiruv uchun ikki o‘lchamga tushirilgan koordinatalaridir.
Treningdan oldin ikki sinfga mansub nuqtalar to‘rtta shoxobchada ham katta darajada aralashgan. Treningdan keyin chap va o‘ng qo‘l sinflarining aniqroq klasterlar hosil qilgani ko‘rinadi. Tadqiqotga ko‘ra 1- va 3-shoxobchalar ko‘proq gorizontal yo‘nalishda, 2- va 4-shoxobchalar esa ko‘proq vertikal yo‘nalishda ajratish hosil qilgan. Bu ko‘rinish shoxobchalar ayni qaror chegarasini takrorlash o‘rniga bir-birini to‘ldiruvchi xususiyatlarni o‘rgangan degan talqinni qo‘llab-quvvatlaydi.
Vizuallashtirishning qamrovi cheklangan. Faqat 2b ma’lumotlar to‘plamidagi B01 shaxsi ko‘rsatilgan va ajralish miqdoriy klasterlash mezoni bilan berilmagan. Shu sababli t-SNE rasmlari model muvaffaqiyatini o‘zi isbotlamaydi; ular tasniflash jadvallarini qo‘llab-quvvatlovchi sifat tahlili sifatida o‘qilishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar nimalar?
- MGLSDNet tadqiqotda qo‘llangan taqqoslash tartibida ikkala ma’lumotlar to‘plamida ham eng yuqori o‘rtacha aniqlikni bergan.
- To‘lqincha koeffitsiyentlarini almashtirishga asoslangan to‘rtta ma’lumot ko‘paytirish variantining barchasi ma’lumot ko‘paytirishsiz versiyadan yuqori o‘rtacha aniqlik bergan.
- Shaxslararo koeffitsiyent almashtirish har ikkala ma’lumotlar to‘plamida ham eng yaxshi ma’lumot ko‘paytirish natijalarini bergan.
- Mahalliy va global o‘z-o‘zini distillash alohida-alohida kichik aniqlik oshishlarini ta’minlagan, birgalikda ishlatilganda esa yuqoriroq oshish kuzatilgan.
- 2b ma’lumotlar to‘plamida MGLSDNet bilan taqqoslangan barcha usullar orasidagi farqlar p<0,05 deb xabar qilingan.
- 2a ma’lumotlar to‘plamida MSVTNetdan tashqari taqqoslash usullari bilan farqlar p<0,01 deb xabar qilingan.
Tadqiqot nimani isbotlamaydi?
- Tadqiqot MGLSDNet klinik reabilitatsiyada bemor natijalarini yaxshilashini ko‘rsatmaydi.
- Yangi foydalanuvchilarning kalibrlash vaqtida o‘lchangan qisqarish xabar qilinmagan.
- Real vaqt protez, nogironlar aravachasi yoki yordamchi qurilma boshqaruvi sinovdan o‘tkazilmagan.
- Yaratilgan EEG namunalarining fiziologik haqiqiyligi mustaqil biologik mezonlar bilan tasdiqlanmagan.
- Turli EEG qurilmalari, turli laboratoriyalar yoki turli ma’lumotlar to‘plamlari orasida umumlashtirish ko‘rsatilmagan.
- Bir odamdagi turli sessiyalar orasida yuzaga keladigan signal siljishiga qarshi umumlashtirish tasdiqlanmagan.
- 2a ma’lumotlar to‘plamida MGLSDNetning MSVTNetga ustunligi statistik jihatdan ko‘rsatilmagan.
- Uzoq muddatli foydalanish, xavfsizlik, foydalanuvchi qulayligi yoki tijoriy qo‘llanilish baholanmagan.
Tadqiqotning kuchli tomonlari nimalar?
- Ma’lumot ko‘paytirish bilan model regulyarizatsiyasini bitta metodologik doirada birlashtiradi.
- Ikkita ochiq va keng qo‘llanadigan taqqoslash ma’lumotlar to‘plami ishlatilgan.
- Nishon test shaxsidan trening ma’lumoti foydalanilmaydigan shaxslararo baholash tartibi qo‘llangan.
- Ma’lumot ko‘paytirish variantlari va o‘z-o‘zini distillash komponentlari alohida tajribalar bilan o‘rganilgan.
- Aniqlikka qo‘shimcha ravishda standart og‘ish, Kappa qiymati va juftlangan t-test natijalari berilgan.
- Model arxitekturasi, yo‘qotish funksiyalari va asosiy trening giperparametrlari tushuntirilgan.
Tadqiqot cheklovlari va manba ichidagi noaniqliklar nimalar?
Tadqiqotning o‘zi uchta asosiy cheklovni tan oladi: to‘lqincha koeffitsiyentini tanlash oldindan belgilangan fiziologik farazlarga bog‘liq, tarixiy o‘qituvchilardan foydalanish trening hisoblash yukini oshiradi va sessiyalararo umumlashtirish tasdiqlanmagan.
Bundan tashqari, baholash har biri to‘qqiz shaxsni o‘z ichiga olgan atigi ikkita ma’lumotlar to‘plamiga asoslangan. Juftlangan t-testlarda effekt kattaligi, ishonch oralig‘i, normal taqsimot nazorati yoki ko‘p taqqoslash tuzatmasi xabar qilinmagan. Trening vaqti, inferensiya kechikishi, xotira sarfi, parametrlar soni va hisoblash xarajati bo‘yicha taqqoslash jadvali berilmagan. Kod ombori yoki ishga tushiriladigan dastur havolasi ham matnda ko‘rsatilmagan.
Manbada ayrim ichki izchillik muammolari mavjud. Ma’lumot ko‘paytirish psevdokodi namunalarni “harakat sinfi + shaxs identifikatori” bo‘yicha guruhlab, ayni shaxs ichidan tanlashni tasvirlasa-da, eng yaxshi tajriba natijalari turli shaxslardan namuna tanlaydigan shaxslararo almashtirishga tegishli. Psevdokod faqat cD2 almashtirishni ko‘rsatadi, tajribalarda esa cD1 va cD2 variantlari qo‘llangan. Asosiy matn qarorlar teng o‘rtacha bilan birlashtirilishini aytadi, inferensiya psevdokodi esa aniqlanmagan \(w_k\) og‘irliklaridan foydalanadi. Bundan tashqari 2b ma’lumotlar to‘plamining beta ritmi usul bo‘limida 18–25 Hz, ma’lumot ko‘paytirish talqinida esa 13–30 Hz deb berilgan. Ushbu maqolada bu diapazonlar birlashtirilmagan yoki yashirincha tuzatilmagan.
O‘tmish, bugun va kelajak nuqtai nazaridan ahamiyati nima?
Tadqiqot avval alohida ishlatilgan to‘lqincha asosidagi ma’lumot ko‘paytirish, ko‘p shoxobchali EEG tarmoqlari va o‘z-o‘zini distillash yondashuvlarini bitta shaxslararo umumlashtirish tizimida birlashtiradi. Bugungi hissasi — ma’lumot taqsimotini kengaytirish bilan tarmoqning o‘z tarixiy bilimidan foydalanib regulyarizatsiya qilinishini birgalikda sinovdan o‘tkazgan taqqoslama va komponent asosidagi tajribalarni taqdim etishidir.
Kelajakda usul dinamik to‘lqincha koeffitsiyentini tanlash, yengilroq o‘qituvchi yangilash usullari, turli ma’lumotlar to‘plamlari, sessiyalararo signal siljishi va real vaqt BCI qurilmalarida sinovdan o‘tkazilishi kerak. Tadqiqotning qiymati amaliyotga tayyor klinik tizim ko‘rsatishidan emas, balki nishon shaxsdan trening ma’lumoti olmasdan EEG tasniflashni yaxshilashga qaratilgan sinab ko‘riladigan usulni taklif etishidan kelib chiqadi.
Tadqiqot usuli va natijalari
Ishlatilgan ma’lumotlar to‘plamlari va namuna xususiyatlari
Quyidagi jadval ikkita ochiq motor tasavvuri EEG ma’lumotlar to‘plamining tadqiqotda ishlatilgan asosiy xususiyatlarini taqqoslaydi.
| Xususiyat | BCI Competition IV 2a | BCI Competition IV 2b |
|---|---|---|
| Ishtirokchilar soni | 9 shaxs | 9 sog‘lom shaxs |
| Vazifa | To‘rt sinfli motor tasavvuri | Chap qo‘l va o‘ng qo‘l bo‘yicha ikki sinfli motor tasavvuri |
| Sessiya tuzilishi | Ikki sessiya; har sessiyada 6 run va har rundа 48 trial | Beshta tajriba sessiyasi; dastlabki uchtasida vizual feedback yo‘q, oxirgi ikkitasida real vaqt neyrofeedback mavjud |
| Vazifa davomiyligi | Har bir motor tasavvuri vazifasi 4 soniya | Matnda bitta trial davomiyligi alohida ko‘rsatilmagan |
| EEG kanallari | 22 EEG kanali model kirishi sifatida ishlatilgan | C3, C4 va Cz bo‘yicha 3 EEG kanali |
| EOG ishlatilishi | Yozib olingan 3 EOG kanali tahlildan chiqarilgan | EOG ishlatilishiga oid tafsilot berilmagan |
| Namunalash chastotasi | 250 Hz | 250 Hz |
| Filtrlash | 0,5–40 Hz band-pass filtr | 2a bilan bir xil filtrlash parametrlari |
| Ajratib ko‘rsatilgan ritmlar | Motor tasavvuri bilan bog‘liq μ va β ritmlar | μ ritmi 8–12 Hz; β ritmi usul bo‘limida 18–25 Hz deb berilgan |
Baholash va trening tartibi
| Metodologik unsur | Qo‘llangan qiymat yoki tartib |
|---|---|
| Baholash | Leave-one-subject-out cross-validation; har iteratsiyada 7 shaxs trening, 1 shaxs mustaqil validation va 1 shaxs test uchun ishlatilgan |
| Dasturiy ta’minot | PyTorch 2.0 |
| Uskuna | NVIDIA RTX 4060 Ti GPU va Intel Core i5-12490F CPU |
| Optimallashtirish | Adam; boshlang‘ich learning rate \(5 \times 10^{-4}\) |
| Maksimal trening | 400 epoch |
| Erta to‘xtatish | Validation aniqligi 50 ketma-ket epoch davomida yaxshilanmasa trening to‘xtatilgan |
| Batch hajmi | 2a uchun 64; 2b uchun 96 |
| Regulyarizatsiya | Dropout va batch normalization |
| O‘qituvchini yangilash oralig‘i | 10 epoch |
| Distillash harorati | \(\tau=2{,}0\) |
| Mahalliy yo‘qotish og‘irligi | \(\alpha=0{,}5\) |
| To‘lqincha bazasi | Daubechies 4 (db4) |
| Ma’lumot ko‘paytirish koeffitsiyenti | 3 |
| Qo‘shilgan past shovqin darajasi | 0,02 |
Taqqoslangan modellar
MGLSDNet EEGNet, DeepConvNet, EEGConformer, TIDNet, FBCNet, MSVTNet va MTMBCNN bilan taqqoslangan. Taqqoslash guruhi ixcham konvolyutsion tarmoqlar, chuqur konvolyutsion tarmoqlar, Transformer asosidagi tuzilmalar, filter bank ishlatadigan ko‘p shoxobchali modellar va ko‘p vazifali EEG tasniflash usullarini o‘z ichiga oladi.
Asosiy tasniflash natijalari
| Ma’lumotlar to‘plami | Vazifa | MGLSDNet aniqligi | Kappa | Eng yuqori o‘rtachaga ega taqqoslash modeli | Aniqlik farqi | Statistik taqqoslash |
|---|---|---|---|---|---|---|
| BCI Competition IV 2a | To‘rt sinfli | %58,24 ± 6,67 | 0,4451 | MSVTNet: %57,16 ± 11,51 | +1,08 foiz punkt | p=0,6507; farq statistik jihatdan ahamiyatli emas |
| BCI Competition IV 2b | Ikki sinfli | %76,07 ± 6,10 | 0,5215 | TIDNet: %73,24 ± 6,37 | +2,83 foiz punkt | p=0,0308; tadqiqot tomonidan ahamiyatli deb baholangan |
2a ma’lumotlar to‘plamida MGLSDNet to‘qqiz shaxsning beshtasida taqqoslangan usullar orasida eng yuqori aniqlikni bergan. Eng yuqori individual natijalar A01da %62,18, A02da %48,81, A04da %50,46, A06da %54,19 va A07da %67,02 deb xabar qilingan.
2b ma’lumotlar to‘plamida model to‘qqiz shaxsning sakkiztasida eng yuqori aniqlikka erishgan. Yagona istisno B04 bo‘lib, unda MTMBCNN %82,99, MGLSDNet esa %78,41 aniqlik bergan. MGLSDNetning eng yuqori individual natijasi B07da %84,55. Tasniflash qiyin deb ta’riflangan B03 shaxsida aniqlik %62,33 deb xabar qilingan.
Juftlangan t-test natijalari
Quyidagi p qiymatlari MGLSDNet bilan har bir taqqoslash usulining shaxs darajasidagi aniqliklari o‘rtasida o‘tkazilgan juftlangan t-testlardan olingan.
| Taqqoslash usuli | 2a ma’lumotlar to‘plami p qiymati | 2b ma’lumotlar to‘plami p qiymati |
|---|---|---|
| EEGNet | 0,0015 | 0,0003 |
| DeepConvNet | 0,0022 | 0,0001 |
| EEGConformer | 0,0025 | 0,0014 |
| TIDNet | 0,0010 | 0,0308 |
| FBCNet | 0,0071 | 0,0014 |
| MSVTNet | 0,6507 | 0,0002 |
| MTMBCNN | 0,0001 | 0,0324 |
2a ma’lumotlar to‘plamida MSVTNet taqqoslashidan tashqari barcha p qiymatlari 0,01 dan past. 2b ma’lumotlar to‘plamida barcha taqqoslashlar 0,05 dan past. Biroq tadqiqot ko‘p taqqoslash tuzatmasi yoki effekt kattaligini bermagani sababli p qiymatlari o‘zi ustunlik kattaligini ko‘rsatmaydi.
To‘lqincha ma’lumot ko‘paytirish usullarining taqqoslanishi
| Ma’lumotlar to‘plami | Ma’lumot ko‘paytirish yo‘q | Shaxslararo + cD1 | Shaxslararo + cD2 | Shaxs ichida + cD1 | Shaxs ichida + cD2 |
|---|---|---|---|---|---|
| BCI Competition IV 2a | %56,56 ± 6,26 | %58,24 ± 6,67 | %58,16 ± 6,44 | %57,63 ± 6,69 | %57,81 ± 6,52 |
| BCI Competition IV 2b | %74,50 ± 6,35 | %75,88 ± 6,27 | %76,07 ± 6,10 | %75,74 ± 5,72 | %75,36 ± 6,14 |
Ma’lumot ko‘paytirish variantlarining hech biri ko‘paytirishsiz versiyadan past bo‘lmagan. 2a ma’lumotlar to‘plamida eng yuqori natija shaxslararo cD1 almashtirish bilan olinib, ma’lumot ko‘paytirishsiz modelga nisbatan 1,68 foiz punkt oshish bergan. 2b ma’lumotlar to‘plamida eng yuqori natija shaxslararo cD2 almashtirish bilan olinib, oshish 1,57 foiz punkt bo‘lgan.
Shaxslararo almashtirishning yaxshiroq natija berishi turli odamlarga mansub bir xil sinf signallarini birlashtirish trening taqsimotiga ko‘proq xilma-xillik qo‘shadi degan tadqiqotchi talqinini qo‘llab-quvvatlaydi. Biroq tadqiqot yaratilgan namunalar qaysi spektral yoki morfologik xususiyatlari muvaffaqiyat oshishiga sabab bo‘lganini alohida mexanizm tajribasi bilan o‘lchamagan.
O‘z-o‘zini distillash komponentlarining ablatsiya natijalari
| Mahalliy o‘z-o‘zini distillash | Global o‘z-o‘zini distillash | 2a aniqligi | 2b aniqligi |
|---|---|---|---|
| Yo‘q | Yo‘q | %57,21 ± 7,04 | %75,23 ± 6,51 |
| Bor | Yo‘q | %57,86 ± 6,87 | %75,76 ± 6,16 |
| Yo‘q | Bor | %57,79 ± 6,74 | %75,63 ± 6,22 |
| Bor | Bor | %58,24 ± 6,67 | %76,07 ± 6,10 |
Faqat mahalliy o‘z-o‘zini distillash distillashsiz modelga nisbatan 2ada 0,65 va 2bda 0,53 foiz punkt oshish bergan. Faqat global o‘z-o‘zini distillashning oshishi mos ravishda 0,58 va 0,40 foiz punkt. Ikkala komponent birga ishlatilganda oshish 2ada 1,03, 2bda 0,84 foiz punktga yetgan. Natijalar ikki nazorat darajasini birgalikda ishlatish ularni alohida ishlatishdan yuqori o‘rtacha aniqlik berganini ko‘rsatadi.
Topilmalarning umumiy talqini
MGLSDNetning eng aniq ishlash ustunligi ikki sinfli 2b ma’lumotlar to‘plamida ko‘rinadi. To‘rt sinfli 2a ma’lumotlar to‘plamida eng yuqori o‘rtacha aniqlikni berganiga qaramay, MSVTNet bilan farq ahamiyatli emas. Shu sababli tadqiqot 2a uchun MGLSDNet barcha kuchli usullardan aniq ustun ekanini ko‘rsatmaydi.
Tajribalar ma’lumot ko‘paytirish va o‘z-o‘zini distillash komponentlari o‘rtacha aniqlikka alohida-alohida hissa qo‘shishini ko‘rsatadi. Biroq yutuqlar ko‘pincha bir necha foiz punkt yoki bir foiz punktdan kam o‘zgarishlardir. Natijalar istiqbolli metodologik yaxshilanish sifatida baholanishi mumkin; ular xatosiz tasniflash, klinik yetarlilik yoki real dunyoda foydalanishga tayyor BCI tizimi degani emas.
Manba va usul haqida izoh
Tadqiqotning to‘liq asl nomi: Enhancing EEG Domain Generalization via Collaborative Data Augmentation and Multi-Scale Self-Distillation
Mualliflar va to‘g‘ri tartibi: Xiaoyu Li; Qingshan She; Zhipeng Zhou; Yunyuan Gao; Xugang Xi.
Teng birinchi muallif: Tadqiqotda teng hissa yoki teng birinchi mualliflik haqida ma’lumot berilmagan.
Mas’ul muallif: Qingshan She. Tadqiqotda berilgan aloqa manzili: qsshe@hdu.edu.cn.
Muassasalar:
- School of Automation, Hangzhou Dianzi University, Hangzhou, Zhejiang 310018, China.
- Zhejiang Provincial Key Laboratory of Brain Computer Collaborative Intelligence Technology and Applications, Hangzhou, Zhejiang 310018, China.
Jurnal: Tadqiqot uchun taqrizli jurnal ma’lumoti mavjud emas.
Asl nashriyot: Taqrizli jurnal nashriyoti mavjud emas; tadqiqot preprint sifatida chop etilgan.
Nashr platformasi: SSRN.
Nashr yili: 2026.
SSRNda nashr sanasi: 29 Iyul 2026.
Manba turi: Tajribaviy hisoblash usuli va ma’lumot tahlilini o‘z ichiga olgan preprint ilmiy maqola.
Taqriz holati: Ushbu tadqiqot preprint bo‘lib, taqrizdan o‘tmagan. Natijalar ushbu cheklov hisobga olingan holda o‘qilishi kerak.
Rasmiy manba havolasi:https://ssrn.com/abstract=7201285
Taqrizli versiya holati: 5 Avgust 2026 sanasidagi bibliografik tekshiruvda ayni nom bilan nashr qilingan taqrizli jurnal versiyasi tasdiqlanmagan.
Moliyalashtirish: Tadqiqotda Zhejiang Provincial Natural Science Foundation of China LZ26F010007 qo‘llab-quvvatlashi hamda National Natural Science Foundation of China 62371172 va 62371171 grantlari ko‘rsatilgan. Hangzhou Dianzi University Supercomputing Center hisoblash resurslarini taqdim etgani aytilgan.
Manfaatlar to‘qnashuvi: Mualliflar nashr bilan bog‘liq manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Ushbu o‘zbekcha maqola yuklangan tadqiqotning matni, formulalari, jadvallari, rasmlari, psevdokodi, muhokamasi va xulosa bo‘limi ko‘rib chiqilib tayyorlangan. Tadqiqotda mavjud bo‘lmagan tashqi ilmiy topilmalar maqolaga qo‘shilmagan; tashqi manba tekshiruvi faqat DOI, platforma, nashr sanasi va taqrizli versiya holati kabi bibliografik identifikatsiya ma’lumotlari uchun ishlatilgan.
Asosiy cheklovlar: faqat ikkita ma’lumotlar to‘plamida baholash, har bir ma’lumotlar to‘plamida to‘qqiz shaxs, klinik yoki real vaqt amaliyoti yo‘qligi, sessiyalararo umumlashtirish tasdiqlanmagani, to‘lqincha koeffitsiyentini tanlash oldindan belgilangan diapazonlarga tayangani va o‘z-o‘zini distillashning trening xarajati miqdoriy tarzda berilmaganidir. Bundan tashqari, manbada buzilgan cross-reference, ma’lumot ko‘paytirish psevdokodi bilan shaxslararo tajriba tartibi orasida aniqlik muammosi, beta chastota diapazonlarida nomuvofiqlik va aniqlanmagan inferensiya og‘irliklari mavjud.
Tadqiqot natijalari MGLSDNet o‘rganilgan ikkita ochiq ma’lumotlar to‘plamidagi shaxslararo motor tasavvuri EEG tasnifida taqqoslama ishlash yaxshilanishini ta’minlashi mumkinligini ko‘rsatadi. Tadqiqot klinik foyda, xavfsiz real vaqt foydalanish, sanoat masshtabidagi muvaffaqiyat yoki yangi foydalanuvchilarda kalibrlash ehtiyoji yo‘qolganini isbotlamaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan