

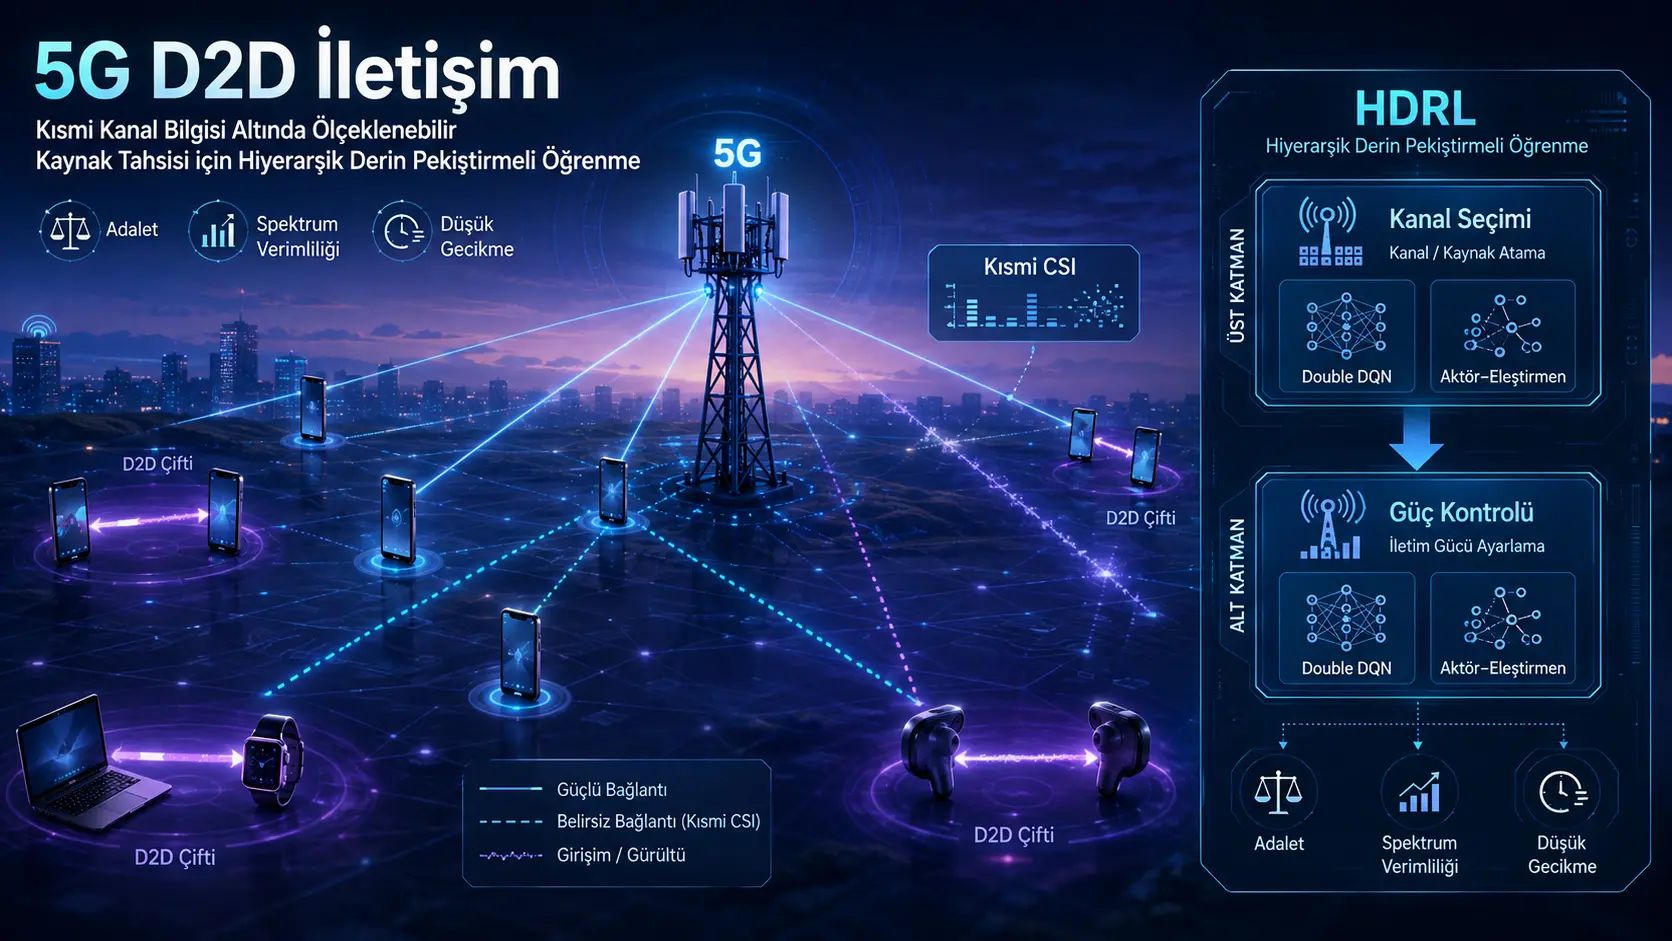
Ushbu tadqiqot 5G uyali tarmoqlarida yaqin qurilmalarning tayanch stansiyaga bormasdan bevosita aloqa qilishini ta’minlaydigan qurilmadan qurilmaga aloqa uchun kanal va uzatish quvvatini taqsimlashni o‘rgangan. Tadqiqotchilar to‘liq kanal holati ma’lumoti mavjud bo‘lmagan sharoitlarda resurs blokini tanlashni Double DQN, uzluksiz quvvat boshqaruvini esa egizak tanqidchili aktor–tanqidchi tuzilmasi orqali amalga oshiradigan ikki qatlamli ierarxik chuqur mustahkamlovchi o‘rganish tizimini taklif qilgan. Simulyatsiyada taklif etilgan usul 108,562 Mbps umumiy ma’lumot uzatish tezligiga, 0,971 Jain adolat indeksiga va 1,542 o‘rtacha mukofotga erishgan. Biroq tizim formulasi bilan foydalanuvchilar soni o‘rtasida muhim resurs taqsimoti nomuvofiqligi mavjud; qisman kanal ma’lumoti modelining parametrlari va turli xato darajalariga nisbatan bardoshlilik natijalari tushuntirilmagan.
Taklif etilgan yondashuvning asosiy g‘oyasi diskret kanal tanlash bilan uzluksiz quvvat boshqaruvini bir xil katta harakatlar fazosida yechish o‘rniga ularni ikkita o‘zaro bog‘langan qaror qatlamiga ajratishdir. Yuqori darajadagi boshqaruvchi har bir D2D juftligi uchun qaysi uyali resurs blokidan qayta foydalanilishini belgilaydi. Quyi darajadagi boshqaruvchi esa tanlangan resurs blokida qo‘llanadigan uzatish quvvatini sozlaydi. Mukofot funksiyasi umumiy ma’lumot uzatish tezligi va foydalanuvchilar o‘rtasidagi adolatni oshirishni, interferensiya, quvvat va xizmat sifati buzilishlarini kamaytirishni ko‘zlaydi.
Turkiya nuqtai nazaridan baholash: Yondashuv Turkiyada xususiy 5G tarmoqlari, aqlli zavodlar, zich IoT tizimlari, transport vositasidan transport vositasiga aloqa, kampus tarmoqlari va ofat paytidagi aloqa ustida ishlaydigan tadqiqot guruhlari uchun moslashtiriladigan resurs boshqaruvi namunasini taqdim etadi. Biroq amaliy qo‘llashdan oldin Turkiyada ishlatiladigan chastotalar, tayanch stansiyalar zichligi, harakatchanlik, bino tuzilishi, interferensiya darajasi va kanalni baholash xatolari bilan ko‘p markazli simulyatsiyalar o‘tkazilishi kerak. Apparatni halqa ichiga olgan tajribalar, haqiqiy radio sinov platformalari, kechikish va energiya o‘lchovlari hamda turli operator tarmoqlarida tashqi tekshiruv ham zarur. Ushbu tadqiqotdan Turkiyadagi jonli mobil tarmoqlarda aynan shu ma’lumot uzatish tezligi oshishiga erishilishi yoki usul bevosita foydalanishga tayyorligi haqida xulosa chiqarib bo‘lmaydi.
Qurilmadan qurilmaga aloqa nima?
Qurilmadan qurilmaga aloqa bir-biriga yaqin ikki foydalanuvchi qurilmasiga ma’lumotni bevosita uzatish imkonini beradi. Shunday qilib, ma’lumot har doim tayanch stansiyaga borib, keyin yana maqsad qurilmaga uzatilishi shart emas. D2D ulanishlari uyali foydalanuvchilar uchun ajratilgan radio resurslardan qayta foydalanib spektr samaradorligini oshirishi, tayanch stansiyadagi trafik yukini kamaytirishi va aloqa kechikishini pasaytirishi mumkin.
Bu foyda bepul emas, chunki D2D uzatgichi uyali foydalanuvchiga yoki tayanch stansiyaga interferensiya keltirib chiqarishi mumkin. Bir xil resurs blokidan foydalanadigan ulanishlarning kanali va uzatish quvvati birgalikda tanlanishi kerak. Haddan tashqari quvvatdan foydalanish bir D2D juftligining ma’lumot uzatish tezligini oshirishi mumkin, biroq boshqa foydalanuvchilarning signal sifatini pasaytiradi.
Qisman kanal holati ma’lumoti nega muhim?
Kanal holati ma’lumoti uzatuvchi bilan qabul qiluvchi o‘rtasidagi radio ulanishning ayni paytdagi sifatini ifodalaydi. To‘liq kanal ma’lumotini olish foydalanuvchi harakatchanligi, baholash xatolari, qayta aloqa kechikishi va signalizatsiya yuklamasi sababli haqiqiy tarmoqlarda qiyin. Shu bois resurs taqsimlash tizimi haqiqiy kanalning o‘zi o‘rniga shovqin yoki kechikishni o‘z ichiga olgan bahoga asoslanib qaror qabul qilishga majbur bo‘lishi mumkin.
Tadqiqotda bevosita D2D kanallari va interferensiya kanallari holatlar fazosiga to‘liq qiymatlari bilan emas, baholangan qiymatlari bilan kiritilgan. Simulyatsiya tavsifida qisman kanal ma’lumoti Gauss shovqini va vaqt bo‘yicha korrelyatsiya yordamida hosil qilingani aytiladi. Biroq shovqin dispersiyasi, korrelyatsiya koeffitsiyenti va kanalni baholash aniqligi berilmagan. Bu yetishmovchilik tajriba sharoitlarini qayta yaratish va modelni turli noaniqlik darajalarida taqqoslashni qiyinlashtiradi.
Tizim modeli qanday qurilgan?
Tadqiqot bir hujayrali tarmoq modelidan foydalangan. Tayanch stansiya uyali foydalanuvchi uskunalari va D2D juftliklariga xizmat ko‘rsatadi. Har bir uyali foydalanuvchiga bitta ortogonal resurs bloki ajratilgan va D2D juftliklariga bu bloklardan qayta foydalanishga ruxsat berilgan.
Tadqiqotning 4. sahifasidagi tizim sxemasi beshta asosiy ulanish turini ko‘rsatadi:
- Uyali foydalanuvchidan tayanch stansiyaga foydali yuqoriga yo‘nalishli ulanish,
- D2D uzatgichidan tayanch stansiyaga yuzaga keladigan qatlamlararo interferensiya,
- Uyali foydalanuvchidan D2D qabul qiluvchisiga yuzaga keladigan qatlamlararo interferensiya,
- D2D uzatgichlari o‘rtasida yuzaga keladigan bir qatlamli interferensiya,
- D2D uzatgichi bilan uning o‘z qabul qiluvchisi o‘rtasidagi bevosita ulanish.
D2D juftligi i uchun signal–interferensiya–shovqin nisbati tadqiqotda quyidagicha modellashtirilgan:
\[ \gamma_i^{D} = \frac{p_i h_{i,i}} {\sum_{j \neq i} p_j h_{j,i} + p_{c_i}^{C} h_{c_i,i} + \sigma^2} \]
Surat D2D uzatgichidan uning o‘z qabul qiluvchisiga yetib keladigan foydali signal quvvatini ifodalaydi. Maxrajda boshqa D2D uzatgichlaridan keladigan bir qatlamli interferensiya, ayni resurs blokidan foydalanadigan uyali foydalanuvchi interferensiyasi va termal shovqin mavjud.
Uyali foydalanuvchi k uchun tayanch stansiyadagi SINR esa quyidagicha berilgan:
\[ \gamma_k^{C} = \frac{p_k^{C} h_{k,B}} {\sum_{i:c_i=k} p_i h_{i,B}+\sigma^2} \]
D2D ulanishlarining uyali resursdan qayta foydalanishi tayanch stansiyadagi uyali signalga interferensiya qo‘shadi. Shu sababli uyali foydalanuvchilarning SINR qiymatini belgilangan minimal chegaradan yuqorida ushlab turish xizmat sifati cheklovi sifatida ta’riflangan.
Ma’lumot uzatish tezligi qanday hisoblangan?
Tadqiqotchilar D2D va uyali ulanishlarning erishish mumkin bo‘lgan ma’lumot uzatish tezliklarini Shannon sig‘imi ifodasi bilan hisoblagan:
\[ R_i^{D}=B\log_2(1+\gamma_i^{D}) \]
\[ R_k^{C}=B\log_2(1+\gamma_k^{C}) \]
Bu yerda B kanal kengligi, R ma’lumot uzatish tezligi va γ tegishli ulanishning SINR qiymatidir. Umumiy D2D ma’lumot uzatish tezligi barcha D2D juftliklari tezliklarining yig‘indisidir:
\[ R_{\mathrm{sum}}^{D}=\sum_{i=1}^{N_d}R_i^{D} \]
Foydalanuvchilar o‘rtasidagi adolat qanday o‘lchangan?
Faqat umumiy ma’lumot uzatish tezligini maksimal qilish yaxshi kanal sharoitiga ega foydalanuvchilarga doimiy ravishda resurs berilib, boshqalarning ortda qolishiga olib kelishi mumkin. Shu sababli tadqiqot Jain adolat indeksidan foydalangan:
\[ J = \frac{\left(\sum_i R_i^{D}\right)^2} {N_d\sum_i\left(R_i^{D}\right)^2} \]
Indeks 0 bilan 1 oralig‘ida qiymat oladi. Qiymatning 1 ga yaqinlashishi D2D foydalanuvchilarining ma’lumot uzatish tezliklari yanada muvozanatli taqsimlanganini ko‘rsatadi. Biroq yuqori Jain indeksi o‘z-o‘zidan barcha foydalanuvchilar yetarli xizmat olayotganini anglatmaydi; past, ammo bir-biriga yaqin ma’lumot uzatish tezliklari ham yuqori adolat qiymatini berishi mumkin.
Resurs taqsimoti qanday optimallashtirish maqsadi bilan ta’riflangan?
Tadqiqotchilar umumiy ma’lumot uzatish tezligi, adolat va energiya samaradorligini oshiradigan; quvvat sarfi hamda SINR buzilishlarini jazolaydigan ko‘p maqsadli muammoni ta’riflagan:
\[ \max_{\mathbf{c},\mathbf{p}} \alpha \bar{R}+\beta J+\eta E-\Phi_P-\Phi_S \]
Bu maqsad D2D va uyali uzatish quvvatlarini chegaralar ichida ushlash, har bir D2D juftligiga resurs bloki ajratish, SINR chegaralarini saqlash va adolat indeksini belgilangan quyi chegaradan yuqorida tutish shartlari bilan birga ko‘rib chiqilgan.
Formuladagi resurs bloki muammosi nima?
Tadqiqotning C3 cheklovi har bir D2D juftligi uyali resurslar to‘plamidan bitta blok tanlashini talab qiladi. C4 cheklovi esa bitta uyali resurs blokidan ko‘pi bilan bitta D2D juftligi foydalanishi mumkinligini bildiradi:
\[ \sum_{i:c_i=k}1\leq 1 \]
Simulyatsiya jadvalida 75 uyali foydalanuvchi va 110 D2D juftligi mavjud. Agar har bir uyali foydalanuvchida faqat bitta resurs bloki bo‘lsa, 75 blok mavjud bo‘ladi. Har bir D2D juftligi bitta blok tanlashi shart va har bir blokdan ko‘pi bilan bitta juftlik foydalanishi mumkin bo‘lsa, 110 juftlikni 75 blokka joylashtirish mumkin emas.
Tarmoq zichligi tajribalarida ham 25 uyali foydalanuvchiga qarshi 40 D2D juftligi, 50 ga qarshi 75, 75 ga qarshi 110, 100 ga qarshi 150 va 125 ga qarshi 200 juftlik ishlatilgan. Barcha konfiguratsiyalarda D2D juftliklari soni resurs bloklari sonidan ko‘p. Model amalda bir nechta D2D juftligiga bir xil blokdan foydalanishga ruxsat beradimi, ayrim juftliklarni xizmatdan tashqarida qoldiradimi yoki C4 cheklovi noto‘g‘ri yozilganmi — bu aniqlashtirilmagan.
Bundan tashqari, agar C4 haqiqatan qo‘llansa, bir xil resurs blokida ikkita D2D juftligi bo‘lmaydi; shu bois D2D SINR tenglamasidagi D2D–D2D bir qatlamli interferensiya yig‘indisi qanday paydo bo‘lishi noaniq. Bu ichki nomuvofiqlik natijalarni talqin qilishdagi eng muhim cheklovlardan biridir.
Muammo nega ierarxik tarzda ajratilgan?
Kanal tanlash diskret, quvvat boshqaruvi esa uzluksiz qarordir. Ikkala qarorni bitta tekis harakatlar fazosida birlashtirish foydalanuvchilar soni oshgani sari juda katta va murakkab qaror muammosini yuzaga keltiradi. Shu bois tadqiqot vazifani ikki qatlamga ajratgan:
- Yuqori qatlam: Double DQN bilan resurs bloki yoki kanal tanlash.
- Quyi qatlam: Aktor–tanqidchi tarmog‘i bilan uzluksiz uzatish quvvatini belgilash.
6. sahifadagi arxitektura sxemasi yuqori qatlamda kirish holati DQN tarmog‘iga uzatilishini, har bir resurs bloki uchun Q qiymatlari hosil qilinishini va epsilon-ochko‘z tanlash orqali bitta blok belgilanishini ko‘rsatadi. Quyi qatlamda aktor tarmog‘i uzluksiz quvvat qiymatini hosil qiladi, tanqidchi tarmoqlar esa holat–harakat juftligining kutiladigan qaytimini baholaydi.
Double DQN nega ishlatilgan?
Standart DQN bir harakatni tanlashda va shu harakat qiymatini hisoblashda bir xil tarmoqdan foydalangani uchun Q qiymatlarini haqiqatdagidan yuqori baholashi mumkin. Double DQN harakat tanlashni onlayn tarmoq bilan, qiymat baholashni esa maqsad tarmog‘i bilan bajarib, bu og‘ishni kamaytirishni ko‘zlaydi:
\[ y=r+\gamma Q\left( s', \arg\max_{a'}Q(s',a';\theta); \theta^{-} \right) \]
Bu yerda θ onlayn tarmoqning, θ− maqsad tarmog‘ining parametrlarini; γ esa kelajakdagi mukofotlarning og‘irligini belgilovchi diskont koeffitsiyentini anglatadi.
Quvvat boshqaruvi qanday amalga oshirilgan?
Aktor tarmog‘i 0 bilan 1 orasida uy chiqishini hosil qiladi. Bu chiqish quvvat chegarasiga quyidagi akslantirish bilan o‘tkazilgan:
\[ p_y=(0{,}05+0{,}95u_y)P_{\max} \]
Bu akslantirish o‘qitish paytida nol quvvat tanlanishini oldini oladi va minimal quvvatni maksimal quvvatning %5’i sifatida belgilaydi. Biroq optimallashtirish cheklovlarida quvvatning nol bo‘lishiga ruxsat berilgani sababli matematik model bilan amaliyot o‘rtasida kichik farq yuzaga keladi.
Quyi qatlamda ikkita tanqidchi tarmoq ishlatilgan:
\[ y=r+\gamma\min \left(Q_1(s',a'),Q_2(s',a')\right) \]
Ikki Q qiymatidan kichigini ishlatish qiymatlarni ortiqcha baholashni kamaytirishga qaratilgan. Kechiktirilgan siyosat yangilanishi va maqsad harakatini silliqlash kabi TD3 dan ilhomlangan usullar qo‘llangani aytilgan. Biroq tarmoq qatlamlari, yashirin o‘lchamlar, faollashtirish funksiyalari, maqsad yangilash koeffitsiyenti va tadqiqot shovqini kabi tafsilotlar berilmagan.
Markazlashgan o‘qitish va taqsimlangan bajarish nimani anglatadi?
Tadqiqot markazlashgan o‘qitish–taqsimlangan bajarish yondashuvini qabul qilgan. O‘qitish paytida global tarmoq ma’lumotlariga kirish mumkinligi, haqiqiy bajarish paytida esa har bir D2D foydalanuvchisi mahalliy kuzatuviga ko‘ra qaror qabul qilishi aytilgan.
D2D agenti y uchun mahalliy holat baholangan bevosita kanal kuchayishi, kuzatilgan interferensiya, oldingi quvvat va oldingi kanalning kodlangan ko‘rinishidan iborat:
\[ s_y^{\mathrm{local}}= \left[ \hat{g}_y^{(d)}, \hat{I}_y, p_y^{\mathrm{prev}}, e(c_y^{\mathrm{prev}}) \right] \]
Biroq nechta mustaqil agent borligi, tarmoq parametrlari foydalanuvchilar o‘rtasida bo‘lishiladimi, markazlashgan tanqidchi qaysi global ma’lumotni olishi va bir vaqtdagi qarorlar qanday muvofiqlashtirilishi batafsil tushuntirilmagan.
Mukofot funksiyasi nimani muvozanatlashtiradi?
Asosiy mukofot ifodasi umumiy ma’lumot uzatish tezligi va adolatni oshirar ekan, cheklov buzilishlarini jazolaydi:
\[ r_t=\alpha R_{\mathrm{sum}}+\beta J-\lambda\cdot\mathrm{Penalty} \]
Jazo hadi SINR buzilishlari, uyali foydalanuvchilarga berilgan ortiqcha interferensiya va ortiqcha quvvat sarfini qamrab olishi aytilgan. SINR buzilishi uchun yana quyidagi ifoda berilgan:
\[ \Phi_S=\sum_{i=1}^{N_d} \max(0,\gamma_{\min}-\mathrm{SINR}_i) \]
Mukofot og‘irliklari bo‘lgan α, β va λ uchun qo‘llangan sonli qiymatlar ochiqlanmagan. Bu qiymatlar ma’lumot uzatish tezligi bilan adolat o‘rtasida qanday afzallik tanlanganiga bevosita ta’sir qilgani uchun qayta ishlab chiqish nuqtai nazaridan muhim.
Tadqiqot PPO dan foydalanadimi?
Kirish qismida “PPO uslubidagi siyosat optimallashtirish” iborasi mavjud. Biroq usul bo‘limida PPO ning ehtimollik nisbati, kesilgan surrogat maqsad funksiyasi yoki afzallik baholashi ta’riflanmagan. Tushuntirilgan haqiqiy arxitektura Double DQN bilan TD3 ga o‘xshash egizak tanqidchili aktor–tanqidchi birikmasidir. Shu sababli tadqiqotni PPO asosidagi tizim sifatida ta’riflash to‘g‘ri emas.
Tajriba tuzilishi qanday?
Simulyatsiyalar Python va PyTorch yordamida NVIDIA A100 GPU mavjud kompyuterda bajarilgan. Kanal modeli Rayleigh so‘nishiga asoslangan, qisman kanal ma’lumoti esa vaqt bo‘yicha korrelyatsiyalangan Gauss shovqini bilan ifodalangan.
| Parametr | Tadqiqotda berilgan qiymat |
|---|---|
| Hujayra radiusi | 500 metr |
| Uyali foydalanuvchilar soni | 75 |
| D2D juftliklari soni | 110 |
| O‘qitish bo‘limi | 200 episode |
| Har bir bo‘limdagi qadam | 40 |
| Mini-batch hajmi | 64 |
| Double DQN o‘rganish tezligi | 1 × 10⁻⁴ |
| Aktor o‘rganish tezligi | 1 × 10⁻⁴ |
| Tanqidchi o‘rganish tezligi | 2 × 10⁻⁴ |
| Tasodifiy urug‘lar | 0, 1 va 2 |
| Protsessor | Intel Xeon w7-2575X |
| Xotira | 128 GB |
| GPU | NVIDIA A100, 40 GB |
| Dasturiy ta’minot | PyTorch 2.7.1, CUDA 12.5, cuDNN 9.3, Python 3.13.7 |
Taqqoslash usullari klassik Q-learning, DQN va kanal kuchayishiga ko‘ra resurs taqsimlaydigan RACG evristik usulidir. Yaqinroq arxitekturaga ega PPO, DDPG, TD3, tekis gibrid aktor–tanqidchi yoki zamonaviy ko‘p agentli DRL bazaviy usullari mavjud emas.
Asosiy natijalar qanday?
| Usul | Umumiy ma’lumot uzatish tezligi (Mbps) | Jain adolat indeksi | O‘rtacha mukofot |
|---|---|---|---|
| Q-Learning | 84,932 | 0,969 | 1,368 |
| DQN | 85,193 | 0,968 | 1,359 |
| RACG | 84,740 | 0,968 | 1,347 |
| Taklif etilgan HDRL | 108,562 | 0,971 | 1,542 |
Taklif etilgan usul tadqiqotdagi DQN bazaviy usuliga nisbatan umumiy ma’lumot uzatish tezligini taxminan %27,4, o‘rtacha mukofotni esa taxminan %13,5 oshirgan. Adolat indeksidagi mutlaq farq atigi 0,003. Q-learning bilan taqqoslanganda ma’lumot uzatish tezligi oshishi taxminan %27,8, RACG bilan taqqoslanganda esa taxminan %28,1.
Bu qiymatlar ishlatilgan simulyatsiya ichida umumiy ma’lumot uzatish tezligida sezilarli farqni ko‘rsatadi. Biroq adolat bo‘yicha barcha usullar allaqachon 0,968 bilan 0,971 orasidagi tor diapazonda. Demak, HDRLning asosiy sonli yutug‘i adolatdan ko‘ra umumiy ma’lumot uzatish tezligidadir.
Yaqinlashish grafiklari nimani ko‘rsatadi?
8. sahifadagi umumiy ma’lumot uzatish tezligi grafigida barcha usullar o‘qitish boshida taxminan 85 Mbps darajasida. HDRL egri chizig‘i 40–60. bo‘limlar orasida tez ko‘tarilib taxminan 108–109 Mbps darajasiga yetadi, boshqa usullar esa 85 Mbps atrofida qoladi.
Adolat grafigida HDRL o‘qitish paytida vaqtinchalik pasayishni boshdan kechirib, keyin 0,971 atrofida tiklangani ko‘rinadi. Mukofot grafigida ham taxminan 40. bo‘limdan keyin aniq sakrash va 1,55 atrofida barqaror davom etish mavjud.
Grafik sarlavhalarida o‘rtacha qiymat va standart og‘ish ko‘rsatilgani aytilgan bo‘lsa-da, standart og‘ishlar jadval ko‘rinishida berilmagan. Faqat uchta tasodifiy urug‘dan foydalanilishi, ayniqsa yuqori o‘zgaruvchanlikka ega mustahkamlovchi o‘rganish tajribalarida cheklangan takrorlash sonidir.
Tarmoq zichligi oshganda nima bo‘lgan?
9. sahifadagi tajribalarda uyali foydalanuvchi va D2D juftliklari soni mos ravishda quyidagi konfiguratsiyalarda oshirilgan:
- 25 uyali foydalanuvchi va 40 D2D juftligi,
- 50 uyali foydalanuvchi va 75 D2D juftligi,
- 75 uyali foydalanuvchi va 110 D2D juftligi,
- 100 uyali foydalanuvchi va 150 D2D juftligi,
- 125 uyali foydalanuvchi va 200 D2D juftligi.
Umumiy ma’lumot uzatish tezligi barcha usullarda foydalanuvchilar soni bilan oshgan, HDRL grafikda eng yuqori egri chiziqni hosil qilgan. HDRL taxminan 40 Mbps dan 200 Mbps gacha ko‘tarilganida eng yaqin bazaviy usul zich konfiguratsiyada taxminan 155 Mbps ga yetgan.
Adolat egri chizig‘ida HDRL barcha zichliklarda taxminan 0,973–0,975 oralig‘ida qoladi. O‘rtacha mukofot egri chizig‘ida HDRL taxminan 1,54–1,57 oralig‘ini saqlagan, bazaviy usullarning mukofotlari esa zichlik oshgani sari pasaygan. Biroq resurs bloki cheklovi bu foydalanuvchi sonlari bilan qanday qo‘llangani tushuntirilmagani sababli masshtablanuvchanlik natijasining matematik modelga muvofiqligi noaniq.
O‘rganish tezligi natijalarga qanday ta’sir qilgan?
10. sahifadagi birinchi grafiklar guruhi 10−5, 5×10⁻⁵, 10−4 va 5×10⁻⁴ o‘rganish tezliklarini taqqoslaydi. Yuqoriroq o‘rganish tezliklari umumiy ma’lumot uzatish tezligi va mukofot bo‘yicha tezroq yaqinlashishni ko‘rsatgan. Eng past o‘rganish tezligi sekinroq rivojlangan va 200 bo‘lim oxirida pastroq samaradorlikda qolgan.
Adolat qiymatlari o‘qitish paytida tebrangan, ayrim sozlamalarda vaqtinchalik pasayishlar kuzatilgan, biroq egri chiziqlar ko‘pincha 0,96 dan yuqorida tiklangan. Tadqiqot turli o‘rganish tezliklari natijalarini grafikda ko‘rsatadi, ammo har bir tezlik uchun yakuniy samaradorlik qiymatlari va dispersiyalarni jadval shaklida bermaydi.
Qaysi optimizator yaxshiroq natija bergan?
Adam, AdamW, RMSProp va SGD optimizatorlari taqqoslangan. Adam, AdamW va RMSProp umumiy ma’lumot uzatish tezligida SGD ga qaraganda biroz tezroq yaqinlashgan. SGD mukofot va adolat egri chiziqlarida yuqoriroq tebranish ko‘rsatgan.
Grafiklarga ko‘ra moslashuvchan optimizatorlar o‘xshash yakuniy ma’lumot uzatish tezligiga erishgan. Shu sababli natija bitta optimizatorning aniq ustunligini emas, balki SGD bu tajribada beqarorroq bo‘lganini ko‘rsatadi.
Ma’lumot uzatish tezligi–adolat muvozanati nimani ko‘rsatgan?
10. sahifadagi oxirgi grafik umumiy ma’lumot uzatish tezligi bilan Jain adolat indeksini bir tekislikda taqqoslaydi. HDRL taxminan 109 Mbps va 0,972 adolat bilan o‘ng yuqori hududda joylashgan, bazaviy usullar esa taxminan 85–86 Mbps oralig‘ida to‘plangan.
Bu ko‘rinish HDRL ishlatilgan tajribada umumiy ma’lumot uzatish tezligini oshirar ekan, adolat qiymatini saqlaganini ko‘rsatadi. Biroq bitta nuqtali umumlashtiruvchi grafik turli mukofot og‘irliklari ostida yuzaga kelishi mumkin bo‘lgan haqiqiy Pareto egri chizig‘ini ko‘rsatmaydi. Ma’lumot uzatish tezligi va adolat o‘rtasidagi tanlovlarni kuchliroq baholash uchun turli α va β qiymatlari bilan tajribalar o‘tkazilishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan natijalar qanday?
- Diskret kanal tanlash bilan uzluksiz quvvat boshqaruvini ierarxik ikkita boshqaruvchiga ajratish mumkin.
- Double DQN va egizak tanqidchili aktor–tanqidchi birikmasi ishlatilgan simulyatsiyada Q-learning, DQN va RACG dan yuqori umumiy ma’lumot uzatish tezligini hosil qilgan.
- Taklif etilgan usul ma’lumot uzatish tezligi oshganida Jain adolat indeksini taxminan shu yuqori darajada saqlagan.
- Tarmoq zichligi oshganda HDRL egri chiziqlari ishlatilgan bazaviy usullardan yuqorida qolgan.
- O‘rganish tezligi va optimizator tanlovi yaqinlashish tezligi hamda o‘qitish barqarorligiga ta’sir qilgan.
Tadqiqot nimani ko‘rsatmaydi?
- Usulning haqiqiy 5G tayanch stansiyasi yoki jismoniy D2D qurilmalarida ishlashini ko‘rsatmaydi.
- Kechikish, paket yo‘qolishi, ishonchlilik, signalizatsiya yuklamasi yoki haqiqiy energiya sarfi o‘lchanmagan.
- Model turli CSI xato kattaliklarida bardoshli ekanini tizimli tarzda ko‘rsatmaydi.
- HDRL zamonaviy PPO, TD3, DDPG yoki ko‘p agentli usullardan ustun ekanini isbotlamaydi.
- Taqsimlangan bajarishning aloqa xarajati, qaror kechikishi yoki xavfsizligini baholamaydi.
- Turkiyadagi operator tarmoqlarida bir xil natijalar olinishi mumkinligini ko‘rsatmaydi.
- Formuladagi resurs bloki nomuvofiqligi hal qilinmasdan bildirilgan masshtablanuvchanlik jismonan amalga oshirilishi mumkinligini isbotlamaydi.
Tadqiqot usuli va natijalari
Usul oqimining qisqacha mazmuni
- Bir hujayrali D2D qo‘llab-quvvatlanadigan tarmoq muhiti yaratilgan.
- Uyali va D2D foydalanuvchilari 500 metrlik hujayra ichiga tasodifiy joylashtirilgan.
- Rayleigh so‘nishidan foydalanib kanal kuchayishlari hosil qilingan.
- Kanal baholariga vaqt bo‘yicha korrelyatsiyalangan Gauss shovqini qo‘shilib qisman CSI yaratilgan.
- Holat vektoriga baholangan kanallar, oldingi kanal va oldingi quvvat ma’lumotlari kiritilgan.
- Double DQN yuqori qatlami resurs blokini tanlagan.
- Aktor tarmog‘i tanlangan blok uchun uzatish quvvatini hosil qilgan.
- SINR, ma’lumot uzatish tezligi, adolat va jazo qiymatlari hisoblangan.
- O‘tishlar tajribani qayta ishlatish xotirasiga saqlangan.
- Double DQN, aktor, ikkita tanqidchi va maqsad tarmoqlari yangilangan.
- 200 bo‘lim oxirida natijalar bazaviy usullar bilan taqqoslangan.
Usul tafsilotlarining to‘liqligini baholash
| Tarkibiy qism | Tadqiqotda tushuntirilgan ma’lumot | Yetishmaydigan yoki noaniq ma’lumot |
|---|---|---|
| Kanal modeli | Rayleigh so‘nishi | Yo‘l yo‘qotishi modeli, soyalanish, tashuvchi chastota va kanal kengligi |
| Qisman CSI | Gauss shovqini va vaqt bo‘yicha korrelyatsiya | Shovqin dispersiyasi va korrelyatsiya koeffitsiyenti |
| Yuqori boshqaruvchi | Double DQN | Tarmoq qatlamlari, tadqiqot jadvali va maqsad yangilash chastotasi |
| Quyi boshqaruvchi | Aktor–tanqidchi, egizak tanqidchi, kechiktirilgan yangilash | Tarmoq arxitekturasi, harakat shovqini va yumshoq yangilash koeffitsiyenti |
| Tajribani qayta ishlatish | Qayta ishlatish xotirasidan foydalanish | Xotira sig‘imi va ustuvorlashtirish usuli |
| Mukofot | Ma’lumot uzatish tezligi, adolat va jazo tarkibiy qismlari | Og‘irlik koeffitsiyentlarining sonli qiymatlari |
| Quvvat modeli | Maksimal quvvatning %5–100 oralig‘i | Maksimal quvvatning sonli qiymati |
| Xizmat sifati | Minimal SINR cheklovlari | Minimal SINR chegaralarining qiymatlari |
| Takrorlash soni | Uchta tasodifiy urug‘ | Sonli standart og‘ish va ishonch oraliqlari |
| Qayta ishlab chiqish imkoniyati | Dasturiy va apparat versiyalari | Manba kodi va simulyatsiya ma’lumot fayllari |
Sonli yutuqlarning konteksti
108,562 Mbps qiymati haqiqiy dala o‘lchovi emas, balki ta’riflangan simulyatsiya muhitidagi umumiy D2D ma’lumot uzatish tezligidir. Taxminan %27–28 atrofidagi oshish faqat tanlangan uchta bazaviy usulga, bir xil kanal modeliga va tadqiqotda qo‘llangan mukofot sozlamalariga nisbatan amal qiladi.
Adolat indeksidagi oshish son jihatdan kichik. HDRLning 0,971 qiymati DQN va RACGning 0,968 qiymatidan 0,003, Q-learningning 0,969 qiymatidan 0,002 yuqori. Shu sababli “adolatli resurs taqsimoti saqlangan” degan ibora qo‘llab-quvvatlanadi, “adolatda katta yaxshilanish” degan ibora esa qo‘llab-quvvatlanmaydi.
Natijalarning ishonchliligini oshirish uchun zarur tajribalar
- Resurs bloki cheklovlari va foydalanuvchilar sonini matematik jihatdan mos holga keltirish,
- Turli kanalni baholash xatosi dispersiyalari va qayta aloqa kechikishlari bilan CSI bardoshliligini tekshirish,
- PPO, TD3, DDPG, tekis gibrid aktor–tanqidchi va ko‘p agentli DRL taqqoslashlari,
- Ierarxiya, egizak tanqidchi, adolat mukofoti va CTDE tarkibiy qismlari uchun ablatsiya tajribalari,
- Kamida besh yoki o‘nta tasodifiy urug‘ bilan ishonch oraliqlari va statistik taqqoslashlar,
- Kechikish, energiya sarfi, paket yo‘qolishi, QoS buzilish darajasi va hisoblash vaqtini o‘lchash,
- Turli hujayra radiuslari, harakatchanlik tezliklari va kanal modellari bilan tashqi simulyatsiya tekshiruvi,
- Manba kodi, konfiguratsiya fayllari va tasodifiy urug‘larni e’lon qilish,
- Dasturiy aniqlanadigan radio yoki apparatni halqa ichiga olgan sinov platformasida tekshirish.
Manba va usul bo‘yicha izoh
Tadqiqotning to‘liq asl nomi: Hierarchical Deep Reinforcement Learning for Scalable Resource Allocation in D2D Communication under Partial Channel State Information in 5G Networks
Mualliflar: Rohit Singh Thakur va Pavan Kumar Mishra
Mualliflar tartibi: Rohit Singh Thakur, Pavan Kumar Mishra
Teng hissa ma’lumoti: Tadqiqotda teng hissa yoki teng birinchi mualliflik bayonoti mavjud emas.
Mas’ul muallif: Rohit Singh Thakur. Ko‘rinadigan tadqiqotda yulduzcha bilan, SSRN qaydida “Contact Author” sifatida ko‘rsatilgan.
Muassasa: Department of Information Technology, National Institute of Technology Raipur, India
Jurnal: Tadqiqot jurnalda chop etilmagan.
Asl jurnal nashriyoti: Mavjud emas.
Nashr platformasi: SSRN
Yuklangan sana: 24 Iyun 2026
Nashr yili: 2026
Manba turi: Simulyatsiyaga asoslangan eksperimental simsiz aloqa va chuqur mustahkamlovchi o‘rganish preprinti
Peer-review holati: Tadqiqot peer-reviewdan o‘tmagan. Sahifalar pastida ham “Preprint not peer reviewed” ogohlantirishi mavjud.
Rasmiy havola:SSRN tadqiqot sahifasi
SSRN qayd sahifasida birinchi muallifning ismi “Rohit Singh Singh Thakur” shaklida takrorlangan. Ko‘rinadigan tadqiqot muqovasida va elektron pochta satrida “Rohit Singh Thakur” nomi ishlatilgan. Ushbu maqolada ko‘rinadigan tadqiqotdagi ism asos qilib olingan.
Ushbu turkcha maqola yuklangan 12 sahifalik tadqiqotning matni, tenglamalari, jadvallari, algoritmi va 11 shakli ko‘rib chiqilib tayyorlangan. Ilmiy natijalar faqat tadqiqotda bildirilgan simulyatsiyalarga asoslanadi. Tashqi manbalar sarlavha, muallif, muassasa, DOI, platforma, sana va peer-review holatini bibliografik tekshirish maqsadida ishlatilgan.
Tadqiqot natijalari resurs bloki cheklovlari bilan foydalanuvchilar soni o‘rtasidagi nomuvofiqlik, qisman CSI parametrlarining yetishmasligi, cheklangan bazaviy usullar, uchta tasodifiy urug‘, e’lon qilinmagan manba kodi va dala tekshiruvi mavjud emasligini hisobga olgan holda o‘qilishi kerak. Ushbu tadqiqot haqiqiy 5G tarmog‘ida operatsion muvaffaqiyat yoki tijoriy foydalanishga tayyor yechimni isbotlamaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan