

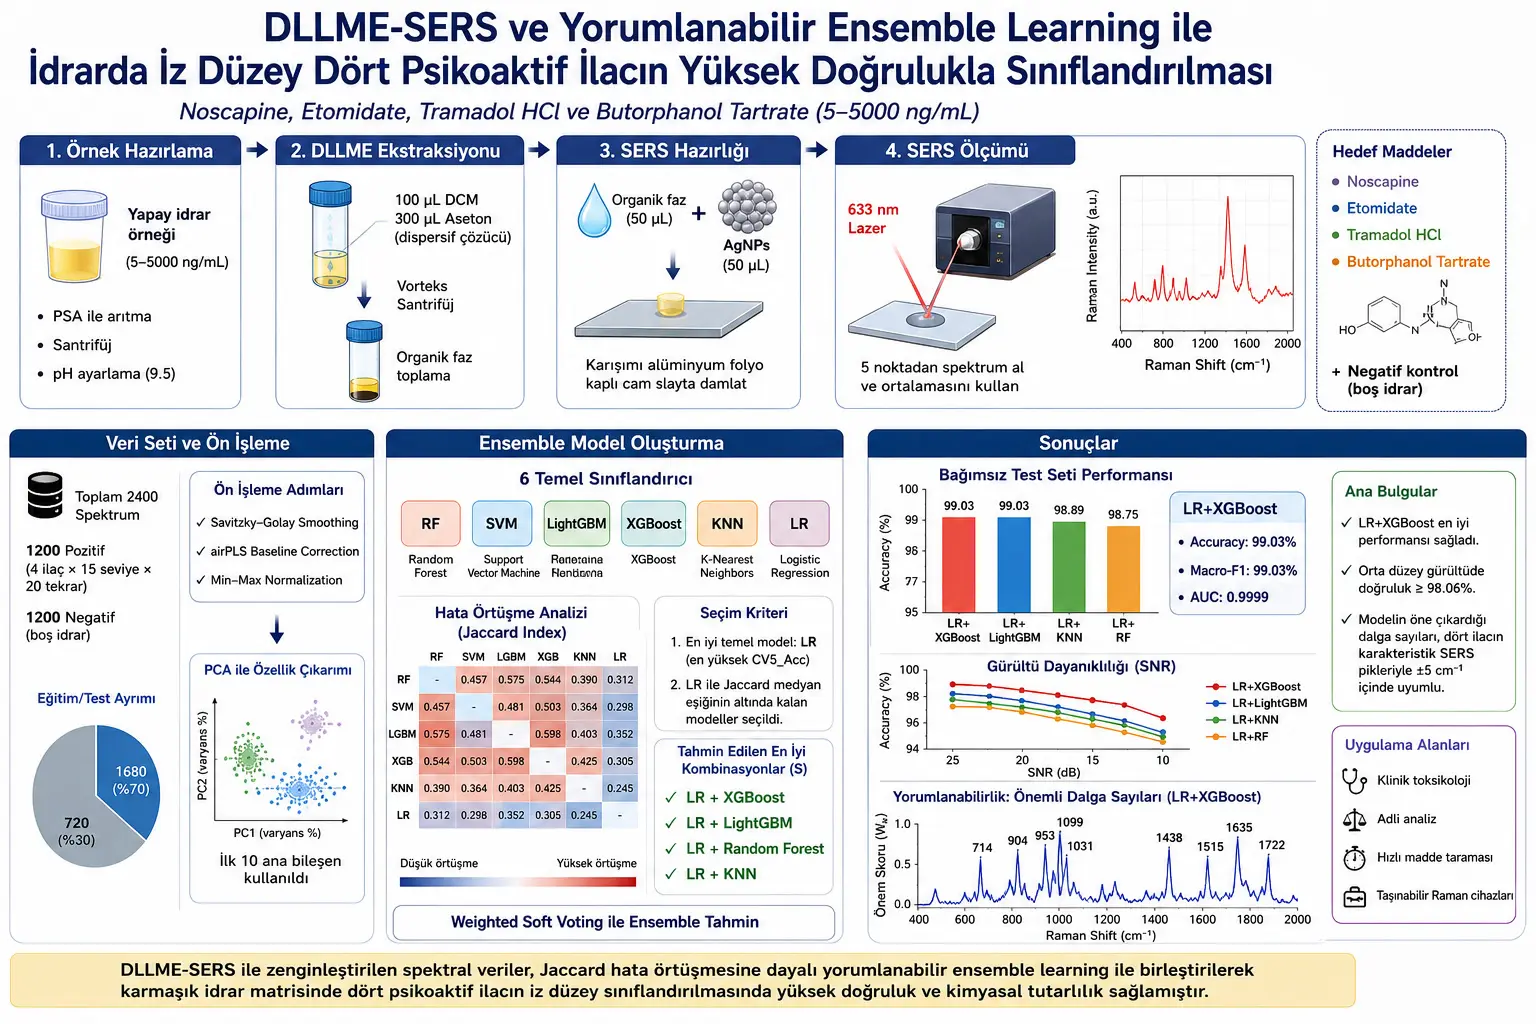
Сӯиистифода аз моддаҳои психоактивӣ ба мушкиле табдил ёфтааст, ки ҳам барои тандурустии ҷамъиятӣ ва ҳам барои илмҳои судӣ аҳамияти рӯзафзун дорад. Махсусан дар ҳолатҳое, ки дар як муҳити биологӣ метавонад якчанд дору ё моддаҳои сохтори кимиёии монанд мавҷуд бошанд, таҳлил танҳо ба саволи “оё модда ҳаст?” маҳдуд намешавад. Ҳамчунин бояд боэътимод муайян карда шавад, ки кадом модда мавҷуд аст, дар кадом диапазони консентратсия қарор дорад ва оё сигнал воқеан ба ҳамон молекула тааллуқ дорад.
Пешоб яке аз намунаҳои биологиест, ки дар скрининги моддаҳо зуд-зуд истифода мешавад. Сабаб дар он аст, ки гирифтани намуна нисбатан осон ва non-invasive мебошад. Аммо таҳлили пешоб аз ҷиҳати кимиёӣ содда нест. Протеинҳо, мочевина, намакҳо, метаболитҳо ва дигар ҷузъҳои эндогенӣ метавонанд сигналҳои моддаи ҳадафро пӯшонанд. Илова бар ин, тавре ки таҳқиқот таъкид мекунад, analyte-ҳои ҳадаф метавонанд дар сатҳи ng/mL бошанд. Яъне миқдори моддаи таҳлилшаванда хеле кам аст ва стратегияи қавии афзоиши сигнал ё пешазғанисозӣ лозим мешавад.
Дар байни усулҳои анъанавӣ техникаҳои chromatography-mass spectrometry монанди GC-MS ва LC-MS/MS қавӣ ва боэътимод ҳисоб мешаванд. Аммо ин низомҳо таҷҳизоти гарон, кормандони омӯзонидашуда, равандҳои мураккаби омодасозӣ ва инфрасохтори лабораториро талаб мекунанд. Immunochromatographic tests метавонанд зуд бошанд, вале мушкилоте монанди cross-reaction, false positive ва маҳдудият дар ҷудокунии чанд моддаро доранд. Аз ин рӯ, муҳаққиқон ба равишҳои спектроскопие рӯ меоранд, ки тезтар, арзонтар ва қодир ба додани molecular fingerprint бошанд.
Raman spectroscopy техникаест, ки аз рӯи vibrational modes-и молекулаҳо “chemical fingerprint” тавлид мекунад. Ҳар молекула вобаста ба сохтори пайвандҳо ва хусусиятҳои ларзишӣ дар wavenumber-ҳои муайян сигнал медиҳад. Аммо normal Raman signal аксар вақт заиф аст. Дар ҳамин ҷо SERS ба кор меояд. Nanostructures-и noble metals монанди silver ё gold майдони электромагнитиро дар наздикии молекула қавӣ карда, Raman signal-ро чанд дараҷа зиёд мекунанд. Ҳамин тавр, сигналҳои молекулавии сатҳи trace, ки одатан хеле заифанд, ченшаванда мешаванд.
Дар ин таҳқиқот пеш аз SERS DLLME истифода шудааст. Ҳадафи DLLME кашидани моддаҳои ҳадаф аз пешоб ба як organic phase-и хурд ва ғанӣ кардани онҳо то сатҳест, ки сигнал гирифтан мумкин шавад. Бо мисоли рӯзмарра, тасаввур кунед дар як стакани калон об миқдори бисёр ками модда ҳал шудааст. Чен кардани он бевосита метавонад мушкил бошад. Аммо агар онро дар як қатраи хурд мутамарказ кунед, чен кардан осонтар мегардад. DLLME бо мантиқи монанд кор мекунад: target molecules-и сатҳи пастро аз намунаи мураккаб ба ҳаҷми хурди solvent phase ҷамъ мекунад.
Раванди омодасозии намуна аз чанд қадам иборат буд. Аввал ба пешоби сунъӣ доруҳои ҳадаф илова карда шуданд. Барои тозакунии пешоб аз 2.0 mL spiked пешоби сунъӣ, яъне намунаи пешоби сунъии дорои модда, истифода шуда, ба он 100 mg PSA илова гардид; омехта vortex ва centrifuge карда шуд. Сипас аз supernatant 1.0 mL гирифта, ба марҳилаи extraction гузаштанд.
Дар марҳилаи DLLME pH-и намуна ба 9.5 танзим карда шуд. Баъд 100 μL dichloromethane ҳамчун extraction solvent ва 300 μL acetone ҳамчун dispersive solvent зуд илова гардид. Омехта vortex шуда, cloudy emulsion ташкил кард; пас аз centrifugation organic phase-и поёнӣ бо microsyringe ҷамъ оварда шуд. Ин марҳила target molecules-ро дар фазае мутамарказ кард, ки барои таҳлил мувофиқтар буд.
Барои қавӣ кардани SERS signal аз silver nanoparticles истифода шуд. Ин particles ҳамчун AgNPs ихтисор мешаванд ва бо Lee-Meisel citrate reduction усул омода гардиданд. Дар таҳқиқот silver nitrate solution ҷӯшонида шуд, trisodium citrate илова гардид ва бо зард-сабз шудани маҳлул ташаккули nanoparticles мушоҳида шуд. Аз рӯи SEM characterization, particles морфологияи нимкуравӣ бо диаметри миёнаи тақрибан 60 nm доштанд.
Барои spectral measurement аз portable Raman detection system, ки дар лаборатория сохта шуда буд, истифода гардид. Система бо laser-и 633 nm кор мекард. Аз organic phase 50 μL гирифта, бо ҳаҷми баробари concentrated silver nanoparticle solution омехта шуд; сипас 10 μL-и омехта ба clean glass slide-и пӯшида бо aluminum foil қатра карда шуд. Барои ҳар намуна аз панҷ нуқтаи гуногуни сатҳи қатра spectrum гирифта шуда, миёнаи онҳо ҳамчун спектри намояндагӣ истифода гардид.
додаҳо set хеле муназзам сохта шудааст. Барои ҳар доруи ҳадаф дар 15 concentration levels 20 independently prepared намунаҳо чен шудаанд. Ин бо ҳисоби 4 drugs × 15 concentrations × 20 намунаҳо, 1200 спектрҳои мусбат медиҳад. Илова бар ин, аз blank пешоби сунъӣ, ки ҳамон тартибро гузашта буд, 1200 спектрҳои манфӣ гирифта шуданд. Ҳамин тавр, дар маҷмӯъ 2400 spectra ба даст омад. Spectral диапазон ҳамчун 159–1996 cm⁻¹ дода шудааст.
Raw Raman/SERS spectra бевосита ба модел дода нашуданд. Аввал бо Savitzky-Golay smoothing noise кам шуд, бо airPLS baseline correction background curve ислоҳ гардид ва бо Min-Max normalization signals ба диапазони 0–1 миқёсгузорӣ шуданд. Чунин preprocessing steps дар spectroscopy хеле муҳиманд, зеро намехоҳем модел ба ҷои chemical differences воқеӣ device noise, baseline drift ё intensity-scale differences-ро омӯзад.
Баъд маҷмӯи додаҳо бо таносуби 7:3 ба омӯзиш ва маҷмӯи санҷиши мустақил ҷудо шуд. 1680 spectra ба маҷмӯи омӯзишӣ ва 720 spectra ба маҷмӯи санҷиши мустақил гузошта шуданд. Нуктаи махсусан муҳим ин аст, ки PCA ва StandardScaler parameters танҳо аз маҷмӯи омӯзишӣ омӯхта шуда, маҷмӯи санҷишӣ бо ҳамон transformation project карда шуд. Ин барои пешгирии information leakage муҳим аст. Агар маълумоти маҷмӯи санҷишӣ дар preprocessing ба модел ворид шавад, самаранокии санҷишӣ метавонад аз воқеият баландтар намоён шавад.
Барои feature extraction PCA, яъне principal component analysis истифода шудааст. PCA high-dimensional spectral додаҳо-ро ба шумораи камтари components коҳиш медиҳад. Spectrum метавонад садҳо ё ҳазорҳо wavenumber points дошта бошад, вале ҳамаи онҳо барои classification яксон информативӣ нестанд. PCA бузургтарин манбаъҳои variation-ро ба axes-и нав табдил дода, feature space-и идорашаванда медиҳад.
Дар таҳқиқот шумораи PCA components бо LightGBM probe модел арзёбӣ шуд. Тавре ки дар Figure 3a нишон дода шудааст, дақиқӣ дар атрофи n=8 ба plateau расид ва баъд аз n=10 improvement-и назаррас надошт. Аз ин рӯ, 10 principal components-и аввал нигоҳ дошта шуданд. Ин маънои онро дорад, ки модел ба ҷои спектри хом дар 10-dimensional PCA feature space кор кардааст.
Figures 3b ва 3c separation-и байни classes-ро бо PCA three-dimensional scatter plot ва t-SNE embedding нишон медиҳанд. Дар се principal component-и аввал баъзе clustering tendencies дида мешавад, аммо boundaries комилан равшан нестанд. Махсусан байни noscapine, etomidate ва negative control overlap дида мешавад. t-SNE барои etomidate ва tramadol hydrochloride clusters-и compactтар нишон медиҳад, дар ҳоле ки negative control дар баъзе class boundaries паҳн мешавад. Ин нишон медиҳад, ки танҳо simple linear separation кофӣ нест ва classifiers бояд discriminative information-и нозуктарро гиранд.
Дар қисми machine learning шаш classifier-и асосӣ арзёбӣ шуданд: Random Forest, Support Vector Machine, LightGBM, XGBoost, K-Nearest Neighbors ва Logistic Regression. Ин моделҳо algorithmic families-и гуногунро намояндагӣ мекунанд. Logistic Regression равиши бештар linear ва statistical медиҳад, XGBoost ва LightGBM gradient-boosted tree моделҳо мебошанд. SVM ба decision boundary, KNN ба neighborhood relationships ва Random Forest ба ensemble-и multiple decision trees асос меёбад.
Ҳар яке аз ин шаш модел бо 5-fold cross-validation ва grid search optimize шуд. Натиҷаҳо нишон доданд, ки ҳамаи моделҳои асосӣ зиёда аз %97.3 cross-validation дақиқӣ гирифтанд. Logistic Regression ҳамчун беҳтарин модели асосӣ CV5_Acc-и %99.29 ± 0.24 нишон дод. SVM ва XGBoost пас аз он буданд. Аммо азбаски самаранокӣ-и single моделҳо аллакай баланд буд, барои ба даст овардани improvement-и иловагӣ ensemble approach истифода шуд.
Қисми аслии таҳқиқот дар ҳамин ҷо равшан мешавад. Ensemble learning кӯшиш мекунад якчанд модел-ро якҷоя намуда, decision-и қавитар диҳад. Аммо ҳар модел combination муфид нест. Агар ду модел дар ҳамон намунаҳо хато кунанд, якҷоя кардани онҳо gain-и зиёд намедиҳад. Агар онҳо дар намунаҳо-и гуногун хато кунанд, яке метавонад хатои дигареро ислоҳ кунад. Таҳқиқот ин фикрро бо Jaccard error overlap index миқдорӣ мекунад.
Jaccard error overlap index бо мантиқи зерин муайян шудааст:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Дар ин формула Mi ва Mj ду base classifier-и гуногунро ифода мекунанд. Ei маҷмӯи намунаҳо аст, ки модел i онҳоро нодуруст classify кардааст. Ej маҷмӯи хатогиҳои модел j мебошад. Ei ∩ Ej намунаҳо-еро нишон медиҳад, ки ҳар ду модел якҷо хато кардаанд; Ei ∪ Ej ҳамаи намунаҳо-еро нишон медиҳад, ки ҳадди ақал яке аз модел-ҳо дар онҳо хато кардааст. J аз 0 то 1 тағйир мекунад. Қимати паст маънои pattern-и хатои бештар гуногун ва эҳтимоли complementarity-и баландтар дар ensemble-ро дорад.
Бо як мисоли оддӣ, ду корманди назоратиро тасаввур кунед. Агар ҳар ду ҳамеша як хел хатоҳоро нагузоранд, кори якҷояашон фоидаи зиёд намедиҳад. Агар яке хатои навъи A ва дигаре навъи B-ро беҳтар бинад, якҷоя боэътимодтар мешаванд. Jaccard error overlap index ба саволи “моделҳо ҳамон хатоҳоро мекунанд ё хатоҳояшон гуногун аст?” ҷавоби рақамӣ медиҳад.
Муҳаққиқон бо истифода аз ин index критерияе бо номи select-the-best, pair-the-best пешниҳод карданд. Дар қадами аввал модели асосӣ бо баландтарин CV5_Acc ҳамчун mandatory member интихоб мешавад. Ин модел Logistic Regression аст. Дар қадами дуюм Jaccard error overlap байни Logistic Regression ва моделҳо-и дигар ҳисоб мешавад ва median-и ҳамаи pairwise Jaccard values ҳамчун threshold гирифта мешавад. моделҳо-е, ки бо LR overlap-и камтар аз threshold доранд, good-pair candidates ҳисоб мешаванд.
Дар натиҷа маҷмӯи пешгӯишудаи беҳтарин комбинацияҳо чунин ба вуҷуд омад:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Дар ин ҷо S binary ensemble combinations-еро ифода мекунад, ки аз нигоҳи назариявӣ бартарӣ доштанашон интизор мерафт. Нуктаи муҳим ин аст, ки ин set танҳо дар сатҳи prediction гузошта нашуд. Муҳаққиқон ҳамаи 15 pairwise combinations-и аз шаш модел имконпазирро бо муқоисаи фарогир санҷиданд.
Дар муқоисаи фарогир чор combination-и аввал дар ranking-и CV5_Acc воқеан LR+XGBoost, LR+LightGBM, LR+RF ва LR+KNN шуданд. Ин натиҷа prediction power-и критерияе, ки бо Jaccard error overlap роҳнамоӣ мешавад, дастгирӣ мекунад. Махсусан LR+XGBoost бо CV5_Acc-и %99.40 ± 0.42 дар ҷойи аввал буд. LR+LightGBM %99.35 ± 0.39, LR+RF ва LR+KNN бошад %99.29 ± 0.24 гирифтанд.
Натиҷаҳои маҷмӯи санҷиши мустақил низ ин чаҳорчӯбаро дастгирӣ мекунанд. дақиқӣ-и чор combination дар set S байни %98.75 ва %99.03 буд. LR+XGBoost ва LR+LightGBM беҳтарин самаранокӣ-и умумиро нишон дода, ҳар ду %99.03 дақиқӣ ва %99.03 Macro-F1 гирифтанд. Аз control combinations, LightGBM+XGBoost танҳо %97.92 дақиқӣ дошт. Ин нишон медиҳад, ки якҷоя кардани моделҳо-и наздик аз як algorithmic family ва high error overlap ҳамеша натиҷаи хуб намедиҳад.
Class-level evaluation нишон медиҳад, ки модел дар кадом substances бештар душворӣ доштааст. Negative control, noscapine ва butorphanol tartrate recall-и баландтар доштанд, дар ҳоле ки etomidate ва tramadol hydrochloride recall-и пасттар нишон доданд. Сабаби кимиёии ин мушкил он аст, ки benzene-ring breathing vibrations-и ҳар ду модда дар атрофи 1000 cm⁻¹ сахт overlap мекунанд. Яъне мушкилоти модел random error нест; spectra воқеан дар ин минтақа наздиканд.
Noise robustness низ санҷида шудааст. Ба маҷмӯи санҷишӣ Gaussian white noise дар SNR levels-и 25, 20, 15 ва 10 dB илова шуд. Дар moderate noise, махсусан 15 dB SNR, дақиқӣ-и чор combination-и set S аз %98.06 боло монд. Ҳатто дар severe noise-и 10 dB дақиқӣ тақрибан %96.53 боқӣ монд. Ин нишон медиҳад, ки моделҳои интихобшуда танҳо дар clean spectra не, балки ҳангоми signal degradation ҳам нисбатан устувор буданд.
Аммо ин натиҷаҳоро бо эҳтиёт хондан лозим аст. Noise robustness тамоми мураккабии намунаҳои воқеии клиникӣ-ро намояндагӣ намекунад. Пешоби воқеӣ фарқиятҳои метаболикии байни одамон, drug metabolites, pH-и гуногун, coexisting substances, kidney function, diet, disease, contamination ва storage conditions дорад. Азбаски таҳқиқот дар пешоби сунъӣ гузаронида шудааст, validation дар намунаҳои воқеии клиникӣ/судӣ қадами навбатӣ мебошад.
Ҷиҳати дигари қавии таҳқиқот interpretability chain мебошад. Ҳатто агар machine learning моделҳо дақиқӣ-и баланд диҳанд, дар chemical analysis саволи “модел чаро ин decision-ро дод?” хеле муҳим аст. Агар decision ба genuine molecular peaks не, балки preprocessing artefacts ё random noise такя кунад, high дақиқӣ маънои reliable chemical evidence-ро надорад. Аз ин рӯ, муҳаққиқон permutation importance-ро тавассути PCA loadings ба original wavenumber space back-project карданд.
Муносибати истифода шуда барои ин interpretability дар таҳқиқот чунин дода шудааст:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Дар ин формула Wk total importance score-и k-th wavenumber point-ро нишон медиҳад. PIi permutation importance-и i-th principal component мебошад. Lik loading coefficient-и k-th wavenumber дар i-th principal component аст. n шумораи principal components-и нигоҳдошташуда мебошад. Дар таҳқиқот n=10 аст. Ҳадафи формула ин аст, ки contribution-и decision-и модел аз PCA space ба original Raman wavenumber axis баргардонида шавад.
Инро чунин фаҳмидан мумкин аст: модел спектри хом-ро бевосита не, PCA components-ро истифода мебарад. Аммо тафсири кимиёӣ дар raw wavenumbers анҷом мешавад. Аз ин рӯ, саволи “кадом PCA component барои модел муҳим буд?” бояд ба “ин importance ба кадом Raman wavenumbers мувофиқ аст?” табдил дода шавад. Back-projection ҳамин корро мекунад.
Wavenumbers-и намоён дар interpretability analysis бо characteristic SERS peaks-и чор drug асосан мувофиқ буданд. Барои noscapine 904 cm⁻¹ ва 1635 cm⁻¹, барои etomidate 952/953 cm⁻¹, 1030/1031 cm⁻¹ ва 1726/1722 cm⁻¹, барои tramadol hydrochloride 715/714 cm⁻¹ ва 1000/999 cm⁻¹, барои butorphanol tartrate 1437/1438 cm⁻¹ ва 1515 cm⁻¹ муҳим буданд. Таҳқиқот мегӯяд, ки deviations дар ҳудуди 5 cm⁻¹ монданд.
Ин аз ҷиҳати илмӣ муҳим аст. модел танҳо statistical classifier нест; дар decision-ҳои худ минтақаҳои мувофиқ ба molecular vibrational modes-и воқеиро истифода кардааст. Масалан, барои noscapine lactone-ring C-O-C stretch дар 904 cm⁻¹ ҳамчун муҳимтарин peak пайдо шудааст. Барои butorphanol tartrate минтақаи 1438 cm⁻¹ ба aromatic C=C stretch нисбат дода шудааст. Overlap-и tramadol ва etomidate дар атрофи 1000 cm⁻¹ шарҳи кимиёии душвории ҷудокунии ин ду class мебошад.
Graphical abstract ва Figure 1 ҷараёни умумии усул-ро нишон медиҳанд. Қисми аввал urine намуна, DLLME extraction, AgNP-enhanced SERS acquisition ва spectral measurement-ро нишон медиҳад. Қисми миёна интихоби RF, SVM, LightGBM, XGBoost, KNN ва LR, Jaccard error-overlap matrix ва сохтани LR-centered combinations-ро нишон медиҳад. Қисми охир ensemble evaluation, noise robustness ва wavenumber-importance plots-ро нишон медиҳад. Ин visual равшан мекунад, ки таҳқиқот laboratory chemistry ва AI модел selection-ро дар як workflow муттаҳид кардааст.
Figure 2 DLLME-SERS spectra-и чор drug-ро дар concentrations-и гуногун нишон медиҳад. Бо зиёд шудани concentration, characteristic peak intensity зиёд мешавад, дар ҳоле ки peak positions собит мемонанд. Ин нишон медиҳад, ки усул signal-и concentration-sensitive медиҳад, вале molecular fingerprint positions-ро ҳифз мекунад. Дар айни ҳол, overlap дар атрофи 1000 cm⁻¹ барои etomidate ва tramadol hydrochloride нишон медиҳад, ки visual discrimination метавонад душвор бошад.
Figure 4 нишон медиҳад, ки модел selection-ро танҳо бо мантиқи “ду модел-и дақиқӣ-и баландро якҷо кун” анҷом додан мумкин нест. Base моделҳо individually самаранокӣ-и баланд доранд, вале error-overlap matrix нишон медиҳад, ки баъзе моделҳо similar errors мекунанд. Махсусан tree-based моделҳо бо high error overlap метавонанд limited ensemble gain диҳанд. Баръакс, lower Jaccard values байни LR ва KNN, RF, LightGBM, XGBoost complementarity potential-ро нишон медиҳанд.
Figure 5 independent-самаранокии санҷишӣ, class-level metrics, noise robustness ва interpretable wavenumber-importance distribution-ро якҷо нишон медиҳад. Паёми асосӣ ин аст, ки модел на танҳо дақиқӣ-и баланд дорад; он ҳамчунин дар noise устувор аст ва decisions-ро ба chemically meaningful wavenumber regions такя мекунад.
Аҳамияти таърихии таҳқиқот дар он аст, ки ду камбудии SERS-ML literature-ро ҳадаф мегирад. Якум, ensemble members аксар вақт бе quantitative justification интихоб мешаванд. Дуюм, қарори модел ба кадом Raman shifts такя мекунад аз ҷиҳати кимиёӣ пайгирӣ намешавад. Ин таҳқиқот кӯшиш мекунад ҳам модел selection-ро бо error complementarity асоснок кунад ва ҳам қарори модел-ро ба chemical peaks пайванд диҳад.
Аз нигоҳи имрӯз, таҳқиқот ба ниёзи скрининги зуд ҷавоб медиҳад. Дар clinical toxicology, forensic laboratories ва substance-abuse monitoring ба fast, sensitive ва portable systems ниёз вуҷуд дорад. Spectroscopic approaches монанди DLLME-SERS шояд confirmation power-и mass spectrometry-ро надошта бошанд, аммо барои rapid preliminary screening ё near-field analysis арзишманд буда метавонанд.
Аз нигоҳи оянда, таҳқиқот аҳамияти interpretable chemical AI моделҳо-ро нишон медиҳад. Дар analytical chemistry, AI набояд танҳо “black box that predicts correctly” бошад. Махсусан дар forensic ва clinical contexts бояд фаҳмонд, ки модел чаро decision медиҳад, ба кадом chemical peak такя мекунад ва оё он decision ба genuine molecular vibrations мувофиқ аст. Ин таҳқиқот permutation importance ва PCA-loading back-projection-ро барои ин мақсад истифода мебарад.
Ҷиҳатҳои қавӣ regular dataset construction, маҷмӯи санҷиши мустақил, train/санҷиш separation барои пешгирии information leakage, муқоисаи ҳамаи 15 binary combinations, noise robustness testing ва тафсирпазирии кимиёӣ analysis мебошанд. Илова бар ин, мувофиқати рақамҳои мавҷии қарор бо characteristic SERS peaks натиҷаҳоро аз ҷиҳати кимиёӣ маънодортар мекунад.
Дар муқобил, limitations равшананд. таҳқиқот preprint аст ва peer review нагузаштааст. намунаҳо real clinical urine не, пешоби сунъӣ мебошанд. Танҳо чор drug арзёбӣ шудааст. Jaccard-based selection criterion бо шаш таснифгарони номзад санҷида шудааст; дар маҷмӯаҳои калонтари моделҳо бояд дубора санҷида шавад. Дар real forensic намунаҳо, mixtures, metabolites, degradation products, diverse urine composition ва multiple-drug presence самаранокӣ-ро метавонанд тағйир диҳанд.
таҳқиқот мегӯяд: trace-level spectral додаҳо-и аз DLLME-SERS гирифташуда бо preprocessing-и дуруст, PCA-based feature extraction, ensemble моделҳо интихобшуда аз рӯи Jaccard error complementarity ва тафсирпазирии кимиёӣ chain бо дақиқӣ-и баланд classify шуда метавонанд. таҳқиқот намегӯяд: усул имрӯз барои definitive diagnosis ё legal evidence дар real clinical/forensic urine омода аст. Барои ин validation бо authentic намунаҳо, панелҳои васеътари доруҳо, сенарияҳои омехта ва лабораторияҳои мустақил лозим аст.
Усул ва Натиҷаҳои Таҳқиқот
Таҳқиқот тарҳи таҷрибавӣ ва ҳисоббарориро дар бар мегирад, ки laboratory analysis ва machine learning-ро барои trace-level classification-и чор psychoactive drug дар пешоби сунъӣ matrix муттаҳид мекунад.
Моддаҳои ҳадаф:
| Модда | Нақш дар таҳқиқот | Минтақаҳои барҷастаи SERS peak |
| Noscapine | Яке аз чор psychoactive drug ҳадаф. | 904 cm⁻¹ ва 1635 cm⁻¹. |
| Etomidate | Моддаи ҳадафе, ки бо benzene-ring vibrations ҷудо карда мешавад. | 952, 1004, 1030 ва 1726 cm⁻¹. |
| Tramadol hydrochloride | Моддаи ҳадаф бо peak overlap бо etomidate дар атрофи 1000 cm⁻¹. | 715 ва 1000 cm⁻¹. |
| Butorphanol tartrate | Моддаи ҳадаф, ки бо aromatic C=C stretching regions фарқ мекунад. | 1437 ва 1515 cm⁻¹. |
Омодасозии намуна ва SERS measurement:
- Artificial urine намунаҳо бо доруҳои ҳадаф spike карда шуданд.
- Барои urine cleanup ба 2.0 mL намуна 100 mg PSA илова шуда, vortex ва centrifuge гардид.
- Барои DLLME pH ба 9.5 танзим карда шуда, 100 μL dichloromethane ва 300 μL acetone истифода шуд.
- Silver nanoparticles бо Lee-Meisel citrate reduction усул омода шуданд.
- AgNPs ҳамчун нимкуравӣ бо average diameter тақрибан 60 nm тавсиф шуданд.
- SERS measurements бо portable Raman system бо laser-и 633 nm иҷро шуданд.
- Барои ҳар намуна аз панҷ нуқтаи гуногун spectrum гирифта шуда, average spectrum истифода шуд.
додаҳо set:
| Унсури дода | Арзиш | Маъно |
| Шумораи доруҳои ҳадаф | 4 | Noscapine, etomidate, tramadol hydrochloride, butorphanol tartrate. |
| Concentration диапазон | 5–5000 ng/mL | Classification диапазон аз trace level то сатҳи баландтар. |
| Concentration levels | 15 | Барои ҳар drug нуқтаҳои concentration гуногун истифода шуданд. |
| Independent намунаҳо per concentration | 20 | Барои ҳар доруи ҳадаф 15 × 20 намунаҳо омода шуданд. |
| Positive spectra | 1200 | Аз ҳисоби 4 × 15 × 20 гирифта шудааст. |
| Negative spectra | 1200 | Аз blank намунаҳои пешоби сунъӣ гирифта шуданд. |
| Total spectra | 2400 | Ҳамаи додаҳо барои modeling. |
| омӯзиш/санҷиш split | 1680 / 720 | Бо таносуби 7:3 ҷудо шудааст. |
| Spectral диапазон | 159–1996 cm⁻¹ | SERS wavenumber диапазон. |
Preprocessing steps:
- Savitzky-Golay smoothing: window size 11, polynomial degree 3.
- airPLS baseline correction: λ = 10⁵, maximum iterations 100, convergence tolerance 10⁻⁶.
- Min-Max normalization: signals ба 0–1 диапазон scale шуданд.
- PCA барои feature extraction истифода шуд.
- 10 principal components-и аввал барои modeling нигоҳ дошта шуданд.
- Барои пешгирии information leakage, PCA ва StandardScaler танҳо дар маҷмӯи омӯзишӣ fit шуданд.
Base classifiers:
| модел | Ихтисор | Нақш дар таҳқиқот |
| Random Forest | RF | Tree-based ensemble модели асосӣ. |
| Support Vector Machine | SVM | Decision-boundary-oriented classifier. |
| LightGBM | LGBM | Gradient-boosted tree модел. |
| XGBoost | XGB | Strong gradient-boosted tree модел. |
| K-Nearest Neighbors | KNN | Classifier based on neighborhood relationships. |
| Logistic Regression | LR | Mandatory ensemble member бо баландтарин base CV5_Acc. |
Формулаи Jaccard error overlap:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Дар ин формула Ei ва Ej маҷмӯи намунаҳо мебошанд, ки ду модел онҳоро нодуруст classify кардаанд. Агар J паст бошад, error patterns гуногунтаранд ва complementarity дар ensemble эҳтимолан баландтар аст.
модел-selection criterion:
- Select-the-best: Base модел бо highest CV5_Acc интихоб мешавад. Дар ин таҳқиқот LR интихоб шуд.
- Pair-the-best: Jaccard error overlap байни LR ва моделҳо-и дигар ҳисоб мешавад.
- Median-и ҳамаи 15 pairwise Jaccard values ҳамчун threshold гирифта шуд.
- моделҳо бо overlap-и камтар аз threshold нисбат ба LR ҳамчун номзадҳои мувофиқи ҷуфтсозӣ қабул шуданд.
Predicted best ensemble set:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Base-модел ва ensemble findings:
| Натиҷа | Арзиши ададӣ | Шарҳ |
| CV5_Acc-и ҳамаи моделҳои асосӣ | Ҳадди ақал %97.3 | 10-dimensional PCA feature space дорои иттилооти таснифӣ-и қавӣ мебошад. |
| Best модели асосӣ | LR, %99.29 ± 0.24 CV5_Acc | Бо highest individual самаранокӣ ҳамчун mandatory ensemble member интихоб шуд. |
| Jaccard диапазон | 0.245–0.575 | Error overlap байни моделҳо ба таври назаррас фарқ мекунад. |
| Median Jaccard threshold | 0.361 | моделҳо бо overlap камтар аз ин threshold бо LR интихоб шуданд. |
| LR+XGBoost CV5_Acc | %99.40 ± 0.42 | Top combination дар муқоисаи фарогир. |
| LR+LightGBM CV5_Acc | %99.35 ± 0.39 | Яке аз дуюмин combination-и қавӣ. |
| LR+RF ва LR+KNN CV5_Acc | %99.29 ± 0.24 | Бо predicted good-combination set мувофиқ. |
Independent санҷиш-set натиҷаҳо:
| модел / Combination | Натиҷа | Шарҳ |
| LR+XGBoost | %99.03 дақиқӣ, %99.03 Macro-F1, AUC 0.9999 | Яке аз best overall combinations. |
| LR+LightGBM | %99.03 дақиқӣ ва Macro-F1 | Ба ҳамон санҷиш дақиқӣ бо LR+XGBoost расид. |
| LR+KNN | %98.89 дақиқӣ | Дар predicted good set ҷой гирифт. |
| LR+RF | %98.75 дақиқӣ | Дар predicted good set ҷой гирифт. |
| SVM+LR | %98.72 дақиқӣ | самаранокӣ наздик буд, аммо error overlap баландтар буд. |
| LightGBM+XGBoost | %97.92 дақиқӣ | High error overlap-и моделҳо аз family-и наздик ensemble gain-ро маҳдуд кард. |
Noise robustness:
- Gaussian white noise дар 25, 20, 15 ва 10 dB SNR ба маҷмӯи санҷишӣ илова шуд.
- Дар moderate noise-и 15 dB, чор combination-и set S дақиқӣ-и зиёда аз %98.06 доштанд.
- Дар severe noise-и 10 dB дақиқӣ тақрибан %96.53 монд.
- LR+LightGBM дар 25 dB SNR %99.17 дақиқӣ нишон дод; гуфта мешавад ин difference-и хурд ба танҳо як намуна аз 720 намунаҳо мувофиқ аст.
- Set S combinations нисбат ба LightGBM+XGBoost control бо homogeneous error pattern robustтар ба назар расиданд.
Формулаи тафсирпазирии кимиёӣ:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Дар ин формула Wk total importance score-и k-th wavenumber point; PIi permutation importance-и i-th principal component; Lik loading-и k-th wavenumber дар i-th PCA component; n бошад number of principal components мебошад. Ин back-projection барои шарҳ додани он истифода шуд, ки қарори модел ба кадом Raman wavenumber regions такя мекунад.
Chemical wavenumbers highlighted by модел:
| Wavenumber | Манбаи алоқаманд | Маънои кимиёӣ |
| 904 cm⁻¹ | Noscapine | Lactone-ring C-O-C stretching. |
| 1438 cm⁻¹ | Butorphanol tartrate | Aromatic C=C stretching region. |
| 1635 cm⁻¹ | Noscapine | Aromatic C=C stretching. |
| 953 cm⁻¹ | Etomidate | Benzene-ring out-of-plane deformation. |
| 999 cm⁻¹ | Tramadol / Etomidate | Overlapping benzene-ring breathing mode. |
| 714 cm⁻¹ | Tramadol hydrochloride | Benzene-ring-related vibration. |
| 1031 cm⁻¹ | Etomidate | Benzene/imidazole ring vibration. |
| 1515 cm⁻¹ | Butorphanol tartrate | Aromatic C=C stretching. |
| 1722 cm⁻¹ | Etomidate | Carbonyl C=O stretching. |
| 449 ва 1397 cm⁻¹ | Substrate / matrix | Background variations associated with AgNP/citrate or urine matrix. |
Натиҷаҳои асосии таҳқиқот:
- DLLME-SERS дар пешоби сунъӣ барои classification-и чор psychoactive drug дар диапазони 5–5000 ng/mL spectral додаҳо-и қобили истифода тавлид кард.
- Бо зиёд шудани concentration characteristic peak intensity зиёд ва peak positions устувор монданд.
- Peak overlap-и etomidate ва tramadol hydrochloride дар атрофи 1000 cm⁻¹ visual discrimination-ро душвор кард.
- 10 PCA components-и аввал ҳамчун feature space-и кофӣ интихоб шуданд.
- Jaccard error overlap index complementarity-и errors-и ensemble members-ро миқдорӣ кард.
- “Select-the-best, pair-the-best” criterion чор best combinations аз 15 pairwise combinations-ро дуруст пешгӯӣ кард.
- LR+XGBoost ва LR+LightGBM дар маҷмӯи санҷиши мустақил %99.03 дақиқӣ ва Macro-F1 гирифтанд.
- LR+XGBoost бо назардошти самаранокии умумӣ ва robustness ҳамчун representative модел барои тафсирпазирии кимиёӣ интихоб шуд.
- Discriminative wavenumbers-и модел бо characteristic SERS peaks-и чор drug дар ҳудуди 5 cm⁻¹ мувофиқ буданд.
Маҳдудиятҳои таҳқиқот:
- таҳқиқот preprint аст ва peer review нагузаштааст.
- намунаҳо real clinical/forensic urine не, пешоби сунъӣ мебошанд.
- Танҳо чор моддаи ҳадаф арзёбӣ шудааст.
- Jaccard-based selection criterion бо шаш таснифгарони номзад санҷида шуд; барои маҷмӯаҳои калонтари моделҳо research-и иловагӣ лозим аст.
- Дар real намунаҳо, metabolites, mixtures, diverse urine compositions ва multiple substances метавонанд самаранокӣ-ро тағйир диҳанд.
- таҳқиқот барои скрининги зуд methodological reference пешниҳод мекунад, аммо definitive clinical/forensic confirmation claim надорад.
Ёддошт оид ба Манбаъ ва Усул
Ин мақола бар асоси таҳқиқоти Ruzhen Xiang, Shijie Zheng, Nan Yin, Haixia Zhao, Liwei Hou, Qinhong Wang ва Li Chen бо унвони “Interpretable Ensemble Learning Combined with DLLME-SERS for High-дақиқӣ Classification and Identification of Four Trace Psychoactive Drugs in Urine” таҳия шудааст.
Тавре ки дар матн равшан гуфта шудааст, таҳқиқот preprint research paper мебошад ва peer review нагузаштааст. Аз ин рӯ, натиҷаҳо набояд ҳамчун усул-и final clinical/forensic, ки дар peer-reviewed journal нашр ва independently validated шудааст, хонда шаванд; онҳо як research proposal ва experimental-methodological contribution мебошанд, ки validation-и иловагӣ талаб мекунанд.
таҳқиқот дар laboratory environment бо намунаҳои пешоби сунъӣ анҷом шудааст. усул аз DLLME намуна enrichment, AgNP-enhanced SERS measurement, spectral preprocessing, PCA-based feature extraction, омӯзиш of six base classifiers, Jaccard error-overlap-based ensemble selection, weighted soft voting, independent санҷиш-set evaluation, noise robustness testing ва тафсирпазирии кимиёӣ analysis бо permutation importance-PCA loading back-projection иборат аст.
Дар ин матн ягон claim-и clinical success, forensic validity, guaranteed field use, guaranteed самаранокӣ дар real patient намунаҳо ё regulatory approval, ки дар PDF нест, илова нашудааст. Арзишҳои монанди %99.03 дақиқӣ, 0.9999 AUC, зиёда аз %98.06 дақиқӣ дар moderate noise ва peak agreement дар ҳудуди 5 cm⁻¹ танҳо дар доираи пешоби сунъӣ маҷмӯи додаҳо ва experimental conditions-и таҳқиқот оварда шудаанд.
Муҳимтарин саҳми илмии таҳқиқот кӯшиши якҷоя кардани high дақиқӣ бо тафсирпазирии кимиёӣ дар SERS-ML мебошад. Истифодаи error complementarity барои модел selection ва back-projection-и қарори моделs ба original Raman wavenumber space ҳадаф дорад, ки натиҷаҳоро на танҳо бо statistical самаранокӣ, балки бо chemical fingerprint низ дастгирӣ кунад.
Дар оянда усул бояд бо real clinical/forensic urine намунаҳо, панелҳои васеътари доруҳо, сенарияҳои омехта, different instruments ва лабораторияҳои мустақил санҷида шавад. То анҷоми чунин validations, таҳқиқот набояд ҳамчун definitive diagnostic ё legal decision tool арзёбӣ шавад; балки ҳамчун methodological step-и қавӣ барои скрининги зуд ва interpretable spectroscopic AI research хонда шавад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд