

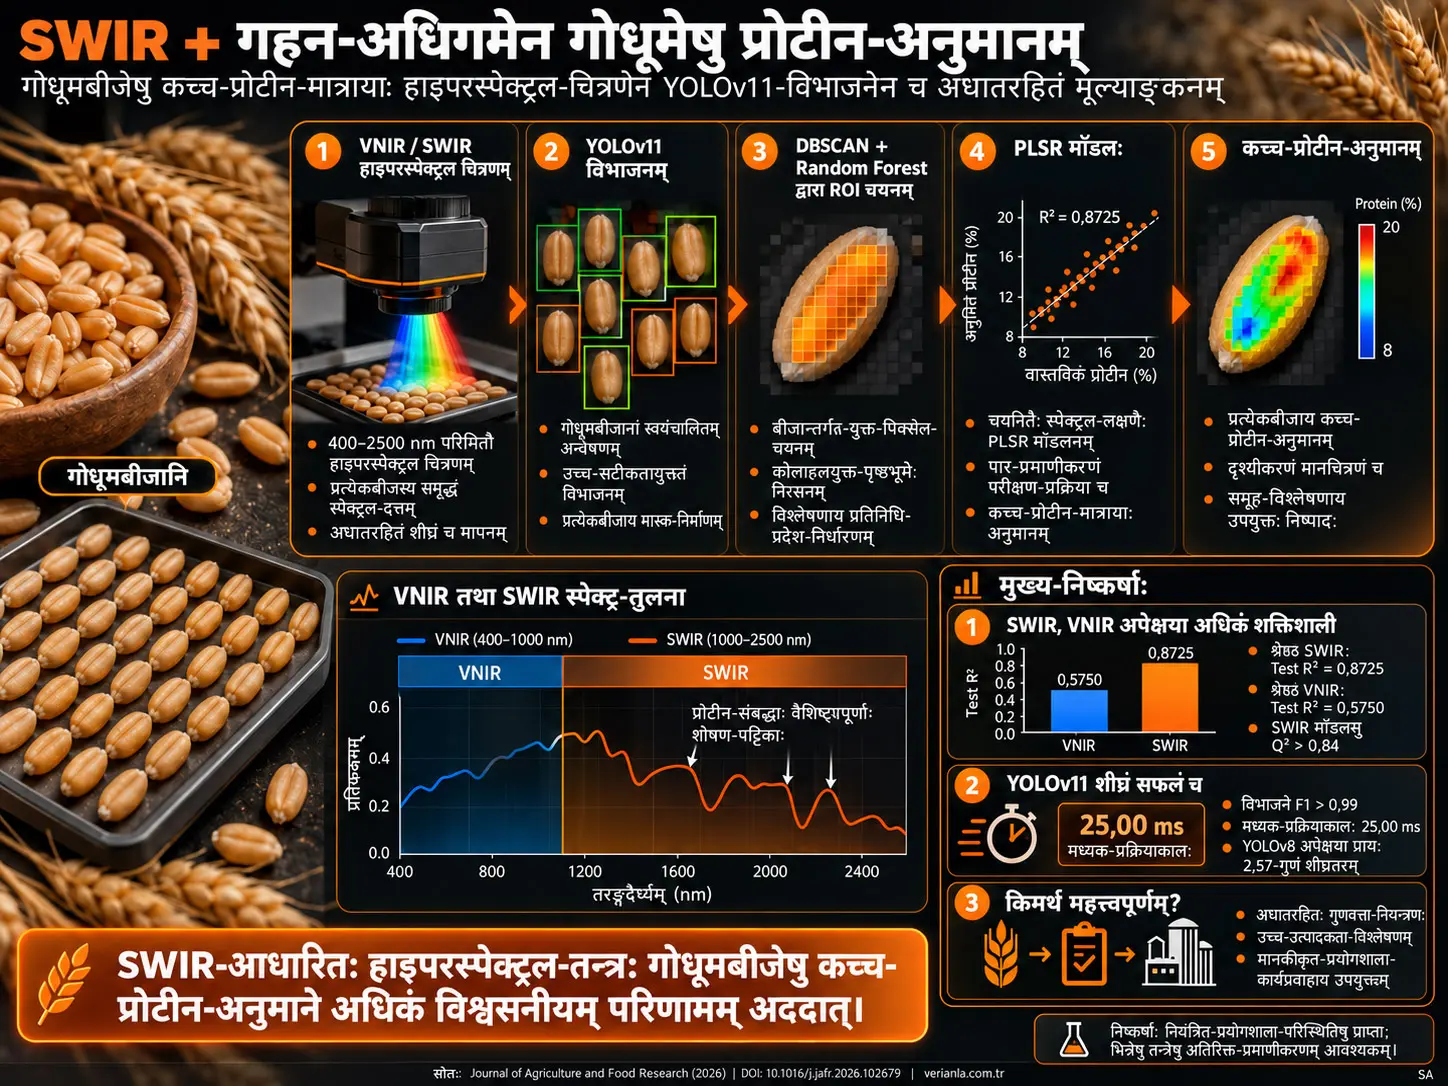
SWIR hyperspectral imaging नाम वस्तुं न नाशयन् प्रयुज्यमानः चित्रणविधिः अस्ति; सः कस्यचित् वस्तुनः लघुतरङ्ग infrared-प्रदेशे अनेकासु सङ्कीर्णासु तरङ्गदैर्घ्येषु परावर्तनसम्बद्धां सूचनाम् एकस्मिन्नेव चित्रे अभिलेखयति। अस्मिन्नध्ययने गोधूमकणेषु crude protein इत्यस्य मात्रां शीघ्रं तथा वस्तुं न नाशयित्वा अनुमातुं SWIR तथा VNIR hyperspectral imaging, YOLOv11-आधारितं कण-segmentation, DBSCAN तथा Random Forest-आधारितः ROI-चयनविधिः, तथा Partial Least Squares Regression (PLSR) च संयोजिताः। 45 गोधूमप्रकारेभ्यः 2023 तथा 2024 वर्षयोः प्राप्ताः 4200 वास्तविकाः कणाः द्वाभ्यां भिन्नाभ्यां spectral-प्रणालीभ्यां चित्रिताः; सन्दर्भ-crude protein-मूल्यानि Dumas nitrogen analysis द्वारा निर्धारितानि। अध्ययनस्य मुख्यः परिणामः अयम् अस्ति यत् नियन्त्रितेषु चित्रणपरिस्थितिषु crude protein-अनुमाने SWIR spectrum इत्यनेन VNIR अपेक्षया स्पष्टतया उच्चतरं तथा अधिकं स्थिरं generalization-performance प्राप्तम्।
उच्चतमं SWIR test-performance Multiplicative Scatter Correction (MSC) पूर्वप्रक्रियया Test R² = 0,8725 तथा RMSE = 0,7479 इति प्राप्तम्। तथापि Savitzky–Golay पूर्वप्रक्रियया मूल-data मध्ये PLS-अवयवानां संख्या 10 तः 3 पर्यन्तं न्यूनीकृता, तथा Test R² = 0,8449 तथा Q² = 0,8487 मूल्यानि रक्षितानि; अतः सरलतरः model प्राप्तः। SWIR-model-समूहे परीक्षितानां सर्वासां पूर्वप्रक्रियाणां Q² मूल्यं 0,84 इत्यस्मात् अधिकम् आसीत्, यदा सर्वोत्तमस्य VNIR-model इत्यस्य Test R² = 0,5750 तथा Q² = 0,5793 आसीत्।
data augmentation प्रयुक्ते सति YOLOv11 segmentation इत्यनेन cropped-चित्रेषु F1 मूल्यं 0,99 इत्यस्मात् अधिकं रक्षितुं शकितम्। model इत्यस्य median processing time 25,00 ms इति मापितः, तथा तस्मिन्नेव अध्ययने YOLOv8-समीक्षणस्य अपेक्षया सः प्रायः 2,57 गुणं शीघ्रतरः आसीत्। किन्तु एते परिणामाः तैरेव camera-यन्त्रैः, नियन्त्रितप्रकाशे, मानकीकृतचित्रणप्रोटोकॉलस्य अधीनं च प्राप्ताः। भिन्नेषु यन्त्रेषु, भिन्नेषु पर्यावरणपरिस्थितिषु, स्वतंत्रसंस्थानां data-set-मध्ये च समानं performance स्थिरं भविष्यति इति अस्मिन्नध्ययने सिद्धं न कृतम्।
गोधूमस्य crude protein-मात्रा किमर्थं मीयते?
गोधूमस्य protein-संरचना, विशेषतः gluten-जालं निर्मातृभ्यां gliadin तथा glutenin protein-भ्यां कारणेन, पिष्टस्य processing-गुणैः निकटतया सम्बद्धा अस्ति। परम्परागत-crude protein-निर्धारणे Kjeldahl अथवा Dumas इत्यादयः रासायनिकविधयः प्रयुज्यन्ते। एते विधयः उच्चां शुद्धतां दातुं शक्नुवन्ति, किन्तु प्रतिदर्शस्य सज्जीकरणं, पेषणं, तथा रासायनिकं वा दहनाधारितं analysis अपेक्षन्ते। यत्र उत्पादनस्य अथवा quality-control-परिस्थितौ बहूनां कणानां शीघ्रं वर्गीकरणम् अपेक्षितम्, तत्र प्रत्येकस्य कणस्य एतैः विधिभिः पृथक् परीक्षणं high-throughput screening इत्यस्य क्षमतां सीमितां करोति।
near-infrared spectroscopy वस्तुं न नाशयित्वा analysis कर्तुं शक्नोति; किन्तु पारम्परिकाः spectrophotometer-यन्त्राणि प्रायः प्रतिदर्शस्य सीमितभागात् spectrum गृह्णन्ति। hyperspectral imaging तु चित्रस्य प्रत्येकस्मिन् स्थानिकबिन्दौ अनेकतरङ्गदैर्घ्यानां परावर्तनसूचनां संयोजयति, अतः “कुत्र?” तथा “कस्य spectral-लक्षणस्य?” इत्येतौ प्रश्नौ एकस्मिन्नेव data-set मध्ये परीक्षितुं शक्येते।
गोधूम-protein-अनुमाने SWIR इत्यनेन VNIR अपेक्षया अधिकबलवान् परिणामः किमर्थं प्राप्तः?
SWIR-प्रदेशः protein-मध्ये विद्यमानानां N–H, C=O तथा C–N बन्धानां vibration-overtones तथा combination-bands इत्येतैः सम्बद्धां spectral-सूचनां गृह्णाति; अतः अस्मिन्नध्ययने सः crude protein-मात्रया अधिकं प्रत्यक्षतया सम्बद्धान् रासायनिकसङ्केतान् वहति स्म। प्रयुक्तः VNIR-अन्तरालः तु protein-सम्बद्धानां प्रमुखानाम् absorption-प्रदेशानां महत्त्वपूर्णं भागं न गृह्णाति स्म, तथा कणत्वक्-वर्ण इत्यादिभिः protein-संबन्धे दुर्बलैः भौतिकलक्षणैः अधिकं प्रभावितः आसीत्। फलतः SWIR-आधारिताः PLSR-models सर्वेषु पूर्वप्रक्रियाविकल्पेषु Q² > 0,84 स्तरात् उपरि स्थिताः, यदा VNIR-models इत्येषां generalization-performance स्पष्टतया न्यूनतरम् आसीत्।
अध्ययने VNIR-अन्तरालः 397,32–1003,58 nm, SWIR-अन्तरालः च 982,08–2576,58 nm आसीत्। उच्च-crude protein तथा निम्न-crude protein समूहयोः औसत-spectrum तुलितेषु VNIR मध्ये केवलम् एकः स्पष्टः turning point ज्ञातः, किन्तु SWIR spectrum मध्ये अष्ट turning points ज्ञाताः:
- 992,0 nm,
- 1200,5 nm,
- 1473,9 nm,
- 1779,3 nm,
- 1934,4 nm,
- 2283,0 nm,
- 2316,2 nm,
- 2487,8 nm।
लेखकाः 1473,9 nm बिन्दुं N–H-vibration-सम्बद्धस्य प्रायः 1500–1530 nm प्रदेशस्य समीपस्थं मन्यन्ते; 2283,0 तथा 2316,2 nm बिन्दू protein-संरचनायां C=O तथा N–H-vibration-सम्बद्धानां combination-bands इत्येषां समीपस्थाः spectral-विशेषताः इति व्याख्यायन्ते। एषा व्याख्या दृष्टानां turning points इत्येषां protein-सम्बद्ध-vibration-कारणतः सम्भवोत्पत्तिं सूचयति; किन्तु अध्ययनं प्रत्येकस्य बिन्दोः कृते स्वतंत्रं molecular validation न कृतवत्।
VNIR मध्ये ज्ञातः प्रायः 1000,5 nm turning point sensor-range इत्यस्य अन्तिमसीमायाम् अस्ति। अनुसन्धातारः सूचयन्ति यत् एषः आकस्मिकः spectral-परिवर्तनः वास्तविक-biochemical-सङ्केतस्य अपेक्षया यन्त्रस्य measurement-limit समीपस्थितं noise प्रतिनिधातुं शक्नोति।
अस्मिन्नध्ययने YOLOv11 किं करोति?
अस्मिन्नध्ययने YOLOv11 crude protein-मात्रां प्रत्यक्षम् अनुमातृ-model नास्ति; hyperspectral-चित्रेषु प्रत्येकं गोधूमकणं तथा white-reference-प्रदेशान् स्वयमेव segment कृत्वा, प्रत्येकस्मात् कणात् spectral-data निष्कासयितुं प्रयोज्यां spatial-boundary निर्धारितुं गहनाधिगमघटकः अस्ति। protein-अनुमानं पश्चात् एतेभ्यः segments इत्येभ्यः निष्कासितानि spectral-features PLSR-model मध्ये दत्त्वा क्रियते।
प्रणाल्याः अवगमनाय एषः भेदः महत्त्वपूर्णः। अध्ययने त्रयः भिन्नाः analytical कार्यभागाः परस्परं संयोजिताः:
- वस्तुनः अन्वेषणम्: YOLOv11 चित्रस्य कः प्रदेशः गोधूमकणः इति निर्धारितुं प्रयुज्यते।
- spectral ROI इत्यस्य परिशोधनम्: UMAP, DBSCAN तथा Random Forest Classifier प्रयुज्य YOLO-box अन्तर्गताः वास्तवतः कणसम्बद्धाः pixels पृथक्क्रियन्ते।
- रासायनिकगुणस्य अनुमानम्: चयनितेभ्यः pixels इत्येभ्यः निष्कासितं spectrum PLSR-model मध्ये प्रविशति, ततः crude protein-मात्रा अनुमीयते।
केवलं YOLO segmentation पर्याप्तं किमर्थं न मतम्?
YOLO कणस्य स्थानं ज्ञापयितुं शक्नोति, तथापि प्राप्तः bounding box केवलं कणं न, अपि तु तस्य परिवेष्टितान् background-pixels अपि अन्तर्भावयितुं शक्नोति। hyperspectral-अनुमाने अल्पसंख्यकाः अपि दोषपूर्णाः pixels औसतपरावर्तन-spectrum परिवर्तयितुं शक्नुवन्ति; अतः अनुसन्धातारः कणस्य वास्तविकं spectral-प्रदेशं पृथक् वर्गीकृतवन्तः।
एतदर्थं spectral-data प्रथमं Min-Max scaling द्वारा 0–1 अन्तराले स्थापितम्; UMAP द्वारा dimensionality reduction प्रयुक्तम्, ततः DBSCAN-clusters निर्मिताः। DBSCAN द्वारा निर्मिताः class-labels Random Forest Classifier इत्यस्य प्रशिक्षणाय प्रयुक्ताः। प्रायोगिकमूल्याङ्कने DBSCAN कृते eps = 0,46 तथा Random Forest कृते maximum depth = 2 चयनितम्।
अन्तिम-ROI-निष्कर्षणे अतीव न्यूनं परावर्तनं दर्शयन्तः प्रदेशाः अपि अपसारिताः। सामान्य-median-परावर्तनापेक्षया %30 इत्यस्मात् अधिकं न्यूनपरावर्तनयुक्ताः प्रदेशाः अपसारिताः, तथा परस्परं आच्छादयन्तेषु detection-boxes मध्ये Intersection over Union (IoU)-आधारितं non-maximum suppression प्रयुक्तम्।
अस्मिन्नध्ययने crude protein-मात्रा वास्तवतः कथं मापिता?
model इत्यनेन अधिगन्तव्यं सन्दर्भ-crude protein-मूल्यं hyperspectral-camera द्वारा न उत्पादितम्; चित्रणस्य अनन्तरं गोधूमप्रतिदर्शाः पिष्टाः, Dumas analyzer द्वारा कुल-nitrogen-मात्रा मापिता, तथा nitrogen-मूल्यं 5,7 conversion factor इत्यनेन गुणित्वा crude protein-मात्रा गणिता। एवं image-based model रासायनिकसन्दर्भमापनस्य अनुमानं कर्तुं शिक्षितम्।
प्रतिदर्शाः Automill-यन्त्रे 140 rpm वेगे 60 seconds कालं द्विवारं, कुलतः 120 seconds, homogenize कृताः। कुल-nitrogen-analysis FlashSmart CHNS/O Dumas analyzer द्वारा कृतम्।
कुलतः 306 सन्दर्भ-crude protein-मापनानि कृतानि:
- 2023 सस्यसंग्रहः: 45 प्रकाराः × 3 technical repeats = 135 मापनानि,
- 2024 शीतकालीनगोधूमः: 45 प्रकाराः × 3 technical repeats = 135 मापनानि,
- 2024 मध्ये चयनिताः 6 प्रतिनिधि-प्रकाराः: 6 प्रकाराः × 6 technical repeats = 36 मापनानि।
अस्यां प्रणाल्यां PLSR किं अनुमिनोति?
PLSR परस्परं उच्चतया correlated शतानि spectral-wavelengths अल्पसंख्येषु latent-components मध्ये निरूपयित्वा, तस्याः spectral-सूचनायाः आधारेण सन्दर्भ-crude protein-मूल्यं अनुमिनोति; अतः एषः regression-model अस्ति। समीपस्थेषु wavelength-मध्ये दृढः परस्परसंबन्धः यत्र अस्ति तादृशस्य hyperspectral-data कृते एषः गुणः विशेषतया उपयोगी अस्ति।
VNIR-model मध्ये सर्वे 204 bands तथा SWIR-model मध्ये सर्वे 288 bands प्रयुक्ताः। model-निर्माणात् पूर्वं मूल-spectrum सहिताः त्रयः भिन्नाः spectral-preprocessing-विधयः मूल्याङ्किताः:
- SNV — Standard Normal Variate: scattering तथा scale-भेदान् न्यूनीकर्तुं प्रयुक्तः standardization-उपायः।
- MSC — Multiplicative Scatter Correction: multiplicative light-scattering तथा तत्सदृशप्रभावान् संशोधयितुं प्रयुक्तः विधिः।
- Savitzky–Golay: spectral-noise न्यूनीकर्तुं तथा spectral-shape रक्षितुं प्रयुक्तः smoothing/derivative-उपायः।
Savitzky–Golay कृते window-lengths 5, 7, 9 तथा 11; polynomial degrees 2 तथा 3; derivative degrees 1 तथा 2; PLS-components संख्या 1–30 पर्यन्तं grid search द्वारा मूल्याङ्किता।
model-performance-मापनमानानि
अध्ययने त्रयः मुख्याः performance-metrics प्रयुक्ताः।
\[ R^2 = 1 - \frac{\sum_i (y_i-\hat{y}_i)^2} {\sum_i (y_i-\bar{y})^2} \]
अत्र \(y_i\) दृष्टं crude protein-मूल्यम्, \(\hat{y}_i\) model-अनुमानम्, तथा \(\bar{y}\) दृष्टमूल्यानाम् औसतम्। \(R^2\) model इत्यनेन data-variation कियत्पर्यन्तं व्याख्यातम् इति दर्शयति।
\[ RMSE = \sqrt{ \frac{\sum_i (y_i-\hat{y}_i)^2}{n} } \]
RMSE अनुमानदोषाणां वर्गाणाम् औसतस्य वर्गमूलम् अस्ति। अतः न्यूनतरं RMSE अनुमानानि सन्दर्भमूल्यानां सामान्यतः समीपतराणि इति दर्शयति।
\[ Q^2 = 1-\frac{PRESS}{SS_{tot}} \]
\[ PRESS=\sum_i (y_i-\hat{y}_{i,-i})^2 \]
\(Q^2\) cross-validation-समये अदृष्टप्रतिदर्शेषु अनुमानानि कियत्पर्यन्तं अर्थपूर्णानि इति मूल्याङ्कयितुं प्रयुक्तं predictive-fit-मापनम् अस्ति। अध्ययने विशेषतः सर्वेषु preprocessing-विधिषु SWIR-models इत्येषां Q²-मूल्यानि 0,84 इत्यस्मात् अधिकानि आसन्; एतत् model-स्थिरतायाः मुख्यप्रमाणेषु एकम् इति प्रयुक्तम्।
अध्ययनस्य विधिः तथा परिणामाः
वनस्पतिसामग्री तथा sample-संरचना
अध्ययने कोरियादेशे संवर्धिताः 45 गोधूमप्रकाराः प्रयुक्ताः। 2023 सस्यसंग्रहे प्रत्येकप्रकारात् 20 कणाः तथा त्रयः technical repeats प्रयुज्य कुलतः 2700 कणाः चित्रिताः। 2024 सस्यसंग्रहे तेषामेव 45 प्रकाराणां 900 कणाः, तथा कोरियादेशे सामान्यतः संवर्धितेभ्यः षड्भ्यः प्रतिनिधिप्रकारेभ्यः प्रत्येकप्रकारात् 100 कणाः, अर्थात् अतिरिक्ताः 600 कणाः, प्रयुक्ताः। एवं 2024 वर्षस्य कुलसंख्या 1500, समग्राध्ययनस्य च कुलसंख्या 4200 वास्तविकगोधूमकणाः अभवत्।
प्रत्येकः वास्तविकः कणः VNIR तथा SWIR-प्रणालीयोः पृथक् चित्रितः; अतः 42 VNIR तथा 42 SWIR, कुलतः 84 hyperspectral-चित्राणि निर्मितानि, तथा analysis-अन्ते 4200 × 2 = 8400 व्यक्तिगताः spectral-कण-profile प्राप्ताः।
द्वे hyperspectral imaging-प्रणाल्यौ
| विशेषता | VNIR | SWIR |
|---|---|---|
| camera | Specim IQ | Specim SWIR |
| spectral range | 397,32–1003,58 nm | 982,08–2576,58 nm |
| bands संख्या | 204 | 288 |
| विधौ प्रतिवेदिता spectral resolution | 7 nm | 12 nm FWHM |
| प्रायः camera-दूरी | 1 m | 1 m |
| प्रकाशनम् | द्वौ halogen-प्रकाशस्रोतौ | द्वौ halogen-प्रकाशस्रोतौ |
| white reference | %99,9 परावर्तकं barium sulfate | मानक-यन्त्रस्य white-reference-panel |
SWIR imaging मध्ये चल-conveyor प्रयुक्तः। उभयप्रणाल्योः मूल-intensity-मूल्यानि white तथा dark references प्रयुज्य reflectance-मूल्येषु परिवर्तितानि:
\[ R=\frac{I-D}{W-D} \]
अत्र \(R\) calibrated reflectance, \(I\) मापिता मूल-intensity, \(D\) dark-current-intensity, तथा \(W\) white-reference-intensity अस्ति। समीकरणं sensor इत्यस्य dark-signal अपसार्य मापनं white-reference-range प्रति normalize करोति।
YOLOv11-प्रशिक्षण-data-set कथं निर्मितम्?
कुलतः 84 चित्रेषु 10 — 5 VNIR तथा 5 SWIR — यादृच्छिकतया चयनितानि तथा Labelme द्वारा हस्तेन label कृतानि। कणाः class 0, white reference च class 1 इति निर्दिष्टाः; प्रारम्भे 1000 कण-labels तथा 10 white-reference-labels निर्मितानि।
hyperspectral-cubes YOLO-प्रशिक्षणाय त्रिभ्यः bands इत्येभ्यः pseudo-RGB-चित्रेषु परिवर्तिताः। VNIR कृते 634,11 nm, 560,30 nm तथा 452,25 nm; SWIR कृते 1133,52 nm, 1335,78 nm तथा 1662,69 nm bands प्रयुक्ताः।
data augmentation मध्ये random cropping तथा image concatenation प्रयुक्ते; स्रोताध्ययनस्य प्रतिवेदनानुसारं training-data-set मूल-data-set अपेक्षया 110 गुणं विस्तारितम्।
YOLOv11-प्रशिक्षण-parameters
| parameter | मूल्यम् |
|---|---|
| Epoch | 100 |
| चित्रस्य आकारः | 640 × 640 pixels |
| Batch size | 4–6 |
| प्रारम्भिक learning rate | 0,01 |
| Momentum | 0,937 |
| Weight decay | 0,0005 |
| IoU validation threshold | 0,7 |
| Horizontal flip | 0,5 |
| Scale | 0,5 |
| Translation | 0,1 |
| HSV hue | 0,015 |
| HSV saturation | 0,7 |
| HSV value | 0,4 |
| Mosaic | 1,0 |
| Random erasing | 0,4 |
प्रशिक्षण-workstation मध्ये AMD Ryzen 5 3600 processor, 32 GB RAM तथा NVIDIA RTX 3060 GPU प्रयुक्ताः। Mixed-precision training (AMP) सक्रियीकृतम्।
data augmentation इत्यनेन YOLO-generalization कथं प्रभावितम्?
data augmentation इत्यनेन समानगोधूमकणचित्रेषु स्थान, scale तथा cropping-परिवर्तनानां प्रति model इत्यस्य सहनशीलता स्पष्टतया वर्धिता। मूलचित्रैः प्रशिक्षिताः models पूर्णाकारचित्रेषु अतीव उच्चानि F1-मूल्यानि प्राप्तुं शक्नुवन्ति स्म, तथापि cropped validation-चित्रेषु recall तथा F1 न्यूनौ अभवताम्; augmented training-sets प्रयुक्तेषु cropped-चित्रेषु F1-मूल्यानि पुनः प्रायः 0,99–1,00 अन्तरालं प्राप्तानि।
| Model | Precision | Recall | F1 |
|---|---|---|---|
| IA2 | 0,9735 | 1,0000 | 0,9866 |
| IA4 | 1,0000 | 1,0000 | 1,0000 |
| IA6 | 0,9932 | 1,0000 | 0,9966 |
| IA8 | 0,9932 | 1,0000 | 0,9966 |
| IA10 | 0,9932 | 0,9932 | 0,9932 |
एषा सारणी केवलं cropped-चित्रेभ्यः निर्मितां अध्ययनस्य validation-परिस्थितिं दर्शयति। भिन्न-camera, संस्था अथवा पर्यावरणपरिस्थितिषु सामान्य-performance इति न व्याख्येयम्।
processing-speed
YOLOv11 segmentation इत्यस्य median कुल-processing-time 25,00 ms इति मापितः। तस्मिन्नेव समीक्षणे YOLOv8 कृते 64,30 ms प्रतिवेदितम्। 25 ms/चित्र मूल्यं सैद्धान्तिकतया प्रायः 40 चित्र/second processing-speed इत्यस्य तुल्यम्; अनुसन्धातारः high-throughput data-processing दृष्ट्या एतत् महत्त्वपूर्णं लाभम् इति मूल्याङ्कितवन्तः।
PLSR training/validation/test-strategy
2023 तथा 2024 वर्षयोः spectral-data संयोजितम्, कुल-data इत्यस्य %10 यादृच्छिकतया independent test-set रूपेण पृथक्कृतम्। अवशिष्टे %90 मध्ये five-fold cross-validation प्रयुक्तम्; प्रत्येकस्मिन् fold मध्ये data %80 training तथा %20 validation रूपेण प्रयुक्तम्।
VNIR तथा SWIR अनुमानपरिणामाः
| पूर्वप्रक्रिया | spectrum | PLS-अवयवः | Test R² | Test RMSE | Q² / टिप्पणी |
|---|---|---|---|---|---|
| मूल-data | VNIR | 10 | 0,0641 | 2,0260 | न्यून-generalization |
| मूल-data | SWIR | 10 | 0,8693 | 0,7571 | SWIR-समूहः Q² > 0,84 |
| SNV | VNIR | 9 | 0,5205 | 1,4501 | VNIR सीमितम् |
| SNV | SWIR | 7 | 0,8547 | 0,7984 | SWIR-समूहः Q² > 0,84 |
| MSC | VNIR | 9 | -0,0495 | 2,1455 | Q² = -0,0296 |
| MSC | SWIR | 9 | 0,8725 | 0,7479 | Q² = 0,8738 |
| Savitzky–Golay | VNIR | 8 | 0,5750 | 1,3653 | Q² = 0,5793 |
| Savitzky–Golay | SWIR | 3 | 0,8449 | 0,8247 | Q² = 0,8487 |
एषा सारणी “उत्तम-model” इत्यस्य द्वौ भिन्नौ अर्थौ पृथक् दर्शयति। यदि केवलं सर्वोच्चं test R² अन्विष्यते, तर्हि MSC–SWIR संयोजनं प्रमुखं भवति। परन्तु model-complexity अपि विचार्यते चेत् Savitzky–Golay–SWIR model केवलैः त्रिभिः PLS-अवयवैः उच्चाम् अनुमानशक्तिं रक्षितवान्। अतः अस्मिन्नध्ययने सर्वोच्चा accuracy तथा सरलतमः model एकस्मिन् configuration मध्ये न स्तः।
उच्च-protein तथा निम्न-protein समूहयोः अनुमानानि
ऊर्ध्वतमेषु तथा अधस्तमेषु %10 protein-समूहेषु Savitzky–Golay-पूर्वप्रक्रियिताः PLSR-models पृथक् तुलिताः। उच्च-protein-समूहे मापितं मूल्यं 15,030 ± 0,908 %, SWIR-अनुमानं 14,988 ± 1,588 %, VNIR-अनुमानं 15,176 ± 2,664 % इति प्रतिवेदितम्। निम्न-protein-समूहे मापितं मूल्यं 11,838 ± 1,02 % आसीत्, यदा VNIR 12,254 ± 2,538 %, SWIR 10,845 ± 2,156 % इति अनुमानितवन्तौ।
एते एकसमूह-औसताः समग्र-model-performance इत्यस्य स्थानापन्नाः न भवन्ति। अनुसन्धातॄणां SWIR-श्रेष्ठता-विवेचनं केवलम् एतयोः द्वयोः समूहयोः औसतयोः आधारेण न, अपि तु test R², RMSE, Q² तथा cross-validation-परिणामानां समग्रतायाः आधारेण अस्ति।
अध्ययने समर्थिताः परिणामाः
- YOLOv11 hyperspectral-चित्रेषु व्यक्तिगतगोधूमकणानां automatic segmentation मध्ये उच्चं performance दातुं शकितवान्।
- data augmentation इत्यनेन cropped-चित्रेषु segmentation-generalization स्पष्टतया सुधारितम्।
- DBSCAN तथा Random Forest-उपायेन YOLO-boxes अन्तः spectral ROI-चयनं स्वचालितम्।
- SWIR-आधारितेन PLSR इत्यनेन अस्मिन् data-set मध्ये VNIR-आधारित-models अपेक्षया उच्चतरं तथा अधिकं स्थिरं protein-अनुमानं प्राप्तम्।
- MSC–SWIR इत्यनेन सर्वोच्चं test R² मूल्यं दत्तम्।
- Savitzky–Golay–SWIR इत्यनेन केवलैः त्रिभिः PLS-अवयवैः सरलतरः किन्तु शक्तिशाली model निर्मितः।
- अध्ययने YOLOv8-समीक्षणस्य तुलनायां YOLOv11 इत्यस्य processing-time न्यूनतरः आसीत्।
अध्ययने न समर्थिताः निष्कर्षाः
- model सर्वेषु गोधूमप्रकारेषु सर्वेषु देशेषु च समानां accuracy दास्यति इति न दर्शितम्।
- भिन्नेषु SWIR/VNIR-camera-यन्त्रेषु performance सत्यापितं न कृतम्।
- अनियन्त्रित-factory अथवा field-परिस्थितिषु एते एव परिणामाः स्थिराः भविष्यन्ति इति सिद्धं न कृतम्।
- model प्रत्यक्षं protein-molecule “न पश्यति”; सः spectral reflectance तथा Dumas-सन्दर्भमूल्ययोः मध्ये सांख्यिकीयसम्बन्धं अधिगच्छति।
- YOLO इत्यस्य उच्चं F1-मूल्यं protein-regression अपि तावत्येव accuracy युक्तम् इति न सूचयति।
- VNIR सर्वेषु रासायनिक-अनुमानकार्येषु सामान्यतः अपर्याप्तम् इति निष्कर्षः न निष्पादनीयः।
- SWIR-श्रेष्ठता अस्य अध्ययनस्य, एतेषां sensors, एतेषां प्रतिदर्शानां तथा अस्य protein-अनुमानस्य सन्दर्भे एव मूल्याङ्कनीया।
मुख्याः सीमाः
सर्वाणि hyperspectral-चित्राणि तैरेव Specim SWIR तथा Specim IQ camera-यन्त्रैः, नियन्त्रितप्रकाशे, मानकीकृतस्थाननिर्धारणे च गृहीतानि। अनुसन्धातारः स्पष्टतया लिखन्ति यत् 84 चित्राणां समग्र-performance-मूल्याङ्कने प्रशिक्षणाय प्रयुक्तानि चित्राणि अपि अन्तर्भूतानि। cropped-प्रदेशेषु पृथक् मूल्याङ्कनं कृतमपि, वास्तविक cross-system generalization कृते अन्यसंस्थानां, अन्ययन्त्राणां, भिन्नपर्यावरणपरिस्थितीनां च independent data-sets आवश्यकाः।
धान्य-hyperspectral-चित्राणां कृते विशालानां मानकीकृतानां public data-sets अभावः अध्ययनस्य विस्तृततर-benchmark-समीक्षणक्षमताम् अपि सीमितवान्।
स्रोतस्य आन्तरिक-संख्यात्मकप्रतिवेदनविषये टिप्पणी
स्रोतस्य परिणामभागे YOLO कृते “maximum F1 = 0,9989” इति उक्तम्; किन्तु अध्ययनस्य सारणीषु भिन्न-data तथा evaluation-परिस्थितिषु R10 = 0,9995, IA10 = 0,9996 तथा cropped IA4 = 1,0000 मूल्यानि सन्ति। अतः performance-मूल्यानि कस्मै सारणी-विषये तथा कस्मै evaluation-परिस्थित्यै सम्बद्धानि इति निर्दिश्य एव व्याख्येयानि।
तथा विधिभागे VNIR कृते 7 nm तथा SWIR कृते 12 nm FWHM spectral resolution प्रतिवेदितम्, यदा चर्चाभागे प्रायः 3,0 nm तथा 5,2 nm मूल्यानि अपि “spectral resolution” इति पदेन प्रयुक्तानि। स्रोतः एतयोः मूल्यसमूहयोः optical resolution तथा spectral sampling interval इत्यनयोः भेदं स्पष्टतया न परिभाषयति; अतः अत्र एकं मूल्यं अन्यस्य स्थाने संशोधितं न कृतम्।
स्रोतः तथा विधिविषयकः टिप्पणीभागः
मूल-अध्ययनम्:Assessment of crude protein in wheat kernels using SWIR hyperspectral imaging combined with deep learning-based segmentation
लेखकाः: Jae Gyeong Jung; Jin-Hyun Kim; Changsoo Kim; Donghwan Shim.
उत्तरदायी लेखकः: Donghwan Shim.
संस्थाः: Department of Biological Sciences, Chungnam National University; Genomics Division, Department of Agricultural Biotechnology, National Institute of Agricultural Sciences, Rural Development Administration; Department of Crop Science, Chungnam National University, Republic of Korea.
पत्रिका: Journal of Agriculture and Food Research.
खण्डः / लेख-संख्या: 26 (2026), 102679.
DOI: 10.1016/j.jafr.2026.102679
प्रकाशकः: Elsevier B.V.
प्राप्तिदिनाङ्कः: 20 August 2025.
संशोधनम्: 8 January 2026.
स्वीकृतिदिनाङ्कः: 14 January 2026.
online-प्रकाशनम्: 17 January 2026.
license: Creative Commons Attribution–NonCommercial 4.0 International (CC BY-NC 4.0).
वित्तपोषणम्: Rural Development Administration, Republic of Korea, Cooperative Research Program for Agricultural Science and Technology Development No. RS-2025-00512183; तथा Institute of Information & Communications Technology Planning & Evaluation (IITP), Korea government (MSIT), No. RS-2022-00155857, Artificial Intelligence Convergence Innovation Human Resources Development, Chungnam National University.
हितसंघर्षः: लेखकैः अध्ययनं प्रभावितुं शक्नुवन्तः ज्ञाताः वित्तीयहितसम्बन्धाः अथवा व्यक्तिगतसम्बन्धाः न प्रतिवेदिताः।
data-उपलब्धता: data याचनायां उपलब्धं भविष्यति इति निर्दिष्टम्।
वैज्ञानिकसीमा: परिणामाः नियन्त्रित-laboratory hyperspectral imaging-परिस्थितिषु प्राप्ताः। भिन्न-sensors, स्वतंत्रसंस्थागत-data-sets तथा परिवर्तनशीलपर्यावरणपरिस्थितिषु external validation न कृतम्। अध्ययनस्य दृढः परिणामः एषः यत् वर्तमानमानकीकृतव्यवस्थायां SWIR + YOLOv11 + spectral ROI + PLSR architecture high-throughput crude protein-अनुमानाय प्रयोज्यः अस्ति; एषः सर्वयन्त्रेषु समानः सार्वत्रिक-field-performance इति नास्ति।
Verianla-वर्णनसिद्धान्तः: एषः विषयः मूल-अकादमिकलेखस्य पूर्णपाठानुवादः नास्ति। प्रयोगरचना, गणितीय-metrics, यन्त्रपरिस्थितयः, प्रतिवेदितानि performance-मूल्यानि तथा methodological limitations स्रोतस्यानुसारं रक्षितानि; वर्णनं स्वतंत्रवैज्ञानिक-अधिगमसंरचनायां पुनः विन्यस्तम्। अकादमिक-सन्दर्भणस्य तथा स्रोतस्थचित्राणां मूलसन्दर्भस्य कृते DOI द्वारा प्रकाशितम् अध्ययनं परीक्षितव्यम्।
Leave a comment
Your email address will not be published. Required fields are marked *