

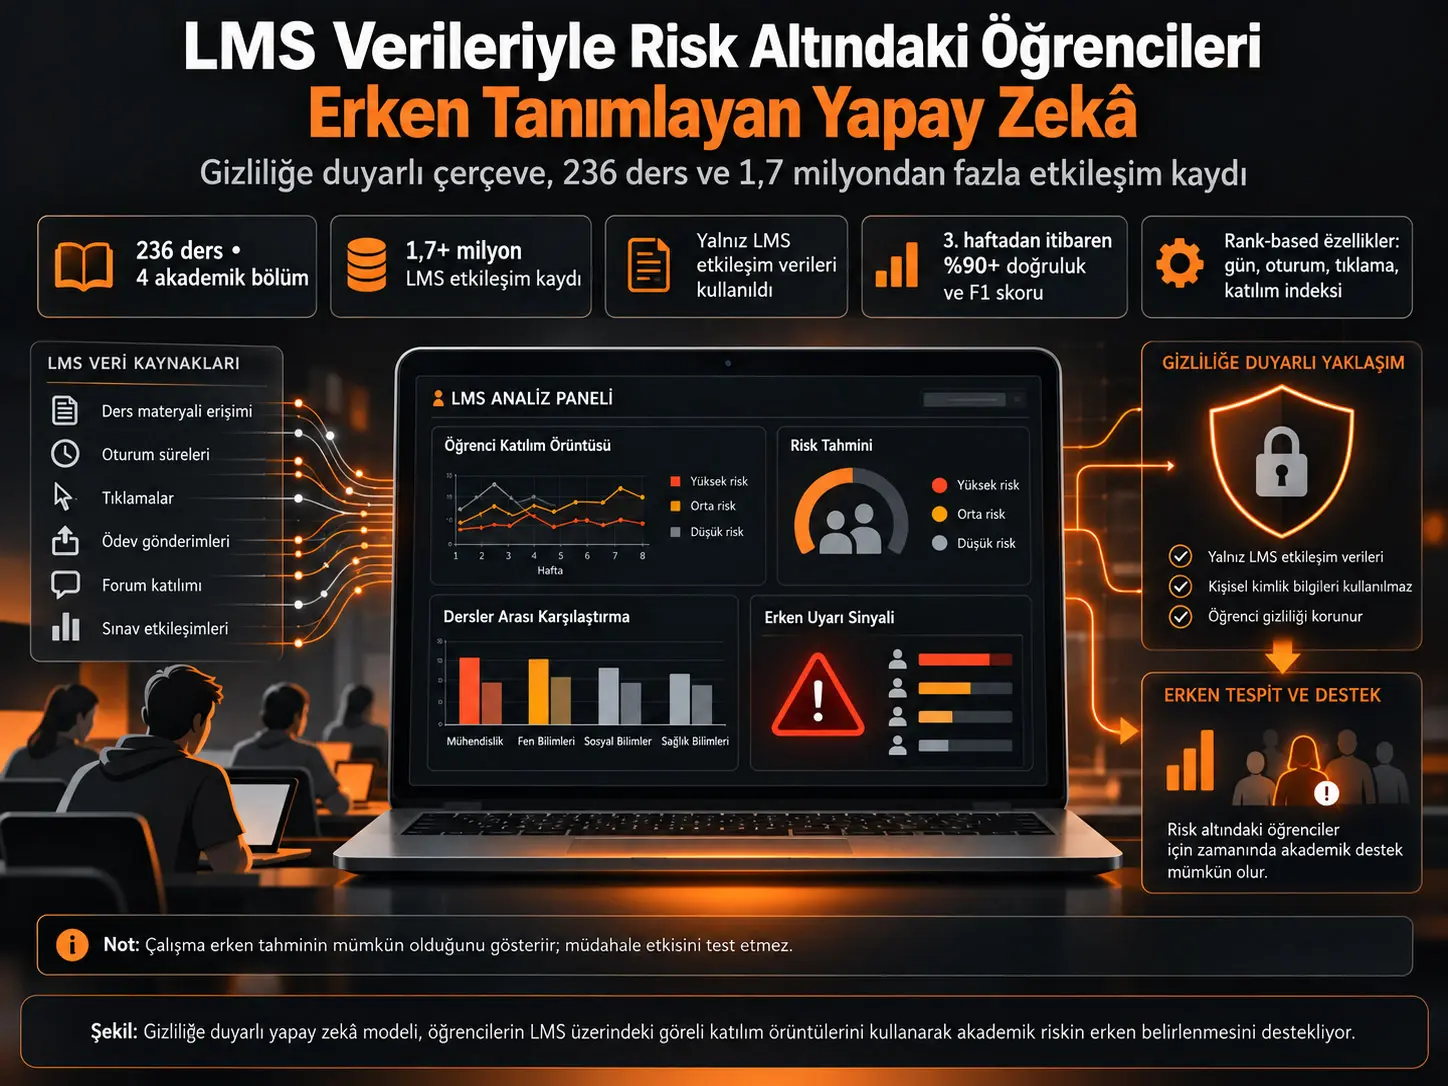
Gizliliğe duyarlı erken uyarı sistemi, öğrencinin demografik özellikleri veya önceki akademik geçmişi gibi daha hassas bilgileri kullanmadan, öğrenme yönetim sistemi üzerindeki davranış örüntülerinden akademik risk sinyali üretmeye çalışan tahmin yaklaşımıdır. Hon-Sun Chiu, Adam Wong ve Tung-Lok Wong'un çalışması, Hong Kong Polytechnic University bünyesindeki 236 lisans dersinden elde edilen 1,7 milyondan fazla Blackboard etkileşim kaydını kullanarak öğrencilerin dönem sonundaki performans kategorilerini erken haftalarda tahmin etmeyi incelemektedir.
Çalışmanın özgün yönlerinden biri, öğrencilerin ham LMS kullanım değerlerini dersler arasında doğrudan karşılaştırmak yerine rank-based engagement features, yani ders içindeki göreli katılım sıralarını kullanmasıdır. Örneğin bir öğrencinin Blackboard'a kaç gün girdiği, kaç oturum gerçekleştirdiği veya kaç tıklama yaptığı tek başına kullanılmak yerine, aynı dersteki diğer öğrenciler arasındaki sırası hesaplanmaktadır.
Bu yaklaşımın gerekçesi açıktır: 10 saatlik Blackboard kullanımı tamamen yüz yüze yürütülen bir ders için çok yüksekken, yoğun çevrim içi etkinlik gerektiren başka bir ders için düşük olabilir. Dolayısıyla ham tıklama veya süre değerleri farklı derslerde aynı anlamı taşımayabilir. Göreli sıralama, öğrencinin kendi ders bağlamındaki davranışını temsil ederek farklı disiplinlerin daha anlamlı biçimde karşılaştırılmasını amaçlamaktadır.
Random Forest sınıflandırıcısıyla yapılan analizde genel modelin doğruluk ve F1 skorları üçüncü öğretim haftasından itibaren %90'ın üzerine çıkmıştır. Bu, henüz dönem sonu sınavları veya notları oluşmadan önce akademik risk açısından kullanılabilir bir erken sinyal üretmenin mümkün olabileceğini göstermektedir.
Ancak modelin yüksek doğruluğu bir destek müdahalesinin öğrencilerin başarısını artırdığını göstermez. Araştırmacılar herhangi bir erken danışmanlık, kişiselleştirilmiş geri bildirim veya başka destek müdahalesinin etkisini test etmemiştir. Çalışmanın gösterdiği şey erken tahmin yapılabildiğidir; bu tahmine dayanarak gerçekleştirilecek müdahalelerin gerçekten etkili olup olmadığı gelecekte ayrıca araştırılmalıdır.
Üniversiteler neden öğrenciyi üçüncü haftada tanımak istiyor?
Geleneksel akademik risk tespiti çoğu zaman öğrenci düşük sınav notu aldıktan, ödev teslimlerini kaçırdıktan veya devamsızlığı belirgin hâle geldikten sonra devreye girer. Bu durumda destek için kullanılabilecek zamanın önemli bir bölümü kaybedilmiş olabilir.
Öğrenme yönetim sistemleri ise öğrencinin dersle ilişkisine ilişkin çok daha erken davranış izleri üretir. Öğrencinin Blackboard'a hangi günlerde eriştiği, kaç oturum gerçekleştirdiği, kaç içeriğe tıkladığı ve sistemde ne kadar süre kaldığı gibi bilgiler henüz ilk sınav yapılmadan oluşmaktadır.
Bu araştırmanın temel sorusu şudur:
Bir öğrencinin kişisel demografik geçmişini veya eski notlarını kullanmadan, yalnız LMS üzerindeki erken dönem davranışlarından dönem sonunda risk altında olup olmayacağı tahmin edilebilir mi?
Veri nereden geliyor?
Araştırma The Hong Kong Polytechnic University bünyesindeki School of Professional Education and Executive Development ortamında gerçekleştirilmiştir.
Veri seti dört akademik bölümdeki dersleri kapsamaktadır:
- Business and Hospitality Management,
- Languages and Communication,
- Science, Engineering and Health Studies,
- Social Sciences, Humanities and Design.
2023–2024 akademik yılının ikinci dönemindeki 236 lisans dersi araştırmaya dahil edilmiştir. Dersler yüz yüze, çevrim içi ve hibrit öğretim biçimlerini; sınav bulunan ve bulunmayan farklı değerlendirme yapılarını içermektedir.
Blackboard öğrenci etkinlik günlüklarından 1,7 milyondan fazla kayıt çıkarılmıştır.
Bir Öğrencinin Çok Tıklaması Başarılı Olacağı Anlamına mı Geliyor?
Hayır. Makalenin önemli sonuçlarından biri de budur.
Farklı derslerin LMS kullanım biçimleri büyük ölçüde değiştiği için ham etkinlik değerleriyle ders notları arasındaki korelasyonlar genel olarak düşüktür. Örneğin bazı derslerde öğrencilerin materyalin önemli bölümünü yüz yüze işlemesi mümkündür; başka bir derste ise neredeyse bütün etkinlik Blackboard üzerinden gerçekleştirilebilir.
Bu nedenle “daha fazla tıklama = daha yüksek başarı” gibi evrensel bir kural kurmak doğru değildir.
Makalenin 14. sayfasındaki karşılaştırmalar, dört akademik bölümün tamamında ham LMS özellikleri ile notlar arasındaki korelasyonların düşük olduğunu göstermektedir. Örneğin platforma giriş yapılan gün sayısı ile ders notu arasındaki korelasyon yaklaşık 0,142–0,203 arasında değişirken bazı tıklama yoğunluğu değişkenlerinde negatif değerler bile görülmektedir.
Buna karşılık aynı sayfadaki öğrenci aktivitesini not kategorilerine göre gösteren grafik, daha yüksek not alan öğrencilerin genel olarak daha sık sisteme erişme, daha fazla oturum gerçekleştirme ve daha fazla etkileşim kurma eğiliminde olduğunu göstermektedir.
Bu iki bulgu çelişkili değildir. Genel davranış örüntüsü vardır; fakat ham sayıların anlamı her dersin kendi yapısına bağlıdır.
Rank-Based Engagement Özellikleri Nedir?
Araştırmacıların önerdiği çözüm, öğrencinin mutlak LMS aktivitesini değil, aynı dersteki diğer öğrencilere göre göreli konumunu hesaplamaktır.
| Özellik | Anlamı |
|---|---|
| Rank_Days | Öğrencinin Blackboard'a eriştiği gün sayısı açısından kendi dersindeki sırası |
| Rank_Sessions | LMS oturum sayısı açısından ders içindeki sırası |
| Rank_Total_Time | Blackboard'da geçirilen toplam süre açısından ders içindeki sırası |
| Rank_Total_Clicks | Toplam tıklama sayısı açısından ders içindeki sırası |
| Index | Rank_Days + Rank_Sessions + Rank_Total_Clicks toplamından oluşturulan bileşik katılım göstergesi |
Böylece bir öğrencinin “20 kez giriş yaptı” bilgisinden çok, kendi dersindeki öğrencilerin önemli bölümünden daha fazla veya daha az etkileşim kurduğu bilgisi kullanılmaktadır.
Bu dönüşüm, dersler arasındaki farklı LMS kullanım yoğunluğunu kısmen standardize etmeyi amaçlar.
Neden süre tek başına güvenilir değil?
Araştırmacılar özellikle toplam LMS süresinin problemli olabileceğini belirtmektedir.
Bir öğrenci Blackboard'da bir dosyayı açıp bilgisayarını açık bırakabilir. Sistem uzun bir erişim süresi kaydetmesine rağmen öğrenci materyalle gerçekte etkileşime girmiyor olabilir.
Bu nedenle araştırmacılar yalnız süreye bağımlı kalmamış ve Index değişkeninde erişim günü, oturum sayısı ve toplam tıklamayı bir araya getirmiştir.
Sisteme hiç girmeyen öğrenciler ne oluyor?
Rank tabanlı yaklaşımın başka bir avantajı, ilk haftalarda Blackboard'a hiç giriş yapmayan öğrencilerin veri setinden kaybolmamasıdır.
Ham özellik yaklaşımında aktivite kaydı bulunmayan öğrenci bazı analizlerde eksik değer nedeniyle dışarıda kalabilir. Bu araştırmada böyle öğrenciler kendi derslerindeki en düşük rank değerine yerleştirilerek veri setinde tutulmaktadır.
Erken uyarı sistemleri açısından bu özellikle önemlidir; çünkü hiçbir LMS aktivitesi göstermemek zaten potansiyel bir disengagement sinyali olabilir.
“Gizliliğe Duyarlı” İfade Gerçekte Ne Anlama Geliyor?
Çalışma öğrencilerin:
- cinsiyetini,
- yaşını,
- sosyoekonomik durumunu,
- önceki akademik geçmişini,
- eski GPA veya not kayıtlarını
tahmin modelinin girdisi olarak kullanmamaktadır.
Temel veri kaynağı öğrencinin LMS içindeki davranışıdır.
Bu nedenle yaklaşım, çok sayıda eğitim tahmin sistemine göre daha az kişisel veri kullanmaktadır ve veri minimizasyonu ilkesine daha yakındır.
Ancak bu noktada önemli bir terminoloji sınırı bulunmaktadır. Makalenin kendisi de LMS davranış verisinin potansiyel olarak kişiyi tanımlayabilir olduğunu kabul etmektedir.
Dolayısıyla burada kullanılan “privacy-conscious” ifadesi:
“Öğrenci gizliliğini matematiksel olarak garanti eden bir sistem” anlamına gelmez.
Çalışmada differential privacy veya federated learning gibi formal privacy-preserving mekanizmalar uygulanmamıştır. Yazarlar kendi yaklaşımlarını bunlara göre daha basit ve kurumsal olarak uygulanabilir bir veri minimizasyonu alternatifi şeklinde konumlandırmaktadır.
Risk Altındaki Öğrenci Nasıl Tanımlandı?
Öğrenciler dönem sonu ders notlarına göre üç sınıfa ayrılmıştır:
| Grup | Kaynak çalışmadaki tanım |
|---|---|
| Yüksek performans | A ve üzeri |
| Normal performans | C ile A− arası |
| Risk altında | C− ve altı |
Risk altındaki öğrenciler toplam veri setinin yaklaşık %5'ini oluşturmaktadır.
Bu oran makine öğrenmesinde önemli bir sorun yaratır: model yalnız çoğunluk grubunu tahmin ederek yüksek görünen bir doğruluk üretebilir.
SMOTE Neden Kullanıldı?
Veri setinde hem risk altındaki hem de çok yüksek performanslı öğrenciler çoğunluğa göre daha azdır. Bu durum sınıf dengesizliği olarak adlandırılır.
Araştırmacılar bu sorunu azaltmak için Synthetic Minority Over-sampling Technique, yani SMOTE kullanmıştır.
SMOTE, az sayıdaki sınıfın mevcut örneklerini basitçe kopyalamak yerine bu örneklerin özelliklerinden yeni sentetik eğitim örnekleri üretir.
Metodolojik açıdan önemli nokta şudur: araştırmacılar önce eğitim ve test verisini ayırmış, SMOTE'u yalnız eğitim setine uygulamıştır.
Böylece sentetik oluşturulan örneklerin test setine sızarak model performansını yapay biçimde yükseltmesi önlenmeye çalışılmıştır.
Çalışmanın Yöntemi ve Bulguları
Kullanılan modeller
Araştırmada üç temel model kullanılmıştır:
- Random Forest Regressor,
- Multiple Linear Regression,
- Random Forest Classifier.
Regresyon modelleri öğrencinin performansını sürekli bir değer olarak tahmin etmek için karşılaştırılmıştır. Random Forest Regressor, doğrusal regresyona göre daha yüksek R² ve daha düşük ortalama kare hata göstermiştir.
Ancak çalışmanın asıl odağı regresyon değil, öğrencileri üç performans kategorisine ayıran Random Forest sınıflandırmasıdır.
Özellik seçimi nasıl yapıldı?
Modelde kullanılabilecek değişkenler SelectKBest yöntemiyle değerlendirilmiştir.
Makalenin 17. sayfasındaki örnek SelectKBest çıktısı ve izleyen karşılaştırma, rank tabanlı özelliklerin ham LMS özelliklerine göre genellikle daha yüksek seçim skoru aldığını göstermektedir.
Makalenin 18. sayfasındaki grafikte de öğretim haftaları ilerledikçe rank tabanlı özelliklerin seçim oranının ham özelliklere göre belirgin biçimde daha yüksek kaldığı görülmektedir.
Bu nedenle sonraki ana tahmin modellerinde rank tabanlı özellikler tercih edilmiştir.
İlk test: büyük dersler
İlk performans değerlendirmesi sınav içeren ve sınıf büyüklüğü 80'in üzerinde olan 16 büyük derste yapılmıştır.
Bu alt örneklem 2341 öğrenciyi kapsamaktadır.
Veri öğrenci düzeyinde tabakalı biçimde %70 eğitim ve %30 test setine ayrılmış; aynı öğrenciye ait verilerin iki tarafa da dağılmamasına dikkat edilmiştir. Eğitim bölümü içinde beş katlı çapraz doğrulama kullanılmış ve SMOTE yalnız eğitim verisine uygulanmıştır.
Bu ilk sınıflandırmada rank tabanlı özellikler kullanıldığında Random Forest Classifier'ın hem doğruluk hem F1 skoru %80'in üzerine çıkmıştır.
Model 236 dersin tamamına nasıl genişletildi?
Farklı derslerin yalnız öğrenci davranışları değil, öğretim ve değerlendirme yapıları da farklıdır. Araştırmacılar bu nedenle beş rank tabanlı değişkene üç ders bağlamı değişkeni eklemiştir:
- EXAM: derste sınav olup olmadığı,
- MODE: yüz yüze, çevrim içi veya hibrit öğretim,
- DIVISION: dersin bağlı olduğu akademik bölüm.
Böylece ana modelde toplam sekiz girdi kullanılmıştır.
Üçüncü Haftada %90'ın Üzerinde Tahmin Gerçekten Elde Edildi mi?
Evet; bu çalışmanın kendi test düzeni içinde, 236 dersin tamamını kapsayan Random Forest sınıflandırmasının doğruluk ve F1 skorları üçüncü öğretim haftasından itibaren %90'ın üzerine çıkmıştır.
Kaynakta Tablo 6 araştırmanın genel performans aralığını yaklaşık %87–93 doğruluk olarak özetlemektedir.
Makalenin 22. sayfasındaki tüm 236 dersi kapsayan grafik de ilk haftadan üçüncü haftaya hızlı bir performans artışı ve sonrasında %90'ın üzerinde kalan bir eğri göstermektedir.
Bu sonuç erken akademik risk tespitinin final notları veya dönem sonu sınavları oluşmadan yapılabileceğini göstermektedir.
Neden ilk iki hafta daha kötü?
Kurumun akademik takviminde ilk iki hafta ders ekleme ve bırakma dönemidir.
Öğrenciler ders değiştirebildiği veya kaydı henüz kesinleşmediği için:
- LMS etkileşim kayıtları daha azdır,
- sınıf listeleri hâlâ değişmektedir,
- öğrencinin davranış örüntüsü yeterince oluşmamıştır.
Üçüncü hafta ise resmî kayıt sayım noktasıdır. Araştırmacılar ilk iki haftadaki daha düşük performansın bu bağlamla ilişkili olabileceğini belirtmektedir.
Büyük sınıflarda model neden biraz daha güçlü?
Sonuçlar büyük derslerde tahmin performansının orta ve küçük derslere göre genel olarak daha yüksek olduğunu göstermektedir.
Araştırmacılar bunun olası nedenlerinden birinin büyük sınıflardaki not dağılımlarının daha düzenli ve normale yakın hâle gelmesi olduğunu öne sürmektedir.
Küçük sınıflarda birkaç öğrencinin farklı davranışı bile dağılımın yapısını daha fazla değiştirebilir ve rank tabanlı özelliklerle nihai notlar arasındaki ilişkinin daha karmaşık görünmesine neden olabilir.
Bu açıklama çalışmanın yorumudur; sınıf büyüklüğünün performans farkına doğrudan neden olduğu deneysel olarak test edilmemiştir.
At-risk öğrenciler çoğunlukta olmadığı hâlde model onları yakalayabiliyor mu?
Makalenin 23. ve 24. sayfalarındaki sınıf bazlı precision, recall ve F1 grafiklerinde risk altındaki ve yüksek performanslı azınlık sınıflarının sonuçları çoğu haftada çoğunluğu oluşturan “normal” sınıftan daha düşük değildir; hatta precision ve F1 açısından daha yüksek görünmektedir.
Yazarlar bunu SMOTE uygulaması sonrasında modelin azınlık sınıflarına yönelik karar sınırlarını daha iyi öğrenmesine bağlamaktadır.
Bu sonuç sınıf dengesizliği sorununun bu veri setinde büyük ölçüde kontrol edildiğini düşündürse de başka üniversitelerde aynı örüntünün mutlaka tekrarlanacağı anlamına gelmez.
Model Öğrencinin Başarısız Olmasını Engelliyor mu?
Hayır; bu araştırma bunu test etmedi.
Model öğrenciyi erken dönemde risk kategorisine ayırabilir. Fakat tahmin sonrasında:
- öğrenciye danışmanlık verilmesi,
- kişiselleştirilmiş geri bildirim gönderilmesi,
- öğrenme desteğine yönlendirilmesi,
- uyarlanabilir materyal sunulması
gibi müdahalelerin öğrenci başarısını gerçekten artırıp artırmadığı bu çalışmanın deneysel kapsamına girmemektedir.
Yazarlar sistemi bu nedenle nihai çözüm olarak değil, proaktif öğrenci desteğini başlatabilecek bir erken uyarı altyapısı olarak konumlandırmaktadır.
Disiplinler Arası Genellenebilirlik Ne Kadar Kanıtlandı?
Çalışma tek bir ders yerine 236 farklı ders, dört akademik bölüm, farklı sınıf büyüklükleri, farklı değerlendirme biçimleri ve yüz yüze/çevrim içi/hibrit öğretim ortamları içermesi bakımından birçok öğrenme analitiği çalışmasına göre oldukça geniş bir iç çeşitliliğe sahiptir.
Rank tabanlı özelliklerin en önemli amacı da bu heterojenliğe dayanıklı olmaktır.
Ancak bütün veriler aynı üniversite sistemi içinden gelmektedir.
Dolayısıyla burada gösterilen şey:
Aynı kurum içindeki çok farklı disiplin ve ders yapıları arasında çalışan bir modeldir.
Başka ülkelerde, farklı LMS sistemlerinde veya başka öğrenci popülasyonlarında aynı doğruluk düzeyinin korunacağı henüz bu makaleyle doğrulanmış değildir.
Bu nedenle “cross-disciplinary generalizability” güçlü bir çalışma içi sonuçtur; “cross-institutional generalizability” ise gelecekte ayrıca doğrulanması gereken bir konudur.
Çalışmanın desteklediği sonuçlar
- Ham LMS aktivite değerleri çok farklı dersler arasında doğrudan karşılaştırıldığında tahmin gücü zayıflayabilir.
- Ders içindeki göreli sıralamaya dayalı özellikler, heterojen dersler arasında daha tutarlı davranış göstergeleri oluşturabilir.
- Random Forest sınıflandırması bu veri setinde güçlü performans göstermiştir.
- 236 dersin tamamında kullanılan model üçüncü haftadan itibaren %90'ın üzerinde doğruluk ve F1 skoru üretmiştir.
- Demografik ve eski akademik bilgiler kullanılmadan güçlü erken tahmin mümkündür.
- Ders modu, sınav durumu ve akademik bölüm gibi bağlamsal değişkenlerin eklenmesi tahmin performansını artırmıştır.
- SMOTE sonrasında azınlık performans sınıfları model tarafından güçlü biçimde ayırt edilebilmiştir.
Çalışmanın desteklemediği sonuçlar
- Modelin öğrencilerin başarısız olmasını azalttığı kanıtlanmamıştır.
- Erken uyarının öğrenci devamlılığını veya mezuniyet oranını artırdığı deneysel olarak gösterilmemiştir.
- Modelin başka üniversitelerde aynı %90+ performansı göstereceği doğrulanmamıştır.
- LMS aktivitesinin öğrencinin gerçek öğrenmesini eksiksiz ölçtüğü söylenemez.
- Daha fazla Blackboard kullanımı tek başına daha yüksek başarıya neden olur sonucu çıkarılamaz.
- Sistem formal bir diferansiyel gizlilik veya federated learning garantisi sağlamamaktadır.
En önemli sınırlılıklar
Birinci sınırlılık: LMS kayıtlarının ayrıntı düzeyi. Blackboard bir öğrencinin dosyayı açtığını gösterebilir; fakat öğrencinin gerçekten okuyup okumadığını veya dosyayı açık bırakıp başka bir şey yapıp yapmadığını kesin olarak göstermez.
İkinci sınırlılık: değerlendirme verisinin ayrıntı düzeyi. Kurumsal not çizelgeleri “test”, “ödev” veya “grup projesi” gibi yüksek seviyeli kategoriler sunmaktadır. Bir testin kaç parçadan oluştuğu veya ödevin çevrim içi, zaman sınırlı ya da evde yapılan bir çalışma olup olmadığı gibi ayrıntılar modelde bulunmamaktadır.
Üçüncü sınırlılık: kurumlar arası dış doğrulama yoktur. Veri çok disiplinli olsa da tek bir üniversite yapısından gelmektedir.
Dördüncü sınırlılık: davranış izi öğrenmeyle aynı şey değildir. Tıklama, oturum ve platform süresi öğrenmenin yalnız dijital izlerini gösterir; öğrencinin anlaması, motivasyonu veya çevrim dışı çalışma süresi doğrudan ölçülmemektedir.
Beşinci sınırlılık: gizlilik garantisi sınırlıdır. Demografik veri kullanılmaması mahremiyet açısından avantaj sağlar; fakat LMS kayıtlarının kendisi de bireysel davranış bilgisidir.
Gelecek araştırmalar neyi test etmeli?
Yazarlar gelecekte daha ayrıntılı LMS olay kayıtlarının kullanılmasını önermektedir. Bir öğrencinin hangi içeriği yalnız açtığı, hangisiyle etkin biçimde çalıştığı ve oturum içindeki davranışların nasıl geliştiği daha ayrıntılı şekilde ölçülebilirse tahminlerin pedagojik anlamı güçlenebilir.
Aynı şekilde ödev ve sınav yapılarının daha ayrıntılı kaydedilmesi, farklı değerlendirme tasarımlarıyla LMS davranışı arasındaki ilişkinin incelenmesini sağlayabilir.
En önemli sonraki adım ise tahmin sonrasında gerçek müdahalenin test edilmesidir. Örneğin:
- erken danışmanlık,
- kişiselleştirilmiş geri bildirim,
- öğrenme destek hizmetine yönlendirme,
- uyarlanabilir öğrenme materyali
uygulandığında risk grubundaki öğrencilerin gerçek akademik sonuçlarının değişip değişmediği kontrollü araştırmalarla değerlendirilmelidir.
Kaynak ve Yöntem Notu
Özgün çalışma: A Privacy-Conscious AI Framework for Early Identification of At-Risk Students Across Disciplines Using LMS Engagement Data
Yazarlar: Hon-Sun Chiu, Adam Wong ve Tung-Lok Wong
Kurum: Division of Science, Engineering, and Health Studies, School of Professional Education and Executive Development, The Hong Kong Polytechnic University, Hong Kong, China.
Dergi: Education Sciences
Yıl / Cilt / Makale: 2026; 16; 1046.
Yayımlanma tarihi: 1 Temmuz 2026.
DOI: 10.3390/educsci16071046
Resmî kaynak:https://doi.org/10.3390/educsci16071046
Lisans: Creative Commons Attribution (CC BY).
Çalışma türü: Yükseköğretim öğrenme analitiği ve makine öğrenmesi temelli erken risk tahmin araştırması.
Veri dönemi: 2023–2024 akademik yılının ikinci dönemi.
Ders sayısı: 236.
Akademik bölüm: Dört.
LMS: Blackboard.
LMS kayıt ölçeği: 1,7 milyondan fazla öğrenci etkileşim kaydı.
Risk tanımı: Dönem sonu ders notunun C− veya altında olması; veri setinin yaklaşık %5'i.
Temel model: Random Forest Classifier.
Yardımcı modeller: Random Forest Regressor ve Multiple Linear Regression.
Temel özellik mühendisliği: Öğrencilerin kendi derslerindeki LMS kullanımına göre rank tabanlı Days, Sessions, Total Time ve Total Clicks değişkenleri ile bileşik Index.
Ders bağlamı değişkenleri: EXAM, MODE ve DIVISION.
Sınıf dengesizliği yöntemi: SMOTE; train-test ayrımından sonra yalnız eğitim verisine uygulanmıştır.
Ana performans sonucu: 236 dersin tamamındaki sınıflandırmada doğruluk ve F1 skoru üçüncü öğretim haftasından itibaren %90'ın üzerinde bildirilmiştir.
Finansman: Research Grants Council of the Hong Kong Special Administrative Region, China; Project No. UGC/FDS24/H06/23.
Etik kurul: Makalede Institutional Review Board Statement “Not applicable” olarak bildirilmiştir.
Bilgilendirilmiş onam: “Not applicable” olarak bildirilmiştir.
Veri erişimi: Veri seti gizlilik ve etik kısıtlamalar nedeniyle açık olarak paylaşılmamaktadır.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir. Fon sağlayıcının çalışma tasarımı, veri toplama, analiz, yorumlama, makale yazımı veya yayın kararında rolü olmadığı belirtilmiştir.
Yapay zekâ kullanım beyanı: Yazarlar makalenin hazırlanması sırasında Microsoft Copilot sürüm 1.25054.80.0'ı yalnız proofreading amacıyla kullandıklarını, çıktıları gözden geçirip düzenlediklerini ve yayın içeriğinin sorumluluğunu üstlendiklerini bildirmiştir.
Temel mahremiyet notu: Çalışma demografik ve geçmiş akademik verileri model girdisi olarak kullanmamaktadır. Buna rağmen LMS davranış kayıtları potansiyel olarak tanımlanabilir olduğundan yaklaşım “privacy-conscious” olarak değerlendirilmelidir; formal privacy-preserving teknoloji içerdiği şeklinde yorumlanmamalıdır.
Temel genellenebilirlik notu: Model aynı kurum içindeki 236 heterojen ders ve dört akademik bölümde sınanmıştır. Başka üniversite ve LMS ortamlarında bağımsız dış doğrulama bu çalışma kapsamında yapılmamıştır.
Verianla yeniden yapılandırma notu: Bu içerik kaynak makalenin Türkçe tam çevirisi değildir. Makalenin veri yapısı, model mimarisi, doğrulanabilir performans sonuçları, etik yaklaşımı ve sınırlılıkları bilimsel bilgi düzeyinde ayrıştırılmış; bağımsız ve öğretici bir Türkçe anlatı içinde yeniden yapılandırılmıştır. Kaynak grafik ve ekran görüntüleri görsel olarak kopyalanmamış, gerekli bilimsel ilişkiler yeni açıklamalar ve HTML tablolarıyla sunulmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir