

Жасалма интеллект менен видео жаратуу тез өнүгүп жатат. Эми бир нече секунддук кыска клиптер гана эмес, бир мүнөттөн ашкан видеолор, жарнамалар, влог стилиндеги контент, продукт тааныштыруулары жана окуя баяндары да жаратылышы мүмкүн. Бирок маанилүү суроо бар: модель кыска сахнаны жакшы жаратканы үчүн узун видеодо ошол эле каарманды, ошол эле окуя агымын, ошол эле үн шайкештигин жана логикалык өтүүлөрдү сактай алабы?
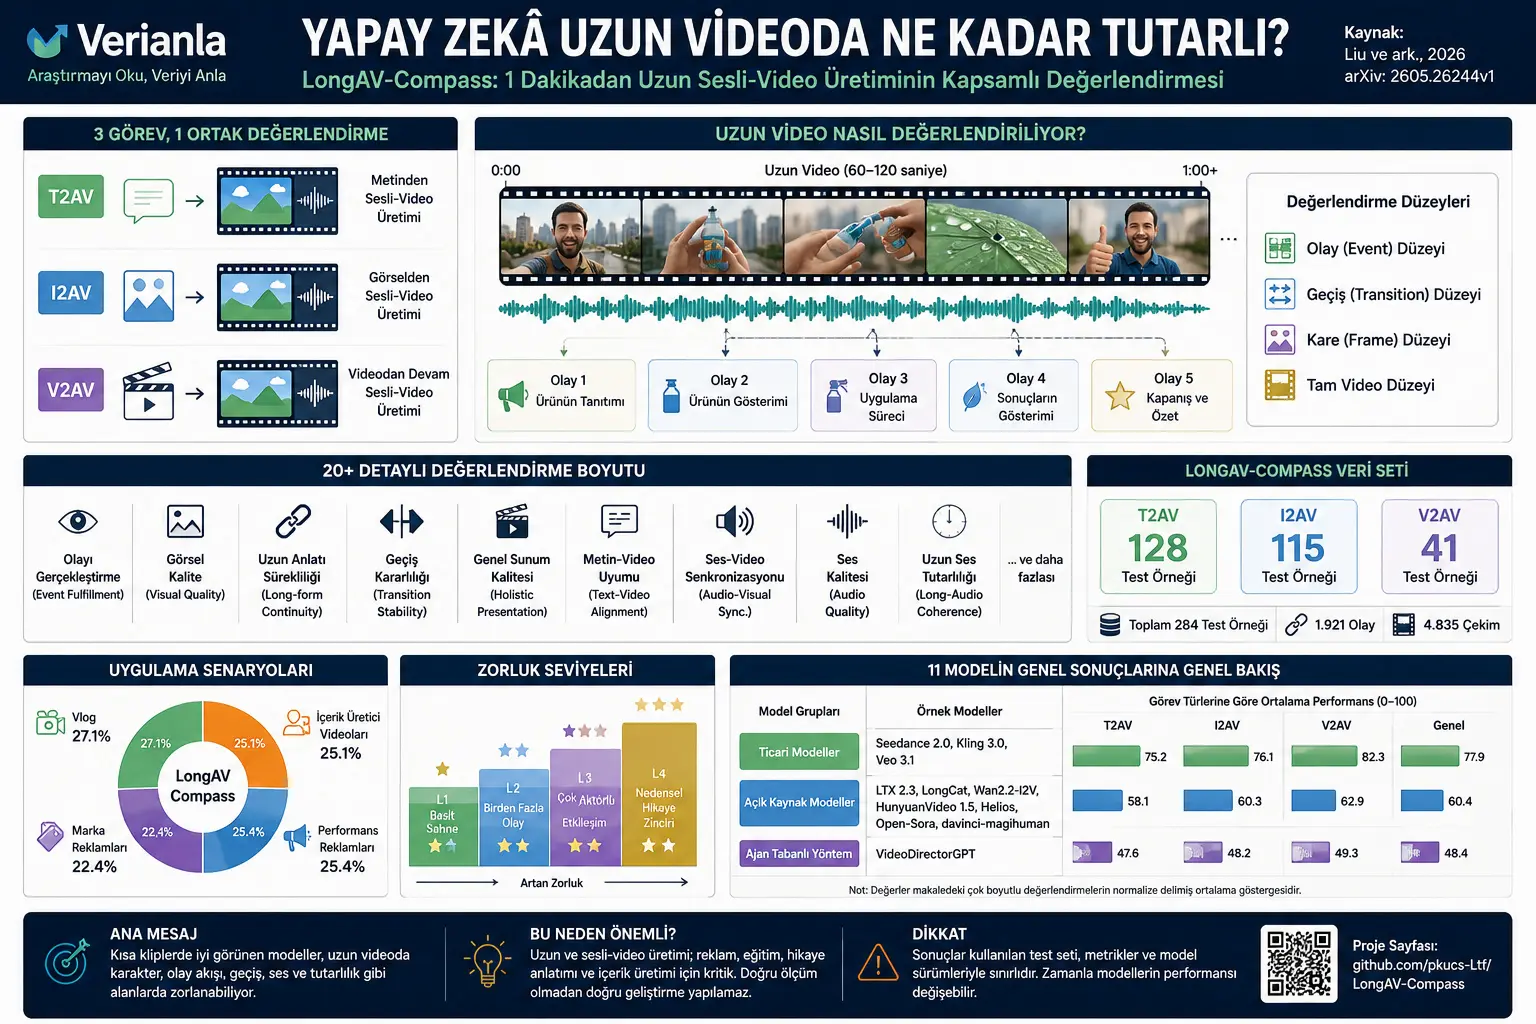
Tengfei Liu жана кесиптештери бул суроого жооп издөө үчүн LongAV-Compass деп аталган баалоо системасын сунуштайт. Бул система бир мүнөттөн узун үндүү-видео жаратууну үч башка тапшырма түрүндө изилдейт: тексттен үндүү видео жаратуу, сүрөттөн үндүү видео жаратуу жана учурдагы видеодогу уландысын жаратуу.
Изилдөө 284 сыноо үлгүсү аркылуу 11 башка видео жаратуу системасын баалайт. Натыйжалар азыркы моделдер кыска клиптерде таасирдүү көрүнгөнү менен, узак мөөнөттүү баян, каарман ырааттуулугу, сахна өтүүлөрү жана үн-видео шайкештиги жагынан дагы эле кыйналып жатканын көрсөтөт.
Бүгүн көптөгөн жасалма интеллект моделдери кыска видеолорду жарата алат. Бир нече секунддук сахнада визуалдык сапат жогору болушу, кыймылдар таасирдүү көрүнүшү жана тексттеги негизги идея болжол менен кармалышы мүмкүн.
Бирок узун видео жаратуу башка маселе. Бир мүнөттүк видеодо модель жалаң кооз сүрөт жаратышы жетишсиз. Төмөнкүлөрдү да сактоосу керек:
- Каарман же продукт бирдей калышы керек.
- Сахна өтүүлөрү логикалык болушу керек.
- Окуялардын ырааттуулугун жоготпоосу керек.
- Үн сүрөттөгү кыймылдар менен шайкеш болушу керек.
- Окуя башынан аягына чейин ырааттуу өнүгүшү керек.
- Продукт тааныштыруу же жарнама сыяктуу контентте берилген убадалар жана көрсөтүлгөн процесстер бирин-бири толукташы керек.
Учурдагы көптөгөн benchmarkтар, башкача айтканда модель баалоо тесттери, адатта 5-10 секунддук кыска видеолорго басым жасашат. Бул тесттер кыска клиптерде визуалдык сапатты же текст менен шайкештикти өлчөө үчүн пайдалуу болушу мүмкүн. Бирок узун видеодо пайда болгон бузулууларды кармоодо жетишсиз калышы мүмкүн.
Ошондуктан изилдөөчүлөр төмөнкү суроого басым жасашат:
Жасалма интеллект видео моделдерин чыныгы узун жана үндүү-видео жаратууга жөндөмдүүбү деген жагынан кантип тактап сынай алабыз?
Ыкма эмне сунуштайт?
Макала LongAV-Compass деп аталган жаңы benchmark сунуштайт. Benchmark жасалма интеллект моделдеринин узун үндүү-видео жаратуусун кеңирирээк жана диагностикалык түрдө өлчөөнү максат кылат.
LongAV-Compass үч негизги тапшырма түрүн камтыйт:
1. T2AV – Text-to-Audio-Video
Тексттен үндүү видео жаратуу. Модель берилген сценарий же текст сүрөттөмөсүнөн сүрөт да, үн да камтыган узун видео жаратууга аракет кылат.
2. I2AV – Image-to-Audio-Video
Сүрөттөн үндүү видео жаратуу. Модель берилген референс сүрөт жана сценарийди колдонуп узун видео түзөт. Бул жердеги маанилүү суроо: сүрөттөгү адам, объект, продукт же сахна узун видео бою сактала алабы?
3. V2AV – Video-to-Audio-Video
Видеодон үндүү видео уландысын жаратуу. Модель кыска баштапкы видеону алып, аны сценарийге ылайык улантат. Бул жердеги максат — баштапкы видеодогу стиль, каарман, сахна жана агымды бузбастан уланды жаратуу.
LongAV-Compass жалпы 284 сыноо үлгүсүн камтыйт:
- 128 тексттен үндүү видео жаратуу үлгүсү
- 115 сүрөттөн үндүү видео жаратуу үлгүсү
- 41 видеодон уланды жаратуу үлгүсү
Бул үлгүлөр кокустук гана тандалган эмес. Изилдөөчүлөр тесттерди ар кандай колдонуу сценарийлерине жана кыйынчылык деңгээлдерине ылайык уюштурушат.
Колдонуу сценарийлери төмөнкүлөр:
- Vlog
- Контент жаратуучу видеолору
- Performance жарнамалары
- Бренд жарнамалары
Кыйынчылык деңгээлдери болсо L1ден L4кө чейин көтөрүлөт. Жөнөкөй сахналардан көп окуялуу, көп актёрлуу, себеп-натыйжа агымын талап кылган татаалыраак баяндарга карай өнүгөт.
Формулалар эмнени түшүндүрөт?
Бул макалада окурманды кыйынчылыкка салган жыш математикалык формулалар алдыңкы планга чыкпайт. Изилдөөнүн негизги күчү өлчөө системасынын кантип курулганында.
Изилдөөчүлөр бир гана «жалпы упай» берүүнүн ордуна, узун видео жаратууну көптөгөн бөлүктөргө бөлүшөт. Анткени бир модель визуалдык жактан жакшы болушу мүмкүн, бирок үн-видео шайкештиги начар болушу мүмкүн. Башка модель продукттун сүрөтүн сакташы мүмкүн, бирок окуяны аягына чыгара албашы мүмкүн.
Өлчөнгөн негизги өлчөмдөр төмөнкүлөр:
Event Fulfillment – Окуяны аткаруу
Модель сценарийде суралган окуяларды чыныгы эле жарата алабы? Мисалы, «продукт жалбыракка чачылууда» делинсе, видеодо чыныгы эле бул окуя көрүнөбү?
Visual Quality – Визуалдык сапат
Кыймылдар табигыйбы? Объекттер бузулабы? Сүрөттө жасалмалуулук, үзүлүү, форма бузулуусу же сапат жоготуусу барбы?
Long-form Continuity – Узак баян үзгүлтүксүздүгү
Видео башынан аягына чейин ырааттуубу? Каарман, продукт, сахна жана окуя агымы сакталабы?
Transition Stability – Өтүү туруктуулугу
Сахналардын ортосунда кара кадр, титирөө, күтүүсүз үзүлүү, тоңуу же логикасыз секирүү барбы?
Holistic Presentation – Жалпы презентация сапаты
Видео аякталган иштей көрүнөбү? Көрүүгө ылайыктуу, тартиптүү жана максатына шайкешпи?
Text-Video Alignment – Текст-видео шайкештиги
Видео берилген сүрөттөмө жана сценарий менен канчалык шайкеш?
Audio-Video Synchronization – Үн-видео синхрондоштуруу
Сүйлөө, эффект, музыка же чөйрө үнү сүрөттөгү окуялар менен убакыт жагынан шайкешпи?
Audio Quality – Үн сапаты
Үн реалисттикпи, сахнага ылайыктуубу, ыңгайсыздык жаратуучу бузулуулар барбы?
Long-Audio Coherence – Узак үн ырааттуулугу
Үн бир мүнөт бою үзүлбөстөн, маанисиз кайталанбастан, күтүүсүз үн деңгээли өзгөрбөстөн уланабы?
Бул өлчөө системасы бизге төмөнкүнү айтат: узун видео жаратууда ийгилик жалаң «сүрөт коозбу?» суроосу менен өлчөнбөйт. Үн, окуя ырааттуулугу, баян, визуалдык ырааттуулук жана сахна өтүүлөрү чогуу бааланышы керек.
График / таблица / схема болсо, негизги билдирүү эмне?
Макаладагы сүрөттөр жана таблицалар LongAV-Compass’тын кадимки модель иреттөө таблицасынан көбүрөөк нерсени максат кылганын көрсөтөт.
Макаладагы жалпы система схемасы:
2-беттеги чоң схема LongAV-Compass’тын видеону бир бөлүк катары эмес, ар кандай майда-чүйдө деңгээлдеринде бааларын көрсөтөт. Толук видео, окуя негизиндеги клиптер, сахна өтүүлөрү жана үлгү кадрлар өзүнчө изилденет. Негизги билдирүү мындай: узун видео жаратууда каталар кээде бир кадрда эмес, окуялар ортосундагы өтүүдө же видеонун жалпы агымында пайда болот.
Benchmark салыштыруу таблицасы:
Макаладагы салыштыруу таблицасы мурунку benchmarkтардын көбү кыска видео же бир тапшырма түрүнө басым жасаганын көрсөтөт. LongAV-Compass болсо тексттен, сүрөттөн жана видеодон үндүү-видео жаратууну бир чатыр астында баалоого аракет кылат. Ошондой эле орточо видео узактыгы бир мүнөттөн ашкан өндүрүштөргө басым жасайт.
Тапшырма камтуу таблицасы:
LongAV-Compass’тын 284 үлгүсү; 879 окуя жана 2.115 тартууну камтыган T2AV бөлүмү, 807 окуя жана 1.989 тартууну камтыган I2AV бөлүмү, 235 окуя жана 731 тартууну камтыган V2AV бөлүмү менен түзүлгөн. Бул тесттердин жалаң «бир буйрук, бир кыска видео» логикасында эместигин; окуя чынжырлары аркылуу курулганын көрсөтөт.
Сценарий жана кыйынчылык бөлүштүрүү графиги:
Макаладагы тегерек бөлүштүрүү сүрөтү тесттердин влог, контент жаратуучу видеолору, performance жарнамалары жана бренд жарнамалары сыяктуу ар кандай тармактарга жайылганын көрсөтөт. Бул маанилүү, анткени бир модель кызыктуу влог стилинде жакшы иштесе да, продукт тааныштыруу же жарнама сценарийинде кыйналышы мүмкүн.
Маалымат түзүү схемасы:
Макаладагы маалымат куруу процессинин схемасы сыноо үлгүлөрүнүн чыныгы видеолордон да, сценарий шаблондорунан да жаратылганын түшүндүрөт. Андан кийин бул үлгүлөр адам текшерүүсүнөн жана жасалма интеллект колдогон сапат баалоосунан өткөрүлөт. Негизги билдирүү мындай: Benchmark жалаң кокустук буйруктардан турбайт; окуя түзүмү, реалдуулук жана баалоо баалуулугу көзөмөлдөнөт.
Модель натыйжа таблицалары:
T2AV, I2AV жана V2AV таблицалары Seedance 2.0, Kling 3.0, Veo 3.1 жана ар кандай ачык булактуу моделдердин ар кандай көрсөткүчтөрдөгү натыйжалуулугун көрсөтөт. Бул жерде бир модель бардык тармакта абсолюттук үстөмдүк кылат деп айтуу кыйын. Мисалы, айрым моделдер тексттеги окуяларды жакшыраак аткарат, айрымдары үн сапаты же сахна өтүүлөрүндө күчтүүрөөк көрүнүшү мүмкүн.
Адам шайкештиги графиги:
Макаладагы адам баалоосу менен автоматтык упайлардын салыштырылган графиги LongAV-Compass упайларынын адам артыкчылыктарына жогорку деңгээлде жакын экенин көрсөтөт. Бул benchmarkтын жалаң техникалык өлчөөлөрдөн турбасын; адам кабыл алуусу менен да белгилүү өлчөмдө шайкеш жыйынтык берерин ойлоого түрткү берет.
Тажрыйбалар кантип жүргүзүлгөн?
Изилдөөчүлөр 11 башка видео жаратуу системасын сынашат. Алар үч топко бөлүнөт:
- Жабык / коммерциялык моделдер
- Ачык булактуу моделдер
- Агент негизиндеги ыкмалар
Коммерциялык моделдердин арасында Seedance 2.0, Kling 3.0 жана Veo 3.1 бар. Ачык булак тарапта LTX 2.3, LongCat, Wan2.2-I2V-A14B, HunyuanVideo 1.5-I2V, Helios, Open-Sora жана davinci-magihuman сыяктуу моделдер бааланат. Ошондой эле VideoDirectorGPT агент негизиндеги мисал катары кошулат.
Тесттерде максаттуу видео узактыгы эң аз 60 секунда деп аныкталат жана көпчүлүк чыгарылыштар 60-120 секунда аралыгында бааланат.
Моделдер колдогон кириш түрүнө жараша сыналат. Мисалы, айрым моделдер үн жарата албаса, бул моделдер видео метрикалары менен бааланат, бирок үн метрикаларында «ылайыктуу эмес» деп каралат.
Баалоо процессинде бир гана упай колдонулбайт. Ар бир видео окуя негизинде, өтүү негизинде, толук видео деңгээлинде жана үн-видео шайкештиги жагынан өзүнчө изилденет. Ошентип, модель кайда ийгиликтүү, кайда начар экени ачыгыраак көрүнөт.
Натыйжалар эмнени көрсөтөт?
Натыйжалар азыркы узун үндүү-видео жаратуу моделдеринин бир упай менен түшүндүрүлбөс даражада ар кандай күчтүү жана начар жактарга ээ экенин көрсөтөт.
Тексттен үндүү видео жаратуу тапшырмасында Kling 3.0 окуяларды аткаруу жана узак форма үзгүлтүксүздүгү жагынан күчтүү көрүнөт. Seedance 2.0 болсо визуалдык сапат, жалпы презентация жана үн көрсөткүчтөрүндө бөлүнүп чыгат.
Сүрөттөн үндүү видео жаратуу тапшырмасында Seedance 2.0 жалпысынан күчтүү натыйжалуулук көрсөтөт. Kling 3.0 референс сүрөттүн биринчи кадрда сакталышы жагынан жакшы жыйынтык берет. Бирок макаланын маанилүү табылгаларынын бири мындай: бир модель референс сүрөттөгү адамды же объектти сүрөт катары сактаса да, узун видеодо окуя агымын жана баян үзгүлтүксүздүгүн сактоодо кыйналышы мүмкүн.
Видеодон уланды жаратуу тапшырмасында Seedance 2.0 ачык бөлүнүп чыгат. Өзгөчө баштапкы видеого ылайыкташуу, окуя улантуучулугу, визуалдык сапат жана үн сапаты жагынан күчтүү жыйынтыктар берет. Veo 3.1 айрым окуяларды маанилүү түрдө уланта алса да, референс видео чегинен кийин үзгүлтүксүздүк жана өтүү туруктуулугу жагынан начарыраак жыйынтыктар көрсөтүшү мүмкүн.
Ачык булактуу моделдердин айрым көрсөткүчтөрдө акылга сыярлык жыйынтык бергени байкалат; бирок узак баян, окуя ырааттуулугу, продукт көрсөтүү, визуалдык бүтүндүк жана үн-видео шайкештиги сыяктуу тармактарда коммерциялык моделдер менен ортосунда дагы деле ачык айырма бар.
Макаланын эң көңүл бурарлык табылгаларынын бири — performance жарнамалары сценарийинин моделдер үчүн өзгөчө кыйын болушу. Анткени мындай видеолордо продукттун көрсөтүлүшү, функциясынын түшүндүрүлүшү, колдонуу процессинин логикалык өнүгүшү жана ынандыруучу агымдын түзүлүшү керек. Моделдер көп учурда продуктту көрсөтө алса да, анын функциясын туура ыраатта түшүндүрүүдө же себеп-натыйжа агымын сактоодо кыйналышы мүмкүн.
Бул эмне үчүн маанилүү?
Бул изилдөө жасалма интеллект менен видео жаратуунун жалаң «кооз сүрөт жаратуу» маселеси эместигин көрсөтөт.
Кыска клипте таасирдүү көрүнгөн модель узун видеодо төмөнкү көйгөйлөрдү башынан кечириши мүмкүн:
- Каармандын жүзү же кийими өзгөрүшү мүмкүн.
- Продукт бир сахнада башкача, башка сахнада башкача көрүнүшү мүмкүн.
- Үн сүрөттөгү окуя менен дал келбеши мүмкүн.
- Окуя башында убада кылган нерсени аягына чыгара албашы мүмкүн.
- Сахна өтүүлөрүндө үзүлүү же тоңуу пайда болушу мүмкүн.
- Жарнама видеосунда продукттун функциясы туура эмес же толук эмес түшүндүрүлүшү мүмкүн.
Ошондуктан узун видео жараткан жасалма интеллект системаларын сыноо үчүн майда-чүйдөлүүрөөк баалоо куралдары керек. LongAV-Compass бул муктаждыкка жооп берүүгө аракет кылат.
Verianla окурман үчүн негизги билдирүү мындай: жасалма интеллект моделинин «видео жарата алышы» анын узун жана ырааттуу үндүү-видео окуясын кура аларын билдирбейт. Узун видео жаратуудагы негизги сыноо — үзгүлтүксүздүк, ырааттуулук, үн шайкештиги жана окуя агымын сактай алуу.
Көңүл буруу керек болгон жактар
Бул макала күчтүү benchmark сунуштайт; бирок айрым чектөөлөр бар.
Биринчиден, изилдөө arXiv preprint катары жарыялангандай көрүнөт. Ошондуктан натыйжалардын peer-review басылма процесси жана көз карандысыз ырастоолор менен колдоолушу маанилүү.
Экинчиден, бааланып жаткан моделдердин версиялары убакыт өткөн сайын өзгөрүшү мүмкүн. Коммерциялык жасалма интеллект кызматтары тез-тез жаңыртылгандыктан, бүгүн алынган жыйынтыктар келечекте башкача болушу мүмкүн.
Үчүнчүдөн, автоматтык баалоо системалары адам баалоосуна жакындаса да, адам өкүмүн толук алмаштырбайт. Макалада адам шайкештиги изилдөөсү жүргүзүлгөн болсо да, бул пилот деңгээлинде.
Төртүнчүдөн, айрым метрикалар белгилүү визуалдык же көп модалдуу өкүлчүлүк моделдерине таянат. Мисалы, CLIP, DINO-v2, ArcFace жана ImageBind сыяктуу куралдар пайдалуу сигналдар берсе да, видеонун эстетикалык, баян жана коммерциялык ийгилигин толук өлчөй албайт.
Бешинчиден, модель иреттөөлөрү колдонулган сыноо сценарийлерине көз каранды. Влог, жарнама, продукт тааныштыруу же окуя видеосу сыяктуу ар кандай контент түрлөрү моделдерди ар башкача кыйындатышы мүмкүн.
Жыйынтык
LongAV-Compass жасалма интеллект менен узун үндүү-видео жаратууну баалоо үчүн комплекстүү сыноо системасын сунуштайт. Изилдөө тексттен, сүрөттөн жана видеодон узун үндүү-видео жаратууну бир чатыр астында караганы менен бөлүнүп чыгат.
Изилдөөнүн негизги жыйынтыгы мындай: азыркы видео жаратуу моделдери кыска клиптерде таасирдүү көрүнгөнү менен, бир мүнөттөн ашкан контентте каарман ырааттуулугу, окуя ырааттуулугу, сахна өтүүлөрү, үн-видео синхрондоштуруу жана баян бүтүндүгү дагы эле олуттуу сыноо.
Бул benchmark жалаң моделдерди иреттөө үчүн эмес, моделдер кайда ийгиликсиз болуп жатканын диагноздоо үчүн иштелип чыккан. Бул келечекте ишенимдүүрөөк, ырааттуураак жана узунураак жасалма интеллект видеолорун жаратууну каалаган изилдөөчүлөр үчүн маанилүү кадам болушу мүмкүн.
Verianla көз карашынан бул макаланын негизги билдирүүсү ачык: жасалма интеллект видео жаратуудагы негизги өнүгүү жалаң кооз кадрларды жаратуу эмес; узак убакыт бою маанини, үндү, каарманды жана окуяны сактай алуу.
Булак жана ыкма эскертмеси
Бул контент Tengfei Liu, Yang Shi, Xuanyu Zhu жана кесиптештери даярдаган “LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV” аттуу академиялык эмгектен пайдаланылып, Verianla редакциялык форматында өз алдынча даярдалган.
Изилдөө arXiv’де 25-май 2026-жылкы preprint катары көрүнөт. Бул жазуу сөзмө-сөз котормо эмес; макаладагы ыкма, таблицалар, графиктер, тажрыйбалар жана натыйжалар жөнөкөйлөштүрүлүп, кыргыз окурман үчүн кайра баяндалган. Контент маалымат жана билим берүү максатын көздөйт. Жасалма интеллект моделин тандоо, коммерциялык видео жаратуу же техникалык система баалоо үчүн жалгыз чечим колдонмосу катары колдонулбоосу керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген