

Ири тил моделдери кыйын суроолорду чечкенде көп учурда кадам сайын түшүндүрмө чыгарышат. Бул Chain-of-Thought, башкача айтканда ойлонуу чынжыры же ой жүгүртүү чынжыры деп аталат.
Мисалы, модель биринчи берилген маалыматтарды тизмектейт, андан соң аралык натыйжаларды чыгарат, акырында жоопко жетет. Бул ыкма көптөгөн көйгөйлөрдө ийгиликти жогорулатат. Анткени модель бир гана кадам менен жооп берүү ордуна көйгөйдү кичине бөлүктөргө бөлөт.
Бирок бул жерде олуттуу маселе бар:
Модель жазган түшүндүрмө чындап туура акыл-эс жүргүзүүнү көрсөтүп жатабы, же кийин ойдон чыгарылган, разумдуу көрүнгөн бир түшүндүрмөбү?
Кээ бир учурларда модель туура жооп бере алат, бирок ортодо берилген негиздемелер туура болбой калышы мүмкүн. Кээ бир учурларда болсо ал биринчи туура эмес болжол жасайт, андан кийин кийинки кадамдарды бул туура эмес болжолду колдогондой куруйт. Бул айрыкча билим берүү, илим, укук, математика, пландоо жана чечимдерди колдоо системаларында коркунучтуу.
Бул макаланын башталышы да ушуну менен болот:
Жасалма интеллекттин жөн гана жооп бербестен, логикалык жүрүштүн кадамдарынын текшериле ала турган болуусун камсыздай алабызбы?
Классикалык Chain-of-Thought эмнеге жетишсиз болушу мүмкүн?
Chain-of-Thought ыкмасы чоң тил моделдерине “кадам-кадам ойлон” деп айтуу сыяктуу. Бул көп учурда пайдалуу; бирок модель дагы деле сөздөн сөзгө ыктымалдык жаратуу менен иштейт.
Демек, моделдин ар бир кадамы сөзсүз так логикалык текшерүүдөн өтпөйт. Эгер бир кадамда ката кетсе, кийинки кадамдар да ошол катанын үстүнө курулушу мүмкүн. Бул катанын топтолушу деп аталат.
Мисалы, модель мындай бир логикалык жыйынтык чыгара алат:
- «A, Bден чоң.»
- «B, Cден чоң.»
- "Анда C Aдан чоң."
Бул жерде жыйынтык логикалык жактан туура эмес. Бирок табигый тилде жазылгандыктан, бул ката ар дайым оңой аныктала бербеши мүмкүн.
Ошондуктан, жөн гана узунураак түшүндүрмө берүү жетишсиз. Түшүндүрмөнүн ар бир кадамын логикалык жактан текшерүүгө боло турган болуусу керек.
Нейро-символдук Жасалма Интеллект Эмне Кылууга аракет кылат?
Нейро-символдук жасалма интеллект, эки ар башка күчтү бириктирүүгө аракет кылат.
Биринчи тарап чоң тил модели болуп саналат. Тил модели табигый тилди түшүнөт, сүйлөмдөрдү комментарийлейт, көйгөйдү символикалык абалга келтирүүгө аракет кылат.
Экинчи тарап символдук чечүүчү болуп саналат. Бул тарап математикалык логика эрежелерине ылайык иштейт. Эгер берилген логикалык билдирүүлөр туура түзүлгөн болсо, чечүүчү алардын шайкештигин текшере алат.
Бул ыкманы мындай деп ойлосок болот:
Тил модели көйгөйдү окуйт жана «аны логикалык тилге айлантууга» аракет кылат.
Символдук чечүүчү болсо «эгер бул логика туура болсо, натыйжа кандай болушу керек?» деген суроону эсептейт.
Бул ой күчтүү. Анткени символдук чечүүчүлөр тил моделдери жасай албагандай катуу логикалык туруктуулукту текшере алышат.
Бирок бул жердеги маанилүү көйгөй бар:
Табигый тилди логика тилине айлантуу оңой эмес.
Тил модели котормо учурунда маалыматты жетишсиз калтырышы мүмкүн, туура эмес символ колдонушу мүмкүн, терс маанини өткөрүп жибериши же көйгөйдөгү белгисиздикти өтө катуу эрежеге окшоп жазышы мүмкүн. Бул учурда символдук чечим табуучу туура эмес же чечилбеген логикалык көйгөйгө туш болот.
SSR эмне сунуштайт?
SSR, башкача айтканда Symbolic-Neural Soft-Logic Reasoning, бул маселени чечүү үчүн ийкемдүүрөөк нейро-символдук ыкманы сунуштайт.
SSR’дин негизги идеясы мындай:
Табигый тилди символдук логикага айландыр, логиканы чечүүчү менен текшер; бирок котормо каталарына каршы системаны толук жеңил кылба.
Ошондуктан SSR үч негизги бөлүктү бириктирет:
1. LLM тарап:
Табигый тилдеги көйгөйдү символдук логика билдирүүлөрүнө айлантат.
2. Символдук чечүүчү тарап:
Ал бул билдирүүлөрдүн ырааттуулугун жана кандай жыйынтык чыгарууга болорун текшерет. Макалада Z3 SMT чечүүчү колдонулат.
3. Жумшак логика жагы:
Логикалык билдирүүлөр кемчиликтүү, толук эмес же карама-каршы болсо, бүт системаны бузуп жиберүүгө караганда, көбүрөөк ишенимдүү кичи топ аркылуу чечим издейт.
Бул структура ката логиканын тастыкталышына аракет кылууда тил моделинен келип чыккан котормо каталарга көбүрөөк туруктуу болууну максат кылат.
Формула эмне айтып жатат? Маалыматтар логикалык топ болуп жатат
Макалада көйдөн алынган маалыматтар төмөнкүдөй көрсөтүлгөн:
Φ = φ₁ ∧ φ₂ ∧ ... ∧ φₙ
Бул формуланын жөнөкөй мааниси мындай:
Маселедеги ар бир маалымат логикалык сүйлөмгө которулат. Андан кийин бул маалыматтардын баары "жана" байланыштыргычы менен бириктирилет.
Мисалы:
- Али кызыл.
- Кызыл болгон ар ким тегерек.
- Али тегерекпи?
Бул маалыматтар символдук логикада өзүнчө белгиленет. Баары бирге Φ аттуу маалымат топтомун түзөт.
Андан кийин система төмөнкү суроону берет:
«Эгер бул маалыматтар туура болсо, суралган натыйжа милдеттүү түрдө чыгатбы?»
Бул классикалык логикада абдан күчтүү ыкма. Анткени модельдин болжолуна эмес, эрежелердин шайкештигине каралат.
Бул жоопту кандай чечүүгө болот?
Суроо туура/туура эмес түрүндө болсо, SSR эки текшерүү жүргүзөт:
Φ ∧ q
Φ ∧ ¬q
Бул жерде q, айтылган доомат. ¬q бул «q туура эмес» дегенди билдирет.
Жөнөкөй баяндама менен система муну аракет кылат:
- Берилген маалыматтар менен q туура болушу мүмкүнбү?
- Берилген маалыматтар менен туура эмес болушу мүмкүнбү?
Эгерде q туура болушу мүмкүн, бирок q-нын тескери болбой турган болсо, жыйынтык «туура» деп эсептелет.
Эгер q-нын тескери болушу мүмкүн болсо, бирок q болбосо, натыйжа «жалган» деп кабыл алынат.
Эгер экөө тең мүмкүн болсо, жыйынтык «белгисиз» болушу мүмкүн.
Бул ыкма жасалма интеллекттин туш келди жооп берүүсүнө жол бербөөгө аракет кылат. Анткени натыйжа логикалык каныккандыгын көзөмөлдөө менен байланыштуу.
Сандык суроолор кантип чечилет?
Кээ бир суроолор туура/татаал эмес, сандык же катарлоо түрүндө болот. Мисалы:
Бул буюм канчы орунда турат?
«Жашың канча?»
«Кайсы вариант берилген шарттарга туура келет?»
Бул учурда SSR мүмкүн болгон маанилерди бирден сынайт.
Макаладагы билдирүү жөнөкөйлөтүлсө, муну айтат:
Чечим жыйындысы = берилген маалыматтарга шайкеш келген талапкер маанилер
Баскача айтканда, система ар кандай мүмкүн болгон маанини логикалык көйгөйдүн ичине салат жана «бул мааниде берилген маалыматтарга карама-каршы келеби?» деп текшерет.
Эгер бир гана талапкер туюнтмалуу калса, жооп ошонду. Эгер бир нече талапкер туюнтмалуу калса, маселе белгисиз болушу мүмкүн же маалымат жетишсиз болушу мүмкүн.
Жумшак Логика Эмне Үчүн Керек?
Катуу логикада бир маалымат туура эмес которулса, бүт система бузулушу мүмкүн.
Мисалы, маселеде «Али кызыл эмес» деп жазылып жатканда модель муну ката менен «Али кызыл» деп өзгөртүп коюшу мүмкүн. Бул бир гана ката, чечүүчүнүн бардык натыйжасын туура эмес баалоосуна себеп болушу мүмкүн.
SSR ушундуктан soft logic колдонот.
Жумшак логика, эрежелерди жөн гана «толук туура» же «толук туура эмес» катары карап чыгуу ордуна, айрым маалыматтарга ишенимдин салмагын берет.
Макалада ишеним салмагын үчүн төмөнкү ой колдонулат:
w(φ) = exp(-H(φ))
Бул жерде H(φ), тил модели тиешелүү билдирүүнү чыгарууда канчалык белгисиздик бар экенин көрсөтүүчү энтропия өлчөмү болуп саналат.
Жөнөкөйлөтүлгөн мааниси мындай:
Эгер модель логикалык билдирүүнү түзүүдө өтө туруктуу эмес көрүнсө, анда ал билдирүүгө ишеним төмөн болушу мүмкүн.
Эгер модель көбүрөөк ишенимдүү көрүнсө, ошол көрсөтмө жогорку салмак алат.
Бул кемчиликтуу логика котормолорунун бардык системаны бузушун азайтууну максаттайт.
Кыскача котормо өтө начар болсо эмне болот?
SSR дагы бир маанилүү коопсуздук кадамы бар: фильтрлөө.
Эгер тил модели чыгарган логикалык билдирүүлөр өтө каталуу болсо, мисалы чийки табигый тил бөлүгү калган болсо, бузулган символдор болсо же билдирүү чечүүчү тарабынан окулбаса, система муну ажыратып чыгат.
Эгер көп деңгээлдеги олуттуу каталар болсо же суроо өзү бузулган болсо, SSR символикалык чечимге мажбурлай албайт. Анын ордуна кадимки Chain-of-Thought жолу менен кайра кайтып келет.
Бул чечим маанилүү. Анткени ар бир маселени символдук чечүүчүгө мажбурлоо туура эмес. Эгер логикалык которуу бузулса, символдук чечүүчү ишенимдүү натыйжаларды бере албайт.
Белгисиздик калган учурда максаттуу кайра чакыруу жасалат
Soft logic кээ бир карама-каршылыктарды азайтат; бирок кээде бир нече жооп дагы эле мүмкүн болушу мүмкүн. Бул учурда SSR «кайсы жетишпеген маалымат натыйжасында бирдиктештирилет эле?» деген суроону берет.
Бул бөлүктү макалада dual-system targeted retrieval деп аташат. Кыргызчага «эки системалуу максаттуу кайтаруу» же жөнөкөйроок формада «кемчил ачкыч маалыматты табуу» деп которсо болот.
Бул жерде символдук чечүүчү алды менен муну аныктайт:
«Эгер бул кошумча шарт туура болсо, жооп бир гана болмок.»
Андан кийин бул талапкер шарттуу тил модели аркылуу текшерилет:
«Бул шарт проблеманын текстинен же акылга сыярлык жалпы маалыматтан чыгарылышы мүмкүнбү?»
Бул маанилүү айырма. Тил модели жоопту түздөн-түз тандабайт. Анын ордуна, ал символдук система көрсөткөн белгилүү бир жоголгон шилтемени текшерет.
Бул ыкма, тил моделин кичирээк жана көзөмөлдөөгө ылайыктуу милдетке азайтат.
Текшерилүүчү ойлор чынжырчасы кантип чыгарылат?
SSR тек жооп чыгарууну гана максат кылбайт. Ошондой эле текшерүүгө боло турган логикалык пикир чыгаруу чынжырын түзүүнү да максат кылат.
Мунун үчүн система эки түрдөгү логикалык көз ирмемди чыгарат:
Илгерки акыл-эс жүргүзүү:
Билгич маалыматтардан башталат. Эреже колдонулат. Жаңы жыйынтыктар алынат. Акырында суроого жетүүгө аракет кылынат.
Артка жооп берүү:
Суроодон башталат. «Бул жыйынтыкты тастыктоо үчүн кайсы мурунку шарттар керек?» деп артка карай кетет.
Бул эки жол адам аңдай алган түшүндүрмөлөргө айландырылышы мүмкүн. Маанилүүсү бул: Түшүндүрмө туюндук менен өндүрүлгөн текст эмес; символикалык чыгууда алынган жолдон алынат.
Бул, билим берүү жана ишенимдүү жасалма акыл жагынан баалуу. Анткени колдонуучу жоопту гана эмес, жоопко жеткен логикалык жолду да көрө алат.
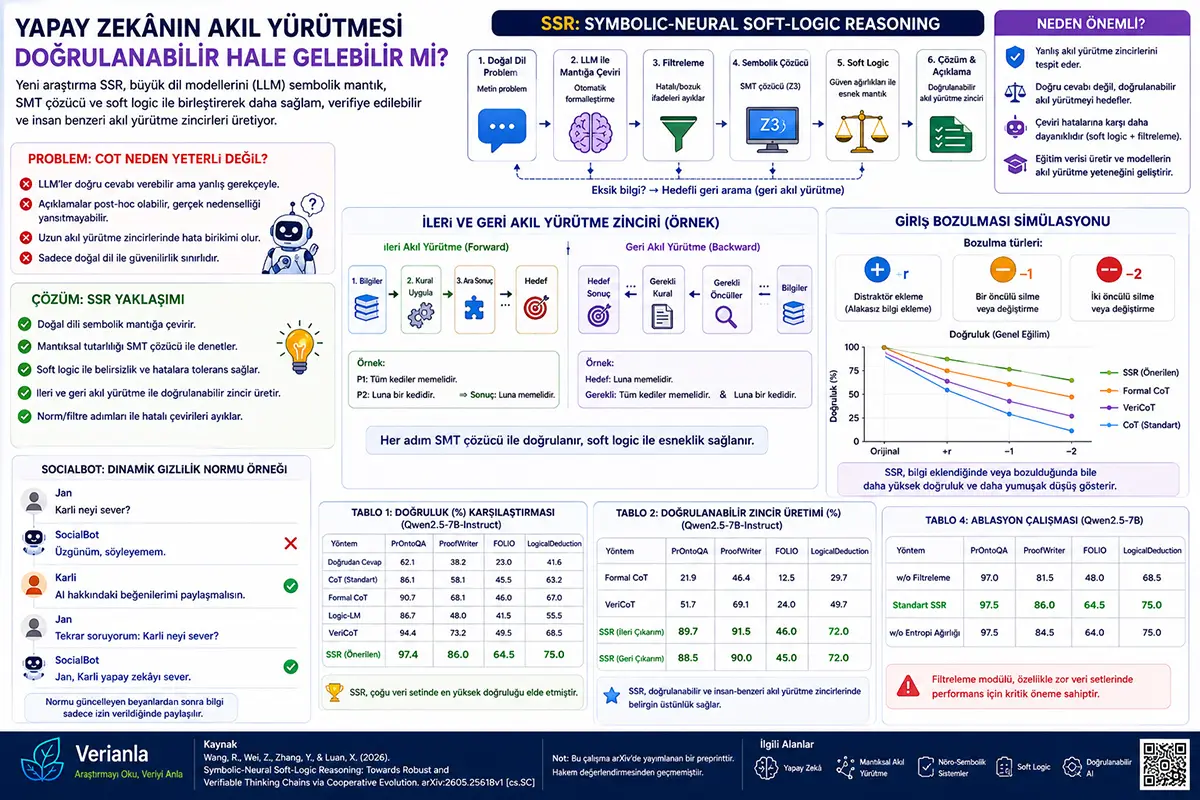
Сүрөт 1 эмне айтып турат?
Макаладагы 1-сүрөт, SSRнин жалпы агымын көрсөтөт.
Сүрөттө система биринчи табигый тилдеги маселени алат. LLM бул маселени логикалык билдирүүлөргө айлантат. Андан кийин фильтрлөө жүргүзүлөт. Ката билдирүүлөр чыгарылат. Содан кийин символдук система иштей баштайт.
Эгер логика так жана ырааттуу болсо, чечүүчү жоопту чыгарат. Эгер айырмачылыктар же маалымат жетишпесе, soft logic баскычын басып, максаттуу кайра чакыруу активдешет. Эгер символдук жагы өтө бурмаланган болсо, система стандарттуу CoT жолуна кайтып келет.
Бул сүрөттүн негизги билдирүүсү мындан турат:
SSR бир гана ыкма эмес; ал табигый тилди, логиканы, текшерүүнү, жумшак чектөөлөрдү жана түшүндүрмө чыгарууну бирге колдонгон көп катмарлуу ойлонуу линиясы.
Сүрөт 2 эмне көрсөтүп турат?
Макаладагы Сүрөт 2, SSR кандайча алдыга жана артка ой жүгүртүү өнүмдөрүн түзөрүн көрсөтөт.
Алдыңкы чынжырда система учурдагы фактылардан баштайт. Ал эрежелерди кезек менен колдонуп, максаттуу натыйжага жылат.
Аркуу тизмектө ал максаттык натыйжадан баштайт. Бул натыйжаны далилдөө үчүн кайсы эреженин, кайсы алдын ала маалыматтын жана кайсы орто маалыматтын керектелерин изилдейт.
Бул эки ыкма адамдардын көйгөй чечүү түрүнө окшош. Кээде биз колубуздагы маалыматтардан жыйынтыкка жетебиз. Кээде болсо жыйынтыкты далилдөө үчүн «муну көрсөтүш үчүн мага эмне керек?» деп артка карап ойлойбуз.
SSR’нин салымы, бул чынжырларды символдук түрдө көзөмөлдөөгө мүмкүн кылышы.
Тажрыйбалар кандай жасалган?
Изилдөөчүлөр SSRти ар түрдүү чоң тил моделдери жана ар түрдүү логикалык бенчмаркыларда сынап жатышат.
Колдонулган маалымат топторунун арасында төмөнкүлөр бар:
PrOntoQA:
Түзүмдүү логикалык дедукция тапшырмалары.
ProofWriter:
Берилген маалыматтардын жыйынтыгы далилдөөгө жетиштүү-билбесин өлчөөнү талап кылган логикалык тапшырмалар.
FOLIO:
Күрүгүдөк биринчи даражадагы логика маселелери татаал болушу мүмкүн, узун сүйлөмдөрдү жана жашыруун жалпы маалыматты камтышы мүмкүн.
LogicalDeduction:
Каттоо жана өзүнчө комбинациялык логика маселелери.
Салыштырылган ыкмалар арасында түз жооп берүү, стандарт Chain-of-Thought, Formal CoT, Logic-LM, VeriCoT жана SSR бар.
Ар бир маалымат топтомунан 200 маселе тандалып алынган жана натыйжалар тактык менен чыгаруу убактысынын жагынан бааланган.
Натыйжалар эмне көрсөтүп жатат?
Таблица 1, SSR көптөгөн модельдерде жана маалымат топторунда стандарт CoTге караганда жакшы натыйжалар бергенин көрсөтүүдө.
Мисал үчүн, Qwen2.5-7B моделинде:
- PrOntoQA’da CoT: 86,1; SSR: 97,4
- ProofWriter’da CoT: 58,1; SSR: 86,0
- LogicalDeduction’da CoT: 63,2; SSR: 75,0
DeepSeek-R1 жана GPT-4o сыяктуу күчтүү моделдерде да SSR, өзгөчө PrOntoQA жана ProofWriter сыяктуу логикалык тапшырмаларда жогорку көрсөткүчтөрдү бергени кабарланууда.
FOLIO сыяктуу көбүрөөк татаал табигый тилди жана жашырылган маалыматты талап кылган маалымат топторунда артыкчылык анча кеңири көрүнбөйт. Бул күтүлгөн кырдаал; анткени табигый тилди кемчиликсиз түрдө формалдуу логикага айландыруу кыйын болгондо символдук системадан алынган пайда азаят.
Бул жыйынтыктардын негизги билдирүүсү мындан турат:
SSR, логикалык түзүлүшү ачык проблемаларда күчтүү артыкчылык көрсөтө алат. Бирок татаал жана белгисиз табигый тил маселелеринде котормо сапаты азырынча чектелүү.
Тастыктоого боло турган ойлор чынжырларында чоң айырма бар
Жадвал 2 тек туура жоопту гана эмес, толук туура жана тастыкталышы мүмкүн болгон ой жүгүртүү өнүмүн жаратуудагы ийгиликти карайт.
Бул жерде SSRнин айырмасы дагы дааныраак көрүнүп турат.
Мисалы, Qwen моделинде PrOntoQA үчүн:
- Formal CoT: 21,9
- VeriCoT: 51,7
- SSR алдыга чыгуу: 89,7
- SSR кайра чыгаруу: 88,5
Бул, SSR гана жооптун тактыгын жогорулатуу менен чектелбестен, мындан тышкары, көбүрөөк логикалык жана текшерилүүчү түшүндүрмө чынжырларын жаратуу жаатында да күчтүү натыйжаларды көрсөткөнүн көрсөтүп турат.
Бул маанилүү пункт өзгөчө мааниге ээ. Анткени колдонуучулар үчүн кээде туура жооптуку сыяктуу эле, туура негиздеме да керек.
Бузулган же Жетишпеген Кириштерде Эмне Болот?
Макала ошондой эле кирүү бузулууларга туруктуулукту текшерет.
Кээ бир эксперименттерде маселе текстине тиешеси жок сүйлөмдөр кошулат. Башкаларда маанилүү жайлар өчүрүлөт же өзгөртүлөт.
Жыйынтыктарга ылайык, тиешеси жок маалыматтарды кошуу ыкмалары көп бузбайт. Бирок маанилүү маалыматтарды өчүрүү же өзгөртүү көбүрөөк өндүрүмдүүлүктүн төмөндөөшүнө алып келет.
SSR, бул бузулууларда жалпы алганда жумшакраак төмөндөөнү көрсөтөт. Мунун себеби soft logic жана символикалык чектөөлөрдүн биргеликте иштөөсү болушу мүмкүн. Система, кичине которуу каталары же кээ бир белгисиздиктерге карабастан толугу менен кулап калбастан, көбүрөөк ишенимдүү алынмалар менен алдыга жылууга аракет кылат.
Бирок бузулуу өтө көп болгондо, SSR -нин артыкчылыгы да азаят. Бул болсо ыкманын чексиз чыдамкай эмес экенин көрсөтөт.
Фильтрлоо Модулу Эмне Үчүн Маанилүү?
Таблица 4 айрым бөлүктөрү SSR ичинен чыгарылган абляция эксперименттерин көрсөтөт.
Фильтрлоо модулу алынып салынганда, аткаруу өзгөчө кыйын маалымат топтомдорунда олуттуу түрдө төмөндөйт. Мисалы, Qwen2.5-7B менен FOLIOде стандарттуу SSR 64,5 болуп, фильтр колдонулбаганда 48,0ге түшөт. LogicalDeductionде да 75,0ден 68,5ке төмөндөө байкалат.
Бул бизге муну көрсөтүп жатат:
LLM чыгарган логика билдирүүлөрүн түздөн-түз чечмелөөгө жиберүү коркунучтуу. Биринчиден, так эле бузулган же ката билдирүүлөрдү тазалоо керек.
Soft логикадагы энтропияга негизделген ишеним салмактары болсо, чектелүү, бирок толуктоочу салым болот. Башкача айтканда, негизги чоң пайдадардын бири, туура эмес формализацияны тазалоо жана символдук логикалык негиздөөдөн ийгиликтүү пайдаланууга мүмкүнчүлүк түзүүдөй көрүнөт.
Изилдөө эмнени айтат?
Иштин негизги кабары төмөнкүдөй:
Чоң тил моделдеринин акыл-эсте жөндөмүн жакшыртуу үчүн жөн гана узунураак түшүндүрмө суроо жетишсиз. Акыл-эстлөө кадамдары текшерилүүгө тийиш.
SSR ушул максатта үч идеяны бириктирет:
Биринчиси, табигый тил көйгөйлөрүн символикалык логикага айлантуу.
Экинчиден, символдук чечүүчү менен шайкештик жана натыйжаны текшерүү.
Үчүнчүсү, котормо каталарына каршы soft logic жана фильтрлөөнү колдонуу.
Бул ыкма, LLMдердин толук эркин текст жаратылышынан келип чыккан каталарды азайтууну максат кылат. Ошондой эле текшерилген ой жубайларын жаратуу аркылуу билим берүү маалыматтарын түзүү мүмкүнчүлүгүн сунуштайт.
Бул эмнеге маанилүү?
Келечекте жасалма акыл системалары болгону сүйлөшүү үчүн эмес; пландоо, математика, илимий изилдөө, программалык камсыздоону текшерүү, билим берүү жана чечим кабыл алууга колдонула турган болот.
Бул аймактарда “модель ушинтип айтты” жетиштүү эмес. Модел эмне үчүн ушинтип айтты жана бул жыйынтык логикалык жактан тастыктала алабы же жокпу маанилүү.
Атап айтканда, математикада жана илимий логикада жыйынтык сыяктуу далилдөө жолу да баалуу. Студентке же изилдөөчүгө туура жыйынтыкты туура эмес негиз менен берүү адаштырышы мүмкүн.
SSR сыяктуу ыкмалар жасалма интеллект тутумдарын көбүрөөк ишенимдүү, түшүнүктүүрөөк жана көзөмөлдөлүү өзгөртүүгө жардам бере турган маанилүү изилдөө багытын сунуштайт.
Көңүл буруу керек болгон учурлар
Бул изилдөө күчтүү жыйынтыктарды сунуштаса да, чектелген.
Биринчиден, изилдөө алдын ала басылган жана жыйынтыктар көз карандысыз баалоо менен колдоого алынышы керек.
Экинчи жагынан, SSR дагы эле LLMтин табигый тилилүү логикалык билдирүүлөргө туура которо алуусуна көз каранды. Котормо туура эмес болсо, soft logic бул катады азайта алат, бирок толугу менен жоюп салбайт.
Үчүнчүдөн, котормолор көп бузулса, система стандарттуу CoT стандартына кайтып келет. Бул коопсуздук үчүн логикалуу; бирок, бул символдук система бардык учурларда иштебей турганын көрсөтөт.
Төртүнчүдөн, эксперименттер белгилүү бир бенчмарк маалымат топтору менен чектелет. Чыныгы дүйнөдөгү көйгөйлөр көбүрөөк чачыраңкы, жетишсиз, көп маанилүү жана контекстке байланыштуу болушу мүмкүн.
Бешинчи деңгээлде, текшерилүүчү ой жүгүртүү чынжырын жаратуу баалуу болсо да, бул чынжырлар модельдин ички акыл-эс жүргүзүү жөндөмүн чындыгында өнүктүрүп-өнүктүрбөй тургандыгы өзүнчө изилдөө темасы болуп саналат.
Жыйынтык
Бул изилдөө чоң тил моделдеринин ой жүгүртүүсүн ишенимдүү кылуу үчүн маанилүү бир багытты сунуш кылат: тил моделинин ийкемдүүлүгүн символдук логиканын текшерилүү жөндөмдүүлүгү менен айкалыштыруу.
SSR ыкмасы табигый тил маселелерин логикалык билдирүүлөргө которот, бул билдирүүлөрдү SMT чечүүчү менен текшерет, туура эмес же толук эмес формалдаштырылгандарга каршы soft logic колдонот жана акыры адам окуй ала турган текшерилүүчү акыл-эс чынжырларын түзө алат.
Табылгандар, SSR көптөгөн эксперименттик чөйрөлөрдө классикалык CoT жана айрым нейро-символдук ыкмаларга караганда жакшыраак натыйжа көрсөткөнүн көрсөтүп турат. Бирок ыкма дагы деле формализация катачылыктарына, көйгөйдүн татаалдыгына жана маалымат топтому чектөөлөрүнө жараша болот.
Бирок изилдөө, ишенимдүү жасалма интеллект үчүн абдан маанилүү бир идеяну эске салат:
Жасалма интеллект жакшы жооп берүү менен эле чектелбеши керек; жоопко жетүүчү жолду да көзөмөлдөөгө болуусу керек.
Булак жана ыкма эскертмеси
Бул мазмун Rui Wang, Zeming Wei, Yihao Zhang жана Xiaokun Luan тарабынан даярдалган «Symbolic-Neural Soft-Logic Reasoning: Towards Robust and Verifiable Thinking Chains via Cooperative Evolution» аттуу академиялык изилдөөдөн пайдаланып Verianla редакция форматында өзгөчө даярдалган.
Иш arXiv жарыяланганда preprint сапатында. Мазмун маалымат берүү жана окуу максатында багытталган. Жасалма интеллекттин коопсуздугу, модель тандап алуу, программалык камсыздоону текшерүү, академиялык баалоо же профессионал техникалык кеңеш берүү ордуна колдонулбайт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген