

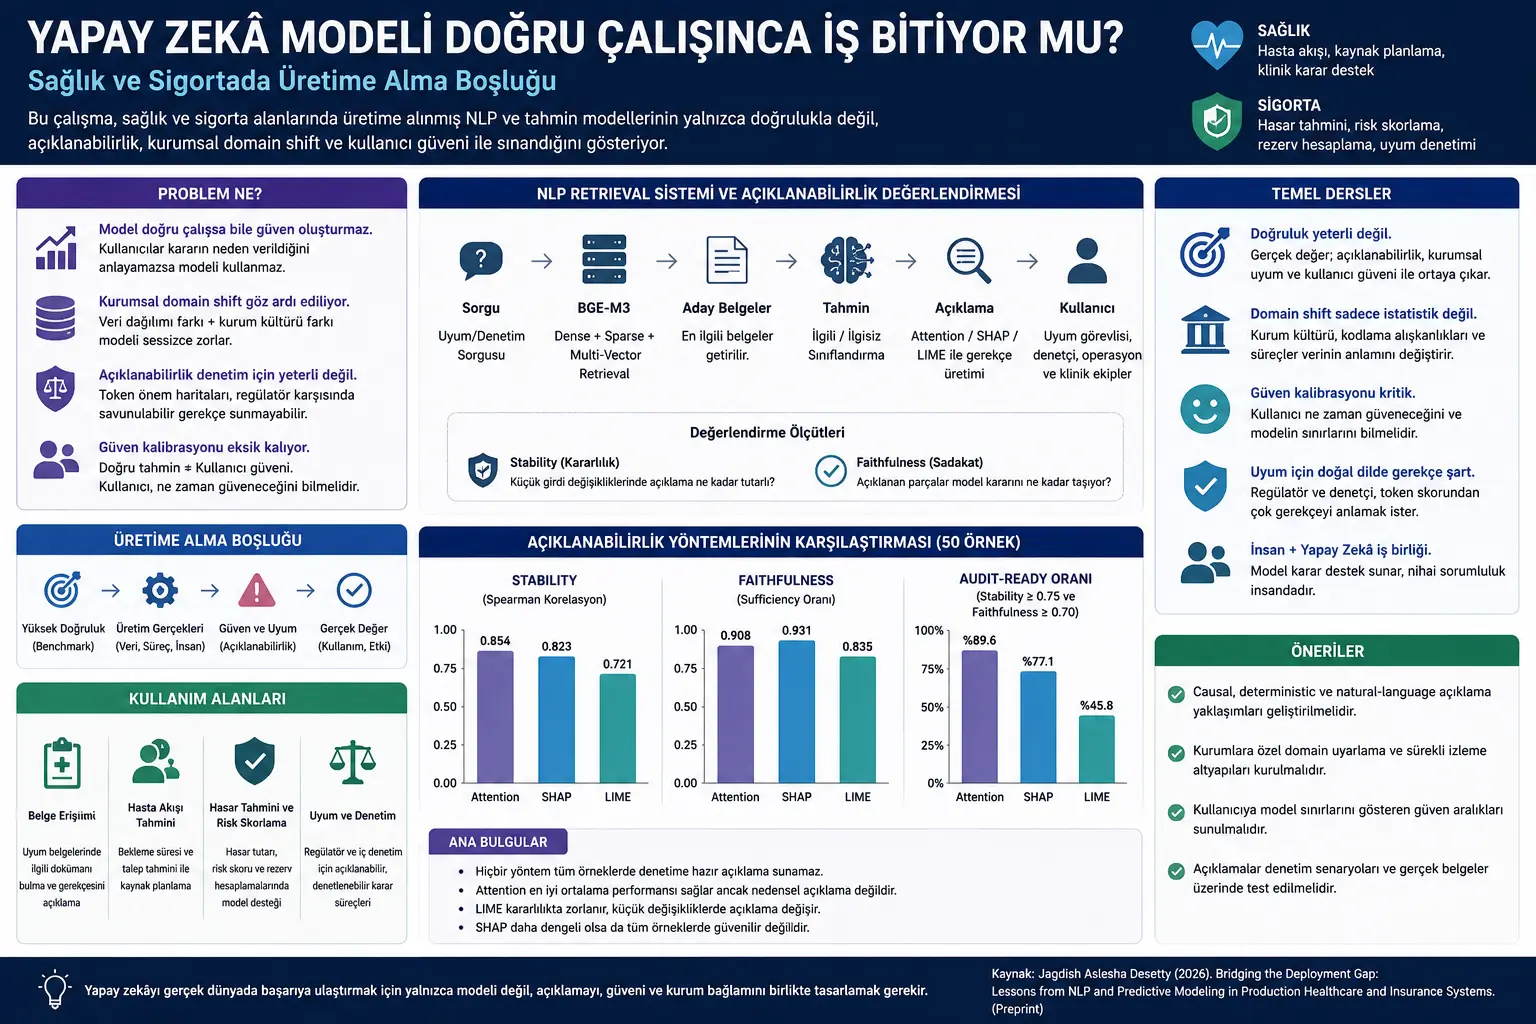
Машиналык үйрөнүү моделдери benchmark тесттеринде жогорку ийгилик көрсөтүшү мүмкүн. Бирок бир моделди оорукана, камсыздандыруу компаниясы же жөнгө салуу басымы бар корпоративдик системаларда иштетүү таптакыр башка көйгөй. Анткени реалдуу дүйнөдө маалымат чачыранды, колдонуучулар этият, ал эми чечимдердин укуктук жана операциялык кесепеттери бар.
Бул изилдөө ушул айырманы өндүрүштөгү эки тажрыйба аркылуу талдайт. Биринчи система чоң корпоративдик кардар үчүн иштелип чыккан шайкештикке сезимтал NLP негизиндеги документке жетүү системасы. Экинчи тажрыйба болсо саламаттык сактоо жана камсыздандыруу тармагында 15 корпоративдик кардарга жайылган божомолдоо моделдери. Бул системалар техникалык жактан ийгиликсиз болгон эмес; бирок түшүндүрмөлүүлүк, мекемелер ортосундагы маалымат айырмачылыгы жана колдонуучунун ишеними жагынан күтүлбөгөн тоскоолдуктарга туш болгон.
Изилдөөнүн негизги кабары ачык: жасалма интеллект өндүрүш чөйрөсүндө туура божомол кылуу менен гана чектелбеши керек. Ал ошол эле учурда чечимин түшүндүрө алышы, ар башка мекемелердин маалымат түзүү ыкмаларына ыңгайлаша алышы жана колдонуучулар кайсы учурда моделге ишене аларын түшүнө турган чечим чөйрөсүн сунушташы керек.
Көйгөй Эмне?
Жасалма интеллект адабиятында өндүрүшкө киргизүү көйгөйү көбүнчө маалымат бөлүштүрүлүшүнүн өзгөрүшү, инфраструктуранын жетишсиздиги, кичинекей окутуу топтому же моделдин өндүрүмдүүлүгүнүн төмөндөшү сыяктуу техникалык темалар менен түшүндүрүлөт. Булар маанилүү; бирок бул изилдөө башка бир көйгөйгө көңүл бурат: модель туура иштесе да адамдар аны колдонууга жетиштүү себеп таба албашы мүмкүн.
Саламаттык сактоо жана камсыздандыруу системаларында моделдин чыгышы жөн гана техникалык балл эмес. Бейтаптын күтүү убактысын божомолдоо ресурстарды пландаштырууга таасир этиши мүмкүн. Камсыздандыруу чыгымын божомолдоо резерв эсептөөлөрүндө колдонулушу мүмкүн. Документке жетүү системасы шайкештик аудитинде жөнгө салуучуга каршы корголууга тийиш болгон жыйынтыктарды чыгара алат. Ошондуктан «модель канча пайыз туура?» деген суроо өзү жетишсиз.
Шайкештик аудити контекстинде көйгөй андан да курч. Документке жетүү системасы белгилүү бир документти 0,87 ишеним баллы менен тиешелүү деп тапса, бул балл шайкештик кызматкери үчүн жетиштүү түшүндүрмө эмес. Шайкештик кызматкерине керек болгон нерсе мындай: бул документ кайсы жобо, кайсы түшүнүк же кайсы жөнгө салуучу негиз боюнча чыгарылды? Ошол эле суроо кичине өзгөртүлүп берилсе, ошол эле логика менен ошол эле жыйынтык түшүндүрүлөбү?
Изилдөөнүн борборундагы көйгөй ошондуктан «модель иштебей калдыбы?» эмес. Андан кыйыныраак суроо мындай: модель туура жыйынтык чыгарганда да, аны текшерүүгө жарактуу, корпоративдик контекстке ылайыкташкан жана адамдын чечим кабыл алуу процессине ишенимдүү түрдө киргизилген абалга келтире алабызбы?
Ыкма Эмнени Сунуштайт?
Изилдөө жаңы алгоритм сунуштагандан көрө, өндүрүштүк тажрыйбалардан чыккан үч негизги көйгөй чөйрөсүн системалуу түрдө документтештирет. Биринчи көйгөй — түшүндүрмөлүүлүк боштугу. Модель жыйынтык чыгара алат; бирок бул жыйынтыктын шайкештик, аудит же жөнгө салуу контекстинде корголуучу түшүндүрмөсүн түзө албашы мүмкүн.
Экинчи көйгөй — корпоративдик domain shift деп аталган көрүнүш. Domain shift — моделдин окутулган маалымат бөлүштүрүлүшү менен өндүрүштө жолуккан маалымат бөлүштүрүлүшүнүн айырмасы. Бирок изилдөө баса белгилеген айырма статистикалык гана эмес. Саламаттык сактоо жана камсыздандыруу мекемелери маалыматты ар башкача түзөт, коддойт, иштетет жана чечмелейт. Мисалы, ICD-10 диагноз коддорунун колдонулуу жыштыгы бейтаптардын популяциясын гана эмес, мекеменин документтештирүү маданиятын да чагылдырышы мүмкүн.
Үчүнчү көйгөй — ишенимди калибрлөө. Модель туура божомолдорду чыгара алат; бирок практиктер, клиницисттер, актуарийлер же операциялык топтор кайсы учурда бул божомолго ишенүү керектигин билбесе, модель колдонулбайт. Ишеним тактыктан автоматтык түрдө пайда болбойт. Колдонуучу моделдин кайсы чектерде иштегенин жана өзүнүн эксперттик чечими менен кантип бирге колдонуларын түшүнө алышы керек.
Изилдөөнүн эмпирикалык бөлүгү түшүндүрмөлүүлүк көйгөйүн өлчөө үчүн BGE-M3 негизиндеги NLP моделинде үч post-hoc түшүндүрмө ыкмасын салыштырат: Attention, LIME жана SHAP. Post-hoc түшүндүрмө — модель окутулгандан кийин анын чечимин түшүндүрүүгө аракет кылган ыкма. Эксперимент MultiNLI маалымат топтомунун government жана slate түрлөрүнөн алынган 50 үлгү менен жүргүзүлөт.
Түшүндүрмөлөр эки өлчөм боюнча бааланат: stability жана faithfulness. Stability кичине киргизүү өзгөрүүлөрүндө түшүндүрмө канчалык туруктуу каларын өлчөйт. Faithfulness болсо түшүндүрмөдө маанилүү деп көрсөтүлгөн tokenдар моделдин чечимин чындап алып жүрөбү, ошону өлчөйт. Изилдөө бул эки көрсөткүчтү бириктирип audit-ready, башкача айтканда аудитке даяр түшүндүрмөлөрдүн үлүшүн эсептейт.
Формулалар Эмнени Түшүндүрөт?
Изилдөөдө түшүндүрмө сапатын өлчөө үчүн эки негизги түшүнүк колдонулат: stability жана faithfulness. Аларды окурманга жөнөкөй тилде төмөнкүдөй түшүндүрүүгө болот.
Stability бирдей же абдан аз өзгөртүлгөн киргизүүлөрдө түшүндүрмө баллдары окшош бойдон калабы, ошону өлчөйт. Изилдөөдө бул окшоштук token маанилүүлүк рейтингдеринин ортосундагы Spearman корреляциясы менен бааланат.
Бул жерде \(E_i\) жана \(E_j\) бир эле үлгүнүн кичине өзгөртүлгөн ар башка версиялары үчүн чыгарылган token маанилүүлүк баллдарын; \(\rho_{\text{Spearman}}\) рейтингдердин окшоштугун билдирет. Эгер түшүндүрмө майда өзгөрүүлөрдө толугу менен өзгөрүп кетсе, аны аудит контекстинде ишенимдүү деп эсептөө кыйын.
Faithfulness түшүндүрмө моделдин чечимин чындап алып жүргөн маалыматты кармап жатабы, ошону өлчөйт. Изилдөөдө sufficiency ыкмасы колдонулат: эң маанилүү деп эсептелген алгачкы 5 token гана калтырылганда моделдин баштапкы чечим ишеними канчалык сакталат?
Бул жерде \(P_{\text{original}}(\hat{y})\) моделдин толук текст менен берген божомол ишенимин; \(P_{\text{top-5 tokens}}(\hat{y})\) болсо түшүндүрмө ыкмасы тандаган эң маанилүү tokenдар гана калганда моделдин ошол эле божомолго берген ишенимин көрсөтөт. Катыш жогору болсо, түшүндүрмө ыкмасы тандаган бөлүктөр моделдин чечимине чындап таасир эткен болушу мүмкүн.
Изилдөөнүн audit-ready көрсөткүчү эки чек бирге аткарылышына негизделет:
Башкача айтканда, түшүндүрмө аудитке даяр деп эсептелиши үчүн ал майда өзгөрүүлөргө каршы жетиштүү туруктуу болушу жана моделдин чечимин алып жүргөн маалыматты жетиштүү жакшы кармашы керек.
Изилдөөнүн негизги өндүрүш сабагын жөнөкөй түрдө төмөнкүдөй жыйынтыктоого болот:
Бул акыркы эки туюнтма изилдөөдө сөзмө-сөз теңдеме катары берилген эмес; макаланын негизги идеясын Verianla окурманы үчүн жөнөкөйлөштүрүп көрсөткөн редакциялык схемалар.
График, Таблица жана Схеманын Негизги Мааниси
Таблица менен сүрөттүн негизги кабары — азыркы түшүндүрмө ыкмалары өндүрүштүк шайкештик талаптарын толук канааттандырбайт. Attention ыкмасы эң жогорку audit-ready көрсөткүчүнө жетет: пайыз 89,6. Бул биринчи караганда күчтүү көрүнөт; бирок шайкештик аудити жагынан ар 10 үлгүнүн ичинен болжол менен 1 үлгүдө түшүндүрмө күтүлгөн чектен өтпөй жатканын билдирет.
LIME ыкмасы өзгөчө stability жагында кыйналат. Орточо stability мааниси 0,721 деп берилет жана 0,75 чектен төмөн калат. Бул майда сөз өзгөрүүлөрүндө token маанилүүлүк рейтингинин олуттуу өзгөрүшү мүмкүн экенин көрсөтөт. Аудит контекстинде бир эле чечимдин ар башка убакта ар башкача түшүндүрүлүшү олуттуу ишенимдүүлүк көйгөйү.
SHAP кыйла тең салмактуу көрүнөт. Faithfulness мааниси жогору жана stability орточосу LIMEга караганда жакшы. Бирок изилдөө баса белгилеген жагдай — орточо көрсөткүч жетишсиз. Айрым үлгүлөрдө түшүндүрмө аудит чегинен төмөн түшүп калса, өндүрүш чөйрөсүндө бул дагы деле тобокелдик жаратат.
Сүрөттө үч көз караш бирге берилет: түшүндүрмөнүн туруктуулугу, түшүндүрмөнүн моделдин чечимин алып жүрүү күчү жана эки критерийди бир убакта аткарган үлгүлөрдүн үлүшү. Бул үчтүк баалоо маанилүү; анткени «түшүндүрмө жакшы көрүнүп жатабы?» деген суроонун ордуна «туруктуу калабы, чечимди чындап алып жүрөбү жана аудитте корголобу?» деген суроолор бирге берилет.
Изилдөөнүн визуалдык жыйынтыктары техникалык түшүндүрмөлүүлүк менен аудитке даяр түшүндүрмөлүүлүктүн ортосунда айырма бар экенин көрсөтөт. Ыкма token маанилүүлүк картасын бере алат; бирок бул карта шайкештик кызматкери жөнгө салуучунун алдында колдоно ала турган табигый, туруктуу жана себептик жүйөгө айланбаса, реалдуу өндүрүш муктаждыгын канааттандырбайт.
Эксперименттер Кантип Жүргүзүлгөн?
Эксперименттерде BGE-M3 аттуу заманбап retrieval embedding модели колдонулат. BGE-M3 dense retrieval, sparse retrieval жана multi-vector retrieval мүмкүнчүлүктөрүн колдогон, узун документтерди иштетүү жөндөмү менен корпоративдик документке жетүү системаларына ылайыктуу модель катары каралат.
Изилдөө реалдуу шайкештик документтеринин ордуна ачык MultiNLI маалымат топтомунун government жана slate түрлөрүн proxy катары колдонот. Бул түрлөр расмий же түзүмдүү тексттерге жакын болгондуктан шайкештик документтерин издөө экспериментинин окшоштуруусу катары колдонулат. Premise бөлүгү документ, hypothesis бөлүгү шайкештик суроосу катары кабыл алынат. Entailment мамилеси тиешелүү документ, contradiction же neutral мамилеси тиешесиз документ катары каралат.
Жалпы 50 үлгүдө үч түшүндүрмө ыкмасы сыналат. Attention үчүн акыркы transformer катмарындагы көңүл буруу салмактары колдонулат. LIME жергиликтүү сызыктуу түшүндүрмө чыгаруу үчүн 75 perturbation үлгүсү менен иштетилет. SHAP болсо partition негизиндеги Shapley маани баалоосу аркылуу token маанилүүлүгүн чыгарат.
Stability экспериментинде бир эле киргизүүнү кайра-кайра иштетүүнүн ордуна майда perturbationдар жасалат. Айрым сөздөр өчүрүлөт, көзөмөлдөнгөн синоним алмаштыруулар жасалат же тыныш белгилери аздап өзгөртүлөт. Ошентип түшүндүрмө майда текст өзгөрүүлөрүнө карата канчалык туруктуу экени өлчөнөт.
Faithfulness экспериментинде түшүндүрмө ыкмасы эң маанилүү деп тапкан алгачкы 5 token калтырылып, моделдин баштапкы божомол ишеними канчалык сакталганы өлчөнөт. Эгер модель ушул tokenдар менен эле ошол эле чечимге окшош ишеним менен жетсе, түшүндүрмө faithful деп көбүрөөк бааланат.
Жыйынтыктар Attention пайыз 89,6, SHAP пайыз 77,1, LIME болсо пайыз 45,8 audit-ready көрсөткүчүнө жеткенин көрсөтөт. Бирок изилдөөнүн чечмелөөсү ачык: эң мыкты ыкма да бардык үлгүлөрдө ишенимдүү шайкештик түшүндүрмөсүн бере албаганы өндүрүш системалары үчүн олуттуу изилдөө боштугу бар экенин көрсөтөт.
Жыйынтыктар Эмнени Көрсөтөт?
Биринчи жыйынтык — түшүндүрмөлүүлүк көйгөйү техникалык визуалдаштыруу маселеси менен гана чектелбейт. Шайкештик контекстинде түшүндүрмө техникалык топ түшүнө турган token маанилүүлүк баллдарынан гана турбашы керек. Аудитор же шайкештик кызматкери чечимдин жөнгө салуучу негизин табигый тилде жана корголуучу түрдө айтып бере алышы керек.
Экинчи жыйынтык — Attention өлчөнгөн критерийлер боюнча эң жакшы натыйжа бергени менен өзү жетишсиз. Attention картасы модель кайсы бөлүктөргө көңүл бурганын көрсөтө алат; бирок бул модель эмне үчүн ошол чечимди чыгарганын себептик түрдө түшүндүрөт дегенди билдирбейт.
Үчүнчү жыйынтык — LIME шайкештик контекстинде олуттуу stability көйгөйүнө ээ. Майда текст өзгөрүүлөрү түшүндүрмөнү олуттуу өзгөртсө, бир эле чечимдин ар башка суроолордо ар башка жүйөлөр менен түшүндүрүлүү коркунучу жаралат. Бул укуктук же шайкештик аудити бар тармактарда кабыл алынгыс болушу мүмкүн.
Төртүнчү жыйынтык — SHAP күчтүүрөөк, бирок дагы эле жетиштүү ишенимдүү эмес. Орточо өндүрүмдүүлүк жакшы көрүнгөнү бардык үлгүлөрдө аудит чеги аткарылды дегенди билдирбейт. Өндүрүштүк шайкештик орточо ийгиликтен көрө катасыздыкка жана туруктуулукка жакын күтүүнү жаратат.
Бешинчи жыйынтык — domain shift көйгөйү мекеме маданияты менен байланыштуу болушу мүмкүн. Саламаттык сактоо жана камсыздандыруу мекемелеринде бир эле маалымат талаасы ар башка маани алып жүрүшү мүмкүн. Коддоо адаттары, чыгымды баалоо саясаттары, документтештирүү маданияты жана операциялык процесстер маалыматтын түзүмүн өзгөртөт. Бул айырманы статистикалык кайра салмактоо менен гана жоюу кыйын болушу мүмкүн.
Алтынчы жыйынтык — тактык ишенимди автоматтык түрдө жаратпайт. Колдонуучулар модель качан ишенимдүү экенин, анын чектери кандай экенин жана өз эксперттик чечими менен кантип бирге колдонуларын түшүнбөсө, туура божомолдор да колдонулбай калышы мүмкүн.
Бул Эмне Үчүн Маанилүү?
Бул изилдөө жасалма интеллектти реалдуу дүйнөгө өткөрүүдө көп учурда көз жаздымда калган жагдайды көрсөтөт: моделдин иштеши системанын пайдалуу экенин билдирбейт. Айрыкча саламаттык сактоо жана камсыздандыруу сыяктуу таасири жогору тармактарда моделдин чыгышы түшүндүрүлүүчү, текшерилүүчү, мекеменин контекстине ылайыкташкан жана колдонуучу тарабынан түшүнүктүү болушу керек.
Саламаттык сактоодо туура эмес же түшүндүрүлбөгөн сунуш бейтап агымына, ресурстарды колдонууга же клиникалык чечимге таасир этиши мүмкүн. Камсыздандырууда түшүндүрүлбөгөн тобокелдик баллы кардар мамилесин, чыгымды башкарууну же шайкештик аудитин кыйындатышы мүмкүн. Шайкештик системаларында болсо документ эмне үчүн чыгарылганын түшүндүрө албаган retrieval модели техникалык жактан туура болсо да, жөнгө салуучунун алдында корголбой калышы мүмкүн.
Изилдөө «түшүндүрүлүүчү жасалма интеллект» талкуусунун практикалык жагын да күчөтөт. Түшүндүрмө ыкмасы изилдөө макаласында жакшы көрүнгөн графикти гана чыгарбашы керек. Ал реалдуу колдонуучуга, реалдуу чечим учурунда, реалдуу мекеме тилинде маанилүү жүйө бериши керек.
Ошондуктан келечектеги изилдөөлөрдүн максаты жогорку benchmark баллы менен гана чектелбеши керек. Causal, deterministic жана natural-language explanation деп жыйынтыктоого боло турган үч муктаждык алдыга чыгат: түшүндүрмө себептик негизге ээ болушу керек, окшош шартта ошол эле киргизүүгө туруктуу жооп бериши керек жана техникалык эмес тараптар колдоно ала турган табигый тилде берилүүгө тийиш.
Көңүл Буруучу Жагдайлар
Биринчи көңүл буруучу жагдай — изилдөөнүн preprint болушу. Жыйынтыктар рецензиядан кийин өзгөрүшү мүмкүн. Ошондуктан алар бекемделген академиялык стандарт катары эмес, өндүрүш тажрыйбасына негизделген күчтүү изилдөө чакырыгы катары окулушу керек.
Экинчи көңүл буруучу жагдай — эксперимент үлгүсүнүн чектелүү болушу. Түшүндүрмөлүүлүк эксперименти 50 үлгүдө жана MultiNLI маалымат топтомунун белгилүү түрлөрүндө жүргүзүлгөн. Бул маалымат реалдуу шайкештик документтеринин ордуна proxy катары колдонулган. Реалдуу саламаттык сактоо же камсыздандыруу шайкештик документтери менен кеңири баалоо талап кылынат.
Үчүнчү көңүл буруучу жагдай — эксперимент downstream task accuracy эмес, түшүндүрмө сапатына басым жасайт. Колдонулган классификация башы fine-tune кылынган эмес; максат моделдин негизги тапшырмадагы ийгилигин эмес, түшүндүрмө ыкмаларынын stability жана faithfulness касиеттерин текшерүү. Бул дизайн XAI баалоо үчүн маанилүү болсо да, жыйынтыктарды түздөн-түз бардык өндүрүш өндүрүмдүүлүгүнө жалпылоого болбойт.
Төртүнчү көңүл буруучу жагдай — Attention натыйжасын туура эмес чечмелебөө. Attentionдын жогорку audit-ready көрсөткүчү attention салмактары чыныгы себептик түшүндүрмө дегенди билдирбейт. Изилдөө муну өзгөчө баса белгилейт: көңүл буруу картасы моделдин кайсы бөлүктөргө көңүл бурганын көрсөтө алат, бирок чечимдин жүйөсүн толук түшүндүрбөшү мүмкүн.
Бешинчи көңүл буруучу жагдай — саламаттык сактоо жана камсыздандыруу колдонмолорунда адамдык көзөмөлдүн зарылдыгы. Мындай системалар чечимди колдоочу курал катары каралышы керек; клиникалык, укуктук, финансылык же камсыздандыруу чечимдеринде өз алдынча автоматтык бийликке айланбашы керек.
Жыйынтык
Бул изилдөө жасалма интеллект системаларын өндүрүшкө киргизүүдөгү маанилүү айырманы тактайт: моделдин туура иштеши жетишсиз. Саламаттык сактоо жана камсыздандыруу сыяктуу таасири жогору тармактарда модель ошол эле учурда түшүндүрүлүүчү, текшерилүүчү, мекеменин контекстине шайкеш жана колдонуучунун ишенимин туура калибрлей ала турган болушу керек.
Эксперименталдык жыйынтыктар Attention, SHAP жана LIME сыяктуу кеңири колдонулган post-hoc түшүндүрмө ыкмалары олуттуу чектөөлөргө ээ экенин көрсөтөт. Attention эң жогорку audit-ready көрсөткүчүнө жетсе да себептик түшүндүрмө бербейт. SHAP кыйла тең салмактуу көрүнөт, бирок бардык үлгүлөрдө ишенимдүү эмес. LIME болсо өзгөчө stability жагынан шайкештик аудити үчүн алсыз.
Изилдөөнүн өндүрүш тажрыйбаларынан чыккан кеңири сабак да маанилүү. Корпоративдик domain shift жөн гана маалымат бөлүштүрүлүшүнүн айырмасы эмес; ал мекемелердин маалыматты түзүү, коддоо жана чечмелөө ыкмаларынан чыккан түзүмдүк айырма. Колдонуучунун ишеними да тактыктан гана пайда болбойт; колдонуучу моделдин чектерин жана чечим процессиндеги ордун түшүнө алышы керек.
Verianla үчүн изилдөөнүн негизги кабары мындай: жасалма интеллектти реалдуу дүйнөгө чыгаруу — жөн гана моделди deploy кылуу эмес. Чыныгы өндүрүш ийгилиги түшүндүрмөлүүлүк, корпоративдик контекст, колдонуучунун ишеними жана текшерүүгө жарактуу чечим процесстерин бирге долбоорлоону талап кылат.
Булак жана Ыкма Жөнүндө Эскертүү
Бул мазмун Jagdish Aslesha Desetty тарабынан даярдалган “Bridging the Deployment Gap: Lessons from NLP and Predictive Modeling in Production Healthcare and Insurance Systems” аттуу preprint изилдөөгө таянып даярдалган. Изилдөө саламаттык сактоо жана камсыздандыруу өндүрүш системаларында NLP негизиндеги документке жетүү, божомолдоо моделдери, түшүндүрмөлүүлүк ыкмалары, корпоративдик domain shift, колдонуучунун ишеними жана audit-readiness көйгөйлөрүн карайт.
Бул мазмун сөзмө-сөз котормо эмес; изилдөөнүн негизги идеясы Verianlaнын жарыялоо багытына ылайык жөнөкөйлөштүрүлүп, оригиналдуу түркчө редакциялык макалага айландырылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген