

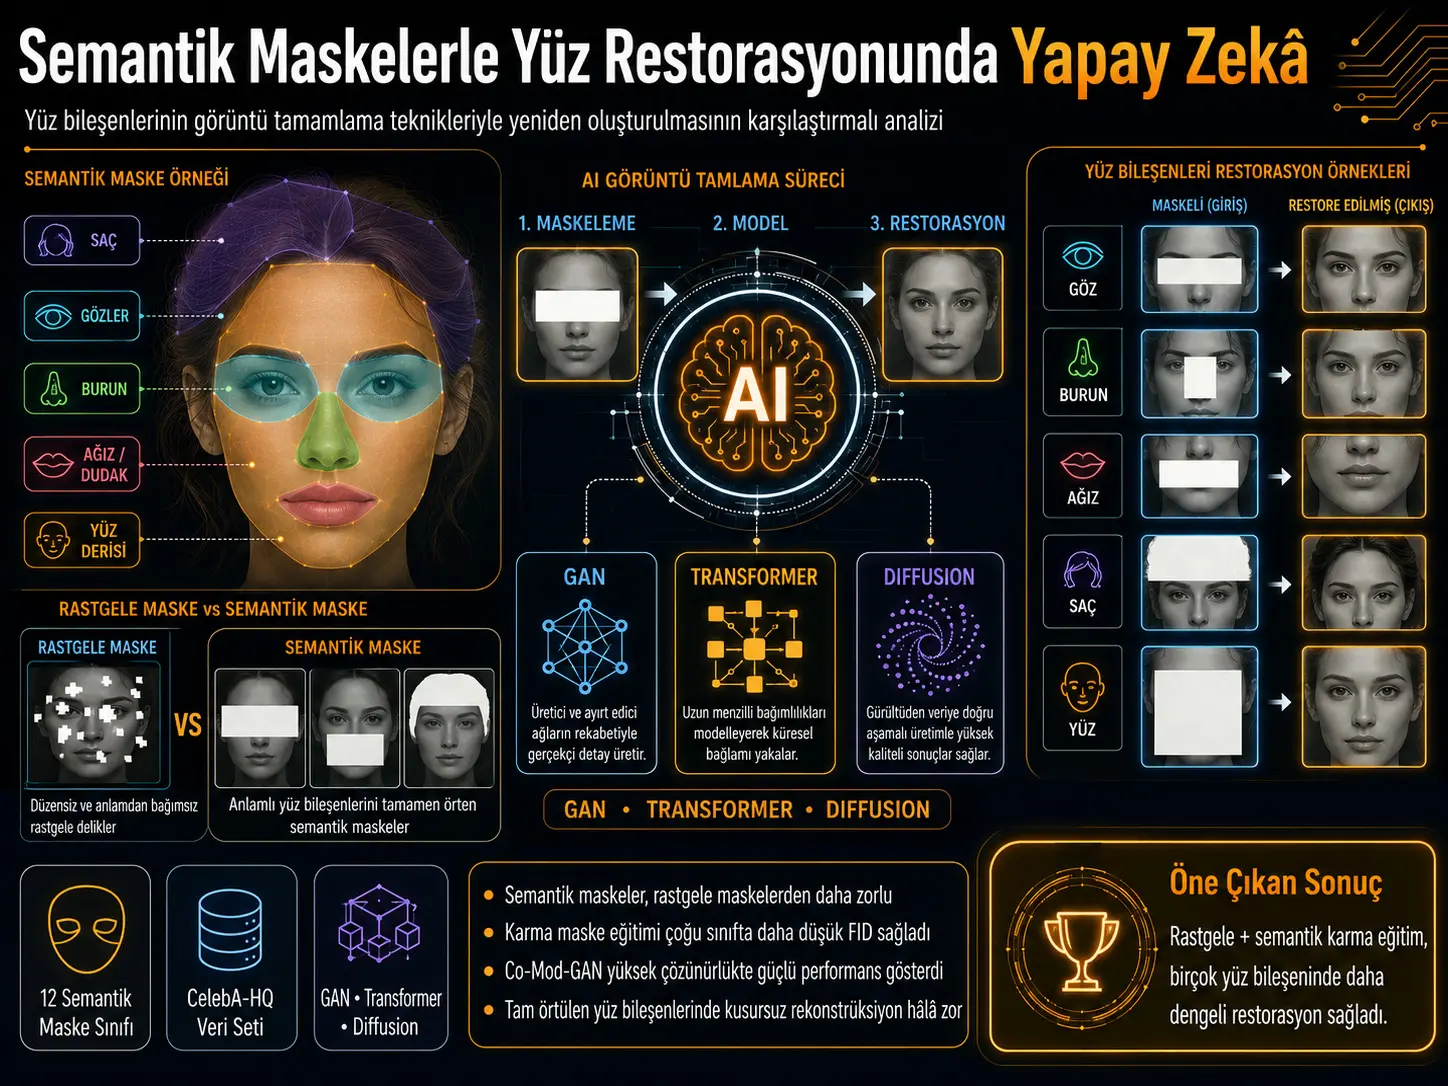
Бул изилдөө көз, мурун, ооз, чач же бет териси сыяктуу бет компоненти семантикалык маска менен толугу менен жашырылганда заманбап жасалма интеллектке негизделген сүрөт толуктоо (image inpainting) ыкмалары жетишпеген аймакты канчалык деңгээлде кайра түзө аларын салыштырат. CelebA-HQ/CelebAMask-HQ бет сүрөттөрү жана 12 ар башка семантикалык маска классы колдонулуп MI-GAN, Latent-based, CMT, MAT, LaMa, Co-Mod-GAN, MADF жана чектелген масштабда RePaint сыяктуу ар башка архитектура үй-бүлөлөрү бааланган. Изилдөөнүн экинчи этабында MAT модели 24.000 окутуу сүрөтү менен туш келди, семантикалык жана бул эки маска түрүн бириктирген аралаш стратегиялар астында нөлдөн кайра окутулуп, 6000 сүрөттө сыналган. Аралаш маска менен окутуу FID боюнча 12 семантикалык маска классынын 10унда эң төмөн маанини берген; бир класста туш келди маска менен бирдей жыйынтык алынган, эң кең бириктирилген маска класында болсо начарыраак иштеген. Ошого карабастан изилдөө толугу менен жабылган бет компоненттери катасыз же оригинал адамга идентификациялык жактан туура түрдө кайтарылып берилерин көрсөтпөйт.
Изилдөөнүн негизги кыйынчылыгы туш келди маскалар менен семантикалык маскалардын ортосундагы маалымат айырмасы. Туш келди маска көздүн, эриндин же чач аймагынын бир бөлүгүн гана жаап, модель калган пиксел түзүлүшүнөн пайдалана алат. Семантикалык маска болсо максат компоненттин баарын алып салып, локалдык структуралык белгилерди жок кылат. Мындай учурда модель көрүнбөгөн аймакты айланадагы бет геометриясы, текстура, симметрия жана окутууда үйрөнгөн статистикалык байланыштардан гана болжолдоого мажбур.
Изилдөөнүн визуалдык эксперименттери бул айырма метрикаларда гана эмес, түзүлгөн беттерде да пайда болорун көрсөтөт. Моделдер калың же кара кирпиктерди, туура эмес түздөлгөн көз каректерин, бириккен эриндер менен тиштерди, даана маска чек араларын, өзгөргөн тери өңдөрүн, табигый эмес чач агымын, жетишпеген кулактарды же айрым учурларда кошумча көз сыяктуу структуралык каталарды чыгарышы мүмкүн. Ошондуктан төмөн FID мааниси өзүнчө анатомиялык же идентификациялык жактан кемчиликсиз реконструкция дегенди билдирбейт.
| Эксперимент элементи | Изилдөөдө колдонулган түзүлүш | Чечмелөө чеги |
|---|---|---|
| Негизги маалымат топтому | Болжол менен 30.000 CelebA-HQ бет сүрөтү, 1024 × 1024 | Клиникалык бейтап же травма маалымат топтому эмес. |
| Семантикалык маска классы | 12 класс (A–L) | Белгиленген бет компоненттери толугу менен жашырылат. |
| Бааланган чечилиштер | 256, 512 жана 1024 | Ар бир модель бардык чечилиште бааланган эмес. |
| Негизги метрикалар | FID, P-IDS, U-IDS | P-IDS/U-IDS багыты боюнча булакта аныктама–чечмелөө дал келбестиги бар. |
| MAT кайра окутуу | 24.000 окутуу + 6000 тест сүрөтү | 512 × 512 чечилиште аткарылган. |
| Маска окутуу стратегиялары | Туш келди, семантикалык, аралаш | Аралаш ыкма көпчүлүк, бирок бардык маска класстарында үстөм эмес. |
Эмне үчүн сүрөт толуктоо көйгөйү семантикалык маскаларда татаалдашат?
Сүрөт толуктоо — сүрөттөгү жетишпеген же жашырылган аймакты айланадагы маалыматты колдонуп жасалма түрдө кайра түзүү. Адам беттеринде бул тапшырма өзгөчө татаал; анткени көздөрдүн бири-бирине карата жайгашуусу, мурун–ооз геометриясы, жаак түзүлүшү, чач агымы, тери өңү жана бет симметриясы сыяктуу бири-бири менен байланышкан көптөгөн өзгөчөлүктөр бар.
Изилдөөдө колдонулган семантикалык маскалар туш келди формадагы боштуктардан айырмаланат. Маскалар белгилүү анатомиялык/визуалдык компоненттин сегментация белгисин колдонуп ошол компонентти толугу менен жашырат. Мисалы көз маскасы көздөр менен кошо каштарды; ооз класстары жогорку эрин, төмөнкү эрин жана ооз аймагынын ар башка комбинацияларын; чач маскасы чачтын баарын; “face” маскасы болсо моюн, көз, мурун, ооз жана кулактардан башка бет терисин жаап коёт.
Бул операция модель үчүн жарым-жартылай көрүнгөн көз же эрин калтырбагандыктан реконструкция маселеси белгисиз болуп калат. Бир эле көрүнгөн бет аймагына туура келиши мүмкүн болгон көптөгөн көз, эрин же чач формалары бар. Демек, түзүлгөн сүрөт визуалдык жактан ишенимдүү көрүнүшү жашырылган оригинал компоненттин так өзү кайтарылганын билдирбейт.
Кайсы жасалма интеллект моделдери изилденди?
Изилдөөчүлөр мурунку сүрөт толуктоо адабиятынан ар башка архитектура үй-бүлөлөрүн көрсөткөн ыкмаларды тандашкан. Алардын арасында GAN-негизиндеги, Transformer-негизиндеги, latent өкүлчүлүккө таянган жана диффузия-негизиндеги системалар бар.
| Модель | Негизги чечилиш маалыматы | Изилдөөдөгү ролу |
|---|---|---|
| MI-GAN | 256 | Мобилдик түзмөктөр үчүн иштелип чыккан жеңил сүрөт толуктоо модели. |
| Latent-based | 256 | Дискреттүү latent коддорго негизделген көп варианттуу сүрөт толуктоо ыкмасы. |
| CMT | 256 | Continuous-Mask-Aware Transformer ыкмасы. |
| MAT | 256 жана 512 | Mask-Aware Transformer; CelebA жана FFHQ моделдери бааланган. |
| LaMa | 256, 512 жана булак таблицаларында 1024 | Fourier convolutions колдонгон кең маскалуу inpainting ыкмасы. |
| Co-Mod-GAN | 512 жана 1024 | Жогорку чечилиште сүрөт толуктоодо бааланган. |
| MADF | 512 | Mask-aware cascaded refinement ыкмасы. |
| RePaint | Булак модель таблицасында 256 | Диффузия-негизиндеги ыкма; жогорку эсептөө чыгымынан улам чектелген үлгүдө гана бааланган. |
RePaintтин камтылышы башка моделдерден ачык айырмаланат. Изилдөөчүлөр бир сүрөттү бир семантикалык маска классы менен толуктоо болжол менен беш мүнөт созуларын; 10 сүрөттү 12 класс менен баалоо болжол менен 10 саат талап кыларын билдиришкен. Ошондуктан RePaint болгону 10 сүрөттө сыналып, башка ыкмалар менен бирдей масштабдагы сандык салыштырууга киргизилген эмес.
Маалымат топтому жана семантикалык сегментация кантип колдонулду?
Изилдөөдө CelebA-HQ негизиндеги болжол менен 30.000 жогорку сапаттагы бет сүрөтү колдонулган. Оригинал сүрөттөр 1024 × 1024 чечилиште жана модель талаптарына жараша кайра өлчөмдөлгөн. Беттин семантикалык сегментациясында 19 класстуу түзүлүш негиз катары алынган.
Изилдөөнүн 1-сүрөтү оригинал бет сүрөтүнүн жанында беттин семантикалык бөлүктөргө ажыратылган көрүнүшүн көрсөтөт. Чач, бет териси, көздөр/каштар, мурун, кулактар, жогорку эрин, төмөнкү эрин жана ооз өзүнчө аймактар болуп коддолгон. Ошентип туш келди тик бурчтук же щетка изи формасындагы маскалардын ордуна чыныгы бет компонентинин чек араларын ээрчиген маскалар түзүлгөн.
| Маска | Жашырылган негизги компонент |
|---|---|
| A | Көздөр жана каштар |
| B | Мурун |
| C | Жогорку эрин + төмөнкү эрин + ооз |
| D | Төмөнкү эрин |
| E | Жогорку эрин |
| F | Ооз |
| G | Чач |
| H | Кулактар/тиешелүү сөйкө аймагы |
| I | Бет териси |
| J | Мурун + жогорку эрин + төмөнкү эрин + ооз |
| K | Көздөр + мурун + эриндер + ооз |
| L | Бет териси + чач + кулактар |
Verianla Live: Эксперименттин негизги агымы
| Этап | Изилдөөдөгү операция |
|---|---|
| 1. Бет сүрөттөрү | CelebA-HQ/CelebAMask-HQ сүрөттөрү колдонулду. |
| 2. Семантикалык сегментация | 19 класстуу бет сегментациясынан максат компоненттер чыгарылды. |
| 3. Маска түзүү | A–L арасында 12 семантикалык маска классы аныкталды. |
| 4. Алдын ала окутулган модель салыштыруусу | Ар башка GAN, Transformer, latent жана диффузия-негизиндеги моделдер бааланды. |
| 5. Чечилиш салыштыруусу | Модель колдоосуна жараша 256, 512 жана 1024 чечилиштер каралды. |
| 6. MAT кайра окутуу | Туш келди, семантикалык жана аралаш маскалар менен үч өзүнчө окутуу жүргүзүлдү. |
| 7. Статистикалык текшерүү | 6000 сүрөттөн түзүлгөн bootstrap кичи үлгүлөрү менен FID айырмалары текшерилди. |
FID, P-IDS жана U-IDS эмнени өлчөйт?
Изилдөөчүлөр пиксел деңгээлиндеги PSNR жана SSIMдин ордуна Inception белгилер мейкиндигине негизделген кабылдоо метрикаларын тандашкан. Негизги өлчөм Fréchet Inception Distance (FID) мааниси. FID чыныгы жана түзүлгөн сүрөт бөлүштүрүүлөрүнүн белгилер мейкиндигиндеги айырмасын салыштырат жана изилдөөдө төмөн FID жакшы жыйынтык катары бааланган:
\[ FID(p_r,p_g)=\|\mu_r-\mu_g\|_2^2+ Tr\left(\Sigma_r+\Sigma_g-2(\Sigma_r\Sigma_g)^{1/2}\right) \]
Бул жерде \(\mu_r\) жана \(\mu_g\) чыныгы жана түзүлгөн сүрөт белгилеринин орточо маанилерин; \(\Sigma_r\) жана \(\Sigma_g\) ковариация матрицаларын билдирет.
Макала P-IDS жана U-IDS өлчөмдөрүн да колдонот. Бирок булакта маанилүү методологиялык дал келбестик бар. Берилген теңдемелер бул өлчөмдөрдү чыныгы жана түзүлгөн сүрөт белгилеринин ортосундагы квадраттык аралыктардын орточосу катары берет:
\[ P\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f(x_i)-f(x'_i)\|_2^2 \]
\[ U\text{-}IDS=\frac{1}{N}\sum_{i=1}^{N}\|f_u(x_i)-f_u(x'_i)\|_2^2 \]
Бул теңдеме формасында кичирээк аралык жакыныраак белги дал келүүсүн билдирет. Бирок изилдөөнүн Таблица 4 түшүндүрмөсү жана жыйынтык чечмелөөлөрү P-IDS/U-IDS үчүн жогорураак маанилерди эң жакшы иштөө катары тизет. Булак бул багыт айырмасын түшүндүрбөгөндүктөн, бул жерде P-IDS жана U-IDS жыйынтыктары авторлор бергендей өткөрүлөт, бирок метрика багыты өз алдынча так аныкталбайт.
256 чечилиште кайсы моделдер алдыга чыкты?
256 × 256 чечилиште FID боюнча MI-GAN 12 семантикалык маска классынын 10унда алдыңкы үчтүккө кирип, төрт класста эң жакшы маанини берген. Latent-based модель тогуз класста алдыңкы үчтүккө кирип, алты класста эң жакшы FID маанисин берген. MAT болсо сегиз маска класста алдыңкы үчтүктүн арасында болгон.
Изилдөөнүн өз P-IDS чечмелөөсүнө ылайык MI-GAN бардык маска класстарында эң жогорку P-IDS маанисин берген; U-IDSде 10 класста эң жогорку жыйынтыкты көрсөткөн. Бирок жогоруда айтылган P-IDS/U-IDS багыты боюнча теңдеме–чечмелөө дал келбестигинен улам бул рейтинг FID жыйынтыктары сыяктуу так чечмеленбеши керек.
512 чечилиште визуалдык каталар кандай болду?
512 × 512 салыштырууда MATтын FFHQ модели FID боюнча 12 маска классынын баарында алдыңкы үч моделдин арасында болуп, жети класста эң жакшы FID маанисин берген. CelebA-негизиндеги MAT модели 11 класста алдыңкы үчтүккө кирген.
Бирок изилдөөнүн 2-сүрөтүндөгү визуалдык мисалдар сандык упайлар өзүнчө жетишсиз экенин көрсөтөт. Изилдөөчүлөр LaMa жана MADF көздөрдү калыбына келтирүүдө бүдөмүк же бири-бирине аралашкан көздөрдү жаратышы мүмкүн экенин; LaMa айрым мурун маскаларында кичинекей мурун жана кош оозго окшош түзүлүш түзүшү мүмкүн экенин; MAT айрым бет маскаларында кирпиктерди калыңдатарын; Co-Mod-GAN мурундун айланасында көрүнгөн чек араларды калтыра аларын; MADF болсо кээ бир үлгүлөрдө кошумча көз же эриндин үстүнө чыгып кеткен тиштерди жарата аларын билдиришкен.
1024 чечилиште Co-Mod-GAN менен LaMaнын айырмасы
1024 × 1024 баалоодо Co-Mod-GAN жана LaMa гана салыштырылган. FID боюнча Co-Mod-GAN 12 семантикалык маска классынын 11инде LaMaдан төмөн мааниге жеткен. Жалгыз өзгөчө учур жогорку эрин маскасы E; бул жерде LaMaнын FID мааниси 0,37, Co-Mod-GANдыкы 0,72.
Verianla Live: 1024 чечилиште тандалган татаал маскалардагы FID
Төмөн FID жакшыраак бөлүштүрмөлүк окшоштукту билдирет. Бул визуалдаштыруу өзгөчө чоң же структуралык жактан татаал семантикалык аймактарды көрсөтөт.
| Маска классы | Co-Mod-GAN FID | LaMa FID |
|---|---|---|
| G — Чач | 11,60 | 41,85 |
| I — Бет | 11,24 | 33,61 |
| J — Мурун + ооз аймагы | 3,93 | 9,20 |
| K — Көз + мурун + ооз аймагы | 6,23 | 18,58 |
| L — Бет + чач + кулактар | 65,73 | 206,07 |
3-сүрөттө LaMaнын 256, 512 жана 1024 чечилиштердеги үлгүлөрү катар көрсөтүлүп, чечилиш жогорулаган сайын айрым бет компоненттеринде даана бузулуулар көрүнүшү мүмкүн. 4-сүрөттө Co-Mod-GANдын 512 жана 1024 чыгыштары бири-бирине жакыныраак көрүнөт. Бул байкоо булак авторлорунун Co-Mod-GANды жогорку чечилиш үчүн натыйжалуураак модель катары баалашына негиз болот.
Бирок метод текстинде “LaMa жогорку чечилиште натыйжасыз табылгандыктан 512 жана 256да бааланды” деген маанидеги билдирүү болгонуна карабастан, кийинки бөлүм, Таблица 5 жана 3-сүрөт 1024 LaMa жыйынтыктарын ачык көрсөтөт. Бул булак ичиндеги карама-каршылык чечилбей сакталууга тийиш.
Кайсы бет компоненттери моделдер үчүн көбүрөөк көйгөйлүү?
Жыйынтыктар бир дагы модель бардык бет аймактарында ишенимдүү үстөмдүк көрсөтпөгөнүн ачып берет. Булак изилдөөнүн модель боюнча визуалдык талдоосунда төмөнкү ката түрлөрү билдирилген:
- Көз: өтө калың кирпик, кара көз, көз карегинин туура эмес жайгашуусу же түс дал келбестиги, бүдөмүк же аралашкан көз түзүлүшү.
- Ооз жана эрин: эриндердин биригиши, реалдуу эмес же жарылган тиштер, тиштердин эриндин үстүнө чыгышы, төмөнкү эриндин жайгашуусу жана түс көйгөйлөрү.
- Бет териси: маска чек араларынын көрүнүшү, тери өңүнүн айырмасы, беттин кыскарышы/ичкериши, чагылууга окшош түзүлүштөр.
- Чач: табигый эмес агым, түс үзгүлтүксүздүгүнүн жоголушу, бөлүк-бөлүк чач жаралышы же маскадагы айрым аймактардын фон/кулак менен толтурулушу.
- Кулак: жетишпеген кулак же кулак аймагынын чач менен алмаштырылышы.
- Мурун: көп моделде салыштырмалуу ийгиликтүү болгону менен айрым учурларда жетишпеген, кичинекей же чек арасы даана реконструкция.
Кошумча A1-сүрөт көз, ооз/эрин, бет жана мурун+ооз комбинацияларынын жакындатылган кесиндилерин модель боюнча салыштырат. Бул жакын көрүнүш толук сүрөттө байкоо кыйын болгон кирпик калыңдыгы, эрин–тиш биригиши жана түс өтүшү сыяктуу кемчиликтерди ачыгыраак көрсөтөт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперимент жабдуусу
| Компонент | Изилдөөдө билдирилген өзгөчөлүк |
|---|---|
| GPU | 2 × NVIDIA A800 Active |
| GPU эс тутуму | Ар бир GPU үчүн 40 GB |
| CUDA | 12.0 |
| CPU | Intel Xeon w9-3495X |
| CPU өзөгү | 56 өзөк, 1,9–4,8 GHz |
| RAM | 256 GB |
| Сактагыч колдонуу | 286 GB |
Моделдин иштөө убакыттары
Изилдөө RePaintтен башка ыкмалар бир сүрөттү 0,3 секунддан аз убакытта толуктай аларын билдирет. Таблица 6га ылайык 2000 сүрөттү иштетүү убакыттары төмөнкүдөй:
| Модель | Булак Таблица 6да билдирилген убакыт |
|---|---|
| MAT | 256: 3 мүн; 512: 5 мүн |
| Co-Mod-GAN | 512: 1 мүн; 1024: 2 мүн |
| MADF | 512 тилкесинде 6 мүн |
| CMT | 512 тилкесинде 1 мүн |
| Latent-based | 512 тилкесинде 10 мүн |
| MI-GAN | 512 тилкесинде 2 мүн |
| LaMa | 256: 0,5–1 мүн; 512: 1,5 мүн; 1024: 5 мүн |
| RePaint | 512 тилкесинде болжол менен 5 мүн/сүрөт |
Бул жерде булак ичиндеги чечилиш дал келбестиги бар. Модель тандоо Таблица 1 CMT, Latent-based, MI-GAN жана RePaint үчүн 256 чечилишти билдирсе, эсептөө убактысы Таблица 6 бул моделдердин убакыттарын 512 × 512 тилкесине жайгаштырат. Макала мунун себебин түшүндүрбөйт; ошондуктан убакыт таблицасы жогоруда булакта көрүнгөндөй берилди.
MAT эмне үчүн кайра окутулду?
512 чечилиш салыштырууларында күчтүү жыйынтык берген MAT семантикалык маска көйгөйү үчүн үч өзүнчө окутуу стратегиясын салыштырууда колдонулган:
- Туш келди маскалар менен гана окутуу,
- Семантикалык маскалар менен гана окутуу,
- Туш келди жана семантикалык маскалар бирге колдонулган аралаш окутуу.
MAT модели ар бир экспериментте нөлдөн башталган. Окутууда 24.000 сүрөт, тестте 6000 сүрөт колдонулган. Adam optimizerдин үйрөнүү ылдамдыгы \(1\times10^{-4}\), \(\beta_1=0.9\) жана \(\beta_2=0.999\) болуп белгиленип; batch size 8 жана окутуу узактыгы 100 epoch катары колдонулган. Batch өлчөмү ар бир GPU үчүн жеткиликтүү 40 GB эс тутум чегинен улам 8 менен чектелген.
Стандарттуу data augmentation катары туш келди горизонталдык оодаруу жана айлантуу колдонулуп, кошумча түс jitter же башка геометриялык трансформация колдонулган эмес. Ар бир окутуу сессиясы болжол менен 7 күн 13 саат созулганы билдирилген.
Эмне үчүн туш келди маска семантикалык маскадан гана жакшы чыкты?
Биринчи кайра окутуу жыйынтыгында, тест семантикалык маскалар менен жасалганына карабастан туш келди маскалар менен гана окутулган MAT модели семантикалык маскалар менен гана окутулган MATтан жалпысынан төмөн FID берген. Авторлор муну туш келди маскалар көп түрдүү жоголгон аймактарды жаратып, моделди сүрөттүн бүтүндөгү контексттик байланыштарды үйрөнүүгө мажбур кылышы менен түшүндүрүшөт.
Бул түшүндүрмө изилдөө сунуштаган чечмелөө. Изилдөө overfitting механизмин өзүнчө эксперименттер менен түз өлчөгөн эмес; ошондуктан “туш келди маска сөзсүз overfittingти азайтат” деген себептик жалпылоо жасалбашы керек.
Аралаш маска стратегиясынын FID жыйынтыктары
| Маска | Туш келди окутуу FID | Семантикалык окутуу FID | Аралаш окутуу FID |
|---|---|---|---|
| A | 1,46 | 1,78 | 1,25 |
| B | 0,93 | 0,95 | 0,93 |
| C | 2,01 | 3,73 | 1,59 |
| D | 0,75 | 1,20 | 0,71 |
| E | 0,74 | 1,40 | 0,56 |
| F | 2,36 | 2,05 | 1,24 |
| G — Чач | 12,51 | 17,38 | 7,10 |
| H | 3,90 | 3,91 | 3,33 |
| I — Бет | 8,16 | 9,25 | 5,69 |
| J | 2,46 | 4,00 | 2,20 |
| K | 3,56 | 5,00 | 3,03 |
| L — Бет + чач + кулактар | 115,51 | 114,35 | 130,82 |
Аралаш окутуу A, C, D, E, F, G, H, I, J жана K класстарында эки жеке стратегиядан тең төмөн FID берген. B класста туш келди окутуу менен бирдей FID 0,93 алынган. Эң кең маска L класста болсо аралаш окутуунун FIDи 130,82ге жогорулап, туш келди жана семантикалык окутуудан начар болгон. Ошондуктан жыйынтыкты “аралаш ыкма бардык учурда үстөм” деп жалпылоого болбойт.
Bootstrap текшерүүсү эмнени көрсөттү?
Изилдөөчүлөр FID айырмалары белгилүү тест үлгүлөрүнөн гана келип чыгабы же жокпу текшерүү үчүн 6000 сүрөттүк тест топтомунан bootstrap анализ жүргүзүшкөн. Ар бир баалоодо 1000 уникал сүрөт тандалып, процесс 100 жолу кайталанган. Бир эле сүрөт бир bootstrap үлгүсүндө кайталанган эмес, бирок ар башка bootstrap үлгүлөрүндө кайра кездеше алган.
Кошумча Таблица A2де аралаш маска окутуу A, C, D, E, F, G, I, J жана K маска класстарында туш келди жана семантикалык окутуудан тең төмөн FID берип, айырмалар p<0,01 деңгээлинде статистикалык маанилүү экени белгиленген. B жана H үчүн мындай эки тараптуу маанилүүлүк белгиленген эмес; L класста аралаш ыкма начар FID берген.
| Тандалган маска | Туш келди FID, орточо ± SS | Семантикалык FID, орточо ± SS | Аралаш FID, орточо ± SS | Булак жыйынтыгы |
|---|---|---|---|---|
| C — Толук ооз/эрин | 2,03 ± 0,05 | 3,76 ± 0,09 | 1,60 ± 0,04 | Аралаш, экөөнөн тең p<0,01 төмөн. |
| G — Чач | 12,66 ± 0,33 | 17,43 ± 0,42 | 7,15 ± 0,21 | Аралаш, экөөнөн тең p<0,01 төмөн. |
| I — Бет | 8,22 ± 0,21 | 9,30 ± 0,24 | 5,71 ± 0,15 | Аралаш, экөөнөн тең p<0,01 төмөн. |
| L — Бет + чач + кулак | 116,10 ± 3,23 | 114,90 ± 3,19 | 131,45 ± 3,51 | Аралаш ыкма үстөм эмес. |
Визуалдык мисалдар аралаш ыкманы кандай көрсөтөт?
5-сүрөттө туш келди, семантикалык жана аралаш маска менен окутулган MAT моделдеринин бет, чач жана толук ооз/эрин калыбына келтирүүлөрү катар көрсөтүлгөн. Авторлордун визуалдык баасына ылайык туш келди маска менен окутулган модель бет түсүн айланага жакшыраак аралаштыра алганы менен бет геометриясы кыска жана шайкеш эмес көрүнүшү мүмкүн. Семантикалык окутуу бет формасына көбүрөөк жакындай алат, бирок тери өңү айлана менен дал келбеши мүмкүн. Аралаш окутуу бул эки ката түрүнүн ортосунда тең салмактуу жыйынтык чыгарган.
Чачта туш келди окутуу чач агымында, семантикалык окутуу түс үзгүлтүксүздүгүндө көйгөй жаратышы мүмкүн, аралаш стратегия болсо эки өзгөчөлүктү жакшыраак тең салмактаган. Ооз мисалында да аралаш окутуу визуалдык жактан калган эки стратегиядан жакшыраак көрсөтүлгөн. Бирок булар тандалган визуалдык мисалдар; изилдөө көз карандысыз адам баалоочулар менен сокурланган кабылдоо колдонуучу изилдөөсүн билдирбейт.
Изилдөө аныктаган структуралык чектөөлөр
Изилдөөчүлөр окутуу маалыматын гана өзгөртүү менен көйгөйдү толук чечүүгө болбой турганын жана учурдагы архитектураларда структуралык чектер бар экенин белгилешет:
- Локалдык receptive field жана convolutional bias: Толук семантикалык маска CNN/GAN моделдери колдоно ала турган локалдык белгилерди толугу менен жок кыла алат.
- Алсыз глобалдык жана семантикалык ой жүгүртүү: Transformer жана диффузия моделдери кең контекстти моделдей алса да сүрөттөгү анатомиялык компоненттердин так структуралык байланышын дайыма сактай албайт.
- Чектелген структуралык priorлор: Моделдер бет анатомиясын ачык эрежелер түрүндө билбейт; негизинен окутуу маалыматындагы статистикалык байланыштарды үйрөнөт.
- Белгисиздик: Толугу менен көрүнбөгөн компонент үчүн визуалдык жактан кабыл алынуучу бир нече чечим болушу мүмкүн.
Авторлор келечекте бет компоненттерин ачык моделдеген, бет геометриясы жана компоненттердин көз карандылыгын эске алган архитектураларды; адаптивдүү маска окутууну жана компонентке мүнөздүү loss функцияларын изилдөөнү сунушташат.
Изилдөө эмнени далилдебейт?
- Масканын астындагы оригинал көз, ооз, мурун же чач идентификациялык жактан туура түрдө калыбына келтириле аларын далилдебейт.
- Түзүлгөн бет компоненттери анатомиялык жактан медициналык реконструкция үчүн ишенимдүү экенин далилдебейт.
- Изилдөө чыныгы бейтап, травма, күйүк же хирургиялык бет реконструкциясы маалыматтарын колдонбойт.
- Купуялуулукту коргоо же бет таануу системаларында чыныгы идентификацияны сактоо ийгилигин өлчөбөйт.
- Аралаш маска ыкмасы бардык маскаларда же бардык inpainting архитектураларында үстөм экенин көрсөтпөйт.
- Төмөн FID адамдын көзү же идентификацияны сактоо жагынан кемчиликсиз жыйынтык дегенди көрсөтпөйт.
- RePaint башка моделдер менен бирдей үлгү саны жана эсептөө бюджети астында салыштырылбагандыктан диффузия моделдери жалпы начар деген жыйынтыкты колдобойт.
Булак жана Ыкма Жөнүндө Эскертүү
| Толук оригинал изилдөө аталышы | Evaluating AI-Based Image Inpainting Techniques for Facial Components Restoration Using Semantic Masks |
|---|---|
| Авторлор | Hussein Sharadga; Abdullah Hayajneh; Erchin Serpedin |
| Тең салым | Булакта тең биринчи/тең салым билдирүүсү көрсөтүлгөн эмес. |
| Жооптуу автор | Hussein Sharadga |
| Мекемелер | School of Engineering, Texas A&M International University, АКШ; King Abdullah II School of Engineering, Princess Sumaya University for Technology, Иордания; Department of Electrical and Computer Engineering, Texas A&M University, АКШ. |
| Булак түрү | Рецензияланган изилдөө макаласы; салыштырма жасалма интеллект/сүрөт иштетүү benchmark жана кайра окутуу изилдөөсү. |
| Рецензия статусу | Рецензияланган журналда жарыяланган макала; preprint эмес. |
| Журнал | AI |
| Басмакана | MDPI |
| Том / сан / макала | 2026, 7(4), 119 |
| DOI | 10.3390/ai7040119 |
| Кабыл алуу / ревизия / кабылдануу / жарыя | 8 февраль 2026 / 12 март 2026 / 23 март 2026 / 30 март 2026 |
| Расмий шилтеме | https://doi.org/10.3390/ai7040119 |
| Лицензия | Creative Commons Attribution (CC BY). |
Каржылоо, маалымат жана кызыкчылыктардын кагылышы
Авторлор изилдөө тышкы каржылоо албаганын билдиришкен. Макаланы иштетүү акысы Texas A&M International University тарабынан төлөнгөнү белгиленген. Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Изилдөөдө колдонулган бет сүрөттөрү жалпыга ачык CelebAMask-HQ маалымат топтомунан алынган жана булак изилдөө бул топтом коммерциялык эмес изилдөө максатында гана колдонулганын билдирет. Авторлор чийки бет сүрөттөрүн кайра таратууга уруксаты жок экенин айтышат.
Генеративдүү жасалма интеллект колдонуу билдирүүсү
Булак изилдөөнүн ыраазычылык бөлүмүндө авторлор макаланын окулушун жакшыртуу үчүн ChatGPTнин “GPT-5 mini, free version” версиясын колдонгонун; андан кийин мазмунду өздөрү карап чыгып түзөткөнүн жана жарыяланган текст үчүн жоопкерчиликти өздөрүнө алышканын билдиришкен. Бул билдирүү изилдөөнүн эксперименттик сүрөт толуктоо жыйынтыктары ChatGPT тарабынан түзүлгөн дегенди билдирбейт.
Автордук салымдар
Концептуалдаштырууга үч автор тең салым кошкон. Методология, программалык камсыздоо, маалымат курациясы жана долбоорду башкаруу Hussein Sharadga менен Abdullah Hayajneh тарабынан жүргүзүлгөн; валидация жана изилдөө иштерине үч автор тең катышкан. Оригинал долбоор Hussein Sharadga жана Abdullah Hayajneh тарабынан даярдалган; үч автор тең карап чыгуу жана редакциялоо процессине салым кошкон.
Булак ичиндеги дал келбестиктердин жазуусу
- P-IDS жана U-IDS теңдемелери аралык өлчөмү катары аныкталганы менен таблицалар жана текст жогорку маанини жакшыраак иштөө катары чечмелейт. Булак бул айырманы түшүндүрбөйт.
- Метод тексти LaMa жогорку чечилиште натыйжасыз табылгандыктан 256 жана 512де бааланганын айтса, кийин 1024 LaMa жыйынтыктары берилет.
- Модель Таблица 1 CMT, Latent-based, MI-GAN жана RePaint үчүн 256 чечилишти билдирсе, эсептөө убактысы Таблица 6 бул моделдердин убакыттарын 512 × 512 тилкесинде көрсөтөт.
Негизги чектөөлөр
- Жыйынтыктар бир негизги бет маалымат топтому үй-бүлөсүнө таянат.
- Клиникалык же травмалык бет реконструкция маалымат топтому колдонулган эмес.
- Ар бир модель бирдей чечилиште жана бирдей эсептөө бюджети менен сыналган эмес.
- RePaint болгону 10 сүрөттө чектелген түрдө бааланган.
- Визуалдык сапат баалары үчүн көз карандысыз, сокурланган адам баалоочу изилдөөсү берилген эмес.
- FID бөлүштүрмөлүк кабылдоо окшоштугунун өлчөмү; оригинал адамдын чыныгы жоголгон бет компоненти кайра түзүлгөнүн далилдебейт.
- Эң кең L семантикалык маска класста аралаш окутуу начар FID чыгарган.
- Булакта P-IDS/U-IDS метрика багыты боюнча аныктама жана чечмелөө дал келбестиги бар.
Изилдөөнүн эң күчтүү жыйынтыгы — толугу менен жашырылган семантикалык бет компоненттери учурдагы сүрөт толуктоо моделдери үчүн дагы эле татаал көйгөй жана маска ар түрдүүлүгү окутуу иштөөсүнө олуттуу таасир бере алат. Аралаш туш келди–семантикалык окутуу стратегиясы көп бет компоненттеринде FIDди жакшыртканы менен, изилдөө кемчиликсиз бет реконструкциясына жетишилгенин эмес, тескерисинче бул дагы деле ачык изилдөө маселеси экенин көрсөтөт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген