

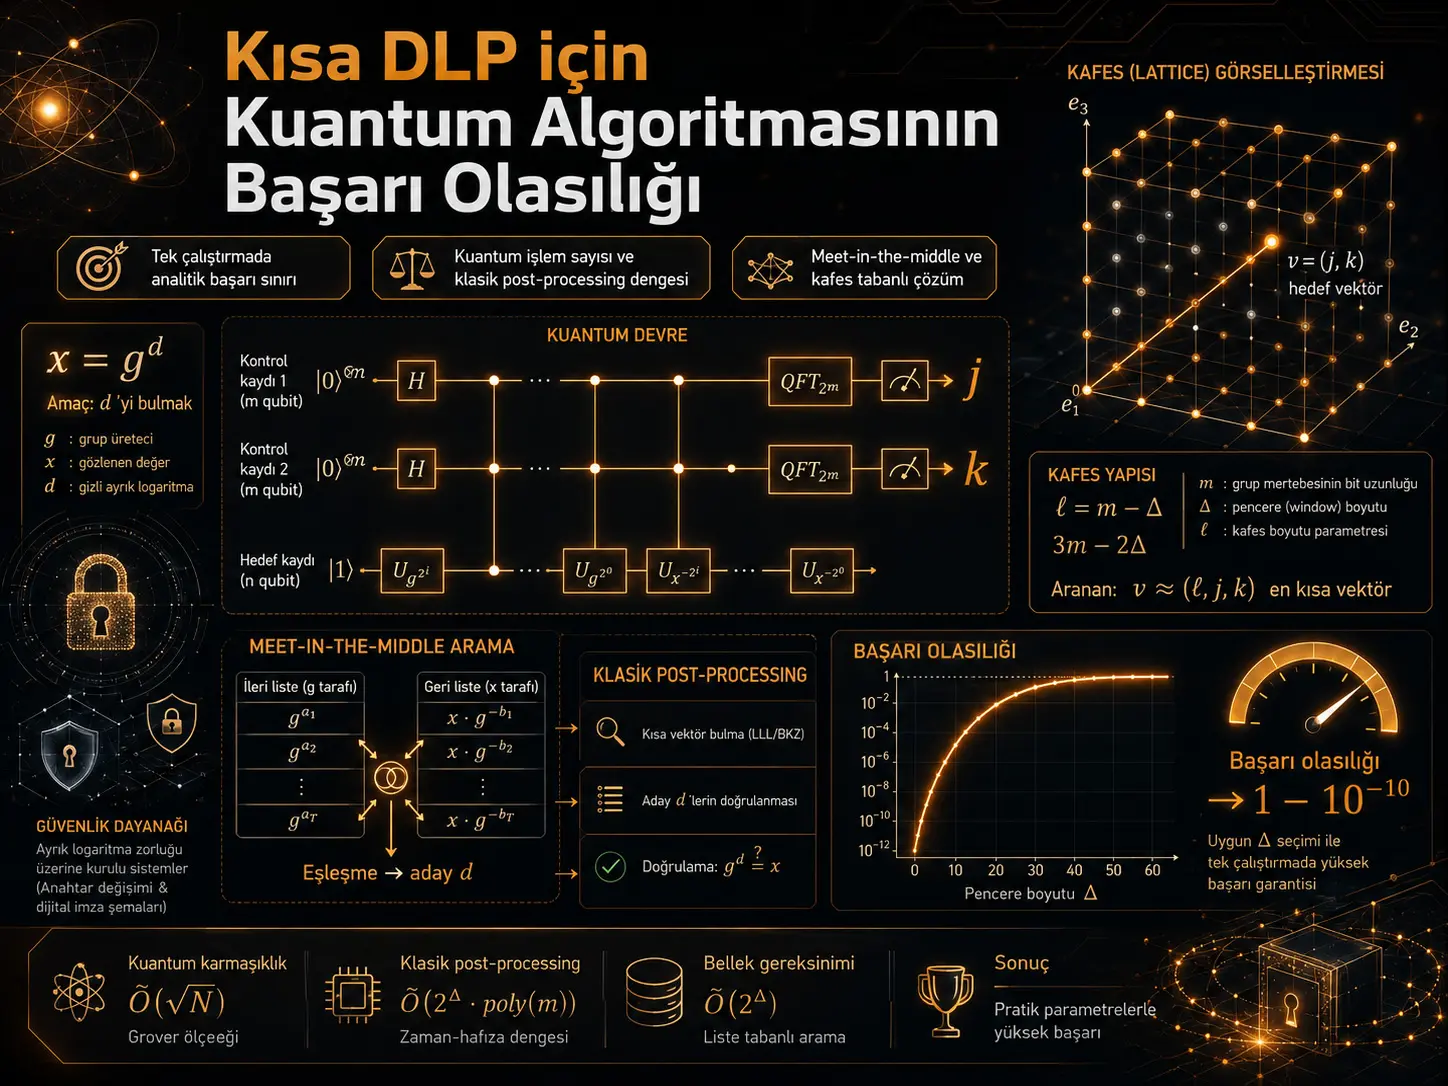
Бул изилдөө Ekerå–Håstad кванттык алгоритминин кыска дискреттик логарифм маселесин (short discrete logarithm problem, short DLP) бир гана кванттык иштетүүдө чечүү ыктымалдыгы үчүн симуляцияга таянбаган математикалык төмөнкү чекти чыгарат жана бул чыгышты классикалык түрдө иштетүүгө керектүү эсептөө чыгымын жогору жактан чектейт. Негизги жыйынтык — ылайыктуу параметрлер жана классикалык post-processing тандалганда кыска логарифм \(d\) ни бир иштетүүдө калыбына келтирүүнүн теориялык ийгилик төмөнкү чеги \(1-10^{-10}\) деңгээлине чейин көтөрүлүшү мүмкүн. Мындай жогорку ийгилик ыктымалдыгы кванттык бөлүктү чоңойтуудан эмес, кванттык өлчөөнүн натыйжасында алынган \((j,k)\) жупту тор негизиндеги классикалык иштетүүдө meet-in-the-middle же аз эс тутумдуу random-walk ыкмаларын колдонуу менен алынат. Натыйжалар математикалык жана логикалык кванттык схемаларга тиешелүү; физикалык кванттык ката деңгээлдери жана кванттык каталарды оңдоонун кошумча жүгү эсепке алынбайт.
Изилдөөнүн маанилүү салымы — мурда симуляциялар аркылуу каралган ийгилик жүрүм-турумун катаал ыктымалдык жана татаалдык чектери менен алмаштыруусу. Алгоритм тартиби белгисиз циклдик топто \(x=g^d\) байланышынын ичиндеги кыска \(d\) маанисин максат кылат. Кванттык бөлүктө эки Fourier үлгүлөө чыгышы \(j\) жана \(k\) түзүлөт, ал эми классикалык бөлүктө бул маанилер эки өлчөмдүү тор маселеси аркылуу \(d\) ни табуу үчүн иштетилет.
Параметрлердин ортосунда ачык чыгым алмашуусу бар. \(\Delta\) чоңойтулганда кванттык компьютерде бааланууга тийиш болгон топтук операциялардын саны азайышы мүмкүн; анын ордуна классикалык издөө мейкиндиги жана post-processing чыгымы өсөт. Изилдөөнүн 2048 биттик коопсуз-жөнөкөй FF-DH мисалында \(\Delta=0\) үчүн берилген 672 кванттык топтук операциядан \(\Delta=50\) тандоосу менен 572 топтук операцияга чейин азайтуу көрсөтүлгөн. Автордун практикалык сыноолору бул болжол менен %15 азайтуу тандалган параметрлерде классикалык post-processing дагы эле ишке жарамдуу бойдон калганда жетишиле турганын билдирет.
Кыска дискреттик логарифм маселеси деген эмне?
Изилдөөдө каралган кыска DLP-де тартиби \(r\) болгон циклдик топтун генератору \(g\) жана
\[ x=g^d \]
мааниси берилет. Максат — \(d\ll r\) шартындагы кыска дискреттик логарифм \(d\) ни эсептөө. Бул изилдөөнүн маанилүү өзгөчөлүгү — топтун тартиби \(r\) алдын ала белгилүү болушу милдеттүү эмес.
\(m\), \(d\) нин бит узундугу үчүн жогорку чек болуп
\[ d<2^m \]
деп алынат. Макала ошондой эле
\[ \ell=m-\Delta \]
параметрин аныктайт. \(\Delta\), кванттык бөлүктүн чыгымы менен кийин жасала турган классикалык издөө ортосундагы алмашууда борбордук роль ойнойт.
Ekerå–Håstad ыкмасы Shor алгоритминен кайсы жагынан айырмаланат?
Shor'дун баштапкы дискреттик логарифм алгоритми тартиби белгилүү циклдик топтордо жалпы дискреттик логарифмдерди караса, бул жерде изилденген Ekerå–Håstad ыкмасы топтун тартиби белгисиз шарттагы кыска логарифмдерди максат кылат.
Изилдөө бул өзгөчөлүк, өзгөчө коопсуз-жөнөкөй топтордо кыска көрсөткүч колдонулган чектүү талаа Diffie–Hellman системалары жана RSA бүтүн санды факторлоону кыска DLP-ге кыскартуу жагынан криптоаналитикалык мааниге ээ экенин белгилейт.
Кванттык алгоритм кандай абалды түзөт?
Алгоритм адегенде \(a\) жана \(b\) маанилеринин үстүндө бирдей суперпозицияларды түзүп, иш регистринде
\[ g^a x^{-b}=g^{a-bd} \]
маанисин эсептейт. QFT алдындагы абал булакта төмөнкүдөй берилет:
\[ \frac{1}{\sqrt{2^{m+2\ell}}} \sum_{a=0}^{2^{m+\ell}-1} \sum_{b=0}^{2^\ell-1} |a,b,g^{a-bd}\rangle . \]
Андан кийин алгачкы эки башкаруу регистрине тиешелүүлүгүнө жараша \(2^{m+\ell}\) жана \(2^\ell\) өлчөмдөгү кванттык Fourier өзгөртүүлөрү (QFT) колдонулат. Башкаруу регистрлери өлчөнгөндө \(j\) жана \(k\) маанилери алынат.
Макаланын аягындагы 1-сүрөт бул схеманы түз көрсөтөт: биринчи башкаруу регистри \(g^a\) түзүлүшүн, экинчи башкаруу регистри \(x^{-b}\) компонентин, ал эми иш регистри алардын топтук операция аркылуу бириктирилишин аткарат. Эки башкаруу регистринде тең QFT жана өлчөө операциялары бар.
Экинчи схема түзүлүшү эмне үчүн маанилүү?
2-сүрөт ошол эле математикалык операцияны кайра иреттеп, адегенде \(j\) ни, андан кийин \(j\) белгилүү болгондо \(k\) ны эсептөөгө болорун көрсөтөт. Бул кайра иреттөө эки башкаруу регистрин бир убакта сактоо зарылдыгын азайтат.
Булакка ылайык стандарттык түзүлүштө эки башкаруу регистринин жалпы өлчөмү \(m+2\ell\) qubit болсо, операцияларды кайра иреттөө менен бир убакта керектелүүчү башкаруу мейкиндиги \(m+\ell\) qubitке чейин азайтылат. Макала ошондой эле жарым-классикалык QFT жана башкаруу qubitин кайра колдонуу менен эки башкаруу регистринин функциясын бир гана кайра колдонулуучу башкаруу qubitи аркылуу аткарууга болорун түшүндүрөт; бул оптималдаштыруу негизги анализдин темасы эмес, схема ишке ашырылышына байланышкан эскертүү катары берилет.
Кванттык бөлүктөгү негизги чыгым эмне?
Изилдөөдө кванттык чыгымдын негизги компоненти эки даражага көтөрүү операциясы катары каралат. Бир иштетүүдө бааланууга тийиш болгон топтук операциялардын саны
\[ m+2\ell \]
болуп, \(\ell=m-\Delta\) болгондуктан:
\[ m+2\ell=3m-2\Delta. \]
Демек, \(\Delta=0\) учурда чыгым \(3m\) топтук операция масштабына барабар. \(\Delta\) ны чоңойтуу кванттык операциялардын санын азайтат; бирок кийинки бөлүмдөрдө көрсөтүлгөндөй, классикалык издөө чыгымын жогорулатат.
\(j\) жана \(k\) өлчөөлөрү логарифм тууралуу маалыматты кантип алып жүрөт?
Изилдөө өлчөөнүн натыйжасында алынган жуп үчүн
\[ \alpha_d=\alpha(j,k) =\{dj+2^mk\}_{2^{m+\ell}} \]
жана ага туура келген
\[ \theta_d= \frac{2\pi\alpha_d}{2^{m+\ell}} \]
бурчун аныктайт. Бул жердеги \(\{u\}_n\), \(u\) нун modulo \(n\) боюнча борборлоштурулган интервалга келтирилген маанисин билдирет.
Далилдин маанилүү бөлүктөрүнүн бири \(j\) нин
\[ [0,2^{m+\ell}) \]
аралыгындагы бүтүн сандардын арасынан бирдей бөлүштүрүү менен тандаларын көрсөтүү. Схеманы ишке ашырууда \(j\) биринчи эсептелиши мүмкүн; андан кийин \(k\), берилген \(j\) шартында кванттык ыктымалдык бөлүштүрүүгө ылайык өлчөнөт.
\(\tau\)-good жуп деген эмне?
Классикалык post-processing ийгиликтүү иштеши үчүн автор төмөнкү аныктаманы колдонот. \((j,k)\) жуп
\[ \left| \{dj+2^mk\}_{2^{m+\ell}} \right| \leq 2^{m+\tau} \]
шартын аткарса, \(\tau\)-good деп аталат. Бул жерде
\[ \tau\in[0,\ell]\cap\mathbb Z. \]
\(\tau\) чоңойгондо “жакшы” деп эсептелген өлчөө натыйжаларынын аймагы кеңейет жана ошого жараша ийгиликтүү өлчөө алуу ыктымалдыгы жогорулайт; анын ордуна классикалык тор издөө камтууга тийиш болгон аймак да чоңоюшу мүмкүн.
\(\tau\)-good жуптун ыктымалдыгы үчүн кандай чек далилденет?
Lemma 1 туруктуу \(j\) үчүн өлчөнгөн \(k\) нын \(\tau\)-good жуп түзүү ыктымалдыгын төмөндөн чектейт:
\[ P_{\tau\text{-good}} \geq 1-\psi'(2^\tau) \]
жана trigamma функциясы үчүн колдонулган жогорку чек аркылуу
\[ P_{\tau\text{-good}} > 1- \frac{1}{2^\tau} - \frac{1}{2\cdot2^{2\tau}} - \frac{1}{6\cdot2^{3\tau}}. \]
Бул эксперименттик ийгилик пайызы эмес. Бул кванттык алгоритмдин математикалык ыктымалдык бөлүштүрүүсүнөн чыгарылган аналитикалык төмөнкү чек.
Тор эмне үчүн классикалык post-processingтин борборунда?
Изилдөө өлчөнгөн \(j\) үчүн эки өлчөмдүү
\[ L^\tau(j) = \langle (j,2^\tau), (2^{m+\ell},0) \rangle \]
торун курат.
\((j,k)\) жуп \(\tau\)-good болгондо белгилүү
\[ v= (\{-2^mk\}_{2^{m+\ell}},0) \]
вектору менен \(d\) ни камтыган белгисиз
\[ u= (dj+2^{m+\ell}z,2^\tau d) \]
вектору бири-бирине жакын болот. Изилдөөдө бул жакындык
\[ \|u-v\|<2^{m+\tau}\sqrt 2 \]
түрүндө чектелет.
Ошентип маселе \(v\) тегерегиндеги белгилүү радиустун ичинде \(L^\tau(j)\) торунун ылайыктуу векторун табууга айланат.
\(t\)-balanced тор эмнени билдирет?
Тордун эң кыска нөлдөн башка векторунун нормасы \(\lambda_1\) болсун. Изилдөө
\[ \lambda_1\geq2^{m-t} \]
шартын аткарган \(L^\tau(j)\) торун \(t\)-balanced деп аныктайт.
Lemma 2 боюнча тордун \(t\)-balanced болбой калуу ыктымалдыгы эң көп
\[ 2^{\Delta-2(t-1)-\tau} \]
болгондуктан, \(t\)-balanced болуу ыктымалдыгы үчүн
\[ P_{\mathrm{balanced}} \geq 1-2^{\Delta-2(t-1)-\tau} \]
түрүндөгү төмөнкү чек алынат; терс болушу мүмкүн болгон параметр аймактары негизги теоремада нөл менен чектелет.
Негизги ийгилик ыктымалдыгынын чеги
Theorem 1 жана Theorem 2, \(\tau\)-good жуп жана \(t\)-balanced тор ыктымалдыктарын бириктирет. Натыйжада кыска логарифмди белгиленген классикалык чыгым чегинин ичинде калыбына келтирүүнүн ийгилик төмөнкү чеги
\[ P_{\mathrm{success}} \geq \max\left( 0, 1- \frac{1}{2^\tau} - \frac{1}{2\cdot2^{2\tau}} - \frac{1}{6\cdot2^{3\tau}} \right) \max\left( 0, 1-2^{\Delta-2(t-1)-\tau} \right) \]
түрүндө берилет.
Бул формула изилдөөнүн эң маанилүү жыйынтыгы: ийгилик ыктымалдыгын жогорулатуу менен классикалык post-processing мейкиндигин кеңейтүүнүн ортосундагы байланышты түз математикалык түрдө көрсөтөт.
Биринчи классикалык чечим: meet-in-the-middle
Биринчи post-processing ыкмасы Shanksтин baby-step giant-step ыкмасын эки өлчөмгө кеңейткен детерминисттик meet-in-the-middle издөөсү.
Изилдөө адегенде Lagrange-reduced тор базасын \((s_1,s_2)\) эсептейт. Babai nearest-plane алгоритми менен белгилүү \(v\) векторуна жакын тор чекити \(o\) табылат. Андан кийин издөө \(o\) тегерегиндеги чектелген эки өлчөмдүү аймакка түшүрүлөт.
Theorem 1 үчүн
\[ N= 2^{\Delta+\tau+1} + 2^{\tau+t+2} + 2 \]
аныкталат. Оң бүтүн туруктуу \(c\) үчүн, айрым топ элементтери алдын ала эсептелген шартта керек болгон топтук операциялардын саны эң көп
\[ 2^3c\sqrt N = 8c\sqrt N \]
деп жогору жактан чектелет.
Lookup таблицасында сакталуучу бүтүн сандардын саны болсо эң көп
\[ \frac{8\sqrt N}{c}+3 \]
болот. \(c\) ни көбөйтүү эс тутум колдонулушун азайтат, бирок экинчи издөө баскычындагы ишти көбөйткөн убакыт-эс тутум алмашуусун түзөт.
Экинчи классикалык чечим: random walk жана Gaudry–Schost
Meet-in-the-middle ыкмасында чоң параметрлерде эс тутум негизги чектөөгө айланышы мүмкүн. Ошондуктан изилдөө экинчи чечимди сунуштайт: тор издөөсүн эки өлчөмдүү кыска DLP-ге айландыруу жана Gaudry–Schost алгоритмин Galbraith–Ruprai жакшыртуулары менен колдонуу.
Бул ыкма чоң детерминисттик lookup таблицанын ордуна ыктымалдык random-walk ыкмасын колдонуп, эс тутум керектөөсүн \(O(1)\) топ элементи деңгээлине түшүрөт.
Theorem 2 үчүн
\[ N= 2^{\Delta+\tau+4} + 2^{\tau+t+5} + 5 \]
болуп, идеалдаштырылган моделде эң жакшы, орточо жана эң начар учур үчүн күтүлгөн топтук операциялардын саны
\[ \left(\frac{4}{3}+o(1)\right)\sqrt{\pi N} \]
менен жогору жактан чектелет.
Бул жердеги жыйынтык күтүлгөн татаалдык болуп, Gaudry–Schost анализинин идеалдаштырылган моделине негизделет; детерминисттик абсолюттук иш убактысы катары чечмеленбеши керек.
Verianla Live: Кванттык өлчөөлөрдөн кыска логарифмге чейин
Бул интерактивдүү процесс изилдөөнүн кванттык жана классикалык бөлүктөрүн булакта колдонулган чыныгы операциялык ирет менен көрсөтөт. Жаңы алгоритмдик кадам же булакта жок жыйынтык кошулган эмес.
| Баскыч | Булакта аныкталган операция | Илимий функциясы |
|---|---|---|
| 1. Кыска DLP кириши | \(x=g^d\), \(d<2^m\), топтун тартиби \(r\) белгисиз болушу мүмкүн. | Калыбына келтириле турган кыска логарифм \(d\) аныкталат. |
| 2. Кванттык суперпозиция | \(a\) жана \(b\) регистрлеринде бирдей суперпозиция даярдалып, \(g^{a-bd}\) эсептелет. | Кыска логарифмге байланышкан фазалык маалыматты кванттык абалга коддойт. |
| 3. QFT жана өлчөө | Башкаруу регистрлерине QFT колдонулат; адегенде \(j\), анан \(j\) ге байланышкан \(k\) алынат. | Классикалык post-processing колдончу \((j,k)\) өлчөө жупту түзөт. |
| 4. \(\tau\)-good текшерүүсү | \(|\{dj+2^mk\}_{2^{m+\ell}}|\leq2^{m+\tau}\). | Өлчөө жуп \(d\) ни калыбына келтирүүгө жетиштүү ылайыктуу аймакта экенин аныктайт. |
| 5. Торду куруу | \(L^\tau(j)\) тору курулуп, Lagrange-reduced база эсептелет. | Кыска логарифм маселесин чектелген эки өлчөмдүү тор издөөсүнө айлантат. |
| 6. Жакын чекит | Babai nearest-plane ыкмасы менен \(v\) ге жакын тор чекити \(o\) аныкталат. | Изделүүчү тор аймагын чектейт. |
| 7A. Meet-in-the-middle | Эки өлчөмдүү жалпыланган Shanks издөөсү колдонулат. | Детерминисттик убакыт-эс тутум алмашуусу менен \(d\) изделет. |
| 7B. Random walk | Маселе эки өлчөмдүү кыска DLP-ге айландырылып, Gaudry–Schost ыкмасы колдонулушу мүмкүн. | Lookup таблицасынын чоң эс тутум талабын \(O(1)\) топ элементине чейин түшүрөт. |
| 8. Логарифмди калыбына келтирүү | Ылайыктуу тор векторунун акыркы компонентинен \(d\) эсептелип, \(x=g^d\) шарты менен текшерилет. | Классикалык post-processing аяктайт. |
\(\Delta\), \(\tau\) жана \(t\) параметрлери эмнени өзгөртөт?
| Параметр | Аныктамадагы ролу | Чоңойгондо негизги тенденция |
|---|---|---|
| \(\Delta\) | \(\ell=m-\Delta\) | Квантта керек болгон \(3m-2\Delta\) топтук операцияларды азайтышы мүмкүн; классикалык enumeration чыгымын көбөйтөт. |
| \(\tau\) | \(\tau\)-good өлчөө аймагынын кеңдигин аныктайт. | Good-pair ийгилик төмөнкү чегин жогорулатат; изделүүчү классикалык аймакты кеңейтиши мүмкүн. |
| \(t\) | \(\lambda_1\geq2^{m-t}\) аркылуу \(t\)-balanced тор шартын аныктайт. | Тордун balanced болуу ыктымалдыгы менен enumeration чыгымынын ортосунда алмашуу түзөт. |
Ийгилик ыктымалдыгы канчага чейин көтөрүлүшү мүмкүн?
Изилдөөнүн 1-таблицасы \(\Delta=0\) үчүн классикалык иш жүгү менен далилденген ийгилик төмөнкү чеги кантип өзгөрөрүн ачык көрсөтөт:
| \(\Delta\) | \(\tau\) | \(t\) | Ийгилик ыктымалдыгынын төмөнкү чеги | Иштин жогорку чеги, \(\log_2\) |
|---|---|---|---|---|
| 0 | 4 | 2 | \(\geq0{,}9\) | \(\leq7{,}1\) |
| 0 | 7 | 2 | \(\geq0{,}99\) | \(\leq8{,}6\) |
| 0 | 11 | 1 | \(\geq0{,}999\) | \(\leq10{,}2\) |
| 0 | 21 | 1 | \(\geq1-10^{-6}\) | \(\leq15{,}2\) |
| 0 | 27 | 2 | \(\geq1-10^{-8}\) | \(\leq18{,}6\) |
| 0 | 34 | 2 | \(\geq1-10^{-10}\) | \(\leq22{,}1\) |
Бул маанилер эксперименттик байкоо көрсөткүчтөрү эмес. Theorem 1ден алынган кепилденген математикалык төмөнкү жана жогорку чектердин тандалган параметр комбинациялары.
\(\Delta\) чоңойгондо эмне болот?
1-таблица жана 2-таблица бирге каралганда негизги тенденция ачык: бирдей максаттуу ийгилик ыктымалдыгы сакталган учурда \(\Delta\) чоңойгон сайын классикалык enumeration чыгымы кыйла өсөт.
Мисалы \(1-10^{-10}\) ийгилик төмөнкү чеги үчүн:
| \(\Delta\) | \(\tau\) | \(t\) | Ийгилик төмөнкү чеги | Иштин жогорку чеги, \(\log_2\) |
|---|---|---|---|---|
| 0 | 34 | 2 | \(\geq1-10^{-10}\) | \(\leq22{,}1\) |
| 20 | 34 | 12 | \(\geq1-10^{-10}\) | \(\leq30{,}6\) |
| 50 | 34 | 27 | \(\geq1-10^{-10}\) | \(\leq45{,}6\) |
| 80 | 34 | 42 | \(\geq1-10^{-10}\) | \(\leq60{,}6\) |
| 130 | 34 | 67 | \(\geq1-10^{-10}\) | \(\leq85{,}6\) |
Ошондуктан кванттык чыгымды азайтуу үчүн \(\Delta\) ны тынымсыз чоңойтуу акысыз оптималдаштыруу эмес. Кванттык эсептөө азайганы менен классикалык эсептөө жана meet-in-the-middle колдонулса эс тутум талабы тез өсөт.
FF-DH мисалдарында кванттык операциялардын саны кандай өзгөрөт?
Изилдөөнүн 3-таблицасы коопсуз-жөнөкөй FF-DH топтору үчүн Ekerå–Håstad алгоритминин кванттык топтук операциялар санын
\[ o_{\mathrm{EH}}=3m-2\Delta \]
түрүндө колдонот. 2048 биттик коопсуз-жөнөкөй жана \(m=224\) биттик кыска көрсөткүч мисалында булак төмөнкү маанилерди берет:
| \(\Delta\) | \(\tau\) | \(t\) | Ийгилик төмөнкү чеги | Классикалык иш, \(\log_2\) | Кванттык топтук операция |
|---|---|---|---|---|---|
| 0 | 34 | 2 | \(\geq1-10^{-10}\) | \(\leq22{,}1\) | 672 |
| 50 | 10 | 29 | \(\geq0{,}999\) | \(\leq33{,}6\) | 572 |
| 70 | 7 | 37 | \(\geq0{,}99\) | \(\leq42{,}1\) | 532 |
\(\Delta=50\) мисалы 672ден 572 кванттык топтук операцияга өтүү дегенди билдирет. Изилдөөнүн өз баалоосу боюнча бул болжол менен %15 кванттык топтук операция азайышы. Мунун ордуна классикалык иштин жогорку чеги \(\log_2\) өлчөмүндө 22,1ден 33,6га чейин өсөт.
Автор оптималдаштырылган параллелдүү ишке ашыруунун алгачкы сыноолорунда \(\Delta=50\) жана кеминде %99 ийгилик максатында кадимки компьютерде post-processing жүргүзүү адатта көйгөй жаратпаганын билдирет. Бул билдирүү практикалык тажрыйбага негизделген байкоо болуп, изилдөөнүн математикалык теоремасынан өзүнчө берилген.
RSA жагынан изилдөө эмне дейт?
Изилдөө RSA бүтүн санды факторлоо маселесин кыска DLP-ге кыскартуу аркылуу ошол эле ийгилик анализин RSAга колдонууга болорун карайт. Бирок бул жерде кошумча шарт бар: туш келди тандалган \(g\) жетиштүү чоң тартипке ээ болушу керек.
RSA үчүн 4-таблица бул кошумча ыктымалдык азайтуу факторун \(f(\Delta)\) менен эсепке алат. Мисалы \(\Delta=20\) үчүн булак азайтуу факторун кеминде
\[ f(20)\geq0{,}999867 \]
деп колдонот. Ушул эле параметр үй-бүлөсүндө:
| \(\Delta\) | \(\tau\) | \(t\) | Жалпы ийгилик төмөнкү чеги | Классикалык иш, \(\log_2\) |
|---|---|---|---|---|
| 20 | 4 | 12 | \(\geq0{,}9\) | \(\leq15{,}6\) |
| 20 | 5 | 12 | \(\geq0{,}95\) | \(\leq16{,}1\) |
| 20 | 7 | 12 | \(\geq0{,}99\) | \(\leq17{,}1\) |
| 20 | 11 | 12 | \(\geq0{,}999\) | \(\leq19{,}1\) |
Бул таблица азыркы физикалык кванттык компьютерде RSA ачкычы көрсөтүлгөн сандагы операциялар менен бузулат дегенди билдирбейт. Изилдөө бул жерде алгоритмдик ийгилик ыктымалдыгын жана классикалык enumeration чыгымын талдайт; физикалык qubit, ката оңдоо, дарбаза катасы жана жалпы реалдуу иш убактысы эсепке кирбейт.
Асимптотикалык жыйынтык эмне үчүн маанилүү?
Corollary 1 маселенин өлчөмү \(m\) чексиздикке кеткенде \(\Delta\), \(\tau\) жана \(t\) ни \(m\) ге жараша тандоо менен ийгилик ыктымалдыгынын төмөнкү чегин бирге жакындатууга болорун, ошол эле учурда классикалык enumeration татаалдыгын
\[ O(\mathrm{poly}(m)) \]
чегинде кармоого болорун көрсөтөт.
Мисалы, изилдөө \(\Delta\) жана \(t\) ни туруктуу кармап
\[ \tau=\log_2 f(m) \]
деп тандоо ылайыктуу супер-туруктуу, бирок полином менен чектелген \(f(m)\) үчүн бул жыйынтыкты камсыздай аларын түшүндүрөт.
Изилдөө колдогон жыйынтыктар
- Ekerå–Håstad кыска DLP алгоритминин бир иштетүүдөгү ийгилик ыктымалдыгы үчүн симуляцияга таянбаган катуу төмөнкү чектер алынат.
- Ылайыктуу классикалык post-processing параметрлери менен ийгилик ыктымалдыгынын төмөнкү чеги \(1-10^{-10}\) деңгээлине чейин көтөрүлөт.
- Meet-in-the-middle издөөсү чектелген тор enumeration маселесин детерминисттик түрдө тездетет.
- Gaudry–Schost негизиндеги random-walk ыкмасы ушул издөө маселесинин эс тутум талабын \(O(1)\) топ элементине чейин түшүрө алат.
- \(\Delta\) ны чоңойтуу квантта керек болгон топтук операцияларды азайтат, бирок классикалык post-processing чыгымын көбөйтөт.
- Анализ коопсуз-жөнөкөй кыска көрсөткүчтүү FF-DH сценарийлерине түз, RSAга болсо кыска DLP кыскартуу аркылуу колдонулат.
- Параметрлер маселенин өлчөмүнө ылайык масштабдалганда ийгилик төмөнкү чеги асимптотикалык түрдө бирге жакындап, классикалык post-processing полином убакытта кала алат.
Изилдөө далилдебеген жыйынтыктар
- Изилдөө реалдуу кванттык компьютерде RSA же FF-DH бузуу экспериментин жүргүзбөйт.
- Теориялык ийгилик ыктымалдыгы физикалык кванттык жабдуунун ката кетирбөө ыктымалдыгы эмес.
- Анализ кванттык каталарды оңдоо жүгүн же физикалык qubit чыгымын эсептебейт.
- Топтук операциялардын санын түздөн-түз секунд, кванттык дарбаза же физикалык qubit саны менен теңештирүүгө болбойт.
- Random-walk ыкмасы үчүн берилген татаалдык идеалдаштырылган моделдеги күтүлгөн татаалдык.
- \(\Delta\) ны чоңойтуу бардык чыгымды азайтпайт; классикалык убакыт жана/же эс тутум чыгымы өсөт.
- RSA колдонмосунда кыска DLP кыскартуунун кошумча тартип шарты жана ага байланышкан ийгилик азайтуу фактору көңүл сыртында калтырылбашы керек.
Изилдөөнүн методу жана табылгалары
Изилдөө дизайны
Бул эксперименттик кванттык жабдуу изилдөөсү эмес, теориялык криптография жана кванттык алгоритмдер тармагындагы математикалык ийгилик ыктымалдыгы жана татаалдык анализи. Изилдөөнүн негизги максаты — мурдагы симуляцияга негизделген ийгилик баасын далилденген төмөнкү чектер менен алмаштыруу.
Анализ төрт негизги баскычта жүргүзүлөт:
- Кванттык алгоритмдин \((j,k)\) өлчөө бөлүштүрүүсү талданат.
- \((j,k)\) жуптун \(\tau\)-good болуу ыктымалдыгы төмөндөн чектелет.
- \(L^\tau(j)\) торунун \(t\)-balanced болуу ыктымалдыгы төмөндөн чектелет.
- Бул эки окуя ишке ашканда \(d\) ни калыбына келтире турган классикалык enumeration операциясынын чыгымы жогору жактан чектелет.
Lemma 1дин ролу
Lemma 1 белгилүү \(j\) үчүн өлчөнгөн \(k\) нын ылайыктуу фаза аймагына түшүү ыктымалдыгын талдайт. Далилде ыктымалдык бөлүштүрүүнүн оң жана терс куйруктары өз-өзүнчө жогору жактан чектелет. Тригонометриялык чектер жана trigamma функциясы колдонулуп, жалпы куйрук ыктымалдыгы көзөмөлдөнөт.
Жыйынтык:
\[ P_{\tau\text{-good}} > 1- 2^{-\tau} - \frac{1}{2}2^{-2\tau} - \frac{1}{6}2^{-3\tau}. \]
Lemma 2нин ролу
Экинчи ыктымалдык компоненти тор геометриясынан келет. Эң кыска нөлдөн башка вектор өтө кыска болсо, enumeration аймагын көзөмөлдөө кыйындайт, ошондуктан \(t\)-balanced шарты колдонулат.
Тордун фундаменталдык аймагы үчүн
\[ \lambda_1\lambda_2^\perp = 2^{m+\ell+\tau} \]
байланышын жана \(j\) нин бирдей бөлүштүрүлүшүн колдонуу менен
\[ P(L^\tau(j)\text{ balanced değil}) \leq 2^{\Delta-2(t-1)-\tau} \]
чеги алынат.
Meet-in-the-middle enumeration кантип чектелет?
Lagrange-reduced база жана Babai nearest-plane жыйынтыгы аркылуу издөө эки индекс \(m_1\) жана \(m_2\) менен чектелген тик бурчтуу индекс аймагына түшүрүлөт. Изилдөө бул аймактын өлчөмдөрүн \(B_1\) жана \(B_2\) менен чектейт.
Shanks ыкмасынын эки өлчөмдүү жалпыланышы бардык \((2B_1+1)(2B_2+1)\) талапкерлерди бирден текшерүүнүн ордуна издөө процессин эки бөлүккө бөлөт. Биринчи бөлүк lookup таблицасына жазылат, экинчи бөлүк таблицадагы дал келүүлөрдү издейт.
Бул түзүлүш талапкерлердин санына болжол менен квадраттык тамыр көз карандылыгын берген meet-in-the-middle тездетүүсүнүн негизи.
Random-walk чечими кайсы чектөөнү жоёт?
Meet-in-the-middle ыкмасында lookup таблица чоңойгон сайын эс тутум тар жерге айланат. Ошондуктан изилдөө enumeration маселесин
\[ g_1^{i_1}g_2^{i_2}=x' \]
түрүндөгү эки өлчөмдүү кыска DLP катары кайра жазат.
Бул маселе Gaudry–Schost алгоритми жана Galbraith–Ruprai жакшыртуусу менен чечилгенде чоң lookup таблица керексиз болуп калат. Натыйжада эс тутум керектөөсү асимптотикалык түрдө \(O(1)\) топ элементине чейин түшүрүлөт.
1-таблица жана 2-таблицанын негизги билдирүүсү
1-таблица жана 2-таблица \(\Delta\), \(\tau\) жана \(t\) өзгөргөндө ийгилик төмөнкү чеги менен классикалык enumeration жогорку чеги кандай өзгөрөрүн көрсөтөт. Эң ачык тенденция — \(\Delta\) чоңойгон сайын бирдей ийгилик деңгээлине жетүү үчүн талап кылынган классикалык иш тез өсөт.
Мисалы %99 ийгилик төмөнкү чегинде “Work” мааниси \(\Delta=0\) үчүн эң көп 8,6 болсо, \(\Delta=50\) үчүн 32,1; \(\Delta=100\) үчүн 57,1 жана \(\Delta=130\) үчүн 72,1 деп берилет. “Work” маанилери түз операциялардын саны эмес, булакта аныкталган топтук операция жогорку чегинин \(\log_2\) көрсөтүлүшү.
3-таблицанын негизги билдирүүсү
FF-DH таблицасы кванттык жана классикалык чыгым алмашуусун реалдуу криптографиялык параметрлер аркылуу ачык көрсөтөт. Таблицада 2048, 3072, 4096, 6144 жана 8192 биттик коопсуз-жөнөкөй топтор үчүн кыска көрсөткүч узундуктары берилет жана Ekerå–Håstad алгоритминин кванттык топтук операциялар саны өзгөртүлгөн Shor ыкмасы менен салыштырылат.
Мисалы 4096 биттик коопсуз-жөнөкөй, \(m=304\) биттик кыска көрсөткүч мисалында:
- \(\Delta=0\): 912 кванттык топтук операция, артыкчылык 9,0.
- \(\Delta=50\): 812 кванттык топтук операция, артыкчылык 10,0.
- \(\Delta=70\): 772 кванттык топтук операция, артыкчылык 10,5.
Бирок бул артыкчылыктын өсүшү классикалык post-processing чыгымынын өсүшү менен бирге бааланышы керек.
4-таблицанын негизги билдирүүсү
RSA таблицасы кыска DLP алгоритминин ийгилик чегин гана эмес, RSA кыскартуусунда тандалган топ элементинин жетиштүү чоң тартипке ээ болбой калуу ыктымалдыгын да эсепке алат. Ошондуктан FF-DH таблицасынан айырмаланып, кошумча \(f(\Delta)\) азайтуу фактору бар.
Изилдөө \(\Delta\) чоңойгон сайын бул фактор бирге жакындай турганын, бирок колдонулган аналитикалык төмөнкү чек ыкмасынын эсептөө чыгымы \(\Delta\) менен тез өсөрүн белгилейт. Ушундан улам таблицада өтө жогорку ийгилик максаттары үчүн бардык маанилер берилген эмес.
Алгоритмдер практикада сыналганбы?
Автор макаладагы Algorithm 1 жана Algorithm 2 post-processing ыкмаларын ишке ашырганын жана симуляцияланган кванттык алгоритм чыгыштарын иштетүү аркылуу алар күтүлгөндөй иштегенин тастыктаганын билдирет.
Ошондой эле оптималдаштырылган жана параллелдештирилген алгачкы практикалык сыноолор \(\Delta=50\) үчүн, кеминде %99 ийгилик максатында, кадимки компьютерде post-processing жүргүзүү адатта көйгөй болбогонун көрсөткөнү айтылат. Изилдөө бул ишке ашырууну оптималдаштыруу жана мындан ары параллелдештирүү иштери уланып жатканын да так билдирет.
1-сүрөт жана 2-сүрөттүн илимий билдирүүсү
1-сүрөт \(m+\ell\) qubitтик биринчи жана \(\ell\) qubitтик экинчи башкаруу регистрин, \(g^a\) жана \(x^{-b}\) башкарылуучу топтук операцияларды, QFT блокторун жана \(j,k\) өлчөөлөрүн бир схемада көрсөтөт.
2-сүрөт математикалык жактан эквиваленттүү схеманы убакыт ирети боюнча кайра түзөт. Биринчи башкаруу регистринин QFT жана өлчөөсү \(g^a\) операциясынан дароо кийин жүргүзүлөт, ал эми экинчи башкаруу регистри кийин даярдалат. Ошентип \(j\) ни биринчи эсептеп, \(k\) ны \(j\) ге байланыштуу кийин алуу Lemma 1дин ыктымалдык анализинде колдонулган түзүлүш менен визуалдык жактан шайкеш келет.
Изилдөөнүн негизги сандык табылгалары
| Табылга | Булакта берилген жыйынтык | Түшүндүрмө чеги |
|---|---|---|
| Мурунку негизги single-run төмөнкү чеги | \(3/32=9{,}375\%\) | Мурунку Ekerå–Håstad анализинен алынган төмөнкү чек. |
| Жаңы теориялык ийгилик деңгээли | \(1-10^{-10}\) чейин | Ылайыктуу параметрлер жана классикалык издөө чектери менен алынган математикалык төмөнкү чек. |
| Кванттык топтук операция | \(m+2\ell=3m-2\Delta\) | Логикалык топтук операциялардын саны; физикалык дарбаза саны эмес. |
| Meet-in-the-middle чыгымы | \(\leq8c\sqrt N\) | Theorem 1 шарттары жана алдын ала эсептөөлөр астында. |
| Random-walk чыгымы | \(\leq(4/3+o(1))\sqrt{\pi N}\) | Идеалдаштырылган моделдеги күтүлгөн чыгым. |
| 2048 бит FF-DH, \(\Delta=50\) | 572 кванттык топтук операция | 3-таблицадагы \(m=224,\tau=10,t=29\) жана \(\geq0{,}999\) ийгилик төмөнкү чеги үчүн. |
| 2048 бит FF-DH баштапкы салыштыруу | 672 кванттык топтук операция | \(\Delta=0\) параметрлештирүүсү. |
Изилдөөнүн негизги күчтүү жактары
- Мурда симуляция менен бааланган single-run ийгилик жүрүм-турумун аналитикалык төмөнкү чектер менен бекемдеши.
- Кванттык чыгым менен классикалык post-processing чыгымын бир эле параметр үй-бүлөсүндө чогуу баалашы.
- Ийгилик ыктымалдыгынан тышкары классикалык enumeration татаалдыгын да ачык жогорку чек менен бериши.
- Убакыт-эс тутум алмашуусу бар детерминисттик жана аз эс тутумдуу ыктымалдык болуп эки өзүнчө post-processing ыкмасын сунушташы.
- FF-DH жана RSA кыскартуусу үчүн өзүнчө параметр таблицаларын бериши.
- Post-processing алгоритмдеринин симуляцияланган кванттык чыгыштарда ишке ашырылып текшерилген болушу.
Изилдөөнүн негизги чектөөлөрү
- Негизги математикалык анализ кванттык компьютер алгоритмди математикалык аныктамасына ылайык жана эсептөө катасы жок иштетет деп болжолдойт.
- Кванттык ката оңдоонун физикалык жана эсептөө жүгү анализге киргизилген эмес.
- Анализ логикалык кванттык схемалар жана логикалык чыгымдар менен чектелет.
- Кыска DLP анализи \(r\geq2^{m+\ell}+(2^\ell-1)d\) түрүндөгү кыскалык шартын колдонот; RSA учурда бул шарт кошумча ыктымалдык факторун талап кылат.
- Gaudry–Schost ыкмасы үчүн берилген иш көлөмү идеалдаштырылган моделдеги күтүлгөн мааниге туура келет.
- Чоң \(\Delta\) маанилеринде meet-in-the-middle post-processingтин эс тутум талабы практикалык колдонулушун чектеши мүмкүн.
- Оптималдаштырылган параллелдүү post-processing ишке ашыруусуна байланышкан жыйынтыктар алгачкы мүнөздө жана автор дагы оптималдаштыруу иштери уланып жатканын белгилейт.
Булак жана метод эскертүүсү
Толук түпнуска иштин аталышы: On the success probability of the quantum algorithm for the short DLP
Автор: Martin Ekerå.
Авторлордун саны: Бир.
Биргелешкен биринчи автор/биргелешкен салым: Колдонулбайт; иш бир авторлуу.
Жооптуу автор: Булакта өзүнчө “corresponding author” белгиси колдонулган эмес. Martin Ekerå үчүн байланыш электрондук почтасы берилген.
Аффилиациялар: KTH Royal Institute of Technology, Stockholm, Sweden; Swedish NCSA, Swedish Armed Forces, Stockholm, Sweden.
Журнал: IACR Communications in Cryptology.
Том / номер: 3 / 1.
ISSN: 3006-5496.
Барак саны: 32 барак.
DOI: 10.62056/an2isgsfg
Расмий жарыя шилтемеси: https://doi.org/10.62056/an2isgsfg
Жарыялоочу / жарыя уюму: International Association for Cryptologic Research (IACR).
Булак түрү: Рецензияланган изилдөө макаласы.
Рецензия статусу: Рецензияланган журналда жарыяланган иш. IACR Communications in Cryptology толук рецензияланган журнал болуп, анын расмий саясаты double-blind peer review колдонуларын билдирет.
Тапшыруу датасы: 2-февраль 2026.
Кабыл алуу датасы: 23-апрель 2026.
Жарыя датасы: 4-май 2026.
Preprint байланышы: Иштин мурунку версиялары arXiv:2309.01754 астында жарыяланган. arXiv жазуусу акыркы журналдык жарыяга жана DOI 10.62056/an2isgsfg дарегине шилтеме берет. Бул Verianla макаласындагы илимий баяндоо колдонуучу жүктөгөн жарыяланган 32 барактык версияга негизделет.
Лицензия: Creative Commons Attribution 4.0 (CC BY 4.0). Автордук укук автор(лор)до калат.
Каржылоо жана колдоо: Изилдөөдө каржылоо жана колдоо Swedish NCSA тарабынан берилгени; Swedish NCSA Swedish Armed Forces курамында экени айтылат. Эсептөөлөр ошондой эле Swedish Research Council grant agreement no. 2022-06725 менен жарым-жартылай каржыланган National Academic Infrastructure for Supercomputing in Sweden (NAISS) алкагында KTH PDC ресурстарында жүргүзүлгөн.
Ыраазычылык: Автор Johan Håstadка комментарий жана кеңештери үчүн, Joel Gärtnerге болсо алгачкы preprint версиясындагы Lemma 3 көйгөйүнө көңүл бурганы үчүн ыраазычылык билдирет.
Маалымат жана программалык камсыздоо эскертүүсү: Изилдөө эксперименттик маалымат топтомуна негизделбейт. Автор post-processing алгоритмдерин ишке ашырганын жана симуляцияланган кванттык алгоритм чыгыштары менен текшергенин билдирет. Макалада жеткиликтүү, бирок оптималдаштырылбаган Algorithm 1 ишке ашыруусу жана симулятор үчүн Quaspy программалык репозиторийине шилтеме бар.
Кызыкчылыктардын кагылышы: Жүктөлгөн иште өзүнчө кызыкчылыктардын кагылышы бөлүмү табылган эмес.
Автор салымдары: Иш бир авторлуу жана өзүнчө CRediT салым билдирүүсү берилген эмес.
Негизги метод: Ekerå–Håstad кыска DLP кванттык алгоритминин өлчөө бөлүштүрүүсүн аналитикалык чектөө; эки өлчөмдүү тор анализи; Lagrange reduction жана Babai nearest-plane ыкмасы; meet-in-the-middle enumeration; эки өлчөмдүү кыска DLPге кыскартуу жана Gaudry–Schost/Galbraith–Ruprai random-walk анализи.
Илимий мазмун чеги: Бул Verianla макаласындагы алгоритмдик механизмдер, формулалар, сандык таблицалар, FF-DH жана RSA жыйынтыктары, ишке ашыруу байкоолору жана чектөөлөр жүктөлгөн булак ишке негизделет. Тышкы булактар иштин идентификаторун, жарыя датасын, журнал статусун, DOI, лицензия жана preprint-жарыя байланышын библиографиялык текшерүү үчүн гана колдонулган; PDFден тышкаркы жаңы илимий табылга кошулган эмес.
Эң маанилүү түшүндүрмө чеги: Изилдөөнүн ийгилик ыктымалдыгы жана чыгым чектери логикалык кванттык алгоритмге тиешелүү. Физикалык жабдуу каталары, кванттык ката оңдоо жана алардын кошумча физикалык ресурс чыгымдары бул анализде камтылган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген