

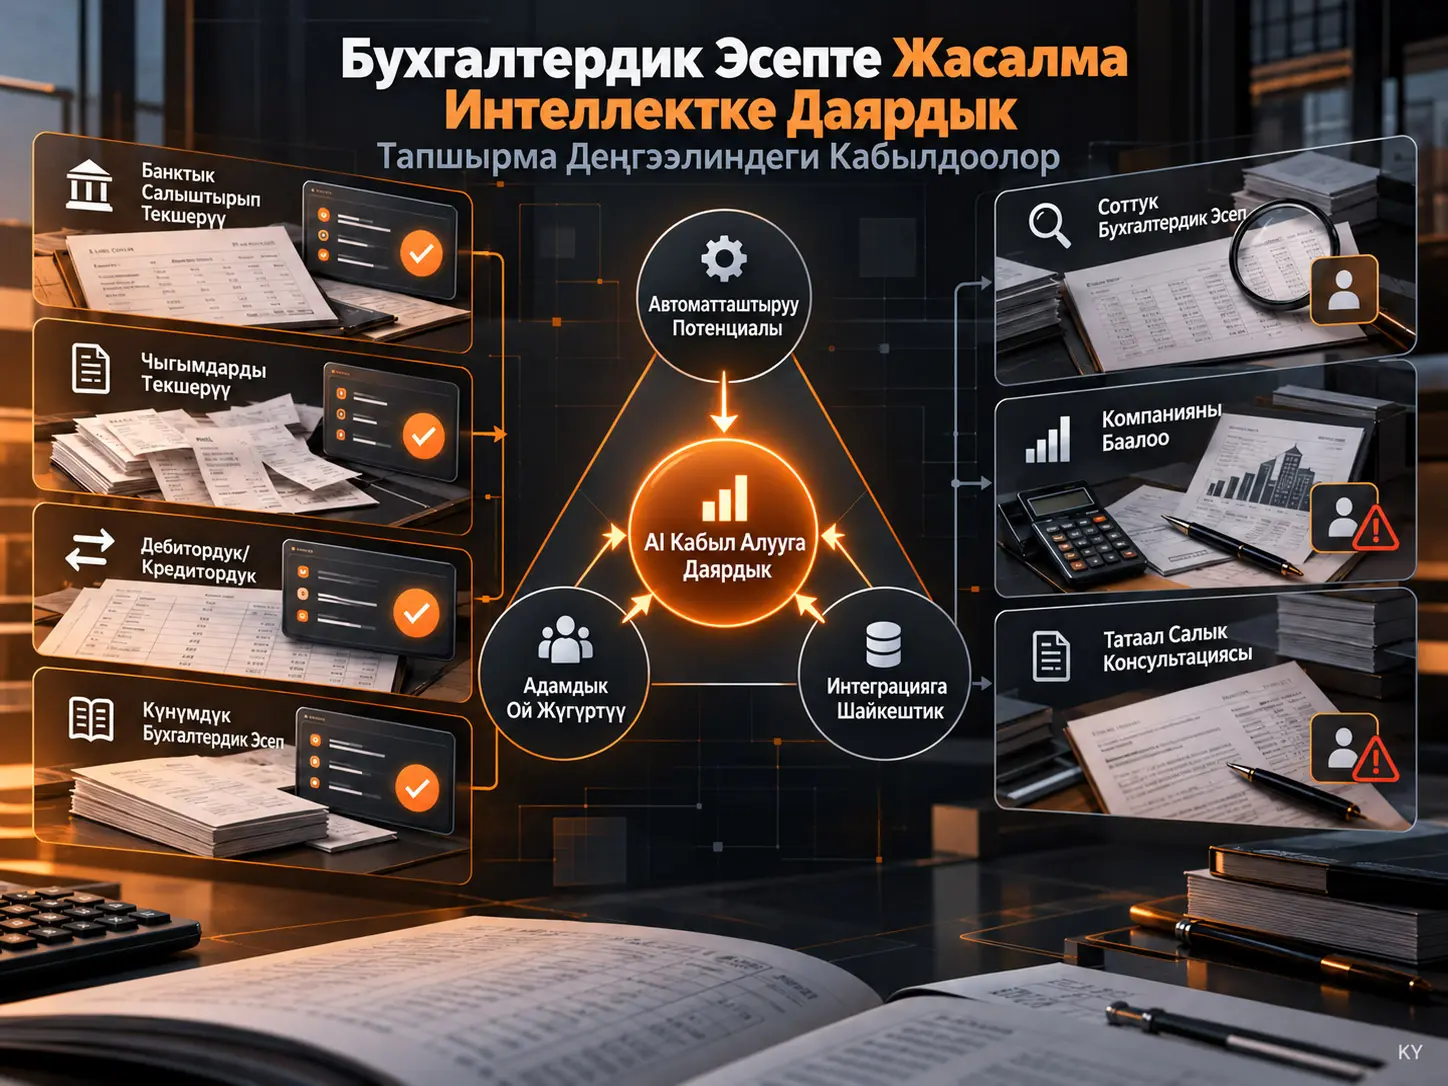
Тапшырма деңгээлинде жасалма интеллектти кабыл алууга даярдык (Adoption Readiness, AR) — бухгалтердик адис белгилүү бир ишти аткарууда AI колдоосу жеткиликтүү болгондо аны колдонууга канчалык даяр экенин билдирген 1–5 шкаласындагы жүрүм-турумдук ниет өлчөмү. Wil Martensтин изилдөөсү Тайвандагы 24 бухгалтердик адистин 24 өкүлчүлүктүү бухгалтердик тапшырманы баалоосунан түзүлгөн 576 тапшырма деңгээлиндеги байкоонун негизинде бул даярдык кайсы тапшырма мүнөздөмөлөрү менен байланыштуу экенин изилдейт. Негизги ordered logistic regression жыйынтыктарында автоматташтыруу потенциалы жана учурдагы иш агымына интеграциялоонун жеңилдиги AI колдонууга жогорку даярдык менен оң байланышкан, ал эми GPT тутумдары менен буга чейинки көбүрөөк тажрыйба төмөн даярдык менен байланышкан. Адамдык ой жүгүртүүнүн зарылдыгынын коэффициенти терс багытта, бирок булак текстинде p = 0,160 деп берилгендиктен, бул статистикалык жактан такталган байланыш эмес.
Изилдөөнүн негизги сунушу — бухгалтердик эсепте AI кабыл алууну технологиянын канчалык күчтүү же натыйжалуу экени менен гана түшүндүрүүгө болбойт. Тапшырманы текшерүүгө мүмкүн болушу, натыйжанын булагын көзөмөлдөөгө мүмкүн болушу, reviewer sign-off механизминин болушу жана AI натыйжасын учурдагы көзөмөл процессине негиздүү түрдө жайгаштырууга мүмкүн болушу да кабыл алууга даярдык менен байланыштуу. Автор бул түзүлүштү task-governance fit, башкача айтканда, тапшырма менен башкаруу инфраструктурасынын шайкештиги алкагында талкуулайт.
Бирок изилдөө AIны чыныгы колдонууну, ката ченин, чыгым үнөмдөөнү же иш натыйжалуулугун өлчөбөйт. Катышуучулар чакан, максаттуу тандалган expert panel болуп саналат, ал эми жыйынтык өзгөрмөсү чыныгы колдонуу жүрүм-туруму эмес, билдирилген колдонуу каалоосу. Ошондуктан табылгалар теорияны өнүктүрүүчү жана гипотеза жаратуучу байланыштар катары чечмеленүүгө тийиш; жалпы бухгалтерлер калкы үчүн так же себептик жыйынтыктар катары каралбашы керек.
Изилдөөнүн негизги көйгөйү
Жасалма интеллект тутумдарын бухгалтердик иштерде техникалык жактан колдонууга мүмкүн болушу бухгалтерлер бул тутумдарга бирдей деңгээлде ишенет дегенди билдирбейт. Банктык салыштырып текшерүү, чыгымдарды текшерүү же дебитордук-кредитордук эсептерди иштетүү сыяктуу көнүмүш тапшырмалар менен соттук бухгалтердик эсеп, компанияны баалоо же татаал аудиттик баалоолор бирдей кесиптик жоопкерчилик деңгээлине ээ эмес.
Ошондуктан изилдөө талдоо бирдигин “колдонуучудан” “тапшырмага” жылдырат. Адистин AIга жалпы оң же терс мамилесин өлчөөнүн ордуна төмөнкү суроого көңүл бурат: Бир эле адис ар башка бухгалтердик тапшырмаларда AI колдонууга эмне үчүн ар кандай деңгээлде даяр болушу мүмкүн?
Technology Acceptance Model (TAM), Unified Theory of Acceptance and Use of Technology (UTAUT) жана Diffusion of Innovation сыяктуу калыптанган ыкмалар адатта колдонуу жеңилдигине, пайдага, социалдык таасирге же жеке технологиялык даярдыкка басым жасайт. Изилдөө көрсөткөн адабияттагы боштук — жогорку отчеттуулукту талап кылган кесиптерде тапшырмага мүнөздүү текшерилүүчүлүктү, көзөмөлдөнүүчүлүктү жана reviewer approval түзүлүштөрүн бул моделдер жетиштүү камтыбайт деген доомат.
Тапшырма–башкаруу шайкештиги деген эмне?
Тапшырма–башкаруу шайкештиги AI тутумунун белгилүү бир кесиптик тапшырмага техникалык жактан гана колдонулушун эмес, анын натыйжасын көзөмөлдөөгө, текшерүүгө жана учурдагы бекитүү/кароо процесстеринин ичинде кесиптик жактан негиздөөгө мүмкүн болушун билдирет. Бул изилдөөдө өзгөчө Integration Feasibility өзгөрмөсү audit trail, traceability, reviewer sign-off жана approval workflow сыяктуу учурдагы көзөмөл механизмдери AI колдонууну канчалык колдоорун билдирет.
Бул айырма маанилүү. Техникалык жактан жеңил AI колдонмосунда натыйжаны ким текшерери же ката үчүн ким жооп берери белгисиз болсо, интеграцияны ишке ашыруу мүмкүнчүлүгү төмөн болушу мүмкүн. Тескерисинче, соттук бухгалтердик эсеп сыяктуу мазмуну татаал тапшырма күчтүү audit trail жана кароо механизмдеринин аркасында AIнын жардамчы ролун көзөмөлдүү түрдө камтый алат.
Кабылдоонун беш негизги өзгөрмөсү
| Өзгөрмө | Кыргызча түшүндүрмө | Өлчөө | Моделдеги ролу |
|---|---|---|---|
| GPT Exposure | GPT түрүндөгү куралдар менен мурдагы кесиптик тааныштык | 1–5 Likert | Көзөмөл өзгөрмөсү |
| Automation Potential (AP) | Тапшырманын бөлүктөрүн AI менен алмаштырууга мүмкүн болушу | %0–100, талдоодо беш топко айландырылган | Негизги түшүндүрүүчү өзгөрмө |
| Human Judgment Necessity (HJ) | Баамдоо, этикалык чечмелөө жана кесиптик ой жүгүртүү зарылдыгы | 1–5 Likert | Негизги түшүндүрүүчү өзгөрмө |
| Task Complexity (TC) | Тапшырманын билим чөйрөсүнүн кеңдиги жана контексттик татаалдыгы | 1–10, талдоодо 1–5ке масштабдалган | Контексттик өзгөрмө |
| Integration Feasibility (IC) | AIны учурдагы кароо жана көзөмөл процессине жайгаштырууга мүмкүн болушу | 1–5 интеграция чыгымы; тескери коддолгон | Негизги түшүндүрүүчү өзгөрмө |
| Adoption Readiness (AR) | Белгилүү тапшырмада AI жардамын колдонуу каалоосу | 1–5 иреттик шкала | Көз каранды өзгөрмө |
Adoption Readiness кандайча суралган?
Катышуучуларга маңызы боюнча мындай жүрүм-турумдук ниет суроосу берилген: азыркы ролунда тиешелүү тапшырма үчүн AI жардамы берилсе, аны колдонууга канчалык даяр болмок? Жооп 1 = strongly unwilling ден 5 = strongly willing ге чейин өлчөнгөн.
Бул өлчөө чыныгы жүрүм-турумду эмес, колдонуу ниетин билдирет. Катышуучунун AR = 5 деп жооп бериши AI тутумун чыныгы иште колдонгонун же тутум ишенимдүү натыйжа бергенин көрсөтпөйт.
Үч негизги гипотеза
H1: Жогорку Automation Potential жогорку Adoption Readiness менен байланыштуу.
H2: Жогорку Human Judgment Necessity төмөн Adoption Readiness менен байланыштуу.
H3: Жогорку Integration Feasibility жогорку Adoption Readiness менен байланыштуу.
Task Complexity негизги моделден чыгарылган; анткени булакта ал HJ менен жогорку коллинеардуулукту көрсөткөнү айтылат. Негизги баяндама жана моделдөө бөлүмүндө бул жүйө r = 0,74 деп берилсе, жарыяланган Spearman Table 3тө HJ–TC коэффициенти 0,65. Бул эки булак мааниси өз-өзүнчө контекстте билдирилиши керек.
Изилдөөгө кимдер катышкан?
| Өзгөчөлүк | Бөлүштүрүү |
|---|---|
| CPA | 8 адам |
| Башкаруу | 8 адам |
| Бухгалтердик кызматкер | 4 адам |
| Бухгалтердик эсеп боюнча окутуучу | 4 адам |
| 0–5 жыл тажрыйба | 4 адам |
| 6–20 жыл тажрыйба | 16 адам |
| 20+ жыл тажрыйба | 4 адам |
| Кийинки маек | 20 адам |
Катышуучулар каржы жана банк иши, технология, меймандостук жана бухгалтердик билим берүү чөйрөлөрүнөн келишкен. Тандоо максаттуу жана referral-based ыкмалар менен жүргүзүлгөн; максат статистикалык калктын өкүлчүлүгү эмес, кесиптик ролдордун жана тажрыйбанын ар түрдүүлүгүн камсыз кылуу.
Эмне үчүн Тайвань тандалган?
Изилдөө Тайванды өнүккөн технологиялык мүмкүнчүлүк менен күчтүү кесиптик отчеттуулук түзүмү бир учурда бар critical case катары колдонот. Бухгалтерлер жеке sign-off жана укуктук жоопкерчилик тарткан чөйрөдө AI натыйжалуулук жагынан гана эмес, көзөмөлдөнүүчүлүк жана кесиптик жактан негизделүүчүлүк жагынан да бааланары күтүлөт.
Ошондуктан өлкө контексти изилдөө дизайнынын бир бөлүгү; бирок жыйынтыктарды башка өлкөлөргө автоматтык түрдө өткөрүүгө болбойт.
Тапшырмалар жөнүндө кабылдоолор бири-бири менен кандай байланышта?
Spearman корреляциялык талдоосунда GPT Exposure менен Automation Potential ортосунда 0,60 оң байланыш билдирилген. Automation Potential Human Judgment Necessity менен −0,29, Task Complexity менен −0,33 жана Integration Feasibility менен −0,36 корреляция көрсөткөн. HJ менен TC ортосундагы Spearman корреляциясы 0,65, HJ менен IC ортосундагы корреляция 0,57, TC менен IC ортосундагы корреляция 0,50.
| Өзгөрмөлөр жубу | Spearman корреляциясы |
|---|---|
| GPT Exposure – AP | 0,60*** |
| AP – HJ | −0,29*** |
| AP – TC | −0,33*** |
| AP – IC | −0,36*** |
| HJ – TC | 0,65*** |
| HJ – IC | 0,57*** |
| TC – IC | 0,50*** |
*** p < 0,001.
Бул үлгү көнүмүш жана алмаштырылуучу тапшырмалар менен жогорку ой жүгүртүү/татаалдык талап кылган тапшырмалар кабылдоо жагынан айырмаланарын көрсөтөт; бирок корреляциялар себептик багытты билдирбейт.
Бухгалтерлер AIны кайсы тапшырмаларда колдонууга көбүрөөк даяр көрүнөт?
Изилдөөнүн негизги табылгасы — AI тапшырманын чоңураак бөлүгүн автоматташтыра алган жана учурдагы аудит/кароо агымына жеңилирээк жайгаштырыла алган тапшырмаларда билдирилген AI колдонуу каалоосу жогору. Тескерисинче, күчтүү адамдык ой жүгүртүү талап кылынган тапшырмаларда даярдык коэффициенти терс багытта, бирок статистикалык жактан такталган эмес; демек, изилдөө “адамдык ой жүгүртүү көбөйгөн сайын AI четке кагылат” деген так жыйынтыкты колдобойт.
Мисалы, бухгалтердик күнүмдүк жаңыртуулар, кызматкерлердин чыгымдарын текшерүү жана payable/receivable операциялары автоматташтыруу потенциалы жогору тапшырмалар катары каралса, forensic accounting жана business valuation тапшырманын жогорку татаалдыгын жана адамдык ой жүгүртүүгө жогорку муктаждыкты көрсөтөт.
Appendix Bде Task Complexity боюнча эң жогорку орточо көрсөткүчтөр forensic accounting үчүн 4,50 жана business valuation үчүн 4,17. Human Judgment Need боюнча эң жогорку маанилер тиешелүүлүгүнө жараша 4,00 жана 3,67. Automation Potential жагынан managing cash flow, examining expenses жана payables & receivables тапшырмаларынын ар бири 4,00 орточо мааниге жетет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Негизги статистикалык модель
Көз каранды өзгөрмө Adoption Readiness 1–5 иреттик шкалада болгондуктан, негизги модель ordered logistic regression болуп саналат. Талдоо бирдиги — 576 task-level rating. Бир эле катышуучу 24 тапшырманы баалагандыктан, байкоолор бири-биринен толук көз карандысыз эмес; негизги моделде стандарттык каталар respondent деңгээлинде cluster-robust түрүндө эсептелген. Кошумча туруктуулук спецификацияларында respondent random intercept колдонулган.
| Өзгөрмө | β | Odds Ratio | Стандарттык ката | Булактын чечмелөөсү |
|---|---|---|---|---|
| GPT Exposure | −0,340 | 0,712 | 0,074 | p < 0,001; терс байланыш |
| Automation Potential | +0,476 | 1,610 | 0,086 | p < 0,001; оң байланыш |
| Human Judgment Necessity | −0,135 | 0,873 | 0,096 | Негизги текстте p = 0,160; маанилүү эмес |
| Integration Feasibility | +0,411 | 1,509 | 0,091 | p < 0,001; оң байланыш |
Моделде 576 байкоо бар. Log-likelihood −899,61, AIC 1815, BIC 1850, McFadden R² 0,026 жана Nagelkerke R² 0,084 деп билдирилген. Төмөн pseudo-R² маанилери автор тарабынан изилдөөнүн чалгындоочу мүнөзүнө жана AI кабыл алуу чечимдеринин көп факторлуу болушуна шайкеш деп эсептелет.
Булак ичиндеги белгилөө эскертүүсү: Table 5тин HJ сабында бир жылдыз басылганына карабастан, ошол эле бөлүмдө p = 0,160 экени жана байланыш conventional significance threshold га жетпегени бир нече жолу ачык жазылган. Ошондуктан H2 статистикалык жактан тастыкталгандай көрсөтүлбөшү керек.
Odds ratio жыйынтыктары эмнени билдирет?
Ordered logit моделинде odds ratio башка өзгөрмөлөр туруктуу кармалганда, түшүндүрүүчү өзгөрмөнүн өсүшү жогорку Adoption Readiness категорияларында болуу odds-у менен кандай байланышта экенин көрсөтөт. AP үчүн OR = 1,610 жана IC үчүн OR = 1,509 жогорку readiness багытындагы байланышты, GPT Exposure үчүн OR = 0,712 төмөн readiness багытындагы байланышты көрсөтөт; булар себептик таасирлер эмес.
Automation Potential таасиринин көлөмү
Булак коэффициентти гана бербестен, өзгөрмөлөр Q25тен Q75ке жылдырылганда модель болжолдогон AR категориясынын ыктымалдыктарын да эсептеген.
| Өзгөрмө | P(AR=1), төмөн | P(AR=1), жогору | P(AR=5), төмөн | P(AR=5), жогору |
|---|---|---|---|---|
| Automation Potential | 0,364 | 0,181 | 0,098 | 0,219 |
| Integration Feasibility | 0,306 | 0,162 | 0,123 | 0,242 |
| GPT Exposure | 0,174 | 0,294 | 0,227 | 0,129 |
| Human Judgment Necessity | 0,207 | 0,256 | 0,191 | 0,153 |
Automation Potential Q25тен Q75ке көтөрүлгөндө модель P(AR=1)ди 0,364төн 0,181ге төмөндөтөт, ал эми P(AR=5)ти 0,098ден 0,219га жогорулатат. Integration Feasibility үчүн P(AR=5) 0,123төн 0,242ге жогорулайт. Бул ыктымалдыктар моделге негизделген болжолдор; чыныгы колдонуу көрсөткүчтөрү эмес.
Эмне үчүн GPT тажрыйбасы төмөн даярдык менен байланыштуу болушу мүмкүн?
GPT Exposure коэффициенти терс жана статистикалык жактан маанилүү. Автор муну experience-skepticism effect деп чечмелейт: чоң тил моделдери менен көбүрөөк практикалык тажрыйба колдонуучуларга моделдин чектөөлөрүн, текшерүү зарылдыгын жана каталарын реалдуураак көрүүгө алып келиши мүмкүн.
Бирок бул изилдөө механизмди түздөн-түз сынабайт. “GPT тажрыйбасы көбөйгөн сайын сөзсүз шектенүү пайда болот” деген жыйынтык чыгарууга болбойт. Терс коэффициент булак маалыматтарында байкалган байланыш; experience-skepticism болсо автордун бул байланышка шайкеш теориялык чечмелөөсү.
Эмне үчүн адамдык ой жүгүртүү боюнча жыйынтык этият окулушу керек?
Human Judgment Necessity коэффициенти күтүлгөн багытта терс, бирок булакта p = 0,160 деп берилет. Ошондуктан H2 үчүн багыттуу, бирок жыйынтыксыз/inconclusive колдоо гана бар.
Автор эки мүмкүн болгон чектөөнү талкуулайт: таасир бул чакан тандоодо чынында алсыз болушу мүмкүн же HJнин Task Complexity менен жогорку корреляциясы өз алдынча коэффициенттин тактыгын азайткан болушу мүмкүн. Ошондой эле тапшырманын түрү, стаж же ой жүгүртүүнүн мүнөзү сыяктуу өлчөнбөгөн модераторлор да роль ойношу мүмкүн.
20 кийинки маек кандай максатта колдонулган?
Кийинки маектер негизги статистикалык жыйынтыктарды алмаштыруу үчүн эмес, коэффициенттердин кесиптик контекстин түшүндүрүү үчүн колдонулган. Маектер Mandarin тилинде жазылып, verbatim transcribe кылынган, белгилүү бөлүгүнө back-translation колдонулуп, калган мазмун эки тилдүү кароо менен текшерилген.
Back-translation максаттуу transcript бөлүк топтомунун %29уна гана колдонулган. Автор муну дизайн чектөөсү катары ачык кабыл алат. Толук thematic analysis бул макаланын негизги натыйжасы эмес; ал companion qualitative study ичинде билдирилгени айтылат.
Үч тапшырма профили
Ward linkage колдонгон hierarchical clustering GPT Exposure, AP, HJ, TC жана ICнин стандартташтырылган маанилери боюнча үч кластер түзгөн. 11-беттеги dendrogram үчтүк чечимди, дароо астындагы kernel density графиктери кластерлердин өзгөрмө профилдериндеги айырманы көрсөтөт.
| Кластер | Негизги профиль | Мисал тапшырмалар | Булакта сунушталган AI ыкмасы |
|---|---|---|---|
| Cluster 1 — Judgment-first | Жогорку HJ жана TC; орто-жогорку IC | Forensic accounting, business valuation, audit leadership | Copilot түрүндөгү жардам + милдеттүү адам sign-off |
| Cluster 2 — Automation-oriented | Жогорку AP жана GPT Exposure; төмөн HJ | Чыгымдарды текшерүү, күнүмдүк бухгалтердик иштер, payable/receivable | AI кабыл алуу үчүн эң түз баштапкы чөйрө |
| Cluster 3 — Intermediate | AP, HJ жана IC боюнча орто деңгээл | Банктык салыштырып текшерүү, жөнгө салуучу талаптарга шайкештик, каржылык болжол | Чечим фирманын башкаруусуна жана кесиптик тажрыйбага көбүрөөк көз каранды |
Бул кластерлөө сүрөттөөчү. Үч профиль табигый же универсалдуу бухгалтердик тапшырма класстары катары далилденген эмес.
Туруктуулук текшерүүлөрү
Изилдөөчү AP пайыздарын кайра топтоо, GPT Exposureду иреттик катары кароо жана TC/IC шкалаларын кайра коддоо сыяктуу альтернативдүү өлчөө варианттарын сынап, коэффициенттер олуттуу өзгөрбөгөнүн билдирген.
Ordered logit жана OLS спецификациялары бирдей жалпы багытты берген; HC3 стандарттык каталары жана nonparametric bootstrap confidence intervals окшош статистикалык тыянактарга алып келген.
Leave-one-respondent-out талдоосунда коэффициенттер күтүлгөн тандоо ызы-чуусунун ичинде туруктуу калган. Фирманын көлөмүнө байланыштуу multivariate үлгүлөр 9999 permutation колдонгон permutation MANOVA менен өзүнчө сыналган. Үч кластердин түзүлүшү k-means жана альтернативдүү distance metrics менен сапаттык жактан сакталган.
Өлчөө диагностикасы
| Өлчөө | Маани |
|---|---|
| Cronbach's α | 0,441 |
| %95 ишеним аралыгы | [0,282; 0,573] |
| KMO | 0,643 |
| Bartlett χ²(10) | 274,219; p < 0,001 |
| Factor 1 eigenvalue | 2,006 |
| Түшүндүрүлгөн дисперсия | 0,401 |
Автор төмөн Cronbach α маанисин классикалык мааниде шкаланын ийгиликсиздиги катары чечмелебейт; анткени AP, HJ, TC, IC жана GPT Exposure бир эле latent түшүнүктүн кайталанма reflective көрсөткүчтөрү катары эмес, ар башка тапшырма өзгөчөлүктөрүн билдирген formative көрсөткүчтөр катары иштелип чыккан.
Бир факторлуу талдоодо GPT Exposure loading-и 0,117, AP 0,474, HJ −0,813, TC −0,780 жана IC −0,706. Белгилер өзгөрмөлөрдү коддоо багыттарын чагылдырат.
Necessary Condition Analysis
Чалгындоочу Necessary Condition Analysisте CE-FDH estimator жана permutation tests колдонулган. Максат Adoption Readiness үчүн бир өзгөрмө зарыл чек же bottleneck экенин текшерүү.
Эч бир фактор салттуу маанилүүлүк деңгээлдеринде нөлдөн айырмаланган necessity threshold га жеткен эмес. Ошондуктан булактын жыйынтыктары “жогорку IC болбосо, AI эч качан кабыл алынбайт” же “GPT тажрыйбасы зарыл шарт” сыяктуу катуу чек дооматтарын колдобойт.
Изилдөө колдогон жыйынтыктар
- Жогорку Automation Potential жогорку AI Adoption Readiness менен оң байланыштуу.
- Жогорку Integration Feasibility жогорку Adoption Readiness менен оң байланыштуу.
- Жогорку GPT Exposure төмөн Adoption Readiness менен байланыштуу.
- Human Judgment Necessity терс багытта, бирок p = 0,160 болгондуктан статистикалык жактан так эмес.
- Task-level governance compatibility AI кабыл алуу каалоосун түшүнүүдө натыйжалуулук логикасына кошумча түшүндүрмө маанисин берет.
- Тапшырмаларды judgment-first, automation-oriented жана intermediate деп үч сүрөттөөчү профилге бөлүүгө болот.
- Көнүмүш жана аз ой жүгүртүү талап кылган тапшырмалар AI колдонууга ачыгыраак баштапкы чөйрөлөр болуп көрүнөт.
Изилдөө колдобогон жыйынтыктар
- AI бухгалтерлердин иш натыйжалуулугун жогорулатары текшерилген эмес.
- AI ката ченин же чыгымды азайтары өлчөнгөн эмес.
- Катышуучулардын AIны чыныгы колдонуу жүрүм-туруму байкалган эмес.
- 24 адамдан турган панель Тайвандын бардык бухгалтерлерин же дүйнөлүк бухгалтердик кесипти билдирбейт.
- GPT тажрыйбасы себептик түрдө шектенүүгө алып келери далилденген эмес.
- Адамдык ой жүгүртүүгө болгон муктаждык AI кабыл алууну сөзсүз төмөндөтөрү статистикалык жактан көрсөтүлгөн эмес.
- Үч cluster универсалдуу бухгалтердик тапшырма категориялары эмес.
- Жөнгө салуу жана отчеттуулук түзүмдөрү ар башка өлкөлөрдө ошол эле байланыштар пайда болоруна кепилдик бербейт.
Чектөөлөр
Эң маанилүү чектөө — 24 адамдан турган purposive expert-panel дизайны. Жалпы 576 тапшырма деңгээлиндеги байкоо көп көрүнгөнү менен, алар болгону 24 адамдын кайталанган баалоолору. Ошондуктан 576 байкоону 576 көз карандысыз адис катары чечмелөө туура эмес.
Жыйынтык өзгөрмөсү чыныгы колдонуу эмес, self-reported behavioral intention. Бир пункттан турган AR өлчөөсү technology acceptance адабиятында колдонууга жарамдуу proxy болгону менен, түзүлүштүн эмоциялык, таанып-билүү жана жүрүм-турум өлчөмдөрүн өз-өзүнчө өлчөбөйт.
Маалыматтар кесилиштик жана кабылдоого негизделген; себептик багыт аныкталбайт. Интеграцияны ишке ашыруу мүмкүнчүлүгүнүн жогору болушу AI даярдыгын көбөйтүшү мүмкүн же AIга ачыгыраак катышуучулар айрым тапшырмаларды интеграциялоону жеңилирээк деп кабылдашы мүмкүн.
Маектер контексттик түшүндүрмө берет, бирок толук сапаттык талдоо бул макалада билдирилген эмес. Мындан тышкары, transcriptтердин %29унда гана back-translation колдонулушу тилдик текшерүүнүн камтуусун чектейт.
Автор келечекте кеңири confirmatory surveys, longitudinal дизайндар, ар башка accountability regimes ортосунда салыштыруулар жана GPT Exposure менен төмөн readiness байланышы experience-based skepticismби же cohort/өтүү таасириби экенин айырмалай алган изилдөөлөрдү сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Task-Level Perceptions of AI Readiness Among Accounting Professionals
Автор: Wil Martens.
Мекеме: College of Management, National Sun Yat-sen University, Kaohsiung 80424, Taiwan.
Журнал: Accounting and Auditing.
Басма: MDPI, Basel, Switzerland.
Библиографиялык жазуу: 2026, Volume 2, Issue 2, Article 7.
DOI: 10.3390/accountaudit2020007
Жарыяланган күнү: 8-май 2026.
Редакциялык даталар: Received 21 January 2026; Revised 1 April 2026; Accepted 20 April 2026.
Булактын түрү: Рецензияланган чалгындоочу task-survey / expert-panel изилдөөсү; түзүмдөштүрүлгөн тапшырма деңгээлиндеги кабылдоо өлчөөлөрү колдоочу кыска маектер менен бирге колдонулган.
Лицензия: Creative Commons Attribution (CC BY).
Тандоо: 24 accounting professional × 24 тапшырма = 576 тапшырма деңгээлиндеги баалоо; 20 адам менен кийинки маек.
Негизги жыйынтык өзгөрмөсү: Adoption Readiness (AR), 1–5 ordinal behavioral-intention өлчөөсү.
Негизги түшүндүрүүчү өзгөрмөлөр: Automation Potential (AP), Human Judgment Necessity (HJ), Integration Feasibility (IC); GPT Exposure көзөмөл өзгөрмөсү. Task Complexity (TC) коллинеардуулуктан улам негизги моделден чыгарылып, сүрөттөөчү жана cluster талдоолорунда сакталган.
Негизги статистикалык ыкма: Ordered logistic regression; respondent деңгээлинде cluster-robust standard errors. Robustness талдоолорунда random-intercept түзүлүштөрү, OLS, HC3 standard errors, nonparametric bootstrap, leave-one-respondent-out, permutation MANOVA жана альтернативдүү cluster ыкмалары колдонулган.
Кластерлөө: Стандартташтырылган GPT, AP, HJ, TC жана IC маанилеринде Ward linkage колдонгон hierarchical clustering; үч cluster чечими.
Кошумча чалгындоочу ыкма: CE-FDH estimator жана permutation tests колдонгон Necessary Condition Analysis.
Каржылоо: Тышкы каржылоо жок.
Этика: Жашыруун сурамжылоо маалыматтарын жана ыктыярдуу маектерди камтыган minimal-risk изилдөө катары аныкталып, колдонулуучу улуттук жана мекемелик эрежелердин алкагында формалдуу этика кеңешинин кароосу талап кылынбаганы айтылган.
Маалымдалган макулдук: Бардык катышуучулардан алынган.
Маалыматтардын жеткиликтүүлүгү: Маалыматтар этикалык жана купуялуулук чектөөлөрүнөн улам коомчулукка ачык эмес; негиздүү өтүнүч боюнча corresponding author аркылуу жеткиликтүү болушу мүмкүн.
Кызыкчылыктардын кагылышы: Автор кызыкчылыктардын кагылышы жок экенин билдирген.
Булак ичиндеги статистикалык эскертүү: Table 5те Human Judgment Necessity үчүн жылдыз белгиси басылганына карабастан, негизги текст жана таблица эскертүүсү p = 0,160 экенин жана conventional significance threshold га жетпегенин билдирет. Verianla чечмелөөсүндө ачык p мааниси жана автордун тексттик чечмелөөсү сакталган.
Негизги чечмелөө чеги: Табылгалар чакан жана максаттуу тандалган expert panel ичиндеги тапшырма деңгээлиндеги кабылдоо байланыштары. Алар себептик таасир, чыныгы колдонуу, тутумдун натыйжалуулугу же калк деңгээлиндеги кабыл алуу көрсөткүчү катары чечмеленбеши керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген