

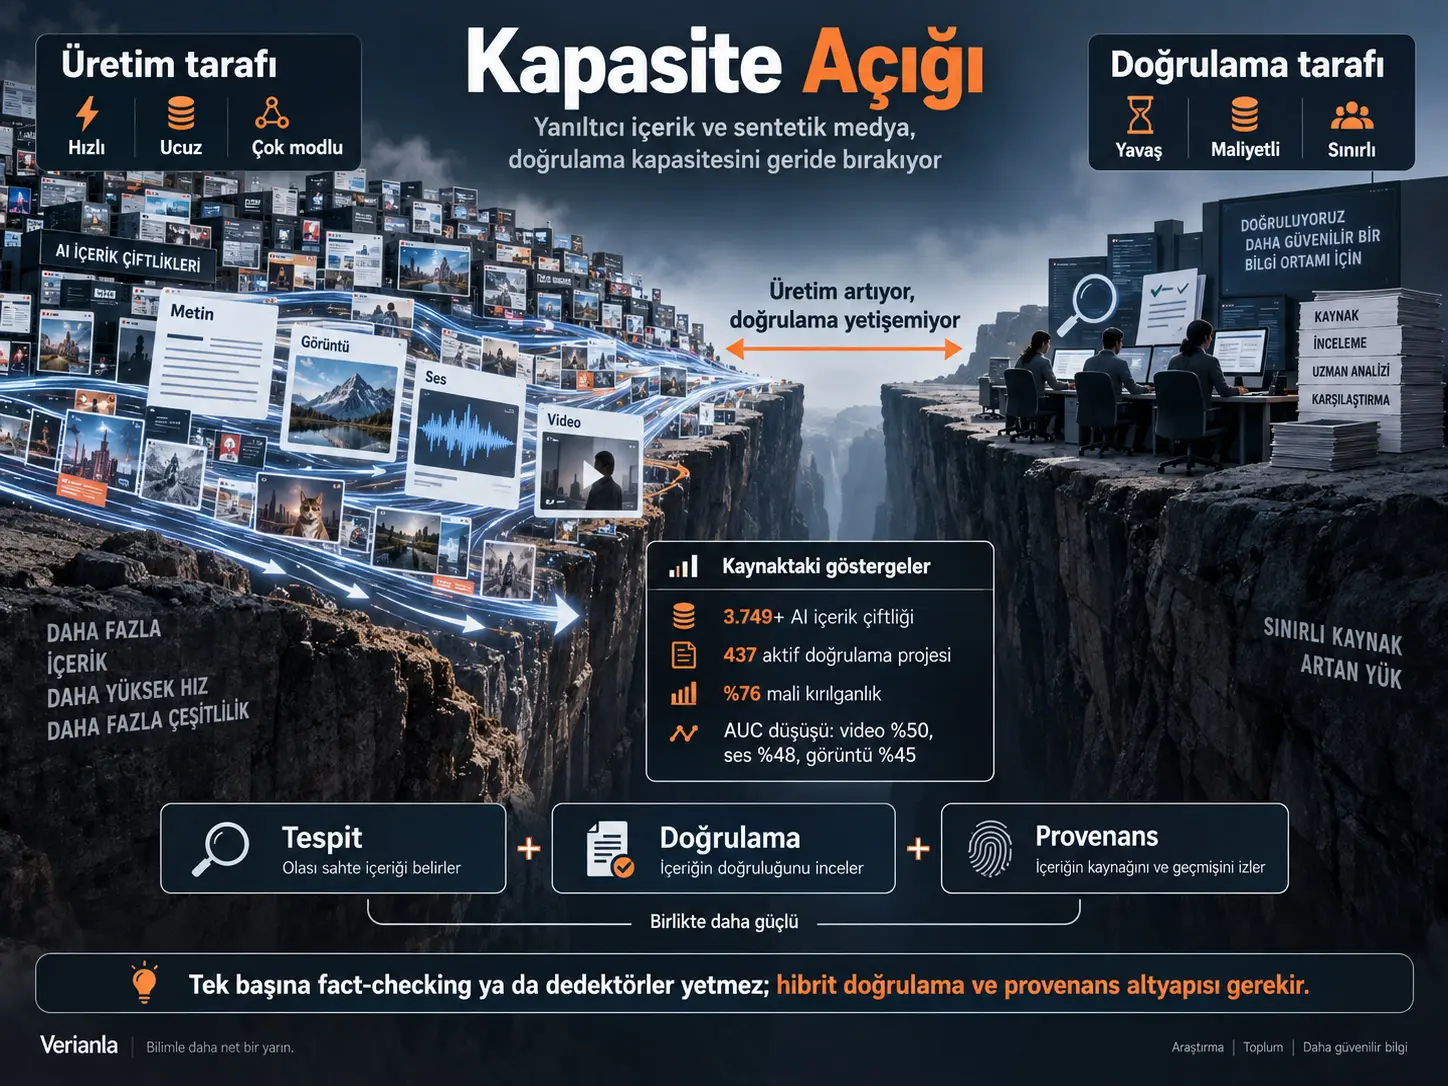
Bu çalışma, yapay zekâ destekli yanıltıcı ve sentetik içeriğin üretim hacmi, üretim hızı ve çok modlu karmaşıklığı artarken profesyonel doğrulama kuruluşlarının işlem kapasitesi ile otomatik tespit sistemlerinin gerçek dünya güvenilirliğinin aynı ölçüde büyümemesini kapasite açığı (capacity gap) olarak tanımlamaktadır. Kapasite açığı, doğrulanması gereken içerik yüzeyinin genişlemesi ile bunu inceleyebilecek insan ve teknik doğrulama kapasitesi arasındaki giderek büyüyen yapısal uyumsuzluktur. Kaynak, 2025–2026 dönemine ait kurumsal veriler ile gerçek dünya deepfake benchmark sonuçlarını birlikte değerlendirerek problemin yalnızca “daha fazla yanlış içerik” meselesi olmadığını; üretim ile doğrulama arasındaki maliyet, hız, ölçeklenebilirlik ve genelleme asimetrisinden kaynaklandığını savunmaktadır.
Çalışmanın aktardığı verilere göre NewsGuard 2026 ortasında 3.749'dan fazla AI içerik çiftliği sitesi tanımlamıştır. Duke Reporters’ Lab verilerinde 2025 yılında yalnızca 10 yeni doğrulama projesi açılırken 30’dan fazla projenin yayını sonlandırılmış, küresel aktif proje sayısı 2025 sonundaki 441’den Haziran 2026’da 437’ye düşmüştür. International Fact-Checking Network araştırmasında 141 kuruluşun %76'sı mali durumunu kırılgan veya kriz içinde olarak bildirmiştir. Buna paralel olarak Deepfake-Eval-2024 gerçek dünya benchmark’ında açık kaynak tespit modellerinin önceki akademik benchmark performanslarına göre ortalama AUC düşüşleri video için %50, ses için %48 ve görüntü için %45 olarak raporlanmıştır.
Çalışma bu bulgulardan “otomatik tespit işe yaramaz” veya “profesyonel doğrulama artık anlamsızdır” sonucunu çıkarmamaktadır. Tam tersine, insan doğrulaması ve teknik tespit araçlarının birbirini tamamlayan hibrit sistemlerde kullanılması; içerik kökeni ve değişiklik geçmişinin izlenmesini sağlayan provenans altyapısının güçlendirilmesi; laboratuvar yerine gerçek dağıtım koşullarını temsil eden dinamik benchmark’ların kullanılması ve profesyonel doğrulama kurumlarının daha dayanıklı finansman modelleriyle desteklenmesi önerilmektedir.
Kapasite Açığı Nedir?
Kapasite açığı, yanıltıcı ve sentetik içeriğin hacmi, üretim hızı ve çok modlu karmaşıklığındaki büyümenin; profesyonel doğrulama kuruluşlarının işlem kapasitesi ile otomatik tespit sistemlerinin gerçek dünya güvenilirliğindeki büyümeyi geride bırakması sonucu oluşan göreli ve yapısal uyumsuzluktur.
Kaynağın özellikle vurguladığı nokta, bu açığın yalnızca nicel olmadığıdır. Üretim tarafında içerik oluşturmanın marjinal maliyeti düşerken aynı metnin, görselin, sesin veya videonun yüzlerce varyasyonu kısa sürede üretilebilir. Doğrulama tarafında ise güvenilir sonuç için hâlâ kaynak incelemesi, bağlam değerlendirmesi, teknik analiz ve çoğu durumda insan uzmanlığı gerekmektedir.
Bu nedenle bir milyon içerik üretme kapasitesinin iki katına çıkması ile doğrulama kapasitesinin iki katına çıkması aynı teknik ve ekonomik süreç değildir. Üretim yazılımla hızlı biçimde ölçeklenebilirken dikkatli doğrulama insan emeği, uzmanlık, finansman ve zamanla sınırlıdır.
Dört temel kavram
| Kavram | Kaynakta kullanılan anlam |
|---|---|
| Yanıltıcı içerik | Üreticinin niyetinden bağımsız olarak yanlış, hatalı veya anlayışı sistematik biçimde çarpıtan bilgi. |
| Sentetik medya | Metin, görüntü, ses, video veya çok modlu biçimde yapay zekâ tarafından oluşturulan ya da önemli ölçüde değiştirilen içerik. |
| Profesyonel doğrulama kapasitesi | Uzman kuruluşların iddiaları araştırma, kanıtı belgeleme ve gerekçeli değerlendirme yayımlama yeteneği; personel, finansman, dil/coğrafya kapsamı ve işlem hacmini içerir. |
| Otomatik tespitin gerçek dünya güvenilirliği | Tespit sistemlerinin sıkıştırma, yeniden kodlama, yeni üreticiler, karma içerik ve saldırgan manipülasyon gibi gerçek dağıtım koşullarında gösterdiği performans. |
Tespit, Doğrulama ve Provenans Aynı Şey midir?
Hayır. Tespit bir medyanın yapay zekâyla üretilmiş veya manipüle edilmiş olup olmadığını sorar; doğrulama içeriğin güvenilirliğini ve hangi kanıtlarla desteklendiğini değerlendirir; provenans ise içeriğin kaynağını, üreticisini ve değişiklik geçmişini belirlemeye çalışır. Bu üç görev birbirini tamamlar fakat birbirinin yerine geçmez.
Bu ayrım özellikle önemlidir çünkü AI tarafından üretilmiş her içerik yanlış değildir. Benzer biçimde insan tarafından üretilmiş bir içerik de yanıltıcı olabilir. Bir deepfake dedektörünün “AI üretimi” sonucu vermesi, görüntüdeki iddianın yanlışlığını tek başına kanıtlamaz.
Aynı şekilde provenans sisteminin bir dosyanın nereden geldiğini ve hangi düzenlemelerden geçtiğini göstermesi, dosyada ifade edilen iddianın doğru olduğunu garanti etmez. Kaynak bu nedenle doğrulama ekosisteminin tek araçlı değil katmanlı düşünülmesi gerektiğini savunmaktadır.
Sentetik içerik arzı neden hızla büyüyor?
Üretken yapay zekâ sistemleri metin, görüntü, ses ve video üretme maliyetini azaltmış; aynı zamanda içerik kalitesini ve üretim hızını artırmıştır. Bu durum yalnız bireysel deepfake üretimini değil, sürekli ve yüksek hacimde içerik üreten otomatik yayın sistemlerini de mümkün hâle getirmiştir.
Kaynağın verdiği görünür göstergelerden biri NewsGuard'ın 2026 ortasında belirlediği 3.749+ AI destekli içerik çiftliği sitesidir. Bu siteler farklı dillerde yüksek frekansta içerik yayımlayabilmekte ve çoğunlukla güçlü insan editoryal denetimi olmadan çalışmaktadır.
Çalışma ayrıca sorun yüzeyinin yalnız yüz deepfake'lerinden ibaret olmadığını vurgulamaktadır. Güncel sistemler gerçekçi konuşma, tutarlı video, görsel-ses kombinasyonları ve uzun anlatı yapıları üretebilmektedir. Böylece doğrulama ihtiyacı metin, fotoğraf, ses, kısa video ve çok modlu içeriğe aynı anda yayılmaktadır.
Profesyonel Doğrulama Kapasitesi Neden Aynı Hızda Ölçeklenemiyor?
Profesyonel doğrulama kapasitesi aynı hızda ölçeklenememektedir çünkü güvenilir inceleme eğitimli personel, kaynak erişimi, dil ve alan bilgisi, kanıt toplama ve editoryal sorumluluk gerektirirken doğrulama kuruluşlarının finansman, personel ve coğrafi kapsama kapasitesi sınırlıdır.
| Gösterge | Değer / gözlem | Kaynak |
|---|---|---|
| Yeni doğrulama projeleri, 2025 | 10 | Duke Reporters’ Lab (2026) |
| Kapanan projeler, 2025 | 30'dan fazla | Duke Reporters’ Lab (2026) |
| Aktif projeler, Haziran 2026 | 437; 2025 sonunda 441 | Duke Reporters’ Lab (2026) |
| Mali açıdan kırılgan veya kriz içinde | %76 | IFCN (2026) |
| Belirlenen AI içerik çiftliği siteleri | 3.749+ | NewsGuard (2026) |
IFCN'nin 2026 raporu 71 ülkeden 141 kuruluşun yanıtlarına dayanmaktadır. Kaynağa göre kuruluşların %76'sı mali durumlarını kırılgan veya kriz içinde olarak tanımlamıştır. Personel azaltımları artmış ve gelir yapısında platform ortaklıklarından hibeye bağımlılığa doğru kayma yaşanmıştır.
Kaynak özellikle kapasitenin “çöktüğünü” söylememektedir. Doğrulama faaliyeti hâlâ on yıl öncesine kıyasla çok daha geniştir. Sorun, kapasitenin karşısındaki içerik hacmi ve karmaşıklığıyla aynı oranda büyümemesidir.
Zamansal asimetri
Yanıltıcı içerik dakikalar veya saatler içinde üretilip farklı platformlara dağıtılabilir. Güvenilir doğrulama ise kanıt toplama, çapraz kontrol, bağlam araştırması ve uzman değerlendirmesi gerektirir.
Bu nedenle doğru bir doğrulama yayımlandığında içerik zaten önemli ölçüde yayılmış olabilir. Kaynak bu zaman farkını kapasite açığının temel yapısal bileşenlerinden biri olarak değerlendirmektedir.
Çalışmanın Yöntemi ve Bulguları
Çalışma tasarımı
Makale yeni bir deepfake tespit modeli veya doğrudan kontrollü deney sunmamaktadır. Çalışma; profesyonel doğrulama kuruluşlarına ilişkin 2025–2026 kurumsal göstergelerini, güncel gerçek dünya tespit benchmark'larını ve bilgi ekosistemi literatürünü bir araya getirerek kapasite açığını teşhis eden bir çalışma raporudur.
Otomatik tespit sistemlerindeki gerçek dünya kaybı
Kaynakta en önemli teknik kanıtlardan biri Deepfake-Eval-2024 benchmark'ıdır. Bu benchmark, 2024 boyunca sosyal medya ve tespit platformlarında gerçek dolaşıma girmiş deepfake örneklerini kullanmaktadır.
| Modalite | Ortalama AUC düşüşü |
|---|---|
| Video | %50 |
| Ses | %48 |
| Görüntü | %45 |
Deepfake Dedektörleri Laboratuvardaki Başarılarını Gerçek Dünyada Koruyor mu?
Kaynağın aktardığı güncel bağımsız değerlendirmelere göre hayır; birçok deepfake tespit sistemi kontrollü akademik benchmark'larda yüksek performans gösterse de sıkıştırılmış, yeniden kodlanmış, yeni üreticilerle oluşturulmuş veya gerçek dağıtım koşullarından geçmiş içeriklerde belirgin performans kaybı yaşamaktadır.
Kaynak bu kaybı birkaç mekanizmayla açıklamaktadır.
- Üreticiye bağımlı öğrenme: Birçok dedektör belirli üretici modellerin bıraktığı izleri öğrenir. Yeni üreticiler ortaya çıktığında bu izler değişebilir.
- Sıkıştırma ve yeniden kodlama: JPEG sıkıştırması, platform yeniden kodlaması, çözünürlük değişimi ve ekran kaydı tespit sistemlerinin kullandığı düşük seviyeli sinyalleri değiştirebilir.
- Karma ve kısmi manipülasyon: Gerçek dünya içeriği tamamen sentetik olmak zorunda değildir; yalnız belirli bölümleri değiştirilmiş olabilir.
- Çok modluluk: Görüntü için optimize edilmiş bir sistem video veya ses üzerinde güvenilir olmayabilir.
- Açık-küme genelleme problemi: Dedektör, eğitim sırasında hiç görmediği üretim yöntemlerine karşı da çalışmak zorundadır.
Kaynak ticari tespit sistemlerinin bazı testlerde açık kaynak modellere göre daha iyi performans gösterebildiğini belirtmekle birlikte, gerçek dünya koşullarında bütün üreticiler ve bütün dağıtım biçimleri karşısında sürekli yüksek doğruluğu koruyan bir sistem gösterilmediğini vurgulamaktadır.
Laboratuvar Doğruluğu Neden Gerçek Dünya Güvenilirliğiyle Aynı Değildir?
Laboratuvar doğruluğu çoğunlukla temiz, kontrollü ve modele tanıdık veri dağılımlarında ölçülürken gerçek dünya güvenilirliği sıkıştırma, yeni üreticiler, yeniden kodlama, karma manipülasyon, farklı platformlar ve saldırgan uyarlamalar altında korunması gereken performansı ifade eder; bu nedenle yüksek benchmark skoru doğrudan operasyonel güvenilirlik anlamına gelmez.
Statik benchmark'ların bir başka sorunu da zamanla eskimesidir. Yeni üretim modelleri ortaya çıktıkça eski test setleri gerçek problem yüzeyini temsil etmeyebilir. Ayrıca test verilerinin ilerleyen dönemlerde model eğitim verilerine karışması veri sızıntısı ve benchmark kontaminasyonu riski yaratabilir.
Kaynak VeriTaS gibi sürekli güncellenen, gerçek dünyadan yeni iddia ve medya ekleyen dinamik benchmark'ları daha gerçekçi değerlendirme yönünde önemli bir yaklaşım olarak göstermektedir.
Kapasite açığının yapısal nedenleri
| Faktör | Üretim tarafı | Doğrulama tarafı |
|---|---|---|
| Ölçeklenme | Yeni içerik üretmenin marjinal maliyeti düşer. | İnsan incelemesi benzer biçimde otomatik ölçeklenmez. |
| Teknolojik değişim | Yeni üreticiler hızla gelişir. | Dedektörlerin yeni üreticilere yeniden genellemesi gerekir. |
| Ekonomik teşvik | Yüksek hacimli içerik doğrudan ekonomik getiri sağlayabilir. | Doğrulama maliyeti çoğunlukla kamu yararı kuruluşlarına ve haber merkezlerine kalır. |
| Ölçüm | Üretimin başarı ölçütü çoğunlukla hız ve gerçekçilik olabilir. | Gerçek dünya doğruluğunu ölçmek dinamik ve pahalı benchmark gerektirir. |
| Zaman | İçerik dakikalar içinde üretilebilir ve çoğaltılabilir. | Güvenilir doğrulama kanıt ve çapraz kontrol için zaman gerektirir. |
Teşvik uyumsuzluğu
Çalışmanın yapısal teşhislerinden biri, yüksek hacimli üretimden ekonomik fayda sağlayan aktörler ile doğrulama maliyetini taşıyan aktörlerin çoğu zaman aynı olmamasıdır. Üretim kapasitesini sağlayan platformlar ve araç geliştiricileri ölçek ekonomilerinden yararlanırken, doğrulama maliyetinin önemli bölümü uzman kuruluşlar, haber merkezleri ve kamu yararı girişimlerine yüklenmektedir.
Kaynağa göre doğrulama tarafında bu maliyeti üretim ölçeğiyle orantılı biçimde içselleştiren güçlü bir mekanizma henüz bulunmamaktadır.
Bilgi ekosistemi açısından sonuçlar
Kapasite açığı yalnız fact-check kuruluşlarının operasyonel problemi değildir. Kaynağa göre güvenilir ile güvenilmez bilgiyi ayırt etmenin maliyetini bütün kullanıcılar ve kurumlar açısından yükseltmektedir.
Bu ortam iki zıt fakat zararlı davranışı birlikte güçlendirebilir: insanların gerçekçi görünen sentetik içeriği kolayca kabul etmesi veya tam tersine gerçek kanıtları da sahte olabileceği gerekçesiyle sistematik olarak reddetmesi.
Haber kuruluşları, platformlar, kamu kurumları, seçim otoriteleri ve mahkemeler gibi hızlı ve güvenilir özgünlük değerlendirmesine ihtiyaç duyan kurumlar açısından bu sorun özellikle önemlidir.
Otomatik Tespit İnsan Fact-Checking'inin Yerini Alabilir mi?
Kaynağa göre mevcut koşullarda hayır. Otomatik tespit büyük hacimli içerikte ön eleme ve teknik sinyal sağlayabilirken bağlam, kanıt değerlendirmesi ve yüksek riskli nihai kararlar için insan doğrulamasına ihtiyaç devam etmektedir; buna karşılık insan doğrulaması da internet ölçeğindeki hacmi tek başına karşılayamaz.
Hibrit doğrulama
Kaynak bu nedenle otomatik araçların önceliklendirme, arama ve delil toplama aşamalarında; eğitimli insan inceleyicilerin ise nihai değerlendirmede görev aldığı hibrit iş akışlarını gerekli görmektedir.
Ancak hibrit yaklaşım sınırsız ölçek sağlayan bir çözüm değildir. Nihai insan sorumluluğu sürdüğü sürece insan uzmanlığı bir darboğaz olarak kalmaktadır.
Provenans altyapısı
Post-hoc tespit yani içerik yayımlandıktan sonra sahte olup olmadığını belirleme kusursuz değilse, içeriğin kaynağı ve değişiklik geçmişini daha erken aşamada gösterebilmek daha değerli hâle gelir.
Kaynak C2PA Content Credentials gibi kriptografik provenans standartlarını bu amaçla değerlendirmektedir. Böyle sistemler medyanın nasıl üretildiği ve düzenlendiğine ilişkin makine tarafından okunabilir bilgi sağlayabilir.
Ancak provenans da doğruluğu tek başına kanıtlamaz ve altyapının yaygın şekilde benimsenmesine, bilgilerin silinmeye veya sahteciliğe karşı dayanıklılığına bağlıdır.
Daha gerçekçi ölçüm
Kaynak, tespit araştırmalarının başarısını değerlendirmek için dinamik, çok modlu ve gerçek dağıtımdan toplanan benchmark'ların daha yaygın kullanılmasını önermektedir.
Bu yaklaşım yalnız daha adil model karşılaştırması sağlamaz; aynı zamanda laboratuvar skorlarının gerçek operasyonel kapasiteyi olduğundan yüksek göstermesi riskini azaltır.
Kurumsal dayanıklılık
Profesyonel doğrulama kuruluşları için daha çeşitli ve istikrarlı finansman modelleri, düşük kaynaklı dillerde ve bölgelerde doğrulama kapasitesinin geliştirilmesi ve tek bir platform ortaklığına aşırı bağımlılığın azaltılması önerilmektedir.
Kaynağın yaklaşımında doğrulama yalnız özel bir medya hizmeti değil, yararı onu gerçekleştiren kuruluşların ötesine yayılan bir kamu yararı işlevi olarak ele alınmaktadır.
Çalışmanın desteklediği sonuçlar
- Sentetik ve yanıltıcı içerik üretiminin ölçeği ve çok modlu karmaşıklığı artmaktadır.
- Profesyonel doğrulama kapasitesi finansal ve personel baskısı altındadır.
- Gerçek dünya dağıtım koşulları otomatik tespit sistemlerinin performansını ciddi biçimde düşürebilmektedir.
- Benchmark başarısı operasyonel güvenilirliğe eşit değildir.
- İnsan doğrulaması ve otomatik tespit birbirinin yerine geçen değil, birbirini tamamlayan katmanlardır.
- Provenans altyapısı doğrulama yükünü azaltabilecek tamamlayıcı bir katmandır.
- Tek bir teknik veya kurumsal çözüm kapasite açığını tek başına kapatamaz.
Çalışmanın desteklemediği sonuçlar
- Bütün AI tarafından üretilen içerik yanıltıcı değildir.
- Bütün sentetik medya deepfake değildir.
- Her otomatik tespit sistemi kullanışsız değildir.
- Profesyonel doğrulamanın çöktüğü sonucu çıkarılmamaktadır.
- Deepfake-Eval-2024'teki AUC düşüşleri bütün dedektörlerin her koşuldaki kesin performansı değildir.
- 3.749+ AI içerik çiftliği sayısı internetteki bütün sentetik içeriğin toplam miktarı değildir.
- Kapasite açığı kaynak tarafından kesin bir küresel oran şeklinde hesaplanmamıştır.
Sınırlılıklar
Çalışmanın kurumsal kapasite analizi büyük ölçüde Duke Reporters’ Lab ve IFCN verilerine dayanmaktadır. IFCN'nin kuruluş verileri öz bildirimlere dayandığından, ağ dışında kalan veya informel doğrulama faaliyetlerinin tamamını kapsamayabilir.
NewsGuard'ın AI içerik çiftliği sayısı özel tanımlama yöntemlerine dayanmaktadır ve yayımlanan bilgilerden yöntemin tamamının bağımsız olarak birebir çoğaltılması mümkün değildir.
Yanıltıcı ve sentetik içeriğin herhangi bir anda internetteki gerçek toplam hacmini ölçmek son derece güçtür. Bu nedenle çalışma doğrulama kapasitesi ile problem hacmi arasında kesin bir matematiksel oran değil, gözlenebilir göstergeler ve yönlü eğilimler kullanmaktadır.
Son olarak 2025–2026 dönemine ait tespit sistemi veya kurumsal kapasite verileri hızla eskiyebilir. Hem üretim teknikleri hem de doğrulama kuruluşlarının koşulları hızlı değişmektedir.
Kaynak ve Yöntem Notu
Özgün başlık: The Capacity Gap: Misleading Content, Synthetic Media, and the Limits of Fact-Checking and Detection
Yazar: Mohith Agadi
E-posta: mohith@fact.technology
Kurum: Fact Protocol
Yayın türü: Working Paper
Seri: Fact Protocol Working Paper No. 2026-05
Tarih: Ağustos 2026
ISSN: 2836-5925 (Online)
DOI: Kaynak PDF'de bu çalışma için DOI verilmemiştir.
Hakemlik durumu: Kaynak bir working paper olarak sunulmaktadır; PDF içinde hakemli dergi yayını olduğuna ilişkin bilgi bulunmamaktadır.
Temel veri ve kaynak grupları: Duke Reporters’ Lab 2026 fact-checking census verileri, International Fact-Checking Network 2026 State of the Fact-Checkers raporu, NewsGuard AI içerik çiftliği takibi, Deepfake-Eval-2024 gerçek dünya benchmark'ı, VeriTaS dinamik benchmark çalışması ve ilgili akademik literatür.
Temel yöntem: Çalışma farklı kurumsal ve teknik göstergeleri bir araya getirerek yanıltıcı/sentetik içerik üretimi ile insan ve otomatik doğrulama kapasitesi arasındaki yapısal uyumsuzluğu teşhis etmektedir.
Katkının niteliği: Yazar katkıyı açıkça “diagnostic”, yani teşhis edici olarak tanımlamaktadır. Makale tek bir kapsamlı çözüm modeli veya yeni tespit algoritması önermemektedir.
Temel yorum sınırı: Kapasite açığı göreli bir kavramdır. Doğrulama faaliyetinin mutlak olarak azaldığı veya bütün tespit sistemlerinin başarısız olduğu anlamına gelmez; sorun, doğrulama kapasitesindeki gelişmenin karşısındaki problem yüzeyinin genişlemesiyle aynı hızda gerçekleşmemesidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir