

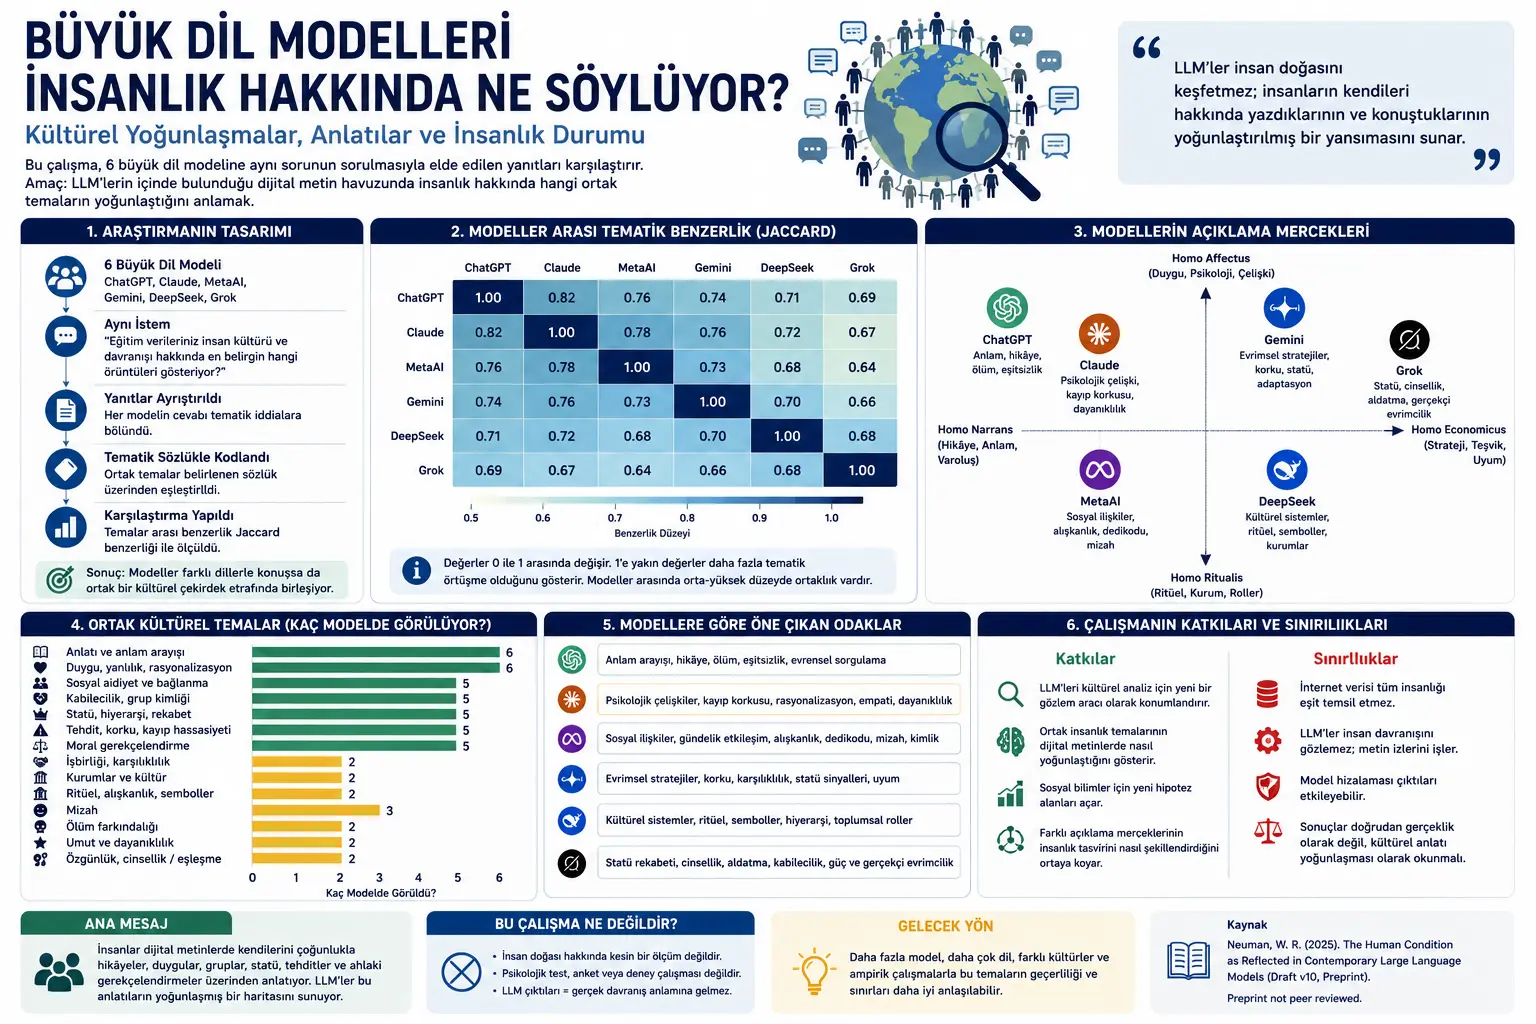
Bu çalışma yapay zekâ, kültür sosyolojisi, sosyal psikoloji, antropoloji, moral psikoloji ve büyük dil modelleri üzerinden kültürel analiz alanlarının kesişiminde yer alan bir taslak/preprint makaledir. Metinde “Draft v10” ve “Preprint not peer reviewed” ifadeleri yer aldığı için çalışma hakemli dergi makalesi olarak değil, tartışmaya açılmış teorik ve karşılaştırmalı bir araştırma taslağı olarak değerlendirilmelidir.
Makalenin ana konusu, büyük dil modellerinin insanlık hakkında ne söylediği değil; insan kültürünün dijital metinlerde nasıl yoğunlaştığı ve bu yoğunlaşmanın farklı LLM çıktılarında hangi ortak temalarla göründüğüdür. LLM, “large language model” ifadesinin kısaltmasıdır ve büyük metin koleksiyonları üzerinde eğitilmiş, dil üretme ve anlam örüntülerini tahmin etme kapasitesine sahip yapay zekâ modelini ifade eder.
Çalışmanın temel kavramı “cultural condensate” yani “kültürel yoğunlaşma”dır. Yazar, LLM’leri insan davranışının doğrudan aynası olarak değil, insanların kendileri hakkında nasıl konuştuğunu, neyi gerekçelendirdiğini, neyi tartıştığını ve hangi anlatıları tekrar ettiğini sıkıştırılmış biçimde taşıyan kültürel nesneler olarak ele alır.
Bu içerik psikolojik/psikiyatrik tavsiye değildir. Makale insan davranışı, moral psikoloji, grup kimliği, statü, korku, aidiyet ve sosyal çatışma gibi hassas konulara temas eder; burada amaç, çalışmanın akademik iddiasını sadeleştirmek ve eleştirel biçimde açıklamaktır.
Makale, altı çağdaş büyük dil modeline aynı temel sorunun sorulmasıyla başlıyor: Eğitim verileriniz insan kültürü ve davranışı hakkında en belirgin hangi örüntüleri gösteriyor? İncelenen modeller ChatGPT, Claude, MetaAI, Gemini, DeepSeek ve Grok’tur. Her modelin cevabı ayrı ayrı temalara bölünür ve ortak bir tematik sözlük üzerinden karşılaştırılır.
Çalışmanın ana bulgusu, farklı modellerin insanlık hakkında şaşırtıcı ölçüde benzer temalara işaret etmesidir. Bu temalar arasında anlatı kurma, anlam arayışı, duygunun akıldan önce gelmesi, sosyal aidiyet, kabilecilik, statü rekabeti, tehdit hassasiyeti, moral gerekçelendirme, ölüm farkındalığı ve dayanıklılık yer alır.
Yazar bu benzerliği, LLM’lerin “insan doğasını keşfettiği” şeklinde yorumlamaz. Daha dikkatli bir iddia kurar: LLM’ler, insanların dijital metinlerde kendilerini nasıl anlattığını, hangi sorunları tekrar tekrar işlediğini ve hangi açıklama biçimlerini kültürel olarak baskın hale getirdiğini gösterebilir.
Çalışmanın en önemli uyarısı da buradadır. LLM çıktıları, insan davranışının doğrudan ölçümü değildir. Modeller, özellikle çevrim içi, yazıya dökülmüş, kamuya açık, belirli kültürel ve demografik ağırlıkları olan veri dünyasından beslenir. Bu nedenle sonuçlar “tüm insanlık böyledir” diye değil, “dijital metinlerde insanlık kendini çoğunlukla böyle anlatır” diye okunmalıdır.
Problem Ne?
İnsanlık durumu, insanların yaşam boyunca tekrar tekrar karşılaştığı temel sorunları anlatan geniş bir kavramdır. Anlam arayışı, ölüm farkındalığı, sevgi, korku, statü, aidiyet, ahlak, çatışma, umut ve kimlik gibi konular bu başlık altında düşünülebilir. Felsefe, edebiyat, antropoloji, sosyoloji ve psikoloji bu soruyu yüzyıllardır farklı biçimlerde ele alır.
Makalenin çıkış noktası şudur: Büyük dil modelleri, trilyonlarca kelimelik dijital metin yığınları üzerinde eğitilir. Bu metinler romanlardan haber yazılarına, akademik metinlerden forumlara, sosyal medya konuşmalarından teknik belgeler ve tartışma yazılarına kadar geniş bir insan anlatısı havuzunu içerir. Bu nedenle LLM’ler, insanlığın kendisi hakkında ürettiği metinsel izlerin yoğunlaştırılmış bir temsilini taşıyabilir.
Ancak burada ciddi bir yöntemsel problem vardır. LLM’ler insan davranışını gözlemlemez; yalnızca insan davranışı hakkında yazılmış, paylaşılmış, indekslenmiş ve modele ulaşmış metinleri işler. İnsanların gerçekten ne yaptığı ile insanların kendileri hakkında ne söylediği aynı şey değildir. Bir toplumun dijital metinlerde çok konuştuğu konu, o toplumun tüm gerçekliğini temsil etmeyebilir.
İkinci problem temsil sorunudur. İnternet verisi tüm insanlığı eşit temsil etmez. Bazı ülkeler, diller, sınıflar, eğitim düzeyleri ve kültürel gruplar çevrim içi metin üretiminde daha görünürdür. Bazı topluluklar ise ya az temsil edilir ya da kendilerini kamusal metin alanında farklı biçimde ifade eder. Bu nedenle LLM’lerden çıkan “insanlık portresi”, insanlığın tamamının değil, dijitalleşmiş ve görünür hale gelmiş kültürel anlatıların portresidir.
Üçüncü problem model hizalamasıdır. Güncel LLM’ler yalnız ham ön eğitim verisiyle çalışmaz; güvenli, yardımcı, zararsız ve toplumsal olarak kabul edilebilir cevaplar vermeleri için ince ayar süreçlerinden geçirilir. RLHF, yani insan geri bildirimiyle pekiştirmeli öğrenme, model çıktılarının hangi tonda, hangi sınırlarla ve hangi değer vurgularıyla verileceğini etkileyebilir. Bu nedenle farklı modeller aynı veri dünyasına baksalar bile farklı açıklama mercekleriyle konuşabilir.
Yöntem Ne Öneriyor?
Çalışma deneysel psikoloji anlamında doğrudan insan deneyi yapmaz. Bunun yerine karşılaştırmalı LLM çıktısı analizi kullanır. Altı büyük dil modeline aynı türde bir istem verilmiştir: Eğitim verilerinizde insan kültürü ve davranışı hakkında en belirgin hangi içgörüleri görüyorsunuz?
Modellerin cevapları daha sonra ayrı ayrı iddialara bölünür. Her iddia, önceden oluşturulan ya da analiz sırasında netleşen tematik bir sözlükle eşleştirilir. Tema, burada tekrar eden kültürel anlam kalıbı demektir. Örneğin “insanlar hikâyelerle anlam kurar”, “insanlar gruplara bağlanır”, “duygular akıldan önce gelir” ya da “statü rekabeti davranışları şekillendirir” gibi iddialar birer tema olarak kodlanır.
Çalışmada kullanılan temalar arasında anlatı ve anlam kurma, duygu ve bilişsel yanlılık, sosyal aidiyet, kabilecilik ve koalisyon psikolojisi, statü ve hiyerarşi, korku ve kayıp hassasiyeti, karşılıklılık ve işbirliği, kurumlar ve kültür sistemleri, ritüel ve alışkanlık, mizah, ölüm farkındalığı, umut ve dayanıklılık, özgünlük ve cinsellik/eşleşme dinamikleri bulunur.
Yazar, modeller arasındaki benzerliği Jaccard benzerliğiyle ölçer. Jaccard benzerliği, iki kümenin ortak öğelerini, toplam farklı öğelerine oranlayan bir ölçüdür. Burada her modelin verdiği tema kümesi birer liste gibi düşünülür. İki model aynı temalara ne kadar çok değindiyse benzerlik değeri o kadar yükselir.
Yöntemin amacı, LLM’lerin söylediklerini “bilimsel gerçek” olarak kabul etmek değildir. Amaç, farklı model mimarileri, hizalama stratejileri ve açıklama tarzları arasında hangi kültürel temaların tekrar ettiğini görmek ve bu tekrar eden temaları sosyal bilimler için araştırma hipotezleri olarak değerlendirmektir.
Formüller Ne Anlatıyor?
Çalışmada ağır matematiksel modelleme bulunmamaktadır; ancak modeller arası tematik örtüşmeyi göstermek için Jaccard benzerliği kullanılır. Bu formül, makaledeki temel ölçüm mantığının en açık matematiksel ifadesidir.
Bu formülde \(A\) ve \(B\), iki farklı modelin tespit edilen tema kümelerini temsil eder. \(A\cap B\), iki modelin ortak temalarını; \(A\cup B\), iki modelde görülen toplam benzersiz temaları gösterir. Sonuç 0 ile 1 arasında değişir. 1’e yakın değerler, iki modelin tematik olarak daha fazla örtüştüğünü; 0’a yakın değerler ise daha az ortak tema bulunduğunu anlatır.
Bu şema, çalışmanın ana varsayımını sadeleştirir. LLM çıktısı yalnız eğitim verisinin doğrudan kopyası değildir. Model mimarisi, eğitim süreci, veri seçimi, hizalama ve cevap verme tarzı da ortaya çıkan kültürel portreyi etkiler.
Bu ifade, altı modelde tekrar eden ana temaları gösterir. Modeller farklı tonlarla konuşsa da insanı çoğunlukla hikâye kuran, duyguyla karar veren, gruplara bağlanan, statüye duyarlı, tehdide hassas ve davranışlarını ahlaki anlatılarla gerekçelendiren bir varlık olarak betimler.
Bu kısa ifade, çalışmanın model karşılaştırmasıyla ilgili ana sonucunu özetler. Modeller çoğu temel temada ayrışmaz; daha çok hangi açıklama düzeyini öne çıkardıkları konusunda farklılaşır. Biri varoluşçu, biri psikolojik, biri evrimsel, biri antropolojik veya gündelik sosyal ilişkilere daha yakın bir açıklama dili kullanabilir.
Bu şema, çalışmanın sosyal bilimlere önerdiği kullanımı anlatır. LLM çıktıları, doğrudan sonuç kabul edilmemeli; deney, anket, etnografi ve tarihsel analiz için yeni araştırma soruları üretmekte kullanılmalıdır.
Grafik, Tablo ve Şema Ana Mesajı
Çalışmanın ilk görseli Jaccard benzerliği matrisidir. Bu matris, altı modelin tema kümeleri arasındaki örtüşmeyi gösterir. Diyagonal değerler doğal olarak 1’dir; çünkü her model kendisiyle tam benzerlik taşır. Diyagonal dışındaki değerler ise iki modelin aynı temalara ne ölçüde değindiğini gösterir. Ana mesaj, modeller arasında orta-yüksek düzeyde tematik ortaklık bulunduğudur.
Bu matris okuyucuya şunu anlatır: Modellerin cümleleri, üslupları veya tercih ettikleri açıklama dili farklı olabilir; fakat insanlık hakkında tekrar eden büyük temalarda belirgin bir ortak çekirdek vardır. Anlatı kurma, duygu, aidiyet, statü, korku ve ahlaki gerekçelendirme gibi temalar birden fazla modelde güçlü biçimde görünür.
İkinci görsel, modelleri iki eksenli bir açıklama alanına yerleştirir. Yatay eksen Homo Narrans ile Homo Economicus arasında uzanır. Homo Narrans, insanı hikâye kuran ve anlam arayan varlık olarak görür. Homo Economicus ise insanı stratejik uyum, çıkar, teşvik ve kısıtlar içinde karar veren varlık olarak açıklar.
Dikey eksen Homo Affectus ile Homo Ritualis arasında uzanır. Homo Affectus, duygu, bilişsel yanlılık, çelişki, kayıp korkusu ve psikolojik dayanıklılık gibi içsel süreçlere odaklanır. Homo Ritualis ise kurumlar, roller, ritüeller, semboller ve toplumsal beklenti sistemlerini öne çıkarır.
Bu şemanın ana mesajı şudur: Modeller insanlık konusunda tamamen farklı sonuçlara ulaşmıyor; insanlığı farklı açıklama katmanlarından anlatıyor. ChatGPT daha varoluşsal ve anlatı merkezli; Claude daha psikolojik ve çelişki-toleranslı; MetaAI gündelik sosyal ilişkiler ve alışkanlıklara yakın; Gemini evrimsel-bilişsel; DeepSeek yapısal-antropolojik; Grok ise daha sert ve evrimsel gerçekçi bir anlatım sunuyor.
Ek tabloda model bazlı lensler özetlenir. ChatGPT anlam, anlatı, ölüm ve eşitsizlik; MetaAI bağlantı, alışkanlık, dedikodu ve mizah; Claude bilişsel çelişki, kayıp korkusu ve dayanıklılık; Gemini korku, karşılıklılık, statü ve adaptasyon; DeepSeek ritüel, araçlar, semboller ve güç; Grok ise cinsellik, statü, aldatma ve kabilecilik gibi temaları daha belirgin biçimde öne çıkarır.
Temaların yaygınlık özeti de önemlidir. Anlatı/anlam kurma ve duygu/yanlılık/rasyonalizasyon 6 modelin tamamında görünür. Sosyal aidiyet, kabilecilik, statü ve korku temaları 5 modelde yer alır. Mizah 3 modelde; kurumlar, karşılıklılık ve işbirliği 2 modelde; ölüm farkındalığı, umut, ritüel, özgünlük ve cinsellik ise daha sınırlı biçimde görünür. Bu dağılım, hangi temaların ortak çekirdeğe daha yakın olduğunu gösterir.
Deneyler Nasıl Yapılmış?
Bu çalışma klasik laboratuvar deneyi değildir. İnsan katılımcılar üzerinde deney yapılmamış, psikolojik ölçek uygulanmamış ve doğrudan davranış gözlenmemiştir. Bunun yerine altı LLM’den alınan paralel cevaplar karşılaştırılmıştır.
İlk aşamada her modele insan kültürü ve davranışı hakkında eğitim verilerinden ne öğrendiğini soran bir istem verilmiştir. Bu istem, modellerin geniş eğitim verilerinde insanlık hakkında hangi temaları öne çıkardığını ortaya çıkarmayı amaçlar.
İkinci aşamada cevaplar küçük iddia birimlerine ayrılmıştır. Örneğin “insanlar anlam arar”, “insanlar statüye duyarlıdır”, “moral akıl yürütme çoğu zaman duygusal sezgiden sonra gelir” gibi ifadeler ayrı tematik iddialar olarak değerlendirilmiştir.
Üçüncü aşamada bu iddialar ortak bir tematik sözlükle kodlanmıştır. Bir tema açıkça söylenmişse ya da güçlü biçimde ima edilmişse o model için mevcut sayılmıştır. Böylece her modelin cevapları, metin uzunluğundan ve üsluptan bağımsız olarak tema kümesine dönüştürülmüştür.
Dördüncü aşamada modellerin tema kümeleri Jaccard benzerliğiyle karşılaştırılmıştır. Bu yöntem, modellerin aynı temalara ne ölçüde ulaştığını göstermek için kullanılmıştır. Sonuç, kelime benzerliğini değil, tematik yapı benzerliğini ölçer.
Beşinci aşamada yazar, benzerlik kadar farklılıkları da yorumlamıştır. Modellerin farklılaştığı yerler çoğunlukla konu seçiminden çok açıklama diliyle ilgilidir. Bir model insanı anlam arayan varlık olarak, diğeri statü ve rekabet içinde, bir başkası ritüel ve kurumlar içinde, bir diğeri psikolojik çelişkiler içinde açıklayabilir.
Sonuçlar Ne Gösteriyor?
Çalışmanın ilk sonucu, altı model arasında güçlü bir ortak kültürel çekirdek bulunduğudur. İnsanlar, LLM çıktılarında çoğunlukla hikâye kuran, anlam arayan, duygularla hareket eden, sosyal aidiyete ihtiyaç duyan, gruplar arası ayrım yapan, statüye duyarlı ve tehdide hassas varlıklar olarak görünür.
İkinci sonuç, modellerin insanlık hakkında tamamen farklı antropolojiler üretmediğidir. Farklılıklar daha çok açıklama katmanında ortaya çıkar. ChatGPT daha felsefi ve varoluşsal bir portre çizerken, Claude psikolojik çelişki ve dayanıklılık üzerinde durur. MetaAI gündelik sosyal bağları vurgular. Gemini evrimsel stratejilere, DeepSeek kültürel sistemlere, Grok ise daha açık biçimde cinsellik, statü, aldatma ve koalisyon davranışlarına yönelir.
Üçüncü sonuç, LLM’lerin sosyal bilimlerde yardımcı bir keşif aracı olarak kullanılabileceğidir. Yazar, LLM’lerin insan davranışı hakkında yeni kesin gerçekler sunduğunu iddia etmez. Bunun yerine, hangi yorumların kültürel olarak baskın, görünür ve tekrar eden olduğunu gösterebileceğini savunur.
Dördüncü sonuç, moral psikoloji açısından önemlidir. Modellerin çoğu, insan ahlakını yalnız soyut ilkelere dayalı rasyonel karar gibi değil, duygu, sezgi, grup kimliği, gerekçelendirme ve sosyal sinyalleşme içinde gelişen bir süreç olarak betimler. Bu, moral akıl yürütmenin çoğu zaman kararın başlangıcı değil, karar sonrası gerekçelendirme aracı olarak çalışabileceği fikriyle uyumludur.
Beşinci sonuç, kültürel sembolizmin ve evrimsel psikolojinin birlikte düşünülmesi gerektiğidir. İnsanlar yalnız biyolojik stratejilerle açıklanamaz; fakat statü, tehdit, karşılıklılık ve koalisyon gibi evrimsel izler kültürel semboller, ritüeller, kurumlar ve anlatılar içinde genişler.
Bu Neden Önemli?
Bu çalışma, LLM’leri yalnız metin üreten araçlar olarak değil, kültürel araştırma nesnesi olarak düşünmeye çağırır. Bir LLM’nin cevabı, “modelin hakikati” değildir; fakat modelin eğitim verilerinde tekrar eden kültürel anlatıların nasıl yoğunlaştığını gösterebilir.
Sosyal bilimler açısından bu önemlidir. Laboratuvar deneyleri belirli mekanizmaları izole eder. Anketler insanların ne düşündüğünü ölçmeye çalışır. Etnografi belirli bağlamlarda derinlik sağlar. LLM analizi ise geniş metin alanlarında hangi temaların, kavramların ve anlatı kalıplarının tekrar ettiğini gösterebilir. Bu yöntem, diğer yöntemlerin yerine geçmez; onları tamamlayabilir.
Çalışmanın önerdiği en yararlı kullanım hipotez üretimidir. Örneğin bir model birçok alanda “statü kaygısı” temasını öne çıkarıyorsa, araştırmacı bunu doğrudan gerçek kabul etmez; ama yeni deneyler, anketler ya da nitel çalışmalar için araştırılabilir bir değişken olarak ele alabilir.
Toplumsal çatışmalar açısından da makale dikkat çekicidir. Eğer LLM’ler insan anlatılarında kabilecilik, tehdit hassasiyeti, statü rekabeti ve moral rasyonalizasyonu sık görüyorsa, bu temalar siyasal kutuplaşma, çevrim içi tartışmalar, örgütsel çatışma ve kültür savaşları için yeni analiz alanları açabilir.
Verianla açısından çalışma, yapay zekâyı yalnız teknik ürün olarak değil, kültürel hafızanın yoğunlaştırılmış bir yüzeyi olarak okumaya imkân verir. Ancak bu yüzey dikkatle okunmalıdır: LLM’ler insanlığın kendisi değil, insanlığın dijital metinlerde bıraktığı izlerin işlenmiş ve hizalanmış temsilidir.
Dikkat Noktaları
Çalışma preprint/taslak niteliğindedir ve hakem değerlendirmesinden geçmemiştir. Bu nedenle yöntem, tema kodlama yaklaşımı, model seçimi ve yorumlar akademik inceleme sürecinde değişebilir.
LLM’ler insan davranışını doğrudan gözlemlemez. Modellerin çıktıları, insanların kamusal ve dijital metinlerde kendileri hakkında nasıl konuştuklarını yansıtır. Bu nedenle sonuçlar “insan doğası kesin olarak böyledir” şeklinde okunmamalıdır.
Veri temsili ciddi bir sınırlılıktır. İnternet verisi Batı merkezli, eğitimli, dijital olarak aktif ve yazılı ifade gücü yüksek grupları daha fazla temsil edebilir. Sessiz kalan, çevrim dışı yaşayan, az yazan ya da farklı dillerde daha az görünür olan topluluklar bu kültürel yoğunlaşmada zayıf temsil edilebilir.
Model hizalaması da sonucu etkileyebilir. RLHF ve güvenlik ayarları, modellerin bazı temaları daha nazik, daha felsefi, daha psikolojik, daha güvenli veya daha az tartışmalı biçimde ifade etmesine neden olabilir. Bu nedenle model farkları yalnız eğitim verisinden değil, sonradan yapılan ince ayarlardan da kaynaklanabilir.
Jaccard benzerliği tema örtüşmesini ölçer; fakat temaların önem sırasını, duygusal tonunu, anlatı bağlamını veya kültürel derinliğini tek başına yakalamaz. İki model aynı temayı işaretleyebilir ama o temayı farklı teorik çerçeveyle açıklayabilir.
Bu içerik psikolojik/psikiyatrik tavsiye değildir. İnsan davranışı, moral karar verme, kutuplaşma ve sosyal çatışma gibi konular, bireysel veya toplumsal kararlar için uzmanlık, yerel bağlam ve çoklu veri kaynağı gerektirir.
Sonuç
Makale, büyük dil modellerini insanlık hakkında kesin hüküm veren makineler olarak değil, kültürel anlatıların yoğunlaştığı yeni araştırma nesneleri olarak ele alıyor. Altı modelin verdiği cevaplar arasında belirgin bir ortak çekirdek vardır: İnsanlar anlam arar, hikâyeler kurar, duygularla yola çıkar, gruplara bağlanır, statüye duyarlıdır, tehdide güçlü tepki verir ve davranışlarını ahlaki gerekçelerle anlatır.
Bu ortak çekirdek, insan davranışının doğrudan ölçümü değildir; fakat insanların kendi yaşamlarını nasıl anlattığına dair güçlü bir kültürel izdir. Modeller arasındaki farklılıklar ise insanlık hakkında temel anlaşmazlıktan çok, açıklama merceklerindeki farkı gösterir. Aynı insanlık portresi, felsefi, psikolojik, evrimsel, antropolojik veya gündelik sosyal ilişki odaklı biçimde anlatılabilir.
Çalışmanın en değerli yönü, LLM’leri sosyal bilimlerde hipotez üretimi için kullanılabilecek bir araç olarak konumlandırmasıdır. LLM’ler araştırmanın yerine geçmez; fakat hangi temaların kültürel olarak baskın olduğunu, hangi çelişkilerin tekrar ettiğini ve hangi sosyal sorunların dilde nasıl biçimlendiğini gösterebilir.
Verianla için bu çalışma, yapay zekâ çağında eski bir soruya yeni bir pencere açıyor: İnsanlık kendini nasıl anlatıyor? Cevap, modellerin içinde değil; modellerin yoğunlaştırdığı devasa insan metinlerinde ve o metinleri nasıl yorumladığımızda yatıyor.
Kaynak ve Yöntem Notu
Bu yazı, W. Russell Neuman tarafından hazırlanan “The Human Condition as Reflected in Contemporary Large Language Models” başlıklı taslak/preprint çalışma temel alınarak hazırlanmıştır. Çalışma; ChatGPT, Claude, MetaAI, Gemini, DeepSeek ve Grok modellerinin insan kültürü ve davranışı hakkındaki yanıtlarını karşılaştırarak anlatı, duygu, sosyal aidiyet, kabilecilik, statü, tehdit hassasiyeti, moral gerekçelendirme ve kültürel yoğunlaşma kavramlarını tartışmaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Metin, hakem değerlendirmesinden geçmemiş bir taslak/preprint üzerinden hazırlanmıştır. LLM çıktıları doğrudan insan davranışının kanıtı olarak değil, dijital metinlerde tekrar eden kültürel anlatıların analiz edilebilir yoğunlaşmaları olarak değerlendirilmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir