

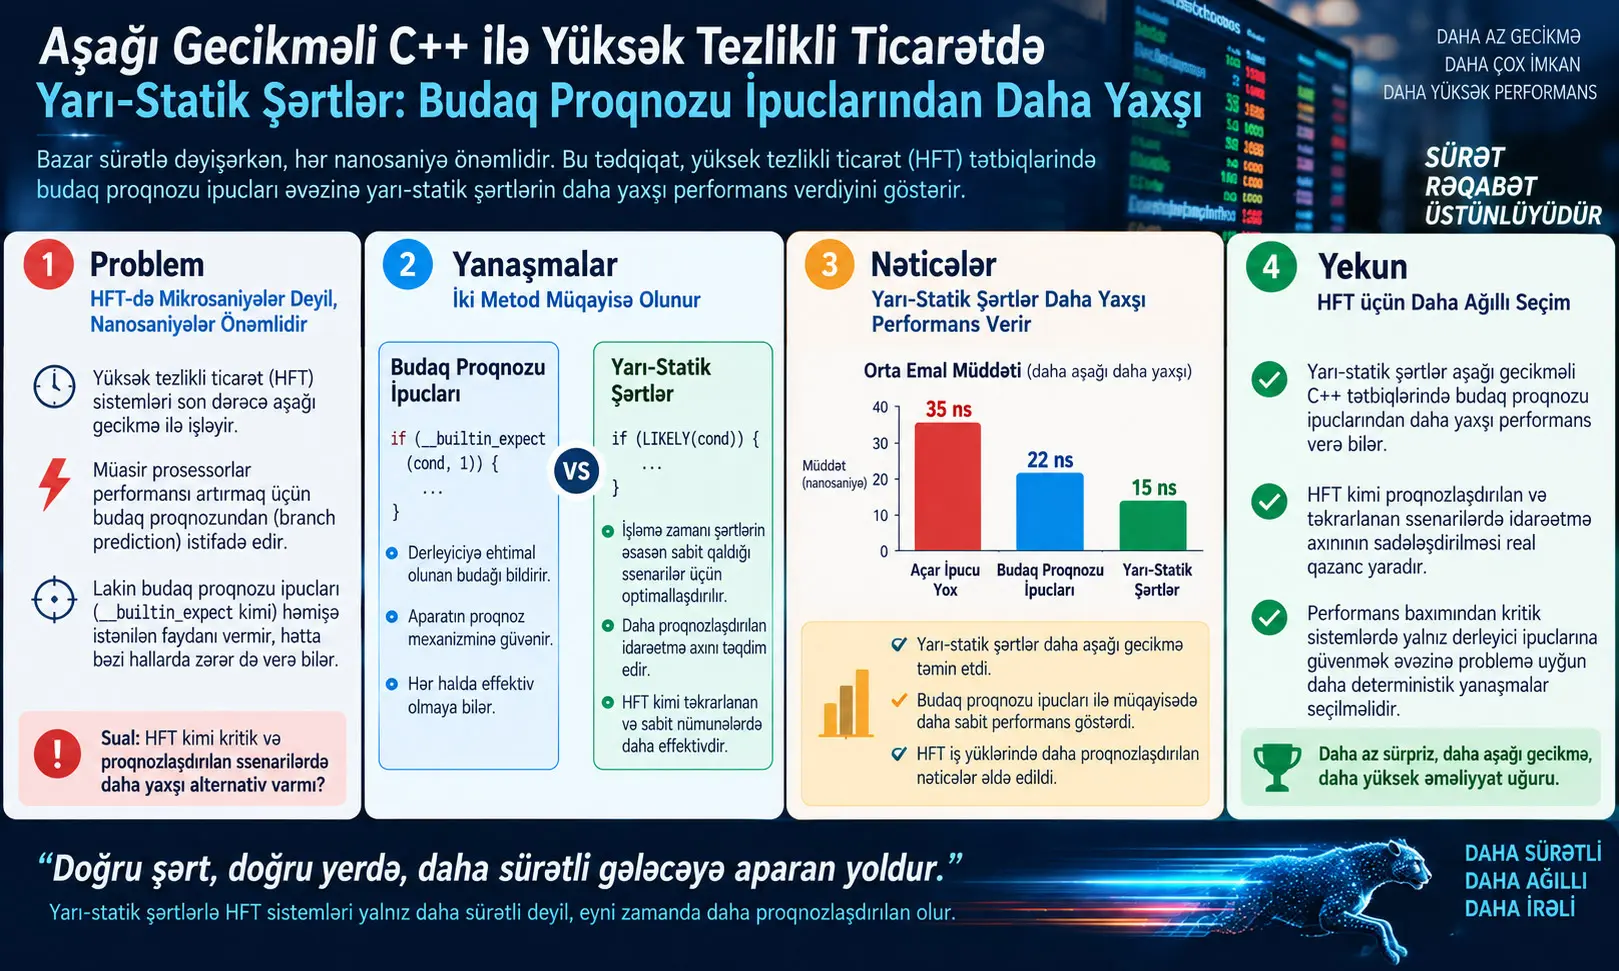
Yarı-statik şərt (semi-static condition), icra zamanı seçiləcək icra istiqamətini dəyişdirərkən gecikməyə həssas kod yolunda ənənəvi şərti budaq qiymətləndirilməsinə ehtiyac qoymamaq üçün işləyən icra olunan faylın maşın kodundakı nisbi keçid hədəfini dəyişdirən C++ idarəetmə axını strukturudur. Paul Alexander Bilokon, Maximilian Lucuta və Erez Shermer tərəfindən hazırlanmış yanaşma, baha başa gələn şərt qiymətləndirilməsi və maşın kodunun dəyişdirilməsi əməliyyatını performans baxımından kritik olmayan yola daşıyarkən, kritik yoldakı branch çağırışını birbaşa funksiya çağırışına yaxın qiymətə malik nisbi keçidə çevirməyi hədəfləyir.
Tədqiqatın əsas ideyası müasir prosessorların şərti budaqları hər dəfə daha yaxşı proqnozlaşdırmasına çalışmaqdansa, müəyyən istifadə ssenarilərində proqnozlaşdırılması tələb olunan şərti budağı kritik icra yolundan tamamilə çıxarmaqdır. Bunun üçün set_direction əməliyyatı hansı funksiyanın işlədiləcəyini əvvəlcədən müəyyənləşdirir və müvafiq 32-bit nisbi keçid ofsetini işləyən kodun içinə yazır; daha sonra branch çağırışı şərti yenidən qiymətləndirmədən həmin hədəfə yönəlir.
Intel Core i7-10700 üzərində aparılan mikrobenchmarklarda birbaşa funksiya çağırışının median xərci 9 CPU dövrü, yarı-statik branch çağırışının medianı 10 dövr və hər ikisinin standart sapması 1 dövr olaraq ölçülmüşdür. Təsadüfi və proqnozlaşdırılması çətin iki istiqamətli HFT-bənzəri isti yol testində keş isitməsi olmadan ənənəvi şərti budaqlanma 75 dövr median və 10 dövr standart sapma göstərdiyi halda, yarı-statik şərtlər 63 dövr median və 3 dövr standart sapma göstərmişdir. Keş isitməsi ilə göstəricilər müvafiq olaraq 68±8 və 62±2 dövr olmuşdur.
Üstünlük şərtsiz deyil. İşləyən maşın kodunun dəyişdirilməsi self-modifying code (SMC) mexanizmlərini işə sala bilər. Assembly dəyişikliyindən dərhal sonra dəyişdirilmiş kodun icra edildiyi testdə SMC machine clear təsirləri icra müddətini təxminən 30–40 dəfə artırmış və təxminən 100 dövrlük əlavə cəzalar müşahidə olunmuşdur. Buna görə metod branch istiqamətinin tez-tez dəyişdirilib dərhal sonra icra edildiyi sıx dövrlər üçün uyğun deyil. Tədqiqatın təklif etdiyi istifadə modeli baha set_direction əməliyyatını “soyuq” yola daşımaq və ucuz branch əməliyyatını gecikməyə həssas “isti” yolda istifadə etməkdir.
Yarı-Statik Şərt Nədir?
Yarı-statik şərt, şərtin qiymətləndirilməsi ilə seçilmiş kod budağının icrasını iki ayrı zaman əməliyyatına ayıran və seçilmiş budağı sonradan nisbi maşın-kodu keçidi vasitəsilə çağıran proqramlaşdırma idarəetmə axını strukturudur. “Statik” tərəfi kritik branch çağırışı zamanı hədəfin əvvəlcədən müəyyən edilmiş olmasıdır; “yarı” tərəfi isə proqramın icra zamanı bu hədəfi set_direction ilə yenidən dəyişdirə bilməsidir.
Adi C++ şərti ifadəsinin məntiqi konseptual olaraq belədir: prosessor bir şərti oxuyur, müqayisə aparır, şərti keçid əmrinə çatır və branch predictor hansı yolun izlənəcəyini proqnozlaşdırır. Proqnoz doğrudursa xərc aşağıdır; yanlışdırsa spekulyativ şəkildə gətirilmiş və qismən emal edilmiş əmrlərin təmizlənməsi lazım gələ bilər.
Yarı-statik yanaşmada isə şərt kritik yol başlamazdan əvvəl qiymətləndirilir. Proqram hansı funksiyanın hədəf olacağını müəyyənləşdirərək branch giriş nöqtəsindəki nisbi jmp əmrinin displacement sahəsini dəyişdirir. Kritik hadisə baş verdikdə şərt yenidən oxunmur; idarəetmə axını birbaşa əvvəlcədən seçilmiş funksiyaya yönəlir.
Niyə klassik branch predictor kifayət hesab edilməmişdir?
Müasir branch predictor-lar bir çox budağı çox yüksək dəqiqliklə proqnozlaşdıra bilir. Tədqiqat xüsusilə keçmişlə güclü korrelyasiyası olmayan, giriş məlumatından asılı olan və ya nadir işlədiyi üçün kifayət qədər tarixçə yaratmayan budaqlara fokuslanır. Bu problem HFT kimi aşağı gecikməli sistemlərdə vacibdir; çünki kritik yol fasiləsiz işləməyə bilər, lakin işlədiyi anda mümkün qədər aşağı və proqnozlaşdırıla bilən gecikmə göstərməlidir.
C++20-nin [[likely]] və [[unlikely]] atributları bu problemi birbaşa aparat branch predictor-ına “bu budağı proqnozlaşdır” əmri göndərərək həll etmir. Mənbədə izah edildiyi kimi, kompilyator bu məlumatı kod yerləşimini və ehtimal olunan isti/soyuq yolların assembly quruluşunu dəyişdirmək üçün istifadə edir. Real vaxt şərt paylanması sonradan dəyişərsə, bu kompilyasiya vaxtı seçimi dinamik şəkildə yenilənmir.
Yarı-Statik Şərtlər Budaq Proqnozundan Necə Fərqli İşləyir?
Yarı-statik şərtlər şərti budağın nəticəsini daha yaxşı proqnozlaşdırmağa çalışmaqdansa, kritik yoldakı şərti budaq əmrini proqramçı tərəfindən istiqaməti dəyişdirilə bilən birbaşa nisbi keçidə çevirir. Beləliklə, execute mərhələsində həll olunan klassik şərti-budaq yanlış proqnozlarının yerini hədəf dəyişdirildikdə daha erkən mərhələdə ortaya çıxa bilən BTB/BAC hədəf düzəlişləri tutur.
BranchChanger strukturu
Prototipdə əsas abstraksiya BranchChanger sinfidir. Sinif başlanğıcda iki funksiya ünvanı alır. set_direction(condition) icra vaxtındakı şərtə görə hansı hədəfin aktiv olacağını müəyyənləşdirir; branch(...) isə seçilmiş hədəfə keçir.
Funksiyaların arqument və qaytarma tipləri template deduction vasitəsilə əldə edilir. Beləliklə, branch giriş nöqtəsinin imzası hədəf funksiyaların çağırış konvensiyası ilə uyğunlaşdırılır. Mənbədə adi üzv funksiyanın gizli this göstəricisi yaratması səbəbindən başlanğıcda üzləşilən registr sürüşməsi problemi izah olunur və əsas prototipdə branch metodunun statik edilməsi seçilir.
Nisbi keçid ofseti
x86 arxitekturasındakı nisbi jmp/call mexanizmində hədəf ünvan birbaşa tam ünvan kimi deyil, cari əmr mövqeyinə görə bir displacement kimi kodlanır. Mənbənin istifadə etdiyi əsas əlaqə belədir:
Jump Offset, maşın əmrinə yazılacaq nisbi məsafədir. Target Address, icra ediləcək if/else funksiyasının giriş ünvanıdır. Entry Point, dəyişdirilən branch giriş nöqtəsini; Size of Instruction isə nisbi keçid əmrinin uzunluğunu bildirir. x86 tətbiqində iş bir baytlıq e9 opcode və onun ardınca gələn dörd baytlıq displacement sahəsindən istifadə edir.
Bu riyaziyyat branch davranışının niyə sadəcə bir Boolean dəyişəninin dəyişdirilməsindən ibarət olmadığını göstərir. Proqram icra olunan kod seqmentinin mövqeyini, hədəf funksiyanın ünvanını və əmr uzunluğunu nəzərə alaraq real maşın kodunu dəyişdirir.
İşləyən kod necə dəyişdirilir?
Maşın əmrləri adətən virtual ünvan məkanındakı executable/text səhifələrində yerləşir və yazmaya bağlıdır. Prototip icra zamanı branch funksiyasının ünvanından müvafiq səhifəni tapır, Linux mprotect mexanizmi ilə səhifə icazələrini dəyişdirir və nisbi keçid displacement-ını yazıla bilən hala gətirir.
Address Space Layout Randomization (ASLR) səbəbindən icra olunan kodun real icra vaxtı ünvanı əvvəlcədən sabit qəbul edilmir. Buna görə ünvan həlli və səhifə hizalama əməliyyatları proqram işləyərkən aparılır.
Branch-Changing və Branch-Taking Niyə Ayrılır?
İki əməliyyat ayrılır, çünki branch istiqamətini dəyişdirmək işləyən executable yaddaşa yazma tələb edən nisbətən bahalı əməliyyatdır; branch-taking isə düzgün hazırlanmış vəziyyətdə yalnız birbaşa funksiya çağırışına əlavə olunan qısa nisbi keçid xərcinə endirilə bilər. Mənbənin optimallaşdırma strategiyası bahalı əməliyyatı gecikməyə həssas olmayan kodda amortizasiya etmək və kritik yolda yalnız ucuz əməliyyatı saxlamaqdır.
Self-modifying code cəzası
Prosessorlar işləyən kodun dəyişdirilməsini dəstəkləsə də instruction cache, pipeline və əlaqəli spekulyativ vəziyyətlər dəyişdirilmiş əmrlərlə uyğunsuz qala bilər. Mənbədəki testlər yalnız executable yaddaşa dörd bayt yazmağın özlüyündə adi yaddaşa dörd baytlıq memcpy əməliyyatından nəzərəçarpacaq dərəcədə bahalı olmadığını göstərmişdir: hər iki halda median təxminən 9 dövr, standart sapma isə 1 dövrdür.
Əsas yüksək xərc dəyişdirilmiş əmr çox qısa müddət sonra icra edildikdə meydana çıxmışdır. Bu halda prosessor self-modifying code aşkarlanmasından sonra machine clear yarada bilər; mənbə testində bu davranış təxminən iki təmizləmə/iterasiya səviyyəsinə yüksəlmiş, ümumi icra müddətini təxminən 30–40 dəfə artırmış və SMC təsirinin təxminən 100 dövr səviyyəsində əlavə xərc yaratdığı müşahidə edilmişdir.
Bu tapıntı yarı-statik şərtlərin hər if ifadəsinin yerinə istifadə edilə bilən ümumi drop-in optimallaşdırma olmadığını göstərir. set_direction və branch fasiləsiz ard-arda işləyəcəksə, metodun əsas üstünlüyü aradan qalxa bilər.
BTB və BAC təsiri
Branch Target Buffer (BTB), prosessorun müəyyən program counter mövqeyində budaq olduğunu və hədəfin harada yerləşdiyini proqnozlaşdırmasına kömək edən aparat strukturudur. Branch Address Calculator (BAC) isə hədəf ünvanın doğrulanmasında rol oynayır. Yarı-statik şərtin nisbi jmp hədəfi dəyişdirildikdə BTB-də köhnə hədəf qala bilər.
Tədqiqatdakı təcrübələrdə daim dəyişdirilən hədəflər BAC düzəlişlərini artırmışdır. Hesablama buferi əlavə edildikdə düzəliş sayı təxminən yarıya enərək iterasiya başına təxminən birə düşmüşdür. Müəlliflər BAC düzəlişi üçün təxminən 2,2 ns, yəni istifadə olunan prosessorda təxminən 6 dövr əlavə xərc ölçmüşlər. Bu xərc şərti budaq yanlış proqnozundan aşağıdır və ən vacibi kritik yol işləməzdən əvvəl “isitmə” çağırışı ilə qabaqcadan ödənilə bilər.
Aktiv branch warming
Mənbənin mühüm təkliflərindən biri branch istiqaməti dəyişdirildikdən sonra soyuq yolda saxta və ya təsirsiz çağırışla branch metodunu işlətməkdir. Bu çağırış cari hədəfin BTB tərəfindən öyrənilməsinə, lazımi instruction-cache məlumatının isinməsinə və SMC təsirlərinin kritik yoldan uzağa daşınmasına kömək edir. HFT nümunəsində tədqiqat bunu konseptual olaraq “dummy order” çağırışı ilə izah edir.
HFT sistemi daxilində mövqeyi
Mənbənin Şəkil 7-dəki sadələşdirilmiş HFT arxitekturasında bazar məlumatı şəbəkə qatından maliyyə protokoluna, order book-a və xüsusi tətbiq məntiqinə çatır; tədqiqatın təklif etdiyi optimallaşdırma xüsusi tətbiq tərəfindəki order-action kritik yoluna yönəlir. Metod şəbəkə gecikməsini, exchange matching engine gecikməsini və ya FPGA-nın öz emal müddətini birbaşa optimallaşdıran texnika deyil.
Təhlükəsizlik
İşləyən executable səhifəsinin read/write/execute edilməsi təhlükəsizlik səthini genişləndirir. Mənbə bu riski qəbul edərək set_direction_safe yanaşmasında səhifənin yalnız dəyişiklik zamanı yazıla bilən hala gətirilməsini, sonra yenidən read/execute vəziyyətinə qaytarılmasını təklif edir. Bunun əvəzi iki sistem çağırışı və daha yüksək gecikmə/jitter-dir. Beləliklə, tədqiqatda təhlükəsizlik ilə ən aşağı gecikmə arasında açıq mühəndislik kompromisi mövcuddur.
Thread safety
Assembly hədəfi bütün çağırışlar tərəfindən paylaşılan kod hissəsi olduğundan, eyni vaxtda bir thread hədəfi dəyişdirərkən başqa thread branch çağırışı edə bilər. Mənbə testləri sinxronizasiya olmadan yanlış budağın nadir də olsa icra oluna bildiyini göstərmişdir. Mutex kimi sinxronizasiya düzgün davranışı təmin edir, lakin performans üstünlüyünün mühüm hissəsini aradan qaldırır.
Daşına bilmə
Kitabxana CMake istifadə edən statik kitabxana kimi paketlənmişdir. Mənbənin uyğunluq cədvəli Windows x86-64 və Linux x86-64 üzərində GCC, MSVC və Clang üçün; həmçinin Linux ARM üzərində GCC və Clang üçün sınaqdan keçirilmiş/işlək kombinasiyalar bildirir. macOS kombinasiyaları işlək kimi işarələnməmişdir. Xüsusilə Apple Silicon Hardened Runtime-ın write/execute səhifə icazələrinə qoyduğu məhdudiyyətlər mövcud yanaşma üçün mühüm maneə kimi göstərilir.
Tədqiqatın Metodu və Nəticələri
Tədqiqat iki mərhələdə aparılmışdır. Birinci mərhələdə C++ səviyyəsində BranchChanger prototipi, calling convention uyğunluğu, template deduction, assembly redaktəsi, compiler optimallaşdırmalarına qarşı qoruma, relative jump və daşına bilmə mexanizmləri hazırlanmışdır. İkinci mərhələdə branch-changing və branch-taking komponentləri CPU dövrü, performans sayğacları və daha yüksək səviyyəli mikrobenchmarklarla ölçülmüşdür.
İnkişaf və təcrübə mühiti
- Əməliyyat sistemi: Linux, Ubuntu distributivi.
- Kompilyator: GCC 13.1.
- İnkişaf dili: Mənbənin inkişaf bölməsində C++20.
- Əsas benchmark CPU-su: Intel Core i7-10700, 2,90 GHz.
- Mənbədə bildirilən keş tutumu: 256 KB L1 instruction/data, 2 MB L2 və 16 MB L3.
- Aşağı səviyyəli zaman ölçümü: RDTSC.
- Serializasiya: LFENCE.
- Performans sayğacları: Linux perf və
perf_event_open. - Daha yüksək səviyyəli testlər: Google Benchmark.
RDTSC ölçmələrində prosessorun out-of-order icrasının ölçmə intervalını pozmaması üçün LFENCE istifadə olunmuşdur. Ölçmə infrastrukturunun öz xərci boş ölçmə dövrəsinin çoxsaylı təkrarı ilə müəyyənləşdirilib sonrakı nəticələrdən çıxılmışdır. Mənbə bəzi instruction-level testlərdə təxminən \(10^7\) təkrar istifadə etmişdir.
Əsas benchmark nəticələri
| Test | Ənənəvi / istinad | Yarı-statik şərt | Elmi mənası |
|---|---|---|---|
| Branch-taking vs birbaşa funksiya çağırışı | 9 dövr, SD=1 | 10 dövr, SD=1 | Əlavə nisbi jmp təxminən bir dövrlük fərq yaradır. |
| Təsadüfi HFT-bənzəri isti yol, cache warming yoxdur | 75 dövr, SD=10 | 63 dövr, SD=3 | Şərti budağın predicted/mispredicted qarışığı daha geniş paylanma yaradır. |
| Təsadüfi HFT-bənzəri isti yol, cache warming var | 68 dövr, SD=8 | 62 dövr, SD=2 | Keş təsiri azalanda yarı-statik yolun paylanması daha sıx qalır. |
| Daha çox hesablama ehtiva edən isti yol | 120 dövr, SD=10 | 104 dövr, SD=3 | Qonşu məntiq əlavə edildikdə misprediction təsiri qorunur. |
| 5 vəziyyətli təsadüfi switch | 30 dövr, SD=8 | 8 dövr, SD=1 | Jump-table/indirect-branch xərcləri yüksək yanlış proqnoz nisbətində artır. |
| Proqnozlaşdırıla bilən budaq; istiqamət hər 1000 iterasiyada dəyişir | 64 dövr, SD=3 | 62 dövr, SD=2 | Yanlış proqnoz az olsa da assembly yolundakı əlavə əmrlər kiçik fərq yaradır. |
Mənbənin Şəkil 16-sında təsadüfi şərtlərlə aparılan iki istiqamətli testin conditional-branch paylanması bimodaldır. Cache warming olmadan predicted və mispredicted qruplar təxminən 65 və 78 dövr; warming ilə təxminən 64 və 80 dövr mərkəzlərində görünür. Aradakı 13–16 dövr fərq tədqiqatın istifadə etdiyi arxitekturda klassik yanlış proqnoz cəzasının böyüklüyünü göstərir.
Müəlliflərin hesablamasına görə yarı-statik şərtlər bu təcrübədə orta hesabla təxminən 2–4 ns, budağın daim yanlış proqnozlaşdırıldığı halda isə təxminən 6 ns qənaət təmin etmişdir. Bu dəyərlər ümumi C++ zəmanəti deyil; ölçülən prosessor, kod yerləşimi, keş vəziyyəti, kompilyator və test ssenarisinə xasdır.
[[likely]] və [[unlikely]] niyə təsadüfi şərtlərdə kömək etmədi?
Təsadüfi yaradılan Boolean şərtlərdə iki istiqamət təxminən bərabər ehtimallı olduğundan kompilyatorun etdiyi statik kod yerləşimi real icra vaxtı davranışını proqnozlaşdıra bilməmişdir. Mənbə testlərində [[likely]] və [[unlikely]] istifadəsi yanlış proqnoz nisbətini azaltmamışdır. Bu nəticə yalnız bu test quruluşunun şərtləri altında keçərlidir; atributların bütün proqramlarda təsirsiz olduğu mənasına gəlmir.
N-istiqamətli budaqlanma
Mənbə, təsadüfi seçilən n-istiqamətli if/else və ya switch strukturunda seçimlərin sayı artdıqca doğru hədəfin proqnozlaşdırılmasının çətinləşdiyini bildirir. Beş vəziyyətli switch testində mənbənin Şəkil 18-i ənənəvi switch üçün 30 dövr median və 8 dövr standart sapma; yarı-statik şərt üçün 8 dövr median və 1 dövr standart sapma bildirir. Bu təcrübədə istifadə olunan budaqların boş funksiyalar olması nəticəni real istehsal iş yükünün birbaşa performansı kimi şərh etməyə imkan vermir.
Proqnozlaşdırıla bilən budaqlarda nə baş verdi?
Şərt hər 1000 iterasiyada bir dəyişdirildikdə conventional branch 64 dövr median və 3 dövr standart sapma, yarı-statik yanaşma 62 dövr median və 2 dövr standart sapma göstərmişdir; mənbə bu müqayisə üçün \(P<0.000001\) verir. Müəlliflər təxminən 2–3 dövrlük kiçik fərqi compiler-ın irəli və geri branch yollarında yaratdığı fərqli assembly quruluşları ilə əlaqələndirirlər.
Switch strukturlarında sözügedən kod yerləşimi təsiri daha nəzərəçarpan olmuş və tədqiqatda bəzi predictable-switch şərtlərində yarı-statik yolun təxminən 5–6 dövr daha sürətli olduğu bildirilmişdir.
Branch-changing xərci
Dörd baytlıq istiqamət dəyişikliyinin izolə edilmiş xərci aşağı görünsə də, yazılan ünvan daha əvvəl instruction cache/pipeline strukturlarında olubsa SMC machine clear yarana bilər. Yaxın zamanlı edit-and-execute ssenarisində mənbə təxminən 30–40 dəfə yavaşlama bildirmişdir. Bu, metodun dizaynındakı ən mühüm məhdudiyyətdir.
CLFLUSH ilə əlaqəli instruction-cache sətirlərinin təmizlənməsi və assembly edit ilə branch-taking arasına hesablama buferinin yerləşdirilməsi machine clear sayını azaltmışdır; lakin xərci tamamilə aradan qaldırmamışdır. Mənbə buna görə istiqamət dəyişikliyi ilə branch-taking arasındakı zaman və mikroarxitektura məsafəsini kritik optimallaşdırma parametri kimi qiymətləndirir.
Etibarlılıq və paralellik
Tək thread-li düzgünlük testlərində istiqamət fasiləsiz dəyişdirilib budaq dərhal işlədildikdə gözlənilən funksiyanın icra olunduğu təsdiqlənmişdir. Çox thread-li vəziyyətdə assembly yazılması atomik yüksək səviyyəli branch seçimi təmin etmədiyi üçün race condition yarana bilər. Sinxronizasiya yanlış budağın icrası riskinin qarşısını alır, lakin mənbədəki müqayisələr performansın nəzərəçarpacaq dərəcədə azaldığını göstərir.
Bu Benchmarklar Real HFT İstehsal Sistemində Eyni Qazancı Sübut Edirmi?
Xeyr. Tədqiqat real bazar məlumatını, istehsal şəbəkə infrastrukturunu, exchange bağlantısını və tam sazlanmış HFT kernel mühitini başdan sona benchmark etməmişdir; nəticələr CPU və mikrobenchmark səviyyəsində, qismən istehsal davranışını təqlid edən testlərdən əldə edilmişdir. Buna görə nanosaniyə səviyyəsindəki üstünlüklər metodun potensialını göstərir, lakin real trading sistemində eyni böyüklükdə başdan sona qazancı zəmanət vermir.
Müəlliflər evaluation bölməsində root səlahiyyətinin olmaması səbəbindən CPU scaling və scheduler kimi kernel sazlamalarının real HFT sistemindəki səviyyədə konfiqurasiya edilə bilmədiyini bildirirlər. Bundan əlavə pseudo-realistic mikrobenchmarkların real istehsal trading sistemini tam təmsil etmədiyini açıq şəkildə qəbul edirlər.
Mənbənin son şəkli daha güclü gələcək yoxlama üçün ayrıca market-data replay serveri, yüksək dəqiqlikli timestamp xüsusiyyətinə malik şəbəkə switch-i, ölçülən istehsal sistemi və cavab müddətlərini hesablayan ayrıca ölçmə serverindən ibarət təcrübə quruluşu təklif edir.
Tədqiqatın dəstəklədiyi nəticələr
- Yarı-statik
branchçağırışı araşdırılan arxitekturda birbaşa funksiya çağırışına çox yaxın icra xərcinə endirilə bilmişdir. - Tez-tez yanlış proqnozlaşdırılan branch-lərdə branch-changing kritik yol xaricində saxlanıla bildikdə daha aşağı median gecikmə və daha aşağı latency variance ölçülmüşdür.
- Şərti branch misprediction xərcinin yerinə daha aşağı xərcli hədəf düzəlişi mexanizmləri istifadə oluna bilər.
- SMC machine clear yanaşmanın əsas performans məhdudiyyətlərindən biridir.
- İstiqamət dəyişikliyi ilə branch-taking kifayət qədər ayrılarsa baha dəyişmə xərci çoxsaylı ucuz branch çağırışlarına paylana bilər.
- Thread safety, təhlükəsizlik və platform daşına bilməsi tətbiqdə əsas məhdudiyyətlərdir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Yarı-statik şərtlərin hər C++
ifvə yaswitchstrukturundan sürətli olduğu göstərilməmişdir. - Hər CPU arxitekturasında eyni dövr və ya nanosaniyə qazancının əldə ediləcəyi göstərilməmişdir.
- Real birjada daha yüksək ticarət gəlirliliyi empirik olaraq ölçülməmişdir.
- Real istehsal HFT sistemində başdan sona market-data-to-order latency təcrübəsi aparılmamışdır.
- Thread-safe sinxronizasiya əlavə edilmiş istifadənin eyni performans üstünlüyünü saxladığı göstərilməmişdir.
- Assembly editing yanaşmasının standart C++ davranışı olduğu iddia edilmir.
- Təhlükəsiz RWX idarəçiliyinin performans xərci olmadan tətbiq edilə bildiyi göstərilməmişdir.
Mənbə və Metod Qeydi
Orijinal başlıq: Semi-static Conditions in Low-latency C++ for High Frequency Trading: Better than Branch Prediction Hints
Müəlliflər: Paul Alexander Bilokon; Maximilian Lucuta; Erez Shermer.
Preprint mənsubiyyətləri: Paul Alexander Bilokon — Department of Computing və Department of Mathematics, Imperial College London; Maximilian Lucuta — Department of Computing, Imperial College London; Erez Shermer — qSpark LLC, Wilmington, Delaware, ABŞ.
Yüklənmiş mənbə: arXiv:2308.14185v1 [cs.PF], 27 avqust 2023. Yüklənmiş fayl özünü açıq şəkildə “A PREPRINT” kimi təsvir edir.
Sonrakı nəşr vəziyyəti: Biblioqrafik yoxlamada tədqiqatın daha sonra Journal of Parallel and Distributed Computing, Cild 196, Məqalə 105000 kimi nəşr edildiyi təsdiqlənmişdir. Jurnal versiyasının DOI-si 10.1016/j.jpdc.2024.105000-dir. Bu Verianla mətnindəki eksperimental təfərrüatlar yüklənmiş 2023 preprintindən çıxarılmışdır; sonrakı jurnal versiyasında edilmiş ola biləcək redaktə və ya elmi dəyişikliklər yüklənmiş mənbə ilə səssizcə birləşdirilməmişdir.
Nəşriyyat: Elsevier.
Proqram artefaktı: Tədqiqat yarı-statik şərtlər tətbiqini açıq mənbəli kitabxana kimi təqdim edir və mənbə kod deposunu maxlucuta/semi-static-conditions adı ilə göstərir.
Maliyyələşdirmə / maraqlar toqquşması / CRediT: Yüklənmiş preprintdə ayrıca və açıq maliyyələşdirmə, maraqlar toqquşması və ya CRediT müəllif töhfəsi bəyanatı müəyyən edilməmişdir; bu sahələr mənbədə olmadığı üçün tamamlanmamışdır.
Əsas metodoloji məhdudiyyət: Performans nəticələri arxitektura və platformadan asılıdır. Əsas benchmarklar Intel Core i7-10700 üzərində aparılmış, real tammiqyaslı HFT istehsal sistemi və tam kernel/network tuning mühiti istifadə edilməmişdir. Çox thread-li istifadənin thread-safe hala gətirilməsi sinxronizasiya xərci yaradır. Assembly editing standart C++ çərçivəsində müəyyən edilmiş təhlükəsiz davranış deyil və executable səhifə icazələri təhlükəsizlik/daşına bilmə problemləri yarada bilər.
Mənbədaxili texniki qeyd: İnkişaf bölməsi C++20/GCC 13.1 mühitini göstərdiyi halda usage nümunəsində -std=c++17 istifadə olunur. Bundan əlavə nisbi jump giriş məsafəsi məhdudiyyətinə dair izah ilə runtime xəta mesajındakı 2 GiB ifadəsi eyni formada yazılmayıb. Bu fərqlər Verianla tərəfindən səssizcə düzəldilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib