

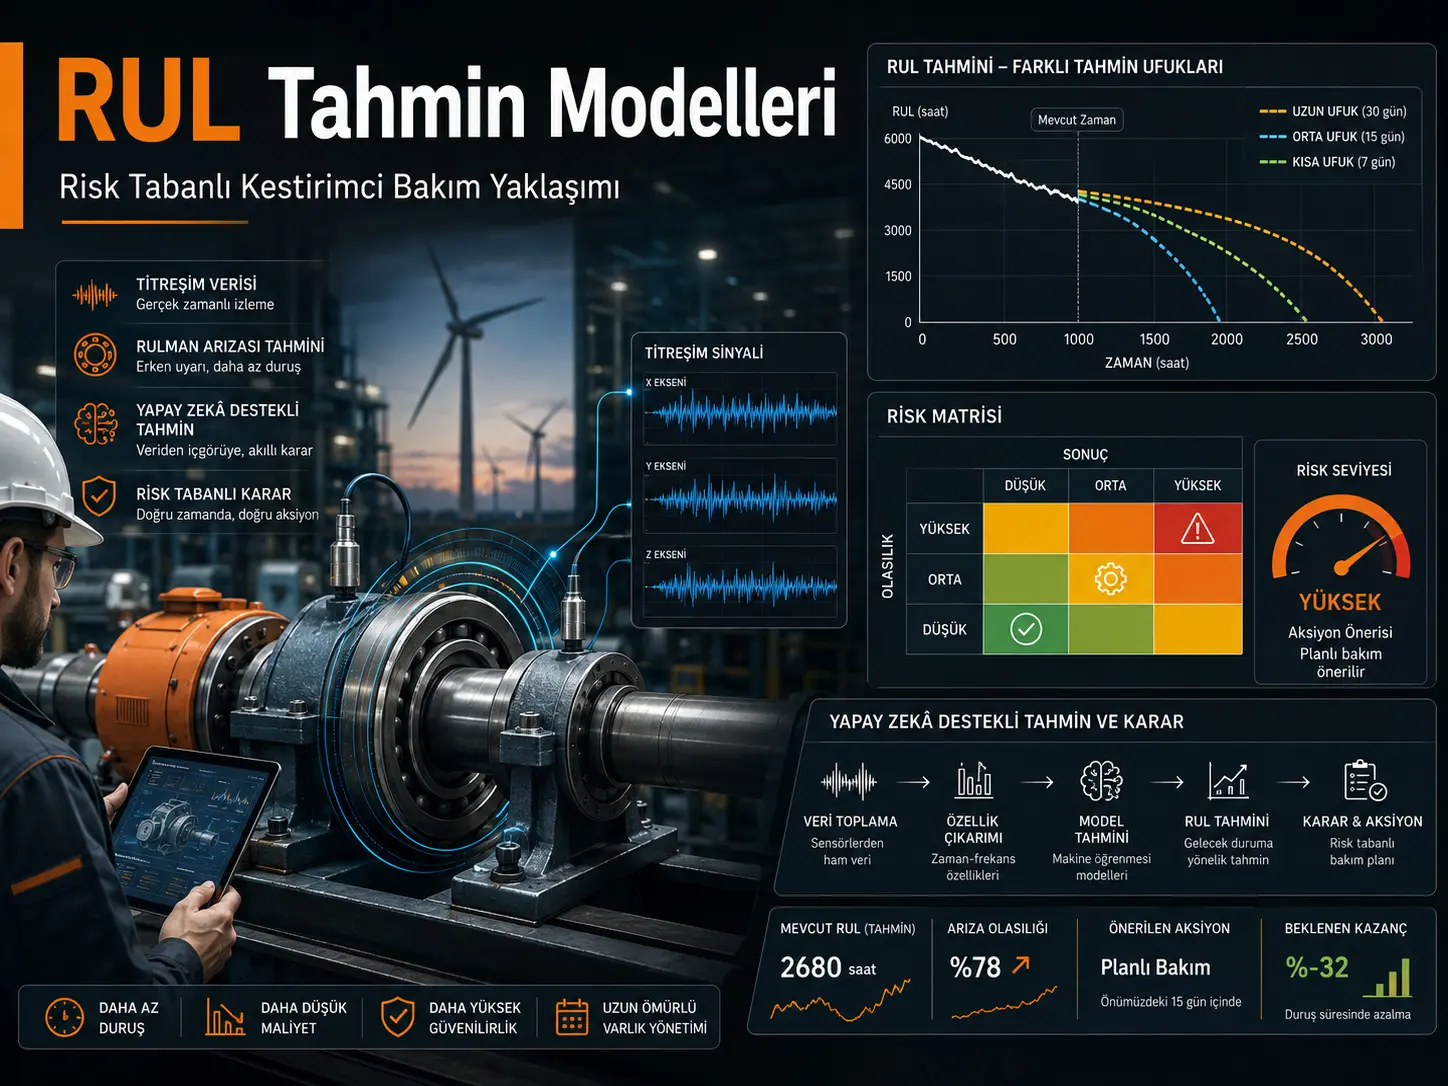
Maşının nə vaxt sıradan çıxacağını düzgün proqnozlaşdırmaq proqnozlaşdırıcı baxım üçün təkbaşına kifayət etməyə bilər. Baxım komandasının ehtiyat hissə tədarükü, personal planlaması, istehsal dayanması və ya müdaxilə hazırlığı edə bilməsi üçün proqnozun eyni zamanda kifayət qədər erkən gəlməsi lazımdır. Bu araşdırma Remaining Useful Life (RUL; qalan faydalı ömür) modellərinin yalnız ümumi xəta və ya doğruluq göstəriciləri ilə deyil, sıradan çıxmaya qalan vaxt, yəni proqnoz üfüqü və yanlış proqnozun əməliyyat nəticəsi birlikdə nəzərə alınaraq qiymətləndirilməsini təklif edir.
Tədqiqatda iki açıq vibrasiya məlumat dəsti üzərində ARIMA, Facebook Prophet, LSTM, GRU və PatchTST kimi yekunlaşdırılan beş proqnozlaşdırma yanaşması müqayisə edilib. Xam vibrasiya məlumatlarının sıxlaşdırılması və xüsusiyyət çıxarılması üçün bütün modellərdən əvvəl autoencoder istifadə olunduğu qeyd edilir. Proqnoz performansı uzun, orta və qısa olmaqla üç üfüqdə qiymətləndirilib. Birinci məlumat dəstində bunlar 20 gün təlim + 30 gün proqnoz, 40 + 10 və 47 + 3 günlük bölmələrlə həyata keçirilib.
Nəticələr hansı modelin “ən yaxşı” olmasının proqnoz üfüqündən asılı olaraq dəyişdiyini göstərir. Dataset 1-də uzun üfüqdə Prophet %72,67 ilə ən yüksək törədilmiş doğruluğu verərkən, qısa üfüqdə ARIMA %90,63-ə yüksəlib. Dataset 2-də uzun üfüqdə Prophet %86,62, orta üfüqdə Cədvəl 8-ə görə ARIMA %82,04 və qısa üfüqdə yenə ARIMA %98,25 ilə ən yüksək nəticəni verib. Bunun əksinə PatchTST xüsusilə Dataset 1-in orta üfüqündə %18,13 və Dataset 2-nin qısa üfüqündə %30,29 ilə zəif nəticələr göstərib.
Bu rəqəmlərdəki “accuracy” klassik təsnifat doğruluğu deyil. Tədqiqatda \(Accuracy = 100 - MAPE\) şəklində müəyyən edilib. Bu fərq kritikdir; çünki Dataset 1-in qısa üfüqündə ARIMA-nın törədilmiş doğruluğu %90,63 olsa da R² dəyəri −0,5988-dir. Başqa sözlə, proqnozların orta ölçü xətası nisbətən aşağı görünərkən model real deqradasiya əyrisindəki dəyişimi kifayət qədər izah edə bilmir.
Tədqiqatın ən mühüm metodoloji məhdudiyyəti odur ki, proqnoz üfüqü qısaldıqca təlim məlumatının miqdarı da eyni vaxtda artır. Uzun üfüq təcrübəsində 20 günlük, qısa üfüq təcrübəsində isə 47 günlük təlim məlumatı istifadə olunur. Buna görə üfüqlər arasındakı performans dəyişiminin nə qədərinin daha qısa proqnoz müddətindən, nə qədərinin daha çox təlim məlumatından qaynaqlandığı təcrübə dizaynı ilə bir-birindən ayrıla bilmir. Tapıntılar “qısa proqnozlar hər şəraitdə daha doğrudur” kimi universal model qanunu olaraq şərh edilməməlidir.
| Əsas tapıntı | Mənbə nəticəsi | Elmi şərh |
|---|---|---|
| Uzun üfüq doğruluq aralığı | %11,64–86,62 | Erkən proqnoz daha çox planlama vaxtı verir, lakin nəticələr model və məlumat dəstindən güclü şəkildə asılıdır. |
| Orta üfüq doğruluq aralığı | %18,13–82,04 | Performans olduqca dəyişkəndir. |
| Qısa üfüq doğruluq aralığı | %30,29–98,25 | Ümumilikdə daha yüksəkdir, lakin müdaxilə üçün qalan vaxt daha azdır. |
| Dataset 1 uzun üfüq lideri | Prophet: %72,67 | Erkən planlama baxımından mənbə tərəfindən önə çıxarılıb. |
| Dataset 1 qısa üfüq lideri | ARIMA: %90,63 | Yüksək törədilmiş doğruluğa baxmayaraq R² mənfidir. |
| Dataset 2 qısa üfüq lideri | ARIMA: %98,25 | Bu məlumat dəstindəki üç günlük üfüq nəticəsidir. |
RUL niyə baxım qərarlarında vacibdir?
Remaining Useful Life avadanlığın mövcud vəziyyətindən funksional sıradan çıxma nöqtəsinə qədər qalan istifadə oluna bilən müddəti proqnozlaşdırmağa çalışır. Məqsəd yalnız nasazlığın yaxınlaşdığını aşkar etmək deyil, müdaxilə üçün istifadə oluna biləcək vaxt pəncərəsini təxmin etməkdir.
Tədqiqatın əsas arqumenti buna görə çox praktikdir: sıradan çıxmaya üç gün qalmış düzgün proqnoz sayısal olaraq uğurlu görünsə də bəzi baxım fəaliyyətləri üçün çox gec ola bilər. Otuz gün əvvəldən bir qədər daha xətalı, lakin istifadə edilə bilən proqnoz isə ehtiyat hissə, komanda, istehsal planı və baxım vaxtı baxımından daha dəyərli ola bilər.
Risk əsaslı baxım ilə risk məlumatlandırılmış baxım arasındakı fərq nədir?
Məqalədəki Şəkil 2 iki anlayışı fərqli həyat dövrü mərhələlərinə yerləşdirir. Risk əsaslı proqnozlaşdırıcı baxım layihə mərhələsində hansı proqnozlaşdırma texnikasının seçilməsi sualına fokuslanır. Risk məlumatlandırılmış proqnozlaşdırıcı baxım isə sistem istismarda olarkən, proqnoz gəldikdən sonra baxımın nə vaxt aparılması ilə maraqlanır.
Bu tədqiqatın ağırlığı ilk problemə, yəni proqnoz modelinin sistemə qəbul edilməzdən əvvəl necə qiymətləndirilməli olduğuna yönəlir. Model seçiminin yalnız orta xəta dəyərinə deyil, müxtəlif proqnoz üfüqlərində göstərdiyi performansa və yanlış qərarın nəticəsinə əsaslanması təklif olunur.
Niyə proqnoz üfüqü ayrıca performans ölçüsüdür?
Məqalədəki Şəkil 3 yüksək qısamüddətli doğruluğun avtomatik olaraq ən faydalı modeli vermədiyini konseptual şəkildə göstərir. Doğruluq bir oxda, zaman/nəticə səviyyəsi digər oxda nəzərə alınır. Beləliklə aşağı doğruluq–yüksək nəticə şiddəti kombinasiyası ən riskli sahə kimi şərh olunur.
Tədqiqat 30 gün qalmış yaranan proqnoz xətasını aşağı nəticə səviyyəsi, 10 gün qalmış olanı orta və 3 gün qalmış olanı yüksək nəticə səviyyəsi ilə uyğunlaşdırır. Bu səviyyələr universal standart deyil; müəlliflər bunlardan külək ferması aktivlərinin idarə olunmasına dair praktik fərziyyələr kimi istifadə edirlər.
Hansı RUL model ailələri müzakirə olunur?
Məqalənin Şəkil 1-dəki ağacı RUL proqnoz modellərini statistik/etibarlılıq əsaslı, maşın öyrənməsi, dərin öyrənmə və fizika əsaslı üsullar kimi geniş qruplara ayırır. Bundan əlavə, bu qrupların komponentlərini birləşdirən hibrid modellər ayrıca qat kimi göstərilir.
Eksperimental müqayisədə isə beş üsul istifadə olunub: ARIMA, Facebook Prophet, LSTM, GRU və mənbə hiperparametr cədvəlində “PatchTST-inspired” adlandırılan Transformer əsaslı yanaşma. Nəticə bölmələrində son model qısa olaraq PatchTST adlandırılır; buna görə tədqiqat standart PatchTST tətbiqinin bütün detalları ilə eynilə istifadə olunduğunu təsdiqləmir.
İki məlumat dəsti nəyi təmsil edir?
Dataset 1 real iş şəraitindəki 2 MW-lıq külək turbininin yüksək sürətli şaft yatağına aid vibrasiya məlumatlarıdır. Məqalə yatağın 50 günlük tədrici deqradasiyasını izləyən MEMS əsaslı radial akselerometr məlumatlarından istifadə edir. Nominal fırlanma sürəti 1800 rpm, yüksək nümunələmə tezliyi 97.656 Hz və qeyd müddəti 6 saniyə olaraq bildirilir.
Dataset 2 University of Cincinnati Intelligent Maintenance Systems Centre tərəfindən hazırlanmış run-to-failure yatak təcrübələrinə əsaslanır. Məqalədəki Şəkil 5 istifadə ömrünün sonuna yaxınlaşdıqca vibrasiya amplitudunun nəzərəçarpacaq dərəcədə artdığı daha aydın deqradasiya quruluşunu göstərir. Müəlliflər Dataset 2-nin Dataset 1-lə müqayisədə daha öyrənilə bilən deqradasiya imzasına malik ola biləcəyini irəli sürürlər.
Məlumat mənbələrinin göstərilməsində mənbədaxili biblioqrafik qeyri-müəyyənlik var. Dataset 1 metod mətnində GitHub üzərindən əlçatan kimi təsvir edildiyi halda, əlaqəli ədəbiyyat qeydi MathWorks-a yönəlir. Dataset 2 üçün metod və məlumat əlçatanlığı bölmələri NASA Prognostics Data Repository-ni göstərərkən [47] nömrəli ədəbiyyat qeydi Kaggle ünvanıdır. Bu vəziyyət nəticələri öz-özlüyündə etibarsız etmir; lakin müstəqil təkrar istehsal üçün hansı orijinal depo və məlumat versiyasının istifadə edildiyinin daha açıq sənədləşdirilməsi lazımdır.
Proqnoz üfüqləri necə yaradıldı?
| Üfüq | Təlim bölməsi | Test / proqnoz bölməsi | Mənbənin nəticə fərziyyəsi |
|---|---|---|---|
| Uzun | 20 gün | 30 gün | Erkən mərhələ; daha çox baxım planlama vaxtı |
| Orta | 40 gün | 10 gün | Nasazlığın irəlilədiyi, müdaxilə vaxtının daraldığı mərhələ |
| Qısa | 47 gün | 3 gün | Kritik nasazlığa yaxın, nəticə şiddətinin yüksək qəbul edildiyi mərhələ |
Bu dizaynın mühüm nəticəsi iki eksperimental dəyişənin birlikdə hərəkət etməsidir. Proqnoz üfüqü 30 gündən 3 günə enərkən təlim məlumatı 20 gündən 47 günə yüksəlir. Buna görə qısa üfüqdəki performans artımının yalnız daha yaxın gələcəyi proqnozlaşdırmağın asanlaşmasından qaynaqlandığını demək olmaz; modelin daha çox deqradasiya tarixçəsi görməsi də nəticələrə təsir edə bilər.
Dataset 1-də model sıralaması necə dəyişdi?
Verianla Live: Dataset 1-də model doğruluğunun proqnoz üfüqünə görə dəyişməsi
Dəyərlər mənbə Cədvəl 2-dən götürülüb. “Doğruluq” tədqiqatda 100 − MAPE olaraq hesablanır; klassik təsnifat doğruluğu deyil. Üfüq dəyişdikcə təlim məlumatının miqdarı da dəyişir.
| Model | Uzun üfüq (%) | Orta üfüq (%) | Qısa üfüq (%) | Mənbə |
|---|---|---|---|---|
| ARIMA | 11,64 | 56,56 | 90,63 | Cədvəl 2 |
| Prophet | 72,67 | 66,12 | 89,81 | Cədvəl 2 |
| LSTM | 34,46 | 59,04 | 79,72 | Cədvəl 2 |
| GRU | 33,77 | 54,77 | 90,39 | Cədvəl 2 |
| PatchTST | 33,99 | 18,13 | 67,64 | Cədvəl 2 |
Dataset 1-də Prophet uzun və orta üfüqdə ən yüksək dəyəri verərkən ARIMA qısa üfüqdə önə çıxır. ARIMA-nın %11,64-dən %90,63-ə yüksəlməsi model sıralamasının qiymətləndirmə pəncərəsindən nə qədər asılı ola biləcəyini aydın göstərir.
Dataset 2 eyni sıralamanı verdimi?
Xeyr. İkinci məlumat dəstində əksər modellərin ümumi performansı yüksəlib və bəzi sıralamalar dəyişib. Bu, tədqiqatın “model risk profili yalnız alqoritmin xüsusiyyəti deyil; məlumat dəstinin deqradasiya quruluşundan da asılıdır” tezisini dəstəkləyən əsas tapıntılardan biridir.
Verianla Live: Dataset 2-də model doğruluğunun proqnoz üfüqünə görə dəyişməsi
Dəyərlər mənbə Cədvəl 8-dən götürülüb. Cədvəl orta üfüqdə ARIMA üçün %82,04 və Prophet üçün %81,03 verir. Mənbə mətnində Prophet-ın Dataset 2 orta üfüqdə də ən yaxşı olduğu yazılması cədvəllə uyğun gəlmir.
| Model | Uzun üfüq (%) | Orta üfüq (%) | Qısa üfüq (%) | Mənbə |
|---|---|---|---|---|
| ARIMA | 77,35 | 82,04 | 98,25 | Cədvəl 8 |
| GRU | 76,56 | 73,21 | 95,18 | Cədvəl 8 |
| LSTM | 84,86 | 70,72 | 95,14 | Cədvəl 8 |
| PatchTST | 46,12 | 33,79 | 30,29 | Cədvəl 8 |
| Prophet | 86,62 | 81,03 | 96,76 | Cədvəl 8 |
Dataset 2 uzun üfüqdə Prophet %86,62 ilə ən yüksək nəticəni verir. Orta üfüqdə mənbə Cədvəl 8-in ən yüksək dəyəri ARIMA-nın %82,04-dür; Prophet %81,03-dür. Qısa üfüqdə ARIMA %98,25-ə çatır. PatchTST isə digər modellərdən fərqli olaraq qısa üfüqdə yaxşılaşmayıb və %30,29-a enib.
Türkiyə baxımından necə şərh edilə bilər?
Tədqiqat Türkiyədə sahə doğrulaması aparmayıb. Bununla belə külək turbinləri, istehsal xətləri, fırlanan maşınlar, yataqlar və oxşar kritik avadanlıqlarda proqnozlaşdırıcı baxım tətbiq edən müəssisələr üçün ortaya qoyduğu qərar problemi Türkiyə baxımından da mühəndislik cəhətdən mənalıdır: yalnız “ən aşağı xəta verən modeli” seçmək əvəzinə müəssisənin real ehtiyat hissə tədarük müddəti, baxım komandasının mobilizasiyası, planlı dayanma tələbi və nasazlığın təhlükəsizlik/istehsal nəticəsi ilə uyğun proqnoz üfüqü müəyyən edilməlidir.
Lakin tədqiqatdakı 30, 10 və 3 günlük hədlər Türkiyədəki bütün sənaye aktivləri üçün tətbiq oluna biləcək standart dəyərlər deyil. Mənbə özü də bu müddətlərin avadanlıq, deqradasiya mexanizmi və əməliyyat mühitinə görə uyğunlaşdırılmalı olduğunu bildirir.
Tədqiqat nəyi dəstəkləyir, nəyi sübut etmir?
| Tədqiqatın dəstəklədiyi nəticə | Tədqiqatın sübut etmədiyi / sınaqdan keçirmədiyi nəticə |
|---|---|
| Model performansı proqnoz üfüqünə və məlumat dəstinə bağlı olaraq əhəmiyyətli dərəcədə dəyişə bilər. | Tək bir alqoritmin bütün sənaye aktivləri üçün ümumilikdə ən yaxşı RUL modeli olduğu sübut edilməyib. |
| Yüksək qısa-üfüq sayısal doğruluğu baxım planlaması üçün kifayət qədər erkən xəbərdarlıq verməyə bilər. | Qısa üfüqdəki performans artımının yalnız üfüq uzunluğundan qaynaqlandığı göstərilməyib; təlim məlumatının miqdarı da dəyişir. |
| Tək bir xəta metrikası real deqradasiya əyrisini kifayət qədər təmsil etməyə bilər. | Təklif olunan Shape-RMSE və ya PHEP-in bütün RUL tətbiqlərində doğrulanmış universal standartlar olduğu göstərilməyib. |
| Prophet iki məlumat dəstində uzun üfüqdə nisbətən ardıcıl performans göstərib. | Prophet-ın bütün məlumat dəstlərində və ya aktiv tiplərində ən aşağı riskli üsul olacağı göstərilməyib. |
| ARIMA iki məlumat dəstində qısa üfüqdə ən yüksək törədilmiş doğruluğu verib. | Bu nəticə ARIMA-nın real deqradasiya formasını ən yaxşı öyrəndiyini göstərmir; Dataset 1-də qısa-üfüq R² mənfidir. |
| İki məlumat dəstindən istifadə tək məlumat dəsti qiymətləndirməsindən daha çox ümumiləşdiriləbilənlik məlumatı verib. | Nəticələr digər yataqlara, reduktorlara, nasoslara, mühərriklərə və ya fərqli iş şəraitlərinə avtomatik ümumiləşdirilə bilməz. |
Tədqiqatın Metodu və Nəticələri
Modellərdən əvvəl məlumat necə emal edildi?
Mənbə yüksəkölçülü və səs-küylü vibrasiya siqnallarının birbaşa proqnoz modellərinə verilməsi əvəzinə autoencoder istifadə edildiyini bildirir. Autoencoder məlumatı sıxlaşdırmaq və xüsusiyyət çıxarmaq üçün tətbiq edilib, əldə olunan təmsil daha sonra beş proqnozlaşdırma yanaşmasına ötürülüb.
Bununla belə autoencoder-ın qat arxitekturası, latent ölçüsü və təliminin bütün detalları əsas hiperparametr cədvəlində verilmir. Bu vəziyyət xüsusilə tədqiqatın nəticələrini tam təkrar istehsal etmək istəyən araşdırmaçılar üçün metodoloji çatışmazlıqdır.
Əsas model parametrləri
| Model | Mənbədə bildirilən seçilmiş parametrlər | Diqqət nöqtəsi |
|---|---|---|
| LSTM | Ardıcıllıq uzunluğu 2; 16 LSTM vahidi; dropout 0,1; dense 16; 300 epoch; batch 4 və ya 2 | “4 və ya 2” batch dəyərinin hansı şəraitdə istifadə olunduğu cədvəldə ayrılmır. |
| GRU | Ardıcıllıq uzunluğu 2; 16 GRU vahidi; dropout 0,1; dense 16; 300 epoch; batch 4 və ya 2 | Dərin model üçün məlumat olduqca məhduddur. |
| ARIMA | p: 0–3; d: 0–2; q: 0–3; ən yaxşı AIC əsaslı sıra | Statistik yanaşma |
| Prophet | Gündəlik/illik mövsümilik bağlı; həftəlik açıq; changepoint prior 0,05; seasonality prior 10; Fourier order 3 | Mənbə “Facebook Prophet” terminologiyasından istifadə edir. |
| PatchTST-inspired | Ardıcıllıq uzunluğu 2; attention head 2; key dimension 4; feed-forward 16; dense 16; 300 epoch | Hiperparametr cədvəlində ad “PatchTST-inspired”, nəticə cədvəllərində isə “PatchTST”dir. |
“Accuracy” necə hesablandı?
Tədqiqatın əsas xəta ölçülərindən Mean Absolute Error (MAE):
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i| \]
Root Mean Square Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2} \]
və Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100}{n}\sum_{i=1}^{n}\left|\frac{\hat{y}_i-y_i}{y_i}\right| \]
şəklində verilir. Tədqiqatın “accuracy” dəyəri isə birbaşa:
\[ Accuracy=100\%-MAPE(\%) \]
olaraq müəyyən edilib. Buna görə %90 doğruluq ifadəsi təsnifatda istifadə olunan “düzgün proqnoz faizi” mənasına gəlmir. Mənbənin özü də xüsusilə yüksək MAPE dəyərlərində və sahə tolerantlıqlarının kritik olduğu hallarda bu tərifdən ehtiyatla istifadə olunmalı olduğunu bildirir.
R² niyə fərqli hekayə danışır?
Coefficient of determination:
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} {\sum_{i=1}^{n}(y_i-\bar{y})^2} \]
ilə hesablanır. R²-nin mənfi olması modelin real seriyadakı variasiyanı izah etməkdə yalnız orta RUL dəyərini proqnozlaşdırmaqdan belə daha pis ola biləcəyini göstərir.
| Model | MAE | RMSE | R² | MAPE (%) | Törədilmiş doğruluq (%) |
|---|---|---|---|---|---|
| ARIMA | 0,0252 | 0,0313 | −0,5988 | 9,3651 | 90,63 |
| Prophet | 0,0292 | 0,0294 | −0,4160 | 10,1910 | 89,81 |
| LSTM | 0,0558 | 0,0612 | −5,1204 | 20,2753 | 79,72 |
| GRU | 0,0275 | 0,0279 | −0,2698 | 9,6050 | 90,39 |
| PatchTST | 0,0905 | 0,0935 | −13,2818 | 32,3619 | 67,64 |
Cədvəl 3-ün ən diqqətçəkən xüsusiyyəti qısa üfüqdə beş modelin hamısının R² dəyərinin mənfi olmasıdır. Deməli yüksək MAPE-əsaslı doğruluq ilə real deqradasiya əyrisinin dinamikasını izah etmək qabiliyyəti eyni şey deyil. Məqalənin Şəkil 8-indəki ARIMA əyrisi də bu problemi vizual şəkildə göstərir.
Shape-RMSE nəyi ölçməyə çalışır?
Tədqiqat mütləq ölçü əvəzinə proqnoz əyrisinin formasının real deqradasiya əyrisinə nə qədər bənzədiyini ölçmək üçün normallaşdırılmış Shape-RMSE təklif edir:
\[ Shape\text{-}RMSE= \sqrt{\frac{1}{N} \sum_{t=1}^{N} (\hat{y}^{norm}_t-y^{norm}_t)^2} \]
Seriyalar öz minimum və maksimumlarına görə normallaşdırılır:
\[ y^{norm}_t= \frac{y_t-\min(y)} {\max(y)-\min(y)} \]
Daha aşağı Shape-RMSE daha yaxşı hesab edilir.
| Model | Uzun üfüq | Orta üfüq | Qısa üfüq |
|---|---|---|---|
| ARIMA | 0,3846 | 0,7464 | 0,5636 |
| GRU | 0,5307 | 0,5147 | 0,1024 |
| LSTM | 0,5323 | 0,4746 | 0,5999 |
| PatchTST | 0,5959 | 0,3228 | 0,0540 |
| Prophet | 0,1015 | 0,1734 | 0,0681 |
Prophet uzun və orta üfüqdə ən aşağı Shape-RMSE verir. Qısa üfüqdə sayısal olaraq PatchTST 0,0540 ilə ən aşağı dəyərə malikdir. Buna baxmayaraq mənbə müəllifləri vizual baxışda Prophet-ın real deqradasiya yolunu daha yaxşı izlədiyini qeyd edirlər. Məqalənin özü buna görə çox qısa pəncərələrdə Shape-RMSE-nin təkbaşına forma sədaqətini tam təmsil etməyə biləcəyini qəbul edir. Bu, yeni təklif olunan ölçünün hələ təkbaşına qərar meyarı olmadığını göstərən mühüm daxili doğrulamadır.
Təlim pəncərəsi dəyişdikdə modellər nə qədər sabitdir?
Tədqiqat seçilən təlim uzunluqlarının ətrafında ±3 günlük dəyişiklik edərək MAPE aralıqlarını müqayisə edib. Xüsusilə qısa üfüq ətrafındakı 42–48 günlük təlim pəncərəsində Prophet-ın MAPE aralığı %7,75–14,46 ilə ən dar və ən aşağı aralıqlardan biridir. ARIMA eyni bölgədə %8,35–45,12 arasında daha çox dəyişir.
| Model | Uzun üfüq ətrafı MAPE (%) | Orta üfüq ətrafı MAPE (%) | Qısa üfüq ətrafı MAPE (%) |
|---|---|---|---|
| ARIMA | 95,15–110,82 | 15,21–93,18 | 8,35–45,12 |
| Prophet | 43,83–76,72 | 10,08–38,57 | 7,75–14,46 |
| LSTM | 91,98–101,41 | 36,60–90,98 | 20,99–48,31 |
| GRU | 93,16–100,39 | 42,70–91,17 | 25,80–55,45 |
| PatchTST | 79,90–104,66 | 55,76–117,48 | 32,36–65,27 |
Şəkil 10-dakı boxplot Prophet-ı kiçik təlim-pəncərəsi dəyişikliklərinə qarşı ən sabit, ARIMA-nı isə ən həssas model kimi göstərir. Bu nəticə ARIMA-nın müəyyən qısa üfüq kəsiyində ən yüksək doğruluğa çatmasının modelin bütün yaxın təlim pəncərələrində eyni dərəcədə sabit olduğu mənasına gəlmədiyini göstərir.
PHEP niyə təklif edildi?
Prediction Horizon Error Profile (PHEP) tək bir orta xəta vermək əvəzinə xəta böyüklüyünün sıradan çıxmaya qalan vaxta görə necə dəyişdiyini göstərməyi məqsəd qoyur:
\[ PHEP(h)= \frac{1}{N_h} \sum_{i=1}^{N_h} \left| \frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}} \right| \times100 \]
Şəkil 11-də bir çox modelin sıradan çıxmaya yaxınlaşdıqca iki ayrı xəta yüksəlişi göstərdiyi, Prophet-ın isə daha düz xəta profili nümayiş etdirdiyi bildirilir. Mənbə bu iki zirvəni əvvəlcə deqradasiya rejiminin dəyişməyə başladığı keçid mərhələsi, sonra isə sıradan çıxmaya çox yaxın daha qeyri-xətti və nizamsız kritik mərhələ kimi şərh edir.
PHEP qrafikinin nöqtə dəyərləri əsas mətndə cədvəl şəklində verilmədiyi üçün Verianla Live daxilində qrafikdən təxmini rəqəmlər çıxarılmayıb.
Risk matrisi necə qurulur?
Tədqiqatda proqnoz doğruluğu üç praktik sinfə ayrılıb: %95-dən yuxarı yüksək, %80–95 orta və %80-dən aşağı aşağı. Müəlliflər bu hədlərin aktiv meneceri təcrübəsinə əsaslanan müqayisəli təsnifat olduğunu və bütün RUL tətbiqləri üçün universal standart olmadığını açıq bildirirlər.
Nəticə şiddəti isə 30 gün qalmış aşağı, 10 gün qalmış orta və 3 gün qalmış yüksək qəbul edilir. Dataset 1-də heç bir model 30 gün qalmış yüksək və ya orta doğruluq sinfinə çatmayıb. Qısa üfüqdə ARIMA, GRU və Prophet orta doğruluq bölgəsinə daxil olarkən LSTM və PatchTST aşağı doğruluq bölgəsində qalıb.
Dataset 2-də qısa üfüqdə ARIMA %98,25, GRU %95,18, LSTM %95,14 və Prophet %96,76 ilə yüksək doğruluq sinfində yer alarkən PatchTST %30,29 ilə aşağı sinifdə qalıb.
“Yanlış proqnoz ehtimalı” həqiqətən ehtimaldırmı?
Mənbə risk yanaşmasını daha da irəli aparmaq üçün yanlış proqnoz ehtimalını accuracy, R², Shape-RMSE və PHEP komponentlərinin funksiyası kimi konseptuallaşdırır:
\[ P_{wrong}=f(E_{acc},E_{R^2},E_{ShapeRMSE},E_{PHEP}) \]
Daha sonra təxmini kompozit etibarsızlıq indeksi təklif olunur:
\[ P_{wrong}\approx w_1E_{acc}+w_2E_{R^2}+w_3E_{SSS}+w_4E_{PHEP} \]
\[ \sum_{i=1}^{4}w_i=1 \]
Bu düstur kalibrlənmiş statistik nasazlıq ehtimalı deyil. Mənbə də real yanlış proqnoz ehtimalını birbaşa hesablamağın çətin olduğunu və burada kompozit predictive unreliability index ilə təxmin edildiyini bildirir. Bundan əlavə, ilk tənlikdə `EShapeRMSE` olaraq verilən üçüncü komponent sonrakı tənlikdə izahsız şəkildə `ESSS` formasına dəyişir; bu, mənbədaxili işarələmə uyğunsuzluğudur. Çəkilər üçün də bu tədqiqatda universal və ya eksperimental olaraq doğrulanmış rəqəmlər verilmir.
Model qiymətləndirməsi üçün təklif olunan yekun proses
Verianla Live: RUL proqnoz modelini istifadəyə verməzdən əvvəl təklif olunan qiymətləndirmə axını
Axın mənbə Şəkil 13-ün əsas qiymətləndirmə məntiqini xülasə edir. Bu, sahə standartı kimi doğrulanmış məcburi prosedur deyil, araşdırmaçıların təklif etdiyi qiymətləndirmə çərçivəsidir.
| Mərhələ | Açıqlama | Mənbə |
|---|---|---|
| 1. Sabit seed, tək üfüq | Model öyrədilir; xəta, R², əyri/forma oxşarlığı və əsas performans qiymətləndirilir. | Şəkil 13 — Stage 1 FSSH |
| 2. Təsadüfi seed, tək üfüq | Model bir neçə dəfə işlədilərək tək üfüqdə performans statistikaları və etibarlılıq araşdırılır. | Şəkil 13 — Stage 2 RSSH |
| 3. Təsadüfi seed, çoxlu üfüq | Model bir neçə proqnoz üfüqündə təkrarlı qiymətləndirilir. | Şəkil 13 — Stage 3 RSMH |
| 4. Ümumi model performansı | Çoxlu meyar və çoxlu üfüq nəticələri digər modellərlə müqayisə edilir. | Şəkil 13 |
| 5. Çoxlu məlumat dəsti testi | Lazım olduqda yeni məlumat dəstlərində, bir neçə iş və üfüqdə performans sınaqdan keçirilir. | Şəkil 13 — Stage 4 |
| 6. Təsdiq | Model müəyyən edilmiş performans və etibarlılıq tələblərini qarşılayırsa istifadə üçün uyğun hesab edilir. | Şəkil 13 |
Tədqiqatın ən mühüm metodoloji məhdudiyyətləri
Proqnoz üfüqü ilə təlim məlumatının miqdarı təcrübə dizaynında birlikdə dəyişdiyinə görə üfüqün müstəqil təsiri izolə edilmir. Birinci məlumat dəsti yalnız 50 günlük məhdud tarixçə verir və mənbə müəllifləri LSTM, GRU və Transformer-bənzəri modellərdə görünən təxminən düz proqnozların qeyri-kafi məlumat və optimizasiyadan qaynaqlana biləcəyini xüsusilə qeyd edirlər. Buna görə təcrübə “statistik modellər ümumilikdə dərin öyrənmədən daha yaxşıdır” nəticəsini dəstəkləmir.
Əsas model cədvəllərində etibar intervalları və ya model sıralamalarının statistik əhəmiyyətini göstərən testlər təqdim edilmir. Tədqiqat təlim pəncərəsi həssaslığını araşdırsa da təklif olunan Şəkil 13 axınındakı təsadüfi-seed etibarlılıq testlərinin hamısının əsas müqayisələrdə eyni əhatədə tətbiq edildiyi göstərilmir.
Risk matrisi nəticə şiddətini birbaşa 30, 10 və 3 günlük pəncərələrlə bağlayır; bu təsnifat sahə üzrə universal deyil. Eyni şəkildə %95 və %80 doğruluq hədləri praktik ekspert rəyinə əsaslanır. Avadanlığın real riski təhlükəsizlik nəticəsi, istehsal itkisi, baxım xərci, ətraf mühit təsiri, ehtiyat hissə müddəti və yanlış erkən baxım xərci kimi aktivə xas dəyişənlərlə yenidən kalibrlənməlidir.
Təklif olunan yanlış proqnoz ehtimalı hələ kalibrlənmiş ehtimal modeli deyil və çəkiləri tədqiqat tərəfindən kəmiyyətcə doğrulanmayıb. Tədqiqatın nəticə bölməsində də qeyri-müəyyənliyin kəmiyyətləşdirilməsinin hazırkı araşdırmaya tam inteqrasiya edilmədiyi və gələcək iş kimi planlaşdırıldığı açıq qeyd olunur.
Yalnız iki məlumat dəsti istifadə olunub və hər ikisi yataq vibrasiya məlumatına əsaslanır. Dataset 1 real külək turbin şəraitini, Dataset 2 nəzarətli run-to-failure təcrübəsini təmsil etsə də nəticələr digər avadanlıq siniflərində birbaşa doğrulanmayıb.
Mənbədə həmçinin Dataset 2 orta üfüq liderinin mətnlə Cədvəl 8 arasında fərqli verilməsi, məlumat deposu istinadlarındakı uyğunsuzluq, `EShapeRMSE`/`ESSS` simvol dəyişməsi, PatchTST/PatchTST-inspired terminologiyası və qısa üfüq Shape-RMSE nəticəsinin müəlliflərin vizual qiymətləndirməsi ilə tam üst-üstə düşməməsi mövcuddur. Bu məqamlar məqalənin əsas mesajını aradan qaldırmır, lakin təkrar istehsal ediləbilənlik və ölçülərin yetkinliyi baxımından nəzərə alınmalıdır.
Mənbə və Metod Qeydi
| Tam orijinal tədqiqat adı | Evaluating RUL Predictive Models: A Risk-Based Predictive Maintenance Approach |
|---|---|
| Müəlliflər | Idriss El-Thalji; Ali Usman; Waqar Ali |
| Müəllif sırası | 1. Idriss El-Thalji; 2. Ali Usman; 3. Waqar Ali |
| Bərabər töhfə / bərabər birinci müəllif | Mənbə tədqiqatda bərabər birinci və ya bərabər töhfə bəyanı göstərilməyib. |
| Məsul müəllif | Idriss El-Thalji |
| Qurumlar | Department of Engineering Management, Prince Sultan University, Riyadh, Səudiyyə Ərəbistanı; Department of Mechanical and Structural Engineering and Materials Science, University of Stavanger, Stavanger, Norveç. |
| Mənbə növü | RUL proqnoz modellərinin iki açıq vibrasiya məlumat dəstində müqayisə edildiyi və risk əsaslı model qiymətləndirmə çərçivəsinin təklif olunduğu tədqiqat məqaləsi. |
| Rəyləndirmə statusu | Rəyli jurnalda dərc edilmiş tədqiqat məqaləsidir; preprint deyil. |
| Jurnal | AI |
| Nəşriyyat | MDPI |
| Cild / say / məqalə | 2026, 7(5), 169 |
| DOI | 10.3390/ai7050169 |
| Alınma tarixi | 2 mart 2026 |
| Reviziya tarixi | 10 may 2026 |
| Qəbul tarixi | 12 may 2026 |
| Nəşr tarixi | 14 may 2026 |
| Rəsmi keçid | https://doi.org/10.3390/ai7050169 |
| Lisenziya | Creative Commons Attribution (CC BY). |
Maliyyələşdirmə, etika və maraqlar toqquşması
Müəlliflər tədqiqatın xarici maliyyələşdirmə almadığını bildiriblər. Institutional Review Board və məlumatlandırılmış razılıq sahələri “tətbiq edilmir” kimi göstərilib. Müəlliflər maraqlar toqquşması olmadığını bəyan ediblər.
Məlumat əlçatanlığı
Mənbə tədqiqat iki əsas məlumat dəstinin açıq depolardan gəldiyini bildirir. Birinci məlumat dəsti külək turbininin yüksək sürətli yataq prognosis məlumatı, ikincisi IMS bearing run-to-failure məlumat dəstidir. Bununla belə əsas mətndəki depo açıqlamaları ilə [46] və [47] nömrəli istinadların hədəfləri tam uyğun gəlmədiyinə görə müstəqil təkrar istehsalda orijinal məlumat deposu və versiyası ayrıca yoxlanmalıdır.
Müəllif töhfələri
Idriss El-Thalji, Ali Usman və Waqar Ali konseptuallaşdırma, proqram təminatı, doğrulama, formal analiz, araşdırma, məlumat kurasiyası, ilkin layihə, nəzərdən keçirmə və vizuallaşdırmaya töhfə veriblər. Metodologiya Idriss El-Thalji və Ali Usman tərəfindən həyata keçirilib. Resurslar, nəzarət, layihə idarəçiliyi və maliyyələşdirmənin əldə edilməsi Idriss El-Thalji tərəfindən üstlənilib.
Mənbə sədaqəti baxımından kritik qeyd
Mənbə mətndə Dataset 2-nin orta proqnoz üfüqündə Prophet-ın ən yaxşı model olduğu deyilir; lakin Cədvəl 8 ARIMA üçün %82,04, Prophet üçün %81,03 göstərir. Verianla mətnində cədvəl dəyərləri dəyişdirilmədən qorunub və mətn–cədvəl uyğunsuzluğu açıq şəkildə qeyd edilib.
Mənbə Cədvəl 1 modeli “PatchTST-inspired” kimi müəyyən edərkən nəticə bölmələri “PatchTST” adından istifadə edir. Buna görə nəticələr kanonik PatchTST arxitekturasının müstəqil və tam benchmark-ı kimi təqdim edilməyib.
Shape-RMSE qısa üfüqdə PatchTST üçün 0,0540 və Prophet üçün 0,0681 verir. Riyazi meyara görə PatchTST daha yaxşı görünərkən mənbə müəlliflərinin vizual baxışı Prophet-ın real deqradasiya əyrisini daha yaxşı izlədiyini bildirir. Mənbənin özü bunun çox qısa pəncərələrdə Shape-RMSE-nin təkbaşına qeyri-kafi ola biləcəyini göstərdiyini ifadə edir.
Yanlış proqnoz riskinin kompozit formulunda ilk göstərimdə `EShapeRMSE`, sonrakı tənlikdə isə tərif verilmədən `ESSS` istifadə olunur. Bundan əlavə, bu kompozit indeks üçün çəkilərin eksperimental kalibrasiyası və real yanlış proqnoz ehtimalına qarşı doğrulaması hazırkı tədqiqatda aparılmayıb.
Nəticələrin ən təhlükəsiz şərhi odur ki, RUL modelinin baxım üçün uyğunluğu yalnız bir xəta metrikası və ya bir zaman üfüqü ilə qiymətləndirilməməlidir. Tədqiqat bu yanaşmanı iki yataq məlumat dəstində göstərsə də, təklif olunan risk əsaslı çərçivənin fərqli aktiv sinifləri, müstəqil məlumat dəstləri və qeyri-müəyyənlik kəmiyyətləşdirilməsi ilə daha geniş şəkildə doğrulanmasına ehtiyac var.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib