


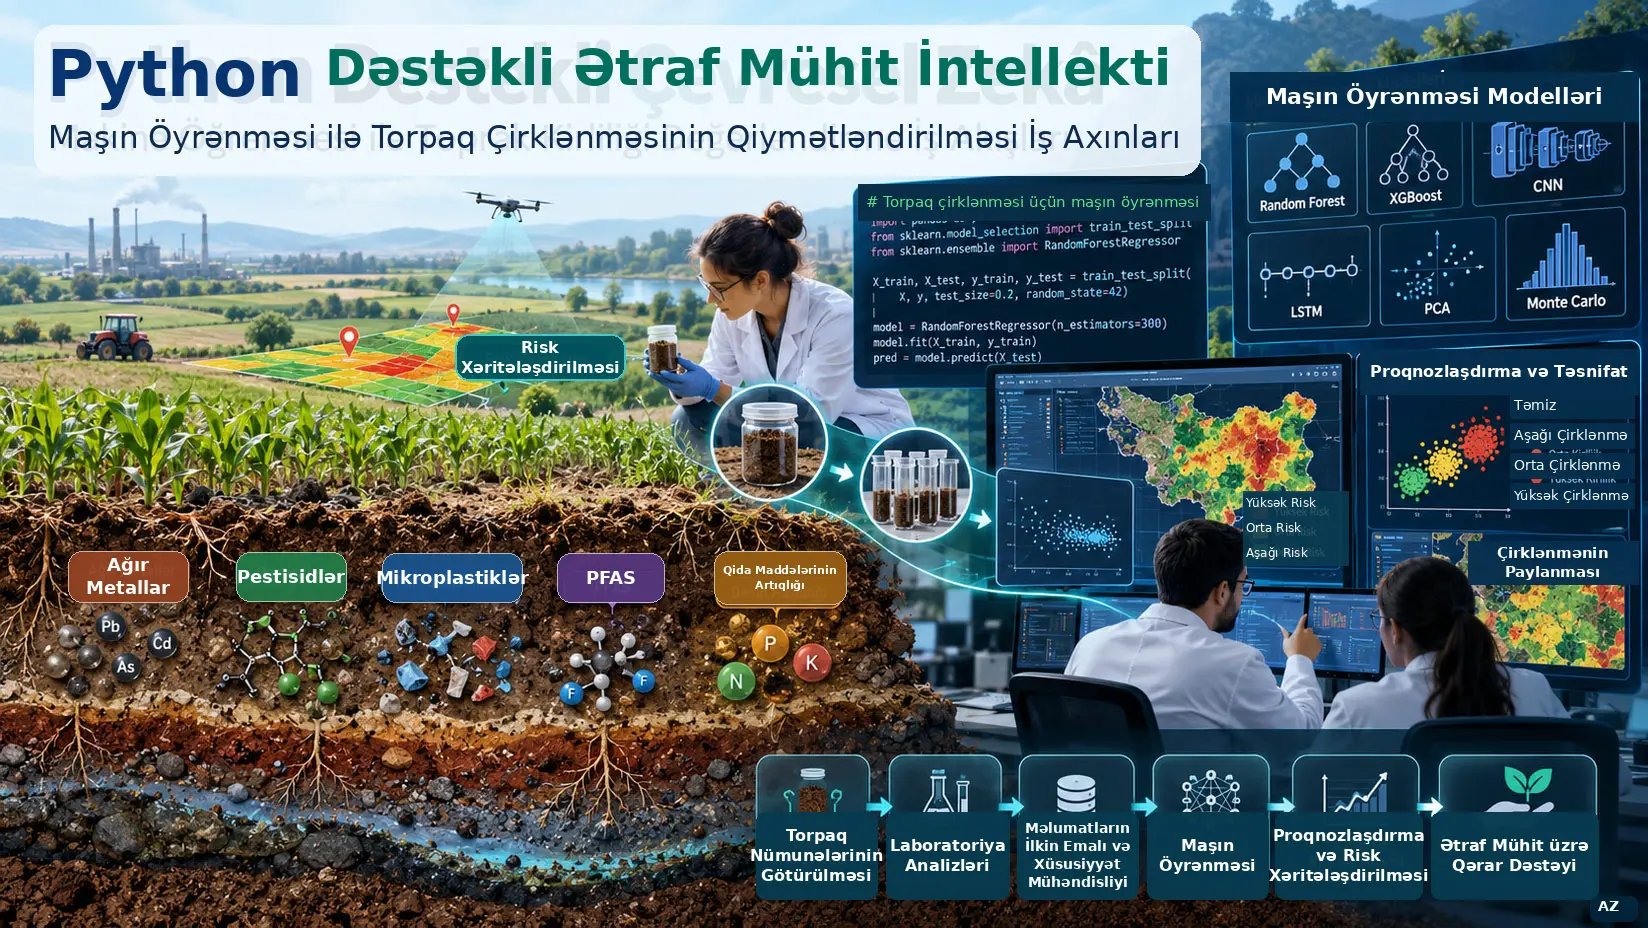
Python əsaslı torpaq çirklənməsinin qiymətləndirilməsi iş axınları, müxtəlif çirkləndirici növlərinin proqnozlaşdırılması, təsnif edilməsi, zaman üzrə dəyişməsinin qabaqcadan qiymətləndirilməsi, qeyri-müəyyənliyinin hesablanması və məkan risk xəritələrinin yaradılması üçün maşın öyrənməsi, dərin öyrənmə, statistika və CİS alətlərini birləşdirən modul hesablama analiz şablonlarıdır. Tədqiqat ağır metalları, pestisidləri, mikroplastikləri, per- və polifloroalkil maddələri (PFAS) və həddindən artıq makroelement yükünü əhatə edir; Random Forest, XGBoost + SHAP, 1-B CNN, LSTM, PCA, Monte Carlo və GeoPandas əsaslı yeddi Python iş axını təqdim edir.
Tədqiqatın ən mühüm şərh məhdudiyyəti, bildirilən model uğurlarının real çirklənmiş sahə məlumatlarında təsdiqlənmiş performans göstəriciləri olmamasıdır. Yeddi tətbiqin məlumat strukturu ədəbiyyatdakı ətraf mühit dəyişənlərini təqlid edən sintetik/benchmark məlumatlarla qurulmuşdur. Random Forest üçün təxminən \(R^2=0{,}88\), XGBoost üçün ROC-AUC təxminən 0,91, mikroplastik 1-B CNN üçün %95-dən yuxarı dəqiqlik, PFAS LSTM üçün 0,05 ng/g-dən aşağı bir-addım-irəli RMSE, PCA üçün birinci komponentdə təxminən %45 izah olunan variasiya, Monte Carlo PLI üçün təxminən ±0,4 vahidlik %90 etibar intervalı və məkan EF xəritələşdirilməsi üçün təxminən 0,38 EF vahidi çarpaz doğrulama RMSE-si bildirilmişdir. Bunların hamısı metodoloji workflow nümayişidir.
Tədqiqat həmçinin hesablama analizini torpaq ekosistem xidmətləri ilə əlaqələndirən altı mərhələli çərçivə qurur: çirklənmə mənbələrinin müəyyənləşdirilməsi, çirkləndirici davranışının modelləşdirilməsi, ssenari proqnozu, ekoloji risk qiymətləndirilməsi, çoxfaktorlu analiz və proqnoz/idarəetmə. Beləliklə məqsəd yalnız bir ML modelinin skorunu yüksəltmək deyil; sahə nümunələnməsindən risk xəritələşdirilməsinə və bərpa qərarına qədər izlənilə bilən ətraf mühit məlumat analizi zənciri yaratmaqdır.
Tədqiqatın araşdırma problemi
Torpaq çirklənməsi yalnız bir çirkləndiricinin konsentrasiyasını ölçməkdən daha mürəkkəb problemdir. Çirkləndiricinin hərəkətliliyi və bioloji əlçatanlığı; torpaq mineralogiyası, üzvi maddə, pH, gil payı, məsamə quruluşu, hidroloji şərait, kimyəvi növləşmə və ətraf mühit prosesləri ilə birlikdə dəyişir. Bu yüksəkölçülü və qeyri-xətti quruluş klassik bir dəyişənli analizlərin ətraf mühit davranışını tam təmsil etməsini çətinləşdirir.
Tədqiqat bu problemi üç qatda nəzərdən keçirir: dərc olunmuş ətraf mühit elmləri ədəbiyyatının sintezi, torpaq ekosistem xidmətlərini analitik proseslə əlaqələndirən altı mərhələli konseptual çərçivə və yeddi icra edilə bilən Python workflow-u.
Ədəbiyyat icmalı necə aparıldı?
Mənbə Web of Science və Scopus üzərində 100-dən çox resenziyalı nəşrə əsaslanan ədəbiyyat sintezi aparmışdır. Axtarış terminləri arasında “soil pollution”, “soil contamination”, “machine learning”, “random forest”, “deep learning”, “heavy metals”, “PFAS”, “microplastics”, “pesticide leaching” və “soil ecosystem services” vardır. Əsas zaman aralığı 2015–2026-dır; metodoloji baxımdan təməl hesab edilən daha köhnə tədqiqatlar tarixi kontekst məqsədilə əhatədə saxlanılmışdır.
Daxiletmə meyarları üç əsas şərtə əsaslanmışdır: tədqiqatın ML əsaslı torpaq çirklənməsinin aşkarlanması və ya risk qiymətləndirilməsi ilə birbaşa əlaqəli olması, kəmiyyət performans metrikası və ya təsdiqlənmiş aşkarlama üsulu bildirməsi və məqalədə nəzərdən keçirilən beş əsas çirkləndirici qrupundan ən azı birini əhatə etməsi.
Tədqiqatın əhatə etdiyi əsas çirkləndirici qrupları
| Çirkləndirici qrupu | Tədqiqatdakı hesablama vəzifəsi | Əsas ekoloji problem |
|---|---|---|
| Ağır metallar | Konsentrasiya proqnozu, risk indeksləri, məkan EF xəritələşdirilməsi | Davamlı yığılma, bioloji əlçatanlıq, trofik zəncirdə yığılma |
| Pestisidlər | Sızma/leaching riskinin təsnifatı | Yeraltı suyuna daşınma, mikrobial və qida dövranına təsirlər |
| Mikroplastiklər | FTIR-bənzər spektrdən təsnifat | Torpaq quruluşu, məsaməlilik və birlikdə daşınan çirkləndiricilər |
| PFAS | Zaman sırası proqnozu | Çox yüksək ekoloji davamlılıq və uzunmüddətli yığılma |
| Həddindən artıq makroelementlər | PCA ilə ölçü azaldılması və hotspot müəyyənləşdirilməsi | N/P yükü, evtrofikasiya, yeraltı su və torpaq keyfiyyəti |
Radioaktiv çirkləndiricilər tədqiqatda mühüm torpaq kontaminasiyası sinfi kimi qəbul edilir, lakin əsas Python workflow əhatəsindən kənarda saxlanılır. Mənbə qamma spektrometriyası və qeyri-müəyyənliyin yayılmasının gələcək radionuklid qiymətləndirmələrində istifadə oluna biləcəyini bildirir.
Yeddi Python İş Axını Torpaq Çirklənməsini Necə Təhlil Edir?
Yeddi workflow eyni problemi təkrarlamaq əvəzinə müxtəlif məlumat tiplərinə uyğun gəlir: Random Forest ağır metal konsentrasiyasını reqressiya ilə, XGBoost pestisid sızma riskini təsnifatla, 1-B CNN mikroplastikləri spektral nümunə ilə, LSTM PFAS-ı zaman sırası ilə, PCA qida hotspotlarını ölçü azaldılması ilə, Monte Carlo risk indekslərində ölçmə qeyri-müəyyənliyini ehtimal üsulu ilə, GeoPandas əsaslı proses isə ağır metal zənginləşməsini məkan xəritəsində emal edir.
Workflow 1: Random Forest ilə kadmium konsentrasiyası
Birinci skript beş spektral əksolunma zolağı ilə pH, torpaq üzvi maddəsi (SOM) və gil faizindən istifadə edərək kadmium konsentrasiyasını proqnozlaşdıran Random Forest reqressiyası qurur. Məlumat sayı \(n=1000\)-dir.
Sintetik hədəf dəyişəni mənbə kodunda aşağıdakı əlaqə ilə yaradılır:
\[ C_{\mathrm{Cd}} = 2.8\,pH - 1.5\,SOM^2 + 6.0\,B_3 + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.4^2) \]
Formula nəyi hesablayır? Sintetik kadmium konsentrasiyasını mg/kg vahidində yaradır. \(B_3\) üçüncü spektral zolağın əksolunmasıdır; \(SOM\) faizlə üzvi maddə dəyişənidir; \(\varepsilon\) standart sapması 0,4 mg/kg olan Qauss səs-küyüdür.
Bu detal niyə kritikdir? Random Forest-ın yüksək \(R^2\) dəyəri təbii ekoloji əlaqəni kəşf etməsindən deyil, hədəf dəyişəninin başlanğıcdan bu predictor-ların riyazi funksiyası kimi yaradılmasından təsirlənir. Mənbə Band 3 və pH-nin dominant predictor kimi çıxmasının məlumat yaratma formulundan qaynaqlandığını xüsusi qeyd edir.
Model 200 ağac, maksimum dərinlik 12 və minimum yarpaq nümunəsi 4 ilə qurulmuş; məlumat %80 təlim və %20 test olaraq bölünmüş, əlavə olaraq beşqat çarpaz doğrulama tətbiq edilmişdir.
Nəticə: Təxminən \(R^2=0.88\), RMSE < 0,35 mg/kg. Bu dəyər sintetik nümayişə aiddir.
Mənbədaxili metod qeydi: metod təsvirində SHAP əsaslı feature importance ifadəsi olmasına baxmayaraq, dərc edilmiş Listing 1 kodu `rf.feature_importances_` istifadə edir. Bu, Random Forest-ın daxili impurity-əsaslı əhəmiyyət ölçüsüdür; dərc olunmuş Listing 1-də SHAP çağırışı görünmür.
Workflow 2: XGBoost + SHAP ilə pestisid sızma riski
İkinci skript qum, gil, SOM, yağıntı, yamac və pH-dan istifadə edərək yüksək/aşağı pestisid leaching riskini təsnif edir. Sintetik riskin yaradılmasında istifadə olunan logit:
\[ z= -0.04\,Sand +0.07\,Clay -0.30\,SOM +0.06\,Precip +0.05\,Slope -0.5 \]
və loqistik çevrilmə:
\[ P= \frac{1}{1+e^{-z}} \]
üzərindən \(P>0.5\) olduqda yüksək risk sinfi yaradılır.
Əmsalların işarəsi sintetik məlumat yaratma məntiqini açıqlayır: məsələn, bu quruluşda yağıntı və gil artdıqca \(z\) yüksəlir, SOM artdıqca isə azalır. Bu əmsallar real sahə üçün ölçülmüş universal pestisid daşınma əmsalları deyil.
XGBoost modelində 300 estimator, maksimum dərinlik 5, learning rate 0,05, subsample 0,8 və column subsampling 0,8 istifadə edilmişdir. Məlumat stratified formada %75 təlim və %25 test olaraq bölünmüşdür.
Nəticə: ROC-AUC təxminən 0,91. Bu dəyər tək bir hold-out partition-a aiddir; kodda çarpaz doğrulama dövrü yoxdur. SHAP analizi bu sintetik quruluşda yağıntı intensivliyini və gil payını əsas risk müəyyənediciləri kimi önə çıxarmışdır.
Workflow 3: 1-B CNN ilə mikroplastik təsnifatı
Üçüncü skript 128 kanallı FTIR-bənzər spektral fingerprint-lərdən mikroplastik və mineral/üzvi hissəcikləri ayırmaq üçün birölçülü Convolutional Neural Network istifadə edir. Cəmi 1200 sintetik spektr yaradılmışdır.
Mineral/üzvi sinif təxminən:
\[ X_{\mathrm{min}}\sim\mathcal{N}(0.3,0.08^2) \]
və mikroplastik sinif:
\[ X_{\mathrm{MP}}\sim\mathcal{N}(0.6,0.10^2) \]
paylanmalarından yaradılmış; mikroplastik spektrlərinin 40–44-cü və 80–84-cü kanal aralıqlarına müvafiq olaraq +0,5 və +0,4 süni absorbsiya xüsusiyyətləri əlavə edilmişdir.
Şəbəkə strukturu ardıcıllıqla 32 filtrli Conv1D (kernel=5), MaxPooling1D, 64 filtrli Conv1D (kernel=3), GlobalAveragePooling1D, 64 neyronlu Dense, %30 dropout və sigmoid çıxış qatından ibarətdir. İtki binary cross-entropy, optimizer Adam-dır. Təlim 30 epoch, batch size 32 və təlim məlumatı daxilində %15 validation split ilə aparılmışdır.
Nəticə: Sintetik hold-out spektrlərində dəqiqlik %95-dən yuxarı, F1 > 0,94 kimi bildirilmişdir. Bu nəticə real torpaq FTIR kitabxanasında təsdiqlənmiş sahə təsnifat skoru deyil.
Workflow 4: LSTM ilə PFAS zaman sırası
Dördüncü skript 10 illik, aylıq 120 nümunədən ibarət sintetik PFAS sırası yaradır:
\[ C(t) = 0.8 + 0.4\sin(t) + 0.015\,m + \varepsilon, \qquad \varepsilon\sim\mathcal{N}(0,0.05^2) \]
Burada \(m\) ay indeksidir. İlk sabit baza səviyyəsini, sinus termini mövsümsəlliyi, \(0.015m\) uzunmüddətli artımı, Qauss termini isə təsadüfi səs-küyü təmsil edir. Konsentrasiya vahidi ng/g-dir.
Sıra MinMaxScaler ilə normallaşdırılmış və 12 aylıq sürüşən pəncərədən istifadə edilmişdir. Hər 12 aylıq giriş ardıcıllığının hədəfi dərhal sonrakı tək aylıq dəyərdir.
LSTM arxitekturası 64 vahidli və sequence qaytaran birinci LSTM, %20 dropout, 32 vahidli ikinci LSTM, 16 neyronlu ReLU Dense və tək dəyər yaradan çıxış qatından ibarətdir. Model Adam + MSE ilə 50 epoch və batch size 16 istifadə edilərək öyrədilir.
Nəticə: Bir-addım-irəli PFAS proqnoz RMSE-si <0,05 ng/g-dir.
Kritik məhdudiyyət: Bu model 12 ay irəlini bir dəfəyə proqnozlaşdırmır. On iki aylıq keçmiş pəncərədən istifadə edib növbəti ayı proqnozlaşdırır. Real uzunmüddətli çoxaddımlı proqnoz üçün autoregressive rollout və müstəqil sahə doğrulaması tələb olunur.
Workflow 5: PCA ilə qida hotspotlarının aşkarlanması
Beşinci skript N, P, K, pH, SOM, nitrat və ammonium dəyişənlərindən ibarət 500 nümunəlik sintetik çoxelementli torpaq kimyası matrisi yaradır. Təsadüfi seçilmiş 50 hotspot nümunəsində N, NO3 və P dəyərləri 3,5 dəfə artırılmışdır.
Əvvəlcə bütün dəyişənlər StandardScaler ilə standartlaşdırılmış, sonra məlumat iki principal component-ə azaldılmışdır. PCA-nın ümumi riyazi ideyası yüksəkölçülü məlumat fəzasını bir-birinə perpendikulyar yeni oxlara proyeksiya etməklə variasiyanın mümkün qədər böyük hissəsini ilk komponentlərdə toplamaqdır.
Nəticə: PC1 ümumi variasiyanın təxminən %45-ni izah etmiş və süni yaradılmış yüksək N/NO3/P hotspot qrupunu ayırmışdır. Buna görə N və P-nin dominant çıxması müstəqil sahə kəşfi deyil; hotspot yaratma addımının özü bu üç dəyişəni xüsusi olaraq yüksəldir.
Workflow 6: Monte Carlo ilə PLI və Igeo qeyri-müəyyənliyi
Altıncı skript dörd metal üçün laboratoriya ölçmə qeyri-müəyyənliyini 50.000 Monte Carlo realizasiyası boyunca risk indekslərinə yayır.
| Metal | Geogen fon (mg/kg) | Sintetik ölçmə ortalaması ± SD (mg/kg) |
|---|---|---|
| Cd | 0,3 | 1,8 ± 0,25 |
| Pb | 20 | 85 ± 9 |
| As | 5 | 22 ± 2,5 |
| Cr | 50 | 120 ± 15 |
İlk hesablanan kəmiyyət contamination factor-dur:
\[ CF_i= \frac{C_{i,\mathrm{measured}}} {C_{i,\mathrm{background}}} \]
Nə deməkdir? Mövcud konsentrasiyanın təbii/geogen fona nisbətən neçə dəfə yüksəldiyini göstərən ölçüsüz nisbətdir. \(CF_i=1\) ölçmə ilə fonun eyni olduğunu, daha böyük dəyərlər isə fon üzərində zənginləşməni ifadə edir.
Pollution Load Index dörd metalın contamination factor-larının həndəsi ortası ilə hesablanır:
\[ PLI= \left( \prod_{i=1}^{n}CF_i \right)^{1/n} \]
\(n\) metal sayıdır. Bu skriptdə \(n=4\)-dür. Həndəsi orta tək bir çox yüksək metalın arifmetik cəm kimi birbaşa dominant olmasını azaldarkən bütün çirkləndirici yükünü bir ölçüsüz indeksdə birləşdirir. Mənbə nümayişində \(PLI=1\) çirklənmə təsnifatı baxımından mühüm istinad həddidir.
Kadmium üçün Geo-accumulation Index:
\[ I_{\mathrm{geo,Cd}} = \log_2 \left( \frac{C_{\mathrm{Cd}}} {1.5\,B_{\mathrm{Cd}}} \right) \]
şəklində hesablanır. \(B_{\mathrm{Cd}}\) kadmiumun fon konsentrasiyasıdır. 1,5 amili təbii geokimyəvi dəyişkənliyi nəzərə alan düzəliş əmsalıdır.
Nəticə: 50.000 realizasiyada PLI üçün təxminən ±0,4 vahidlik %90 etibar intervalı bildirilmişdir. Mənbə bu intervalın bəzi realizasiyalarda PLI sinfini 1 hədd dəyərinin iki tərəfinə daşıya bildiyini göstərir. Kadmium \(I_{\mathrm{geo}}\) paylanmasında realizasiyaların təxminən %15-i \(I_{\mathrm{geo}}>3\) Class 4 həddini aşarkən ensemble ortalaması Class 3-də qalmışdır. Bu nümunə tək deterministik risk dəyərinin yüksək risk quyruğunu gizlədə biləcəyini göstərir.
Workflow 7: GeoPandas ilə məkan EF xəritəsi
Yeddinci skript 150 sintetik nümunələmə nöqtəsi yaradır və Pb konsentrasiyasını Fe istinad elementinə görə normallaşdıran Enrichment Factor hesablayır:
\[ EF_{\mathrm{Pb}} = \frac{ C_{\mathrm{Pb}}/C_{\mathrm{Fe}} }{ B_{\mathrm{Pb}}/B_{\mathrm{Fe}} } \]
\(C_{\mathrm{Pb}}\) və \(C_{\mathrm{Fe}}\) nümunədə ölçülən Pb və Fe konsentrasiyaları; \(B_{\mathrm{Pb}}\) və \(B_{\mathrm{Fe}}\) regional fon dəyərləridir. Skriptdə \(B_{\mathrm{Pb}}=20\) mg/kg və \(B_{\mathrm{Fe}}=25\,000\) mg/kg istifadə edilmişdir.
EF nisbət olduğu üçün ölçüsüzdür. Mənbə kodunda siniflər:
| EF | Mənbə kodundakı sinif |
|---|---|
| \(EF<2\) | Minimal |
| \(2\leq EF<5\) | Moderate |
| \(5\leq EF<20\) | Significant |
| \(EF>20\) | Very high |
Mənbənin nəticələr bölməsində \(EF_{\mathrm{Pb}}>5\) olan şimal-şərq hotspotunun sahənin təxminən %12-ni əhatə etdiyi və %20 withheld nöqtəyə görə çarpaz doğrulama RMSE-sinin təxminən 0,38 EF vahidi olduğu bildirilmişdir.
Mənbədaxili metod fərqi: Mətn və nəticələr bu səthi “IDW” adlandırır. Lakin dərc edilmiş Listing 7-də interpolasiya çağırışı `scipy.interpolate.griddata(..., method="linear")` formasındadır. `griddata` daxilində xətti interpolasiya ilə klassik inverse-distance weighting eyni alqoritm deyil. Verianla mənbə kodunu dəyişmir və bu adlandırma fərqini görünən saxlayır. Bundan əlavə, nəticələr bölməsindəki %20 withheld-point doğrulama kodu dərc edilmiş Listing 7-nin görünən sətirlərində yoxdur.
Bu Performans Nəticələri Real Çirklənmiş Sahələrdəki Uğuru Göstərirmi?
Xeyr. Tədqiqatın performans dəyərləri nəzarət olunan sintetik/benchmark məlumat strukturlarındakı workflow nümayişləridir; real çirklənmiş sahələrdə müstəqil xarici doğrulama aparılmamışdır və mənbə real tətbiqdə sahə məlumatı, məkan çarpaz doğrulaması, bölgəyə xas hiperparametr optimallaşdırması və müstəqil validasiya tələb olunduğunu açıq bildirir.
Tədqiqatın Metodu və Nəticələri
Yeddi workflow-un ümumi performansı
| Skript | Vəzifə | Metod | Metrik | Mənbədə bildirilən sintetik nəticə |
|---|---|---|---|---|
| 1 | Kadmium konsentrasiyası | Random Forest reqressiyası | \(R^2\) / RMSE | \(R^2\approx0.88\); RMSE <0,35 mg/kg |
| 2 | Pestisid leaching | XGBoost + SHAP | ROC-AUC | ≈0,91; tək hold-out split |
| 3 | Mikroplastik | 1-B CNN | Accuracy / F1 | Accuracy >%95; F1 >0,94 |
| 4 | PFAS zaman sırası | LSTM | RMSE | <0,05 ng/g; bir-addım-irəli |
| 5 | Qida hotspotları | PCA | İzah olunan variasiya | PC1 ≈%45; hotspot ayrılmışdır |
| 6 | Çoxmetallı risk | Monte Carlo PLI/Igeo | %90 etibar intervalı | PLI ≈±0,4 vahid; 50.000 realizasiya |
| 7 | Məkan EF | GeoPandas / mənbədə “IDW” | CV RMSE | ≈0,38 EF vahidi |
Metodların real məlumatlara köçürülə bilməsi
| Metod | Məlumat tələbi | Şərh edilə bilmə | Hesablama xərci | Qeyri-müəyyənlik | Mənbənin real məlumat qiymətləndirməsi |
|---|---|---|---|---|---|
| Random Forest | Orta; tabular | Yüksək | Aşağı–orta | Bootstrap CI tətbiq oluna bilər | Yaxşı; məkan CV-si lazımdır |
| XGBoost + SHAP | Orta; tabular | Yüksək | Aşağı–orta | Daxili deyil | Yaxşı; stratified CV tövsiyə olunur |
| 1-B CNN | Böyük spektral kitabxana | Orta | Orta | Dropout | Orta; transfer learning tövsiyə olunur |
| LSTM | Uzun zaman sırası | Aşağı | Orta–yüksək | Daxili deyil | Orta; sahəyə xas sazlama lazımdır |
| PCA | Etiketsiz məlumat kifayətdir | Yüksək | Çox aşağı | Daxili deyil | Yüksək; unsupervised |
| Monte Carlo | Ehtimal paylanmaları | Yüksək | Aşağı | Açıq şəkildə CI | Yüksək; qeyri-müəyyənlik üçün hazırlanıb |
| GeoPandas xəritələşdirməsi | Məkan nümunə nöqtələri | Yüksək | Aşağı | Daxili deyil | Orta; məkan avtokorrelyasiyasına nəzarət lazımdır |
Torpaq ekosistem xidmətləri ilə əlaqə
Tədqiqatın fərqləndirici cəhətlərindən biri yeddi kod nümunəsini yalnız texniki ML vəzifələri kimi saxlamamasıdır. Listing 1 və 2 çirkləndiricinin tutulması/azaldılması ilə; Listing 2 və 5 su tənzimlənməsi və qida dövranı ilə; Listing 3 və 4 habitat və biokütlə istehsalı ilə; Listing 6 karbon saxlanması və ekoloji risklə; Listing 7 isə məkan risk idarəetməsi və bərpa planlaşdırılması ilə əlaqələndirilmişdir.
Tədqiqatın dəstəklədiyi nəticələr
- Python ilə müxtəlif məlumat tiplərini əhatə edən modul torpaq çirklənməsi analiz zəncirinin qurula bildiyi göstərilmişdir.
- Sintetik nümayişdə RF Cd hədəfində yerləşdirilmiş qeyri-xətti quruluşu təxminən \(R^2=0.88\) ilə yenidən öyrənmişdir.
- XGBoost + SHAP sintetik pestisid risk quruluşunda təxminən 0,91 ROC-AUC əldə etmişdir.
- 1-B CNN açıq şəkildə ayrılmış sintetik FTIR-bənzər spektrlərdə %95-dən yuxarı təsnifat dəqiqliyi təmin etmişdir.
- LSTM mövsümsəllik və xətti artımın məlumat yaradılmasında açıq təyin edildiyi PFAS sırasında bir-addım-irəli RMSE-ni 0,05 ng/g-dən aşağı saxlamışdır.
- PCA süni şəkildə üç yarım dəfə yüksəldilmiş N/NO3/P hotspot qrupunu PC1 üzərində ayırmış və təxminən %45 variasiyanı izah etmişdir.
- Monte Carlo analizi tək dəyərli PLI/Igeo hesabatının qeyri-müəyyənlik quyruqlarını gizlədə biləcəyini nümayiş xarakterli göstərmişdir.
- Mənbə nəticələrinə görə məkan EF pipeline-ı aydın hotspot yaratmış və təxminən 0,38 EF vahidi doğrulama RMSE-si bildirilmişdir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr və məhdudiyyətlər
- Heç bir model real çirklənmiş sahə məlumat dəstində müstəqil xarici doğrulamadan keçirilməmişdir.
- Yüksək performans göstəriciləri real ekoloji əlaqələrin kəşfinin sübutu deyil; sintetik məlumat yaradılmasında güclü siqnallar əvvəlcədən kodlaşdırılmışdır.
- RF-də Band 3 və pH-nin mühüm çıxması hədəf dəyişəninin bu dəyişənlərin funksiyası kimi yaradılması ilə birbaşa əlaqəlidir.
- PCA-da N, nitrat və P hotspotunun ayrılması bu dəyişənlərin seçilmiş 50 nümunədə 3,5 dəfə artırılması ilə bağlıdır.
- LSTM uzunmüddətli çoxaddımlı real PFAS proqnozunu təsdiqləməmişdir.
- Radionuklidlər əsas əhatədən kənardadır.
- Real ekoloji tətbiqlərdə məkan avtokorrelyasiyası, sahə nümunələmə dizaynı, cihaz xətası, məlumat sürüşməsi və yerli geokimya ayrıca qiymətləndirilməlidir.
- Listing 1-in SHAP təsviri ilə dərc olunmuş importance kodu arasında metodoloji adlandırma fərqi vardır.
- Listing 7-nin “IDW” adlandırması ilə `griddata(method="linear")` tətbiqi eyni riyazi interpolasiya üsulu deyil.
- Listing 7 üçün bildirilən withheld-point çarpaz doğrulama prosesi dərc olunmuş kodun görünən Listing bölməsində yoxdur.
Təkrar istehsal oluna bilmə baxımından istifadə olunan alətlər
Python versiyası 3.12 kimi göstərilmişdir. İstifadə olunan əsas açıq mənbəli kitabxanalar scikit-learn, XGBoost, TensorFlow/Keras, SHAP, GeoPandas, SciPy, NumPy, pandas və Matplotlib-dir. Tədqiqatın məqsədi bu kodları son sahə modelləri kimi təqdim etmək deyil, real çirklənmiş sahə məlumat dəstlərinə uyğunlaşdırıla bilən öz-özlüyündə anlaşılan analiz şablonları yaratmaqdır.
Mənbə və Metod Qeydi
Orijinal başlıq: Python-Powered Environmental Intelligence: Computational Workflows for Soil Pollution Assessment Using ML Methods
Müəllif: Polina Lemenkova.
Qurumlar: Bureau de Recherches Géologiques et Minières (BRGM), Orléans, Fransa; Le Studium, Institut d’Etudes Avancées du Val de Loire, Orléans, Fransa; Le Laboratoire PRISME, INSA Centre-Val de Loire / Université d’Orléans, Fransa; La Technopole d’Orléans, Fransa.
Jurnal: Environmental Remediation.
Nəşriyyat: MDPI.
Biblioqrafik qeyd: Environ. Remediat. 2026, 1(2), 6.
DOI: 10.3390/environremediat1020006
Rəsmi keçid: https://doi.org/10.3390/environremediat1020006
Academic Editor: Wenjie Ren.
Təqdim: 23 may 2026. Reviziya: 16 iyun 2026. Qəbul: 23 iyun 2026. Nəşr: 8 iyul 2026.
Mənbə növü: Resenziyalı metodoloji workflow tədqiqat məqaləsi; ədəbiyyat sintezi ilə sintetik/benchmark məlumatlar üzərində yeddi təkrar istehsal edilə bilən Python nümayişini birləşdirir. Mənbə özünü sərt bibliometrik mənada sistematik icmal kimi deyil, methodological workflow paper kimi müəyyən edir.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşmə: Mənbə “This research received no external funding” bəyanatını verir.
Etik komitə / razılıq: Tətbiq edilə bilməz kimi bildirilmişdir.
Məlumatların əlçatanlığı: Mənbə tədqiqatın orijinal töhfələrinin məqalənin daxilində olduğunu bildirir.
Maraqların toqquşması: Müəllif maraqların toqquşmasının olmadığını bildirmişdir.
Müəllif töhfələri: Mənbə PDF-nin son bəyanatlar bölməsində ayrıca CRediT/Author Contributions paraqrafı yoxdur; tək müəllifli tədqiqat üçün mənbədə olmayan töhfə rolları əlavə edilməmişdir.
Əsas metodoloji məhdudiyyət: Məqalədəki bütün model performansları sintetik və ya nümayiş benchmark məlumatlarına əsaslanır. Real çirklənmiş sahələr üçün müstəqil sahə validasiyası, uyğun məkan çarpaz doğrulaması, hədəf bölgəyə xas hiperparametr optimallaşdırması və məlumat keyfiyyəti qiymətləndirilməsi tələb olunur.
Mənbədaxili metod qeydləri: Listing 1 təsviri SHAP əsaslı əhəmiyyət sıralamasını qeyd etdiyi halda görünən kod Random Forest-ın `feature_importances_` çıxışından istifadə edir. Listing 7 mətndə IDW adlandırılsa da görünən interpolasiya kodunda `griddata(method="linear")` istifadə edilir. Results bölməsində Listing 7 üçün %20 withheld-point doğrulaması və təxminən 0,38 EF RMSE bildirilir, lakin bu doğrulama dövrü dərc olunmuş Listing 7-nin görünən kod sətirlərində yoxdur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib