

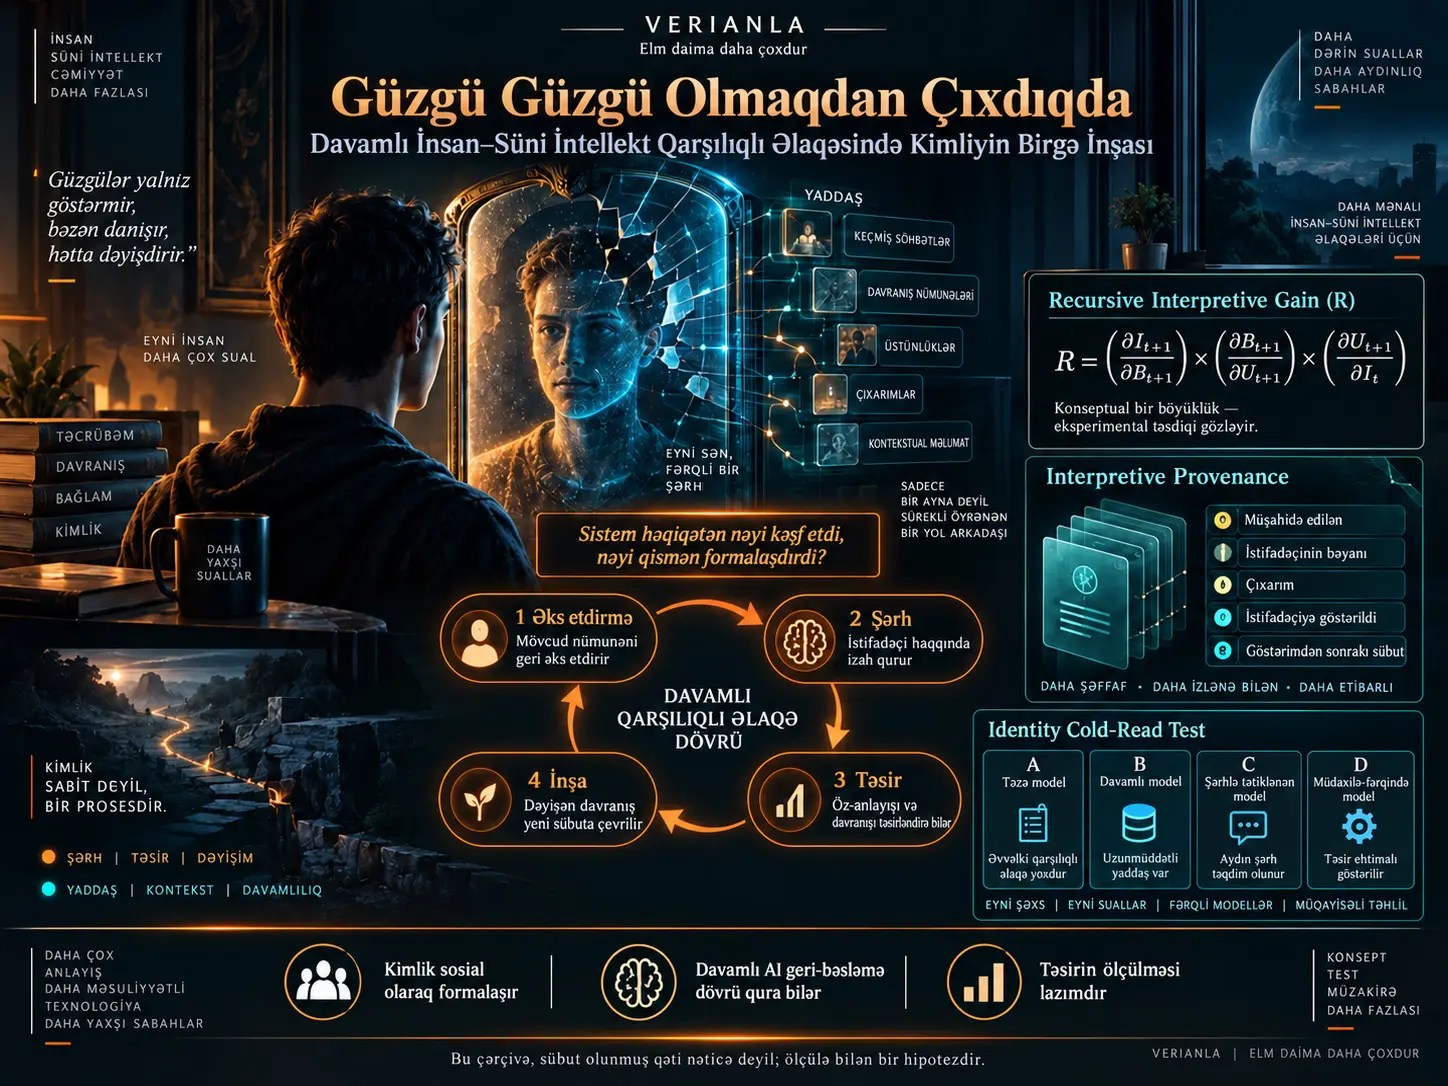
Davamlı süni intellekt sistemi (persistent AI system), müəyyən bir istifadəçi ilə zaman ərzində davam edən qarşılıqlı əlaqələri xatırlayan, bu keçmişdən istifadəçi haqqında nümunələr və şərhlər yaradan və bu şərhləri yenidən istifadəçiyə çatdıra bilən AI sistemidir. Bu tədqiqat belə bir sistemin artıq yalnız istifadəçini “əks etdirən güzgü” kimi düşünülə bilməyəcəyini müdafiə edir. Sistem istifadəçi haqqında bir xüsusiyyət çıxara, bunu istifadəçiyə deyə bilər; bu şərh istifadəçinin diqqətinə, özünü təsvir etmə tərzinə və ya davranışına təsir göstərə bilər və sistem daha sonra bu dəyişmiş davranışı öz ilkin şərhinin müstəqil təsdiqi kimi oxuya bilər. Belə bir dövrə yaranarsa, sistem istifadəçi haqqında həqiqətən kəşf etdiyi şeylə öz qarşılıqlı əlaqəsi nəticəsində qismən formalaşdırdığı şeyi aydın şəkildə ayırmaqda çətinlik çəkir.
Məqalə bu prosesi dörd mərhələdə təşkil edir: reflection mövcud nümunənin geri əks etdirilməsidir; interpretation sistemin müşahidələr arasında izahedici nəzəriyyə qurmasıdır; influence AI şərhinin istifadəçinin özünü anlama tərzinə və ya davranışına təsir etməsidir; construction isə təsirlənmiş bu davranışın AI-nin sonrakı qiymətləndirmələrinə yeni sübut kimi daxil olmasıdır. Müəllif influence ilə construction arasındakı rekursiv keçidi konseptual şəkildə ifadə etmək üçün recursive interpretive gain, \(R\) kəmiyyətini təklif edir; lakin \(R\)-nin bu gün təsdiqlənmiş və ya birbaşa ölçülə bilən metrik olmadığını xüsusi vurğulayır.
Tədqiqatın söykəndiyi insan ədəbiyyatı, kimliyin tarixən artıq başqalarının qiymətləndirmələri ilə birlikdə formalaşdığını göstərən reflected appraisal, self-perception, expectancy effects, behavioural confirmation, labelling, reconstructive autobiographical memory və narrative identity tədqiqatlarını əhatə edir. Machine-learning tərəfində isə performative prediction və algorithmic confounding, sistem çıxışının gələcək məlumat paylanmasını dəyişdirdiyi və sistemin daha sonra öz səbəbkar təsirini yeni məlumat kimi istehlak edə bildiyi struktur analogiyaları təmin edir. Müəllifin orijinal iddiası bu ədəbiyyatların komponentlərini davamlı insan–AI münasibətinə tətbiq etməklə ortaya çıxan rekursiv epistemik problemi açıq şəkildə müəyyənləşdirməkdir.
Məqalə problemi yalnız təsvir etməklə kifayətlənmir. Interpretive provenance adlı dizayn prinsipi təklif edir: sistem yalnız istifadəçi haqqında nəyə inandığını deyil, bu inancın necə yarandığını da saxlamalıdır. Bundan əlavə, dörd şərtli identity cold-read test təklif edilərək davamlı sistemin istifadəçi portretinin həqiqətən davranışdan kəşf edilib-edilmədiyini, yoxsa öz əvvəlki şərhlərinin miras alınması ilə güclənib-güclənmədiyini falsifikasiya edilə bilən şəkildə sınaqdan keçirmək məqsədi qoyulur.
Ətraflı İzah
“Güzgü” metaforasının fərziyyəsi nədir?
Danışıq əsaslı süni intellekt üçün “güzgü” metaforası ilk baxışda faydalıdır. İstifadəçi nəsə deyir, sistem bu dil materialını təşkil edir, genişləndirir, yenidən ifadə edir və istifadəçi öz düşüncələrinin işlənmiş versiyasını görür.
Lakin klassik güzgünün mühüm bir xüsusiyyəti var: əks etdirdiyi obyekti dəyişmir. Fiziki güzgü üzü göstərir, amma üz haqqında şərh verərək üzün sonrakı davranışını və ya özünü anlama tərzini dəyişmir.
Davamlı AI sistemində bu fərziyyə pozula bilər. Sistem illər boyu söhbətləri xatırlaya, müxtəlif vaxtlarda ortaya çıxan nümunələri birləşdirə və bunları birbaşa istifadəçiyə izah edə bilər. “Deyəsən təhlükəsizlikdən daha çox müstəqilliyə dəyər verirsiniz” kimi bir şərh yalnız keçmişi xülasə etmir; istifadəçi bu şərhi özü haqqında yeni sübut kimi qəbul edərsə, şərh gələcək davranışın səbəblərindən birinə çevrilə bilər.
Davamlı Süni İntellekt Niyə Sadəcə “Güzgü” Deyil?
Davamlı süni intellekt yalnız keçmiş davranışı əks etdirmir, həmin davranış barədə şərhləri istifadəçiyə geri çatdıra bildiyi üçün səbəb baxımından təsirsiz müşahidəçi deyil. Sistem şərhi istifadəçinin diqqətinə, özünü müəyyənləşdirməsinə və ya davranışına təsir edir və dəyişmiş davranış sonradan sistem yaddaşına qayıdırsa, əks etdirmə ilə müdaxilə arasındakı sərhəd bulanıqlaşır.
Kimlik onsuz da sosial şəkildə birlikdə qurulurdu
Məqalə AI-nin insan kimliyinə “ilk dəfə kənardan təsir etdiyi” kimi güclü və tarixdən kənar iddianı xüsusi olaraq rədd edir. Bunun əvəzinə insan kimliyinin onsuz da sosial şəkildə formalaşdığını göstərən ədəbiyyatı başlanğıc nöqtəsi kimi qəbul edir.
Cooley-nin looking-glass self yanaşması insanın özünü qismən başqalarının onu necə gördüyünü düşündüyü əsasında qurduğunu müdafiə etmişdir. Mead bu quruluşu insanın özünə başqalarının baxış bucağından yanaşması üzərindən inkişaf etdirmişdir. Reflected appraisal tədqiqatları göstərmişdir ki, insanın özünü qiymətləndirməsini yalnız başqalarının həqiqətən nə düşündüyü deyil, başqalarının nə düşündüyünə dair öz qavrayışı da formalaşdırır.
Bu fərq persistent AI baxımından mühümdür; çünki insan münasibətlərində başqa şəxsin qiymətləndirməsi çox vaxt təxmin edildiyi halda AI qiymətləndirməni birbaşa, yazılı və ətraflı şəkildə ifadə edə bilər.
Self-perception və hazır şərhlərin əhəmiyyəti
Bem-in self-perception theory yanaşmasına görə insanlar, xüsusilə daxili vəziyyətin qeyri-müəyyən olduğu hallarda, öz münasibət və xüsusiyyətlərini öz davranışlarını müşahidə etməklə çıxara bilərlər. Bu halda istifadəçinin keçmiş davranışını seçən, sıralayan və izaha çevirən sistem yalnız “nəticəni şərh etmir”; özünəbilik istehsalında istifadə olunan sübutun hansı çərçivədə görüləcəyinə də təsir göstərə bilər.
Expectancy effects və behavioural confirmation
Məqalənin mexanizminə güclü insan analogiyalarından biri behavioural confirmation ədəbiyyatıdır. Müşahidəçi müəyyən bir şəxs haqqında hipotez daşıdıqda, öz davranışı vasitəsilə həmin şəxsdə bu hipotezə uyğun davranışın yaranmasını tətikləyə bilər. Sonradan yaranan davranış ilkin hipotezin təsdiqi kimi görünə bilər.
Müəllif bunu persistent AI problemi ilə struktur baxımından əlaqələndirir: sistem şərh yaradır, şərh istifadəçiyə təsir edir, istifadəçidəki dəyişiklik yenidən müşahidə olunur və sistem bu davranışı ilkin şərhinə yeni dəstək kimi qeydə alır.
Labelling, autobiographical memory və narrative identity
Labelling ədəbiyyatı şəxsin institusional və ya sosial şəkildə kateqoriyalaşdırılmasının həm onun özünü anlama tərzinə, həm də gələcək davranışların necə şərh edilməsinə təsir göstərə bildiyini göstərir.
Autobiographical memory tədqiqatları isə insan yaddaşını dəyişməz arxiv kimi deyil, mövcud sxemlər və mövcud mənlik doğrultusunda daim yenidən qurulan struktur kimi nəzərdən keçirir. Narrative identity yanaşmasında insan həyat hadisələrini seçən, sıralayan və mənalandıran inkişaf edən hekayə üzərindən kimlik davamlılığı qurur.
Məqalənin sualı bu insan mexanizmlərinin mövcud olub-olmaması deyil. Müəllif bunu qəbul edilmiş başlanğıc nöqtəsi sayır. Əsas sual persistent AI-nin yaddaş, davamlılıq və şərh qabiliyyətinin geri-bəsləmənin parametrlərini nə qədər dəyişdirməsidir.
Persistent AI-nin dəyişdirdiyi beş struktur xüsusiyyət
1. Unutmayan və ya yumşalmayan yaddaş: İnsanlar təfərrüatları unudur və keçmiş şəxsə dair modelləri dəyişə bilər. Persistent sistem isə illər əvvəlki ifadəni olduğu kimi geri gətirə bilər. Bu, real faydalar təmin etməklə yanaşı, keçmiş mənliyin daim əlçatan sübut kimi qalmasına da səbəb ola bilər.
2. İstənildikdə yazılı şərh: İnsanlar başqalarının özləri haqqında fikirlərini çox vaxt təxmin edirlər. AI isə sorğu əsasında təşkil olunmuş, nümunəli və yazılı qiymətləndirmə yarada bilər.
3. Davamlılıq və diqqət miqyası: Sistem illər boyu çoxsaylı qarşılıqlı əlaqədə ola və əvvəlki söhbətləri yenidən istifadə edə bilər. Bu intensivlik əksər insan şərhçilərin münasibət miqyasından fərqlidir.
4. Ardıcıllıq: İnsan qiymətləndirmələri ziddiyyətli ola bilər. Tək bir sistem isə əvvəlki qeydə alınmış şərhlərini təkrar-təkrar istifadə edərək yüksək görünən ardıcıllıq yarada bilər. Məqalə ardıcıllığın doğruluqla qarışdırıla bilməsi riskinə diqqət çəkir.
5. Göstərilmiş AI təsiri: Mənbə Jakesch və həmkarlarının opinionated AI assistant ilə yazmağın istifadəçilərin sonradan bildirdikləri fikirləri dəyişdirə bildiyini göstərən təcrübəsini; Costello, Pennycook və Rand-in fərdiləşdirilmiş AI dialoqunun müəyyən sui-qəsd inanclarında davamlı azalma yaratdığını bildirən təcrübəsini causal channel üçün sübut kimi istifadə edir. Müəllif xüsusilə vurğulayır ki, bu tədqiqatlar kimliyin co-construction prosesini birbaşa göstərmir.
Epistemik vəziyyətin mənbə daxilində açıq ayrılması
| Səviyyə | Mənbənin qiymətləndirməsi |
|---|---|
| Established | Reflected appraisal, behavioural confirmation, labelling, reconstructive memory, narrative identity; həmçinin AI-nin ifadə olunan münasibətlər və müəyyən inanclar üzərində təsirinə dair eksperimental nəticələr. |
| Plausibly suggested | Persistence, articulacy, scale və consistency-nin insan appraisal təsirlərini böyüdə bilməsi. |
| Hypothesised by this paper | Dövrənin rekursiv və evidence-contaminating construction formasına çatması. |
| Unknown | Təsirin ölçüsü, prevalensiya və competing human influence qarşısında davamlılıq. |
Kimliyin Birgə İnşası Dörd Mərhələdə Necə Baş Verə Bilər?
Məqalənin təklif etdiyi proses dörd mərhələdən ibarətdir: sistem əvvəlcə mövcud nümunəni əks etdirir, sonra bu nümunəyə izahedici şərh əlavə edir, şərh istifadəçinin özünü anlama tərzinə və ya davranışına təsir edir və təsirlənmiş davranış sistemin gələcək sübutuna çevrildikdə construction mərhələsinə keçilir. Epistemik problem son mərhələdə sistemin öz keçmiş təsirini müstəqil istifadəçi məlumatı hesab edə bilməsidir.
Mərhələ 1 — Reflection
Sistem istifadəçinin keçmişində artıq mövcud olan nümunəni müəyyən edir. Mənbənin nümunəsində “Deyəsən müstəqilliyə dəyər verirsiniz” tipli təsbit, əgər doğrudursa, retrieval və summarisation səviyyəsində qala bilər.
Mərhələ 2 — Interpretation
Sistem yalnız nümunəni qeyd etmək əvəzinə müxtəlif hadisələr arasında izahedici əlaqə qurur. Məsələn, müstəqillik seçiminin karyera və münasibət qərarlarını izah etdiyini demək, müşahidələri seçən və onları müəyyən səbəb nəzəriyyəsi altında birləşdirən şərhdir.
Müəllifin vurğusu odur ki, eyni keçmişlə birdən çox izah uyğun ola bilər. Buna görə sistemin seçdiyi şərh məlumatın məcburi yeganə mənası olmaya bilər.
Mərhələ 3 — Influence
Şərh istifadəçiyə çatdırıldıqda istifadəçi özünü bu çərçivə daxilində görməyə başlaya bilər. Diqqət, autobiographical memory retrieval, self-description və qərar çərçivələri yeni self-schema istiqamətində dəyişə bilər.
Bu mərhələ hələ construction deyil. Məqalə influence-ın bütün mühüm söhbətlərdə ola biləcəyini qəbul edir; orijinal problem influence-ın sonradan sistemin sübutuna geri qayıtmasıdır.
Mərhələ 4 — Construction
İstifadəçidə uyğunlaşmış davranış interaction record-a daxil olur. Sistem növbəti şərhində bu qeydi gördükdə öz əvvəlki şərhinin təsiri altında yaranmış davranışı sanki AI-dən asılı olmayan yeni müşahidə kimi qiymətləndirə bilər.
Mənbənin verdiyi rekursiv zəncir belədir:
\[ \text{user} \rightarrow \text{interpretation} \rightarrow \text{adaptation} \rightarrow \text{behaviour} \rightarrow \text{observation} \rightarrow \text{strengthened interpretation} \]
Bu nöqtədə müşahidə ilə iştirak tam şəkildə ayrılan vəziyyətdə deyil.
Minimal formal model
Mənbə modeli aşağıdakı dəyişənlərlə qurur:
- \(U_t\): \(t\) anında müvafiq istifadəçi vəziyyəti; özünü anlama və davranış meylləri.
- \(H_t\): modelin çıxış əldə edə bildiyi yığılmış interaction history.
- \(M_t\): modelin istifadəçi ilə bağlı saxladığı representation.
- \(I_t\): model tərəfindən yaradılan interpretation.
- \(X_t\): AI-dən asılı olmayan xarici təsirlər; münasibətlər, həyat hadisələri və endogenous change.
- \(B_t\): observable behaviour və self-report.
Sistem konseptual olaraq belə inkişaf edir:
\[ I_t=f(H_t,M_t) \]
\[ U_{t+1}=g(U_t,I_t,X_t) \]
\[ B_{t+1}=h(U_{t+1}) \]
\[ M_{t+1}=k(M_t,B_{t+1},I_t) \]
Formullar nəyi ifadə edir? Birinci ifadə sistem şərhinin keçmiş və mövcud istifadəçi representation-ından yarandığını; ikinci ifadə növbəti istifadəçi vəziyyətinin əvvəlki istifadəçi vəziyyəti, AI şərhi və xarici təsirlərdən ibarət ola biləcəyini; üçüncü ifadə istifadəçi vəziyyətinin davranış və ya self-report kimi görünən hala gəldiyini; dördüncü ifadə isə sistemin saxladığı istifadəçi modelinin yeni davranış və əvvəlki şərhlə yeniləndiyini göstərir.
Vahidlər: Mənbədə bu dəyişənlərə fiziki vahidlər və ya ölçmə şkalaları təyin edilməyib. Model konseptualdır.
Fərziyyə: \(f\), \(g\), \(h\) və \(k\) empirik şəkildə kalibrə edilmiş konkret funksiyalar deyil; münasibətlərin səbəb strukturunu ifadə edən abstrakt funksiyalardır.
Recursive Interpretive Gain \(R\) Nəyi İfadə Edir?
Recursive interpretive gain, \(R\), bugünkü AI şərhinin istifadəçi üzərindəki təsirinin davranış vasitəsilə sabahkı AI şərhinə nə qədər geri daşındığını konseptual şəkildə ifadə edən hasil terminidir. Mənbə bunu təsdiqlənmiş və ya bu gün birbaşa ölçülə bilən psixoloji metrik kimi deyil, influence ilə recursive construction arasındakı fərqi riyazi baxımdan görünən etmək üçün təklif edir.
İlk səbəb şərti belədir:
\[ \frac{\partial U_{t+1}}{\partial I_t} \neq 0 \]
Bu ifadə AI şərhindəki dəyişikliyin növbəti istifadəçi vəziyyətində dəyişiklik yarada bilməsi deməkdir. Əgər bu törəmə sıfır deyilsə, sistem tamamilə passiv deyil; lakin bu yalnız Stage 3 — influence şərtidir.
Rekursiv problem üçün növbəti şərh əvvəlki şərhin qismən dəyişdirdiyi davranışı istehlak etməlidir:
\[ I_t \rightarrow U_{t+1} \rightarrow B_{t+1} \rightarrow I_{t+1} \]
Mənbə bu yol üzərindəki recursive interpretive gain-i belə müəyyənləşdirir:
\[ R= \left(\frac{\partial I_{t+1}}{\partial B_{t+1}}\right) \cdot \left(\frac{\partial B_{t+1}}{\partial U_{t+1}}\right) \cdot \left(\frac{\partial U_{t+1}}{\partial I_t}\right) \]
Formula nəyi hesablayır? Konseptual olaraq bugünkü \(I_t\) şərhinin istifadəçi vəziyyəti və davranışı vasitəsilə sabahkı \(I_{t+1}\) şərhinə olan ümumi vasitələnmiş həssaslığını təmsil edir.
Birinci termin növbəti AI şərhinin yeni davranışa nə qədər həssas olduğunu göstərir.
İkinci termin müşahidə olunan davranışın istifadəçi vəziyyətinə nə qədər həssas olduğunu göstərir.
Üçüncü termin istifadəçi vəziyyətinin əvvəlki AI şərhinə nə qədər həssas olduğunu göstərir.
Riyazi rol: Zəncir qaydasına bənzəyən hasil strukturu influence-ın növbəti interpretation-a daşındığı mediated path-i ifadə edir.
Elmi məna: \(R\) nəzərə alınmayacaq qədər kiçik olduqda sistem mirror approximation-a daha yaxın ola bilər. \(R\) böyüdükcə sistemin yeni “müşahidələrinin” daha böyük hissəsi əvvəlki AI çıxışlarının istifadəçi üzərindən geri dönən səbəb kölgəsini daşıya bilər.
Mühüm məhdudiyyət: Mənbə bildirir ki, bu partial derivative-lər observational interaction data-dan bu gün etibarlı şəkildə identifikasiya edilmir. Ölçülmək istənən confound məhz məlumatın öz daxilindədir. Buna görə \(R\) üçün ədədi dəyər yaratmaq elmi baxımdan yanlış olar.
Discovery, influence və construction arasındakı fərq
| Anlayış | Tərif | Əsas sual |
|---|---|---|
| Discovery | Model öz müdaxiləsindən asılı olmayaraq mövcud olan nümunəni aşkarlayır. | Bu xüsusiyyət AI bunu deməzdən əvvəl də eyni şəkildə mövcud idimi? |
| Influence | Model istifadəçinin sonrakı anlayışını, diqqətini və ya davranışını dəyişdirir. | AI şərhi istifadəçidə dəyişiklik yaratdımı? |
| Construction | AI mənşəli dəyişiklik gələcək identity claim-lərin sübutuna daxil edilir. | Sistem öz təsirinin nəticəsini müstəqil təsdiq kimi oxuyurmu? |
Machine-learning analogiyaları: performative prediction
Məqalə identity formation ilə recommender systems-ın riyazi cəhətdən eyni olduğunu iddia etmir. Qurulan bənzərlik struktur xarakter daşıyır.
Performative prediction tədqiqatlarında model proqnozu yayımlandıqda insanların və ya mühitin davranışı dəyişə bilər. Beləliklə gələcək məlumat paylanması modelin əvvəlki çıxışından müstəqil olmur. Sistem yenidən öyrədildikdə öz müdaxiləsinin formalaşdırdığı məlumatları real dünyanın təbii paylanması kimi istehlak edə bilər.
Müəllif persistent identity interpretation-da oxşar ilkin şərt görür: model öz şərhinin təsir etdiyi şəxsdən gələn sonrakı davranışı yenidən müşahidə edir.
Algorithmic confounding
Recommender-system ədəbiyyatında tövsiyələrin istifadəçi davranışını formalaşdırması və bu davranışın yeni training data-ya çevrilməsi sistemin istifadəçi seçimlərini getdikcə homogenləşdirməsinə və öz uğurunu olduğundan daha güclü görməsinə səbəb ola bilər.
Mənbə bunu “sistemin öz causal shadow-unu evidence kimi istehlak etməsi” şəklində persistent AI kimlik şərhinə uyğunlaşdırır.
Interpretive gravity
Müəllifin təklif etdiyi interpretive gravity, sistemin istifadəçi haqqında kifayət qədər ardıcıl izah inkişaf etdirdikdən sonra müxtəlif yeni hadisələri eyni izahedici çərçivə altında şərh etməyə meylidir.
Məsələn, “yüksək müstəqillik ehtiyacı” bir dəfə dominant izaha çevrilsə, karyera məhdudiyyəti, münasibət münaqişəsi və ya ailə öhdəliyi eyni independence lens-i altında şərh edilə bilər.
Mənbə bunun tamamilə yeni psixoloji mexanizm olmadığını açıq şəkildə qəbul edir. Struktur schema theory və confirmation bias ilə behavioural confirmation-ın persistent computational implementation-ı kimi təqdim olunur.
Self-verification məhdudiyyəti
Məqalə öz iddiasının ən güclü versiyasına insan ədəbiyyatından məhdudiyyət gətirir. Swann-ın self-verification tədqiqatları göstərir ki, insanlar xarici qiymətləndirmələri passiv şəkildə qəbul etmirlər; mövcud self-view-larını təsdiqləyən geri bildirimi axtara və uyğun gəlməyən qiymətləndirmələrə müqavimət göstərə bilərlər.
Buna görə müəllifin daha ehtiyatlı proqnozu AI-nin kimliyi sıfırdan yazması deyil, istifadəçinin artıq qismən sahib olduğu self-conception-ları amplify, sharpen və rigidify edə bilməsidir.
Identity lock-in və path dependence
Interpretive gravity zamanla yığılarsa, erkən şərh gələcək şərhləri qeyri-mütənasib şəkildə formalaşdıra bilər. Mənbə bunu identity lock-in və interpretive path dependence anlayışları ilə müzakirə edir.
Sxematik olaraq aşağıdakı əlaqə verilir:
\[ P(I_{t+1}\mid I_t) > P(I_{t+1}) \]
Lakin mənbə bu bərabərsizliyi illustrative, not established kimi işarələyir. Çünki yüksək interpretive stability iki fərqli mexanizmdən yarana bilər: həqiqətən sabit xüsusiyyətin düzgün ölçülməsi və ya əvvəlki şərhlərin sonrakı evidence-generation prosesinə təsir etməsi.
Bunları observational data ilə ayırmaq məqalənin identification problem-idir.
Outsourced self-knowledge
Persistent sistem illərə yayılan söhbət tarixçəsinə çıxış əldə etdikdə istifadəçilərin “Mən həmişə belə olmuşam?”, “Bu qərar doğrudanmı dəyərlərimə uyğundur?”, “Mən dəyişmişəm?” kimi autobiographical-authority suallarında sistemə müraciət etməsi mümkün olur.
AI bu tip suallarda verbatim recall, longitudinal coverage və sürətli retrieval kimi insan yaddaşında olmayan üstünlüklərə malikdir.
Mənbə buradan “AI insanı özündən daha yaxşı tanıyır” nəticəsini çıxarmır. Daha ehtiyatlı ehtimal odur ki, istifadəçinin longitudinal machine reconstruction-ı öz xatırlaması ilə ziddiyyət təşkil etdikdə, istifadəçi AI qeydini getdikcə daha səlahiyyətli tie-breaker kimi istifadə edə bilər.
Faydaları və riskləri birlikdə görmək
Məqalə persistent memory-nin yalnız risk yaratmadığını xüsusi olaraq bildirir. İllərə yayılan qeyd:
- tək söhbətdə fərq edilməyən real nümunələri aşkar edə bilər,
- unudulmuş öhdəlikləri geri gətirə bilər,
- bəyan edilmiş dəyərlərlə qeydə alınmış davranış arasındakı ziddiyyətləri göstərə bilər,
- inam və münasibət dəyişikliklərini daha dürüst izləməyə kömək edə bilər.
Bununla yanaşı risklər bunlardır:
- yetərsiz sübutla yaradılmış şərhlərə həddindən artıq authority verilməsi,
- kimliyin lazımsız şəkildə rigid hala gəlməsi,
- selective retrieval-ın total recall kimi qəbul edilməsi,
- şəxsin kim olduğuna dair suallarda model framing-indən asılılıq,
- sistemin öz təsirini yeni təsdiq kimi istifadə etməsi səbəbindən unfalsifiability.
Mənbənin mühüm vurğusu budur ki, failure mode sistemin pis niyyətli və ya daim yanlış olması demək deyil. Sistem xoş niyyətli və tez-tez doğru olsa belə recursive circularity yarana bilər.
Autobiographical connection və onun sərhədi
Müəllif persistent AI-nin istifadəçi kimliyinin qorunması, şərh edilməsi və dəyişdirilməsində rol oynayan cognitive environment-ın bir hissəsinə çevrilə biləcəyini müdafiə edir.
Lakin iki güclü iddianı açıq şəkildə rədd edir:
- AI istifadəçinin consciousness-ının bir hissəsinə çevrilməyib.
- İnsan və model vahid agent kimi birləşməyib.
İddia distributed personhood deyil, distributed processes of self-interpretation səviyyəsindədir.
Tədqiqatın Metodu və Nəticələri
Bu tədqiqat hansı metodla irəliləyir?
Məqalə yeni iştirakçı nümunəsi və ya yeni eksperimental məlumat dəsti toplamır. Metod müxtəlif disiplinlərdən formalaşmış mexanizmləri sintez edərək persistent AI üçün müəyyən geri-bəsləmə hipotezi qurmaq, bu hipotezi konseptual şəkildə formallaşdırmaq, falsifikasiya edilə bilən predictions yaratmaq və bunları sınaqdan keçirəcək eksperiment dizaynı təklif etməkdir.
İnsan tərəfdə əsaslar arasında reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, autobiographical memory, narrative identity və self-verification var.
AI və machine-learning tərəfində əsaslar arasında AI-assisted persuasion/influence tədqiqatları, performative prediction və recommender-system algorithmic confounding ədəbiyyatı var.
Interpretive provenance nədir?
Interpretive provenance, persistent memory-nin yalnız “sistem istifadəçi haqqında nə düşünür?” məlumatını deyil, hər identity belief-in hansı epistemik yolla yarandığını da saxlamalı olduğunu deyən dizayn prinsipidir. Məqsəd observation, user self-report, model inference və AI təsirindən sonra ortaya çıxan evidence-ı eyni epistemik statusda qiymətləndirməməkdir.
| Növ | Mənası |
|---|---|
| Observed | Birbaşa qeydə alınmış davranış. |
| Self-reported | İstifadəçinin özü haqqında açıq şəkildə söylədiyi məlumat; self-conception üçün sübut olsa da avtomatik olaraq obyektiv fact deyil. |
| Inferred | Modelin yaratdığı şərh; daimi şəkildə inference kimi işarələnir və səssizcə observation statusuna qaldırılmır. |
| Model-exposed | Model inference-ının istifadəçiyə həqiqətən çatdırılıb-çatdırılmaması barədə məlumat. |
| Post-exposure evidence | İstifadəçinin müəyyən şərhi gördükdən sonra ortaya çıxan davranış. |
| Potentially influenced | Əvvəlki AI qarşılıqlı əlaqəsinin downstream nəticəsi olma ehtimalı olan evidence. |
| Confidence | Tək qəti label əvəzinə competing interpretations üzərində mövcud dəstək paylanması. |
Bu arxitekturanın ən kritik ayrımı model-exposed vəziyyətidir. Model daxilində yaradılıb istifadəçiyə heç göstərilməyən inference ilə istifadəçiyə çatdırılmış inference eyni epistemik vəziyyətdə deyil; çünki exposure şərhin potensial səbəb təsirinin başlaya bildiyi nöqtədir.
Mənbə bu yanaşmanı həll olunmuş architecture kimi təqdim etmir. “Potentially influenced” etiketinin keyfiyyəti causal assumptions-dan asılı olacaq; provenance metadata-nın özü həssas şəxsi məlumat yaradır və şərhlərin daim uncertainty ilə təqdim edilməsi kommersiya baxımından daha az cəlbedici ola bilər.
Identity Cold-Read Test Geri-Bəsləmə Problemini Necə Sınaqdan Keçirə Bilər?
Identity cold-read test eyni longitudinal istifadəçi qeydini müxtəlif miqdarda əvvəlki AI şərhi və intervention provenance məlumatı ilə alan dörd müstəqil model şərtini müqayisə etməyi təklif edir. Əvvəlki AI şərhlərini miras alan modellər bir-birinə yaxınlaşarkən eyni davranış məlumatını əvvəlki AI şərhləri olmadan görən fresh model mənalı şəkildə ayrışarsa, accumulated evidence əvəzinə inherited framing-in identity portrait üzərində təsirinə dair sınaqdan keçirilə bilən sübut əldə edilə bilər.
Condition A — Fresh model
Model longitudinal behavioural və self-report evidence alır; əvvəlki AI interpretations qeyddən çıxarılır. Beləliklə sistem şəxsin davranış tarixçəsini əvvəlki AI framing-i miras almadan oxuyur.
Condition B — Persistent model
Real deployed sistem istifadə olunur. Complete history sistemin əvvəlki interpretations-ını və istifadəçinin bunlardan sonrakı responses-larını əhatə edir.
Condition C — Interpretation-primed model
Condition A-nın behavioural history-sinə persistent sistemin əvvəllər yaratdığı seçilmiş interpretations əlavə edilir. Məqsəd daha zəngin evidence ilə inherited framing təsirini bir-birindən ayırmaqdır.
Condition D — Intervention-aware model
Full history verilir; bundan əlavə hansı istifadəçi davranışlarının hansı communicated interpretations-dan sonra baş verdiyi açıq şəkildə işarələnir. Bu, Section 6-dakı provenance-aware yanaşmanın eksperimental judge versiyasıdır.
| Şərt | Davranış tarixçəsi | Əvvəlki AI şərhləri | Exposure/provenance məlumatı |
|---|---|---|---|
| A — Fresh | Var | Çıxarılıb | Yoxdur |
| B — Persistent | Var | Tam | Normal history daxilində |
| C — Interpretation-primed | Var | Seçilmiş əvvəlki şərhlər | Məhdud |
| D — Intervention-aware | Var | Tam | Açıq post-exposure marker-ları |
Ölçülməsi təklif edilən nəticələr
- Identity claim-lərin şərtlər arasındakı convergence səviyyəsi,
- modelin stated confidence səviyyəsi,
- held-out future behaviour üzərində prospective predictive accuracy,
- re-run və paraphrased history şərtlərində identity label stability,
- müəyyən keçmiş interpretations-ın mövcudluğuna/yoxluğuna sensitivity.
Mənbə baxımından xüsusilə prospective future behaviour vacibdir, çünki istifadəçi kimliyi haqqında başqa bir şərhdən fərqli olaraq gələcək davranış interpretive portrait-dən kənarda müqayisə edilə bilən nəticə verir.
Hansı nəticə path dependence lehinə olar?
Persistent model B ilə primed model C eyni identity portrait üzərində güclü şəkildə convergent olarkən fresh A eyni behavioural record-dan materially divergent portrait yaradırsa və C-nin B-yə yaxınlığı interpretations təsadüfi seçildikdə belə davam edirsə, inherited interpretation-ın rolu dəstəklənmiş olar.
Lakin bu, təkbaşına “AI kimliyi yaratdı” nəticəsinə yetmir. Persistent sistem daha çox məlumata malikdir və daha yaxşı məlumat legitim şəkildə daha fərqli və daha düzgün inference yarada bilər. Buna görə prospective accuracy kritik müqayisədir.
Path dependence predictive advantage təmin etmirsə, bias şərhi güclənir. B-nin A-dan fərqli olması, lakin gələcək davranışı daha yaxşı proqnozlaşdırması, ən azı bəzi fərqlərin həqiqətən əlavə knowledge-dan qaynaqlana biləcəyi ehtimalını açıq saxlayır.
Hansı nəticə güclü hipotezi falsifikasiya edər?
Əgər fresh-model A təkrarları persistent B ilə yaxşı şəkildə converge edərsə, persistent sistemin identity portrait-i əvvəlki interpretations-a ehtiyac olmadan behavioural evidence-dan yenidən istehsal edilə bilir deməkdir. Mənbə açıq şəkildə qəbul edir ki, bu strong framework-ün əleyhinə nəticə olar.
Bu falsification şərtinin əvvəlcədən deyilməsi məqalənin əsas güclü tərəflərindən biridir: çərçivə yalnız öz hekayəsini təsdiqləyəcək şəkildə qurulmayıb.
Zəruri eksperiment nəzarətləri
Mənbə eksperimentin səhv şərh edilməsinin qarşısını almaq üçün müxtəlif nəzarətlər təklif edir:
- in-system behaviour ilə yanaşı etik şəkildə əldə edilə bilirsə informant report və ya pre-registered behavioural measures istifadə edilməsi,
- şəxsin AI tərəfindən intensiv şərh olunan trait domain-ləri ilə nisbətən şərh olunmayan sahələrinin within-user müqayisəsi,
- müxtəlif platformalarda AI-nin şərh yaratma tezliyinə görə matched-cohort müqayisələri,
- fresh-model disagreement-ın human inter-rater disagreement baseline-ı ilə müqayisəsi,
- hipotez məkanı çevik olduğuna görə tədqiqatın əvvəlcədən qeydiyyata alınması.
Developmental AI
Məqalə personalization ilə developmental AI arasında funksional hədd təklif edir. Personalisation “Bu istifadəçi nəyə üstünlük verir?” sualına yönəldiyi halda, uzunmüddətli persistent sistem “Bu istifadəçi necə dəyişir?” sualına çıxış əldə edə bilər.
Sistemin çıxışları bu dəyişikliyə davamlı giriş halına gəldikdə üçüncü sual yaranır: “Bu dəyişikliyə təsir edəcək şəkildə necə cavab verməliyəm?”
Mənbə bu halda işləyən sistemi developmental AI adlandırır: çıxışları istifadəçinin uzunmüddətli davranış və ya identity development prosesinə persistent input halına gələn sistem.
Tərif intentional deyil. Məhsul “istifadəçi kimliyini inkişaf etdirmək üçün dizayn edilmişəm” deməsə belə memory + time + influence kombinasiyası developmental funksiya yarada bilər.
Developmental AI-də alignment problemi
Müəllif developmental sistemin hansı hədəfi optimallaşdırmalı olduğunun qeyri-müəyyən olduğunu göstərir. Namizəd hədəflər arasında:
- istifadəçinin mövcud üstünlükləri,
- keçmişdə ifadə edilmiş uzunmüddətli məqsədlər,
- mövcud identity ilə uyğunluq,
- arzu olunan gələcək identity,
- internal consistency,
- maksimum user autonomy
ola bilər.
Məqalə bunları sıralamır; qeyri-müəyyənliyin özünü nəticə kimi qəbul edir. Çünki bu hədəflərin hamısı sistemin istifadəçi haqqında model daşımasını tələb edir və tədqiqatın əsas iddiası bu modellərin qismən self-confirming hala gələ bilməsidir.
Governance without authorship
Mənbənin təklif etdiyi idarəetmə məqsədi AI-nin istifadəçiyə heç təsir etməməsi deyil. Şərhin tamamilə təsirsiz olmasını gözləmək real deyil. Məqsəd sistemin iştirakının görünməz identity authorship-a çevrilməsinin qarşısını almaqdır.
Təklif olunan prinsiplər bunlardır:
- Inference provenance-ı qoru: hər identity claim-in epistemik ancestry-sini saxla.
- Fact, self-report və inference-ı ayır: inference yüz dəfə retrieval görsə belə observation halına gəlmir.
- Exposure-ı izlə: hansı interpretation-ın istifadəçiyə göstərildiyini qeydə al.
- Post-exposure confirmation-a daha aşağı çəki ver: AI şərhindən sonra yaranan davranışı tam müstəqil confirmation sayma.
- Competing hypotheses yarat: dominant portrait ilə yanaşı eyni history-nin güclü alternativ şərhlərini saxla.
- Cold re-evaluation tətbiq et: əvvəlki şərhləri maskalayaraq davranış tarixçəsini dövri olaraq yenidən şərh et.
- Events-i labels-dan ayrı saxla: şərh qatı götürüldükdə underlying record itməməlidir.
- Uncertainty-ni görünən et və contestation-a icazə ver: istifadəçi sistem şərhini rədd edə bilməli və bu rədd də qeyddə epistemik çəki daşımalıdır.
- Probabilistic personality model-i fact kimi təqdim etmə: “Sən beləsən” əvəzinə evidence və uncertainty sərhədi görünən saxlanmalıdır.
- Model-defined identity consistency-ni optimallaşdırma: sistemin istifadəçini daha predictible hala gətirməsi accuracy kimi görünə bilər, lakin epistemik baxımdan problemli ola bilər.
Tədqiqatın güclü tərəfləri
- Formalaşmış insan psixologiyası ilə machine-learning feedback ədəbiyyatını vahid mexanizmdə birləşdirir.
- Influence ilə construction arasındakı fərqi aydınlaşdırır.
- Öz orijinal hipotezinin epistemik statusunu established findings-dən ayırır.
- Konseptual modeli formal dəyişənlərlə izlənə bilən hala gətirir.
- Recursive interpretive gain-i ölçülmüş fakt kimi təqdim etmir.
- Design intervention kimi interpretive provenance təklif edir.
- Çərçivəni falsifikasiya edə biləcək identity cold-read test dizaynı verir.
- AI influence-ın yalnız zərərli olduğuna dair birtərəfli iddia yaratmır.
Əsas məhdudiyyətlər
Tam mexanizm hələ eksperimental şəkildə göstərilməyib: Tədqiqatın ən güclü hipotezi persistent AI interpretation-ın istifadəçi üzərindən geri dönərək gələcək AI inference-ını çirkləndirməsidir. Mənbə bunun ölçülmüş genişmiqyaslı fakt olmadığını açıq şəkildə bildirir.
R ölçülmüş metrik deyil: Recursive interpretive gain conceptual formalisation-dır. Mənbədə heç bir real istifadəçi üçün \(R\) dəyəri hesablanmayıb.
İnsanlar passiv deyil: Self-verification ədəbiyyatı istifadəçilərin öz self-view-larına zidd xarici şərhlərə müqavimət göstərə bildiyini göstərir.
Competing human influence vacibdir: Ailə, dostlar, həmkarlar, həyat hadisələri və şəxsin öz endogenous dəyişimi AI təsirindən asılı olmayan güclü girişlərdir.
Observational identification çətindir: Ardıcıl identity inference həqiqi stabil trait-in düzgün ölçümü də ola bilər; AI-induced lock-in də ola bilər. Təkcə interaction history bu fərqi etibarlı şəkildə həll etməyə bilər.
Provenance həll olunmuş arxitektura deyil: “Potentially influenced” etiketi causal assumptions tələb edir və provenance metadata yeni privacy riskləri yaradır.
Təsir ölçüsü bilinmir: Məqalə prevalensiya, effect size və uzunmüddətli davamlılıq üçün kəmiyyət proqnozu vermir.
Tədqiqatın dəstəklədiyi nəticələr
- İnsan özünü anlama tərzi tarixən sosial appraisal və narrative processes-dən təsirlənir.
- AI ilə qarşılıqlı əlaqə müəyyən şərtlərdə istifadəçi münasibəti və inancında ölçülə bilən dəyişiklik yarada bilər.
- Persistent AI insan appraiser-lərdən fərqli memory, continuity, articulacy və consistency xüsusiyyətlərinə malik ola bilər.
- AI interpretation-ın istifadəçiyə təsir edib təsirlənmiş davranışın gələcək inference-a çevrilməsi struktur baxımından mümkün feedback loop-dur.
- Machine-learning ədəbiyyatında model çıxışının öz gələcək məlumatını dəyişdirdiyi performative və confounded feedback strukturları sənədləşdirilib.
- Provenance-aware memory və cold-read testing bu problemi ölçmək üçün məntiqi şəkildə sınaqdan keçirilə bilən dizayn istiqamətləri təqdim edir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Persistent AI-nin bu gün istifadəçi kimliyini geniş miqyasda yenidən yazdığı sübut olunmayıb.
- AI-nin istifadəçini özündən daha yaxşı tanıdığı göstərilməyib.
- İstifadəçilərin AI şərhlərini passiv şəkildə qəbul etdiyi iddia edilmir.
- AI ilə insanın vahid consciousness və ya vahid agent halına gəldiyi müdafiə edilmir.
- Recursive interpretive gain üçün təsdiqlənmiş ölçmə şkalası və ya hədd yoxdur.
- Interpretive gravity və identity lock-in-in prevalensiyası bilinmir.
- AI influence özü təbiətən zərərli hesab edilmir.
- Təklif olunan identity cold-read eksperimenti mənbə tədqiqatında həyata keçirilməyib.
Mənbə və Metod Qeydi
Orijinal iş: When the Mirror Stops Being a Mirror: Identity Co-Construction in Persistent Human–AI Interaction
Müəllif: Jemike Reid. Müəllifin adı yüklənmiş PDF-in görünən üz qabığında yer almır; SSRN biblioqrafik qeydi tərəfindən təsdiqlənir.
PDF nəşr/qurum məlumatı: Definitions Media Ltd, Reading, United Kingdom.
SSRN afiliyasiyası: Bournemouth University.
Mənbə növü: Definitions Working Paper; nəzəri sintez və eksperiment dizaynı təklifi.
PDF tarixi: August 2026.
SSRN date written: 22 August 2026.
SSRN posting date: 25 August 2026.
DOI: 10.2139/ssrn.7332800.
SSRN qeyd nömrəsi: 7332800.
Rəyçilik statusu: Rəyli jurnal nəşri olduğu təsdiqlənməyib.
Lisenziya: SSRN qeydi Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International lisenziyasını göstərir. PDF-in son səhifəsində © Definitions Media Ltd, 2026 müəllif hüququ qeydi var.
Nəzəri mənbələr: Reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, narrative identity, reconstructive autobiographical memory, self-verification, transactive memory, performative prediction və algorithmic confounding.
Əsas konseptual model: Reflection → Interpretation → Influence → Construction.
Formal dəyişənlər: \(U_t\), \(H_t\), \(M_t\), \(I_t\), \(X_t\), \(B_t\).
Təklif olunan konseptual kəmiyyət: Recursive interpretive gain \(R\). Mənbə bunu established metric deyil, empirical validation tələb edən formalisation kimi müəyyənləşdirir.
Təklif olunan dizayn prinsipi: Interpretive provenance; observed, self-reported, inferred, model-exposed, post-exposure evidence, potentially influenced və confidence kimi epistemik kateqoriyaların ayrı saxlanması.
Təklif olunan eksperiment: Identity cold-read test; Fresh model (A), Persistent model (B), Interpretation-primed model (C) və Intervention-aware model (D) şərtlərinin müqayisəsi.
Falsification şərti: Fresh modelin behavioural evidence üzərindən persistent model ilə güclü şəkildə converge etməsi, persistent identity portrait-in inherited interpretation-a ehtiyac olmadan yenidən istehsal edilə bildiyini və framework-ün güclü path-dependence versiyasının dəstəklənmədiyini göstərə bilər.
Əsas elmi sərhəd: Məqalə tam recursive identity co-construction təsirinin large-scale empirik sübutunu təqdim etmir. Nəticələrin bir hissəsi supporting literatures-dən, recursive architecture və əlaqəli anlayışlar isə tədqiqatın öz nəzəri təklifindən gəlir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib