

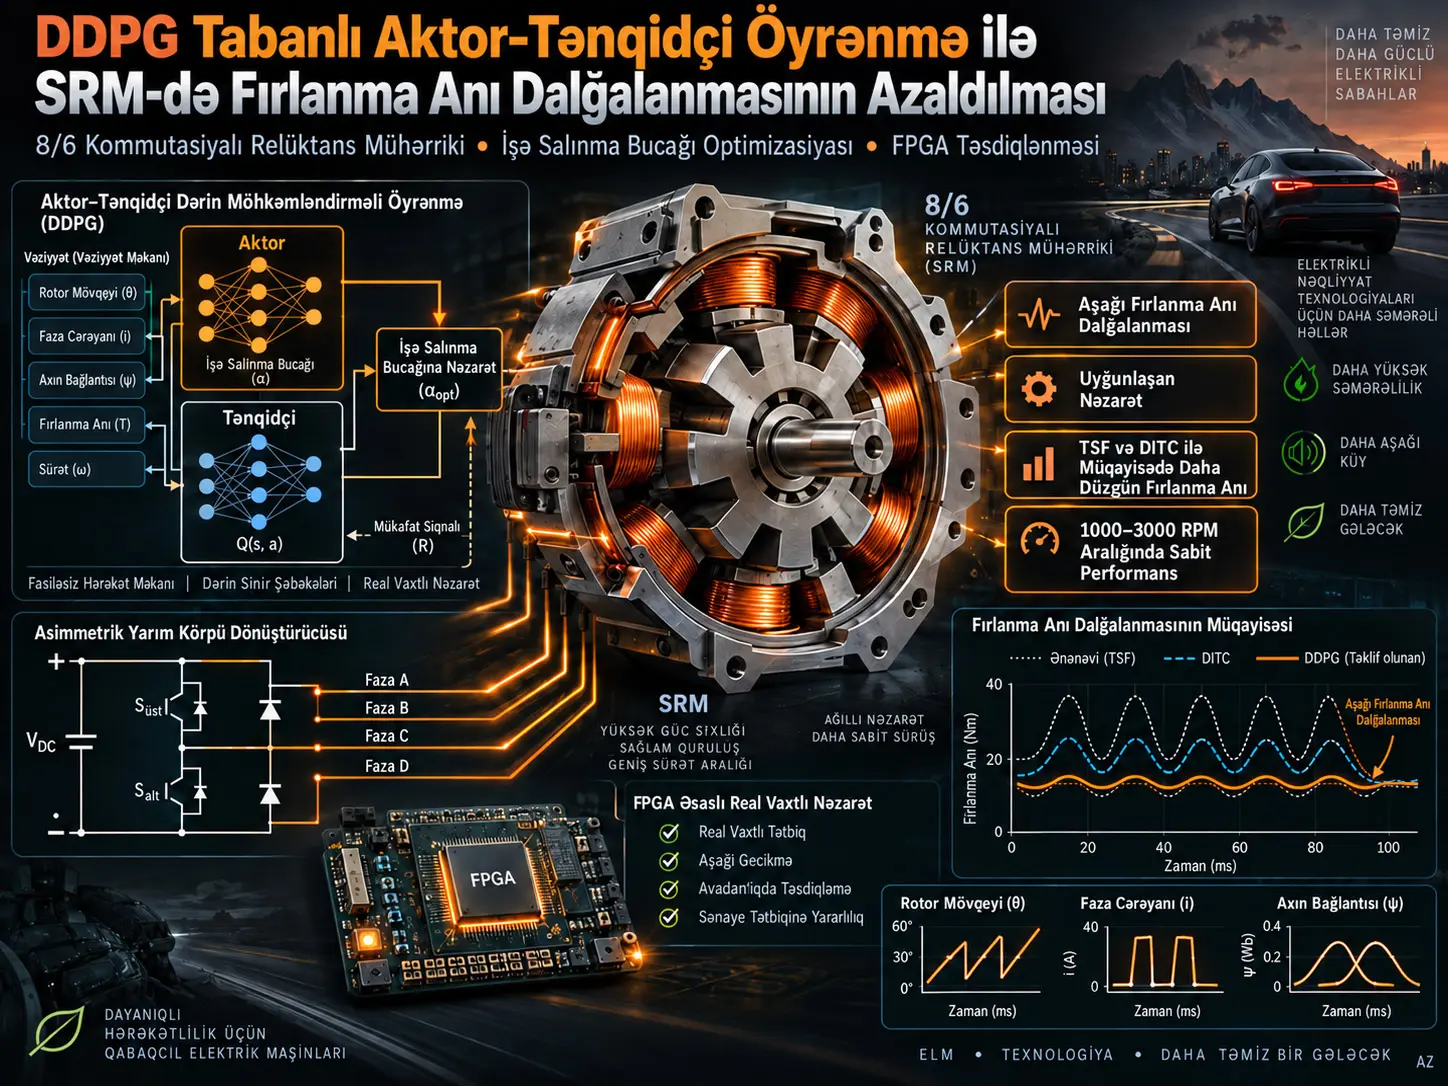
DDPG əsaslı aktor–tənqidçi SRM nəzarətçisi, Anahtarlamalı Relüktans Mühərrikinin (Switched Reluctance Motor, SRM) cərəyan, elektromaqnit fırlanma anı, maqnit axını ilişməsi, rotor sürəti və rotor mövqeyi kimi iş vəziyyətlərini müşahidə edərək dörd fazanın işə salınma bucağı ofsetlərini fasiləsiz qiymətli hərəkətlər kimi öyrənən möhkəmləndirməli öyrənmə idarəetmə sistemidir. Tədqiqat 8/6 qütblü dörd fazalı SRM-ni Asymmetrical Half-Bridge (ASHB) çeviricisi vasitəsilə idarə edir; Deep Deterministic Policy Gradient (DDPG) aktor–tənqidçi arxitekturasını MATLAB Simulink R2024b mühitində öyrədir və öyrənilmiş siyasəti FPGA əsaslı Wavect rəqəmsal nəzarətçisində real vaxt rejimində tətbiq edir. Simulyasiyada 20 Nm yük və 1000–3000 RPM diapazonunda bildirilən pikdən-pikə fırlanma anı dalğalanması %1,29 ilə %2,08 arasındadır. Bununla belə, eksperimental aparat doğrulaması ani fırlanma anı dalğalanmasını birbaşa ölçməmiş; əsasən orta mexaniki fırlanma anı və sürətin simulyasiya nəticələrinə yaxınlığını göstərmişdir.
SRM-lər daimi maqnit tələb etməyən, sadə rotor quruluşuna malik, möhkəm, nasazlığa davamlı və geniş sürət diapazonunda işləyə bilən elektrik maşınlarıdır. Bununla yanaşı, ikiqat çıxıntılı stator–rotor həndəsəsi, rotor mövqeyindən asılı qeyri-xətti induktivlik və diskret faza kommutasiyası fırlanma anı istehsalını dalğalı edir. Bu dalğalanmalar vibrasiyaya, akustik səs-küyə, mexaniki aşınmaya və sürüş rahatlığının pisləşməsinə səbəb ola bilər.
Mənbə tədqiqatın təklif etdiyi həll sabit cərəyan profili və ya əvvəlcədən müəyyən edilmiş kommutasiya cədvəli istifadə etmək əvəzinə işə salınma bucağını iş şəraitinə görə öyrənən DDPG agentidir. Aktor şəbəkəsi uyğun işə salınma ofsetlərini yaradır, tənqidçi şəbəkəsi isə bu hərəkətlərin uzunmüddətli fırlanma anı hamarlığına töhfəsini Q-dəyəri vasitəsilə qiymətləndirir. Təcrübənin təkrar istifadəsi yaddaşı, hədəf şəbəkələr və yumşaq yeniləmələr təlimin sabitliyini dəstəkləyir.
SRM-də Fırlanma Anı Dalğalanması Niyə Yaranır?
Anahtarlamalı Relüktans Mühərrikində fırlanma anı dalğalanmasının əsas səbəbi elektromaqnit fırlanma anının faza cərəyanının kvadratı və rotor bucağına görə dəyişən faza induktivliyinin meyli ilə əlaqəli olmasıdır; faza kommutasiyası zamanı çıxan fazanın cərəyanı azalarkən daxil olan fazanın cərəyanı kifayət qədər tez formalaşmazsa ümumi fırlanma anının davamlılığı pozulur və bu təsir maqnit doyumu, rotor mövqeyindən asılı qeyri-xətti induktivlik və yanlış kommutasiya üst-üstə düşməsi ilə arta bilər.
SRM-nin elektromaqnit fırlanma anı mexanizmi
SRM-də rotor sarğısı və ya daimi maqnit yoxdur. Rotor maqnit dövrəsinin relüktansını azaldan hizalanmış mövqeyə doğru hərəkət etməyə çalışır. Bir faza üçün mənbədə verilən əsas fırlanma anı əlaqəsi:
\[ T_{e,i}(\theta,t)=\frac{1}{2}i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Burada \(i_i(t)\) faza cərəyanıdır; \(L_i(\theta)\) fazanın rotor bucağından asılı induktivliyidir. \(dL_i/d\theta\), rotor fırlanarkən induktivliyin hansı sürətlə dəyişdiyini göstərir.
Tənlik iki kritik əlaqəni ehtiva edir. Birincisi, fırlanma anı faza cərəyanının kvadratı ilə əlaqəlidir; buna görə cərəyandakı dəyişikliyin fırlanma anına təsiri xətti deyil. İkincisi, müsbət fırlanma anı istehsalı əsasən induktivliyin rotor bucağı ilə artdığı \(dL/d\theta>0\) sahəsində baş verir. Nəzarətçinin fazanı rotorun düzgün sahəsində enerjiləndirməsi buna görə vacibdir.
Dörd fazanın ümumi elektromaqnit fırlanma anı mənbədə belə verilir:
\[ T_e(\theta,t)=\sum_{i\in\{A,B,C,D\}}T_{e,i}(\theta,t) =\frac{1}{2}\sum_i i_i^2(t)\frac{dL_i(\theta)}{d\theta} \]
Bu cəm fırlanma anı dalğalanmasını azaltma strategiyasının fiziki əsasını izah edir: hər fazanın fırlanma anı töhfəsi uyğun vaxtlama ilə üst-üstə salına bilsə, ümumi elektromaqnit fırlanma anı daha hamar olar.
Fırlanma anı dalğalanması necə ölçülür?
Mənbənin əsas pikdən-pikə fırlanma anı dalğalanması metrikası:
\[ TR(\%)=\frac{T_{\max}-T_{\min}}{T_{\mathrm{avg}}}\times100 \]
\(T_{\max}\) bir elektrik dövründə ən yüksək fırlanma anını; \(T_{\min}\) ən aşağı fırlanma anını; \(T_{\mathrm{avg}}\) isə orta fırlanma anını göstərir. Nisbət azaldıqca fırlanma anı istehsalı daha hamar hesab olunur.
Tədqiqat fasiləsiz-zaman qiymətləndirməsi üçün əlavə olaraq normallaşdırılmış RMS formasını verir:
\[ TR_{\mathrm{RMS}}= \frac{ \sqrt{\frac{1}{T}\int_0^T [T_e(t)-T_{\mathrm{avg}}]^2dt} } {T_{\mathrm{avg}}} \]
Bu forma yalnız ən yüksək və ən aşağı nöqtələri deyil, bir elektrik dövrü ərzində orta fırlanma anından sapmaların enerjiyə bənzər ümumi böyüklüyünü nəzərə alır.
Elektrik faza dinamikası
SRM fazasının gərginlik tənliyi mənbədə:
\[ V_s(t)=R_i i_i(t)+\frac{d}{dt}[L_i(\theta(t))i_i(t)] \]
şəklindədir. Törəmə açıldıqda:
\[ V_s(t)=R_i i_i(t)+L_i(\theta)\frac{di_i(t)}{dt} +i_i(t)\dot{\theta}\frac{dL_i(\theta)}{d\theta} \]
alınır. Son termin elektrik və mexaniki hərəkət arasındakı əlaqəni göstərir. Rotor sürəti dəyişdikdə, eyni gərginlik və kommutasiya strategiyası eyni cərəyan davranışını yaratmaq məcburiyyətində deyil. Sabit işə salınma bucaqlarına əsaslanan üsulların geniş sürət diapazonunda çətinlik yaşamasının fiziki səbəblərindən biri budur.
Eksperimental induktivlik xəritəsi
Tədqiqatda faza induktivliyi yalnız nəzəri əyri kimi qəbul edilməmişdir. Səhifə 10–11-də göstərilən eksperimental qurğuda dəqiq LCR ölçən cihaz istifadə edilmiş; rotor əl ilə 10 dərəcə addımlarla fırladılmış və hər mövqedə faza induktivliyi qeydə alınmışdır. Rotor mövqeyi istinadı valın ötürülməyən ucuna qoşulan və 5 V DC ilə qidalanan incremental encoder vasitəsilə izlənmişdir.
Mənbə hizalanmış induktivliyi 55 mH, hizalanmamış induktivliyi 12 mH kimi bildirir. Ölçülmüş induktivlik profilləri agentin yüksək müsbət \(dL/d\theta\) sahələrini müəyyən etməsinə kömək edən fiziki istinad kimi idarəetmə mühitinə daxil edilmişdir.
Niyə Asymmetrical Half-Bridge çeviricisi?
Dörd fazalı ASHB çeviricisi hər faza üçün iki idarə olunan açar və iki diod istifadə edir. Tədqiqatda üç əsas elektrik vəziyyəti müəyyən edilir:
| Vəziyyət | Faza gərginliyi | Əsas funksiya |
|---|---|---|
| Maqnitləşmə | +\(V_{DC}\) | Hər iki idarə olunan açar açıqdır; faza cərəyanı sürətlə yüksəlir. |
| Sərbəst dövriyyə | 0 V | Açarlardan biri açıq, digəri bağlıdır; faza cərəyanı dövr etməyə davam edir. |
| Demaqnitləşmə | −\(V_{DC}\) | Hər iki açar bağlıdır; sarğıdakı maqnit enerjisi DC şinaya geri qaytarılır və faza cərəyanı azaldılır. |
ASHB-nin müstəqil faza idarəetməsi və cərəyanı sürətlə artırıb-azaltma qabiliyyəti DDPG agentinin işə salınma vaxtını faza üzrə tənzimləyə bilməsi baxımından mərkəzi əhəmiyyət daşıyır.
DDPG Fırlanma Anı Dalğalanmasını Necə Azaldır?
DDPG nəzarətçisi mühərrikin ölçülmüş vəziyyətini dörd faza üçün fasiləsiz qiymətli işə salınma bucağı ofsetlərinə çevirir; aktor şəbəkəsi idarəetmə hərəkətini yaradır, tənqidçi şəbəkəsi isə bu hərəkətin gələcək ümumi mükafatını qiymətləndirir və təlim boyu daha aşağı fırlanma anı dalğalanması yaradan kommutasiya vaxtlamaları möhkəmləndirilir.
İdarəetmə problemi Markov Qərar Prosesi kimi müəyyən edilir
Mənbə möhkəmləndirməli öyrənmə mühitini:
\[ M=(S,A,P,R,\gamma) \]
şəklində Markov Qərar Prosesi kimi müəyyən edir.
- Vəziyyət məkanı \(S\): faza cərəyanları, elektromaqnit fırlanma anı, maqnit axını ilişməsi, rotor sürəti, rotor mövqeyi və əvvəlki idarəetmə hərəkətləri.
- Hərəkət məkanı \(A\): dörd fazaya aid fasiləsiz işə salınma bucağı ofsetləri.
- Keçid \(P\): bir hərəkət tətbiq edildikdən sonra mühərrikin yeni vəziyyətə keçməsi.
- Mükafat \(R\): aşağı fırlanma anı dalğalanmasını və hamar iş şəraitini təşviq edən performans siqnalı.
- Diskont amili \(\gamma\): gələcək mükafatların cari optimallaşdırmadakı çəkisi.
Siyasətin məqsədi gözlənilən diskontlaşdırılmış ümumi mükafatı artırmaqdır:
\[ J(\pi)=E_{\pi}\left[\sum_{k=0}^{\infty}\gamma^k r(s_k,a_k)\right] \]
Aktor şəbəkəsi
Aktorun deterministik siyasəti:
\[ a=\mu(s|\theta^\mu) \]
şəklindədir. Mənbədə aktor şəbəkəsi 13 ölçülü mühərrik vəziyyət vektorunu qəbul edir; 256, 128 və 64 neyronlu üç fully-connected gizli qat istifadə edir və dörd çıxış neyronu ilə dörd fazanın işə salınma bucağı ofsetlərini yaradır. Gizli qatlarda ReLU, çıxışda tanh aktivləşdirməsi istifadə olunur.
Tanh çıxışı fiziki bucaq sərhədinə çevrilərək hərəkətin mühərrikin tətbiq oluna bilən kommutasiya sahəsində qalması təmin edilir.
Tənqidçi şəbəkəsi
Tənqidçi şəbəkəsi həm mühərrik vəziyyətini, həm də aktorun hərəkətini qəbul edir və:
\[ Q(s,a|\theta^Q) \]
ilə göstərilən uzunmüddətli hərəkət dəyərini təxmin edir. Mənbədə tənqidçinin 13 ölçülü vəziyyətlə dörd ölçülü hərəkəti ümumilikdə 17 ölçülü girişdə birləşdirdiyi; 256 və 128 neyronlu qatlardan sonra tək skalyar Q-dəyəri yaratdığı açıqlanır.
Tənqidçi üçün hədəf:
\[ y_k=r_k+\gamma Q'\left(s_{k+1}, \mu'(s_{k+1}|\theta^{\mu'})|\theta^{Q'}\right) \]
kimi qurulmuşdur. Proqnozlaşdırılan Q-dəyəri ilə bu hədəf arasındakı fərqin kvadratı azaldılaraq critic öyrədilir.
Aktor–tənqidçi qarşılıqlı əlaqəsi
Aktor düzgün hərəkəti birbaşa “bilmir”. Tənqidçinin Q-dəyərinin hərəkətə görə qradiyentindən istifadə edir:
\[ \nabla_{\theta^\mu}J \approx \frac{1}{N}\sum_{k=1}^{N} \nabla_aQ(s,a|\theta^Q)|_{a=\mu(s)} \nabla_{\theta^\mu}\mu(s|\theta^\mu) \]
Bu qradiyent aktoru tənqidçinin daha yüksək uzunmüddətli mükafatla əlaqələndirdiyi işə salınma bucaqlarına yönəldir.
Təcrübə təkrar yaddaşı və hədəf şəbəkələr
Hər qarşılıqlı əlaqə:
\[ (s_k,a_k,r_k,s_{k+1}) \]
dördlük kimi replay buffer-ə yazılır. Təlim zamanı keçmiş təcrübələrdən təsadüfi mini-batch nümunələrinin seçilməsi zaman ardıcıllığından yaranan korrelyasiyanı azaldır.
Aktor və tənqidçinin həmçinin yavaş yenilənən hədəf nüsxələri vardır. Tədqiqatda soft-update amili \(\tau=0.005\) kimi istifadə edilmişdir. Məqsəd öyrənən şəbəkələrdəki sürətli dəyişikliyin hədəf dəyərlərini eyni anda həddindən artıq dəyişməsinin qarşısını almaqdır.
Kəşfiyyat səs-küyü
Təlimin əvvəlində hərəkətə Ornstein–Uhlenbeck səs-küyü əlavə olunur:
\[ a_t=\mu(s_t|\theta^\mu)+N_t \]
Mənbədə səs-küy parametrləri \(\mu=0\) və \(\sigma=0.25\) kimi verilmişdir. Bu yanaşma fasiləsiz hərəkət məkanında müxtəlif işə salınma vaxtlarının araşdırılmasını təmin edir.
Əsas təlim hiperparametrləri
| Parametr | Dəyər |
|---|---|
| Aktor öyrənmə sürəti | 1 × 10⁻⁴ |
| Tənqidçi öyrənmə sürəti | 2 × 10⁻⁴ |
| Diskont amili \(\gamma\) | 0,99 |
| Hədəf şəbəkə yeniləməsi \(\tau\) | 0,005 |
| Replay buffer | 1 × 10⁶ nümunə |
| Mini-batch | 128 |
| Kəşfiyyat səs-küyü | Ornstein–Uhlenbeck, μ = 0, σ = 0,25 |
| Maksimum təlim | 500 episode |
| Episode uzunluğu | 1 s simulyasiya |
Mənbə bu hiperparametrlərin davranış şərhlərini “heuristic” kimi xarakterizə edir və onların formal sabitlik və ya yaxınlaşma zəmanəti yaratmadığını açıq şəkildə bildirir.
Mükafat ilə fırlanma anı dalğalanması arasındakı əlaqə
Nəticələrin təhlilində verilən sadə mükafat əlaqəsi:
\[ r=100-TR(\%) \]
şəklindədir. Fırlanma anı dalğalanması azaldıqca mükafat artır. Şəkil 24-də təlimin əvvəlindəki yüksək dalğalanma və aşağı mükafatın təxminən 0,15 s sonra daha aşağı dalğalanma və yüksək mükafata doğru keçdiyi göstərilir.
Bununla belə, məqalə digər bölmələrdə mükafat funksiyasının fırlanma anı izləmə xətasını və idarəetmə dəyişkənliklərini də cəzalandırdığını bildirir. Buna görə Equation 30 nəticə qrafikinin şərhində istifadə edilən açıq xətti əlaqə kimi qiymətləndirilməlidir; mənbədə verilən bütün mükafat dizaynı təfərrüatlarının yeganə tənliyi olduğu fərz edilməməlidir.
Tədqiqatın Metodu və Nəticələri
Simulyasiya sistemi
MATLAB Simulink R2024b mühitindəki sistem dörd əsas fiziki/idarəetmə komponentindən ibarətdir:
- 8/6 qütblü dörd fazalı SRM,
- dörd fazalı ASHB güc çeviricisi,
- mühərrik vəziyyətlərini toplayan observation/state bloku,
- işə salınma bucağı ofsetlərini yaradan DDPG aktor–tənqidçi agenti.
Mənbə Cədvəl 3-də simulyasiya üçün 220 V DC link, 20 Nm yük, 1000–3000 RPM sürət diapazonu, 55 mH hizalanmış və 12 mH hizalanmamış induktivlik ilə 1,5 Wb maksimum faza maqnit axını ilişməsi verir.
Öyrənmənin yaxınlaşması
Şəkil 16-da episode reward və critic tərəfindən təxmin edilən Episode Q0 dəyərlərinin təlim boyu yüksəldiyi, təxminən 300–350 episode-dan sonra sabit sahəyə daxil olduğu göstərilir. Təlim ən çox 500 episode olaraq qurulmuşdur.
Mənbə bu davranışı aktor–tənqidçi siyasətinin yaxınlaşması kimi şərh edir. Bununla belə, tədqiqat nəzəri və ya riyazi qlobal yaxınlaşma sübutu təqdim etmir; Cədvəl 2 də istifadə olunan sazlamaların formal sabitlik zəmanəti olmadığını açıq şəkildə bildirir.
Faza cərəyanları və maqnit axını ilişməsi
Şəkil 17 dörd faza cərəyanının ardıcıl və qismən üst-üstə düşən profillərini göstərir. Mənbə təxminən 20–22 A pik cərəyanlarındakı fazalararası bərabərsizliyi rotor mövqeyi və induktivlik fərqlərini kompensasiya edən öyrənilmiş cərəyan modulyasiyası kimi şərh edir.
Şəkil 18-də maqnit axını ilişməsi hər fazada ardıcıl olaraq yüksəlir və azalır, pik səviyyələr təxminən 1,3–1,5 Wb diapazonunda bildirilir. Bu üst-üstə düşən maqnit enerji profili ümumi elektromaqnit fırlanma anının davamlılığına töhfə verir.
1000–3000 RPM arasındakı nəticələr
| İstinad sürəti (RPM) | Sabit sürət (RPM) | Yük (Nm) | Orta fırlanma anı (Nm) | Tmax (Nm) | Tmin (Nm) | Yerləşmə müddəti (s) | Fırlanma anı dalğalanması (%) |
|---|---|---|---|---|---|---|---|
| 1000 | 1012,4 | 20 | 20,53 | 20,74 | 20,31 | 0,3 | 2,08 |
| 1500 | 1513,3 | 20 | 20,79 | 20,96 | 20,65 | 0,3 | 1,48 |
| 2000 | 2008,6 | 20 | 21,06 | 21,21 | 20,94 | 0,3 | 1,29 |
| 2500 | 2506,9 | 20 | 21,32 | 21,51 | 21,22 | 0,3 | 1,38 |
| 3000 | 3038,6 | 20 | 21,61 | 21,89 | 21,51 | 0,3 | 1,75 |
Bu nəticələrdə bildirilən ən aşağı dalğalanma 2000 RPM-də %1,29; ən yüksək dəyər isə 1000 RPM-də %2,08-dir. Araşdırılan bütün simulyasiya nöqtələrində dəyər %3-dən aşağıdır.
DDPG-RL, TSF və DITC müqayisəsi
| Sürət | DDPG-RL | TSF | DITC |
|---|---|---|---|
| 1500 RPM | 1,48% | 16,16% | 24,26% |
| 3000 RPM | 1,75% | 23,01% | 32,16% |
Müqayisə eyni 8/6 mühərrik modeli, dörd fazalı ASHB çeviricisi, 220 V DC link, 20 Nm yük və eyni sürət nöqtələri altında aparılmışdır. TSF üçün sabit cubic torque-sharing lookup table, DITC üçün sabit hysteresis band və kommutasiya bucaqları istifadə edilmişdir. DDPG-RL isə işə salınma bucaqlarını öyrənilmiş siyasət vasitəsilə adaptiv şəkildə dəyişdirir.
Bu nəticə yalnız mənbədə tətbiq olunan TSF və DITC konfiqurasiyaları ilə aparılan müqayisəni dəstəkləyir. “DDPG bütün mümkün klassik idarəetmə üsullarından hər şəraitdə üstündür” kimi daha geniş nəticə bu tədqiqatdan çıxarıla bilməz.
Aparat doğrulaması
Səhifə 35–38-də göstərilən eksperimental qurğuda 8/6 SRM mexaniki olaraq ayrıca həyəcanlandırılan DC generatoruna qoşulmuşdur. Generator tənzimlənə bilən mexaniki yük yaradır. ASHB çeviricisi vasitəsilə idarə olunan mühərrikin nəzarəti Wavect FPGA əsaslı rəqəmsal nəzarətçi tərəfindən həyata keçirilmişdir.
Mənbə eksperimental mühərrik üçün aşağıdakı xüsusiyyətləri bildirir:
| Xüsusiyyət | Dəyər |
|---|---|
| Val gücü | 3,7 kW / 5 HP |
| Qidalanma | 220 V |
| Cərəyan | 5–10 A |
| Konfiqurasiya | 8 stator / 6 rotor qütbü |
| Nominal sürət | 3000 RPM |
| Nominal fırlanma anı | 8–25 Nm |
| Faza müqaviməti | 0,22 Ω/faz |
| Ətalət momenti | 0,0055 kg·m² |
| Encoder | 24 PPR |
| Bildirilən səmərəlilik | 90% |
Fırlanma anı–sürət ölçən cihazın kg·m vahidində verdiyi mexaniki fırlanma anı:
\[ T_{\mathrm{Nm}}=T_{\mathrm{kg\cdot m}}\times 9.81 \]
tənliyi ilə Nm-ə çevrilmişdir.
Eksperimental orta fırlanma anı nəticələri
| Sürət (RPM) | Fırlanma anı (kg·m) | Fırlanma anı (Nm) | Çıxış gücü (kW) |
|---|---|---|---|
| 1002 | 2,09 | 20,51 | 2,16 |
| 1503 | 2,11 | 20,71 | 3,26 |
| 2001 | 2,13 | 20,90 | 4,38 |
| 2504 | 2,15 | 21,09 | 5,55 |
| 3005 | 2,17 | 21,28 | 6,67 |
Eksperimental Doğrulamada Fırlanma Anı Dalğalanması Birbaşa Ölçüldümü?
Xeyr. Mənbə tədqiqatda eksperimental qurğu orta mexaniki fırlanma anı, val sürəti və çıxış gücü ölçmələrini təmin edir; pikdən-pikə fırlanma anı dalğalanması isə zəruri yüksək buraxılış zolaqlı ani fırlanma anı ölçməsi aparılmadığı üçün simulyasiya edilmiş elektromaqnit fırlanma anı dalğa formalarından hesablanmışdır.
Bu fərq tədqiqatın sübut səviyyəsini düzgün şərh etmək üçün kritikdir. Aparat nəticələri öyrədilmiş DDPG siyasətinin FPGA üzərində real vaxtda işlədilə bildiyini və eksperimental orta fırlanma anının simulyasiyadakı orta fırlanma anına yaxın olduğunu göstərir. Lakin Cədvəl 7-dəki %1,29–%2,08 dəyərləri birbaşa eksperimental fırlanma anı sensoru ilə ölçülmüş ripple dəyərləri deyil.
Mənbə daxilində rəqəmsal hesabat fərqləri
Mənbə bəzi parametrləri müxtəlif bölmələrdə fərqli miqyaslarda bildirir və onların səssizcə vahid bir dəyərə endirilməsi uyğun deyil.
- Simulyasiya Cədvəl 3-də 75 kW rated power göstərilir; eksperimental mühərrik Cədvəl 10-da 3,7 kW / 5 HP kimi verilmişdir.
- Cədvəl 3-də simulyasiya edilmiş faza cərəyanı 5–10 A kimi göstərildiyi halda, Şəkil 17-nin şərhində faza cərəyanlarının təxminən 20–22 A pik dəyərlərə çatdığı bildirilir.
- Eksperimental mühərrik üçün 3,7 kW val gücü verildiyi halda Cədvəl 11-də yüksək sürət nöqtələrində 5,55 kW və 6,67 kW çıxış gücü bildirilir.
Bu dəyərlərin necə uzlaşdırılmalı olduğuna dair mənbədə kifayət qədər izah olmadığından Verianla onları yenidən hesablayaraq və ya fərziyyə əlavə edərək düzəltmir. Təkrar istehsal ediləbilənlik və ya dizaynın miqyaslandırılması məqsədilə istifadə olunacaqsa, bu məqamların corresponding author tərəfindən aydınlaşdırılması lazımdır.
Tədqiqatın dəstəklədiyi nəticələr
- DDPG agenti dörd fazanın işə salınma bucağı ofsetlərini fasiləsiz idarəetmə hərəkətləri kimi öyrənə bilir.
- Araşdırılan simulyasiya şəraitində fırlanma anı dalğalanması %1,29–%2,08 arasında bildirilmişdir.
- Eyni tədqiqatdakı TSF və DITC konfiqurasiyalarına görə DDPG-RL daha aşağı fırlanma anı dalğalanması yaratmışdır.
- Öyrənilmiş siyasət FPGA əsaslı nəzarətçiyə köçürülmüş və real mühərrik qurğusunda işlədilmişdir.
- Eksperimental orta mexaniki fırlanma anı dəyərlərinin bildirilən simulyasiya orta fırlanma anı dəyərlərinə yaxın olduğu müəyyən edilmişdir.
- DDPG-nin fasiləsiz hərəkət məkanı işə salınma bucağının faza üzrə incə tənzimlənməsinə uyğundur.
Tədqiqatın dəstəkləmədiyi nəticələr
- Eksperimental sistemdə %1,29–%2,08 fırlanma anı dalğalanmasının birbaşa sensorla ölçüldüyünü demək olmaz.
- 1000–3000 RPM xaricindəki performans bu təcrübələrlə doğrulanmamışdır.
- Aşağı qiymətli bütün quraşdırılmış nəzarətçilərdə online öyrənmənin tətbiq oluna bildiyi göstərilməmişdir.
- DDPG-nin bütün SRM həndəsələrində, güc siniflərində və yük şəraitində eyni performansı verəcəyi nəticəsinə gəlmək olmaz.
- Akustik səs-küyün azaldılması birbaşa ölçülməmişdir; gələcək tədqiqat mövzusu kimi saxlanılmışdır.
- Enerji səmərəliliyi–fırlanma anı ripple çoxməqsədli optimallaşdırması mövcud tədqiqatın bir hissəsi deyil.
- Mənbədə formal qlobal sabitlik və ya DDPG yaxınlaşma sübutu təqdim edilmir.
Məhdudiyyətlər və gələcək tədqiqatlar
Müəlliflər əvvəlcə təlim və doğrulamanın müəyyən 1000–3000 RPM iş sahəsi ilə məhdud olduğunu bildirirlər. Bu sahədən çox kənara çıxmaq yeni təlim və ya əlavə adaptasiya tələb edə bilər.
İkinci məhdudiyyət offline təlim xərcidir. DDPG-nin siyasət öyrənməsi çoxsaylı simulyasiya episode-u tələb edir; lakin təlim başa çatdıqdan sonra real vaxt tətbiqində siyasət sabit nəzarətçi kimi istifadə olunur.
Üçüncü məhdudiyyət hesablama platformasıdır. Tədqiqat FPGA kimi yüksək performanslı rəqəmsal idarəetmə platformalarında tətbiq oluna bildiyini göstərir; aşağı qiymətli aparat üzərində, xüsusən online öyrənmə üçün prosessor və yaddaş məhdudiyyətləri ola bilər.
Gələcək tədqiqat istiqamətləri daha geniş sürət sahəsi, daha qısa təlim müddəti, səmərəlilik–fırlanma anı dalğalanması arasında çoxməqsədli optimallaşdırma, akustik səs-küyün birbaşa yatırılması, batareya ilə qidalanan elektrikli nəqliyyat vasitəsi platforması ilə inteqrasiya və daha səmərəli online adaptasiya üsullarıdır.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Deep Deterministic Policy Gradient-Based Actor–Critic Reinforcement Learning for Torque Ripple Minimization in Switched Reluctance Motors
Müəlliflər: Divya Ramasamy; Sundaram Maruthachalam.
Qurumlar: Department of Electrical and Electronics Engineering, PSG Institute of Technology and Applied Research; Department of Electrical and Electronics Engineering, PSG College of Technology, Tamilnadu, India.
Corresponding author: Divya Ramasamy.
Jurnal: Machines.
Nəşriyyatçı: MDPI.
Cild / nömrə / məqalə: 14(3), 333.
DOI: 10.3390/machines14030333.
Göndərilmə: 9 yanvar 2026.
Reviziya: 25 fevral 2026.
Qəbul: 11 mart 2026.
Nəşr: 16 mart 2026.
Mənbə növü və resenziya: Resenziyadan keçmiş tədqiqat məqaləsi.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Maliyyələşdirmə: Tədqiqatın dövlət, kommersiya və ya qeyri-kommersiya maliyyələşdirmə qurumlarından xüsusi maliyyə dəstəyi almadığı bildirilir.
Maraq toqquşması: Müəlliflər maraq toqquşması bildirmirlər.
Məlumatların əlçatanlığı: Tədqiqatın orijinal töhfələrinin məqalədə olduğu və əlavə sualların corresponding author-a yönləndirilə biləcəyi bildirilir.
Müəllif töhfələri: Konseptuallaşdırma D.R. və S.M.; metod, proqram təminatı və doğrulama D.R.; formal təhlil və resurslar S.M.; ilkin layihə D.R.; nəzərdən keçirmə/redaktə D.R.; vizuallaşdırma D.R. və S.M.; elmi rəhbərlik S.M.
Metod: Eksperimental induktivlik xarakterizasiyası + MATLAB Simulink DDPG təlimi + 8/6 SRM simulyasiyası + TSF və DITC müqayisəsi + FPGA əsaslı real vaxt aparat tətbiqi.
Əsas eksperimental məhdudiyyət: Aparat təcrübəsi orta mexaniki fırlanma anı və sürət davranışını doğrulayır; fırlanma anı dalğalanması faizi birbaşa eksperimental ani fırlanma anı ölçməsindən deyil, simulyasiya edilmiş elektromaqnit fırlanma anından hesablanmışdır.
Mənbədaxili hesabat xəbərdarlığı: Simulyasiya və eksperimental mühərrik gücü ilə bəzi cərəyan dəyərləri müxtəlif bölmələrdə bir-biri ilə birbaşa uyğun gəlməyən şəkildə bildirilir. Mənbə kifayət qədər izah vermədiyi üçün bu dəyərlər Verianla tərəfindən düzəldilməmiş və ya vahid ortaq dəyərə məcbur edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib