

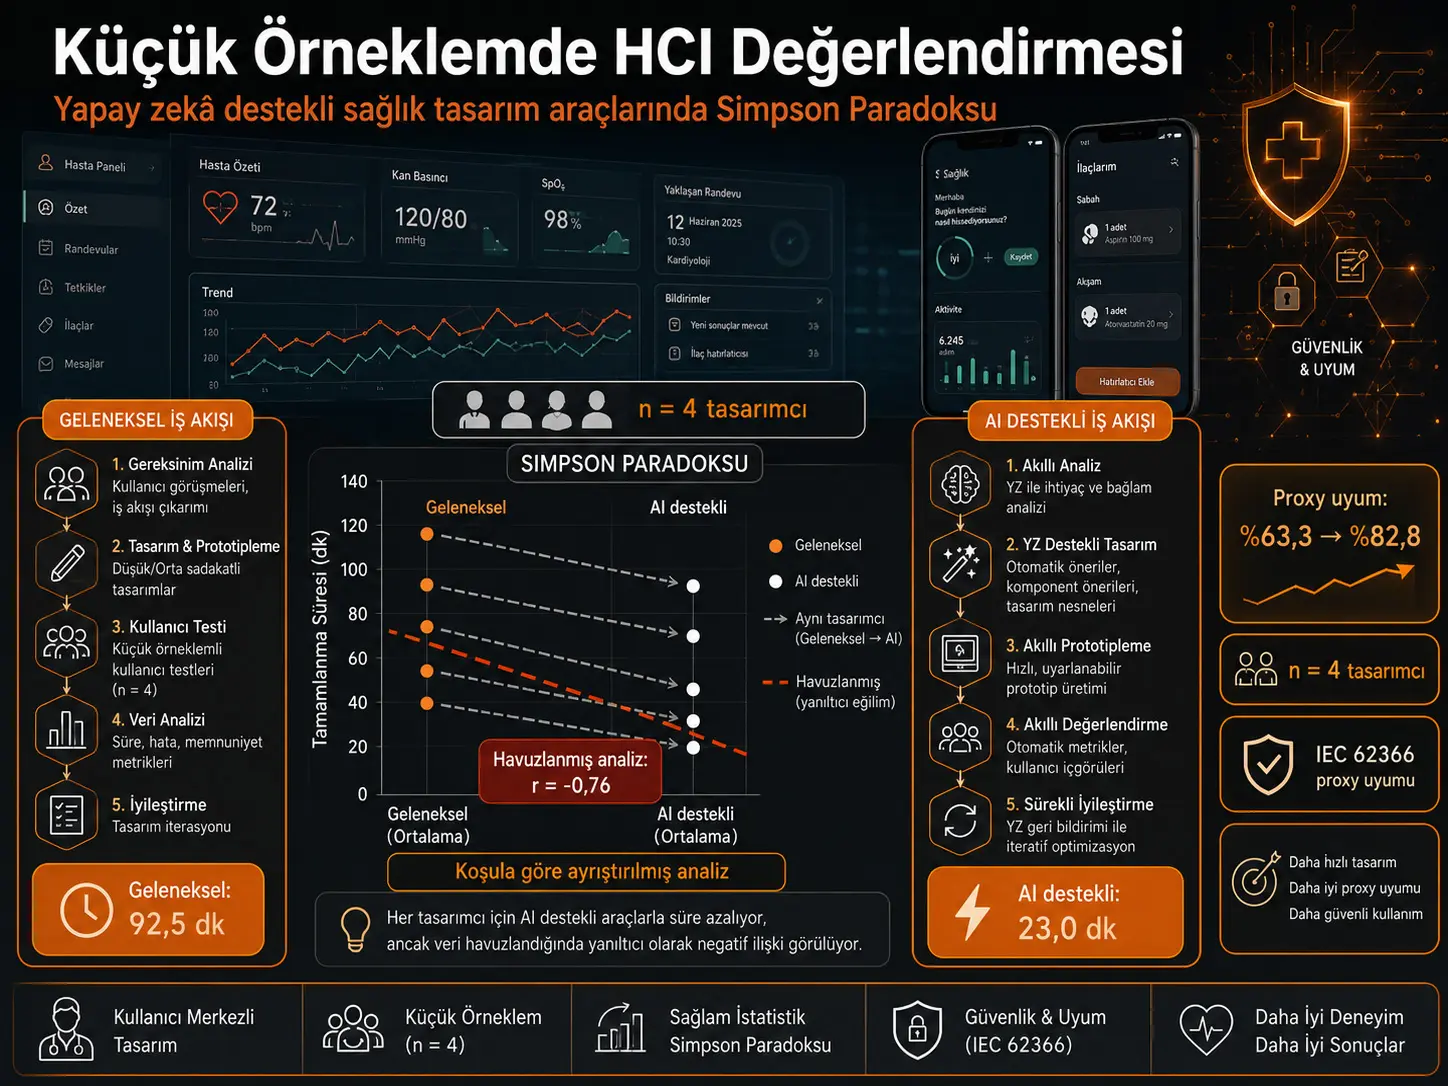
Bu tədqiqat mütəxəssis iştirakçı tapmağın çətin olduğu səhiyyə sahəsində insan–kompüter qarşılıqlı əlaqəsi (Human–Computer Interaction, HCI) araşdırmalarında kiçik nümunələrin necə təhlil edilməli olduğunu Simpson Paradoksu vasitəsilə araşdırır. Dörd peşəkar UI/UX dizayneri eyni səhiyyə proqram təminatı interfeys tapşırıqlarını əvvəlcə ənənəvi üsulla, daha sonra GPT əsaslı süni intellekt dəstəkli dizayn aləti ilə tamamladı. Səkkiz müşahidənin hamısı vahid məlumat dəsti kimi birləşdirildikdə dizayn müddəti ilə avtomatik IEC 62366 proxy-uyğunluq balı arasında güclü və statistik baxımdan əhəmiyyətli mənfi korrelyasiya tapıldı: \(r=-0{,}76\), \(p=0{,}029\), \(n=8\). Buna qarşı ənənəvi şərt öz daxilində \(r=-0{,}33\), \(p=0{,}67\); AI dəstəkli şərt isə öz daxilində \(r=+0{,}18\), \(p=0{,}82\) verdi. Hər iki şərtdaxili korrelyasiya əhəmiyyətli deyildi və işarələri bir-birindən fərqli idi. Buna görə hovuzlaşdırılmış korrelyasiya “daha sürətli işləmək daha yaxşı uyğunluğa gətirib çıxarır” kimi şərh edilə biləcək real fərdi əlaqə deyil, iki fərqli eksperimental şərtin bir-birindən ayrılmasının yaratdığı aggregation artefact kimi qiymətləndirildi.
Xam məlumatlarda bütün dörd dizaynerin AI dəstəkli şərtdə həm daha qısa müddətdə işlədiyi, həm də daha yüksək avtomatik proxy-uyğunluq balı aldığı görüldü. Orta tapşırıq müddəti 92,5 dəqiqədən 23,0 dəqiqəyə; orta proxy-uyğunluq balı %63,3-dən %82,8-ə dəyişdi. Lakin bütün iştirakçılar şərtləri eyni ardıcıllıqla tamamladığı üçün bu fərqlərin hamısı birbaşa AI alətinə aid edilə bilməz; praktika, öyrənmə və tapşırığa tanışlıq təsirləri nəticələrə töhfə vermiş ola bilər. Bundan əlavə, yalnız dörd dizaynerin olması Gaussian paylanma fərziyyəsi, variasiya dəyişiklikləri və təcrübə qrupları arasındakı fərqlər barədə güclü ümumiləşdirmə aparmağa imkan vermir. Tədqiqatın əsas töhfəsi “dörd nəfər kifayətdir” iddiası deyil; kiçik nümunə qaçılmaz olduqda məlum eksperimental şərtləri aradan qaldıran hovuzlaşdırmanın aldadıcı ola biləcəyini və şərtə görə ayrılmış təhlilin məlumatın həqiqi strukturunu daha açıq göstərə bildiyini ortaya qoymaqdır.
Simpson Paradoksu nədir?
Simpson Paradoksu alt qruplar ayrıca araşdırıldıqda görünən əlaqələrin məlumatlar birləşdirildikdə yox olması, dəyişməsi və ya əks istiqamətdə görünməsi halıdır. Problem yalnız riyazi maraq deyil. Tədqiqatçı qrup və ya eksperimental şərt məlumatını nəzərə almadan bütün müşahidələri vahid paylanmadan gəlirmiş kimi təhlil etdikdə, müxtəlif qrupların ortalamaları arasındakı məsafə süni korrelyasiya yarada bilər.
Bu araşdırmadakı nümunə olduqca aydındır. Ənənəvi dizayn şərti ümumilikdə yüksək müddət–daha aşağı uyğunluq bölgəsində; AI dəstəkli şərt isə aşağı müddət–daha yüksək uyğunluq bölgəsində yerləşir. İki klaster birlikdə regressiyaya daxil edildikdə qrafik sol yuxarıdan sağ aşağıya uzanan güclü mənfi meyl yaradır.
Lakin araşdırmanın əsas sualı “səkkiz müstəqil müşahidədə müddət ilə uyğunluq arasında əlaqə varmı?” deyil. Eyni dörd insan iki müxtəlif şərt altında ölçülüb. Şərt üzvlüyü və şəxslərin uyğunlaşdırılması eksperimental dizaynın əsas hissələridir.
Hovuzlaşdırılmış təhlil niyə aldadıcı nəticə verdi?
Səkkiz müşahidə birlikdə hesablandıqda:
\[ r_{\mathrm{pooled}}=-0{,}76,\qquad p=0{,}029,\qquad n=8. \]
Bu rəqəm təkbaşına oxunduqda daha qısa müddətdə dizayn etməyin daha yüksək IEC 62366 uyğunluğu ilə davamlı şəkildə əlaqəli olduğu düşünülə bilər. Müəlliflər belə bir şərhin dəstəklənmədiyini xüsusilə vurğulayırlar.
Şərtlər ayrı saxlanıldıqda:
\[ r_{\mathrm{traditional}}=-0{,}33, \qquad p=0{,}67, \qquad n=4 \]
və:
\[ r_{\mathrm{AI}}=+0{,}18, \qquad p=0{,}82, \qquad n=4 \]
əldə edilir.
Hər iki korrelyasiya statistik baxımdan əhəmiyyətli deyil; üstəlik biri mənfi, digəri müsbətdir. Buna görə mənbə tədqiqat \(-0{,}76\)-lıq hovuzlaşdırılmış əmsalın şərtlər arasındakı mövqe fərqindən yarandığını və dizaynerlərin öz daxilindəki sürət–uyğunluq mexanizmini təmsil etmədiyini müdafiə edir.
Fərdi dizaynerlər əslində necə hərəkət etdi?
| Dizayner | Ənənəvi müddət (dəq) | AI dəstəkli müddət (dəq) | Ənənəvi proxy-uyğunluq | AI dəstəkli proxy-uyğunluq |
|---|---|---|---|---|
| D1 | 90 | 33 | %64 | %93 |
| D2 | 88 | 32 | %50 | %75 |
| D3 | 120 | 10 | %63 | %83 |
| D4 | 72 | 17 | %76 | %80 |
Dörd dizaynerin hamısı ənənəvi şərtdən AI dəstəkli şərtə keçərkən qrafikdə eyni ümumi istiqamətdə hərəkət etdi: müddət azaldı və avtomatik proxy-uyğunluq balı yüksəldi. Bu fərdi uyğunlaşdırılmış hərəkət şərt məlumatını yox edən hovuzlaşdırılmış korrelyasiyanın niyə ehtiyatla şərh edilməli olduğunu göstərir.
Şərti Gaussian model nə edir?
Tədqiqatın təklif etdiyi yanaşmada hər eksperimental şərt ayrıca iki dəyişənli Gaussian xülasə kimi təmsil olunur:
\[ p(x\mid k)= \mathcal N(x;\mu_k,\Sigma_k), \]
burada:
\[ x= \begin{bmatrix} \text{süre}\\ \text{proxy-uyum} \end{bmatrix} \]
və \(k\) traditional və ya AI-assisted şərtini göstərir.
\(\mu_k\) hər şərtin mərkəzini; \(\Sigma_k\) isə həmin şərtdə müşahidə olunan variasiya və covariance strukturunu təmsil edir.
Bu modelin məqsədi dörd müşahidədən etibarlı populyasiya paylanması təxmin etmək deyil. Müəlliflər Gaussian komponentlərini şərtə xas mərkəzləri, səpələnməni və birgə dəyişmə istiqamətini nizamlı şəkildə göstərən təsviri xülasələr kimi istifadə edirlər.
Bu həqiqətən Gaussian Mixture Model-dir?
Məqalə terminologiyanı xüsusilə aydınlaşdırır. Tədqiqatın ilk hazırlandığı dövrdə “conditional GMM” adı istifadə olunsa da, tətbiq olunan üsul klassik unsupervised Gaussian Mixture Model deyil.
Klassik GMM-də:
- hansı müşahidənin hansı klasterə aid olduğu bilinməyə bilər,
- mixing weights təxmin edilir,
- Expectation–Maximisation kimi alqoritmlər istifadə oluna bilər,
- komponent sayı BIC kimi meyarlarla seçilə bilər.
Bu tədqiqatda isə ənənəvi və AI dəstəkli şərt etiketləri eksperimental dizayndan əvvəlcədən məlumdur. İki komponent kəşf edilmir, əvvəldən müəyyənləşdirilir. EM istifadə edilməyib, latent cluster axtarılmayıb və BIC ilə komponent sayı seçilməyib.
Buna görə müəlliflər cari mətndə əsas ad kimi conditional Gaussian model ifadəsini istifadə edirlər.
Şərt mərkəzləri nə qədər fərqlidir?
Ənənəvi şərtin mərkəzi:
\[ \mu_{\mathrm{traditional}} = (92{,}5\ \mathrm{dk},\;63{,}3\%) \]
olduğu halda AI dəstəkli şərtin mərkəzi:
\[ \mu_{\mathrm{AI}} = (23{,}0\ \mathrm{dk},\;82{,}8\%) \]
kimi verilib.
Nümunədəki mərkəz fərqi AI şərtinin ənənəvi şərtlə müqayisədə orta hesabla 69,5 dəqiqə daha qısa və 19,5 faiz bəndi daha yüksək avtomatik proxy-uyğunluq dəyərinə sahib olduğunu göstərir.
Lakin sabit şərt ardıcıllığına görə “AI aləti təkbaşına 69,5 dəqiqə qazandırdı” və ya “AI aləti təkbaşına uyğunluğu 19,5 bənd artırdı” nəticəsi çıxarıla bilməz. Bu dəyərlər araşdırmanın həyata keçirildiyi ardıcıllıqda müşahidə olunan şərt fərqləridir.
IEC 62366 balı əslində nəyi ölçür?
Tədqiqatın istifadə etdiyi ikinci əsas ölçü IEC 62366-1:2015 ilə uyğunlaşmanı qiymətləndirmək üçün ayrıca GPT əsaslı alətin yaratdığı faiz balıdır. Qiymətləndirmə rubrikası beş ölçünü ehtiva edir:
- İstifadə xətasının azaldılması: təhlükəsizlik baxımından vacib qarşılıqlı əlaqələrdə səhv imkanlarının azaldılması.
- Məlumat iyerarxiyası: kritik və ilkin tapşırıq məlumatının vizual və struktur üstünlüyü.
- Geribildirimin aydınlığı: sistem cavablarının, xəta vəziyyətlərinin və təsdiqlərin aydın olması.
- Əlçatanlıq: oxunaqlılıq, kontrast, hədəf ölçüsü və klinik istifadə mühiti ilə əlaqəli əlçatanlıq xüsusiyyətləri.
- Tibbi cihaz interfeysi konvensiyaları: məlum terminologiya və qarşılıqlı əlaqə gözləntilərinə uyğunluq.
Bu bal rəsmi IEC 62366 sertifikatlaşdırması və ya tənzimləyici uyğunluq qərarı deyil. Rubrika qiymətləndirmə aləti tərəfindən standartdan çıxarılıb və mütəxəssis insan qiymətləndiricilərinə qarşı doğrulanmayıb. Müəlliflər buna görə ölçünü “consistency-controlled proxy measure” kimi məhdudlaşdırırlar.
Eyni model ailəsinin həm yaratması, həm də qiymətləndirməsi niyə vacibdir?
AI dəstəkli dizayn aləti tədqiqat dövründə ChatGPT üzərindən əlçatan olan GPT-4o əsaslı xüsusi GPT-dir. Ayrı compliance scorer də GPT-4o model ailəsi üzərində işləyən başqa bir xüsusi GPT kimi qurulub.
Müəlliflər bunun mümkün model-family bias yarada biləcəyini açıq şəkildə qəbul edirlər. Dizayn istehsalında istifadə olunan model ailəsinin yaratdığı nümunələr eyni ailədən gələn qiymətləndirmə sisteminə struktur baxımından daha uyğun görünə bilər.
Beləliklə, uyğunluq ballarının müstəqil mütəxəssislər tərəfindən doğrulanması gələcəkdə görülməli əsas metodoloji nəzarətlərdən biridir.
Nümunədəki standart yayınmalar nə göstərir?
Mənbədə müşahidə olunan nümunə standart yayınmaları belədir:
| Ölçü | Ənənəvi şərt | AI dəstəkli şərt |
|---|---|---|
| Tapşırıq müddəti | 20,0 dəq | 11,3 dəq |
| Proxy-uyğunluq | 10,6 faiz bəndi | 7,6 faiz bəndi |
Hər iki ölçüdə nümunə standart yayınması AI şərtində daha kiçikdir. Lakin yalnız dörd müşahidə olduğu üçün bu fərq populyasiya variasiyasının həqiqətən azaldığını sübut etmir.
Brown–Forsythe formasındakı Levene testində müddət üçün:
\[ W=0{,}16,\qquad p=0{,}70 \]
və proxy-uyğunluq üçün:
\[ W=0{,}12,\qquad p=0{,}74 \]
əldə edilib.
Müəlliflər bu nəticələri “variasiyalar bərabərdir” kimi şərh etmirlər. \(n=4\) olduğu üçün testin gücü çox aşağıdır; mövcud məlumat variasiyanın daralmasını nə təsdiqləyə, nə də istisna edə bilər.
Təcrübə səviyyəsinə görə necə bir nümunə görüldü?
| Dizayner | Profil | Müşahidə olunan müddət azalması | Müşahidə olunan proxy-uyğunluq artımı |
|---|---|---|---|
| D1 | Orta UI / Yüksək AI | %63 | +29 faiz bəndi |
| D2 | Orta UI / Yüksək AI | %64 | +25 faiz bəndi |
| D3 | Aşağı UI / Bir qədər AI | %92 | +20 faiz bəndi |
| D4 | Yüksək UI / Aşağı AI | %76 | +4 faiz bəndi |
UI təcrübəsi ən aşağı olan dizayner D3, 120 dəqiqədən 10 dəqiqəyə enərək nümunədəki ən böyük müddət fərqini göstərib. AI təcrübəsi yüksək olan D1 və D2 isə müvafiq olaraq +29 və +25 faiz bəndi ilə ən böyük avtomatik proxy-uyğunluq artımlarına sahibdir.
Bu dəyərlər təcrübə qrupları arasında sübut olunmuş qarşılıqlı təsir effektləri deyil. Hər profil üçün bir dizayner və ya çox az müşahidə olduğuna görə müəlliflər bunları yalnız gələcək araşdırmalar üçün hipotez yaradan kəşfiyyat nümunələri kimi qiymətləndirirlər.
Dizaynerlərin geribildirimi nə dedi?
Phase 1-də dörd dizaynerin hamısı AI dəstəkli alətin ideyadan vizual dizayna keçid prosesini sürətləndirdiyini bildirdi. Üç dizayner alətin dizayn vizyonunu konkret dizayna çevirməkdə faydalı olduğunu söylədi.
Buna qarşı iki daha təcrübəli dizayner standart addım-addım yönləndirmənin öz ekspert iş axınlarında lazımsız sürtünmə yaratdığını bildirdi. Mənbədə bu geribildirim formal thematic analysis kimi təqdim olunmur; yalnız kiçik nümunədən əldə edilmiş təsviri təkrarlanan mövzu xülasəsi kimi bildirilir.
Bu müşahidə aləti necə dəyişdirdi?
Tədqiqatçılar ilk mərhələdəki heterogenliyi yalnız bildirməklə kifayətlənməyib, ikinci mərhələdə aləti yenidən dizayn etmək üçün istifadə ediblər.
Yeni alət sessiyanın əvvəlində istifadəçinin:
- AI alətləri ilə təcrübəsini,
- UI dizayn təcrübəsini
soruşur və iki qarşılıqlı əlaqə rejimindən birini seçir.
Daha az təcrübəli istifadəçi: açıq dizayn qərarları, inline rəhbərlik və addım-addım “handholding” rejimi.
Daha təcrübəli istifadəçi: daha az scaffolding ehtiva edən açıq uclu/free-form rejim.
Bundan əlavə, ilk alətin yalnız vizual istehsala əsaslanan yanaşmasına əlavə olaraq UI elementlərinin birbaşa redaktə oluna bildiyi real-canvas səthi əlavə edilib.
İkinci mərhələdə nə baş verdi?
Phase 2-də D1, D2 və D3 iştirak etdi. D4 bu mərhələdə iştirak etmədi.
| Dizayner | Phase 1 AI aləti (dəq) | Phase 2 uyğunlaşan alət (dəq) | Müşahidə olunan zaman dəyişikliyi |
|---|---|---|---|
| D1 | 33 | 10 | −%70 |
| D2 | 32 | 17 | −%47 |
| D3 | 10 | 32 | +%220 |
AI təcrübəsi yüksək olan D1 və D2 uyğunlaşdırılmış alətlə daha da sürətləndi. UI təcrübəsi aşağı olan D3 isə əvvəlki 10 dəqiqə əvəzinə 32 dəqiqə sərf etdi.
Mənbə bu artımı avtomatik olaraq pisləşmə kimi şərh etmir. D3 açıq uclu geribildirimdə dizayn üzərində daha uzun müddət iterasiya etdiyini və çıxışı daha çox inkişaf etdirdiyini bildirib. Bununla belə tədqiqat obyektiv Phase 2 keyfiyyət ölçüsü olmadığı üçün:
“daha yavaşdır, çünki daha diqqətlidir”
ilə:
“daha yavaşdır, çünki alət daha çox məhdudlaşdırıb”
ehtimallarını kəmiyyət baxımından ayıra bilmir.
Phase 2-nin keyfiyyət ölçüsü niyə Phase 1 ilə müqayisə edilə bilməz?
Phase 1-də keyfiyyət/uyğunluq üçün GPT əsaslı IEC 62366 proxy-balı istifadə olunub. Phase 2-də eyni avtomatik qiymətləndirmə təkrarlanmayıb; əvəzinə iştirakçılar beş ballıq məmnunluq/keyfiyyət qiymətləndirməsi aparıblar.
Üç dizayner də 4/5 verib və scaffolding-in uyğun olduğunu bildirib. Lakin:
\[ \text{IEC 62366 proxy-puanı} \neq \text{öznel 5 puanlık memnuniyet} \]
olduğuna görə Phase 1 və Phase 2 keyfiyyət dəyərləri birbaşa müqayisə edilə bilməz.
Gaussian fərziyyəsi həqiqətən sınaqdan keçirilibmi?
Xeyr. Tədqiqatçılar \(n=4\) müşahidə ilə bivariate normality fərziyyəsinin mənalı şəkildə doğrulana bilməyəcəyini açıq şəkildə bildirirlər.
Shapiro–Wilk, Kolmogorov–Smirnov və ya Anderson–Darling kimi testlərin bu ölçüdə nümunədə şərh edilə bilən gücü yoxdur. Dörd nöqtədən ibarət Q–Q qrafiki də paylanma formasını etibarlı şəkildə müəyyən edə bilməz.
Buna görə conditional Gaussian model formal likelihood inference üçün doğrulanmış ehtimal modeli kimi deyil, şərtləri təşkil edən və vizual şəkildə xülasə edən alət kimi istifadə edilir.
Paired t-test nə göstərdi?
Eyni iştirakçılar iki şərtdə ölçüldüyü üçün tədqiqatçılar standart paired t-test müqayisəsini də aparıblar.
Müddət fərqi üçün:
\[ \bar d=69{,}5\ \mathrm{dk}, \]
\[ t(3)=5{,}15, \qquad p=0{,}014, \]
\[ 95\%\ GA=[26{,}5,\;112{,}5], \qquad d_z=2{,}57. \]
Proxy-uyğunluq fərqi üçün:
\[ \bar d=19{,}5\ \text{yüzde puanı}, \]
\[ t(3)=3{,}56, \qquad p=0{,}038, \]
\[ 95\%\ GA=[2{,}0,\;37{,}0], \qquad d_z=1{,}78. \]
Müəlliflər paired t-test-i iki şərtin orta fərqi haqqında əsas inferential comparator kimi istifadə edirlər. Conditional Gaussian model isə bunun əvəzinə Simpson Paradoksunu və şərtlərə/istifadəçi profillərinə görə struktur heterogenliyi görünən edir. Yəni conditional model paired t-test-in yerinə qoyulmur.
Wilcoxon testi niyə əhəmiyyətli çıxmadı?
Exact Wilcoxon signed-rank test hər iki nəticə üçün:
\[ W=0,\qquad p=0{,}125 \]
verib.
Lakin dörd uyğunlaşmanın hamısı eyni istiqamətdə olduqda iki tərəfli exact Wilcoxon testinin əldə edə biləcəyi ən kiçik p-dəyəri:
\[ 2\left(\frac12\right)^4=0{,}125 \]
olduğuna görə tədqiqat bu nəticəni “təsir yoxdur” kimi şərh etmir. Bu nümunə ölçüsündə testin p-dəyəri ayırdetmə qabiliyyəti onsuz da 0,05-in altına enə bilmir.
Niyə mixed-effects model istifadə olunmadı?
Dörd dizayner random-effect variasiya komponentlərinin etibarlı təxmini üçün son dərəcə məhdud qrup səviyyəsi sayıdır. Tədqiqatçılar random-intercept modelini sınaqdan keçiriblər, lakin maksimum likelihood həlli üç optimizer ilə yenidən sınanmasına baxmayaraq converge etməyib; bir L-BFGS konfiqurasiyasında singular design matrix əldə edilib.
Random-slope modeli riyazi baxımdan converge etmiş olsa da yalnız dörd şəxsdə həddindən artıq parametrik olduğu üçün variasiya komponentlərinin şərh olunmaz olduğu qəbul edilib.
Bayesian hierarchical model niyə tətbiq edilmədi?
Tədqiqatın qiymətləndirməsinə görə \(n=4\)-də dizaynerlərarası variasiyanı təmsil edən hyperparameter məlumatdan kifayət qədər müəyyən edilə bilmir. Zəif prior istifadə olunduqda posterior böyük ölçüdə prior-ı geri verə bilər; güclü prior istifadə edildikdə nəticə daha birbaşa prior tərəfindən müəyyən edilə bilər.
Buna görə Bayesian hierarchical model daha böyük məlumat dəsti üçün gələcək iş kimi saxlanılıb.
Tədqiqatın dəstəklədiyi nəticələr
Birincisi, bu nümunədə ənənəvi və AI dəstəkli şərtlər birləşdirildikdə güclü mənfi korrelyasiya yaranıb, lakin şərtlər ayrıca təhlil edildikdə eyni əlaqə görünməyib. Tədqiqatın Simpson Paradoksu/aggregation artefact iddiasının birbaşa empirik əsası budur.
İkincisi, dörd dizaynerin hamısında AI dəstəkli şərt ənənəvi şərtlə müqayisədə daha qısa müddət və daha yüksək avtomatik proxy-uyğunluq balı ilə birlikdə müşahidə olunub.
Üçüncüsü, şərtə xas təhlil dizaynerlər arasında fərqli cavab profillərinin olduğunu göstərib; lakin bu profillər kiçik nümunəyə görə hipotez yaradan səviyyədədir.
Dördüncüsü, Phase 1-də müşahidə olunan scaffolding heterogenliyi alətin təcrübəyə uyğunlaşdırılmış ikinci versiyasının hazırlanmasına səbəb olub və Phase 2-də dizaynerlər arasında iki istiqamətli zaman cavabı müşahidə olunub.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
Tədqiqat dörd nəfərin kiçik nümunə üçün ümumiyyətlə kifayət etdiyini göstərmir. Müəlliflər bunun əksini açıq şəkildə qəbul edirlər.
Tədqiqat AI alətinin müşahidə olunan bütün yaxşılaşmanın səbəb mənbəyi olduğunu sübut etmir. Şərtlər counterbalanced olmadığı üçün praktika və tapşırığa tanışlıq təsirləri ayrılmayıb.
Tədqiqat GPT əsaslı uyğunluq balının həqiqi tənzimləyici IEC 62366 uyğunluğuna bərabər olduğunu göstərmir.
Tədqiqat AI şərtində həqiqi populyasiya variasiyasının daha aşağı olduğunu sübut etmir.
Tədqiqat müəyyən təcrübə səviyyələrindəki bütün dizaynerlərin eyni şəkildə cavab verəcəyini göstərmir.
Phase 2 uyğunlaşan alətin keyfiyyət baxımından üstün olduğunu sübut etmir. Phase 2-də Phase 1 ilə eyni obyektiv/proxy keyfiyyət ölçüsü istifadə edilməyib.
Conditional Gaussian model formal kiçik-nümunə inferential həll kimi doğrulanmayıb. Məqalədə onun əsas funksiyası şərt strukturunu qoruyan təsviri və diagnostik təhlildir.
Türkiyə baxımından nə ifadə edir?
Tədqiqat Yaponiyadakı universitetə bağlı tədqiqatçılar tərəfindən aparılıb və yalnız dörd peşəkar dizaynerdən ibarət rahatlıq nümunəsi istifadə olunub. Türkiyədəki səhiyyə proqram təminatı dizaynerləri və ya tibbi cihaz istehsalçıları üçün birbaşa performans nəticəsi təqdim etmir.
Bununla belə metodoloji mesaj ölkəyə xas deyil: mütəxəssis iştirakçıların az olduğu səhiyyə HCI, tibbi proqram təminatı, sənaye interfeysi və ya digər təhlükəsizlik-kritik UX tədqiqatlarında şərtləri vahid hovuzda birləşdirməzdən əvvəl şərtdaxili nümunələr araşdırılmalıdır. Türkiyə kontekstində eyni metodun tətbiqi yerli dizaynerlərlə daha böyük və şərt ardıcıllığı balanslaşdırılmış müstəqil tədqiqatlar tələb edir.
Tədqiqatın Metodu və Nəticələri
Phase 1 eksperimental dizaynı
Dörd peşəkar UI/UX dizayneri səhiyyə proqram təminatı interfeysləri üçün eyni dizayn tapşırıqlarını iki şərtdə tamamladı:
- Ənənəvi iş axını: AI dizayn aləti istifadə edilmədən manual yanaşma.
- AI dəstəkli iş axını: səhiyyə HCI prinsipləri və IEC 62366 biliyi ilə strukturlaşdırılmış GPT əsaslı alət.
İştirakçıların xüsusiyyətləri belədir:
| ID | UI təcrübəsi | AI təcrübəsi | Arxa plan |
|---|---|---|---|
| D1 | Orta | Yüksək | Healthcare UX, 3+ il |
| D2 | Orta | Yüksək | Medical software, 4 il |
| D3 | Aşağı | Bir qədər | Ümumi UX; səhiyyə sahəsinə keçid |
| D4 | Yüksək | Aşağı | Baş dizayner, 8+ il |
Tapşırıqlara Portable Health Clinic mobil sistemi üçün təhlükəsiz giriş ekranı və səhiyyə işçisi dashboard-u kimi səhiyyə interfeysləri daxil idi. Tələblər xəta qarşısının alınması, məlumat iyerarxiyası və əlçatanlıq ölçülərini əhatə edirdi.
Sessiyalar təxminən 90 dəqiqə üçün planlaşdırılmışdı, lakin sərt vaxt limiti tətbiq edilməmişdi. Müddət tapşırığın başlanmasından dizaynerin son təhvilinə qədər qeydə alındı.
Şərt ardıcıllığının dizayna təsiri
Dörd iştirakçının hamısı:
əvvəl traditional → sonra AI-assisted
ardıcıllığını izləyib.
Tədqiqatçılar bunu AI aləti ilə əvvəlcədən qarşılaşmanın manual dizayna təsir etməsinin qarşısını almaq üçün seçiblər. Bunun əvəzində bu qərar ikinci şərtdəki nəticələri tapşırıq öyrənməsi və tanışlıqla qarışdırır.
Buna görə tədqiqat randomised və ya counterbalanced causal trial kimi deyil, sequentially unbalanced exploratory comparison kimi şərh edilir.
AI dizayn alətinin strukturu
AI şərtində istifadə olunan tətbiq təbii dil istəkləri ilə işləyən GPT əsaslı dizayn alətidir. Alət:
- mətn təsvirlərindən interfeys mockup-ları yarada bilirdi,
- HCI və istifadəolunma prinsiplərinə görə təkmilləşdirmələr təklif edə bilirdi,
- potensial istifadə xətalarını işarələyə bilirdi,
- səhiyyə UX nümunələrini və IEC 62366 biliklərini dizayn prosesinə daxil edə bilirdi.
Tədqiqat dövründə alət ChatGPT platformasında xüsusi GPT formasında və GPT-4o model ailəsi ilə işləyirdi.
Əsas ölçülər
İki ilkin kəmiyyət ölçüsü toplanıb:
- Tapşırığı tamamlama müddəti: dəqiqə.
- IEC 62366 proxy-uyğunluq balı: ayrıca GPT əsaslı qiymətləndirmə alətindən əldə edilən faiz dəyəri.
Xam müddət məlumatları və Verianla Live
Dörd iştirakçının hamısında AI dəstəkli şərtdə tapşırıq müddəti daha aşağıdır. Aşağıdakı Verianla Live qrafiki yalnız eyni vahiddə olan müddət məlumatlarını müqayisə edir; compliance balları müddət oxuna qarışdırılmayıb.
Orta müddət:
\[ 92{,}5\ \mathrm{dk} \rightarrow 23{,}0\ \mathrm{dk} \]
kimi dəyişib. Mənbə bunu müşahidə olunan ortalamada təxminən %75 azalma kimi bildirir. Sabit şərt ardıcıllığı səbəbindən bu faiz saf səbəbkar AI təsiri deyil.
Proxy-uyğunluq nəticələri
| Dizayner | Ənənəvi proxy-uyğunluq | AI dəstəkli proxy-uyğunluq | Fərq |
|---|---|---|---|
| D1 | %64 | %93 | +29 faiz bəndi |
| D2 | %50 | %75 | +25 faiz bəndi |
| D3 | %63 | %83 | +20 faiz bəndi |
| D4 | %76 | %80 | +4 faiz bəndi |
Nümunə ortalaması:
\[ 63{,}3\% \rightarrow 82{,}8\% \]
kimi dəyişib və dörd dizaynerin hamısında istiqamət müsbət olub. Lakin balın avtomatik və mütəxəssis doğrulamasından keçməmiş proxy olması xüsusilə qorunmalıdır.
Simpson Paradoksunun ədədi xülasəsi
| Təhlil | Korrelyasiya \(r\) | p | n | Mənbənin şərhi |
|---|---|---|---|---|
| Bütün müşahidələr hovuzlaşdırılıb | −0,76 | 0,029 | 8 | Əhəmiyyətli görünən, lakin şərtlərarası fərqin yaratdığı aggregation artefact |
| Yalnız ənənəvi şərt | −0,33 | 0,67 | 4 | Əhəmiyyətli deyil |
| Yalnız AI dəstəkli şərt | +0,18 | 0,82 | 4 | Əhəmiyyətli deyil |
Mənbə tədqiqatın metodoloji iddiası məhz bu fərqdən doğur: şərtlərin ayrılması hovuzlaşdırılmış korrelyasiyada görünməyən eksperimental strukturu geri qaytarır.
Paired təhlil ilə conditional modelin vəzifələri fərqlidir
| Metod | Bu tədqiqatdakı rolu |
|---|---|
| Paired t-test | Eyni iştirakçının iki şərt arasındakı orta fərqini inferential olaraq sınaqdan keçirir. |
| Conditional Gaussian model | Hər şərtin mərkəzini, səpələnməsini və birgə dəyişən strukturunu ayrı saxlayır; aggregation artefact-ı görünən edir. |
| Wilcoxon signed-rank | Rank əsaslı nəzarət; \(n=4\)-də minimum iki tərəfli p=0,125 səbəbindən inferential ayırdetmə qabiliyyəti kifayət deyil. |
| Repeated-measures ANOVA | İki şərtli dizaynda paired t-test ilə riyazi baxımdan ekvivalentdir. |
| Linear mixed-effects | Dörd random-effect səviyyəsinə görə etibarlı şəkildə təxmin edilməyib. |
| Bayesian hierarchical model | Bu nümunədə between-designer variasiyası prior-a həddindən artıq asılı olacağından tətbiq edilməyib. |
Monte Carlo əlavə təhlili nə göstərir?
Məqalənin əlavə materialında eksperimental dizayna uyğunlaşdırılmış Monte Carlo simulyasiyası bildirilir. Mənbə mətnin xülasə etdiyi nəticədə within-condition correlation sıfır olacaq şəkildə müəyyənləşdirilən məlumat yaratma prosesində \(n=4\) şəxs/şərt səviyyəsində 10.000 simulyasiyanın %56-sında hovuzlaşdırılmış təhlil statistik baxımdan əhəmiyyətli mənfi korrelyasiya yaradıb.
Bu simulyasiya məqalədəki tək parametr konfiqurasiyasına aiddir. Müxtəlif nümunə ölçüləri, effekt ölçüləri, korrelyasiya strukturları və normal paylanmadan sapmalar üçün ümumi operating characteristics tədqiqatı aparılmayıb.
Phase 2-nin metodoloji mənası
İkinci mərhələnin əsas töhfəsi conditional təhlildən çıxan istifadəçi heterogenliyi hipotezinin konkret məhsul dizaynı dəyişikliyinə çevrilməsidir:
təhlil → təcrübədən asılı scaffolding hipotezi → alətin yenidən dizaynı → yeni istifadəçi cavablarının müşahidəsi.
Müəlliflər bu dövrün iterative HCI design-a xas unikal metod olmadığını qəbul edirlər. Conditional modelin töhfəsi hovuzlaşdırılmış təhlilin hamarlaşdıracağı heterogenliyi struktur olaraq qorumasıdır.
Tədqiqatın metodoloji tövsiyələri
- Şərt fərqi gözlənilirsə əvvəlcə şərtləri ayrıca araşdır.
- Pooled korrelyasiya ilə within-condition korrelyasiyalarını müqayisə edərək Simpson Paradoksu yoxlaması apar.
- Hər şərt üçün orta, səpələnmə və korrelyasiyaları ayrıca bildir.
- Kiçik nümunədə variasiya fərqlərini inferential həqiqətlər kimi deyil, təsviri statistika kimi təqdim et.
- Təcrübə və ekspertlik kimi müvafiq istifadəçi xüsusiyyətlərinə görə cavabları kəşfiyyat xarakterli araşdır.
- Within-subject dizaynın pairing strukturunu inferential təhlil zamanı qoru.
Əsas məhdudiyyətlər
- Phase 1 yalnız dörd dizayneri əhatə edir.
- Phase 2 yalnız üç dizayneri əhatə edir.
- İştirakçılar convenience sampling ilə peşəkar şəbəkələrdən seçilib.
- Şərt ardıcıllığı sabitdir və counterbalanced deyil.
- Praktika/öyrənmə təsiri AI təsirindən ayrıla bilmir.
- Tapşırıqlar yalnız bir mobil səhiyyə proqram təminatı kontekstindədir.
- IEC 62366 bal sistemi müstəqil insan ekspertləri ilə doğrulanmayıb.
- Dizayn aləti ilə compliance scorer eyni GPT-4o model ailəsindədir.
- Gaussian paylanma fərziyyəsi \(n=4\)-də sınaqdan keçirilə bilməz.
- Şərtlərarası variasiya fərqi sübut edilməyib.
- Experience-indexed nəticələr tək müşahidələrdən çıxarılan kəşfiyyat nümunələridir.
- Phase 2-də D4 iştirak etməyib.
- Phase 2-də Phase 1-dəki IEC 62366 proxy-balı təkrarlanmayıb.
- Phase 2-nin 5 ballıq subyektiv keyfiyyət/məmnunluq ölçüsü Phase 1-in proxy-compliance metrikası ilə birbaşa müqayisə edilə bilməz.
Gələcək tədqiqatlar
Müəlliflərin təklif etdiyi növbəti addımlar daha böyük və counterbalanced nümunələr, şərt variasiyalarının kifayət qədər güclə sınaqdan keçirilməsi, Gaussian goodness-of-fit qiymətləndirməsi, modelin müxtəlif nümunə və korrelyasiya şərtlərində simulyasiya ilə hərtərəfli xarakterizə edilməsi və avtomatik IEC 62366 balının ekspert insan qiymətləndiriciləri qarşısında inter-rater reliability təhlilidir.
Çərçivənin aviasiya interfeysləri, maliyyə xidmətlərinin compliance UI-ları və əlçatanlıq məcburiyyəti olan dövlət interfeysləri kimi səhiyyədən kənar təhlükəsizlik-kritik sahələrdə sınaqdan keçirilməsi də təklif olunur.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: Conditional Gaussian Modelling for Small-Sample HCI Evaluation: Resolving Simpson’s Paradox in AI-Assisted Healthcare Design Tools
Müəlliflər: Mohammad Bilal Firoz; Ashir Ahmed.
Bərabər birinci/bərabər töhfə: Mənbədə göstərilməyib.
Məsul müəllif: Mohammad Bilal Firoz.
Qurum: Department of Information Science and Technology, Kyushu University, Fukuoka 819-0395, Japan.
Mənbə növü: İnsan iştirakçıları olan, kiçik nümunəli HCI/usability tədqiqat məqaləsi; iki mərhələli kəşfiyyat qiymətləndirməsi və metodoloji təhlil.
Rəyləndirmə statusu: Rəyli jurnal nəşridir.
Jurnal: AI.
Nəşriyyat: MDPI, Basel, İsveçrə.
Biblioqrafik qeyd: AI, 2026, Cild 7, Say 6, Məqalə 199.
DOI: 10.3390/ai7060199.
Qəbul / reviziya / qəbul olunma / nəşr: 31 mart 2026 / 22 may 2026 / 26 may 2026 / 30 may 2026.
Lisenziya: Creative Commons Attribution (CC BY).
Academic Editors: Zubaer Mannan; Asif Karim; Nur Alam Md.
Phase 1 nümunəsi: Dörd peşəkar UI/UX dizayneri.
Phase 2 nümunəsi: İlk mərhələdəki dizaynerlərdən üçü; D4 iştirak etməyib.
Tədqiqat dizaynı: Within-subjects, lakin şərt ardıcıllığı sabit, sequentially unbalanced exploratory comparison. Bütün dizaynerlər traditional şərti əvvəl, AI-assisted şərti ikinci tamamlayıb.
AI dizayn aləti: Tədqiqat dövründə ChatGPT platforması üzərindən əlçatan olan GPT-4o əsaslı custom GPT.
Compliance qiymətləndirmə aləti: Dizayn alətindən ayrı, lakin yenə GPT-4o model ailəsi üzərində qurulmuş custom GPT.
Compliance metrikasının statusu: IEC 62366-1:2015 uyğunlaşması üçün avtomatik və consistency-controlled proxy ölçüdür; doğrulanmış tənzimləyici uyğunluq qərarı deyil və ekspert insan qiymətləndirməsi ilə inter-rater reliability qurulmayıb.
Əsas metodoloji üsul: Məlum eksperimental şərtlərə görə condition-stratified bivariate Gaussian summaries. Unsurpervised GMM, EM alqoritmi, BIC component selection və ya latent cluster discovery istifadə edilməyib.
Əsas statistikalar: Pearson korrelyasiyaları, paired t-test, exact Wilcoxon signed-rank, Brown–Forsythe formasında Levene variance testi və repeated-measures ANOVA ekvivalentliyi. Linear mixed-effects fit sınaqdan keçirilib, lakin etibarlı şəkildə istifadə edilə bilməyib; Bayesian hierarchical təhlil tətbiq edilməyib.
Phase 1 əsas müşahidə olunan fərq: Orta müddət 92,5 dəqiqədən 23,0 dəqiqəyə; avtomatik proxy-uyğunluq ortalaması %63,3-dən %82,8-ə dəyişib. Şərt ardıcıllığı sabit olduğuna görə dəyərlər saf səbəbkar alət təsirləri kimi şərh edilə bilməz.
Simpson Paradoksu nəticəsi: Pooled \(r=-0{,}76\), \(p=0{,}029\), \(n=8\); traditional \(r=-0{,}33\), \(p=0{,}67\), \(n=4\); AI-assisted \(r=+0{,}18\), \(p=0{,}82\), \(n=4\).
Paired t-test: Zaman qənaəti üçün \(t(3)=5{,}15\), \(p=0{,}014\), \(d_z=2{,}57\); proxy-uyğunluq artımı üçün \(t(3)=3{,}56\), \(p=0{,}038\), \(d_z=1{,}78\).
Maliyyələşdirmə: Araşdırma xarici maliyyələşdirmə almayıb.
Etika komitəsi: Mənbəyə görə müvafiq Yaponiya institusional qaydaları çərçivəsində formal etika komitəsi təsdiqi zəruri hesab edilməyib. Tədqiqat pasiyent, klinik müdaxilə, bioloji nümunə və ya şəxsi sağlamlıq məlumatı ehtiva etməyən, könüllü yetkin peşəkarlarla aparılan non-medical və non-interventional usability qiymətləndirməsi kimi müəyyən edilib. Tədqiqatçılar işin Helsinki Bəyannaməsinin prinsiplərinə uyğun aparıldığını bildirirlər.
Məlumatlandırılmış razılıq: Bütün iştirakçılardan razılıq alınıb; anonim iştirakçı kodlarının, anonim dizayn qeydi sitatlarının və tapşırıqlarda yaradılan interfeys dizaynlarının dərc edilməsi üçün də razılıq verildiyi qeyd olunur.
Məlumat əlçatanlığı: Tədqiqatın orijinal töhfələrinin məqalə və Supplementary Materials daxilində olduğu, əlavə sualların məsul müəllifə yönəldilə biləcəyi bildirilir.
Əlavə material: AI dizayn alətləri, eksperimental məlumatlar, tapşırıq təsvirləri, nümunə dizaynlar, tədqiqat protokolu, statistik təfərrüatlar, məlumat/alət əlçatanlığı, Q–Q qrafikləri, Simpson Paradoksu Monte Carlo təhlili və təkrar istehsal oluna bilmə skripti bölmələrinin olduğu bildirilir.
Müəllif töhfələri: Konseptuallaşdırma M.B.F. və A.A.; metodologiya M.B.F.; formal təhlil M.B.F.; araşdırma M.B.F.; ilkin layihə M.B.F.; nəzərdən keçirmə və redaktə A.A.; vizuallaşdırma M.B.F.; rəhbərlik A.A. tərəfindən həyata keçirilib.
Generativ AI istifadəsi bəyanatı: Eksperimentdə UI/UX dizayn aləti və IEC 62366 proxy-qiymətləndirmə aləti GPT-4o əsaslı custom GPT-lər kimi istifadə olunub. Mənbə həmçinin məqalə hazırlanarkən dil düzəlişi, redaktə və statistik hesablamaların yoxlanmasına dəstək məqsədilə Claude Opus 4.7 istifadə edildiyini; bütün statistikaların müəlliflər tərəfindən nəzərdən keçirilib doğrulandığını və məzmuna görə müəlliflərin məsul olduğunu bildirir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirməyiblər.
Elmi şərh sərhədi
Tədqiqatın əsas metodoloji mesajı kiçik nümunənin kifayət etdiyi deyil; qaçılmaz kiçik nümunələrdə eksperimental strukturu yox edən hovuzlaşdırmanın əlavə olaraq xəta yarada biləcəyidir. Conditional Gaussian yanaşması bu tədqiqatda şərt strukturunu qoruyan təsviri/diagnostik çərçivədir və böyük nümunəli təsdiqləyici statistik tədqiqatların yerini tutmur.
AI şərtində müşahidə olunan daha qısa müddət və daha yüksək proxy-uyğunluq balı sabit şərt ardıcıllığına görə yalnız AI alətinin səbəbkar təsirinə aid edilə bilməz. Tədqiqatçılar eyni məhdudiyyəti iş boyu təkrar edirlər.
IEC 62366 faizi real tibbi cihazın tənzimləyici uyğunluğunun doğrulandığı anlamına gəlmir. İstifadə olunan GPT əsaslı rubrika müstəqil ekspert qiymətləndirilməsinə qarşı doğrulanmadığı üçün məqalədəki dəyərlər yalnız avtomatik proxy-uyğunluq ölçüsü kimi qəbul edilməlidir.
Phase 2-də təcrübəyə görə müşahidə olunan iki istiqamətli zaman cavabı da təsdiqləyici qarşılıqlı təsir testi deyil. Üç dizayner, sabit tapşırıq ardıcıllığı və fərqli keyfiyyət ölçüsü səbəbindən nəticə yalnız dizayn hipotezi yaradan xarakter daşıyır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib