

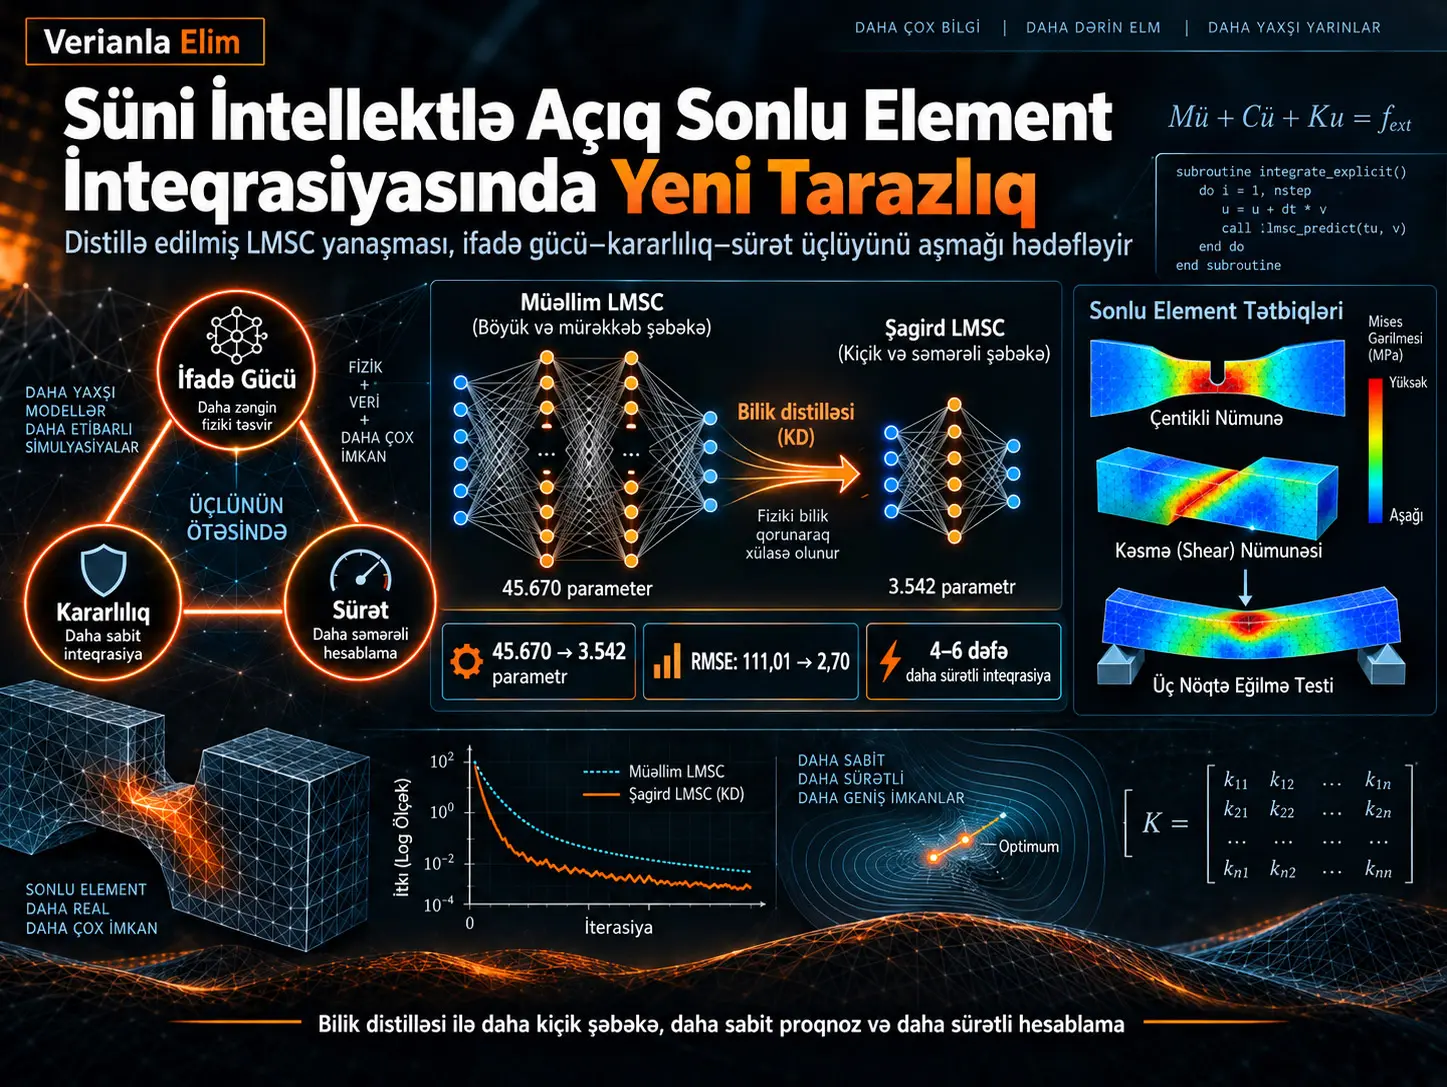
Metal formalaşdırma kimi böyükmiqyaslı açıq sonlu element analizlərində konstitutiv material modeli hər zaman addımında və çox böyük sayda inteqrasiya nöqtəsində təkrar-təkrar işlədilir. Klassik von Mises izotropik sərtləşmə modeli fiziki baxımdan etibarlı olsa da, bu davamlı qiymətləndirmə əhəmiyyətli hesablama xərci yaradır. Sinir şəbəkəsi əsaslı əvəzedici modellər bu xərci azaltmaq potensialına malikdir; lakin kiçik və sürətli şəbəkələr açıq inteqrasiya zamanı ardıcıl proqnoz xətalarının böyüməsi səbəbindən ədədi qeyri-sabitlik göstərə bilər.
Bu tədqiqat sözügedən ziddiyyəti “İfadə Gücü–Sabitlik–Sürət Üçlüyü” kimi müəyyənləşdirir və həll üçün Linearized Minimal State Cells (LMSC), native Fortran əsaslı Abaqus VUMAT inteqrasiyası və Knowledge Distillation (KD) üsulunu birləşdirir. Böyük və yüksək dəqiqlikli LMSC müəllim modelində 45.670 parametr olduğu halda, ultra-yüngül tələbə şəbəkəsi 3.542 parametrə endirilmiş; beləliklə təxminən 12,89 dəfə parametr sıxılması əldə edilmişdir.
Lakin tədqiqatın ən mühüm nəticəsi yalnız modelin kiçildilməsi deyil. Distillə edilməmiş kompakt şəbəkələr çevrimdışı verilənlər dəstində aşağı xəta göstərə bilsə də, açıq sonlu element inteqrasiyasında gərginlik xətalarını addım-addım toplayaraq qeyri-sabitləşə bilər. Məsələn, u=6, w=50 konfiqurasiyasının onlayn RMSE-si 111,01-ə yüksəldiyi halda, bilik distilləsindən sonra eyni arxitektura üçün RMSE 2,70-ə düşmüş və katastrofik sapma aradan qalxmışdır.
Çentikli dartılma, kəsilmə və üçnöqtəli əyilmə analizlərində distillə edilmiş tələbə modelləri referans Abaqus von Mises həllinə yaxın gərginlik sahələri və yük–yerdəyişmə əyriləri yaratmışdır. Native Fortran, BLAS/VML, batch processing və yaddaş yerləşimi optimallaşdırmaları ilə yüksək iterasiyalı analizlərdə ən kiçik şəbəkənin Abaqus-un daxili modeli ilə bənzər, hətta bəzi CPU konfiqurasiyalarında %24-ə qədər daha qısa hesablama müddəti təmin etdiyi bildirilmişdir.
Niyə sinir şəbəkəsindən istifadə avtomatik olaraq daha sürətli sonlu element analizi demək deyil?
Konstitutiv modeli sinir şəbəkəsi ilə əvəz etmək nəzəri olaraq riyazi inteqrasiya xərcini azalda bilər; lakin real sonlu element proqram təminatında yalnız şəbəkənin riyazi əməliyyatlarının sayı vacib deyil. Şəbəkə çəkilərinin diskdən oxunması, Python ilə Fortran arasında məlumat ötürülməsi, xarici maşın öyrənməsi kitabxanalarına edilən çağırışlar və kiçik matris əməliyyatlarının səmərəsiz icrası şəbəkənin nəzəri üstünlüyünü tamamilə aradan qaldıra bilər.
Mənbədə əvvəlki LMSC inteqrasiya yanaşmasının bəzi testlərdə Abaqus-un daxili fiziki modelindən 4–6 dəfə daha yavaş işləyə bildiyi bildirilir. Buna görə müəlliflər sürət problemini yalnız “daha kiçik şəbəkə” kimi deyil, həm də proqram təminatı arxitekturası problemi kimi nəzərdən keçirirlər.
İfadə Gücü–Sabitlik–Sürət Üçlüyü Nədir?
Tədqiqatın tərifinə görə uğurlu konstitutiv əvəzedici model eyni anda üç şərti yerinə yetirməlidir: mürəkkəb gərginlik–deformasiya tarixçəsini kifayət qədər dəqiqliklə ifadə etməli, qapalı dövrəli açıq inteqrasiyada kiçik ədədi xətaları böyütmədən sabit qalmalı və fiziki konstitutiv modeli əvəz etməyi mənalı edəcək qədər sürətli işləməlidir. Böyük şəbəkələr ifadə gücü və sabitlik təmin etsə də yavaşdır; həddindən artıq kiçildilmiş şəbəkələr sürətlidir, lakin ifadə qabiliyyətini və ya onlayn sabitliyi itirə bilər.
Çevrimdışı dəqiqlik niyə yanıltıcı ola bilər?
Çevrimdışı testdə şəbəkə hər proqnoz addımında düzgün fiziki tarixçə məlumatı ilə qidalanır. Açıq sonlu element inteqrasiyasında isə bir zaman addımında şəbəkənin yaratdığı daxili vəziyyət növbəti addıma ötürülür.
Buna görə kiçik bir xəta:
- daxili vəziyyət dəyişəninə daxil olur,
- növbəti proqnozu bir qədər dəyişdirir,
- dəyişmiş proqnoz növbəti vəziyyətin girişi olur,
- xəta təkrar qidalanaraq böyüyə bilər.
Mənbə bunu autoregressive error accumulation kimi müəyyənləşdirir.
Məsələn, LMSC_u6_w25 modeli çevrimdışı test loss baxımından kifayət qədər yaxşı görünür:
Losstest = 9,9 × 10⁻⁵
Lakin Abaqus VUMAT daxilində onlayn RMSE:
RMSE = 5,10
olur.
LMSC_u6_w50 üçün fərq daha da böyükdür:
Losstest = 6,17 × 10⁻³
Online RMSE = 111,01
Bu nəticələr göstərir ki, yalnız çevrimdışı MSE və ya validation loss dəyərinə baxmaqla açıq inteqrasiya sabitliyini qiymətləndirmək olmaz.
Bilik Distilləsi Kiçik LMSC Şəbəkəsini Necə Sabitləşdirir?
Tədqiqatda bilik distilləsi yalnız böyük modelin çıxışını kiçik modelə öyrətmə üsulu kimi istifadə edilmir. Tələbə şəbəkəsi həm Abaqus-dan gələn real gərginlik dəyərlərini, həm də yüksək tutumlu müəllim şəbəkəsinin daha hamar və davamlı gərginlik trayektoriyalarını öyrənir. Müəlliflər irəli sürürlər ki, bu yumşaq hədəflər kiçik şəbəkənin daxili təmsil məkanını daha hamar edərək ardıcıl xəta böyüməsinə qarşı bir növ topoloji tənzimləmə yaradır.
Müəllim model
Seçilmiş müəllim:
- Vəziyyət ölçüsü: u = 10
- Gizli qat genişliyi: w = 100
- Qeyri-xətti qat sayı: d = 3
- Parametr: 45.670
- Offline test loss: 9,16 × 10⁻⁵
- Online RMSE: 1,79
Bu şəbəkə yüksək ifadə gücünə və sabitliyə malikdir; lakin komponent miqyasında forward pass xərci yüksəkdir.
Ultra-yüngül tələbə
LMSC_u6_w25:
- u = 6
- w = 25
- 3.542 parametr
- Müəllimlə müqayisədə təxminən 12,89× daha kiçik
KD-dən sonra optimal distillə çəkisi təxminən α = 0,6 kimi bildirilmişdir.
w=50 tələbə
LMSC_u6_w50 distillə edilməzdən əvvəl ciddi onlayn sapma göstərmişdir. Tədqiqatda optimal KD çəkisi təxminən α = 0,9 seçilmişdir.
| Model | Test loss | Online RMSE |
|---|---|---|
| LMSC_u10_w100 müəllim | 9,16×10⁻⁵ | 1,79 |
| LMSC_u6_w25 | 9,90×10⁻⁵ | 5,10 |
| LMSC-KD_u6_w25_α0.6 | 1,04×10⁻⁴ | 3,94 |
| LMSC_u6_w50 | 6,17×10⁻³ | 111,01 |
| LMSC-KD_u6_w50_α0.9 | 2,8×10⁻⁵ | 2,70 |
Bilik distilləsi itkisi
Tələbə təlimindəki itki real Abaqus etiketləri ilə müəllim şəbəkəsinin yumşaq hədəflərini birlikdə ehtiva edir:
\[ L_{\mathrm{student}} = \alpha \frac{1}{N} \sum \left\| \hat{y}_{student}-y_{true} \right\|^2 + (1-\alpha) \frac{1}{N} \sum \left\| \hat{y}_{student}-\hat{y}_{teacher} \right\|^2 \]
Birinci termin real fiziki etiketlərə uyğunluğu, ikinci termin isə müəllimin daha hamar konstitutiv trayektoriyasına uyğunluğu təmsil edir.
Loss landscape nə göstərir?
Mənbənin Şəkil 15-i və PDF-in 56-cı səhifəsindəki qrafiklər model çəkilərinin kiçik perturbasiyaları altında loss səthini göstərir.
Müəllim şəbəkəsində minimum ətrafındakı səth geniş və nisbətən simmetrikdir. Distillə edilməmiş kompakt modellərdə isə daha kəskin, dar və asimmetrik sahələr müşahidə olunur. KD-dən sonra tələbə şəbəkələrinin minimum ətrafındakı səth yenidən daha nizamlı hala gəlir.
Müəlliflər bu geniş və hamar minimum quruluşunu fasiləsiz inteqrasiya zamanı yaranan kiçik daxili-vəziyyət perturbasiyalarına qarşı daha yüksək davamlılıqla əlaqələndirirlər.
Neyron aktivasiyaları nə göstərir?
Mənbənin 57-ci səhifəsindəki violin qrafikləri tanh aktivasiyalarının paylanmasını müqayisə edir.
Müəllim model təxminən:
−0,709 ilə +0,573
aralığında işləyir.
Distillə edilməmiş u6_w50 şəbəkəsi isə minimumda təxminən:
−0,867
dəyərinə yaxınlaşır. Tanh törəməsi:
\[ \frac{d}{dx}\tanh(x)=1-y^2 \]
olduğuna görə müəlliflərin hesabına əsasən bu sahədə qalan lokal gradient təxminən %24,8-ə düşür.
KD-dən sonra minimum aktivasiya təxminən −0,521-ə çəkilir və ən zəif nöqtədə gradient axını təxminən %72,8-ə yüksəlir.
Bunun əksinə, u6_w25 şəbəkəsinin problemi doyma deyil, aktivasiyaların təxminən −0,298 ilə +0,289 arasında həddindən artıq sıxışmasıdır. Mənbə bunu “topological stiffness” adlandırır. KD-dən sonra aktivasiya aralığı genişlənir və şəbəkənin qeyri-xətti təmsil qabiliyyəti artır.
Native Fortran İnteqrasiyası Niyə Bu Qədər Vacibdir?
Maşın öyrənməsi modelinin sürətli olması, onu sonlu element proqram təminatına bağlayan qat yavaşdırsa kifayət deyil. Buna görə tədqiqatda LMSC forward pass-inin hamısı VUMAT daxilində native Fortran ilə yenidən həyata keçirilmişdir.
Xarici ML icra mühiti yoxdur
İş zamanı PyTorch və ya TensorFlow çağırışı edilmir. Şəbəkə çəkiləri simulyasiyanın başlanğıcında yalnız bir dəfə oxunur və daha sonra RAM-dakı read-only Fortran MODULE strukturunda saxlanılır.
BLAS və VML
Sıx matris əməliyyatları BLAS, tanh və exp kimi funksiyalar isə Intel MKL Vector Mathematical Library istifadə edilərək vektorlaşdırılmışdır.
Yaddaş düzülüşü
Çəki matrisləri Fortran-ın column-major yaddaş quruluşuna uyğun olaraq əvvəlcədən transpozisiya edilir. Məqsəd stride-1 girişini təmin etməklə CPU cache istifadəsini və SIMD performansını artırmaqdır.
Batch processing
İnteqrasiya nöqtələri tək-tək emal edilmək əvəzinə paketlənir. Mənbə nümunə olaraq:
BATCH_SIZE = 128
dəyərini verir.
Beləliklə kiçik fərdi şəbəkə çağırışları əvəzinə sıx və vektorlaşdırıla bilən matris əməliyyatları icra olunur.
Tədqiqatın Metodu və Nəticələri
Təlim verilənlərinin yaradılması
Verilənlərin yaradılmasında 8 düyünlü reduced-integration C3D8R tək elementdən istifadə edilmişdir.
Training set:
- 10.000 müstəqil deformasiya yolu
Validation set:
- 1.000 müstəqil deformasiya yolu
Hər yol 125 piecewise-linear segmentdən yaradılmışdır. Hər segment 16 mikro addıma bölünərək:
125 × 16 = 2.000 mikro deformasiya artımı
əldə edilmişdir.
Təsadüfi yollar elastik-plastik sərhədin, boşalmanın və istiqamət dəyişmələrinin tez-tez müşahidə olunmasını təmin edəcək şəkildə yaradılmışdır.
Referans material modeli
Referans model klassik von Mises axma şərti ilə Swift izotropik sərtləşməsini birləşdirir.
Von Mises ekvivalent gərginliyi:
\[ \bar{\sigma} = \sqrt{\frac{3}{2}\mathbf{s}:\mathbf{s}} \]
Axma şərti:
\[ f= \bar{\sigma} - \sigma_y(\bar{\varepsilon}^{p}) \leq 0 \]
Swift sərtləşməsi:
\[ \sigma_y = K \left( \varepsilon_0+\bar{\varepsilon}^{p} \right)^n \]
| E | ν | K | ε₀ | n |
|---|---|---|---|---|
| 70.000 MPa | 0,32 | 650 MPa | 0,0001 | 0,07 |
LMSC-nin əsas xüsusiyyəti
LMSC deformasiya artımının böyüklüyünü və istiqamətini bir-birindən ayırır. Beləliklə dəyişkən FE zaman/addım ölçüsünün RNN daxili vəziyyətinə süni asılılıq yaratması azaldılmağa çalışılır.
Daxili vəziyyət yenilənməsi mənbədə analitik formada həyata keçirilir və Forward Euler kimi diskret ədədi inteqrasiya əvəzinə qapalı-form yeniləmədən istifadə edilməsi LMSC-nin self-consistency xüsusiyyətinin əsasını təşkil edir.
Tək elementli çevrimsel test
Teacher model referans gərginlik–deformasiya çevrimlərini demək olar ki, üst-üstə düşəcək şəkildə izləmişdir.
u6_w25 şəbəkəsində distillədən əvvəl, xüsusilə elastik-plastik künclərdə kiçik sapmalar müşahidə olunur.
u6_w50 şəbəkəsində isə davamlı çevrim altında amplituda sürüşməsi getdikcə böyüyərək makroskopik sapmaya çevrilir.
KD-dən sonra hər iki şəbəkənin gərginlik çevrimləri referans əyriyə yenidən yaxınlaşmışdır. PDF-in 42–44-cü səhifələrindəki qrafiklər bu fərqi açıq şəkildə göstərir.
Çentikli dartılma
| Model | Maksimum Mises | Referansa fərq |
|---|---|---|
| Abaqus referans | 557,2 MPa | — |
| Teacher | 560,5 MPa | +3,3 MPa |
| u6_w25 | 565,7 MPa | +8,5 MPa |
| KD u6_w25 | 558,0 MPa | +0,8 MPa |
| u6_w50 | 644,3 MPa | +87,1 MPa |
| KD u6_w50 | 556,7 MPa | −0,5 MPa |
Kəsilmə testi
| Model | Maksimum Mises |
|---|---|
| Referans | 609,5 MPa |
| Teacher | 607,2 MPa |
| u6_w25 | 611,3 MPa |
| KD u6_w25 | 607,9 MPa |
| u6_w50 | 646,5 MPa |
| KD u6_w50 | 608,5 MPa |
Üçnöqtəli əyilmə
| Model | Maksimum Mises |
|---|---|
| Referans | 598,8 MPa |
| Teacher | 597,3 MPa |
| u6_w25 | 595,4 MPa |
| u6_w50 | 648,0 MPa |
| KD u6_w50 | 597,6 MPa |
Mənbənin 45–47-ci səhifələrindəki Mises konturları yalnız maksimum dəyəri deyil, KD-dən sonra yüksək-gərginlik zolaqlarının məkan sərhədlərinin də referans həllə yaxınlaşdığını göstərir.
Yük–yerdəyişmə davranışı
Referans modellərin təxmini pik yükləri:
- Çentikli dartılma: 2,67 kN.
- Kəsilmə: 1,00 kN.
- Üçnöqtəli əyilmə: 30,72 kN.
Distillə edilməmiş u6_w50 şəbəkəsi təxminən:
- 3,37 kN,
- 1,09 kN,
- 37,17 kN
piklərinə yüksələrək hər üç testdə həddindən artıq proqnoz göstərir.
KD-dən sonra tələbə modellərinin yük–yerdəyişmə əyriləri referans və müəllim əyriləri ilə böyük ölçüdə üst-üstə düşür. Bu davranış PDF-in 48–50-ci səhifələrindəki üç qrafikdə görünə bilər.
Hesablama müddəti
Çentikli dartılma analizində təxminən 1.000.000 iterasiya üçün optimallaşdırılmış u6_w25 modelinin mənbədə verilən müddətləri:
| CPU | Abaqus Ref | Optimize LMSC |
|---|---|---|
| 1 | 7.909 s | 6.528 s |
| 2 | 7.485 s | 5.689 s |
| 4 | 5.717 s | 5.488 s |
| 8 | 5.710 s | 5.421 s |
| 16 | 5.674 s | 5.379 s |
Bu yüksək-iterasiya ssenarisində LMSC bütün CPU konfiqurasiyalarında referansdan sürətlidir.
Təxminən 100.000 iterasiyada isə başlanğıc və VUMAT çağırış xərcləri daha böyük pay təşkil etdiyindən üstünlük aradan qalxa bilər.
Şəbəkə ölçüsünün zaman xərci
16 CPU və təxminən 1.000.000 iterasiyalı üçnöqtəli əyilmə testində mənbə təxminən:
- Ref: 3.347 s
- u6_w25-opt: 6.796 s
- u10_w100-opt: 15.417 s
bildirir.
Bu nümunə mühüm bir həddi göstərir: daha böyük və daha dəqiq şəbəkənin konstitutiv dəqiqliyi yüksək ola bilər, lakin real FE simulyasiyası baxımından böyük sürət cəzası yarada bilər.
Amdahl qanunu və azalan gəlir
Çentikli dartılmada 16 CPU-da:
- Teacher: 5.971 s
- Ultra-yüngül student: 5.379 s
olmasına baxmayaraq şəbəkə parametrləri 12,89 dəfə fərqlənir.
Bunun səbəbi ümumi FE vaxtının yalnız konstitutiv modeldən ibarət olmamasıdır. Paralel kommunikasiya, təmas, kinematik yenilənmə və history-variable əməliyyatları model kiçildikcə ümumi müddətdə daha üstün mövqe tutur.
Tədqiqatın birbaşa dəstəklədiyi nəticələr
- Native Fortran inteqrasiyası əvvəlki LMSC embedding üsulları ilə müqayisədə böyük I/O və cross-language xərclərini aradan qaldırmışdır.
- Bilik distilləsi kiçik LMSC şəbəkələrinin onlayn açıq-FE sabitliyini ciddi şəkildə artırmışdır.
- Çevrimdışı aşağı loss dəyəri onlayn sabitliyin yetərli göstəricisi deyil.
- KD-dən sonra u6_w50 şəbəkəsinin onlayn RMSE-si 111,01-dən 2,70-a düşmüşdür.
- 3.542 parametrli tələbə 45.670 parametrli müəllimlə müqayisədə təxminən 12,89× daha kiçikdir.
- KD-li modellər dartılma, kəsilmə və üçnöqtəli əyilmə gərginlik sahələrində referansa yaxın nəticə vermişdir.
- Yüksək iterasiyalı bəzi ssenarilərdə optimallaşdırılmış ultra-yüngül model Abaqus-un daxili Mises modelindən daha qısa wall-clock müddəti yaratmışdır.
- Loss landscape və aktivasiya paylanmaları KD-dən sonra daxili təmsil həndəsəsinin dəyişdiyini göstərir.
Tədqiqatın birbaşa dəstəkləmədiyi nəticələr
- Hər sinir şəbəkəsi konstitutiv modelinin bilik distilləsi ilə sabitləşəcəyi sübut edilməmişdir.
- KD bütün açıq sonlu element analizləri üçün riyazi sabitlik zəmanəti vermir.
- Parametr sayının 12,89 dəfə azalması FE həllinin 12,89 dəfə sürətlənməsi demək deyil.
- LMSC bütün iterasiya saylarında və bütün komponentlərdə Abaqus-un daxili modelindən sürətli deyil.
- Tədqiqat real fiziki dartılma/kəsilmə/əyilmə təcrübələrini doğrulama ground truth-u kimi istifadə etmir; əsas referans Abaqus-un klassik Mises modelidir.
- Anizotropik plastik davranış, sürətdən asılılıq, zədələnmə və ya qırılma bu tədqiqatda doğrulanmamışdır.
- “Topoloji tənzimləyici” mexanizmi loss-landscape və aktivasiya analizləri ilə dəstəklənən müəllif şərhidir; ümumi riyazi teorem deyil.
Mənbə və Metod Qeydi
Orijinal başlıq:Breaking the Expressivity-Stability-Speed Trilemma in Explicit FE Integration via Distilled Linearized Minimal State Cells
Müəlliflər: Xudong Yang; Yanfeng Yang; Heng Li.
Qurumlar: State Key Laboratory of Solidification Processing, School of Materials Science and Engineering, Northwestern Polytechnical University; Research & Development Institute of Northwestern Polytechnical University in Shenzhen.
Mənbə növü: Hesablama mexanikası / maşın öyrənməsi dəstəkli konstitutiv modelləşdirmə preprinti.
Platforma: SSRN.
SSRN qeyd nömrəsi: 7381099.
Rəyçilik statusu: Yüklənmiş iş hər səhifədə peer review-dan keçmədiyini bildirir.
Referans konstitutiv model: von Mises (J2) axma meyarı + Swift izotropik sərtləşməsi.
Referans sonlu element proqram təminatı: Abaqus/Standard verilənlərin yaradılması və Abaqus/Explicit VUMAT inteqrasiyası.
Əsas sinir şəbəkəsi: Linearized Minimal State Cells (LMSC).
Əsas sıxma/tənzimləmə üsulu: Knowledge Distillation.
Müəllim: u=10, d=3, w=100; 45.670 parametr.
Ultra-yüngül tələbə: u=6, w=25; 3.542 parametr; təxminən 12,89× parametr sıxılması.
Verilənlər dəsti: 10.000 training və 1.000 validation deformasiya yolu; hər yol üzrə 125 segment və 2.000 mikro artım.
Struktur yoxlamaları: Çentikli dartılma, lokal kəsilmə və üçnöqtəli əyilmə.
Proqram təminatı optimallaşdırmaları: Library-free native Fortran, bir dəfəlik parametr yükləmə, global read-only weights, BLAS, Intel MKL VML, yaddaş transpozisiyası, stride-1 giriş, batch processing və SIMD.
Verilənlərə çıxış: Müəlliflər bu tədqiqatda hesablanan və ya analiz edilən bütün verilənlərin məqalə daxilində olduğunu bildirirlər.
Maliyyələşmə: National Natural Science Foundation of China və müxtəlif Shenzhen, Shaanxi və mərkəzi universitet tədqiqat proqramları tərəfindən dəstəklənmişdir.
Maraqlar toqquşması: Müəlliflər rəqabət aparan maraqların olmadığını bəyan edirlər.
AI istifadəsi bəyanatı: Müəlliflər Gemini 3 Pro-dan qrammatika və dil axıcılığını yaxşılaşdırmaq məqsədilə istifadə etdiklərini; texniki məzmunu özlərinin yoxlayıb redaktə etdiklərini və nəticələrə görə məsuliyyəti öz üzərlərinə götürdüklərini bildirirlər.
Əsas elmi hədd: Tədqiqat fiziki ground truth kimi eksperimental metal nümunələrindən ölçülmüş gərginlik tarixçəsini deyil, Abaqus daxilindəki von Mises–Swift modelini istifadə edir. Buna görə göstərilən uğur əsasən klassik ədədi konstitutiv modelin aşağı xərcli əvəzedici modellə yenidən yaradılmasıdır.
Ümumiləşdirmə həddi: Anizotropik axma, viskoplastiklik və continuum damage mechanics yalnız gələcək tədqiqat sahələri kimi qeyd olunur.
Sabitlik həddi: Tədqiqatın “catastrophic autoregressive divergence eliminated” nəticəsi araşdırılan modellər və yük yolları üçün eksperimental hesablama nəticəsidir; bütün açıq FE problemləri üçün formal sabitlik zəmanəti deyil.
Sürət həddi: Sürət üstünlüyü iterasiya sayı, şəbəkə ölçüsü, CPU sayı və problem növündən asılıdır. Aşağı iterasiyalı analizlərdə native Abaqus modeli daha sürətli ola bilər.
Amdahl həddi: Şəbəkə kiçildikcə konstitutiv inference ümumi hesablama müddətinin daha kiçik hissəsini təşkil edir; buna görə parametr sıxılmasının wall-clock qazancı xətti deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib