

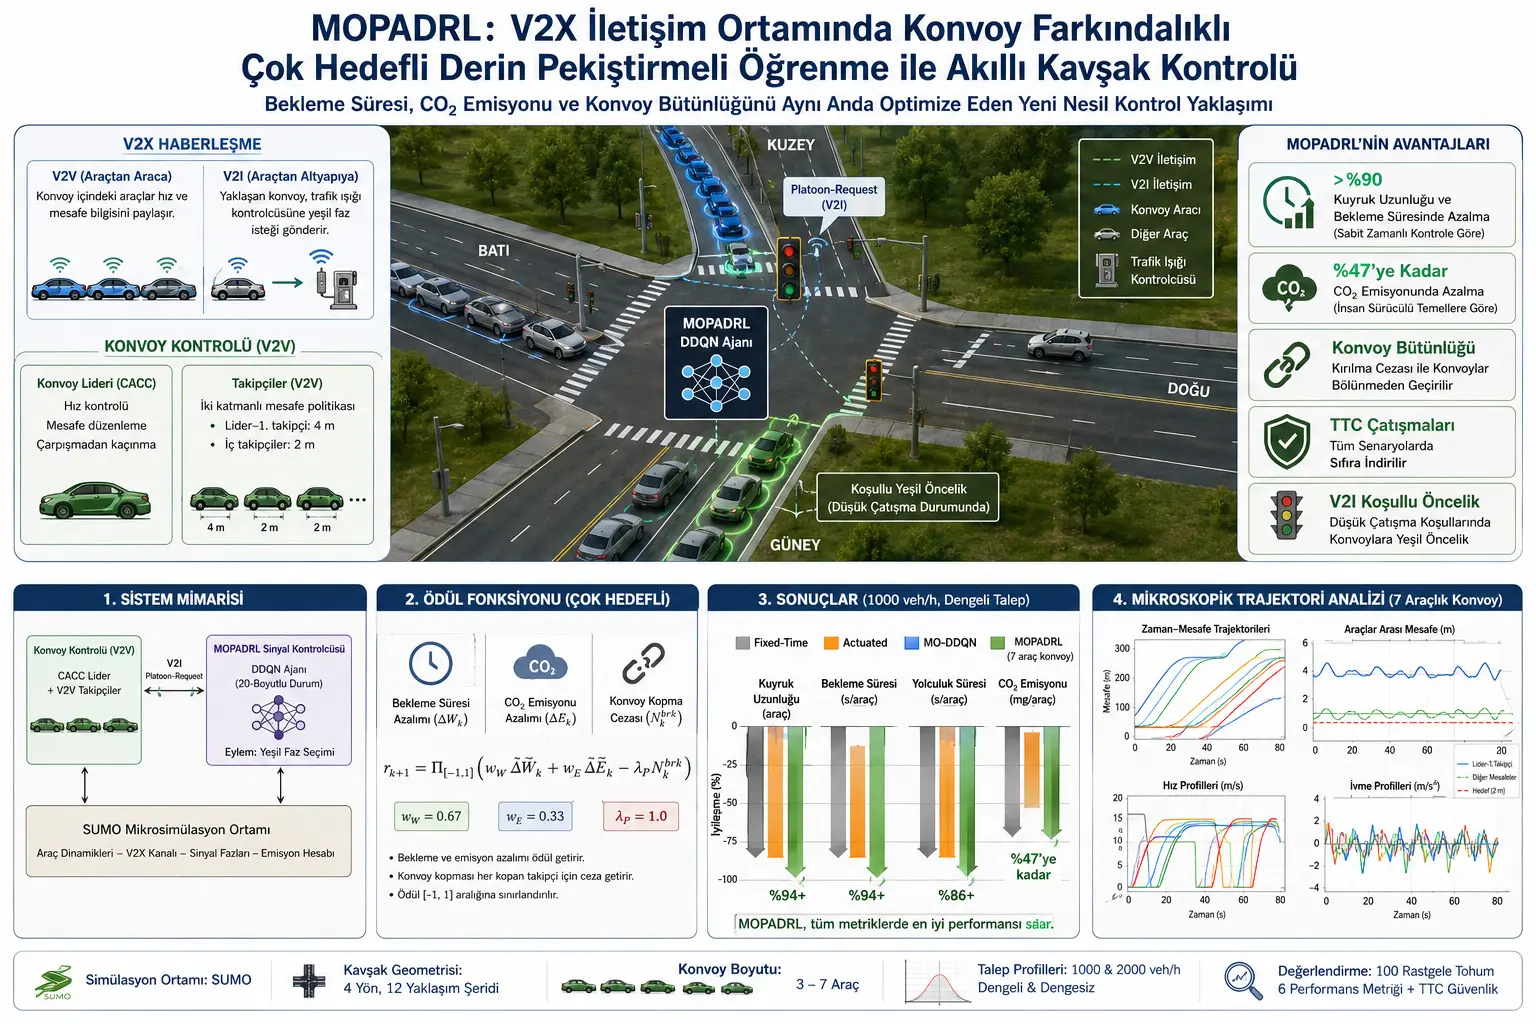
Şehir içi sinyalize kavşaklar, trafik sisteminin en kritik boğum noktalarından biridir. Araçlar farklı yönlerden kavşağa gelir, sola döner, düz gider, sağa döner ve bütün bu hareketler trafik ışıklarıyla düzenlenir. Geleneksel sinyal kontrol sistemleri çakışan hareketleri ayırarak güvenliği sağlamaya çalışır; fakat artan araç sayısı, değişken talep, yoğun saatlerde oluşan kuyruklar, bekleme süresi, yakıt tüketimi, CO2 emisyonu ve kaza riski bu sistemleri giderek zorlamaktadır.
Çalışma, bu problemi üç yönüyle ele almaktadır. Birincisi, sıkışıklık sorunudur. Araçlar kırmızı ışıkta bekledikçe kuyruk oluşur, kavşak kapasitesi düşer ve yolculuk süresi artar. İkincisi, çevresel etkidir. Dur-kalk hareketleri ve gereksiz bekleme, araç başına emisyonu yükseltir. Üçüncüsü, güvenliktir. Özellikle kavşağa yaklaşırken ani durma, yakın takip ve insan sürücü hataları zaman-kazaya-kadar süreyi azaltarak çatışma riskini artırabilir.
Bu çalışmanın yenilikçi tarafı, sinyal kontrolünü yalnızca tek tek araçlara göre değil, araç konvoyları yani platoon yapıları üzerinden düşünmesidir. Otomatik ve bağlantılı araçlar, V2V iletişimle birbirine çok daha düzenli mesafelerde ilerleyebilir. Ancak trafik ışığı bu konvoyu ortadan bölerse, öndeki araçlar geçerken arkadakiler kırmızıda kalabilir. Bu durum yalnızca konvoy bütünlüğünü bozmaz; arkada bekleme, yeniden hızlanma, ilave emisyon ve yeni kuyruk oluşumu da yaratır. Bu nedenle araştırma şu soruya cevap arar: Trafik ışığı kontrolcüsü, hem bekleme süresini hem CO2 emisyonunu hem de otomatik araç konvoylarının kopmasını aynı anda azaltabilir mi?
Bu problem neden önemli?
Akıllı ulaşım sistemlerinde en büyük zorluklardan biri, farklı hedeflerin birbirine bağlı olmasıdır. Bir trafik kontrolcüsü yalnızca bekleme süresini azaltmaya çalışırsa, bazı yönlere daha uzun yeşil vererek kısa vadede iyi sonuç alabilir. Fakat bu yaklaşım, başka yönden gelen araç konvoylarını bölebilir, emisyonu artırabilir veya güvenlik açısından olumsuz dur-kalk dalgaları üretebilir. Yalnızca emisyonu azaltmak da yeterli değildir; çünkü kavşakta uzun kuyruklar oluşursa sistem pratikte başarısız olur. Yalnızca konvoyu korumak da yeterli değildir; çünkü diğer yönlerde haksız bekleme ve sıkışıklık yaratılabilir.
Bu nedenle çalışma, kavşak kontrolünü çok hedefli bir problem olarak kurmaktadır. MOPADRL modeli üç hedefi aynı anda dikkate alır:
- Trafik verimliliği: Bekleme süresi ve kuyrukların azaltılması,
- Çevresel etki: CO2 emisyonunun düşürülmesi,
- Konvoy bütünlüğü: Kırmızı ışık nedeniyle konvoyun bölünmesinin cezalandırılması.
Bu yaklaşım, gelecekte bağlantılı ve otomatik araçların yaygınlaşacağı şehirlerde kavşakların yalnızca sabit ışık planlarıyla yönetilemeyeceğini gösterir. Kavşak, gelen araçların yalnızca sayısını değil, yapılarını, haberleşme durumunu, konvoy ilişkilerini ve yaklaşma mesafelerini de anlamalıdır.
Literatürdeki boşluk nedir?
Çalışmada önceki araştırmaların önemli bir eksikliği açık biçimde ortaya konmaktadır. Derin pekiştirmeli öğrenme tabanlı trafik ışığı kontrolü üzerine çok sayıda çalışma vardır. Otomatik araç konvoyları üzerine de geniş bir literatür bulunmaktadır. Ancak bu iki alanı birlikte ele alan çalışmalar sınırlıdır.
Mevcut bazı çalışmalar, trafik ışığı kontrolünde tek hedefli optimizasyon kullanmaktadır; örneğin yalnızca gecikmeyi veya yalnızca bekleme süresini azaltmaya odaklanmaktadır. Bazı çalışmalar konvoyları dikkate alsa bile, konvoy davranışını mikroskobik V2V/V2I iletişimle ayrıntılı modellemek yerine hazır simülasyon eklentilerine veya daha makroskobik kabullere dayanmaktadır. Ayrıca konvoy boyutunun kavşak başarımı üzerindeki sistematik etkisi çoğu çalışmada ayrıntılı incelenmemiştir.
Bu çalışma, bu boşluğu üç ana katkıyla doldurmaya çalışır:
- Konvoy farkındalıklı, çok hedefli bir DDQN sinyal kontrolcüsü geliştirir.
- V2V haberleşmeye dayalı mikroskobik bir konvoy takip modeli kurar ve bunu zaman alanında güvenlik ve string stability açısından doğrular.
- Konvoy boyutunu 3 ile 7 araç arasında değiştirerek en uygun platoon büyüklüğünü dengeli ve dengesiz talep senaryolarında araştırır.
MOPADRL mimarisi nasıl çalışır?
Çalışmanın sistem mimarisi üç katmandan oluşur. İlk katman, konvoy kontrolüdür. Burada konvoy lideri CACC yani Cooperative Adaptive Cruise Control modeliyle hareket eder. Konvoy takipçileri ise araştırmacıların önerdiği V2V tabanlı takipçi kontrol yasasıyla liderden gelen hız, ivme ve konvoy durumu bilgisini kullanır.
İkinci katman, MOPADRL sinyal kontrolcüsüdür. Bu kontrolcü bir Double Deep Q-Network yani DDQN ajanıdır. Ajan, kavşaktaki trafik durumunu, aktif sinyal fazını ve yaklaşan konvoy bilgisini gözlemleyerek hangi yeşil fazın verileceğine karar verir.
Üçüncü katman, SUMO mikroskobik trafik simülasyon ortamıdır. Araç hareketleri, sinyal fazları, V2X haberleşme kanalı, emisyon hesapları ve değerlendirme metrikleri bu ortamda çalıştırılmıştır. Çalışmadaki sistem diyagramı, konvoy kontrolü ile sinyal kontrolcüsünün birbirinden ayrı değil, aynı simülasyon döngüsü içinde haberleşen bileşenler olarak çalıştığını göstermektedir.
V2V ve V2I iletişim neden ayrı ayrı önemlidir?
V2V iletişim, konvoy içindeki araçların birbirine göre güvenli ve düzenli hareket etmesini sağlar. Lider aracın hızı, ivmesi ve konvoy durumu takipçilere iletilir. Böylece takipçiler yalnızca önlerindeki aracı görerek değil, konvoy liderinin durumunu da bilerek hareket eder. Bu, özellikle ani durma ve yeniden hızlanma durumlarında konvoyun dalgalanmadan hareket etmesi için önemlidir.
V2I iletişim ise konvoy ile trafik ışığı arasında kurulur. Yaklaşan bir konvoy, kavşak kontrolcüsüne Platoon-Request yani konvoy yeşil isteği gönderebilir. Ancak çalışma bu isteği koşulsuz kabul etmez. Yeşil öncelik yalnızca düşük çatışma koşullarında verilir. Böylece sistem, bir konvoyu geçirmek için diğer yönlerde ciddi kuyruk veya çatışma oluşturma riskini azaltmaya çalışır.
Bu ayrım çok önemlidir. Sadece V2V olursa araçlar kendi aralarında düzenli gider, fakat trafik ışığı onları yine bölebilir. Sadece V2I olursa trafik ışığı konvoya öncelik verebilir, fakat araçların mikroskobik takip davranışı yeterince güvenli ve kararlı olmayabilir. MOPADRL bu iki iletişim biçimini birlikte kullanarak hem konvoy içi hareketi hem kavşak düzeyindeki sinyal kararını koordine eder.
İnsan sürücülü araçlar için kullanılan IDM modeli
Çalışmada insan sürücülü araçlar için Intelligent Driver Model yani IDM kullanılmıştır. IDM, bir aracın ivmesini hem hedef hıza yaklaşmasına hem de önündeki araçla arasındaki mesafeye göre hesaplayan sürekli zamanlı bir takip modelidir. Çalışmada verilen temel IDM ivme formülü şöyledir:
\[ a=a_0\left[1-\left(\frac{v}{v_0}\right)^\delta-\left(\frac{s^*(v,\Delta v)}{s}\right)^2\right] \]
Burada a aracın ivmesini, a0 maksimum ivmeyi, v mevcut hızı, v0 istenen hızı, δ ivme üssünü, s öndeki araçla gerçek mesafeyi ve s*(v, Δv) istenen dinamik takip mesafesini ifade eder.
İstenen dinamik mesafe şu şekilde verilmiştir:
\[ s^*(v,\Delta v)=s_0+\max\left[0, vT+\frac{v\Delta v}{2\sqrt{a_0b}}\right] \]
Burada s0 duruş mesafesini, T istenen zaman aralığını, Δv göreli hızı ve b konforlu yavaşlamayı gösterir. Bu formülün gündelik anlamı şudur: Araç hızlandıkça veya öndeki araca göre kapanma hızı arttıkça güvenli mesafe büyür. İnsan sürücülü senaryolarda araç davranışı bu modelle temsil edilmiştir.
Otomatik araç lideri için CACC modeli
Konvoy liderleri, Cooperative Adaptive Cruise Control yani CACC modeliyle yönetilmiştir. Bu modelde araç, hız kontrolü, mesafe düzenleme, mesafe kapatma ve çarpışmadan kaçınma gibi farklı rejimlerde hareket eder. Hız kontrol rejiminde ivme komutu şu şekilde verilmiştir:
\[ a_{i,k+1}=k_4(v_d-v_{i,k}) \]
Burada a_i,k+1 i aracının bir sonraki zaman adımındaki ivmesini, vd istenen hızı, vi,k mevcut hızı ve k4 kontrol kazancını ifade eder. Araç hedef hızın altındaysa pozitif ivme, üstündeyse negatif ivme üretir.
Mesafe düzenleme rejiminde hız güncellemesi şu şekilde ifade edilmiştir:
\[ v_{i,k+1}=v_{i,k}+k_5e_{i,k}+k_6\dot{e}_{i,k} \]
Burada e_i,k mesafe hatasını, ė_i,k bu hatanın değişim hızını, k5 ve k6 kontrol kazançlarını gösterir. Hata türevi ise şu şekilde tanımlanır:
\[ \dot{e}_{i,k}=v_{i-1,k}-v_{i,k}-t_da_{i,k} \]
Bu ifade, takip eden aracın öndeki araca göre hız farkını ve kendi ivme durumunu dikkate alır. Amaç, araçların bir konvoy halinde güvenli mesafeyi koruyarak hareket etmesidir.
V2V tabanlı takipçi kontrolü ve iki katmanlı mesafe politikası
Çalışmanın özgün katkılarından biri, konvoy takipçileri için önerilen V2V tabanlı kontrol yapısıdır. Bir konvoy şu şekilde tanımlanır:
\[ \mathcal{P}_k=\{v_{k,0},v_{k,1},...,v_{k,N_k}\} \]
Burada v_k,0 konvoy liderini, v_k,i i numaralı takipçiyi, N_k ise konvoydaki takipçi sayısını ifade eder. Takipçi aracın boylamsal durumu şu şekilde verilmiştir:
\[ \mathbf{x}_{k,i}(t)=(p_{k,i}(t),v_{k,i}(t)) \]
Burada p tampon konumunu, v hızı ifade eder. İki araç arasındaki tampon-tampona mesafe ise şöyledir:
\[ g_{k,i}(t)=p_{k,i-1}(t)-p_{k,i}(t)-L_{k,i-1} \]
Burada g_k,i takipçi ile hemen önündeki araç arasındaki mesafeyi, L_k,i-1 ise öndeki aracın uzunluğunu gösterir. Çalışmada araç uzunluğu 5 m olarak alınmıştır.
Lider araç her simülasyon adımında takipçilere şu üçlü bilgiyi yayınlar:
\[ \mathcal{B}(t)=(v_0(t),a_0(t),\sigma_{\mathcal{P}}(t)) \]
Burada v0 lider hızı, a0 lider ivmesi, σP ise konvoy durum bayrağıdır. Bu bayrak konvoyun tamamlanmış, kırmızıda durmuş veya bozulmuş durumda olup olmadığını belirtir.
Çalışmanın önemli mühendislik ayrıntısı, lider ile ilk takipçi arasında bir zaman adımı yani 0,1 saniyelik iletişim gecikmesi kabul edilmesidir. İç takipçiler için bu etkin gecikme sıfır alınmıştır. Bu nedenle mesafe politikası iki katmanlı tasarlanmıştır:
\[ g_i^*= \begin{cases} g_{LF}^*=4.0\,m, & i=1\\ g_{II}^*=2.0\,m, & i\geq 2 \end{cases} \]
Burada gLF* lider ile ilk takipçi arasındaki hedef mesafeyi, gII* iç takipçiler arasındaki hedef mesafeyi ifade eder. İlk takipçi için 4 m, iç takipçiler için 2 m hedeflenmiştir. Bunun nedeni, lider bilgisinin ilk takipçiye 0,1 saniye gecikmeyle ulaşmasıdır. İç takipçiler aynı lider yayınını aynı adımda kullandıkları için daha kısa mesafe yeterli görülmüştür.
4 m / 2 m mesafe tasarımı nasıl gerekçelendirilmiş?
Çalışmada iki katmanlı mesafe politikası yalnızca sezgisel olarak seçilmemiş, analitik olarak türetilmiştir. En kötü durum senaryosunda lider araç 13,89 m/s hızdan acil fren yapar. İlk takipçi liderin komutunu 0,1 saniye geç aldığı için bu süre boyunca eski hızla ilerlemeye devam eder. Bu kapanma mesafesi şu şekilde hesaplanır:
\[ \Delta_{close}=v^\circ\tau=13.89\times0.1=1.389\,m \]
Burada Δclose kapanma mesafesini, v° seyir hızını ve τ iletişim gecikmesini ifade eder. Güvenlik zemini 2 m olarak alınmıştır. Bu durumda lider ile ilk takipçi arasındaki hedef mesafe şu eşitsizliği sağlamalıdır:
\[ g_{LF}^*-\Delta_{close}\geq g_{min} \]
Bu da şu anlama gelir:
\[ g_{LF}^*\geq g_{min}+v^\circ\tau=3.389\,m \]
Çalışmada 4 m seçilerek 0,611 m ek güvenlik payı bırakılmıştır. Bu tasarım, mikroskobik trajektori analizinde doğrulanmıştır. Gözlenen kırmızı faz minimum lider-ilk takipçi mesafesi 2,61 m olmuş, analitik tahmin ise 2,611 m’dir. Bu çok yakın uyum, mesafe tasarımının simülasyonda beklenen şekilde çalıştığını göstermektedir.
Sinyal kontrol problemi nasıl MDP olarak kurulmuş?
Çalışmada trafik ışığı kontrolü Markov Decision Process yani MDP olarak modellenmiştir. Temel yapı şu şekilde ifade edilir:
\[ \mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{T},r,\gamma) \]
Burada S durum uzayını, A eylem uzayını, T geçiş çekirdeğini, r ödül fonksiyonunu ve γ iskonto faktörünü ifade eder. Trafik ışığı kontrolcüsü her karar anında mevcut durumu gözlemler, bir yeşil faz seçer ve bunun sonucunda kuyruk, bekleme, emisyon ve konvoy bütünlüğü açısından ödül alır.
Ajanın amacı beklenen iskonto edilmiş toplam ödülü en yüksek yapan politikayı öğrenmektir:
\[ J(\pi)=\mathbb{E}_{\pi}\left[\sum_{k=0}^{\infty}\gamma^kr_{k+1}\right] \]
Burada π kontrol politikasını, J(π) bu politikanın beklenen toplam başarımını ifade eder. Gündelik bir ifadeyle, ajan yalnızca o anki ışık kararını değil, bu kararın gelecek kuyruklara ve konvoylara etkisini de öğrenmeye çalışır.
DDQN neden kullanılmış?
Çalışmada sinyal kontrol ajanı olarak Double Deep Q-Network yani DDQN kullanılmıştır. DDQN, klasik DQN’in bazı durumlarda eylem değerlerini olduğundan yüksek tahmin etme sorununu azaltmak için eylem seçimi ile eylem değerlendirmesini ayırır. Çalışmada çevrimiçi ağ ve hedef ağ olmak üzere iki sinir ağı kullanılmıştır.
Zaman farkı hedefi şu şekilde verilmiştir:
\[ y_k=r_{k+1}+\gamma(1-d_{k+1})Q_{\theta^-}\left(s_{k+1},\arg\max_{a'}Q_\theta(s_{k+1},a')\right) \]
Burada yk öğrenme hedefini, rk+1 ödülü, γ gelecekteki ödüllerin ağırlığını, d terminal durum bayrağını, Qθ çevrimiçi ağı ve Qθ− hedef ağı ifade eder.
Kayıp fonksiyonu ise Bellman ortalama karesel hatasıdır:
\[ \mathcal{L}(\theta)=\mathbb{E}\left[\left(Q_\theta(s_k,a_k)-y_k\right)^2\right] \]
Bu formülün anlamı şudur: Sinir ağı, seçilen eylemin değerini tahmin eder; sonra bu tahmin, ödül ve gelecekteki beklenen değerle oluşturulan hedefe yaklaştırılır. Trafik ışığı kontrolünde bu, “bu fazı seçmek uzun vadede kuyruk, bekleme, emisyon ve konvoy bütünlüğü açısından iyi mi?” sorusunun öğrenilmesidir.
MOPADRL durum vektörü: Kontrolcü neyi görüyor?
MOPADRL’nin durum vektörü 20 boyutludur ve üç bloktan oluşur:
\[ s_k=[\mathbf{p}_k\|\boldsymbol{\phi}_k\|\boldsymbol{\psi}_k]\in[0,1]^{20} \]
Burada p_k şerit basıncı bloğunu, φ_k aktif faz bilgisini, ψ_k ise konvoy algılama bloğunu ifade eder. Şerit basıncı 12 yaklaşım şeridindeki toplam ve durmuş araç sayılarını içerir. Aktif faz bloğu, mevcut yeşil fazın hangi faz olduğunu gösterir. Konvoy sensör bloğu ise her faz için, o fazın hizmet ettiği şeritlerde dur çizgisine 50 m içinde bir konvoy aracı olup olmadığını belirtir.
Şerit basıncı özelliği şu şekilde tanımlanmıştır:
\[ p_l(k)=\min\left\{1,\frac{2n_l^{stop}(k)+n_l(k)}{100}\right\} \]
Burada nl ilgili şeritteki toplam araç sayısını, nstop_l durmuş araç sayısını ifade eder. Dikkat edilirse durmuş araçlar iki kat ağırlıkla hesaba katılır. Çünkü durmuş araçlar yalnızca mevcut yoğunluğu değil, gecikmenin biriktiğini de gösterir.
Konvoy sensörü şu mantıkla çalışır: Eğer bir aktif konvoyun herhangi bir aracı, belirli bir fazın hizmet ettiği şeritte dur çizgisine 50 m veya daha yakınsa, o faz için konvoy varlığı 1 olarak kodlanır. Bu küçük gibi görünen ek bilgi, ajanı platoon-blind yani konvoy körü olmaktan çıkarır.
Çok hedefli ödül fonksiyonu: Bekleme, emisyon ve konvoy kopması
MOPADRL’nin en önemli bileşenlerinden biri ödül fonksiyonudur. Ödül yalnızca bekleme süresine göre değil, bekleme süresi, CO2 emisyonu ve konvoy kopması birlikte dikkate alınarak hesaplanır.
Önce her karar döneminde bekleme süresi ve emisyon farkları hesaplanır:
\[ \Delta W_k=W(k-1)-W(k) \]
\[ \Delta E_k=E(k-1)-E(k) \]
Burada ΔW bekleme süresindeki iyileşmeyi, ΔE emisyon azalımını ifade eder. Bu değerler pozitifse sistem önceki döneme göre iyileşmiş demektir.
Son ödül fonksiyonu şu şekildedir:
\[ r_{k+1}=\Pi_{[-1,1]}\left(w_W\widetilde{\Delta W}_k+w_E\widetilde{\Delta E}_k-\lambda_PN_k^{brk}\right) \]
Burada wW = 0,67 bekleme süresi ağırlığını, wE = 0,33 emisyon ağırlığını, λP = 1,0 konvoy kopma cezası ağırlığını, Nbrk ise o dönemde konvoyundan kopan takipçi araç sayısını ifade eder. Π[-1,1] işlemi ödülü -1 ile 1 arasına kırpar.
Bu formül çalışmanın ana fikrini çok iyi gösterir. Ajan, bekleme süresini azaltırsa ödül alır. Emisyonu azaltırsa ödül alır. Fakat bir konvoyu kırmızı ışık nedeniyle bölerse ceza alır. Böylece sistem, “kavşağı hızlı boşaltayım ama konvoyları böleyim” gibi kısa vadeli fakat uzun vadede kötü sonuçlar üretebilecek politikalardan uzaklaştırılır.
V2I Platoon-Request mekanizması nasıl sınırlandırılmış?
MOPADRL’de yaklaşan konvoylar trafik ışığına yeşil faz isteği gönderebilir. Ancak bu istek rastgele veya koşulsuz kabul edilmez. Çalışmada üç koşul tanımlanmıştır:
- Konvoy lideri dur çizgisine 10–50 m aralığında yaklaşmış olmalı veya 10 m’den daha yakın olup durmuş olmalıdır.
- Çatışan yönde 150 m içinde başka bir konvoy bulunmamalıdır.
- Konvoyun hizmet edilmeyen çatışan şeritlerinde durmuş araç bulunmamalıdır.
Bu koşulların amacı, yeşil önceliği yalnızca düşük çatışma durumlarında vermektir. Böylece bir konvoyu geçirmek için diğer yönleri haksız ve tehlikeli biçimde bastıran bir kontrol ortaya çıkmaz. Bu tasarım, V2I önceliğinin pratikte uygulanabilir ve dengeli olmasını sağlar.
Deney ortamı: SUMO mikrosimülasyonu
Çalışmada bütün deneyler SUMO yani Simulation of Urban MObility ortamında yapılmıştır. Test ağı, dört yönlü izole bir sinyalize kavşaktır. Her yaklaşımda üç giriş şeridi ve iki çıkış şeridi vardır. Şerit düzeni bir sola dönüş şeridi, bir yalnız düz gidiş şeridi ve bir düz+sağ şeridi şeklindedir. Hız sınırı 50 km/s, yani yaklaşık 13,89 m/s olarak alınmıştır. Takipçi araçlar yalnızca mesafe kapatma gerektiğinde 60 km/s yani yaklaşık 16,67 m/s yakalama hız tavanına izinlidir.
Araç gelişleri 0–3600 saniyelik bölümde Weibull dağılımıyla üretilmiştir. Bu dağılım, yoğun saat trafiğine benzeyen bir geliş profili oluşturur: Başta kademeli artış, ortalarda yoğun tepe, sonda azalma. Çalışmada 1000 araç/saat ve 2000 araç/saat talep düzeyleri, dengeli ve dengesiz yön dağılımları ve 3–7 araç arası konvoy boyutları test edilmiştir.
Değerlendirme 100 eşleştirilmiş rastgele tohum üzerinden yapılmıştır. Bu, tek bir rastgele simülasyon sonucuna dayanmak yerine, değişken trafik gelişlerini daha güvenilir biçimde karşılaştırmak için önemlidir.
Karşılaştırılan kontrolcüler
Çalışma beş sinyal kontrolcüsünü karşılaştırmıştır:
- Fixed-Time: Trafik durumunu dikkate almayan sabit zamanlı ışık planı.
- Actuated: Gelen araçlara göre yeşili uzatabilen klasik duyargalı kontrol.
- MO-DDQN: Çok hedefli fakat konvoy farkındalığı olmayan DDQN tabanlı öğrenen kontrolcü.
- MOPADRL-WV2I: Konvoy farkındalığı ve konvoy kopma cezası olan, fakat V2I yeşil istek mekanizması olmayan model.
- MOPADRL: Konvoy farkındalığı, konvoy kopma cezası ve koşullu V2I Platoon-Request mekanizmasını birlikte kullanan önerilen model.
Bu karşılaştırma düzeni önemlidir; çünkü yalnızca MOPADRL’nin iyi çalışıp çalışmadığını değil, hangi bileşenin ne katkı verdiğini de ayırmaya çalışır. Örneğin MOPADRL-WV2I ile MOPADRL arasındaki fark, V2I öncelik mekanizmasının katkısını gösterir. MO-DDQN ile MOPADRL arasındaki fark ise konvoy farkındalığı, kopma cezası ve V2I yapısının birleşik etkisini gösterir.
Değerlendirme metrikleri
Çalışmada performans altı ana metrikle ölçülmüştür:
- Ortalama kuyruk uzunluğu,
- Ağ içindeki ortalama araç sayısı,
- Araç başına ortalama bekleme süresi,
- Araç başına ortalama yolculuk süresi,
- Araç başına ortalama CO2 emisyonu,
- Kopan konvoy sayısı.
Ayrıca güvenlik için zaman-kazaya-kadar süre yani Time-to-Collision çatışma sayısı kullanılmıştır. Bu metrik, araçların mevcut hızlarıyla devam etmesi halinde çarpışmaya ne kadar süre kaldığını hesaplar. Otomatik araçlar için 0,5 saniye, insan sürücülü araç çiftleri için 1,5 saniye eşik kullanılmıştır.
Faz 1: Konvoy boyutu ve kontrolcü karşılaştırması
İlk değerlendirme aşamasında, 1000 araç/saat talep altında 3, 4, 5, 6 ve 7 araçlık konvoylar denenmiştir. Dengeli talep durumunda MOPADRL, bütün platoon boyutlarında verimlilik metriklerinde en iyi kontrolcü olmuştur. Yedi araçlık konvoyda ortalama kuyruk uzunluğu 0,53 araç, ortalama bekleme süresi 1,95 saniye/araç, ortalama yolculuk süresi 111,51 saniye/araç ve ortalama CO2 emisyonu 117.021 mg/araç olarak raporlanmıştır.
Bu sonuçlar sabit zamanlı kontrolle karşılaştırıldığında kuyruk uzunluğu ve bekleme süresinde yaklaşık yüzde 94 azalma anlamına gelir. Actuated kontrolcüye göre ise azalma yaklaşık yüzde 86’dır. Bu, MOPADRL’nin yalnızca klasik sabit planı değil, trafik talebine tepki verebilen duyargalı kontrolü de ciddi biçimde geçtiğini gösterir.
Dengeli talepte en iyi MOPADRL konfigürasyonu yedi araçlık konvoydur. Ancak dengesiz talepte optimum altı araçlık konvoya kaymıştır. Bu bulgu çok önemlidir: En iyi konvoy boyutu sabit bir değer değildir; talep desenine bağlıdır. Dengesiz talepte kuzey-güney koridoru daha baskın olduğunda, altı araçlık konvoy sınırlı yeşil pencereye daha iyi sığmıştır.
Konvoy bütünlüğü verimliliğe zarar veriyor mu?
Çalışmanın en dikkat çekici bulgularından biri, konvoy bütünlüğü cezasının verimliliğe zarar vermemesidir. İlk bakışta bir modele “konvoyu bölme” cezası eklendiğinde, modelin bekleme süresi veya kuyruk açısından daha kötü kararlar verebileceği düşünülebilir. Çünkü sistem konvoyu korumak için bazı araçları daha fazla bekletebilir.
Ancak sonuçlar bunun tersini göstermiştir. MOPADRL, konvoy farkındalığı olmayan MO-DDQN’e göre her konvoy boyutunda tüm verimlilik metriklerinde daha iyi sonuç vermiştir. Kuyruk uzunluğunda yüzde 10–69, bekleme süresinde yüzde 10–65, yolculuk süresinde yüzde 1,0–4,4, CO2 emisyonunda yüzde 1,3–6,6 arası iyileşme sağlamış; aynı zamanda kopan konvoy sayısını yüzde 30–99 azaltmıştır.
Bunun nedeni yapısaldır. Bir konvoy kırmızı ışıkta bölündüğünde, arkada kalan araçlar bekler, daha sonra yeniden hızlanır, kuyruk üretir ve emisyonu artırır. Dolayısıyla konvoyu korumak, sadece konvoy bütünlüğünü değil, bekleme ve emisyon hedeflerini de destekler. Çalışmanın ifadesiyle bu hedefler birbirine rakip değil, doğru ödül yapısında birbirini tamamlayan hedeflerdir.
V2I önceliğin katkısı nedir?
MOPADRL ile MOPADRL-WV2I karşılaştırması, V2I Platoon-Request mekanizmasının etkisini ayırır. İki model de aynı durum vektörünü ve aynı ödül fonksiyonunu kullanır; fark yalnızca MOPADRL’nin yaklaşan konvoya düşük çatışma koşullarında yeşil öncelik verebilmesidir.
Dengeli talepte V2I öncelik; kuyruk uzunluğunu yüzde 28–53, bekleme süresini yüzde 23–53, yolculuk süresini yüzde 1,9–4,3 ve CO2 emisyonunu yüzde 3,0–5,9 azaltmıştır. Ancak kopan konvoy sayısı üzerindeki ek etkisi daha sınırlıdır; çünkü konvoy kopma cezası zaten birçok durumda kopmaları neredeyse sıfıra indirmiştir. Bu sonuç, V2I mekanizmasının temel katkısının konvoyları “daha hızlı” geçirebilmek olduğunu, konvoy kopmasını önlemede ise ödül fonksiyonundaki cezanın zaten güçlü çalıştığını gösterir.
Faz 2: İnsan sürücülü ortam ile V2X konvoy ortamı karşılaştırması
İkinci değerlendirme aşamasında, insan sürücülü araç ortamı ile tamamen V2X destekli konvoy ortamı karşılaştırılmıştır. İnsan sürücülü temel senaryolarda Actuated ve MO-DDQN kullanılmıştır. V2X ortamında ise önerilen MOPADRL kontrolcüsü ve Faz 1’de bulunan optimum konvoy boyutları kullanılmıştır: dengeli talep için yedi araç, dengesiz talep için altı araç.
Üç talep senaryosu incelenmiştir:
- 1000 araç/saat dengeli talep,
- 2000 araç/saat dengeli talep,
- 2000 araç/saat dengesiz talep.
MOPADRL her üç senaryoda da her metrikte en iyi ortalama değeri üretmiştir. En güçlü insan sürücülü öğrenen temel model olan MO-DDQN’e göre ortalama kuyruk uzunluğunu yüzde 73–75, bekleme süresini yüzde 67–75 azaltmıştır. Actuated kontrolcüye göre ise kuyruk uzunluğu ve bekleme süresi azalmaları daha da büyüktür: yaklaşık yüzde 82–89 ve yüzde 80–87 aralığında.
CO2, yolculuk süresi ve ağ içi araç sayısı gibi akış-mobilite metriklerinde en büyük fark 2000 araç/saat dengeli talepte görülmüştür. Bu önemlidir; çünkü aynı toplam talep dengesiz olduğunda klasik veya öğrenen kontrolcüler baskın koridora daha uzun yeşil vererek bazı verimlilik kazanımları elde edebilir. Dengeli fakat yüksek talep ise daha zor bir işletme noktasıdır; her yön yoğundur ve hangi yöne ne zaman yeşil verileceği daha karmaşık hale gelir. Çalışmanın yorumu, V2X avantajının yalnızca ham talep miktarıyla değil, işletme zorluğuyla ölçeklendiği yönündedir.
Güvenlik sonucu: TTC çatışmaları neden sıfıra indi?
Çalışmanın güvenlik açısından en çarpıcı sonucu, MOPADRL’nin tüm talep senaryolarında zaman-kazaya-kadar süreye dayalı çatışma sayısını sıfıra indirmesidir. İnsan sürücülü temel sistemlerde TTC çatışmaları talep arttıkça belirgin biçimde yükselmiştir. Buna karşılık V2X konvoy ortamında bu çatışmalar hiç kaydedilmemiştir.
Bu sonucun nedeni, V2V tabanlı CACC yapısının konvoy içindeki kapanma hızı dalgalanmalarını azaltmasıdır. Liderin hız ve ivme bilgisi takipçilere iletilir; takipçiler liderin fren veya hızlanma davranışına çok kısa sürede uyum sağlar. İki katmanlı mesafe politikası da özellikle lider ile ilk takipçi arasındaki 0,1 saniyelik gecikmeyi absorbe edecek şekilde tasarlanmıştır. Bu nedenle konvoy içinde arkadan çarpışmaya giden kinematik koşullar oluşmamıştır.
Burada dikkatli olmak gerekir: Çalışma “gerçek dünyada hiçbir kaza olmaz” dememektedir. Sonuçlar simülasyon ortamında, varsayılan güvenilir V2V haberleşme ve belirli trafik senaryoları altında elde edilmiştir. Ancak bu bulgu, güvenilir V2X iletişim ve doğru mesafe kontrolüyle kavşak yaklaşımındaki takip çatışmalarının ciddi biçimde azaltılabileceğini göstermektedir.
Faz 3: Mikroskobik trajektori analizi
Üçüncü değerlendirme aşaması, sistem düzeyindeki iyileşmenin araç düzeyinde gerçekten tutarlı olup olmadığını anlamak için yapılmıştır. Çalışmada yedi araçlık tek bir V2X konvoy, yaklaşma, kırmızıda durma, boşalma ve yeniden hareket etme döngüsü boyunca 0,1 saniyelik adımlarla izlenmiştir.
Zaman-mesafe trajektorileri, konvoy araçlarının kırmızı ışıkta birlikte durduğunu, yeşilde birlikte hareket ettiğini ve konvoyun bölünmeden kavşağı geçtiğini göstermektedir. Aynı çevrimde ikinci bir konvoyun da bir konvoy uzunluğu geride durduğu görülmüştür. Bu, modelin yalnızca tek araç düzeyinde değil, ardışık konvoylar düzeyinde de düzenli davranış üretebildiğini gösterir.
Mesafe analizinde lider-ilk takipçi ortalama mesafesi 3,73 ± 0,48 m, iç takipçiler arası ortalama mesafe 2,002 ± 0,020 m olarak bulunmuştur. En kritik değer kırmızı fazda lider-ilk takipçi minimum mesafesidir: 2,61 m. Analitik hesap 2,611 m öngördüğü için bu sonuç tasarımın mikroskobik düzeyde doğrulandığını göstermektedir.
Hız senkronizasyonunda iç takipçi çiftleri arasındaki hız farkı sayısal hassasiyet düzeyinde sıfırdır. Lider ile ilk takipçi arasında 0,1 saniyelik gecikmeden kaynaklanan en yüksek geçici hız farkı 0,55 m/s olarak raporlanmıştır. String stability oranı 1,00’dır; yani hızlanma-yavaşlama bozulması konvoy boyunca büyümemiştir. Bu, konvoyun yalnızca yakın mesafede değil, kararlı biçimde hareket ettiğini gösterir.
Çalışmanın geçmiş, bugün ve gelecek açısından önemi
Geçmişte trafik ışığı kontrolü büyük ölçüde sabit zamanlı planlara, yerel duyargalı kurallara veya yalnızca araç sayısına dayalı optimizasyona dayanıyordu. Daha sonra pekiştirmeli öğrenme modelleri kavşak kontrolüne uygulanmaya başlandı; fakat birçok model insan sürücülü araç ortamı varsaydı veya otomatik araç konvoylarını kontrol problemine sınırlı biçimde dahil etti.
Bugün açısından bu çalışma, kavşak kontrolünün yeni bir aşamaya geçtiğini gösterir. Artık kavşak yalnızca “hangi yönde daha çok araç var?” sorusunu değil, “hangi yönde yaklaşan otomatik araç konvoyu var, bu konvoy bölünürse bekleme ve emisyon nasıl etkilenir, çatışan yönde kuyruk var mı, yeşil öncelik verilebilir mi?” sorularını birlikte ele alabilir.
Gelecek açısından MOPADRL gibi modeller, bağlantılı ve otomatik araçların yaygınlaşması halinde şehir içi sinyal kontrolünün daha koordineli hale gelmesine katkı sağlayabilir. Özellikle yüksek talep altında, simetrik yüklenen yoğun kavşaklarda V2X koordinasyonunun büyük kazanım sunabileceği çalışmada gösterilmiştir. Ancak gerçek uygulama için karma trafik, farklı otomatik araç penetrasyon oranları, haberleşme gecikmesi, paket kaybı, çoklu kavşak koridorları ve farklı kavşak geometrileri gibi konuların ayrıca incelenmesi gerekir.
Gündelik yaşama etkisi ne olabilir?
Bu çalışma doğrudan gündelik yaşama çevrildiğinde, gelecekte trafik ışıklarının yalnızca saniye sayan pasif sistemler değil, yaklaşan araç gruplarını anlayan ve onlarla haberleşen aktif kontrol sistemleri haline gelebileceğini gösterir. Böyle bir sistemde araçlar konvoy halinde kavşağa yaklaşabilir, trafik ışığı bu konvoyu algılayabilir, uygun koşullarda yeşil öncelik verebilir ve konvoyu bölmeden geçirebilir.
Bu, sürücüler için daha kısa bekleme, şehirler için daha düşük kuyruk, çevre için daha düşük CO2 emisyonu ve güvenlik açısından daha az takip çatışması anlamına gelebilir. Ancak bu faydalar, çalışmanın simülasyon ortamında ve tamamen V2X destekli araç varsayımı altında elde edilmiştir. Gerçek hayatta insan sürücülü araçlar, yayalar, bisikletliler, otobüs durakları, acil durum araçları, haberleşme kesintileri ve sürüş davranışı çeşitliliği gibi çok daha karmaşık etkenler vardır.
Çalışmanın güçlü yönleri
Çalışmanın güçlü yönlerinden biri, konvoy farkındalığını yalnızca kavramsal düzeyde bırakmamasıdır. Konvoy bilgisi durum vektörüne eklenmiş, konvoy kopması ödül fonksiyonunda açıkça cezalandırılmış ve V2I Platoon-Request mekanizmasıyla yaklaşan konvoylara koşullu öncelik verilmiştir.
İkinci güçlü yön, araç takip modelinin mikroskobik düzeyde doğrulanmasıdır. Çalışma yalnızca sistem ortalamalarına bakmamış; tek bir konvoyun araç araç mesafe, hız ve ivme davranışını incelemiştir. Analitik 2,611 m tahmininin simülasyonda 2,61 m olarak doğrulanması, model tasarımının rastgele bir sonuç olmadığını göstermektedir.
Üçüncü güçlü yön, ablation mantığıyla farklı kontrolcüleri karşılaştırmasıdır. Fixed-Time, Actuated, MO-DDQN, MOPADRL-WV2I ve MOPADRL karşılaştırması sayesinde, öğrenme, konvoy farkındalığı, konvoy kopma cezası ve V2I önceliğin katkıları ayrı ayrı yorumlanabilmiştir.
Çalışmanın sınırlılıkları
Çalışma kendi sonunda bazı sınırlılıkları açıkça belirtmektedir. Birincisi, deneyler izole tek bir sinyalize kavşakta yapılmıştır. Gerçek şehir trafiğinde kavşaklar genellikle koridor veya ağ halinde birbirini etkiler. Bir kavşakta verilen karar, sonraki kavşakların kuyruğunu ve yeşil dalga düzenini etkileyebilir.
İkincisi, çalışma homojen V2X penetrasyonu varsaymaktadır. Yani V2X ortamında tüm araçların işbirlikçi konvoylar halinde hareket ettiği kabul edilmiştir. Gerçek dünyada uzun süre insan sürücülü araçlar, bağlantılı araçlar ve tam otomatik araçlar birlikte bulunacaktır. Bu karma trafik ortamı modelin başarısını değiştirebilir.
Üçüncüsü, V2V iletişim kanalı güvenilir varsayılmıştır. Gerçek uygulamada gecikme, paket kaybı, sensör hatası, konumlama hatası veya siber güvenlik sorunları olabilir. Çalışmada lider-ilk takipçi için 0,1 saniyelik gecikme dikkate alınmış olsa da daha değişken ve bozulmalı haberleşme koşulları gelecek çalışmalar için önemlidir.
Dördüncüsü, model tek bir talep dağılımı üzerinde eğitilmiştir. Farklı şehirler, farklı sürüş kültürleri, farklı kavşak geometrileri, yaya geçişleri, otobüs şeritleri, acil durum öncelikleri ve bisiklet trafiği gibi koşullarda modelin yeniden test edilmesi gerekir.
Çalışma ne söylüyor, ne söylemiyor?
Çalışma, MOPADRL’nin SUMO simülasyon ortamında, belirli kavşak geometrisi ve talep senaryoları altında sabit zamanlı, duyargalı ve platoon-kör öğrenen kontrolcülere göre daha iyi performans verdiğini göstermektedir. Ayrıca V2V tabanlı konvoy modelinin, incelenen koşullarda konvoy içi takip çatışmalarını sıfıra indirdiğini ve konvoy stabilitesini koruduğunu ortaya koymaktadır.
Çalışma, bu modelin gerçek şehirlerde doğrudan uygulanmaya hazır olduğunu söylemez. Gerçek saha testi sunmaz. Karma trafik penetrasyon oranlarını ayrıntılı incelemez. Çok kavşaklı ağ kontrolünü çözmez. Haberleşme arızaları veya paket kaybı altında dayanıklılığı ayrıntılı değerlendirmez. Bu nedenle sonuçlar güçlü bir simülasyon kanıtı olarak görülmeli, fakat nihai saha başarısı veya güvenlik garantisi gibi yorumlanmamalıdır.
Çalışmanın Yöntemi ve Bulguları
Yöntem özeti
- Problem tanımı: Sinyalize kavşak kontrolü, V2X destekli otomatik araç konvoylarıyla birlikte ele alınmıştır.
- Araç modeli: İnsan sürücülü araçlar IDM ile, konvoy liderleri CACC ile, konvoy takipçileri ise önerilen V2V tabanlı takipçi kontrol yasasıyla modellenmiştir.
- Konvoy mesafe politikası: Lider-ilk takipçi için 4 m, iç takipçiler için 2 m hedef mesafe belirlenmiş ve bu değerler iletişim gecikmesi üzerinden analitik olarak gerekçelendirilmiştir.
- Sinyal kontrol modeli: Kavşak kontrolü MDP olarak kurulmuş ve DDQN tabanlı MOPADRL ajanı eğitilmiştir.
- Durum vektörü: 12 boyutlu şerit basıncı, 4 boyutlu aktif faz kodlaması ve 4 boyutlu konvoy sensör bloğu ile 20 boyutlu durum vektörü oluşturulmuştur.
- Ödül fonksiyonu: Bekleme süresi azalımı, CO2 emisyon azalımı ve konvoy kopma cezası birleştirilmiştir.
- V2I mekanizması: Yaklaşan konvoylar düşük çatışma koşullarında yeşil faz isteği gönderebilmiştir.
- Simülasyon: SUMO ortamında dört yönlü izole sinyalize kavşak, farklı talep senaryoları ve 3–7 araçlık konvoy boyutlarıyla test edilmiştir.
- Karşılaştırma: Fixed-Time, Actuated, MO-DDQN, MOPADRL-WV2I ve MOPADRL kontrolcüleri 100 eşleştirilmiş rastgele tohumla karşılaştırılmıştır.
Başlıca formüller ve anlamları
| Formül | Ne anlatıyor? |
|---|---|
| [ a=a_0[1-(v/v_0)^\delta-(s^*/s)^2] ] | İnsan sürücülü araçların hız ve takip mesafesine göre ivme davranışını tanımlar. |
| [ \mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{T},r,\gamma) ] | Trafik ışığı kontrol problemini Markov karar süreci olarak kurar. |
| [ s_k=[\mathbf{p}_k\|\boldsymbol{\phi}_k\|\boldsymbol{\psi}_k] ] | MOPADRL’nin gördüğü trafik basıncı, mevcut faz ve konvoy varlığı bilgisini birleştirir. |
| [ r_{k+1}=\Pi_{[-1,1]}(w_W\widetilde{\Delta W}_k+w_E\widetilde{\Delta E}_k-\lambda_PN_k^{brk}) ] | Bekleme süresi, CO2 emisyonu ve konvoy kopmasını aynı ödül yapısında birleştirir. |
| [ \Delta_{close}=v^\circ\tau=13.89\times0.1=1.389\,m ] | Lider-ilk takipçi iletişim gecikmesi nedeniyle oluşabilecek kapanma mesafesini hesaplar. |
| [ g_{LF}^*\geq g_{min}+v^\circ\tau=3.389\,m ] | İlk takipçi için 4 m hedef mesafenin neden güvenlik payı sağladığını gösterir. |
Sayısal bulgular
| Bulgular | Sonuç |
|---|---|
| Dengeli 1000 araç/saat talepte en iyi MOPADRL konvoy boyutu | 7 araç |
| Dengesiz 1000 araç/saat talepte en iyi MOPADRL konvoy boyutu | 6 araç |
| MOPADRL, dengeli talepte 7 araçlık konvoyda ortalama kuyruk uzunluğu | 0,53 araç |
| MOPADRL, dengeli talepte 7 araçlık konvoyda ortalama bekleme süresi | 1,95 s/araç |
| MOPADRL, dengeli talepte 7 araçlık konvoyda ortalama yolculuk süresi | 111,51 s/araç |
| MOPADRL, dengeli talepte 7 araçlık konvoyda CO2 emisyonu | 117.021 mg/araç |
| Sabit zamanlı kontrole göre kuyruk ve bekleme azalması | Yaklaşık %94 |
| Actuated kontrole göre kuyruk ve bekleme azalması | Yaklaşık %86 |
| MO-DDQN’e göre MOPADRL kuyruk iyileşmesi | %10–69 aralığında |
| MO-DDQN’e göre MOPADRL bekleme süresi iyileşmesi | %10–65 aralığında |
| MO-DDQN’e göre kopan konvoy azalması | %30–99 aralığında |
| V2I mekanizmasının kuyruk azaltma katkısı | %28–53 aralığında |
| V2I mekanizmasının bekleme azaltma katkısı | %23–53 aralığında |
| V2X ortamında TTC çatışmaları | Tüm talep senaryolarında 0 |
| Mikroskobik analizde lider-ilk takipçi minimum kırmızı faz mesafesi | 2,61 m; analitik tahmin 2,611 m |
| İç takipçi çiftleri ortalama mesafesi | 2,002 ± 0,020 m |
| String-stability oranı | 1,00 |
Şekil ve grafiklerin anlattığı ana fikirler
Çalışmanın sistem mimarisi diyagramı, MOPADRL’nin yalnızca bir sinyal kontrol algoritması olmadığını göstermektedir. Konvoy kontrolü, V2V takipçi kontrolcüsü, V2I konvoy isteği, DDQN tabanlı sinyal kontrolcüsü ve SUMO mikrosimülasyon ortamı aynı çerçeve içinde bağlanmıştır. Bu yapı, araç düzeyi ile kavşak düzeyinin birlikte kontrol edildiğini gösterir.
Kavşak geometrisi şekli, dört yönlü izole bir sinyalize kavşakta her yaklaşımın üç giriş şeridine sahip olduğunu gösterir. Bu geometri, modelin bir şehir ağından ziyade kontrollü bir tek-kavşak deneyinde test edildiğini anlamak için önemlidir.
Weibull dağılımlı talep grafikleri, araç gelişlerinin tekdüze değil, yoğun saat trafiğine benzer biçimde zaman içinde yükselip azaldığını gösterir. Dengeli talepte yönler daha simetrik yüklenirken, dengesiz talepte belirli koridorlar daha yoğun hale gelir. Bu fark, optimum konvoy boyutunun neden 7’den 6’ya kaydığını açıklamada önemlidir.
MOPADRL’nin diğer kontrolcülere göre yüzde iyileşme grafiklerinde, sabit zamanlı ve Actuated kontrolcülere karşı büyük ve istikrarlı kazanımlar görülür. Öğrenen fakat konvoy farkındalığı zayıf olan MO-DDQN’e karşı fark daha çok kuyruk ve bekleme süresinde belirginleşir. Bu, MOPADRL’nin asıl katkısının konvoyları doğru zamanda geçirmek ve gereksiz dur-kalkları azaltmak olduğunu gösterir.
Per-seed dağılım grafikleri, MOPADRL sonuçlarının yalnızca ortalamada değil, farklı rastgele tohumlarda da daha dar ve düşük performans aralıklarında toplandığını gösterir. TTC grafiğinde MOPADRL’nin sıfır çatışmada kalması, V2V konvoy kontrolünün simülasyon ortamındaki güvenlik etkisini açık biçimde gösterir.
Mikroskobik zaman-mesafe trajektori grafikleri, konvoyun kırmızıda birlikte durduğunu, yeşilde birlikte hareket ettiğini ve bölünmediğini gösterir. Mesafe grafiği, lider-ilk takipçi mesafesinin kırmızı fazda 2,61 m’ye kadar indiğini fakat 2 m güvenlik tabanının üzerinde kaldığını; iç takipçilerin ise 2 m hedef mesafeyi çok kararlı biçimde koruduğunu ortaya koyar. Stop-and-go grafikleri, frenleme ve hızlanma dalgasının konvoy boyunca büyümediğini gösterir.
Teknik sonuç
MOPADRL’nin başarısı tek bir bileşenden değil, dört bileşenin birlikte çalışmasından doğmaktadır: DDQN tabanlı öğrenen sinyal kontrolü, konvoyu görebilen durum vektörü, bekleme-emisyon-konvoy kopmasını birleştiren ödül fonksiyonu ve düşük çatışma koşullu V2I yeşil öncelik mekanizması. Bu yapı, konvoyu korumayı ayrı bir lüks hedef değil, doğrudan trafik verimliliğini ve emisyonu iyileştiren bir kontrol sinyali haline getirmiştir.
Kaynak ve Yöntem Notu
Bu makale, Amir Hossein Karbasi ve Hao Yang tarafından hazırlanan “MOPADRL: Multi-Objective Platoon-Aware Deep Reinforcement Learning Model for Signalized Intersection Control under V2X Communication” başlıklı çalışmaya dayanarak hazırlanmıştır. Çalışmanın yazarları McMaster University, Department of Civil Engineering bağlantılıdır.
Kaynak metin SSRN üzerinde yer alan, Elsevier’e sunulmuş bir preprint araştırma makalesidir. Metinde açıkça “This preprint research paper has not been peer reviewed” ifadesi bulunduğu için çalışma hakem değerlendirmesinden geçmemiştir. Bu nedenle sonuçlar, hakemli literatürde nihai olarak doğrulanmış bulgular gibi değil, teknik olarak ayrıntılı fakat hakemlik süreci tamamlanmamış preprint sonuçları olarak okunmalıdır.
Bu içerik, çalışmanın sunduğu model, formüller, simülasyon düzeni, tablolar, grafikler ve sonuçlar esas alınarak hazırlanmıştır. Çalışmada olmayan saha uygulaması, ticari başarı, gerçek şehir trafiğinde kesin güvenlik garantisi veya düzenleyici uygunluk iddiası eklenmemiştir.
Çalışmanın yöntemi SUMO mikroskobik trafik simülasyonuna, DDQN tabanlı derin pekiştirmeli öğrenmeye, V2V tabanlı CACC konvoy kontrolüne ve koşullu V2I Platoon-Request mekanizmasına dayanmaktadır. Deneyler izole dört yönlü bir sinyalize kavşakta, farklı talep senaryoları ve 3–7 araçlık konvoy boyutlarıyla yürütülmüştür.
Çalışmanın önemli sınırlılıkları vardır. Analiz tek bir izole kavşakla sınırlıdır; çok kavşaklı koridor veya ağ düzeyi koordinasyon incelenmemiştir. V2X penetrasyonu homojen kabul edilmiştir; karma insan sürücülü ve otomatik araç trafiği ayrıntılı analiz edilmemiştir. V2V haberleşmesi güvenilir varsayılmıştır; paket kaybı, değişken gecikme ve haberleşme hataları kapsamlı biçimde test edilmemiştir. Model tek bir talep dağılımı üzerinde eğitilmiştir. Bu nedenle sonuçlar gelecek çalışmalarla, farklı trafik ağları ve gerçekçi karma trafik koşullarıyla desteklenmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir