

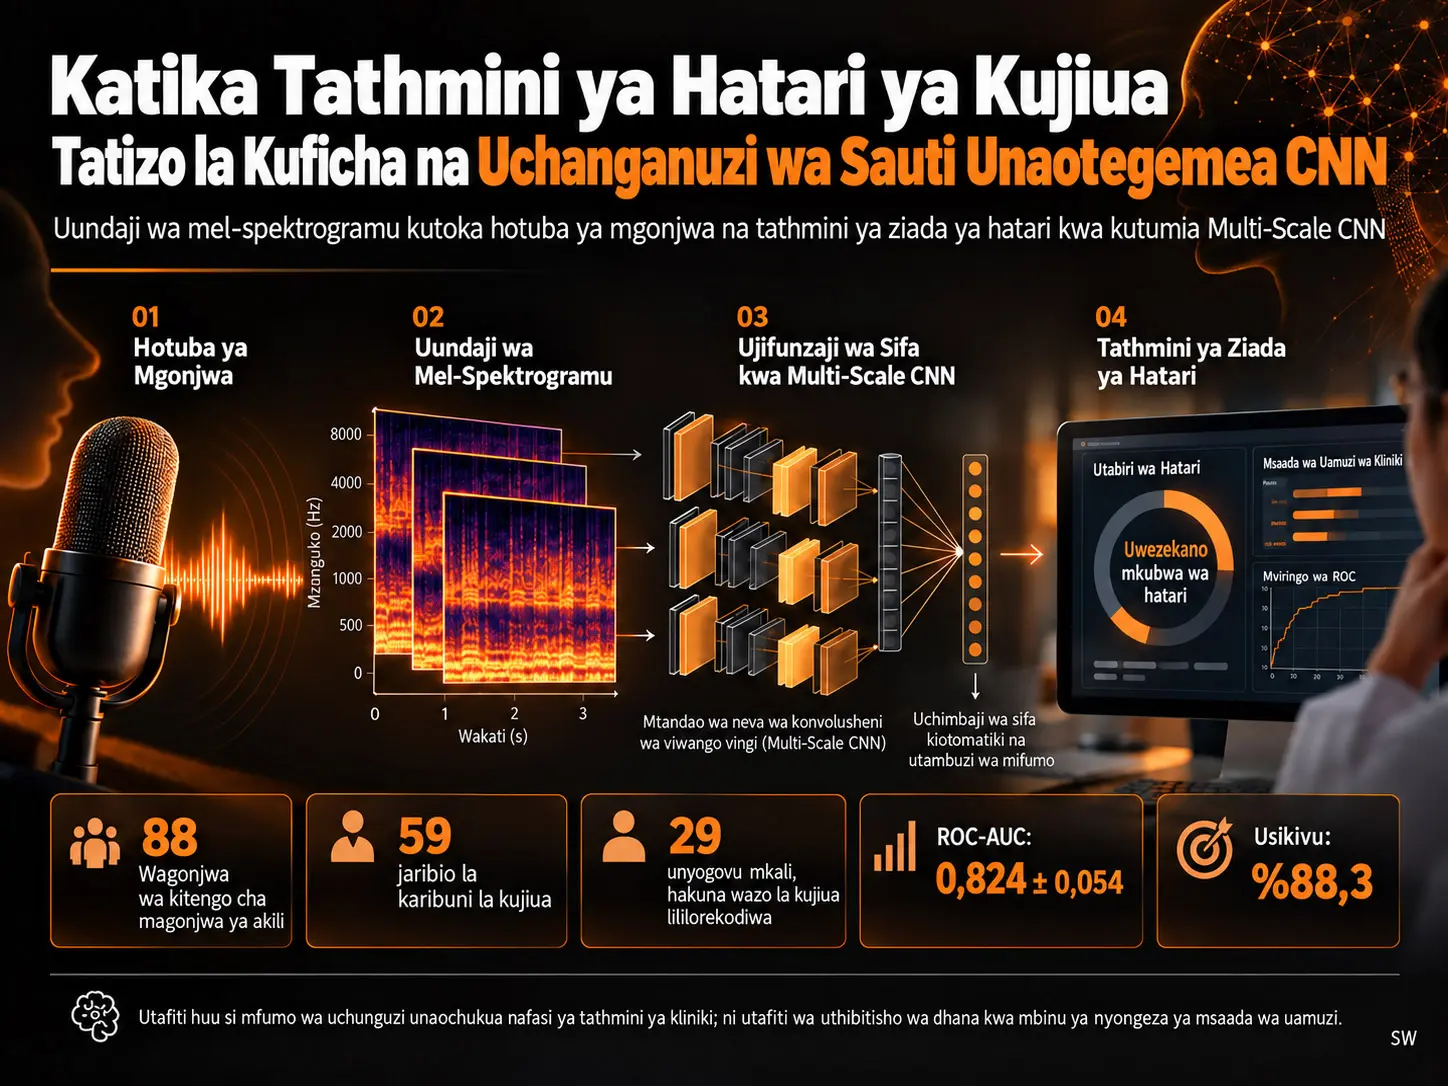
Utafiti huu unachunguza ikiwa mel-spectrogram zinazotokana na hotuba ya wagonjwa iliyorekodiwa katika mahojiano ya kliniki ya magonjwa ya akili zinaweza kuchanganuliwa kwa deep learning ili kutofautisha kwa njia ya akustiki wagonjwa waliokuwa na jaribio la kujiua hivi karibuni na wagonjwa wenye unyogovu mkali lakini bila mawazo ya kujiua yaliyorekodiwa. Multi-Scale Convolutional Neural Network (Multi-Scale CNN) ni classifier ya deep learning ya pande mbili inayounganisha tabaka za convolution sambamba zinazochota mifumo ya muda-marudio katika mizani tofauti na residual connections pamoja na spatial attention mechanism. Utafiti ulitumia rekodi za wagonjwa wazima 88 waliolazwa kutoka hospitali mbili za magonjwa ya akili nchini Romania: wagonjwa 59 walilazwa baada ya jaribio la kujiua la hivi karibuni, huku wagonjwa 29 wakiunda kundi la ulinganisho wa kliniki lenye unyogovu mkali lakini bila mawazo ya kujiua yaliyorekodiwa au tabia ya kujiua ya hivi karibuni. Katika repeated stratified five-fold cross-validation katika kiwango cha mgonjwa, usahihi wa wastani wa modeli ulikuwa %72,67 ± 6,44, thamani ya ROC-AUC ilikuwa 0,824 ± 0,054, unyeti %88,3 ± 9,5 na umaalumu %41,3 ± 25,0. Hata hivyo, ukubwa mdogo wa sampuli, kutokuwepo kwa external validation, kutokuwiana kwa mgawanyo wa kijinsia, ukosefu wa data za dawa na tofauti za mazingira ya mahojiano hupunguza uwezo wa kujumlisha matokeo kliniki.
Motisha ya kliniki ya utafiti inatokana na tatizo la kuficha linaloitwa “dissimulation”: baadhi ya wagonjwa wenye mawazo ya kujiua wanaweza kuyakana au kutoyafichua wakati wa tathmini. Hata hivyo, utafiti huu haukuundwa kuainisha wagonjwa wanaoficha mawazo yao kwa makusudi. Kile ambacho modeli hufanya ni kujaribu kutofautisha mifumo ya sauti katika mazingira ya rekodi ya wagonjwa waliokuwa na jaribio la kujiua hivi karibuni dhidi ya mifumo ya sauti ya kundi la unyogovu mkali. Kwa hiyo, matokeo hayawezi kutafsiriwa kuwa “sauti hugundua nia ya kujiua iliyofichwa”.
Unyeti wa juu wa modeli unaonyesha kwamba iliweka sehemu kubwa ya wagonjwa waliokuwa na jaribio la kujiua hivi karibuni katika darasa husika, huku umaalumu mdogo ukionyesha mzigo mkubwa wa false positives katika kundi la unyogovu. Aidha, katika uchanganuzi uliolinganishwa kwa jinsia, kushuka kwa ROC-AUC hadi 0,621 ± 0,156 kunaonyesha kwamba sehemu ya uwezo wa kutenganisha katika data set kuu huenda iliathiriwa na tofauti za sauti zinazohusiana na jinsia. Kwa hiyo, utafiti huu si mfumo huru wa sauti unaoweka utambuzi wa kliniki, bali unatoa ushahidi wa hatua ya awali kwa mbinu ya ziada ya kusaidia maamuzi inayoweza kuendelezwa baadaye.
Moja ya changamoto kuu katika tathmini ya hatari ya kujiua ni kwamba daktari hupata kiasi kikubwa cha taarifa kutoka katika ripoti ya mgonjwa mwenyewe. Utafiti chanzo, ukitokana na matokeo ya fasihi kwamba baadhi ya watu wenye mawazo ya kujiua huyakana wakati wa tathmini, unapendekeza kuchunguza njia ya taarifa iliyo nje ya maudhui ya kisemantiki. Njia hii inahusu zaidi mifumo inayobebwa na muundo wa akustiki wa hotuba kuliko maneno anayosema mgonjwa.
Swali la utafiti si ikiwa sauti peke yake inaweza “kusoma nia ya kujiua”. Swali finyu zaidi na linaloweza kupimwa ni hili: je, hotuba inayozalishwa wakati wa mahojiano ya kliniki na wagonjwa wenye unyogovu mkali waliokuwa na jaribio la kujiua hivi karibuni na wagonjwa wenye unyogovu mkali lakini bila mawazo ya kujiua yaliyorekodiwa ina mifumo ya akustiki inayoweza kutofautishwa katika kiwango cha mgonjwa kwa machine learning?
Je, uchanganuzi wa sauti hugundua moja kwa moja nia ya kujiua iliyofichwa?
Hapana. Utafiti huu haukufanya jaribio la kutambua watu wanaoficha kwa makusudi mawazo ya kujiua; ulijaribu uwezo wa kutenganisha kwa njia ya akustiki kati ya rekodi za sauti za wagonjwa waliokuwa na jaribio la kujiua hivi karibuni na rekodi za kundi la unyogovu mkali. Kwa hiyo, thamani za utendaji zilizopatikana si ushahidi kwamba nia ya kujiua iliyofichwa inaweza kutambuliwa kwa kutegemewa kupitia sauti katika mazingira ya kliniki.
Tofauti hii ni ya msingi katika kutafsiri kwa usahihi kichwa cha utafiti. Watafiti wanadai kwamba ili mfumo wa tathmini “usioathiriwa na kuficha” uwezekane kisayansi, kwanza lazima kuwe na tofauti zinazoweza kujirudia katika ishara ya sauti kati ya makundi husika ya kliniki. Utafiti wa sasa unachunguza sharti hili la lazima la awali. Lakini sharti la kutosha—mfumo kuweza kutambua kwa njia ya prospective hatari iliyofichwa wakati mtu anakataa moja kwa moja kuwa na mawazo ya kujiua—bado halijaonyeshwa.
Kwa nini sauti inachunguzwa?
Sauti ya binadamu si maneno pekee. Uratibu wa mfumo wa upumuaji, larynx, nyuzi za sauti na supralaringeal vocal tract huunda msingi wa kimwili wa hotuba. Katika mfumo wa neurophysiology unaotumiwa na utafiti chanzo, mfumo wa neva wa autonomic unaweza kuathiri sifa zinazoweza kupimwa kama fundamental frequency, ubora wa sauti, jitter, shimmer na mgawanyo wa spectral energy. Si athari zote hizi ziko chini ya udhibiti wa makusudi wa msemaji kwa kiwango sawa.
Nadharia tete ya utafiti inatokana na hoja hii: hali kali za kihisia na kifizikia zinaweza kuacha alama ya pamoja katika muundo wa muda-marudio wa hotuba, na deep neural network inaweza kujifunza muundo huu wenye vigezo vingi badala ya sifa moja moja zilizochaguliwa kwa mkono. Hata hivyo, utafiti hauonyeshi kwamba sifa yoyote moja ya akustiki ni mahsusi kwa tabia ya kujiua.
Kwa nini ulinganisho wa kliniki ulifanywa na wagonjwa wenye unyogovu mkali badala ya watu wenye afya?
Katika utafiti, kundi la unyogovu mkali lilitumika kama active clinical control. Sababu muhimu ni kwamba unyogovu wenyewe unaweza kuhusishwa na mabadiliko ya sifa za sauti kama kasi ya hotuba, variability ya pitch, shughuli za psychomotor na spectral energy. Ikiwa wagonjwa waliokuwa na jaribio la kujiua hivi karibuni wangelinganishwa na watu wenye afya pekee, ingekuwa vigumu zaidi kutenganisha ikiwa modeli imejifunza mabadiliko ya jumla ya sauti yanayohusiana na unyogovu au muundo wa ziada unaohusiana na jaribio.
Hata hivyo, muundo wa active control haukuondoa confounders zote. Mgawanyo wa jinsia katika makundi mawili ulikuwa tofauti sana: %49,2 ya kundi la jaribio la kujiua walikuwa wanaume, ilhali wanaume walikuwa %17,2 pekee katika kundi la unyogovu. Tofauti hii ilionekana kuwa na umuhimu wa kitakwimu. Kwa kuwa fundamental frequency ya sauti na sifa nyingine za spectral zinaweza kuathiriwa na jinsia ya kibayolojia, modeli huenda ilitenganisha labels za makundi kwa sehemu kupitia sifa hizi.
Rekodi ya hotuba ilikusanywaje?
Kati ya Desemba 2023 na Septemba 2024, wagonjwa wazima 88 wenye umri wa 18–65 walijumuishwa kutoka hospitali mbili za magonjwa ya akili nchini Romania. Washiriki wote walikuwa na utambuzi mkuu wa unyogovu mkali. Rekodi zilifanywa katika vyumba tulivu vya mahojiano ya kliniki katika vituo vyote viwili kwa kutumia vifaa vya kurekodia sauti vya kidijitali Sony ICD-PX240. Rekodi za awali zilichukuliwa kwa sample rate ya 44,1 kHz na katika muundo wa 128 kbps MP3. Kila mahojiano yalidumu takribani dakika 8–12.
Mahojiano yalikuwa na sehemu mbili zilizoundwa kwa kiasi. Katika kundi la jaribio la kujiua, sehemu ya kwanza ililenga jaribio hilo na hali za kihisia zinazohusiana nalo, huku katika kundi la unyogovu hali ya sasa ya kihisia ya mgonjwa ilijadiliwa. Katika sehemu ya pili, mada zisizo na msisimko mkubwa kama hali ya hewa na mambo ya kupenda zilizungumziwa. Muundo huu ulilenga kupata sehemu za hotuba zenye maudhui ya kihisia yaliyotamkwa na sehemu zisizo na msisimko mkubwa.
Hata hivyo, waendesha mahojiano walijua wagonjwa walikuwa katika kundi gani la kliniki, na mada za mwanzo za mahojiano katika makundi mawili hazikuwa sawa. Kwa hiyo, baadhi ya tofauti katika msisimko wa kihisia au prosody ya msemaji huenda ziliathiriwa si na hali ya kliniki pekee, bali pia na mada iliyozungumzwa au mwingiliano wa mahojiano. Kwa sababu hiyo, waandishi wanazuia tafsiri ya matokeo kuwa ushahidi wa “biomarker ya sauti iliyo mahsusi kwa kujiua”; badala yake wanayawasilisha kama uwezo wa kutenganisha kwa akustiki makundi mawili chini ya mazingira haya ya mahojiano.
Je, sauti ya mwendesha mahojiano iliingia kwenye modeli?
Hapana. Mahojiano ghafi yalifanyiwa kwanza speaker diarization ya kiotomatiki kwa modeli iliyofundishwa awali pyannote/speaker-diarization-3.1, kisha assignment za wasemaji zikathibitishwa kwa mkono na timu ya utafiti. Segmenti za hotuba za mgonjwa pekee ndizo zilihifadhiwa; sauti ya mwendesha mahojiano iliondolewa kabisa kabla ya kuondoa ukimya, kutengeneza mel-spectrogram, kufundisha CNN na kutathmini modeli.
Hatua hii pia iliambatana na kinga muhimu dhidi ya data leakage. Segmenti zote za sauti za mshiriki mmoja ziliwekwa katika sehemu ileile ya cross-validation. Kwa njia hii, sehemu fulani za mtu yuleyule hazikuwekwa katika training huku nyingine zikiwa katika test. Bila utenganishaji huu, modeli ingeweza kujifunza zaidi utambulisho wa msemaji kuliko darasa la kliniki na kuonyesha utendaji wa juu kuliko ulivyo kwa kweli.
Mel-spectrogram na Multi-Scale CNN zilitumikaje katika utafiti huu?
Katika utafiti, hotuba ya mgonjwa iligawanywa katika vipande vinavyoingiliana vya sekunde mbili, kila kipande kikabadilishwa kuwa picha ya muda-marudio ya ukubwa thabiti yenye 128 mel frequency bands, na Multi-Scale CNN ikajifunza mifumo midogo na mipana ya spectro-temporal katika picha hizo kupitia parallel convolutions, residual connection na attention mechanism ili kutoa uwezekano kwa madarasa mawili ya kliniki.
Mlolongo wa preprocessing kutoka ishara ya sauti hadi modeli
| Hatua | Utaratibu uliotumika katika chanzo | Lengo la kisayansi |
|---|---|---|
| Rekodi ghafi | 44,1 kHz, MP3 128 kbps, mahojiano ya kliniki ya dakika 8–12 | Kurekodi hotuba ya asili ya kliniki |
| Utenganishaji wa msemaji | pyannote/speaker-diarization-3.1 + uthibitishaji wa mkono | Kuhifadhi hotuba ya mgonjwa pekee |
| Resampling | 22.050 Hz | Kuunda muundo mmoja wa sampling kwa uchakataji wa akustiki |
| Kuondoa ukimya | librosa.effects.split, top_db = 20 | Kupunguza sehemu tulivu zisizo na hotuba |
| Segmentation | Sekunde 2, %50 overlap kati ya segmenti zinazofuatana | Kuunda input za CNN zenye muda thabiti |
| STFT | n_fft = 2048, hop length = 512 | Kubadilisha sauti kuwa uwakilishi wa nguvu wa muda-marudio |
| Mel projection | 128 mel bands, 0–11.025 Hz | Kuunda uwakilishi wa marudio uliobadilishwa kulingana na usikivu wa binadamu |
| Scaling | Ubadilishaji kuwa desibeli + Z-score standardization | Kusanifisha kiwango cha input |
| Ukubwa thabiti | 128 × 100 × 1 | Kutoa ukubwa wa picha unaofanana kwa CNN |
Chanzo kinaeleza kuwa kwa STFT, dirisha la sampuli 2048 katika 22.050 Hz linalingana na takribani 93 ms, huku hop length ya sampuli 512 ikilingana na takribani 23 ms. Spectrogram fupi zilijazwa kwa sifuri na ndefu zikakatwa hadi fremu 100 za muda.
Figure 1 ya chanzo katika ukurasa wa 12 inaonyesha mifano wakilishi ya mel-spectrogram kutoka makundi mawili ya kliniki. Jambo ambalo waandishi wanasisitiza ni kwamba picha hizi mbili hazitarajiwi kuonyesha tofauti ya wazi ya darasa kwa jicho la binadamu. Utenganishaji hautokani na mstari mmoja unaoonekana au frequency band moja, bali na mifumo changamano ya spectro-temporal ambayo CNN hujifunza katika segmenti nyingi.
Mantiki ya usanifu wa Multi-Scale CNN
Katika hatua ya kwanza ya modeli, spectrogram ileile hutumwa katika njia mbili sambamba za convolution. Njia ya kwanza hutumia kernels 32 za 3 × 3 kuchakata maelezo ya karibu na madogo ya spectro-temporal. Njia ya pili hutumia kernels 32 za 5 × 5 kuangalia mifumo ya muktadha mpana zaidi. Matokeo ya njia hizo mbili huunganishwa katika dimension ya channels na kutengeneza feature map yenye channels 64.
Sifa zilizounganishwa hupitia tabaka la 3 × 3 Conv2D lenye filters 64 na Batch Normalization. Kisha, ndani ya residual structure, njia ya transformation yenye 3 × 3 convolution huunganishwa na shortcut ya projection ya 1 × 1. Residual connection ni kipengele cha usanifu kinachosaidia kuhifadhi gradient flow wakati mtandao unapojifunza representations za kina zaidi.
Baada ya ReLU na 2 × 2 max pooling, tabaka jingine la 3 × 3 Conv2D lenye filters 128 na Batch Normalization hutumika. Kisha feature maps hupelekwa kwenye attention mechanism. Badala ya kutoa uzito sawa kwa maeneo yote ya spectrogram, mekanizimu hii hujifunza kutoa uzito zaidi kwa maeneo ya spatial/muda-marudio yanayoonekana kuwa na uwezo mkubwa wa kutofautisha kwa ajili ya classification.
Matokeo ya Attention hupelekwa kwenye tabaka la fully connected ReLU lenye units 128, kisha dropout rate ya 0,5 na mwisho kwenye softmax output ya madarasa mawili. Chanzo kinaeleza kwamba jumla ya parameters ni 170.691; kati ya hizo 170.307 zinaweza kufundishwa, na 384 haziwezi kufundishwa kwa sababu zinatokana na running statistics za Batch Normalization.
| Kipengele | Parameter ya chanzo | Kazi |
|---|---|---|
| Parallel convolution 1 | Filters 32, 3 × 3 | Mifumo midogo ya karibu ya muda-marudio |
| Parallel convolution 2 | Filters 32, 5 × 5 | Muktadha mpana wa spectro-temporal |
| Residual block | Njia ya 3 × 3 yenye filters 64 + shortcut ya 1 × 1 yenye filters 64 | Transformation ya kina zaidi ya sifa na gradient flow |
| Convolution ya mwisho | Filters 128, 3 × 3 + Batch Normalization | Kuboresha feature map iliyounganishwa |
| Attention | Spatial weighting | Kusisitiza maeneo tofauti ya spectro-temporal |
| Kichwa cha classification | Dense 128, ReLU, dropout 0,5, Dense 2 + softmax | Kutoa uwezekano kwa makundi mawili ya kliniki |
Walihamaje kutoka utabiri wa segmenti kwenda utabiri wa mgonjwa?
Ingawa CNN hufanya kazi kwenye segmenti nyingi za hotuba za sekunde mbili, matokeo makuu ya utendaji wa makala hayakuhesabiwa katika kiwango cha segmenti bali katika kiwango cha mgonjwa. Madarasa ya segmenti za mgonjwa yuleyule yaliunganishwa kwa majority voting ili kuamua darasa la mwisho la mgonjwa. Katika hesabu ya ROC-AUC, wastani wa uwezekano wa darasa la jaribio la kujiua katika segmenti zote za mgonjwa huyo ulitumika.
Chaguo hili ni muhimu kimetodolojia; kwa sababu kuwepo kwa maelfu ya segmenti za sauti hakumaanishi kwamba maelfu ya sampuli huru yamepatikana kutoka kwa wagonjwa huru 88. Segmenti zinazotoka kwa mtu yuleyule zinashiriki mfumo uleule wa kuzalisha sauti, mazingira yale yale ya kurekodi na kwa sehemu kipindi kilekile cha muda.
Mbinu na Matokeo ya Utafiti
Uchanganuzi mkuu wa utafiti unategemea stratified five-fold cross-validation katika kiwango cha mgonjwa kwa wagonjwa wote 88. Wagonjwa 59 wako katika darasa la jaribio la kujiua la hivi karibuni, na wagonjwa 29 katika darasa la ulinganisho la unyogovu mkali. Katika kila fold, sehemu zote za hotuba za mtu mmoja ziliwekwa upande wa training pekee au upande wa test pekee.
Muundo wa sampuli
| Sifa | Jaribio la kujiua la hivi karibuni | Unyogovu mkali, hakuna mawazo ya kujiua yaliyorekodiwa | Jumla |
|---|---|---|---|
| Mshiriki | 59 | 29 | 88 |
| Mwanaume | 29 (%49,2) | 5 (%17,2) | 34 (%38,6) |
| Mwanamke | 30 (%50,8) | 24 (%82,8) | 54 (%61,4) |
| Umri | 18–65 | 18–65 | 18–65 |
Tofauti ya mgawanyo wa jinsia kati ya makundi mawili ilionekana kuwa na umuhimu katika kiwango cha p < 0,01 kwa χ² test. Kwa hiyo, pamoja na uchanganuzi mkuu, uchanganuzi wa ziada ulifanywa kwa wanawake pekee, wanaume pekee na sampuli zilizolinganishwa kwa jinsia.
Utendaji mkuu katika kiwango cha mgonjwa
| Kipimo | Wastani ± mkengeuko wa kawaida | Tafsiri |
|---|---|---|
| Usahihi | 72,67 ± 6,44% | Kiwango cha jumla cha uainishaji sahihi wa makundi mawili |
| Usahihi uliosawazishwa | 61,83 ± 9,56% | Utendaji wa wastani wa madarasa unaozingatia kutokuwiana kwa madarasa |
| ROC-AUC | 0,824 ± 0,054 | Kiwango cha uwezo wa kutenganisha madarasa bila kutegemea threshold |
| Unyeti | 0,883 ± 0,095 | Kiwango cha kutambua kundi lililokuwa na jaribio la kujiua hivi karibuni |
| Umaalumu | 0,413 ± 0,250 | Kiwango cha kuweka kwa usahihi kundi la unyogovu katika darasa hasi |
| Precision, darasa la jaribio | 0,761 ± 0,070 | Sehemu sahihi ya visa ambavyo modeli iliweka katika darasa la jaribio |
| Macro-F1 | 0,633 ± 0,142 | Kipimo cha muhtasari kinachopa utendaji wa F1 wa madarasa mawili uzito sawa |
ROC-AUC 0,824 inapaswa kutafsiriwaje pamoja na unyeti wa juu na umaalumu mdogo?
ROC-AUC 0,824 inaonyesha kwamba modeli inaweza kutenganisha makundi mawili ya kliniki katika thresholds tofauti za uamuzi, huku unyeti wa %88,3 na umaalumu wa %41,3 ukionyesha kwamba katika mazingira yaliyochaguliwa ya utafiti modeli inaelekea kutambua kundi la jaribio lakini hufanya hivyo kwa gharama ya idadi kubwa ya false-positive classifications katika kundi la unyogovu; kwa hiyo AUC peke yake haimaanishi kuwa kipimo cha hatari kiko tayari kwa matumizi ya kliniki.
Hoja hii ni muhimu hasa katika maeneo kama hatari ya kujiua, ambako base rate ni ndogo na gharama za kliniki si linganifu. False negative inaweza kupitisha hatari kubwa ya kliniki, huku false positive ikiweza kusababisha hatua zisizo za lazima, wasiwasi wa mgonjwa, kupotea kwa uaminifu au maamuzi ya kliniki yenye vizuizi visivyo vya lazima. Utafiti chanzo haupendekezi threshold yoyote ya matumizi ya kliniki.
Uchanganuzi uliodhibiti jinsia ulionyesha nini?
Katika uchanganuzi wa wanawake pekee, wastani wa ROC-AUC uliripotiwa kuwa 0,866 ± 0,123. Katika uchanganuzi wa kiuchunguzi wa wanaume pekee, ROC-AUC ilikuwa takribani 0,786; hata hivyo, kwa kuwa kulikuwa na wanaume watano tu katika kundi la unyogovu, matokeo haya hayakuchukuliwa kuwa independent validation ya kuaminika.
Katika uchanganuzi unaorudiwa uliolinganishwa kwa jinsia, ROC-AUC ilishuka hadi 0,621 ± 0,156. Kushuka huku kunaonyesha kwamba sehemu ya nguvu ya kutenganisha katika sampuli kamili huenda iliathiriwa na mgawanyo wa jinsia na sifa za akustiki zinazohusiana na jinsia. Wakati huohuo, ukweli kwamba utendaji haukushuka kabisa hadi kiwango cha bahati huacha wazi nadharia kwamba kuna taarifa ya ziada ya akustiki nje ya jinsia. Hata hivyo, tafsiri hii ya pili haiwezi kuwa ushahidi wa mwisho wa biomarker mahsusi ya kujiua bila external validation.
Je, Multi-Scale CNN ilikuwa bora kuliko modeli ya kawaida?
Utafiti chanzo pia ulitathmini modeli ya Random Forest inayotumia sifa za MFCC katika sehemu zilezile za cross-validation za kiwango cha mgonjwa. Matokeo yanaonyesha kwamba CNN haikuwa na ubora wazi dhidi ya msingi wa kawaida.
| Kipimo | Multi-Scale CNN | MFCC + Random Forest |
|---|---|---|
| Usahihi | 72,7 ± 6,4% | 75,0 ± 3,4% |
| ROC-AUC | 0,824 ± 0,054 | 0,818 ± 0,123 |
| Unyeti | 0,883 ± 0,095 | 0,950 ± 0,075 |
| Umaalumu | 0,413 ± 0,250 | 0,340 ± 0,107 |
| Macro-F1 | 0,633 ± 0,142 | 0,651 ± 0,056 |
| Usahihi uliosawazishwa | 61,8 ± 9,6% | 64,5 ± 4,8% |
Kwa uainishaji uliolinganishwa katika kiwango cha mgonjwa, exact McNemar test ilitoa p = 0,804. Matokeo haya yanamaanisha kuwa katika data set hii hakuna tofauti yenye umuhimu wa kitakwimu ya uainishaji iliyoonyeshwa kati ya mbinu hizo mbili. Kwa hiyo, si sahihi kuwasilisha mchango wa kisayansi wa utafiti kama “deep learning ilishinda mbinu ya kawaida”.
Kwa nini hatari ya overfitting ni kubwa?
Multi-Scale CNN ina parameters 170.691 dhidi ya wagonjwa huru 88 pekee. Chanzo kinakokotoa uwiano huu kuwa takribani 1940 parameters/mgonjwa. Ingawa imeripotiwa kwamba jumla ya spectrogram 8037 zilitengenezwa baada ya segmentation, segmenti zinazotoka kwa mgonjwa mmoja si sampuli huru; zinashiriki utambulisho wa msemaji, mazingira ya kurekodi na %50 overlap ya muda. Kwa hiyo, ukubwa halisi wa sampuli huru unapaswa kuchukuliwa kuwa wagonjwa 88, si maelfu ya spectrogram.
Katika training curves, ukweli kwamba training accuracy ilikaribia takribani %97–98 huku validation performance ikibaki katika kiwango cha chini pia unaonyesha kwamba hatari ya overfitting haikuondolewa kabisa. Kwa sababu hiyo, waandishi wanaeleza matokeo kama ya hatua ya awali na ya kiuchunguzi.
Kutokuwiana muhimu kwa mbinu katika chanzo kuhusu reproducibility
Sehemu ya mbinu na sehemu ya mapungufu ya makala hazilingani katika baadhi ya maelezo ya training. Sehemu ya mbinu inaripoti TensorFlow/Keras 2.x, Adam optimizer, learning rate ya mwanzo 2 × 10⁻⁴, batch size 16 na 20 epoch. Sehemu hiyo hiyo inaeleza wazi kwamba early stopping haikutumika, data augmentation haikutumika na explicit class weighting haikutumika.
Kinyume chake, sehemu ya mapungufu inaeleza kwamba SpecAugment na class-weighted training zilitumika, na kwamba early stopping ilitumika. Kauli nyingine katika mapungufu inataja training accuracy ya takribani %98 kufikiwa katika kipindi cha 60 epoch. Kauli hizi haziwezi kuelezea pamoja protocol ileile ya mwisho ya training. Verianla haitatui kimya kimya mkanganyiko huu kwa makadirio; ili modeli iweze kuzalishwa tena kikamilifu, ni lazima ithibitishwe kwa code ya utafiti au maelezo ya waandishi ni training configuration ipi ilikuwa ya uchanganuzi wa mwisho.
Maelezo mbadala
Waandishi wanajadili kwa kina kwamba utengano wa akustiki ulioonekana haumaanishi lazima kuwepo kwa alama ya kifizikia iliyo mahsusi kwa tabia ya kujiua. Uwezekano wa kwanza muhimu ni athari za dawa. Dawa za psychotropic zinaweza kuathiri shughuli za psychomotor, udhibiti wa upumuaji, phonation na tone ya misuli ya larynx; lakini data za dawa za washiriki hazikurekodiwa kwa utaratibu.
Uwezekano wa pili ni hali ya kifizikia baada ya mgogoro mkali. Kiwango cha uchovu, sedation au arousal baada ya mgogoro kwa mgonjwa aliyelazwa hivi karibuni baada ya jaribio la kujiua kinaweza kutofautiana na mgonjwa mwingine aliyelazwa kwa unyogovu lakini aliyerekodiwa katika hatua tofauti ya kulazwa.
Uwezekano wa tatu ni muktadha wa mahojiano. Hata ikiwa sauti ya mwendesha mahojiano imeondolewa kwenye input ya modeli, hali ya kliniki anayoijua na maswali tofauti yanaweza kubadilisha nguvu ya kihisia na muundo wa prosody wa majibu ya mgonjwa.
Uwezekano wa nne ni ukali wa unyogovu. Ingawa makundi yote mawili yana unyogovu mkali, kiwango cha wastani cha ukali wa ugonjwa, kukata tamaa au psychomotor impairment katika kundi la jaribio kinaweza kuwa tofauti. Katika hali hiyo, modeli inaweza kuwa inajifunza si tabia ya kujiua yenyewe bali ukali wa kliniki ulio juu zaidi unaohusiana nayo.
Sababu kubwa ya tano ni kutokuwiana kwa jinsia. Kushuka kwa ROC-AUC baada ya kulinganisha jinsia kunaonyesha kwamba athari hii ya confounding si ya kinadharia pekee bali imejitokeza katika matokeo.
Je, matokeo ya utafiti yanaonyesha kuwa kipimo huru cha hatari ya kujiua kinaweza kutumika kliniki?
Hapana. Hakukuwa na external validation katika utafiti, tabia ya kujiua ya prospective haikutabiriwa na threshold ya matumizi ya kliniki haikujaribiwa; watafiti wanaweka uainishaji unaotegemea sauti si kama mbadala wa tathmini pana ya kliniki bali kama njia ya ziada ya taarifa ya kusaidia maamuzi ambayo lazima ithibitishwe baadaye.
Mipaka ya kimaadili
Rekodi za sauti ni data nyeti za biometriki na afya. Chanzo kinasisitiza kwamba ikiwa siku zijazo kutakuwa na matumizi kama ufuatiliaji endelevu wa sauti, informed consent, mabadiliko ya uwezo wa kufanya maamuzi wakati wa ugonjwa mkali wa akili, usimbaji wa data, udhibiti wa ufikiaji, sheria za data binafsi na uwazi wa algorithm lazima viwe mahitaji ya msingi ya usanifu.
Gharama za false-positive na false-negative results pia si linganifu. False-positive alarm inaweza kusababisha hatua zisizo za lazima za kliniki na kuharibu uaminifu wa matibabu. False negative inaweza kumpa daktari imani isiyo sahihi. Kwa hiyo, threshold halisi ya alarm ya kliniki haiwezi kutolewa kutoka katika data hizi za proof-of-concept.
Kikomo cha uwezo wa kujumlisha
Utafiti unajumuisha mahojiano ya lugha ya Kiromania kutoka hospitali mbili za magonjwa ya akili nchini Romania. Ingawa neurophysiology ya msingi ya uzalishaji wa sauti ya binadamu ina vipengele vya pamoja kati ya lugha, haiwezi kudhaniwa kwamba modeli itajumlisha kiotomatiki kwa lugha, tamaduni, microphones, mazingira ya kliniki au protocols za kurekodi zilizo tofauti. Chanzo pia kinaelekeza umakini katika upotevu wa utendaji unaotokea katika cross-dataset na cross-language transfer kwa modeli zinazotegemea sauti.
Vipaumbele vya tafiti za baadaye
Waandishi wanapendekeza kama kipaumbele cha hatua inayofuata utafiti wa validation wa vituo vingi wenye angalau washiriki 500. Muundo huu unapangwa kujumuisha mgawanyo wa kidemografia uliosawazishwa, mahojiano yaliyosanifishwa, cohorts huru za external validation na, inapowezekana, lugha zaidi ya moja na mazingira tofauti ya kurekodi.
Lengo lingine muhimu ni ufuatiliaji wa prospective wa muda mrefu. Katika utafiti wa aina hiyo, sampuli za sauti za kila siku zinaweza kuchukuliwa baada ya wagonjwa kuruhusiwa kutoka hospitalini, na inaweza kujaribiwa ikiwa mabadiliko katika model score yanajitokeza kabla ya kuzorota kwa kliniki au kurudia kwa tabia ya kujiua. Hali hii haikutekelezwa katika makala ya sasa.
Aidha, inapaswa kupimwa kwa multivariable models ikiwa voice biomarkers kweli zinaongeza predictive value juu ya zana zilizoundwa kama C-SSRS na tathmini ya kliniki. Ikiwa sauti, ukali wa unyogovu, dawa, viashiria vya kifizikia na neuroimaging vitachunguzwa pamoja, inaweza kueleweka vizuri zaidi ni sehemu gani ya representation iliyojifunzwa na CNN inayohusiana na tabia ya kujiua na ni sehemu gani inayohusiana na covariates za kidemografia au kliniki.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Addressing the Dissimulation Problem in the Assessment of Suicide Risk Using CNN-Based Voice Analysis: A Proof-of-Concept Study.
Waandishi: Adela Magdalena Ciobanu; Ana Voichita Tebeanu; Vlad Tau; Anca Ana Chendea; Eduard Dan Franti; Catalin Niculae; Claudiu Ionut Vasile; George Florian Macarie; Liliana Neagu; Monica Dascalu; Cristian Ioan Stoica; Marius Moga; Gabriela Iorgulescu.
Corresponding authors: Ana Voichita Tebeanu na Vlad Tau.
Taasisi kuu: University of Medicine and Pharmacy “Carol Davila”; “Prof. Dr. Al. Obregia” Psychiatry Clinical Hospital; National University of Science and Technology Politehnica Bucharest; Eden Health SRL; IMT Bucharest; Research Institute for Artificial Intelligence “Mihai Draganescu”; Areus Technology; “Elisabeta Doamna” Psychiatry Hospital; “Dunarea de Jos” University; Clinica PSIHOGER.
Jarida: Psychiatry International.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Psychiatry International, 2026, 7(4), 174.
DOI: 10.3390/psychiatryint7040174.
Tarehe ya kuchapishwa: 4 Agosti 2026.
Toleo la chanzo: Version of Record.
Aina ya makala: Article; utafiti wa uainishaji wa kliniki wa proof-of-concept.
Leseni: Creative Commons Attribution (CC BY). Kwa kuwa namba ya toleo la leseni haikutajwa kando katika PDF, toleo halikukadiriwa.
Maadili: Utafiti ulifanywa kwa mujibu wa Azimio la Helsinki na uliidhinishwa na kamati za maadili za “Prof. Dr. Al. Obregia” Psychiatry Clinical Hospital na “Elisabeta Doamna” Psychiatry Hospital. Written informed consent ilipatikana kutoka kwa washiriki wote.
Ufadhili: Hakuna external funding iliyoripotiwa kwa utafiti. Uchapishaji wa makala uliungwa mkono na programu ya taasisi ya “Publish not Perish” ya University of Medicine and Pharmacy Carol Davila.
Upatikanaji wa data: Rekodi za sauti za wagonjwa wa magonjwa ya akili zinazoweza kutambulisha mtu na data za kliniki haziko wazi kwa umma kwa sababu ya masharti ya faragha na consent. Mel-spectrogram feature matrices ambazo zimeelezwa kutokuwa na maudhui ya sauti yanayoweza kurejeshwa, code ya model architecture na training scripts zinaweza kuombwa kutoka kwa corresponding author kwa ombi linalofaa chini ya masharti ya ethical approval na data use agreement husika.
Taarifa ya mgongano wa maslahi: Vlad Tau, Catalin Niculae na George Florian Macarie walikuwa na uhusiano wa ajira, mtawalia, na Eden Health SRL, Areus Technology na Clinica PSIHOGER wakati wa utafiti. Waandishi walieleza kwamba taasisi hizi hazikuwa na maslahi ya kifedha au kibiashara katika matokeo ya utafiti. Waandishi wengine hawakuripoti mgongano wa maslahi ya kibiashara au kifedha.
Taarifa ya generative AI: Waandishi waliripoti kutumia Claude Opus 4.7 wakati wa kuandaa makala kwa drafting/editing ya maandishi, msaada wa kutafuta fasihi, kuthibitisha bibliographic metadata, kusaidia kutafsiri baadhi ya hesabu za kitakwimu na formatting ya marejeo. Zana haikutumiwa kwa study design, patient recruitment, mahojiano, uchanganuzi wa primary voice data, maendeleo au training ya CNN model, wala kutengeneza figures.
Mapungufu makuu ya kimetodolojia: Sampuli ya watu 88; uwiano mkubwa wa parameter/mgonjwa dhidi ya modeli yenye parameters 170.691; kutokuwepo kwa external validation; kutokuwiana kwa madarasa 59/29; kutokuwiana dhahiri kwa jinsia; data ya Kiromania pekee kutoka vituo viwili; kutokuwepo kwa rekodi za dawa; athari za mada ya mahojiano na mwendesha mahojiano; MP3 lossy compression; kutumia label ya tukio la kliniki la zamani badala ya hatari halisi ya prospective; kutopimwa kwa uwezo wa kujumlisha kwa lugha na vituo tofauti.
Onyo la reproducibility ndani ya chanzo: Sehemu ya mbinu inaripoti 20 epoch, hakuna early stopping, hakuna data augmentation na hakuna class weighting; sehemu ya mapungufu, kwa upande mwingine, inataja training iliyofikia 60 epoch, SpecAugment, class-weighted training na matumizi ya early stopping. Mkanganyiko huu haujatatuliwa kimya kimya na Verianla; protocol ya mwisho ya training inahitaji kuthibitishwa kwa source code au maelezo ya waandishi.
Dokezo la matumizi ya visual: Figure 1–6 za chanzo hazikunakiliwa moja kwa moja. Ujumbe wa kisayansi wa mel-spectrogram, CNN architecture na performance data umehamishwa kupitia maelezo huru ya Verianla na HTML tables zilizoundwa upya.
Kikomo cha matumizi ya kliniki: Modeli ya utafiti huu haijathibitishwa kama zana ya kliniki inayoweka utambuzi au kuamua peke yake hatari ya kujiua. Mtazamo wa chanzo chenyewe pia unaweka mfumo huu katika siku zijazo kama sehemu tu ya clinical decision support.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *