

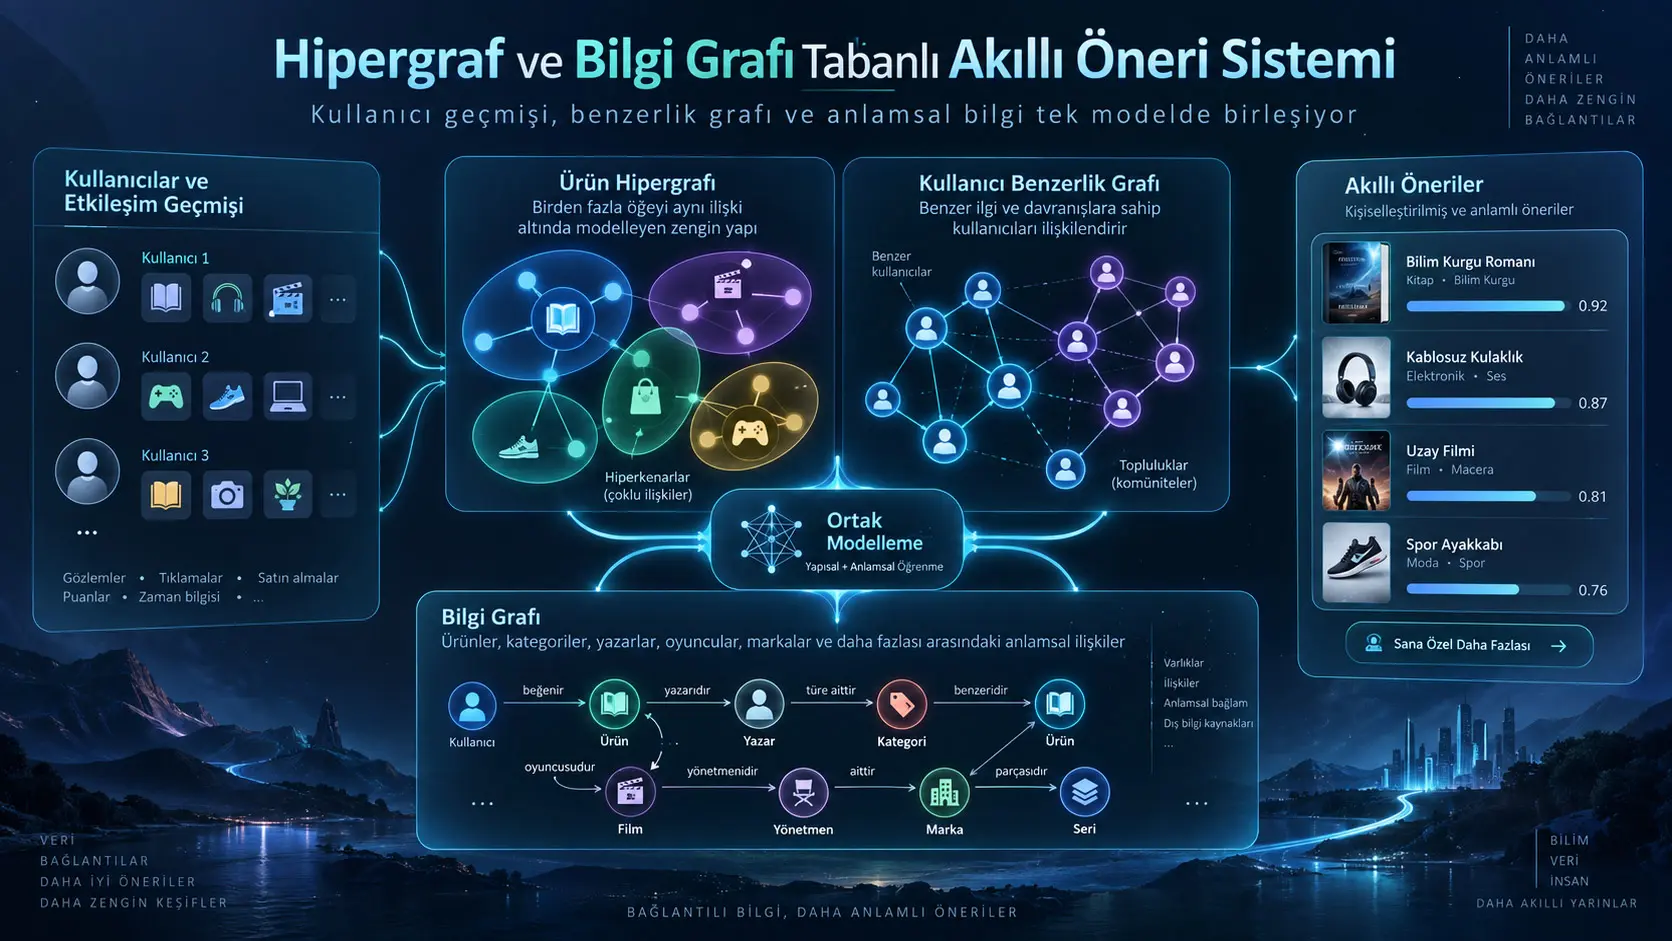
Bu çalışma, seyrek kullanıcı–öğe etkileşimlerinde yalnız ikili kullanıcı–öğe bağlantılarına dayanan geleneksel öneri yöntemlerinin kaçırabildiği yüksek dereceli işbirlikçi yapıyı ve öğelerin dış anlamsal bilgisini aynı modelde birleştiren bilgi-farkındalıklı bir öneri sistemi çerçevesini inceler. Önerilen çerçeve; kullanıcı geçmişlerinden oluşturulan bir öğe hipergrafı, başlangıç kullanıcı temsillerini yerel olarak iyileştiren top-k kullanıcı benzerlik grafı ve öğelerin bilgi grafındaki tek-atlamalı komşularını kullanıcıya bağlı ilişki ağırlıklarıyla birleştiren bilgi grafı toplulaştırıcısından oluşur. Hipergraf, ikili bağlantının ötesinde aynı kullanıcı geçmişinde birlikte görülen öğelerin grup düzeyindeki yapısını öğrenirken, bilgi grafı kolu öğelere semantik bağlam kazandırır. Son kullanıcı ve öğe temsilleri çok katmanlı algılayıcıya aktarılır ve model kullanıcı–öğe uygunluk puanı üretir.
MovieLens-1M, Last.FM ve Book-Crossing veri kümelerinde yapılan sabit çevrimdışı benchmark değerlendirmesinde önerilen model, makalede karşılaştırılan LightGCN, ENMF, NeuMF ve HMKRec yöntemlerine karşı AUC, doğruluk ve Recall@K ölçütlerinde genel olarak güçlü sonuçlar vermiştir. Örneğin sabit benchmark protokolünde MovieLens-1M için AUC 0,8737 ve ACC 0,7202; Last.FM için AUC 0,8620 ve ACC 0,6954; Book-Crossing için AUC 0,7287 ve ACC 0,5623 raporlanmıştır. Bununla birlikte bu sonuçlar yalnız çalışmada kullanılan veri işleme, negatif örnekleme ve aday listeleme protokolü altında değerlendirilmelidir. Çalışma, modelin bütün öneri sistemlerinde evrensel olarak üstün olduğunu veya çevrimdışı benchmark başarısının doğrudan gerçek dünya kullanıcı memnuniyetine dönüştüğünü göstermemektedir.
Öneri sistemlerindeki temel problem
Bir öneri sistemi, belirli bir kullanıcının hangi film, şarkı, kitap veya başka bir öğeyle ilgilenme olasılığının yüksek olduğunu tahmin etmeye çalışır. En basit işbirlikçi filtreleme yaklaşımları bu tahmini geçmiş kullanıcı–öğe etkileşimlerinden çıkarır. Ancak gerçek veri kümelerinde kullanıcıların katalogdaki öğelerin çok küçük bir bölümüne dokunması nedeniyle etkileşim matrisi genellikle son derece seyrektir.
Bu seyrek yapı iki önemli bilgi kaybı doğurabilir. Birincisi, standart kullanıcı–öğe grafı çoğunlukla ikili bağlantıları temsil eder ve aynı kullanıcının geçmişinde birlikte bulunan çok sayıda öğenin oluşturduğu grup yapısını doğrudan kodlamaz. İkincisi, yalnız etkileşim kaydına bakıldığında öğelerin türü, ilişkileri veya dış bilgi tabanındaki anlamsal bağlantıları yeterince kullanılamaz.
Çalışmanın temel yaklaşımı bu iki bilgi kaynağını ayrı fakat birbirini tamamlayan kollarda işlemektir. Kullanıcı geçmişleri hipergraf üzerinden yüksek dereceli işbirlikçi yapı oluşturur; bilgi grafı ise öğelerin semantik bağlamını sağlar. Bunlara ek olarak kullanıcıların başlangıç temsilleri arasındaki benzerlikler ayrı bir kullanıcı grafında yayılır.
Hipergraf Bu Öneri Sisteminde Neyi Temsil Eder?
Bu çalışmadaki hipergraf, düğümleri öğelerin oluşturduğu ve her kullanıcının geçmişte etkileşim kurduğu öğe kümesinin tek bir hiperkenar olarak temsil edildiği yüksek dereceli bir ilişki yapısıdır. Böylece normal bir grafın iki düğüm arasındaki tek bağlantısından farklı olarak, bir kullanıcının aynı geçmiş içinde seçtiği çok sayıda öğe ortak bir hiperkenar altında birlikte modellenebilir.
Kullanıcı kümesi \(U\), öğe kümesi \(V\) ve kullanıcı \(u\)'nun etkileşim kurduğu öğeler \(I_u\) ile gösterildiğinde kullanıcıya karşılık gelen hiperkenar şu şekilde tanımlanır:
\[ e_u=\{v\mid v\in I_u\} \]
Burada önemli ayrıntı, kullanıcının hipergraf düğümü olmamasıdır. Hipergrafın düğümleri öğelerdir; kullanıcının geçmişi ise bu öğeleri birbirine bağlayan hiperkenarı tanımlar. Bu tasarım, örneğin aynı kullanıcının seçtiği beş öğeyi beş ayrı ikili bağlantı olarak görmek yerine bu beş öğenin ortak davranış bağlamını tek yapısal birim içinde ifade etmeye izin verir.
Hipergrafın incidence matrisi \(H\), bir öğenin belirli bir hiperkenara ait olup olmadığını gösterir:
\[ H_{v,e_u}= \begin{cases} 1, & v\in e_u\\ 0, & \text{aksi halde} \end{cases} \]
Hipergraf evrişimi sırasında bilgi önce öğelerden hiperkenarlara, daha sonra hiperkenarlardan tekrar öğelere yayılır. Kaynakta kullanılan temel yayılım yapısı:
\[ X^{(l+1)}= \sigma\left( D_v^{-1/2} H D_e^{-1} H^{T}D_v^{-1/2} X^{(l)}W^{(l)} \right) \]
biçimindedir. Burada \(X^{(l)}\), \(l\). katmandaki öğe embedding matrisini; \(W^{(l)}\), öğrenilebilir ağırlık matrisini; \(D_v\), öğe derece matrisini; \(D_e\), hiperkenar derece matrisini; \(\sigma\) ise aktivasyon fonksiyonunu temsil eder. Normalize edilmiş matris çarpımı, çok sık görülen öğelerin yalnız yüksek bağlantı sayıları nedeniyle yayılımı kontrolsüz biçimde domine etmesini azaltmaya yardımcı olur.
Öğe temsillerinden kullanıcı temsiline geçiş
Hipergraf katmanları ilk aşamada doğrudan kullanıcı embedding'i üretmez. Önce yüksek dereceli ilişkileri taşıyan öğe embedding'leri öğrenilir. Daha sonra her kullanıcı için, o kullanıcının etkileşim kurduğu öğelerin son hipergraf temsilleri ortalanarak başlangıç kullanıcı vektörü elde edilir:
\[ h_u^{(0)} = \frac{1}{|I_u|} \sum_{v\in I_u} x_v^{(L_h)} \]
Bu ayrım modelin mimarisini anlamak açısından önemlidir: hipergraf kolu “kullanıcı düğümlerini” doğrudan işlememekte, kullanıcı geçmişinin oluşturduğu hiperkenarlar üzerinden öğeleri işlemekte ve kullanıcı temsili daha sonra bu öğe temsillerinden türetilmektedir.
Kullanıcı Benzerlik Grafı Neden İkinci Bir Kullanıcı Modelleme Aşaması Ekler?
Kullanıcı benzerlik grafı, hipergraftan türetilen başlangıç kullanıcı embedding'lerini birbirine yakın kullanıcılar arasında yayarak yerel tercih benzerliğini modelleyen ikinci kullanıcı-temsil aşamasıdır. Hipergraf daha geniş grup düzeyindeki ortak öğe yapısını yakalarken, benzerlik grafı embedding uzayında birbirine yakın kullanıcıların bilgisini doğrudan komşuluk ilişkisi halinde işler.
İki kullanıcının benzerliği başlangıç kullanıcı vektörlerinin kosinüs benzerliğiyle hesaplanır:
\[ S(u_i,u_j) = \frac{ h_{u_i}^{T}h_{u_j} }{ \|h_{u_i}\|\|h_{u_j}\| } \]
Tüm kullanıcı çiftlerini tam bağlı bir graf haline getirmek hem hesaplama maliyetini hem de anlamsız zayıf bağlantıları artıracağından model her kullanıcı için yalnız en yüksek benzerliğe sahip 50 kullanıcıyı tutar. Böylece top-k seyrekleştirilmiş kullanıcı grafı elde edilir.
Çalışmanın mevcut uygulamasında bu kullanıcı grafı eğitim boyunca dinamik olarak yeniden oluşturulmaz. Hipergraftan havuzlanan başlangıç kullanıcı vektörlerinden bir kez oluşturulur ve sabit tutulur. Kullanıcı grafı kolunda tek bir grafik yayılım katmanı kullanılır; yazarlar bunu aşırı yumuşatma riskini sınırlayan bir tasarım olarak sunmaktadır.
Statik hipergraf varsayımı
Hipergraf da geçmiş etkileşimlerden çıkarılan sabit bir çevrimdışı görüntü olarak kullanılır. Bu tercih MovieLens-1M, Last.FM ve Book-Crossing gibi sabit benchmark veri kümeleriyle uyumludur. Ancak kullanıcı tercihleri zaman içinde değişebileceği için bu varsayım canlı üretim ortamlarında ayrıca sınanmalıdır. Çalışmanın kendisi zamansal tercih kaymasını modellememekte ve dinamik hipergraf geliştirmesini gelecek çalışma konusu olarak bırakmaktadır.
Bilgi Grafı Kullanıcıya Özel Öğe Temsilini Nasıl Oluşturur?
Bilgi grafı kolu, her öğeyi bilgi grafındaki karşılık gelen entity ile eşleştirir ve o entity'nin tek-atlamalı komşularından anlamsal bilgi toplar. Bu toplama işlemi sabit bir komşu ortalaması değildir; hangi ilişkinin daha önemli olduğu hedef kullanıcıya göre ağırlıklandırılır. Böylece aynı öğenin anlamsal temsili farklı kullanıcılar için farklı ilişki vurgularına sahip olabilir.
Modelde her öğe için 16 bilgi grafı komşusu tutulur. Entity ve relation embedding'leri önce DistMult ile hafif bir ön eğitimden geçirilir ve daha sonra öneri sistemiyle birlikte ince ayarlanır.
Kullanıcı \(u\) ve ilişki türü \(r\) için tercih katsayısı softmax yapısıyla hesaplanır:
\[ \alpha_{u,r} = \frac{ \exp(z_u^{T}r) }{ \sum_{r'\in\mathcal{R}_u} \exp(z_u^{T}r') } \]
Bu katsayı, kullanıcı embedding'i ile ilişki embedding'i arasındaki uyuma göre belirli ilişki türlerini daha fazla veya daha az etkili kılar. Ardından hedef entity \(e_v\) ile komşu entity'ler birleştirilerek kullanıcıya koşullu semantik öğe temsili üretilir:
\[ z_{u,v} = \sigma \left( W_e \left[ e_v+ \sum_{(r,e_j)\in\mathcal{N}(e_v)} \alpha_{u,r}e_j \right] \right) \]
Bu mekanizma çok-atlamalı bir KG mesajlaşması değildir. Çalışmada özellikle tek-atlamalı komşuluk kullanılmaktadır. Dolayısıyla sonuçlar “derin bilgi grafı muhakemesi” olarak yorumlanmamalıdır.
Tahmin vektörü ve MLP
Son aşamada rafine edilmiş kullanıcı embedding'i ile kullanıcıya özgü öğe embedding'i bir araya getirilir. Kaynağın kompakt denkleminde kullanıcı ve öğe vektörleri ile eleman bazlı etkileşim kullanılırken algoritmik açıklama ayrıca mutlak fark bileşeninin de tam tanımlayıcıya dahil edildiğini belirtmektedir. Bu nedenle çalışmanın metinsel açıklaması ile kompakt Denklem (8) arasında gösterim düzeyinde bir ayrım bulunmaktadır; Verianla anlatımında bu fark gizlenmemelidir.
MLP tahmini genel olarak:
\[ \hat y_{u,v} = \sigma \left( W_2\, \phi(W_1x_{u,v}+b_1)+b_2 \right) \]
şeklindedir. Burada \(\phi\), ReLU aktivasyonunu; son sigmoid katmanı ise kullanıcı–öğe çiftinin pozitif etkileşim olasılığına karşılık gelen skoru üretir.
Popülerlik Düzeltmesi Modelin Öğrendiği Ana Mekanizma mı?
Hayır. Popülerlik-farkındalıklı işlem, temel modelin eğitim mimarisinin yerine geçen ana öğrenme mekanizması değil, oluşturulmuş öneri skorlarına isteğe bağlı uygulanabilen hafif bir son-işleme kalibrasyonudur. Çalışma bu adımın “uzun kuyruk performansını tek başına sağlayan mekanizma” olarak yorumlanmaması gerektiğini özellikle sınırlar.
Kaynakta verilen son-skor düzeltmesi:
\[ y'_{u,v} = \hat y_{u,v} - \lambda\log(1+\mathrm{pop}(v)) \]
biçimindedir. Burada \(\mathrm{pop}(v)\), öğenin eğitim verisindeki etkileşim sayısını; \(\lambda\) ise doğrulama protokolünde ayarlanan katsayıyı temsil eder. Popüler bir öğenin etkileşim sayısı arttıkça logaritmik ceza büyür ve nihai sıralamadaki aşırı baskınlığı azaltılabilir.
Ancak çalışmada bu son-işleme bileşeninin izole etkisini ölçen bağımsız bir ablasyon bulunmamaktadır. Dolayısıyla modelin uzun kuyruk davranışındaki değişimin ne kadarının bu düzeltmeye, ne kadarının hipergraf/KG yapısına ait olduğunu kesin olarak ayrıştırmak mümkün değildir.
Eğitim kaybı
Model, gözlenen pozitif kullanıcı–öğe çiftleri ve örneklenmiş negatif çiftler üzerinde noktasal binary cross-entropy ile eğitilir:
\[ \mathcal{L} = - \sum_{(u,v)\in\mathcal{Y}^{+}} \log \hat y_{u,v} - \sum_{(u,v)\in\mathcal{Y}^{-}} \log(1-\hat y_{u,v}) \]
Bu kayıp, pozitif etkileşimlerin yüksek; negatif örneklerin düşük skor almasını teşvik eder. Buradaki “negatif”, kullanıcının gerçekten öğeyi sevmediğini mutlaka göstermez; çalışmanın protokolünde gözlenmemiş öğeler arasından örneklenen eğitim çiftlerini ifade eder.
Değerlendirme metrikleri
Çalışma bağlantı tahmini için Accuracy (ACC) ve ROC eğrisi altında kalan alanı gösteren AUC; Top-K öneri için ise Recall@K kullanır.
\[ ACC= \frac{TP+TN} {TP+TN+FP+FN} \]
AUC, rastgele seçilmiş bir pozitif etkileşime rastgele seçilmiş negatif etkileşimden daha yüksek skor verme olasılığı üzerinden modelin sıralama ayırt ediciliğini ölçer.
Bir kullanıcı için Recall@K:
\[ Recall@K(u) = \frac{ |\mathcal{R}_u(K)\cap\mathcal{T}_u| }{ |\mathcal{T}_u| } \]
olarak hesaplanır. Burada \(\mathcal{R}_u(K)\), kullanıcıya önerilen ilk K öğeyi; \(\mathcal{T}_u\) ise test verisindeki gerçek pozitif öğeleri temsil eder. Sistem düzeyi Recall@K, kullanıcı bazındaki değerlerin makro ortalamasıdır.
Çalışmanın Yöntemi ve Bulguları
Veri kümeleri ve ön işleme
Çalışma üç farklı alanı temsil eden MovieLens-1M, Last.FM ve Book-Crossing benchmarklarını kullanır. Film, müzik ve kitap alanlarının birlikte değerlendirilmesi, modelin yalnız tek bir etkileşim yapısına bağlı kalıp kalmadığını gözlemlemek açısından önemlidir.
| Veri kümesi | Kullanıcı | Öğe | Etkileşim | KG ilişki türü | KG entity | KG üçlüsü |
|---|---|---|---|---|---|---|
| MovieLens-1M | 5.148 | 2.380 | 553.277 | 2 | 96 | 6.706 |
| Last.FM | 1.265 | 606 | 41.879 | 1 | 9.749 | 28.383 |
| Book-Crossing | 8.380 | 12.634 | 91.810 | 3 | 5.213 | 36.375 |
MovieLens-1M'de 4 ve üzeri puanlar pozitif örtük geri bildirim olarak işaretlenir. Last.FM'nin örtük geri bildirim yapısı ve Book-Crossing'in yüksek seyrekliği nedeniyle tutulan geçmiş etkileşimler pozitif kabul edilir. Minimum destek eşiği MovieLens-1M ve Last.FM için 20 etkileşim; Book-Crossing için uyarlanmış fallback sonrasında 3 etkileşimdir.
İşleme sonrasında veri kümelerinin seyrekliğinin sırasıyla %95,48, %94,54 ve %99,91 olduğu raporlanmıştır. Bu değerler, özellikle Book-Crossing'de kullanıcı–öğe matrisindeki bilginin ne kadar sınırlı olduğunu gösterir.
| Veri kümesi | Seyreklik | Uzun-kuyruk öğe oranı | En popüler %20 öğenin etkileşim payı | Gini katsayısı |
|---|---|---|---|---|
| MovieLens-1M | %95,48 | %63,36 | %61,79 | 0,581 |
| Last.FM | %94,54 | %49,01 | %52,58 | 0,449 |
| Book-Crossing | %99,91 | %45,27 | %53,73 | 0,441 |
Eğitim ayarları
- Embedding boyutu: 128.
- KG DistMult ön eğitimi: Adam, öğrenme oranı 1×10⁻³, weight decay 1×10⁻⁵, batch size 2048, 5 epoch.
- Ana model: Adam, 30 epoch.
- Ana öğrenme oranı: 5×10⁻⁴.
- Weight decay: 5×10⁻⁵.
- Batch size: 2048.
- KG komşu sayısı: 16.
- Kullanıcı benzerlik grafında top-k: 50.
- MovieLens-1M ve Last.FM eğitiminde pozitif başına 4 negatif.
- Book-Crossing eğitiminde pozitif başına 8 negatif.
- Tekrarlı ablasyonda pozitif başına 6 negatif.
- AUC/ACC değerlendirmesinde pozitif başına 1 negatif.
- Recall@K değerlendirmesinde kullanıcı başına 100 aday öğe.
Uygulama Python 3.12 ve PyTorch 2.5.1 ile Windows 11 üzerinde gerçekleştirilmiştir. Çalışmada ayrıca NumPy 2.3.5, pandas 3.0.1 ve Pillow 12.2.0 kullanıldığı; hesaplamaların Intel Core i7-12800HX işlemci ve NVIDIA GeForce RTX 4070 Laptop GPU üzerinde yapıldığı raporlanmıştır.
Karşılaştırılan yöntemler
Önerilen model dört baseline ile aynı veri bölünmesi ve değerlendirme protokolü altında yeniden çalıştırılarak karşılaştırılmıştır:
- LightGCN
- ENMF
- NeuMF
- HMKRec
Bu nokta sonuçların yorumunda kritiktir. Çalışma, literatürdeki bütün yöntemlerin sonuçlarını bir araya getirerek evrensel bir sıralama yapmamaktadır. Yazarların iddiası yalnız aynı deneysel protokol altında karşılaştırılan bu baseline kümesiyle sınırlıdır.
Sabit benchmark AUC ve ACC sonuçları
| Veri kümesi | Model | AUC | ACC |
|---|---|---|---|
| MovieLens-1M | Önerilen yöntem | 0,8737 | 0,7202 |
| MovieLens-1M | HMKRec | 0,8384 | 0,6565 |
| MovieLens-1M | LightGCN | 0,8085 | 0,6489 |
| MovieLens-1M | ENMF | 0,7722 | 0,6081 |
| MovieLens-1M | NeuMF | 0,8650 | 0,7057 |
| Last.FM | Önerilen yöntem | 0,8620 | 0,6954 |
| Last.FM | HMKRec | 0,7891 | 0,5917 |
| Last.FM | LightGCN | 0,8549 | 0,6885 |
| Last.FM | ENMF | 0,7809 | 0,6009 |
| Last.FM | NeuMF | 0,8249 | 0,6593 |
| Book-Crossing | Önerilen yöntem | 0,7287 | 0,5623 |
| Book-Crossing | HMKRec | 0,6887 | 0,5360 |
| Book-Crossing | LightGCN | 0,6797 | 0,5587 |
| Book-Crossing | ENMF | 0,5528 | 0,5388 |
| Book-Crossing | NeuMF | 0,6611 | 0,5375 |
Sabit benchmark sonuçlarında önerilen yöntem üç veri kümesinde de karşılaştırılan baseline modelleri arasında en yüksek AUC değerini verir. ACC açısından da bu ana benchmark tablosunda en yüksek değerler önerilen yönteme aittir.
Recall@K sonuçları
| Veri kümesi | Recall@10 | Recall@20 | Recall@50 |
|---|---|---|---|
| MovieLens-1M | 0,3584 | 0,5597 | 0,8455 |
| Last.FM | 0,4665 | 0,6569 | 0,9233 |
| Book-Crossing | 0,3817 | 0,4996 | 0,7541 |
Recall@K eğrileri önerilen yöntemin çalışmada karşılaştırılan baseline modellerine karşı güçlü sıralama performansı verdiğini gösterir. Ancak Recall@K, bu deneyde 100 aday öğe üzerinden örneklenmiş sıralama protokolünde hesaplandığından tam katalog öneri performansıyla birebir eşdeğer değildir. Ayrıca yüksek Recall@K tek başına uzun kuyruk öğelerinin daha fazla gösterildiğini kanıtlamaz.
Ablasyon Çalışması Modelin Hangi Bileşenlerinin Önemli Olduğunu Gösteriyor?
Ablasyon çalışması, tam modelden kullanıcı benzerlik grafı veya hipergraf kolu çıkarıldığında performansın nasıl değiştiğini beş bağımsız random seed üzerinden karşılaştırır. Sonuçlar hipergraf ile kullanıcı benzerlik kolunun ikisinin de genel sıralama performansına katkıda bulunduğunu, AUC açısından özellikle kullanıcı benzerlik kolunun çıkarılmasının daha büyük düşüş oluşturduğunu göstermektedir.
| Veri kümesi | Tam model AUC | Benzerlik yok AUC | Hipergraf yok AUC |
|---|---|---|---|
| MovieLens-1M | 0,8398 | 0,7980 | 0,8255 |
| Book-Crossing | 0,7205 | 0,6893 | 0,6896 |
| Last.FM | 0,8210 | 0,8012 | 0,8048 |
Ablasyon sonuçlarında önemli bir nüans vardır. MovieLens-1M'de tam modelin ACC değeri 0,6210 iken hipergrafın çıkarıldığı varyant 0,6353 ACC'ye ulaşmıştır. Dolayısıyla “tam model her veri kümesinde ve her metrikte mutlaka en iyi” şeklinde bir yorum kaynak tarafından desteklenmez. Yazarlar da sonuçlarını daha temkinli biçimde, tam modelin özellikle AUC ve veri kümeleri genelindeki çoklu-metrik denge açısından güçlü olduğu şeklinde yorumlamaktadır.
Ana benchmarktaki tam model değerleri ile ablasyon grafiğindeki tam model değerlerinin aynı olmaması hata değildir. Kaynak açıkça Şekil 2'nin sabit ana benchmark protokolünü, Şekil 4'ün ise ayrı tekrarlı-seed ablasyon protokolünü gösterdiğini belirtir.
Hesaplama karmaşıklığı
Modelin maliyetinin önemli bileşenleri şunlardır:
- Hipergraf yayılımı: \(O(L_h \cdot nnz(H)\cdot d)\)
- Kullanıcı benzerlik grafını tam çiftler üzerinden kurma: seyrekleştirme öncesi yaklaşık \(O(|U|^2d)\)
- Kullanıcı grafı yayılımı: \(O(L_g\cdot |E_u|\cdot d)\)
- Tek-atlamalı KG toplulaştırması: \(O(B\cdot K\cdot d)\)
- MLP skorlaması: yaklaşık \(O(B\cdot d^2)\)
Bu karmaşıklık yapısında özellikle kullanıcılar arasındaki çiftli benzerlik hesabı büyük kullanıcı evrenlerinde ölçeklenebilirlik darboğazı oluşturabilir. Kaynağın tartışma bölümünde de kullanıcı benzerlik grafının daha büyük kullanıcı kümelerinde pahalı hale gelebileceği açık bir sınırlılık olarak belirtilmektedir.
Çalışmanın desteklediği sonuçlar
- Hipergraf, kullanıcı geçmişindeki grup düzeyli öğe birlikteliklerinden yüksek dereceli işbirlikçi sinyal üretebilir.
- Hipergraftan oluşturulan başlangıç kullanıcı embedding'lerinin ayrı kullanıcı benzerlik grafıyla rafine edilmesi deneylerde ek katkı sağlamıştır.
- Tek-atlamalı bilgi grafı komşularının kullanıcıya koşullu ilişki ağırlıklarıyla toplanması semantik öğe temsiline ek bilgi sağlar.
- Üç bileşenin birlikte kullanıldığı model, bildirilen ana benchmark protokolünde karşılaştırılan baseline kümesi karşısında güçlü sonuç vermiştir.
- Ablasyon, kullanıcı benzerlik kolu ile hipergraf kolunun özellikle AUC açısından katkı yaptığını göstermektedir.
Çalışmanın desteklemediği sonuçlar
- Modelin bütün mevcut öneri sistemlerinden evrensel olarak üstün olduğu gösterilmemiştir.
- Çevrimdışı benchmark sonucu gerçek kullanıcı memnuniyetini veya ticari dönüşümü doğrudan kanıtlamaz.
- Çalışma canlı A/B testi içermemektedir.
- Model kullanıcı tercihlerinin zaman içindeki değişimini dinamik olarak modellememektedir.
- Bilgi grafı kolu tek-atlamalıdır; derin çok-atlamalı semantik muhakeme test edilmemiştir.
- Popülerlik-farkındalıklı son-skor düzeltmesinin bağımsız katkısı özel bir ablasyonla ölçülmemiştir.
- Recall@K sonuçları tek başına uzun-kuyruk görünürlüğü artışının kanıtı değildir.
- Film, müzik ve kitap dışındaki sektörlere genelleme bu çalışma içinde deneysel olarak doğrulanmamıştır.
Bilimsel anlam
Çalışmanın önemli yönü tek bir grafik temsilini “daha derin” yapmak yerine üç farklı bilgi türünü ayrı işlevlerle birleştirmesidir. Hipergraf grup düzeyli davranışı, kullanıcı benzerlik grafı yerel kullanıcı yakınlığını ve bilgi grafı öğelerin ilişkisel semantiğini taşır. Bu ayrım, seyrek veri altında aynı problemi farklı bilgi kaynaklarından tamamlamayı amaçlayan bir temsil öğrenme stratejisidir.
Bununla birlikte mimarinin karmaşıklığı da artmaktadır. Hipergrafın, kullanıcı grafının, bilgi grafının ve MLP'nin birlikte tutulması daha fazla veri hazırlama, entity hizalama ve hesaplama adımı gerektirir. Özellikle bilgi grafı kalitesinin düşük olduğu veya öğelerin dış entity'lere güvenilir biçimde eşlenemediği alanlarda KG kolunun beklenen katkısı azalabilir.
Kaynak ve Yöntem Notu
Özgün başlık: Knowledge-Aware Recommendation Based on Hypergraph and Knowledge Graph
Yazarlar: Shunping Niu; Kuo Chi; Ting Su; Yongqin Yang; Jiabao Gao.
Sorumlu yazar: Kuo Chi.
Kurum: School of Information and Communication Engineering, Hainan University, Haikou 570228, China.
Dergi: AI, 2026, Cilt 7, Sayı 6, Makale 215.
DOI: 10.3390/ai7060215
Yayıncı: MDPI.
Gönderim: 22 Nisan 2026. Revizyon: 7 Haziran 2026. Kabul: 8 Haziran 2026. Yayın: 11 Haziran 2026.
Lisans: Creative Commons Attribution (CC BY). Bu Verianla metni kaynak makalenin cümle yapısını veya özgün şekil kompozisyonlarını yeniden üretmez; bilimsel olgular, denklemler, yöntem ve ölçüm sonuçları bağımsız öğretici bir düzen içinde açıklanmıştır.
Finansman: Çalışma Hainan Provincial Natural Science Foundation, Hainan Province Key Research and Development Program ve National Natural Science Foundation of China kapsamındaki çeşitli hibelerle desteklenmiştir.
Veri erişilebilirliği: MovieLens-1M, Last.FM ve Book-Crossing kamuya açık benchmark veri kümeleridir. Çalışmada kullanılan bilgi grafı yapıları makalede atıf verilen önceki veri hazırlama çalışmalarına dayanmaktadır.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Temel yöntemsel sınırlılıklar: Kullanıcı benzerlik grafı sabit ve top-k seyrekleştirilmiştir; kullanıcı sayısı büyüdükçe oluşturma maliyeti artabilir. KG kodlayıcı tek-atlamalıdır ve entity hizalama kalitesine bağlıdır. Popülerlik-farkındalıklı yeniden sıralama bileşeninin bağımsız etkisini ölçen özel ablasyon yoktur. Deneyler çevrimdışı benchmark protokolüyle sınırlıdır.
Şekil ve grafik kullanımı: Kaynak makalenin özgün Şekil 1–5 tasarımları doğrudan kopyalanmamalıdır. Verianla sürümünde, olgusal veri kullanılıyorsa yeni eksen, tipografi ve kompozisyonla bağımsız grafikler; model mimarisi için ise aynı bilimsel ilişkileri koruyan fakat görsel olarak bağımsız bir teknik şema hazırlanmalıdır.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *